❌

Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hieria
  • ✇Dans les algorithmes
  • Quels travailleurs détestent le plus l’IA ?
    Il y a visiblement une profession qui déteste l’IA plus que toute autre, ce sont les assureurs chargés du traitement des sinistres, rapporte Wired. Ils sont les premiers à se plaindre de « dirigeants obsédés par l’IA qui l’imposent, à eux et à leurs clients ». C’est en tout cas ce qu’on apprend d’une étude de Glassdoor sur le ressenti des travailleurs face à l’IA qui a étudié les réflexions des employés sur l’IA issue des avis qu’ils laissent sur leur employeur sur le grand site participatif d’é

Quels travailleurs détestent le plus l’IA ?

23 septembre 2026 à 07:00

Il y a visiblement une profession qui déteste l’IA plus que toute autre, ce sont les assureurs chargés du traitement des sinistres, rapporte Wired. Ils sont les premiers à se plaindre de « dirigeants obsédés par l’IA qui l’imposent, à eux et à leurs clients ». C’est en tout cas ce qu’on apprend d’une étude de Glassdoor sur le ressenti des travailleurs face à l’IA qui a étudié les réflexions des employés sur l’IA issue des avis qu’ils laissent sur leur employeur sur le grand site participatif d’évaluation des environnements de travail. Tout secteur confondu, rapporte l’étude, les mentions de l’IA dans les avis Glassdoor ont augmenté de 240 % entre mai 2025 et mai 2026. Mais si par le passé, les avis mentionnant l’IA étaient majoritairement positifs (81 % d’avis positifs en 2019), cette tendance s’inverse : en 2026, on ne compte plus que 43 % d’avis positifs, 4 % d’avis mitigés et 53 % d’avis négatifs. 

L’étude empirique de Glassdoor montre un renforcement de la tension sociale autour de l’IA. Hormis les dirigeants d’entreprises qui demeurent le groupe le plus favorable à l’IA, certains métiers adhèrent à ses avantages, comme les responsables des ventes et des produits, les recruteurs, les architectes logiciels ainsi que les analystes et ingénieurs de données. A l’inverse, d’autres professions y sont majoritairement hostiles, notamment les rédacteurs, les journalistes, les comptables, les agents de service client, les designers et professionnels de l’informatique. Mais les plus hostiles restent les gestionnaires de sinistres : 98 % de leurs commentaires étant négatifs.

Les femmes et la génération Z (nés entre 1997-2012) sont les plus critiques à l’égard de l’IA. Les travailleurs plus âgés ont tendance à avoir une opinion plus positive de l’IA, tandis que les plus jeunes sont plus critiques. Au sein de chaque génération, les hommes sont plus enclins à mentionner l’IA, et les femmes se montrent plus critiques que les hommes à son sujet. Chez les hommes de la génération X (nés entre 1960 et 1980), 50 % des commentaires sur l’IA sont positifs, alors que 42 % des commentaires des femmes de cette même génération sont négatifs. Les différences liées au poste occupé et au secteur d’activité expliquent entièrement cet écart. Les commentaires des hommes de la génération Y (milléniaux, nés entre 1980 et 1997) sont positifs à 44 %, contre 33 % pour les femmes. Les différences de poste et de secteur n’expliquent qu’un quart de cet écart. Les hommes de la génération Z affichent 42 % d’avis positifs, contre 21 % pour les femmes de la même génération ; ici, le poste et le secteur d’activité n’entrent pas en ligne de compte. Cet écart persiste même après ajustements statistiques. 

Les commentaires sur l’IA reflètent des opinions tranchées Les mentions de l’IA apparaissent généralement dans des avis Glassdoor très positifs ou très négatifs, en particulier concernant la direction et les perspectives de l’entreprise. Seuls 23 % des auteurs d’avis critiques envers l’IA approuvent le PDG, et 18 % perçoivent des perspectives commerciales positives. À l’inverse, 86 % des auteurs d’avis positifs sur l’IA approuvent le PDG et 81 % envisagent des perspectives commerciales favorables. Les auteurs d’avis positifs sur l’IA sont plus attachés à leur entreprise Les employés ayant cité l’IA comme un point positif sont 47 % moins susceptibles de postuler à d’autres emplois sur Glassdoor. Ceux qui émettent des critiques sur l’IA postulent à d’autres emplois dans des proportions similaires aux employés ne mentionnant pas l’IA. Aucun secteur ni aucune taille d’entreprise ne recueille une majorité de commentaires positifs sur l’IA, mais certains affichent un taux de critique élevé. Les travailleurs du secteur technologique mentionnent l’IA 3,6 fois plus souvent que la moyenne. Les secteurs suivants en termes de fréquence sont les médias et la communication (1,8 fois) ainsi que la gestion et le conseil (1,1 fois le taux de référence). L’IA est la plus populaire dans le secteur juridique, bien que les avis y soient partagés à parts égales (50/50). D’autres secteurs se montrent extrêmement critiques à l’égard de l’IA, notamment les arts (89 % d’avis négatifs), les organisations à but non lucratif (85 %), les assurances (81 %), les télécommunications (80 %) et le transport/la logistique (79 %). Les petites entreprises (200 employés ou moins) ont tendance à susciter davantage de commentaires positifs sur l’IA (50 % d’avis positifs), un chiffre qui tombe à 33 % pour les entreprises de plus de 10 000 employés. 

Bon, revenons à nos agents d’assurances. « Nous sommes épuisés par la quantité d’IA qu’on nous impose », témoigne l’un d’eux à Wired. En fait, la profession traverse une crise majeure. Le nombre de postes a baissé de 5% au cours de la dernière décennie et de plus de 21% entre mai 2025 et 2026, et les postes de débutants ont chuté de plus de 50% depuis 2025. Pour le bureau des statistiques du travail américain, cette chute serait liée au déploiement technique. « Des startups spécialisées, comme Liberate ou Pace, ont levé des millions de dollars en promettant de « réinventer » l’assurance, tandis que les assureurs ont intensifié le recours à l’IA pour traiter un volume croissant de dossiers. Concrètement, cela peut se traduire par un échange avec un chatbot plutôt qu’avec une personne physique pour déclarer un sinistre. Au lieu d’envoyer des agents inspecter une habitation endommagée, des outils d’IA peuvent analyser des photos ou des vidéos pour estimer le montant des indemnisations. L’IA peut également résumer des centaines de pages de dossiers médicaux afin d’en extraire les informations essentielles. Ou bien, l’outil d’IA d’un assureur pourrait traiter les informations transmises par un assuré – photos, vidéos, documents, reçus – puis effectuer un versement, le tout en quelques secondes », comme le propose Lemonade dont le chatbot traiterait 55% de l’ensemble des dossiers de sinistres, laissant à ses employés la gestion des dossiers les plus complexes. Mais les professionnels du secteur ont surtout l’impression d’être remplacés par des modèles d’IA… sans que les clients ne comprennent très bien que les conclusions d’une expertise (et ses erreurs) sont bien plus le fait de robots que d’experts. 

Comme le résume l’historien Brian Merchant sur son blog qui s’est également intéressé à l’étude : « les personnes qui décrivent l’IA en termes très positifs occupent, pour la grande majorité, des postes de direction ; ce sont les cadres de niveau directeur ou supérieur qui manifestent le plus d’enthousiasme à son égard. Les responsables des ventes – en somme, les chefs d’équipe commerciale – se montraient également bien plus favorables que défavorables à l’IA, dans une proportion d’environ deux pour un. Les chefs de produit, les recruteurs et les ingénieurs logiciels affichent eux aussi un avis plutôt positif, avant que les opinions ne tendent vers un certain équilibre ». A l’inverse, remarque l’historien, si l’on observe les professions qui décrivent l’IA en termes très négatifs, on voit apparaître une toute autre configuration sociale. Merchant souligne que le basculement des avis négatifs a progressé et qu’il s’affirme à mesure que les entreprises adoptent massivement des solutions d’automatisation basées sur l’IA. Mais, il semble que « plus les travailleurs sont exposés à l’IA, moins ils l’apprécient ». Pour Merchant, « le ressenti vis-à-vis de l’IA au travail dépend probablement du pouvoir dont vous disposez au sein de l’entreprise ». Le rapport à l’IA est distribué selon le pouvoir dont on dispose sur ces outils. L’appréciation est directement liée à la position sociale qu’on occupe. 

« Pour percevoir l’IA de manière positive, il faut avoir la main sur les décisions concernant son utilisation (ou non) et disposer d’une marge de manœuvre suffisante pour se sentir protégé contre le risque de remplacement, de surveillance ou de dégradation des conditions de travail ». Les cadres et les patrons ont bien peu de comptes à rendre quant à leur utilisation de l’IA. A l’inverse, les employés, eux, n’ont bien souvent aucune liberté dans leur rapport à l’IA. Pour Brian Merchant, la question de la responsabilité éclaire la différence de perception. C’est pourquoi les emplois d’employés sont bien plus en colère contre l’IA que les cadres. Cela explique que les comptables, les conseillers clientèles ou les informaticiens de base soient mis en difficulté par ces outils, car c’est sur eux que repose la tension de la vérification entre « le patron exige que toute l’entreprise utilise l’IA » et « la moindre erreur est de votre faute et vous en êtes responsable ». Entre ceux qui sont contraints et ceux qui restent libres. La tension entre ceux que ces outils assistent et libèrent et ceux que ces outils contrôlent et limitent, n’est pas tant une différence d’approche de l’IA, qu’une différence sociale entre le haut et le bas du déploiement de l’IA.

  • ✇Dans les algorithmes
  • Musique : le piège du droit d’auteur génératif
    Pour le magazine canadien Maisonneuve, le journaliste Michael Rancic, qui fait partie de la coopérative de journalistes musicaux New Feeling, se désole de l’omniprésence de la musique générative partout. Mais si les plateformes de streaming sont déjà envahies des morceaux produits notamment via les outils proposés par Suno et Udio, les acteurs majeurs de la musique (stations de radio, organismes de réglementation et maison de disques), eux, tergiversent, hésitant entre intégrer ou au contraire à

Musique : le piège du droit d’auteur génératif

22 septembre 2026 à 07:00

Pour le magazine canadien Maisonneuve, le journaliste Michael Rancic, qui fait partie de la coopérative de journalistes musicaux New Feeling, se désole de l’omniprésence de la musique générative partout. Mais si les plateformes de streaming sont déjà envahies des morceaux produits notamment via les outils proposés par Suno et Udio, les acteurs majeurs de la musique (stations de radio, organismes de réglementation et maison de disques), eux, tergiversent, hésitant entre intégrer ou au contraire à contrer la musique générative. 

En octobre 2025, la Socan (Société canadienne des auteurs, compositeurs et éditeurs de musique) a annoncé avoir harmonisé sa position sur la génération de musique avec son homologue américain, l’Ascap (la société américaine des compositeurs, auteurs et éditeurs). 

Désormais, « les auteurs-compositeurs peuvent enregistrer des chansons partiellement générées par l’IA pour percevoir des redevances ». Pour Rancic, c’est là un tournant : les œuvres créées avec l’aide de l’IA générative peuvent être intégrées aux systèmes existants de propriété et de rémunération. L’annonce précise soigneusement que, pour être éligible aux redevances, une chanson doit toujours comporter des « éléments de création humaine ». Cependant, elle légitime simultanément une technologie que beaucoup perçoivent comme une menace pour le savoir-faire musical humain.

Or, rappelle Rancic, Suno a reconnu avoir entraîné son modèle depuis toute la musique enregistrée disponible. L’entreprise n’avait aucune autorisation pour ce faire et n’a offert aux artistes aucun moyen de retirer leurs œuvres, qu’elles soient protégées ou non par le droit d’auteur. Des plateformes comme Suno absorbent ainsi des décennies de travail humain et produisent des imitations convaincantes en quelques secondes. Entraînée sur des milliers d’œuvres protégées par le droit d’auteur, la production est alors considérée comme une « nouvelle » chanson. Durant leurs premières années d’activité, Suno et Udio ont également mis en place des cadres propriétaires autour de ces nouvelles chansons : celles-ci peuvent être immédiatement acquises par quiconque saisit l’instruction de génération. Ce contournement des droits d’auteur a, à juste titre, suscité l’inquiétude des artistes.

Premièrement, il a permis aux entreprises d’IA de tirer profit d’œuvres pour lesquelles elles n’avaient pas nécessairement acquis de licence. Deuxièmement, il permet aux utilisateurs de générer des quantités massives de musique sans rémunérer les artistes – un système qui pourrait entraîner la perte de revenus pour de nombreux musiciens. Une lettre ouverte de 2024, signée par des artistes tels que Billie Eilish, Chappell Roan et Arkells, qualifiait l’entraînement d’IA sur de la musique sans compensation d’« atteinte à la créativité humaine ».

Ces tensions ne sont pas propres à la musique. Les artistes visuels ont exprimé des préoccupations quasi identiques concernant les générateurs d’images entraînés sur leurs œuvres, tandis que les cinéastes et les acteurs ont commencé à se confronter aux outils d’IA capables de reproduire des voix, des textes et même des images.

En annonçant les nouvelles lignes directrices sur les redevances, la Socan a décrit l’IA comme un outil précieux largement adopté par les musiciens. Dans le même temps, la déclaration critique le fonctionnement actuel de cet outil censément utile : « l’utilisation par les entreprises de technologies d’IA de modèles basés sur des œuvres musicales protégées par le droit d’auteur, sans autorisation, compensation ni mention des créateurs, ne relève pas de l’usage loyal, mais du vol ». La Socan a réitéré ce point de vue lors d’une récente campagne publique, appelant le gouvernement fédéral à « dire non à l’entraînement de l’IA sur de la musique sans licence ». Mais si la Socan le croit vraiment, pourquoi autoriser la perception de redevances sur des œuvres produites à l’aide de telles plateformes ?

Les lignes directrices de la Socan concernant l’enregistrement de l’IA font la distinction entre les « productions générées par l’IA », qui ne sont pas admissibles à l’enregistrement, et les « œuvres assistées par l’IA ». Or, les déclarants n’ont pas à divulguer l’utilisation de l’IA dans leurs œuvres assistées par l’IA, ce qui signifie que la Socan fait preuve d’une grande confiance, explique Michael Rancic. Déterminer si une chanson a été partiellement ou entièrement créée avec l’IA semble reposer sur une simple intuition. Seule compte une directive vague selon laquelle « la créativité de l’auteur humain doit être centrale ». Il serait envisageable de déposer une chanson avec des voix humaines sur une musique instrumentale générée par IA – entraînée sur les meilleurs rythmes jamais créés – et de satisfaire ainsi aux exigences minimales fixées. Si certains défenseurs font la distinction entre la musique utilisant simplement des composants d’IA et celle entièrement produite par IA, cette frontière est de plus en plus difficile à maintenir. En pratique, les deux reposent souvent sur les mêmes infrastructures d’entraînement et l’extraction de données à partir d’enregistrements humains, ce qui rend la distinction moins pertinente qu’il n’y paraît et pourrait même contribuer à redorer l’image de la génération par IA.

Bien que toutes les plateformes de musique générée par IA ne soient pas entraînées sur de la musique sans licence, la nouvelle réglementation n’identifie aucun mécanisme permettant de distinguer la musique générée par IA utilisant ou non des chansons sans licence, et crée un précédent en faveur de l’adoption de cette technologie. Parallèlement, la déclaration souligne l’importance de soutenir les artistes et de favoriser la créativité. « L’avenir de la musique peut intégrer l’IA tout en restant profondément humain », affirme Jennifer Brown, PDG de la Socan. Ce cadre confère de fait la propriété intellectuelle aux utilisateurs d’IA générative et fragilise les structures de propriété antérieures, censées protéger les artistes. Il révèle une asymétrie dans le traitement de la paternité, du travail et des risques au sein de l’industrie musicale. « Les associations musicales s’empressent d’adopter les nouvelles technologies et plateformes, tout en les critiquant, reflétant une tendance générale du secteur à privilégier les plateformes au détriment des artistes ».

Alors que des organismes comme la Socan acceptent la musique générée par l’IA, les acteurs gouvernementaux et industriels élaborent leurs propres approches. Le gouvernement fédéral canadien consulte actuellement les intervenants du secteur, notamment la Socan, sur l’interaction entre l’IA générative et le droit d’auteur. Ces consultations, menées auprès du Groupe de travail sur la stratégie en matière d’IA du gouvernement et du Comité permanent du patrimoine canadien, visent à éclairer l’élaboration de la stratégie canadienne en matière d’IA pour les années à venir. Malgré la croissance rapide de l’IA générative, le Canada ne dispose actuellement d’aucune loi spécifiquement conçue pour traiter de ses implications en matière de droit d’auteur et de droits des créateurs. Toutes les questions relatives au droit d’auteur relèvent de la Loi sur le droit d’auteur. Actuellement, la Loi sur le droit d’auteur limite l’« utilisation équitable » à des fins spécifiques comme la recherche, la critique, l’éducation ou la parodie. Autrement dit, il est légal d’utiliser des œuvres protégées par le droit d’auteur sans autorisation à ces fins et dans certains contextes. Ces fins n’incluent pas explicitement les entreprises d’IA qui entraînent leurs modèles sur de la musique sans autorisation. « Dans ce contexte, la décision de la Socan d’intégrer la musique générée par l’IA à son système de redevances, avant même que le Canada n’ait établi si cette technologie est conforme à la loi sur le droit d’auteur, revient à mettre la charrue avant les bœufs ».

Il est paradoxal de voir les organisations de l’industrie s’empresser de créer des voies d’accès pour l’IA, explique Michael Rancic. « Prenons l’exemple des plateformes musicales. Lorsque de nouvelles technologies ont bouleversé les normes créatives par le passé, l’industrie n’a pas hésité à intervenir pour protéger les titulaires de droits et sanctionner ceux qui opéraient en dehors du cadre établi. Le sampling (ou échantillonnage), par exemple, a suscité des décennies de litiges, d’accords de licence stricts et une dynamique inéquitable où la charge du risque juridique lié à l’autorisation des échantillons incombait à celui qui les utilisait. Dans les années 1980 et 1990, les différends canadiens liés au sampling ont été largement influencés par les grandes maisons de disques et les titulaires de droits américains. John Oswald, pionnier de l’approche de collage musical par échantillonnage baptisée « plunderphonics », a ressenti le poids et l’influence de la Canadian Recording Industry Association (CRIA, aujourd’hui Music Canada). L’œuvre d’Oswald transformait des tubes classés en tête des palmarès en mosaïques sonores abstraites, métamorphosant le familier en quelque chose d’étrange et d’insolite – une prouesse alliant virtuosité technique et créativité. La CRIA a agi pour le compte des majors américaines en adressant à Oswald une mise en demeure, obtenant finalement la destruction de son œuvre. »

Le régime actuel du droit d’auteur favorise les artistes établis représentés par de grandes maisons de disques, ces dernières disposant des ressources nécessaires pour identifier les titulaires de droits, négocier les licences et régler les frais initiaux éventuels, rappelle Michael Rancic. « Ce système opaque et bureaucratique pénalise lourdement les artistes émergents : il rend risquée l’utilisation transparente d’échantillons et les empêche souvent de détenir légalement les droits sur leurs œuvres – et donc d’en tirer profit. Une chanson contenant un seul échantillon non autorisé ne peut être enregistrée pour percevoir des redevances ; en revanche, une chanson créée par des plateformes entraînées sur une quantité colossale de musique non autorisée semble, elle, échapper à ces contraintes. »

« Les structures du droit d’auteur dans l’industrie musicale sont conçues pour servir ses membres les plus puissants » (voir notre article, « Mais qui décide de comment on compte ? », qui prenait justement l’exemple des Majors de la musique). « Les nouvelles technologies contribuent à perpétuer ce mécanisme : il est révélateur, par exemple, qu’avant même de pouvoir générer de la musique, les outils d’IA aient été utilisés par l’industrie pour surveiller les violations du droit d’auteur ». Spotify a acquis The Echo Nest en 2014 après que cette entreprise a mis au point une technologie d’empreinte acoustique (audio fingerprinting), capable d’analyser les caractéristiques sonores uniques d’un enregistrement pour les convertir en une signature numérique compacte. Concrètement, cette technologie permet aux plateformes de reconnaître les chansons dès leur mise en ligne et d’empêcher la diffusion de copies non autorisées. Aujourd’hui, les plateformes de streaming utilisent des technologies similaires – telles que des « filtres anti-spam musical » – pour identifier la musique générée par IA et les violations potentielles du droit d’auteur. Ces outils sont présentés comme une réponse aux violations du droit d’auteur liées à la génération de musique par IA, alors même qu’ils reposent eux aussi sur cette technologie, explique Rancic. Lorsque l’IA est à la fois le problème et la solution, il semble qu’il n’y ait plus vraiment de choix.

« Le déploiement rapide, au cours de la dernière décennie, d’outils de protection des droits basés sur l’IA témoigne de la priorité accordée de longue date à la préservation de la propriété intellectuelle et des redevances associées. Pourtant, lorsque ces mêmes technologies sous-jacentes permettent la production automatisée de musique, la réaction du secteur se fait nettement plus permissive, voire complaisante. » Au départ, l’industrie a semblé céder à la panique face à l’émergence de la musique générée par IA, les grandes maisons de disques intentant des procès aux entreprises technologiques à l’origine de ces outils. Aujourd’hui, certains de ces mêmes acteurs cherchent activement à collaborer avec ces entreprises. Warner Music Group a récemment trouvé un terrain d’entente avec Suno et Udio concernant les méthodes d’entraînement de leurs modèles d’IA, et Universal Music Group a également conclu un accord avec Udio, sans que les détails financiers et une grande partie des clauses contractuelles de ces accords ne soient ni publics ni transparents, rappelle le journaliste. « Ce que l’on sait, en revanche, c’est que ces accords s’accompagnent de l’annonce d’un partenariat entre Warner, Universal et Udio visant à créer une nouvelle plateforme de génération de musique par IA. Les accords conclus par Udio avec ces deux labels, tout comme celui passé entre Warner et Suno, prévoiraient des mécanismes permettant aux artistes de choisir si leur musique peut ou non servir à l’entraînement des modèles d’IA. Udio et Suno promettent tous deux d’abandonner progressivement les modèles actuels de leurs plateformes – entraînés à partir de musiques non autorisées -, bien que ces modèles soient toujours en service à l’heure où nous écrivons ces lignes. »

Cette attitude permissive de l’industrie face au vol de contenu par les plateformes devient plus compréhensible si l’on reconsidère la véritable finalité de la génération de musique par IA, explique Rancic. Le discours marketing d’Udio affirme que l’entreprise « développe des outils d’IA pour permettre à la prochaine génération de créateurs musicaux d’émerger », tout en soulignant sa capacité à « élargir les horizons musicaux et à permettre à chacun de créer une musique extraordinaire ». Cette présentation de l’IA comme un outil de création se retrouve dans les déclarations de la Socan ainsi que dans des articles du secteur vantant les innombrables possibilités offertes par la musique générée par IA ; comme de générer « des genres musicaux nouveaux ». « Mais tout cela relève de la communication. La véritable proposition de valeur des plateformes de musique générative ne réside ni dans l’innovation esthétique, ni dans un meilleur accès aux outils musicaux, ni même dans l’enrichissement de la création. Elle consiste avant tout à produire des contenus sonores dont on peut immédiatement s’approprier les droits. » Avant les poursuites engagées à leur encontre par les grandes maisons de disques, Suno et Udio permettaient toutes deux aux utilisateurs de télécharger et, de fait, de s’approprier les morceaux générés par l’IA. Dans le cadre de son accord à l’amiable, Udio ne permet plus aux utilisateurs de télécharger et de posséder des chansons générées par IA. Tandis que Suno impose désormais aux utilisateurs de payer pour télécharger les morceaux créés sur sa plateforme. Le nouvel abonnement « Pro » de Suno promet aux utilisateurs la possibilité de générer jusqu’à 500 chansons par mois et l’octroi immédiat des « droits d’utilisation commerciale pour les nouvelles créations ». 

« Vous n’avez pas les moyens d’obtenir les droits d’utilisation d’un sample d’artistes Warner comme Neil Young ou Ed Sheeran ? Aucun souci. Vous pouvez désormais créer une chanson dans le style de ces artistes. Vous en devenez immédiatement propriétaire, vous pouvez l’échantillonner à volonté et, grâce à l’annonce de la Socan, vous pouvez même percevoir des droits d’auteur, à condition d’avoir écrit les paroles. Ce nouveau modèle contourne complètement les structures de droits d’auteur et de propriété de l’industrie musicale, le tout dans le but de générer de la valeur pour les investisseurs du secteur technologique (et, grâce à leurs accords, les maisons de disques s’assurent toutefois de conserver leur part du gâteau). Il est franchement lassant de voir ce cycle se répéter sans cesse et de constater que ceux qui, dans l’industrie, ont le pouvoir d’influencer le changement, traitent ces évolutions comme s’il s’agissait de nouveautés – une énième technologie présentée comme un outil de démocratisation de la musique, alors qu’elle sert surtout à consolider leur pouvoir et à s’approprier le travail d’autrui. »

L’abonnement « Pro » offrant « 500 chansons par mois » fait qu’il est difficile de voir Suno autrement que comme un outil de production de masse de musique sous licence pour la publicité, la télévision, les réseaux sociaux et les espaces publics. Cette stratégie est tout à fait logique étant donné la financiarisation croissante de l’industrie, où la propriété des compositions est devenue primordiale. Posséder les droits sur la composition d’une chanson – non seulement l’enregistrement sonore, que l’industrie a toujours exploité, mais aussi la musique et les paroles – est devenu un bien précieux. Des musiciens canadiens comme Young et Justin Bieber ont vendu les droits d’une part importante de leur catalogue. « L’argent dans l’industrie musicale provient désormais des contrats de licence, et non plus des ventes de disques, et les chansons constituent un actif financier », rappelle pertinemment le journaliste. « Grâce à l’IA, les grandes maisons de disques peuvent exploiter davantage ces actifs pour créer de la musique à l’image de leurs artistes sans nécessairement leur verser de royalties ». Un phénomène qui se manifeste dans l’ensemble des industries créatives, à l’image du monde des acteurs et des scénaristes… « Si l’industrie musicale s’est d’abord montrée méfiante face à la menace que représente l’IA pour le droit d’auteur, elle a désormais compris qu’elle pouvait intégrer cette technologie à ce système à son propre avantage ». Au final, tout cela se traduit par moins de travail et probablement une baisse des revenus pour les artistes.

La question n’est plus de savoir si l’IA va transformer la musique, mais dans quelles conditions cette transformation aura lieu. « Des décisions comme celle de la Socan, et les récents accords conclus entre les grandes maisons de disques et les principales entreprises de musique générée par IA, laissent penser que l’industrie se prépare à intégrer les systèmes génératifs avant même d’avoir mis en place des garde-fous capables de protéger les créateurs que ces systèmes exploitent. Les nouvelles politiques de la Socan, et leur exclusion des œuvres entièrement générées par IA, pourraient constituer les prémices de tels garde-fous, mais leur portée reste floue et leur application encore plus complexe. En l’absence de normes contraignantes concernant les données d’entraînement, le consentement et la rémunération, la normalisation de la paternité assistée par IA risque de consolider les inégalités plutôt que de les résoudre. Les cadres émergents permettent aux plus influents de tirer profit de la musique générée par IA, tandis que les artistes moins connus, dont le travail a été volé, sont exploités de manière perpétuelle à chaque utilisation de ces plateformes. »

« Bien que je ne partage pas leur analyse selon laquelle les craintes suscitées par l’IA sont comparables à celles qui ont accompagné l’apparition des synthétiseurs et des boîtes à rythmes, Gordon A. Gow et Brian Fauteux proposent une idée pertinente pour un cadre potentiel encadrant l’IA », explique encore Rancic. S’appuyant sur le précédent du système de classification canadien MAPL – un label apposé sur la musique canadienne indiquant qu’elle répond à un certain niveau de contribution canadienne -, ils proposent d’étiqueter les chansons générées par l’IA. Des labels physiques et numériques pour l’IA pourraient à tout le moins favoriser la transparence et permettre aux consommateurs de faire des choix éclairés, souligne le journaliste pour qui « la transparence est essentielle et doit guider tout cadre réglementaire futur ». « Les plateformes d’IA générative doivent divulguer leurs sources de données d’entraînement et fournir une documentation sur leurs modèles d’IA (taille de l’ensemble de données, répartition par genre et méthodologie). »

Certains de ces changements sont en cours : Suno a annoncé en 2025 qu’elle abandonnerait ses modèles d’IA actuels et les remplacerait par de nouveaux modèles « plus avancés », entraînés exclusivement sur des données autorisées, dans le cadre de son accord avec Warner. Toutefois, on peut soutenir que les plateformes ayant bâti leur valeur grâce à de la musique non autorisée devraient être explicitement exclues de tout cadre réglementaire régissant la musique générée par IA. Les récompenser aujourd’hui ne ferait qu’encourager, à l’avenir, ces mêmes modèles fondés sur le principe « construire d’abord, demander ensuite ».

« L’IA générative menace de déstabiliser non seulement les revenus des artistes, mais aussi le lien conceptuel entre la créativité et les créateurs eux-mêmes ». Contrairement au sampling ou à l’imitation – pratiques ancrées dans des choix guidés par un dialogue artistique et une longue tradition de la citation musicale -, « l’IA générative évince totalement le créateur ». Il ne s’agit pas d’un outil de création retravaillant ou répondant à une œuvre existante, mais d’un processus qui dépossède les artistes de leur propre travail. « Si les accords conclus entre les grandes maisons de disques et les plateformes d’IA peuvent sembler positifs pour les artistes, il convient de rappeler qu’ils sont conçus dans l’intérêt des dirigeants et des actionnaires, et non nécessairement de celui des artistes et musiciens ; ces derniers risquent de subir des pressions pour s’intégrer à ces nouveaux systèmes d’IA, alors même que leurs opportunités s’amenuisent face à la production de masse de chansons ».

« Si les décideurs politiques n’agissent pas avec détermination, les artistes pourraient se retrouver confrontés à un avenir où prospèrent des structures de propriété prédatrices et des plateformes dominantes, tandis que la pratique musicale humaine deviendrait de plus en plus précaire au sein des systèmes qui reposent pourtant sur elle. Il n’en résulterait pas nécessairement le silence, mais une profusion de musique à la tonalité étrangement anonyme : un flux ininterrompu de chansons aux styles familiers, générées pour imiter des artistes et des genres populaires, mais déconnectées des communautés et des relations qui les avaient fait naître. Dans ce scénario, la musique de demain se caractériserait par une présence sonore constante doublée d’une absence croissante d’auteur identifiable. »

  • ✇Méta-media | La révolution de l'information
  • Liens vagabonds : IA, le marketing de la peur ?
    « L’IA va-t-elle tous nous tuer ? » La question, digne d’un scénario de Black Mirror, s’est rapidement imposée dans les médias après l’alerte lancée par Jacob Coxon, ancien chercheur chez Anthropic. « Les personnes qui construisent l’IA croient sincèrement qu’elle pourrait nous tuer tous d’ici la fin de la décennie. Ce n’est pas une […] The post Liens vagabonds : IA, le marketing de la peur ? first appeared on Méta-media | La révolution de l'information.

Liens vagabonds : IA, le marketing de la peur ?

« L’IA va-t-elle tous nous tuer ? » La question, digne d’un scénario de Black Mirror, s’est rapidement imposée dans les médias après l’alerte lancée par Jacob Coxon, ancien chercheur chez Anthropic. « Les personnes qui construisent l’IA croient sincèrement qu’elle pourrait nous tuer tous d’ici la fin de la décennie. Ce n’est pas une […]

The post Liens vagabonds : IA, le marketing de la peur ? first appeared on Méta-media | La révolution de l'information.

  • ✇Dans les algorithmes
  • La transcription automatique en ses limites
    On avait déjà souligné les grandes limites de la synthèse automatisée. Un organisme de surveillance du service national de santé (NHS) britannique, Healthwatch England, met en garde : les assistants de transcription par IA – qui écoutent et transcrivent les consultations médicales – utilisés par de plus en plus de docteurs, se trompent sur les noms de médicaments et les diagnostics, rapporte The Guardian. « Si elles ne sont pas détectées, ces erreurs risquent de se retrouver dans les dossiers mé

La transcription automatique en ses limites

18 septembre 2026 à 07:00

On avait déjà souligné les grandes limites de la synthèse automatisée. Un organisme de surveillance du service national de santé (NHS) britannique, Healthwatch England, met en garde : les assistants de transcription par IA – qui écoutent et transcrivent les consultations médicales – utilisés par de plus en plus de docteurs, se trompent sur les noms de médicaments et les diagnostics, rapporte The Guardian. « Si elles ne sont pas détectées, ces erreurs risquent de se retrouver dans les dossiers médicaux des patients et d’affecter leur prise en charge ». Le problème, souligne Healthwatch England, c’est que les dispositifs de transcription automatiques des consultations sont au cœur du « grand virage » prévu pour le NHS, visant à transformer un service fonctionnant sur des méthodes analogiques en un service numérique. Ces erreurs, souvent repérées par les patients eux-mêmes, nécessitent de mettre en place un système de signalement et de rectification adapté. Le problème, pointe encore l’organisme, c’est que l’Agence de réglementation des médicaments et des produits de santé a décidé de ne pas classer ces outils de transcription par IA comme des dispositifs médicaux ; cela signifie qu’il n’y aura aucune supervision à l’échelle de l’Angleterre pour garantir leur sécurité et leur efficacité. 

Pour Charlotte Blease, experte en utilisation de l’IA dans le secteur de la santé à l’université d’Uppsala (Suède), les erreurs sont plus susceptibles de se glisser dans les dossiers lorsque la consultation implique plusieurs personnes, que les patients ont des antécédents médicaux complexes ou les patients maîtrisent mal l’anglais.

  • ✇Dans les algorithmes
  • Comprendre les défaillances de la chaîne d’élimination automatisée
    L’AI Now Institute en collaboration avec Airwars.org, un site qui depuis 2014 documente les conflits, ont publié un excellent reportage visuel pour comprendre les enjeux de l’IA sur le champ de bataille sous forme d’un récit, fictif et simplifié, d’une attaque menée avec l’IA, augmenté d’explications spécifiques. « Pour démystifier l’IA militaire, nous construisons une chaîne de destruction abstraite qui reflète un cycle de ciblage par IA. Plutôt que de copier un cadre formel de chaîne de destru

Comprendre les défaillances de la chaîne d’élimination automatisée

17 septembre 2026 à 07:00

L’AI Now Institute en collaboration avec Airwars.org, un site qui depuis 2014 documente les conflits, ont publié un excellent reportage visuel pour comprendre les enjeux de l’IA sur le champ de bataille sous forme d’un récit, fictif et simplifié, d’une attaque menée avec l’IA, augmenté d’explications spécifiques. « Pour démystifier l’IA militaire, nous construisons une chaîne de destruction abstraite qui reflète un cycle de ciblage par IA. Plutôt que de copier un cadre formel de chaîne de destruction utilisé par un État spécifique, notre schéma illustre les activités tactiques et les décisions impliquant l’utilisation de systèmes d’IA à travers six étapes : 1. Capteurs et données, 2. Surveillance, 3. Renseignement et identification, 4. Sélection, 5. Frappe et 6. Évaluation post-frappe. » 

« Les systèmes d’aide à la décision assistés par l’IA – qu’ils s’appuient sur de grands modèles de langage (LLM) ou sur d’autres types d’algorithmes d’apprentissage automatique – intègrent des informations provenant de capteurs couvrant les zones d’opérations militaires. Il peut s’agir de textes issus d’Internet, d’images satellites, de données audio provenant de télécommunications ou de vidéos captées par des drones. Ces données sont synthétisées sur une interface unique et conviviale.

Le problème : les données des capteurs peuvent être incomplètes ou altérées en raison de défaillances, d’interruptions des communications ou d’incertitudes environnementales. Des données comportant des erreurs d’étiquetage (par exemple, des inversions, des omissions ou des étiquettes superflues) peuvent entraîner une dégradation significative, bien que difficile à déceler, des performances de l’IA. L’écosystème d’information dans lequel évoluent les LLM ou autres réseaux de neurones peut également contenir des informations obsolètes ou délibérément corrompues. Ces sources de données sont par ailleurs vulnérables aux afflux massifs d’événements, aux campagnes de désinformation, au détournement de tendances et aux manœuvres de leurre militaire, autant d’éléments qui finissent par compromettre l’efficacité des technologies d’IA en matière de ciblage. » En fait, contrairement au discours qui voudrait que toutes les données utilisées soient parfaitement fiables, c’est en fait assez peu le cas, rappellent les chercheurs. 

Si l’histoire est fictive, les technologies décrites, elles, sont bien réelles. Et les explications permettent de comprendre les enjeux de chacune, comme la détection d’anomalie par exemple, qui vise à repérer des schémas inhabituels ou des changements dans l’imagerie  satellitaire, les données radar et autres flux de télédétection provenant de zones d’opérations militaires. Ces systèmes peuvent recourir à des réseaux de neurones à convolution ou à des auto-encodeurs pour traiter des volumes massifs de données et repérer des éléments susceptibles d’indiquer des mouvements de troupes, des déploiements de missiles, des infrastructures endommagées ou des modifications inattendues du terrain. Le problème avec ces technologies de détection d’anomalies c’est qu’elles peinent à distinguer des menaces réelles des variations environnementales ordinaires. « Les conditions météorologiques, les ombres, le bruit des capteurs et les différences d’angles de vue peuvent entraîner des erreurs de classification. De même, les auto-encodeurs sont entraînés à différencier les schémas correspondant à une classification spécifique des anomalies qui s’en écartent. Toutefois, ces modèles manquent de généralisabilité et de fiabilité ; par ailleurs, les données utilisées pour leur apprentissage peuvent être biaisées, présenter une distribution limitée ou reposer sur des classifications stéréotypées, conduisant à une mauvaise identification de la nature ou de l’identité d’une menace imminente. En 2025 par exemple, il a été démontré que la précision de Maven peut chuter en dessous de 30 % lorsqu’il est déployé sur un terrain inconnu ou dans des conditions environnementales incertaines entravant sa capacité à reconnaître et à signaler des objets », comme le rappelait Katrina Manson dans son livre. 

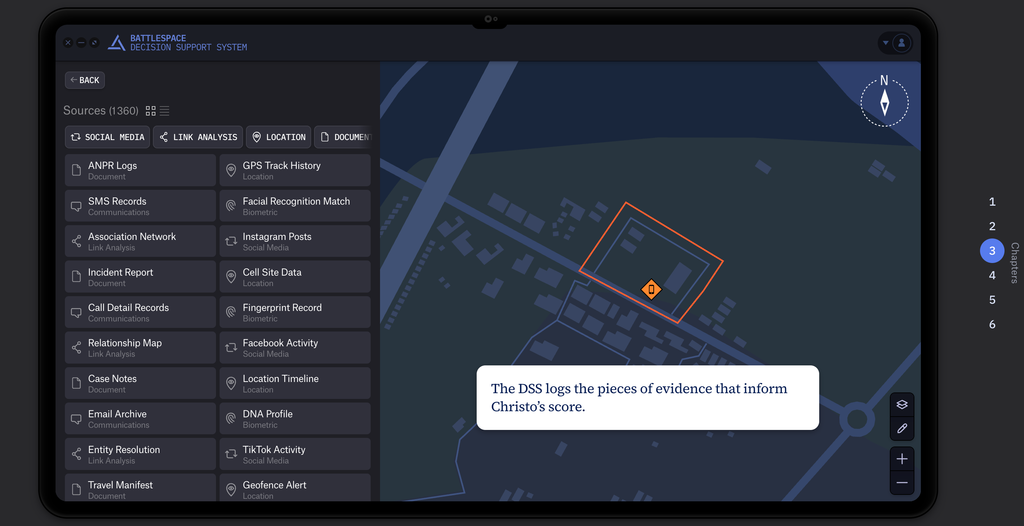
Parmi les nombreuses techniques utilisées, il y a aussi le géorepérage de ces mêmes cibles pour détecter les véhicules ou téléphones qui entrent dans une zone, déclenchant une surveillance et un suivi de la localisation des téléphones et véhicules et une interception des communications : les messages sont automatiquement relayés et traduits en direct, avec des termes qui déclenchent des alertes renforcées (notamment des termes temporels, comme « imminent » ou « bientôt »). Les propriétaires des cartes Sim sont bien sûr identifiés pour contrôler s’ils ne sont pas déjà sur des listes de suspects ou contrôler leur score de risque (un système de notation sociale qui passe au crible toutes les données collectées passivement sur les habitants, données issues de caméras et des réseaux sociaux, pour créer un score de probabilité qu’ils appartiennent à l’armée adverse, voir notre dossier). Si le score de menace est élevé, l’opérateur peut accéder aux sources afférentes pour enquêter et confirmer ou infirmer la menace depuis toutes les données collectées. Parmi celles-ci : les déplacements provenant du GPS du téléphone, les informations relatives aux plaques minéralogiques du propriétaires du véhicules (et donc les déplacements associés à ces véhicules), ses SMS, l’enregistrement de ses derniers appels, l’enregistrement de son visage ou de ses empreintes pour débloquer son téléphone, ses mails, savoir s’il s’est déjà trouvé dans une zone géorepérée… Des tonnes d’informations que l’opérateur n’a souvent pas le temps d’examiner car son temps est compté. Mais surtout, les liens et les activités sur les réseaux sociaux constituent l’un des facteurs du score de risque. Une analyse des publications est produite, traduite et analysée automatiquement notamment pour y détecter des émotions, comme le fait que leur auteur soit susceptible d’apprécier des actions de l’ennemi, ou que ces échanges aient été likés par des membres avérés de l’armée adverse. Dans ces analyses traduites, automatisées, il est impossible de vérifier si les publications en question sont bien réelles ou si les traductions sont fidèles. Ses relations sur les réseaux sociaux ou via ses appels et SMS sont également analysées pour montrer si ses abonnés sont membres de l’armée adverse ou s’il a pu échanger avec des ennemis confirmés. En accédant à son profil, on peut récupérer des photos permettant de lancer automatiquement une requête dans les réseaux de caméras de vidéosurveillance et observer si ses déplacements ont un rapport avec des sites surveillés et sensibles. Là encore les erreurs d’identification peuvent être innombrables. Compte tenu du temps limité, l’opérateur a tendance à valider ce que le système de notation sociale suggère. Si l’identification a un caractère d’urgence, un drone de surveillance peut être déployé pour suivre la personne identifiée. 

Capture d’écran de la fiction explicative de l’AI Now Institute et AIrwars. On voit sur la carte un téléphone géorepéré dans un bâtiment et sur la gauche, tous les éléments du téléphone auquel accède le système.
Autre capture, le système repère les téléphones, les véhicules et le matériel en leur attribuant des caractéristiques spécifiques.

Dans ce cas, le flux vidéo permet d’identifier qui est présent. Les personnes, les véhicules… et les personnes sont distinguées entre civils et membres de l’armée ennemie. Selon leur taille ou leur gabarit, il identifie les objets et les personnes, par exemple en les classant comme des « hommes en âge de combattre ». Chaque image du scénario permet d’accéder à des fenêtres contextuelles permettant de mettre en perspective la fiabilité des technologies utilisées. Par exemple, l’animation rappelle que la détection de formes et d’objets reste peu fiable. « Des recherches ont par exemple révélé que les systèmes peuvent classer de manière erronée 97 % des objets s’ils apparaissent dans des postures s’écartant de celles figurant dans les données d’apprentissage. Par ailleurs, diverses études montrent qu’une grande précision lors des phases de test ne garantit pas nécessairement une précision ou des performances élevées lors du déploiement en conditions réelles. En 2021, l’US Air Force a mené un programme pilote de reconnaissance de cibles affichant un taux de précision de 95 % dans des scénarios d’entraînement. Ce chiffre a toutefois chuté à seulement 25 % en environnement réel. Dans la grande majorité des cas, des algorithmes entraînés à reconnaître des images de missiles sol-sol sous un angle oblique se sont révélés incapables d’identifier ces mêmes objets lorsqu’ils apparaissaient dans des positions différentes. »

Une fois la frappe accomplie, l’opérateur reçoit un rapport d’évaluation, généré par un système d’évaluation des dommages de combat assisté par IA. Ces rapports ont tendance à renforcer les erreurs de classification déjà commises par les systèmes. Les réseaux sociaux sur place et les publications journalistiques locales donnent souvent une autre vision de ces résultats, mais ces informations ne sont pas réintégrées dans le système pour apprécier ses erreurs. Ils montrent aussi parfois que les personnes ciblées ne sont pas aussi menaçantes qu’elles semblaient l’être, en rappelant leur parcours et leurs fonctions. 

« À Gaza, l’armée israélienne a publié une vidéo d’une frappe tuant un homme qui transportait ce qu’elle a identifié comme un lance-roquettes. Elle a par la suite reconnu que ses forces avaient mal identifié l’objet : il s’agissait d’un vélo. » La vidéo est d’ailleurs confondante. Vue de haut, on ne sait pas ce que l’homme tient à son bras. Mais, si le système vous indique que c’est un lance-roquette, alors assurément, cela semble en être un. En fait, on comprend que c’est la manière dont ces outils regardent le monde qui est problématique. Pour un système de ce type, tout est menace, tout est orienté pour détecter des menaces, et à force de regarder le monde comme une menace, il le devient. 

« Les partisans de l’IA soutiennent qu’elle peut atténuer et réduire ces erreurs. Toutefois, ces systèmes risquent aussi de provoquer l’effet inverse, notamment en augmentant les taux d’erreur tout au long de la chaîne de ciblage et de frappe. Au cours d’une campagne de frappes de 40 jours contre l’Iran ce printemps, l’armée américaine a déclaré avoir atteint plus de 13 000 cibles, un rythme d’opérations quasi impossible à tenir avant l’avènement de l’IA.

L’IA pourrait également compliquer l’identification des défaillances et entraver l’obligation de rendre des comptes. À la suite d’une enquête d’Airwars sur une série de frappes assistées par l’IA ayant tué un étudiant irakien, l’armée américaine a déclaré n’avoir « aucun moyen de savoir » si la frappe meurtrière avait reposé sur l’IA.

Le livre Project Maven (voire notre critique), consacré à l’IA militaire américaine a révélé que, dans certaines opérations, seules deux des six étapes de la chaîne de ciblage et de frappe impliquent désormais une intervention humaine directe, une troisième nécessitant une certaine supervision humaine. Les autres étapes sont aujourd’hui entièrement automatisées. »

Dans une interview pour Democracy Now, Heidy Khlaaf, directrice scientifique chargée de l’IA à l’AI Now Institute et responsable de la publication avec AIrwars de cette fiction explicative, rappelle que derrière ces systèmes automatisés il n’y a pas de robot tueur, mais des chaînes de systèmes algorithmiques qui ont tous leurs propres pièges et leurs propres défauts. « Ils présentent tous une fiabilité et une précision très faibles. Ces systèmes s’appuient les uns sur les autres et s’alimentent mutuellement pour aboutir, malheureusement, à des pertes civiles, comme nous l’avons souvent constaté lors de leur utilisation. » « La distinction entre systèmes autonomes et systèmes de soutien est assez superficielle en pratique ». En réalité, quand on utilise ces systèmes, les biais d’automatisation sont très forts, rappelle-t-elle : tout y est présenté comme un risque. C’est le cas par exemple des systèmes de traduction automatisés, comme l’a montré une enquête d’Associated Press, qui montrait que l’usage de systèmes de traduction avaient du mal avec l’arabe. Prendre un mot pour un autre peut suffire pour vous inscrire sur une liste de personnes cibles. « Il est très difficile de comprendre pourquoi une IA a pris une décision donnée lorsqu’il s’agit de grands modèles de langage, en raison de leur envergure et de leur mode de fonctionnement. Était-ce dû à des données erronées ? L’IA a-t-elle reçu des instructions en ce sens ? S’agissait-il d’hallucinations ? Quiconque a utilisé ChatGPT sait que ces agents conversationnels inventent souvent des informations. C’est, je pense, la situation dans laquelle nous nous trouvons actuellement. La cause exacte de ces événements reste incertaine. En fait, je dirais même que c’est là l’une des finalités des systèmes d’IA : ils servent souvent à diluer la responsabilité », comme le pointait très bien le sociologue Ori Schwarz également (voir notre article). 

« En fin de compte, ces entreprises sont en train de réinventer la notion de sécurité. Elles s’approprient bon nombre de termes traditionnellement utilisés dans l’ingénierie de la sûreté et de la sécurité pour les appliquer à des formes de sécurité différentes. Au lieu de se demander : « Nos systèmes sont-ils fiables ? Sont-ils précis ? Fonctionnent-ils comme prévu ? Sont-ils adaptés à leur usage, de sorte qu’aucun être humain ne subisse de préjudice du fait des décisions ou des recommandations qu’ils génèrent ? » Au lieu de cela, nous nous retrouvons avec des cadres relatifs à la sécurité et à l’éthique qui portent sur des questions telles que l’autonomie, l’intentionnalité ou la conscience de ces systèmes. Or, il s’agit là d’une question tout à fait différente. Ces systèmes peuvent souvent donner l’illusion de posséder ces caractéristiques, ce qui conduit à anthropomorphiser le langage ou les actions de ces modèles. Nous avons vu récemment, par exemple, les capacités de cybersécurité être présentées comme si ces systèmes étaient autonomes – comme s’ils agissaient de leur propre chef, ce qui correspondrait à une attente que nous aurions à leur égard. Pourtant, dans la réalité, ces entreprises les déployaient dans des environnements très peu sécurisés et amenaient délibérément ces modèles à mener des cyberattaques dans le cadre de tests ou d’évaluations comparatives. »

« C’est précisément ce qui me pose problème : ces entreprises tentent, une fois de plus, d’attribuer la responsabilité à l’IA plutôt qu’à elles-mêmes. Or, l’IA ne fait que ce que nous lui ordonnons de faire ; elle n’est capable que de ce pour quoi nous l’avons conçue. »

« Il est donc crucial de garder à l’esprit que, certes, ces systèmes sont performants. Oui, ils sont capables de mener des actions telles que des cyberattaques ou des frappes. Et ils accélèrent effectivement les opérations ; c’est indéniable. C’est même l’une de leurs caractéristiques fondamentales. Toutefois, si l’on dispose d’un outil qui accélère les opérations mais dont la fiabilité et la précision de base se situent entre 30 et 60 %, le résultat ne diffère guère d’un ciblage aveugle, n’est-ce pas ? » Nous ne sommes pas confrontés à des robots tueurs dotés d’intentions propres, mais à une conception délibérée, défaillante, produite par des personnes qui « décident de le déployer, en toute connaissance de cause des systèmes à la fiabilité et à la précision médiocres – surtout dans des situations inédites, un cas de figure plus probable encore en temps de guerre que lors de cyberattaques.»

  • ✇Dans les algorithmes
  • La gauche doit-elle céder au chant de l’IA générative ? Non ! 
    « Depuis que le camp de l’émancipation a renoncé à combattre l’aliénation et a adopté les « innovations » du capital en les saluant comme des progrès, il ne cesse de multiplier les défaites. Parce que, précisément, ces innovations garantissent une passivité face à la réalité capitaliste qui sape les bases de toute tentative sérieuse d’émancipation. » Pour le journaliste Romaric Godin de Mediapart, l’IA générative ne conduira la gauche nulle part. « Le capital est le principe dominant de cette te

La gauche doit-elle céder au chant de l’IA générative ? Non ! 

9 septembre 2026 à 07:00

« Depuis que le camp de l’émancipation a renoncé à combattre l’aliénation et a adopté les « innovations » du capital en les saluant comme des progrès, il ne cesse de multiplier les défaites. Parce que, précisément, ces innovations garantissent une passivité face à la réalité capitaliste qui sape les bases de toute tentative sérieuse d’émancipation. » Pour le journaliste Romaric Godin de Mediapart, l’IA générative ne conduira la gauche nulle part. « Le capital est le principe dominant de cette technologie qui est à son service. » « Si l’État prenait le contrôle de l’IA aujourd’hui, il la mettrait au service de la société capitaliste comme une matière première. Il en assurerait donc l’abondance bien davantage que la sobriété. Cela changerait certes les rapports de force au sein du capital, mais cela ne changerait rien à la centralité du capital dans la société. »

Mais surtout, rappelle le journaliste, à quoi sert l’IAG dans la lutte pour l’émancipation ? « En réalité, cette technologie n’est pas qu’un simple outil que l’on pourrait aisément retourner. La gestion de l’économie du capitalisme tardif passe par le déni des crises économiques, anthropologiques et écologiques. Et l’IAG est l’outil conçu pour organiser ce déni. Son développement est un choix du capital qui a investi et continue d’investir dans cette technologie au détriment d’autres technologies qui pourraient davantage répondre aux besoins de l’humanité. »

  • ✇C'est pas mon idée !
  • L'IA impose ses exigences
    Les traditionnelles prédictions stratégiques annuelles de Gartner sont, pour 2027 et au-delà, exclusivement consacrées à l'intelligence artificielle. Cependant, ce qui me surprend le plus est le prisme retenu : il n'est pratiquement question que des défis et des contraintes qu'elle imposera aux entreprises et non des opportunités qu'elle leur offre.Dans ce dernier registre, les analystes ne retiennent que deux propositions. L'une, élémentaire, concerne l'irruption de l'IA « physique » aux côtés

L'IA impose ses exigences

Par : Patrice
20 septembre 2026 à 21:40
Gartner
Les traditionnelles prédictions stratégiques annuelles de Gartner sont, pour 2027 et au-delà, exclusivement consacrées à l'intelligence artificielle. Cependant, ce qui me surprend le plus est le prisme retenu : il n'est pratiquement question que des défis et des contraintes qu'elle imposera aux entreprises et non des opportunités qu'elle leur offre.

Dans ce dernier registre, les analystes ne retiennent que deux propositions. L'une, élémentaire, concerne l'irruption de l'IA « physique » aux côtés des employés, que ce soit sous forme de robots à proprement parler ou de véhicules autonomes, de drones et autres appareils interagissant avec leur environnement. En la matière, une recommandation notable porte sur les impératifs de sécurité, qui devraient être placés en tête des préoccupations. La seconde est indirecte puisqu'elle esquisse l'émergence d'une activité de distribution d'énergie dans les grands groupes qui déploient leurs propres capacités de production face aux besoins engendrés par leurs usages.

Une idée intéressante, qui changerait radicalement le fonctionnement des directions informatiques, touche aux nouvelles méthodes de développement logiciel. Il ne s'agit pas ici uniquement de considérer les impacts sur la programmation, dont l'assistance constitue un des premiers cas de mise en œuvre de l'intelligence artificielle, mais aussi du changement de perspective sur le patrimoine applicatif que son efficacité induit : d'ici 2029, 80% des applications générées seraient jetables, par conception, en réponse à des demandes ponctuelles ou pour une adaptation rapide à un contexte mouvant.

Dans la catégorie des challenges, ensuite, Gartner voit apparaître une classe d'acteurs opérant nativement via l'IA, ce qui leur procure la faculté de mettre sur le marché des produits personnalisés à grande échelle qui déstabiliseront les organisations restées à la traîne de la tendance, notamment par leurs conséquences sur la fidélité de leurs clients… et de leurs collaborateurs. Ce genre de prophéties est classique de l'exercice, mais elle a le mérite d'insister sur l'importance, indiscutable, de l'innovation et, en arrière-plan, de la nécessité de définir un cadre qui la stimule continuellement.

Gartner – Prédictions Stratégiques 2027

Mais les aspects financiers sont ce qui inquiète le plus le cabinet. Si la problématique des coûts directs du recours à des modèles intelligents est désormais relativement bien intégrée, divers risques périphériques sont également à envisager, tels que les attaques par épuisement de tokens – quand des personnes malintentionnées abusent de services exposés au grand public afin de provoquer une consommation excessive de ressources – et le débordement de capacité – quand les utilisateurs légitimes exploitent de plus en plus massivement des agents pour exécuter leurs tâches automatiquement.

La défense passera par la mise en œuvre d'une gouvernance spécifique. À un niveau tactique, il faudra installer des solutions de suivi et de contrôle en temps réel, fournissant un socle de pilotage aux décideurs. À un stade plus stratégique, ces outils devront être aptes à un rapprochement avec une mesure du retour sur investissement, et donner ainsi de la visibilité sur la valeur réelle dégagée par les initiatives, afin, le cas échéant, d'engager les arbitrages nécessaires. Dans ce but, 6 entreprises sur 10 disposeraient en 2029 d'une fonction dédiée à cette surveillance de l'équilibre coûts-bénéfices de l'IA.

Enfin, il restera à traiter le (vaste) sujet de la responsabilité qui, dans certains secteurs, dont le secteur financier, relève aussi d'un enjeu réglementaire. Pour Gartner, le directeur informatique ou, si le poste existe, le directeur de l'intelligence artificielle devra assumer cette charge supplémentaire de définition des règles applicables et se porter garant de leur implémentation effective. Dernière note, toujours dans ce domaine, ce sont les assureurs et non les régulateurs qui en établiront les normes, à travers les contraintes qu'ils édicteront pour offrir une couverture abordable à leurs clients.

En conclusion, les firmes qui aujourd'hui se concentrent sur des expérimentations avec l'IA, en essayant de déterminer comment elle peuvent tirer parti de ses opportunités, ont tout intérêt à se pencher au plus tôt sur le cadre général dans lequel elles devront se projeter quand elle sera devenue une composante stratégique de leurs infrastructures.

  • ✇C'est pas mon idée !
  • Une IA pour remplacer les actuaires
    Huscarl, qui vient d'opérer une première levée de fonds au début du mois, s'attaque à une forteresse historique de l'analyse de données : l'actuariat. Elle développe en effet, à l'intention des entreprises auto-assurées, des outils d'intelligence artificielle capables de calculer des projections de pertes et de primes sur des scénarios personnalisés.Bien sûr, il n'est pas question – en tous cas pour l'instant (?) – de remplacer les experts qui, dans les compagnies, affinent presque quotidiennem

Une IA pour remplacer les actuaires

Par : Patrice
18 septembre 2026 à 21:45
Huscarl
Huscarl, qui vient d'opérer une première levée de fonds au début du mois, s'attaque à une forteresse historique de l'analyse de données : l'actuariat. Elle développe en effet, à l'intention des entreprises auto-assurées, des outils d'intelligence artificielle capables de calculer des projections de pertes et de primes sur des scénarios personnalisés.

Bien sûr, il n'est pas question – en tous cas pour l'instant (?) – de remplacer les experts qui, dans les compagnies, affinent presque quotidiennement les évaluations de risques sur les produits courants de l'industrie avec des modèles mis au point et étalonnés sur de longues années. En revanche, la jeune pousse (française) défend ses atouts pour s'implanter dans des domaines plus spécialisés, tels que ceux que prennent en charge les entités captives, correspondant fréquemment à des besoins atypiques.

Huscarl propose ainsi de réaliser des études de faisabilité ad hoc ou bien de construire un véritable plan d'affaires pour une couverture donnée. À partir d'informations plus ou moins riches et d'une description des attentes, ses algorithmes vont élaborer un dossier d'étude sur cinq ans, illustrant l'équation économique d'un projet, y compris en conditions extrêmes, ou bien estimer le coût à prévoir, ligne par ligne, prenant même en compte les évolutions structurelles, par exemple autour des aléas liés au changement climatique.

Dans une large mesure, la startup cherche plus à combler les niches dans lesquelles les professionnels ne peuvent s'engager qu'à remplacer le travail des actuaires, ce qui explique son positionnement. Elle promet notamment, de manière explicite, de fournir des résultats exploitables sur des risques que les acteurs traditionnels ne veulent pas considérer ou, du moins, pas avec le niveau de personnalisation souhaité, que ce soit par manque de données de référence ou en raison de leur mauvaise qualité.

Accueil Muscarl

Aujourd'hui, vus de l'extérieur, les actuaires représentent une élite intouchable dans l'univers de l'assurance. Pourtant, ils ne seront pas épargnés par la révolution de l'intelligence artificielle, bien au contraire. Leurs compétences en matières de statistiques sont évidemment parmi les plus exposées à l'automatisation… et, conscients du progrès, ils ont su s'approprier les générations précédentes de science de données en vue de décupler leur efficacité. Désormais, c'est le second pan de leur savoir-faire qui est menacé : la compréhension des sous-jacents d'un risque et d'une couverture. Certes les IA n'en ont pas une réelle perception mais elles sont néanmoins en mesure de les capturer dans des documents ou autre sources d'information et cette capacité peut probablement suffire à reproduire une expertise convaincante.

  • ✇C'est pas mon idée !
  • Des IA pour les conseillers financiers
    Coup sur coup, OpenAI puis Anthropic ont présenté leurs solutions d'intelligence artificielle générative à l'intention des conseillers financiers. Au milieu de la frénésie pour les agents IA, leurs prétentions, largement circonscrites à la documentation, paraissent timides : l'extrême prudence qui règne dans le secteur impose ses conditions.Pour être précis, les annonces des deux firmes ne concernent pas exactement les mêmes populations : la déclinaison de ChatGPT s'adresse plutôt aux équipes d

Des IA pour les conseillers financiers

Par : Patrice
16 septembre 2026 à 21:45
Claude
Coup sur coup, OpenAI puis Anthropic ont présenté leurs solutions d'intelligence artificielle générative à l'intention des conseillers financiers. Au milieu de la frénésie pour les agents IA, leurs prétentions, largement circonscrites à la documentation, paraissent timides : l'extrême prudence qui règne dans le secteur impose ses conditions.

Pour être précis, les annonces des deux firmes ne concernent pas exactement les mêmes populations : la déclinaison de ChatGPT s'adresse plutôt aux équipes de banque d'investissement tandis que celle de Claude est véritablement dédiée aux professionnels de l'accompagnement des particuliers. J'estime néanmoins intéressant de constater à quel point les approches s'avèrent similaires et, finalement, portent sur un périmètre contraint qui, en pratique, en limite la valeur en tant qu'offre tierce.

Les solutions visent ainsi un même objectif de simplifier les phases documentaires et préparatoires au travail des spécialistes. Dans cette perspective, l'accent est mis sur les connecteurs pré-intégrés, qui permettent à l'IA d'accéder directement et de manière aussi transparente que possible (donc sans requérir des configurations techniques parfois complexes) aux sources d'information habituelles de ses utilisateurs. À partir de cette matière, elle réalise les tâches administratives classiques de son audience cible.

Pour ChatGPT, qui rattrape ici son grand concurrent sur un produit datant de plus d'un an, il s'agit de produire des documents d'analyse financière – sous divers formats, y compris graphiques, adaptés aux chartes de chaque client, le cas échéant – en combinant des sources multiples et en opérant sur des dimensions variables (statique, temporelle…). Naturellement, OpenAI insiste sur les garanties de sécurité et de confidentialité qu'elle engage vis-à-vis des données ingérées par son modèle.

L'IA pour les Conseillers Financiers

Du côté de Claude, c'est une batterie de fonctions unitaires qui est mise à la disposition des conseillers, également dans l'optique de faciliter leur quotidien : études préalables à un entretien, portant, selon les cas, sur les investissements alternatifs, sur les aspects réglementaires, sur la fiscalité, la revue des équilibres du portefeuille… Les protections sont partiellement automatisées, par exemple le contrôle des exigences de la SEC sur les communications aux clients, ou déléguées à l'humain, dont la validation est requise pour les livrables potentiellement sensibles (notamment s'ils sont partagés).

En synthèse, les géants de l'IA proposent à l'industrie de la finance des outils qui se contentent d'implémenter les « basiques » de l'intelligence artificielle générative dans ses métiers, à savoir, en simplifiant le concept, l'acquisition d'information, son traitement, et la restitution de contenus dérivés plus ou moins originaux. Cette démarche évite certes les inquiétudes suscitées par des modèles qui élaboreraient des stratégies d'investissement ou émettraient des recommandations. Mais ne correspond-elle pas à ce que les institutions construisent déjà en interne depuis quelques temps ?

  • ✇Dans les algorithmes
  • Flock : quel niveau de surveillance êtes-vous prêts à tolérer ?
    Aux Etats-Unis, la fronde contre le développement des détecteurs automatiques des numéros de plaques d’immatriculations est forte. Si quelques caméras Flock ont été vandalisées, ce sont surtout nombre de conseils municipaux abonnés au système qui rejettent et résilient leurs contrats avec l’entreprise qui les installe, suite notamment aux révélations de l’utilisation du système par l’ICE, la police qui de l’immigration américaine, qui s’en sert pour traquer les étrangers sans lien avec des infra

Flock : quel niveau de surveillance êtes-vous prêts à tolérer ?

8 septembre 2026 à 07:00

Aux Etats-Unis, la fronde contre le développement des détecteurs automatiques des numéros de plaques d’immatriculations est forte. Si quelques caméras Flock ont été vandalisées, ce sont surtout nombre de conseils municipaux abonnés au système qui rejettent et résilient leurs contrats avec l’entreprise qui les installe, suite notamment aux révélations de l’utilisation du système par l’ICE, la police qui de l’immigration américaine, qui s’en sert pour traquer les étrangers sans lien avec des infractions de circulations. 

Pour faire face à la fronde, Flock a fini par réagir et a annoncé une série de changements dans les modalités de partage d’information avec les forces de l’ordre américaine. Des changements surtout cosmétiques, ironise Gizmodo. L’entreprise, en effet, propose désormais que par défaut, la durée de conservation des informations passe de 30 à 7 jours. Mais en fait, précise l’entreprise, « les forces de l’ordre peuvent prolonger ou réduire cette période. Chaque collectivité continuera de choisir la durée de conservation adaptée à sa stratégie de sécurité publique et conforme aux politiques locales ou étatiques. » Elle annonce également un dispositif supplémentaire (le mode « Preuve ») qui permettra à la police de conserver « des données LAPI (systèmes de Lecture automatisée de plaques d’immatriculation) spécifiques à titre de preuve pour une enquête en cours, dans un stockage à long terme ». L’ACLU (American Civil Liberties Union) a publié une réponse moqueuse (« Flock semble davantage viser à résoudre un problème d’image qu’à s’attaquer aux atteintes majeures à la vie privée et aux autres préjudices engendrés par ses produits ») et maintient sa campagne invitant les citoyens à agir pour « se débarrasser du Flock » (Get the Flock out). L’Institut pour la Justice a pour sa part publié une base de données pour recenser les abus d’utilisation des systèmes de lecture automatisée de plaques d’immatriculation. L’ACLU rappelle que si Flock souhaite évaluer l’efficacité de son outil et notamment mieux surveiller les usages abusifs qu’en fait la police, l’entreprise devrait le soumettre à l’analyse d’un évaluateur indépendant. Flock a déjà par le passé annoncé des mesures de sécurité liées au motif de recherche, mais elles n’ont produit aucune amélioration, bien au contraire. Comme, le rappelle Gizmodo, « il est difficile d’imaginer qu’une personne prête à détruire une caméra Flock changera d’avis simplement parce que la durée recommandée de conservation des données passe de 30 à 7 jours ». 

Dans un entretien à la BBC, le PDG de Flock, Garrett Langley, ajoute qu’il s’est rallié à l’idée d’organisations telles que l’ACLU et l’Electronic Frontier Foundation (EFF), selon lesquelles la police devrait disposer d’un numéro de dossier en cours pour pouvoir consulter les données de Flock. Pour Cooper Quentin, de l’EFF, « les requêtes dans les bases de données [de lecteurs automatiques de plaques d’immatriculation], devraient impérativement faire l’objet d’un mandat judiciaire ». Ce n’est pas le cas. 

Alors que le gouvernement américain surveille activement sur les réseaux sociaux les publications anti-Flock devenues virales, rapporte 404 media, et menace le site DeFlock, qui cartographie la présence des caméras, son initiateur, Will Freeman, rappelle qu’il n’a jamais appelé à neutraliser les caméras ni à masquer les plaques d’immatriculation, contrairement à ce qu’affirment les récents bulletins des forces de l’ordre. Le vandalisme montre surtout que les gens sont mécontents de voir ces systèmes installés à leur insu ou sans leur consentement. Mais le sabotage semble surtout assez anecdotique, bien moindre en tout cas que la contestation qui pousse les citoyens à demander des comptes aux autorités locales qui tissent des partenariats avec l’entreprise Flock. 

Comme l’explique une enquête de New Republic sur la montée de la contestation contre les systèmes de caméras LAPI, « Flock constitue un système de surveillance de masse d’une puissance – et d’une rentabilité – stupéfiante. Ses caméras LAPI sont utilisées par plus de 1 000 entreprises et environ un tiers des 18 000 services de police des États-Unis ». L’ACLU l’estime à le nombre de caméras de surveillance des plaques d’immatriculations déployées aux Etats-Unis à 90 000. Quant à l’entreprise, elle a généré un chiffre d’affaires de 285 millions de dollars en 2024. Le géant du capital-risque Andreessen Horowitz a récemment valorisé l’entreprise à 7,5 milliards de dollars. 

Alors qu’il valorise son entreprise en promettant rien de moins que l’élimination de la criminalité des Etats-Unis d’ici une décennie, l’année dernière, Garrett Langley a qualifié DeFlock d’« organisation terroriste ». A l’heure où les actions de résistance anti-tech sont devenues, aux Etats-Unis, une menace terroriste, Will Freeman répond que son site, DeFlock, est surtout un outil de transparence. 

Les études (2019 et 2024), jusqu’à présent, montrent surtout que l’efficacité des caméras à prévenir le crime est plus que douteuse. « En 2022, l’entreprise s’est vantée que ses caméras à San Marino, en Californie, avaient entraîné une baisse de 80 % des cambriolages en cinq mois ; Forbes a révélé par la suite que les cambriolages avaient en réalité augmenté dans les années suivant l’installation des caméras de Flock ». « Même si les caméras et le réseau de surveillance de Flock contribuent à élucider certains crimes, les critiques estiment que le prix à payer en matière de vie privée est trop élevé. La police a été prise en flagrant délit d’utilisation illégale des données de Flock pour localiser une femme cherchant à avorter, pour traquer et harceler des individus, surveiller des manifestations ou prêter main-forte aux services d’immigration de l’ICE pour arrêter des individus depuis de simples suspiscions. » 

« Au minimum, cette surveillance de masse implique le suivi, sans mandat, de toute personne circulant sur la voie publique », a averti l’ACLU. « Au pire, elle instaure un État policier numérique où les forces de l’ordre […] peuvent traquer manifestants, opposants politiques, immigrés, patients et autres personnes non soupçonnées de crime, et utiliser ces informations pour leur nuire. »

Une contestation de droite comme de gauche

Sous la pression populaire d’opposants à Flocks, locaux et actifs, « Austin, au Texas, a suspendu son programme Flock en juin dernier face à la contestation locale, tandis qu’Evanston, dans l’Illinois, y a mis fin en août. Selon la NPR, au moins 30 localités « ont soit désactivé leurs caméras Flock, soit annulé leurs contrats depuis le début de l’année 2025 ». » A Ithaca, les manifestations ont fait reculer la police. Par des pétitions, des interventions publiques et des tribunes dans la presse locale, le collectif local, Flock Off, a quelque peu freiné les activités de l’entreprise. En octobre, le bureau du shérif du comté a cessé de partager les données Flock avec les comtés collaborant avec l’ICE. En février, suite à une  manifestation devant l’hôtel de ville, la police locale a réduit le nombre de services avec lesquels elle partageait les données. « À bien des égards, cela prouve qu’au niveau local, la démocratie peut encore fonctionner », estime le responsable du groupe Flock Off local. Le prochain objectif de Flock Off est de faire résilier purement et simplement le contrat passé avec la ville.

« Si les groupes opposés à Flock émergent généralement de bastions progressistes, certains États dirigés par des républicains ont également pris des mesures pour restreindre la surveillance par ces systèmes. Les libertariens, en particulier, s’opposent à Flock : le magazine libertarien Reason a publié plusieurs articles critiquant l’entreprise, qu’il accuse de mener un programme de surveillance de masse orwellien », rapporte New Republic. 

Le New York Times s’est également intéressé à « ces caméras que la police adore et que les citoyens détestent ». Au Texas, rapportent les journalistes Fernando Alfonso III et Kashmir Hill, « il est un point sur lequel progressistes et conservateurs s’accordent : ils ne veulent pas de caméras braquées sur leurs voitures ». Pourtant, les Américains sont habitués à la vidéosurveillance. « Ils en installent sur leurs sonnettes et les acceptent au coin des rues, dans les bureaux et les restaurants ». Mais, ce qui distingue les caméras Flock, rappellent les journalistes, « c’est qu’elles sont connectées entre elles, formant un vaste réseau national interrogeable ; cette situation surprend souvent les habitants – qui ignoraient que leurs autorités locales avaient souscrit à ce service – et suscite des craintes d’une surveillance digne de « Big Brother ». De plus, il est difficile de ne plus les voir une fois qu’on a commencé à les remarquer. » Le Texas est devenu un baromètre, estiment les journalistes. « Flock a commencé à vendre ses services aux services de police début 2020, en installant quelques dizaines de caméras dans une banlieue de Houston. Six ans plus tard, 700 services de police texans ont passé contrat avec l’entreprise. L’opposition regroupe des progressistes inquiets de la surveillance gouvernementale, des conservateurs méfiants à l’égard de l’extension du pouvoir de l’État, ainsi que des citoyens et des élus soucieux de leur vie privée et préoccupés par les possibles dérives du réseau. » A l’image de Hannah Foust, qui vit à Carrollton (Texas), qui a commencé à publier des messages sur les lecteurs de plaques d’immatriculation dans des groupes Reddit et a lancé une pétition en ligne pour obtenir le retrait de ces caméras de sa commune. Devant le conseil municipal, elle explique : « Je ne commets aucun délit, mais je ne veux pas nécessairement que quiconque – et encore moins des agences gouvernementales ou une entreprise privée – puisse voir où je dépose mes enfants, quel itinéraire je privilégie pour me rendre au travail, si je préfère H-E-B ou Kroger, ou quel lieu de culte je fréquente. » À travers le Texas, l’opposition à ces caméras transcende les clivages partisans. Les contrats de Flock ont ​​été résiliés aussi bien à Austin, ville progressiste, qu’à Bandera, une localité conservatrice de la région de Hill Country comptant environ 900 habitants. « Au Congrès, Keith Self, un républicain dont la circonscription se situe au nord de Dallas, a déposé un projet de loi en juillet. Ce texte imposerait aux agences fédérales chargées de l’application de la loi d’obtenir un mandat avant d’accéder aux données collectées par les systèmes de surveillance étatiques et locaux – notamment les lecteurs de plaques d’immatriculation – ou de les interroger. » Pour un colonel de l’armée à la retraite et ancien juge de comté, « nous sommes en train de basculer vers un État de surveillance », estime-t-il, en flirtant avec des dénonciations que l’on retrouve dans les pire propos conspirationnistes d’extrême-droite, comme ceux que colporte, à longueur d’émission, la War Room de Steve Bannon.

Flock, la plateforme d’hypersurveillance des déplacements

« Flock facture environ 3 000 dollars par caméra et par an, a précisé M. Langley. En contrepartie, l’entreprise installe et entretient les caméras, fournit une base de données consultable répertoriant tous les véhicules qui passent devant elles et envoie des alertes si les caméras repèrent des voitures figurant sur une liste de surveillance prioritaire – comme la base de données du FBI recensant les véhicules volés et les plaques d’immatriculation associées à des personnes disparues ou recherchées. Ces dernières années, grâce aux progrès de l’intelligence artificielle, Flock a ajouté une fonctionnalité permettant de rechercher des voitures en fonction de leur marque, de leur type, de leur couleur ou de détails spécifiques, tels que des autocollants sur le pare-chocs ou des dommages visibles.» 

« Pour effectuer une recherche, les agents précisent le type de délit, allant de la cruauté envers les animaux à l’homicide. Ils saisissent ensuite un numéro de plaque d’immatriculation ou une description du véhicule ainsi qu’un lieu, ou optent simplement pour l’option par défaut : « Tous les réseaux sélectionnés ». La recherche affiche les images des voitures correspondantes, en indiquant précisément l’heure et le lieu où elles ont été repérées, ainsi que le service de police auquel appartenaient les caméras. Par défaut, les photos prises par les caméras sont supprimées au bout de 30 jours, bien que les services de police puissent modifier la durée de conservation.

Si un service de police souhaite accéder à d’autres caméras ailleurs dans l’État ou dans le pays, il doit partager l’accès aux siennes. La plupart des organismes effectuent des recherches et partagent des informations à l’échelle nationale. » 

L’éditorialiste et animateur de télévision de droite radicale américain Tucker Carlson, qui pourrait être candidat à la prochaine élection présidentielle américaine, s’est récemment moqué de l’assimilation faite par M. Langley entre un projet de cartographie participative et le terrorisme. Carlson a déclaré n’avoir pris conscience que récemment de l’ampleur du réseau Flock après avoir consulté le site de DeFlock ; il a confié au New York Times que cette découverte l’avait « horrifié ». Il s’est dit surpris qu’un système de surveillance aussi vaste ait pu se développer en suscitant si peu d’attention de la part du public… Tant et si bien que le PDG de Flock a depuis présenté ses excuses pour ses propos assimilant le site DeFlock au terrorisme. 

« Que l’on soit libertarien, conservateur, partisan du mouvement MAGA ou progressiste, tout le monde a des objections à l’encontre de Flock », a déclaré Chad Marlow de l’ACLU. Reste que si l’opposition au Texas attire peut-être l’attention, elle n’a pas freiné la croissance de Flock. À travers l’État, de nouvelles villes signent des contrats plus rapidement que d’autres ne les résilient, a indiqué Jennifer Szimanski, porte-parole de la Combined Law Enforcement Associations of Texas, un syndicat de police représentant plus de 28 000 agents. Selon elle, la raison repose sur les résultats impressionnants du réseau. Certains services de police texans ont retrouvé des centaines de véhicules volés après avoir installé ces caméras, a-t-elle précisé, et dans les petites municipalités, les vols dans les véhicules ont pratiquement cessé. Pour elle, le risque d’utilisation abusive du système par les policiers texans n’était pas plus élevé qu’avec les autres bases de données auxquelles ils ont accès, et que Flock fournissait un historique de chaque recherche, précisant qui l’avait effectuée et pour quel motif.

La possibilité de rechercher n’importe quel véhicule circulant sur les routes du pays est certes pratique pour les autorités, mais Barry Friedman, professeur de droit et directeur du Policing Project, soutient que la création d’une vaste base de données sur les déplacements des Américains est inconstitutionnelle : « il s’agit d’une collecte de données indiscriminée, et non d’une surveillance ciblant des infractions spécifiques ». « Si le quatrième amendement existe, c’est parce que l’on estimait que le gouvernement ne devrait pas pouvoir s’en prendre à n’importe qui, même en l’absence de tout acte répréhensible. » 

Jusqu’à présent, les tribunaux ont rejeté cette interprétation, tout en laissant entendre que la situation pourrait évoluer à mesure que la technologie se généralise. Dans une affaire où des habitants avaient poursuivi la ville de Norfolk (Virginie) pour l’installation de 172 caméras Flock, un juge fédéral a statué que les lecteurs de plaques pourraient un jour devenir si omniprésents que leur utilisation s’apparenterait à une surveillance de masse indiscriminée et inconstitutionnelle, mais que ce n’était pas encore le cas. « Je ne pense pas que les juges réalisent que le pays est désormais couvert par ces dispositifs et qu’ils sont tous interconnectés », a déclaré Sid Thaxter, de l’Association nationale des avocats de la défense pénale.

En attendant, la police américaine invite les agents à ne plus mentionner le fait qu’ils ont eu recours à une technologie de détection automatique des numéros de plaques d’immatriculations dans leur rapports ou auprès des personnes qu’ils appréhendent, rapporte 404media. « Lorsque les forces de l’ordre utilisent Flock pour procéder à une arrestation dans le comté de Wapello, en Iowa, elles ne souhaitent pas que la personne concernée le sache. Une politique d’utilisation des caméras de lecture automatique de plaques du comté ordonne explicitement à la police de garder ce dispositif secret. » Un moyen de rendre encore plus invisible les abus que Flock annonce vouloir limiter. 

Pour Tech Policy Press, Jake Laperruque responsable du projet « Sécurité et surveillance » au sein du Center for Democracy & Technology (CDT), « les systèmes de lecture automatisée de plaques d’immatriculation en général, et le fournisseur de premier plan Flock en particulier, sont confrontés à un moment de prise de conscience publique aux États-Unis. Cette technologie de surveillance provoque des réactions négatives majeures dans tout le pays et devient un sujet de campagne majeur ». Mais pour Laperruque, les risques actuels liés à la vie privée liés aux systèmes de détection des plaques d’immatriculation ne sont que la pointe de l’iceberg et vont s’étendre considérablement dans les années à venir. « À moins qu’ils ne soient sérieusement maîtrisés, ces systèmes deviendront un outil de surveillance de masse bien plus répandu qu’aujourd’hui ». La raison, notamment : de nouvelles fonctionnalités ajoutées à Flock à partir d’analyses automatisées par l’agence fédérale des douanes créant des alertes sur des comportements de conduite suspects et signalant des véhicules à arrêter, rapporte AP News. Un comportement innocent au volant, comme prendre une route secondaire, conduire à des heures indues ou se rendre dans un endroit inhabituel, pourrait devenir des motifs de contrôle. 404 media a révélé également que les vidéos captées par les caméras étaient utilisées pour identifier des formes ou des conducteurs. Une fonctionnalité de recherche en texte libre permet de trouver des personnes tatouées ou portant des maillots de sport spécifiques ; ces recherches incluent parfois l’origine ethnique de la personne visée. A terme, connectée à la reconnaissance faciale, elle pourrait permettre de rechercher des personnes partout sur les routes. « Ces systèmes risquent fort de se transformer en un « œil omniscient » permettant de rechercher n’importe quel type de véhicule, d’objet ou de personne, avec la même facilité que nous recherchons aujourd’hui des mots dans un fichier texte ». Reste à savoir s’il faut limiter ce pouvoir par une accréditation judiciaire pour chercher dans ces images, comme le propose Laperruque ou limiter le développement du réseau. 

Wired rappelle que Flock Safety, géant de la surveillance des véhicules, affirme depuis des années que sa technologie « ne peut ni reconnaître, ni identifier, ni suivre des individus ». Ses pages dédiées à la confiance du public assurent aux clients que la technologie est conçue pour des enquêtes spécifiques, au cas par cas, et « non pour surveiller les gens ». Ce n’est plus le cas, notamment via l’ajout d’innombrables outils qui donnent accès « aux métadonnées des caméras, aux dossiers d’arrestation, aux dossiers d’enquête, aux journaux d’appels, aux résultats d’analyses balistiques ainsi qu’à des bases de données commerciales contenant des numéros de sécurité sociale, dates de naissance, numéros de téléphone, adresses e-mail, informations sur les proches et les associés ». Les requêtes préconfigurées d’OS Investigate, le logiciel de Flock, inversent la logique de recherche. « Un agent n’a plus besoin de plaque, de nom ou d’infraction pour lancer une recherche : il lui suffit d’indiquer un lieu, une période et un schéma comportemental, et le système identifie les personnes correspondant à ces critères. » Pour utiliser ce moteur de recherche, Flock propose des requêtes préconfigurées, comme «« Trouve-moi des témoins en te basant sur les véhicules les plus aperçus dans [tel quartier] au cours des [X derniers jours] durant [telle plage horaire quotidienne] ». Un agent remplit les champs vides et valide la demande. Le résultat est une liste de plaques d’immatriculation que d’autres outils du logiciel convertissent ensuite en noms et adresses de domicile.»

« Dix-neuf de ces requêtes visent à identifier des schémas comportementaux plutôt qu’à consulter un dossier spécifique. Quatorze d’entre elles ne nécessitent ni plaque d’immatriculation, ni nom, ni description physique ; l’agent indique simplement un lieu, un créneau horaire et un comportement.

Certaines requêtes ciblent des véhicules ayant visité au moins trois commerces dans une ville en trois jours, plusieurs banques en une semaine ou plusieurs stations-service entre minuit et 5 heures du matin. Aucune de ces cinq requêtes ne mentionne de cible ou d’incident précis.

L’outil utilisé pour ces recherches intègre un filtre qui exclut les bus, les semi-remorques, les fourgonnettes utilitaires et les remorques ; ainsi, un livreur visitant cinq magasins est retiré de la liste, tandis qu’un conducteur ordinaire effectuant la même tournée y figure toujours. Ce type de recherche s’applique également aux déplacements interurbains : véhicules ayant quitté une ville pour une autre avant d’y revenir dans la semaine, ayant effectué plusieurs allers-retours sur une période de 14 jours ou ayant traversé trois zones successivement.»

Flock se défend en expliquant que ce produit en cours de développement ne proposera pas à terme toutes ces fonctionnalités lors de son lancement commercial. Pour Jay Stanley de l’ACLU : « Nous assistons à un déploiement agressif de l’IA par Flock ; on observe, à certains égards, une frontière très mince entre ce qui est techniquement possible et ce qui est réellement mis en œuvre. » Pour Chad Marlow, avocat à la tête de la campagne « Get The Flock Out » de l’ACLU, le danger est de passer de : « Voyez-vous des schémas criminels ? à Trouvez-moi des schémas criminels, car ces requêtes donneront des résultats différents ». Le risque est de glisser très vite au moment où un agent demandera à une IA quelles personnes elle considère comme les plus susceptibles de commettre des crimes. « Elle ne se fondera pas sur une norme juridique de suspicion criminelle, mais sur ses propres critères internes. » Le code définit déjà les filtres auxquels la requête sera soumise. Le logiciel de Flock associe des recherches de véhicules à des interrogations de fichiers de police classant les individus selon le sexe, la race, l’origine ethnique, la taille, le poids, la corpulence, ainsi que la présence de cicatrices, de marques distinctives et de tatouages. Une fonction permet d’effectuer une recherche uniquement à partir d’une description, en ciblant des enregistrements correspondant à des critères tels que « homme, environ 1,80 m, sweat à capuche noir, tatouage sur l’avant-bras » à proximité d’un lieu donné. L’outil permet à l’agent de délimiter ces critères en choisissant un rayon d’action ou en dessinant des formes libres sur une carte. Selon Stanley, cette pratique s’apparente étroitement à la question examinée par la Cour suprême des États-Unis en juin dernier : la Cour a alors statué que les individus conservent un droit à la vie privée concernant les données retraçant leurs déplacements et que le quatrième amendement s’applique lorsque la police réclame ces informations à une entreprise. Dans le cas présent, les services de police achètent directement cette capacité technologique, ouvrant la voie à des recherches exploratoires (fishing expeditions) d’une ampleur inédite.

L’année dernière, un policier du Texas a effectué des recherches sur plus de 83 000 caméras à travers le pays pour retrouver une femme ayant pratiqué un avortement elle-même, selon des journaux de recherche obtenus initialement par 404 Media. Une enquête récente du Washington Post a révélé qu’une cinquantaine d’agents de police avaient été inculpés ou accusés d’usage abusif des systèmes de lecture de plaques d’immatriculation : 26 d’entre eux les utilisaient pour surveiller leur épouse, leur petite amie, leur ex-compagne ou des femmes qu’ils souhaitaient rencontrer. En août dernier, les autorités de régulation de l’Illinois ont conclu que Flock avait enfreint la loi de l’État en menant un programme pilote – aujourd’hui suspendu – qui donnait au service des douanes et de la protection des frontières accès aux caméras situées dans l’État.

Flock laisse à ses clients le soin de définir la plupart des règles. Les responsables des services décident qui obtient des identifiants, si les données des caméras doivent être partagées au-delà des limites de la ville ou de l’État, et s’il convient d’activer les paramètres proposés par l’entreprise pour prévenir les abus. L’outil d’audit, conçu pour repérer les schémas suspects dans les recherches effectuées par un service, a été lancé en avril 2026 en tant qu’option activable par les forces de l’ordre. Or, selon le Washington Post, de nombreux services de police ont jusqu’à présent peu surveillé les recherches qu’accomplissent leurs agents sur ces systèmes.

L’Electronic Frontier Foundation a examiné des ensembles de données portant sur plus de 12 millions de recherches enregistrées sur une période de 10 mois ; elle a constaté qu’environ 20 % d’entre elles ne mentionnaient qu’un terme vague tel que « enquête », « suspect » ou « requête ». Plus de 50 services ont effectué des centaines de recherches dont le champ « motif » faisait référence à des manifestations.

Comment réguler le changement de nature de la surveillance ?

« Flock ambitionne bien au-delà de la simple lecture automatique des plaques d’immatriculation ; l’objectif est de devenir une plateforme numérique pour le maintien de l’ordre », explique Bob Ferguson, gouverneur de Washington, à l’origine d’une proposition de loi pour réguler le déploiement des caméras. « Nous sommes à l’aube de l’ère de la police automatisée et la capacité à créer des chatbots en langage naturel capables d’effectuer des recherches dans d’immenses bases de données deviendra bientôt la norme. »

Pour Jason Pye, du Due Process Institute, il y a peu de preuves que ces technologies contribuent à faire baisser la criminalité. Il rappelle que, contrairement à ce qu’affirme l’administration Trump, la criminalité violente américaine est en baisse depuis les années 90 (758,2 crimes pour 100 000 habitants en 1991 contre 348,6 en 2024). La raison de cette baisse n’est pas unique, elle n’est pas liée uniquement à l’augmentation de l’incarcération (qui s’est stabilisée dans les années 2000 alors que la criminalité a continué à chuter), mais également à l’amélioration des perspectives économiques, aux mutations des marchés de la drogue, voire même au vieillissement de la population. Si des études montrent que les LAPI peuvent aider la police à identifier des véhicules volés, à générer des pistes d’enquête et, parfois, à élucider des crimes. Établir qu’ils jouent un rôle significatif dans la baisse de la criminalité observée après 2020 est une tout autre affaire, bien plus complexe à démontrer. 

Et Pye de citer deux études portant sur l’effet des LAPI : la première note que le déploiement à Atlantic City est associé à une baisse des fusillades, des vols de véhicules et des atteintes aux bien, mais sans reconnaître que le déploiement des caméras puisse être le seul facteur explicatif. La seconde passe en revue l’ensemble des recherches sur le sujet et montre que les preuves que ces systèmes génèrent des avantages plus larges en matière de lutte contre la criminalité restent mitigées. Pye observe ensuite Atlanta, qui compte plus de 3000 systèmes Flock. Or, malgré ce réseau de surveillance sans précédent, les taux d’élucidation des crimes ne se sont pas améliorés. « Par exemple, une arrestation a eu lieu dans 54,3 % des cas d’homicide en 2021. En 2025, seuls 48 % des homicides ont été élucidés. Il existe toutefois des catégories de crimes pour lesquelles les taux d’élucidation se sont améliorés, notamment les cambriolages et les vols dans des véhicules. » De plus, malgré l’un des plus importants réseaux de surveillance des Etats-Unis, le taux de crimes violents à Atlanta a augmenté entre 2024 et 2025 (mais a beaucoup diminué, elle aussi, depuis au moins 2011). Cela ne signifie pas que les LAPI n’apportent rien à la sécurité publique, estime Pye. Ils peuvent être efficaces pour certaines tâches ou certains crimes, mais cela ne signifie pas qu’ils soient à l’origine de la baisse de la criminalité aux Etats-Unis. Et quand bien même ce serait le cas, la question de savoir quel niveau de surveillance l’Amérique est-elle prête à accepter en contrepartie de sa sécurité reste entière, estime Pye. Qui rappelle qu’avec ces systèmes, « il n’est pas nécessaire d’être soupçonné d’un crime pour que les autorités disposent potentiellement d’un relevé indiquant que votre voiture se trouvait à proximité d’une manifestation politique, d’une église, d’une armurerie, d’une clinique médicale ou du domicile d’un tiers. Il s’agit d’une forme de surveillance fondamentalement différente de celle d’un policier vérifiant ponctuellement une plaque d’immatriculation sur l’autoroute ». Le problème, c’est bien le caractère amplificateur de la surveillance que produit la mise en réseau des caméras et la possibilité de les interroger. « Cette situation soulève des questions quant aux personnes habilitées à consulter ces données, aux justifications requises pour effectuer une recherche, à l’étendue du partage de l’information, à la durée de conservation des données et aux conséquences d’une utilisation abusive du système – une éventualité inévitable. Ces questions ne disparaissent pas pour autant du simple fait que les systèmes de lecture automatique de plaques d’immatriculation aident parfois la police à élucider des crimes. » Reste que c’est « une chose qu’un agent de police voit votre voiture traverser un carrefour. C’est tout autre chose qu’un réseau de caméras enregistre discrètement chaque apparition de votre véhicule, stocke ces informations et les rend consultables dans le temps et entre différentes juridictions ». « La question est de savoir si le gouvernement devrait pouvoir exploiter des millions, voire des milliards, d’observations publiques ordinaires et légales pour en faire une carte détaillée et consultable des déplacements des personnes, sans aucun soupçon individualisé ni contrôle significatif ». 

« Supposons que des preuves plus solides finissent par démontrer que Flock prévient certains crimes. Je resterais néanmoins mal à l’aise avec ce compromis. La sécurité publique est importante, certes, mais ce n’est pas le seul critère essentiel dans une société libre. Le respect de la vie privée et l’autonomie sont tout aussi importants. Pouvoir vaquer à ses occupations quotidiennes sans que le gouvernement n’enregistre discrètement ses déplacements est fondamental. Les caméras de Flock ne se limitent pas aux personnes soupçonnées d’avoir commis des crimes. Elles collectent des informations sur tous les automobilistes qui passent devant elles, dont l’immense majorité n’a absolument rien fait de mal.

Bien sûr, ces informations peuvent être utiles à la police. C’est précisément ce qui rend la question si complexe. Presque n’importe quel système de surveillance peut améliorer la sécurité publique s’il fournit au gouvernement davantage d’informations sur nous. Installez suffisamment de caméras à des endroits stratégiques, conservez suffisamment de données et donnez-y accès à un nombre suffisant d’agences : tôt ou tard, ces informations contribueront à résoudre des crimes. L’argument selon lequel « le gouvernement pourrait trouver cela utile un jour » est un critère inacceptable pour déterminer le niveau de surveillance que les Américains sont prêts à tolérer. » Pour Pye, la surveillance omniprésente ne devrait pas devenir une composante normale de la vie américaine. 

Pour The Conversation, le philosophe et criminologue de l’Institut catholique de Lille, Tony Ferri, rappelait que c’est la nature des systèmes de surveillance, quels qu’ils soient, de s’étendre (même si dans son article, il n’évoque pas les dispositifs de lecture automatisés des plaques d’immatriculation). « Un dispositif de contrôle naît pour une cible précise, dans un contexte qui rend son acceptation facile » (…) « puis, par la force de son infrastructure technique désormais disponible, il s’étend, se prolonge, se banalise, bien au-delà de sa justification initiale ». Pris isolément, ces solutions peuvent paraître légitimes. Mais, comme le disait la CNIL elle-même dans un avis de 2022 : « ces outils ne constituent pas une simple évolution technologique, mais une modification de la nature des dispositifs ». Un changement de nature et pas seulement de degré, face auquel nous avons pour l’instant bien peu de réponses pour en limiter la déflagration à l’encontre des libertés publiques.

Ah, oui, les systèmes LAPI se déploient également en France, même si pour l’instant, ce n’est pas avec la même intensité qu’aux Etats-Unis (on compterait 700 lecteurs en France mis en œuvre par la police nationale, la gendarmerie et les douanes, sans compter ceux des municipalités et des acteurs privés, comme les opérateurs de parkings et d’autoroute). Depuis 2024, un système de traitement central a été mis en place. En 2026, le récent projet de loi RIPOST renforce leur utilisation (par exemple à des fins administratives sans avoir à justifier d’une enquête spécifique), étend le régime d’infraction permettant leur consultation ainsi que la durée de conservation des informations à un an, comme s’en inquiétait, bien légitimement, la Quadrature du Net. La plateforme d’hypersurveillance des déplacements se porte bien chez nous aussi !

Hubert Guillaud

  • ✇C'est pas mon idée !
  • Démocratiser la gestion de patrimoine avec l'IA
    Rêve ancien mais, hélas, jamais concrétisé, la gestion de patrimoine pour tous semble aujourd'hui réveiller les appétits, à l'aune des promesses de l'intelligence artificielle. Le géant américain Vanguard annonce ainsi l'acquisition d'Altruist, en espérant que sa plate-forme aide les conseillers spécialisés à démultiplier leur force de frappe.Avec les générations successives de « robots-conseillers », la première vague de démocratisation du secteur vise, depuis une quinzaine d'années, à propose

Démocratiser la gestion de patrimoine avec l'IA

Par : Patrice
27 août 2026 à 21:30
Vanguard
Rêve ancien mais, hélas, jamais concrétisé, la gestion de patrimoine pour tous semble aujourd'hui réveiller les appétits, à l'aune des promesses de l'intelligence artificielle. Le géant américain Vanguard annonce ainsi l'acquisition d'Altruist, en espérant que sa plate-forme aide les conseillers spécialisés à démultiplier leur force de frappe.

Avec les générations successives de « robots-conseillers », la première vague de démocratisation du secteur vise, depuis une quinzaine d'années, à proposer une alternative aux personnes ne disposant pas des moyens de bénéficier des services d'un professionnel. L'absence d'une dimension d'accompagnement de proximité dans ces outils les a malheureusement relégués à un rôle de plate-forme d'investissement certes accessible, mais avec laquelle le client est largement laissé seul devant ses choix.

La vision cible a maintenant changé, y compris chez les trublions d'autrefois, qui, pour les plus évolués, ont mis en place des modèles de conseil humain pour les utilisateurs « haut de gamme ». L'objectif privilégié consiste désormais à rendre ces approches plus efficaces, de manière à en abaisser les coûts et parvenir de la sorte à les ouvrir à une population plus large… qui ne pourra cependant englober l'immense majorité des ménages, modestes, voués, pour l'instant (à jamais ?), à rester à l'écart de la tendance.

Altruist se positionne clairement sur ce créneau, avec une solution propulsée à l'IA pour l'optimisation des processus administratifs qui consomment tellement de temps et d'énergie chez les conseillers, qu'ils préfèreraient consacrer à aider plus d'individus dans le pilotage de leur argent : ouvertures de compte (et les contraintes, notamment réglementaires, associées), suivi des portefeuilles et rapports contextualisés (incluant aussi un portail dédié pour les clients), pilotage des opérations, facturation…

Vanguard x Altruist

Le domaine de la gestion de patrimoine est historiquement en retard dans sa transformation « digitale » et cette situation crée une opportunité pour des jeunes pousses qui voient dans l'intelligence artificielle un moyen de combler le déficit (en France, Patrimind, dont je parlais récemment en fournit un autre exemple). En revanche, leurs offres adressent en priorité des enjeux de productivité dans les métiers existants plutôt que d'envisager une modernisation pourtant nécessaire de l'expérience client.

Je reste toutefois optimiste pour l'avenir, même si celui ci semble encore lointain, car, comme je le remarquais dans un article précédent, je pense que les acteurs qui commencent à convaincre la profession de recourir à l'IA dans leur quotidien – et l'irruption de Vanguard dans la bataille devrait accélérer le mouvement – prendront certainement conscience, avec leurs clients, des possibilités d'étendre progressivement leur périmètre d'intervention, en particulier en permettant à leurs outils d'offrir les niveaux de conseil primaires qui font aussi partie du train-train des spécialistes et peuvent couvrir une part importante des besoins des moins fortunés.

  • ✇C'est pas mon idée !
  • Un assistant IA pour la gestion de patrimoine
    Conçue et développée par un conseiller en gestion de patrimoine en activité et un spécialiste de l'intelligence artificielle, Patrimind est une solution qui vise d'abord à soulager les professionnels du domaine de leurs tâches administratives, mais qui peut également les aider à mieux accompagner leurs clients, notamment les plus modestes.Dans son rôle primaire d'assistante technique, le premier volet de l'expertise de cette IA sectorielle porte sur l'acquisition et la restitution d'information

Un assistant IA pour la gestion de patrimoine

Par : Patrice
14 août 2026 à 21:50
Intellectuality
Conçue et développée par un conseiller en gestion de patrimoine en activité et un spécialiste de l'intelligence artificielle, Patrimind est une solution qui vise d'abord à soulager les professionnels du domaine de leurs tâches administratives, mais qui peut également les aider à mieux accompagner leurs clients, notamment les plus modestes.

Dans son rôle primaire d'assistante technique, le premier volet de l'expertise de cette IA sectorielle porte sur l'acquisition et la restitution d'information. Pour ce faire, la plate-forme ingurgite différents types de sources (documents d'identité, justificatifs fiscaux, échanges informels…), sous de multiples formats (fichiers PDF, feuilles de calcul, courriels…),  et en extrait les données importantes pour, par exemple, l'analyse initiale du dossier d'un prospect ou la préparation d'une proposition de plan d'investissement.

Outre un tableau de bord récapitulatif du client, l'utilisateur a la possibilité d'interroger, par tchat, le corpus ainsi constitué, de manière à retrouver en un tournemain une information utile sans avoir à explorer les pièces accumulées. Et, parce que le métier de la gestion de patrimoine ne souffre aucune approximation et que règne, à juste titre, une certaine méfiance vis-à-vis des hallucinations de l'IA, les réponses apportées à chaque question sont assorties d'une référence précise et vérifiable à leur origine.

Selon sa complétude, la connaissance engrangée de la sorte est ensuite disponible pour diverses analyses – bilans, audits, études de conformité… – qui pourront aussi déboucher sur des suggestions opérationnelles, spontanées ou stimulées (par une demande explicite). Comme tout ce que produit l'outil, les éléments de raisonnement mis en œuvre dans ce contexte sont toujours fournis avec leur provenance officielle, entre autres les textes juridiques pertinents, afin d'asseoir la légitimité des recommandations.

Patrimind

À partir des propositions retenues, émanant de l'IA ou élaborées à l'instigation du professionnel, la solution est alors en mesure de dérouler des scénarios de bout en bout, basés sur les données réelles, afin d'en évaluer la valeur et/ou de constituer un argumentaire à partager avec le client. Enfin, lors du passage à l'action, elle va extraire de ses registres et transmettre automatiquement les données nécessaires à la souscription de produits (pour les procédures de KYC et anti-fraude, en particulier).

Clairement et sans ambiguïté possible, l'objectif de Patrimind consiste bien à libérer du temps pour le conseiller, qu'il va pouvoir consacrer à son véritable savoir-faire, au service de ses clients. Cependant, les préconisations que commence à inclure son outil laissent également entrevoir une autre opportunité, de démocratisation de la gestion de fortune. En effet, l'intelligence artificielle pourrait assumer une part autonome plus ou moins importante et plus ou moins standardisée de l'accompagnement – sous contrôle d'un expert humain, par sécurité – selon le niveau de patrimoine de l'intéressé.

  • ✇C'est pas mon idée !
  • Pas de résilience sans recensement des logiciels
    Parce qu'ils sont aujourd'hui au cœur de toutes les activités, les logiciels sont devenus une des principales sources de menace pour la résilience des économies et des états. Pourtant, l'évolution des pratiques au fil des ans rend leur maîtrise de plus en plus difficile. Les agences de cybersécurité du monde entier, CISA américaine en tête, souhaitent donc imposer des contraintes de transparence radicales.Elle est bien loin l'époque où chaque organisation – utilisatrice finale ou éditrice – con

Pas de résilience sans recensement des logiciels

Par : Patrice
12 août 2026 à 18:30
CISA
Parce qu'ils sont aujourd'hui au cœur de toutes les activités, les logiciels sont devenus une des principales sources de menace pour la résilience des économies et des états. Pourtant, l'évolution des pratiques au fil des ans rend leur maîtrise de plus en plus difficile. Les agences de cybersécurité du monde entier, CISA américaine en tête, souhaitent donc imposer des contraintes de transparence radicales.

Elle est bien loin l'époque où chaque organisation – utilisatrice finale ou éditrice – concevait et bâtissait ses propres applications de A à Z, maîtrisant de fait sa chaîne de développement de bout en bout. De nos jours, et la prolifération des assistants de codage à base d'intelligence artificielle ne va faire que renforcer la tendance, les logiciels sont constitués d'un assemblage d'une myriade de composants externes – souvent sous licence libre – complétés d'une couche spécifique, plus ou moins élaborée.

En parallèle, une nouvelle forme de criminalité s'est développée qui consiste à introduire discrètement des opérations malveillantes au cœur des éléments les plus fréquemment mis à contribution par ces entreprises, ce qui expose alors quasi automatiquement leurs produits à des attaques redoutables. Par ailleurs et plus banalement, ces mêmes modules sont également sujets à des erreurs et anomalies qui, elles aussi, engendrent des risques de dysfonctionnement et autres failles de sécurité.

Ces méthodes de combinaison de logiciels (ou de parties de logiciels) sont désormais tellement répandues, avec des degrés d'imbrication inextricables, que, en l'absence d'une information claire et exhaustive, un responsable se trouve dans l'impossibilité de savoir ce que les applications qu'il déploie embarquent réellement, ni les menaces qu'elles provoquent. Voilà pourquoi les autorités compétentes demandent dorénavant aux fournisseurs d'inventorier en détails la composition de ce qu'ils distribuent.

La démarche semble parfaitement naturelle… mais elle risque de se heurter à un sérieux problème : selon certains experts, de nombreux acteurs spécialisés, surtout parmi les plus importants, seront incapables de respecter les exigences, notamment en raison des limitations de leur outillage en la matière. Que feront-ils lorsque leurs clients – et les institutions financières, particulièrement sensibles, devraient en être pionnières – leur transmettront la dite liste à remplir lors de leurs appels d'offres ?

Dans tous les cas, selon toute probabilité, les réglementations en matière de résilience, à l'instar de DORA pour le secteur financier européen, incluront à court ou moyen terme des obligations de cet ordre et leurs partenaires technologiques devront y répondre. Cependant, une fois la transparence établie et la connaissance du patrimoine informatique ainsi approfondie, il faudra ensuite la mettre à profit, en priorité afin de corriger au plus tôt les vulnérabilités identifiées. Dans ce domaine également, les outils de support sont pour l'instant immatures et devront progresser rapidement.

Puzzle

  • ✇C'est pas mon idée !
  • L'IA de l'ombre devient impossible à stopper
    Alors que Google déploie depuis peu en France l'« Aperçu IA » au sein de son moteur de recherche, un article d'ITRmanager me procure une occasion de prendre un peu de recul sur les stratégies de protection mises en place dans les entreprises afin d'éviter les fuites de données et autres risques de sécurité engendrés par l'intelligence artificielle.Après le lancement de ChatGPT puis des autres plates-formes d'intelligence artificielle générative destinées au grand public, les responsables inform

L'IA de l'ombre devient impossible à stopper

Par : Patrice
6 août 2026 à 22:00
AI
Alors que Google déploie depuis peu en France l'« Aperçu IA » au sein de son moteur de recherche, un article d'ITRmanager me procure une occasion de prendre un peu de recul sur les stratégies de protection mises en place dans les entreprises afin d'éviter les fuites de données et autres risques de sécurité engendrés par l'intelligence artificielle.

Après le lancement de ChatGPT puis des autres plates-formes d'intelligence artificielle générative destinées au grand public, les responsables informatiques des grands groupes, notamment du secteur financier, particulièrement sensibles, ont rapidement commencé à instaurer des blocages en vue d'interdire leur accès aux collaborateurs, par crainte (souvent justifiée) de divulgation de données confidentielles lors de leur utilisation ou de confiance excessive accordée aux résultats qu'elles produisent.

Naturellement, il n'était rien de plus simple jusqu'à présent que de créer des règles de filtrage sur les réseaux internes verrouillant toute tentative de consultation des sites bien connus, comme il en existe depuis très longtemps pour d'autres catégories de services en ligne (par exemple de divertissement). Hélas, l'initiative de Google vient rappeler aux gardiens du temple que l'IA n'existe déjà plus seulement sous la forme d'outils indépendants, faciles à identifier, mais que, de plus en plus, elle va s'infiltrer partout.

Avec la dernière version en date de son moteur de recherche, ce que redoutait les spécialistes de la sécurité fait désormais partie intégrante d'une des fonctions les plus utilisées d'internet. Tout en continuant à pouvoir l'exploiter comme ils l'ont toujours fait, avec une requête à base de mots-clés, ils ont maintenant aussi la possibilité d'exécuter des demandes complexes, partager le contexte de leur navigation, copier-coller des informations de leur poste de travail… pour obtenir des réponses élaborées.

Sauf à mettre entièrement Google (et ses pairs suivant la même évolution) sur liste noire, il est difficile d'empêcher les employés de profiter de cet ajout pour contourner les contraintes qui leur ont été imposées auparavant. Outre le renforcement nécessaire des messages pédagogiques sur les dangers de l'IA et les précautions plus ou moins élémentaires à prendre dans sa prise en main, l'auteur de l'article en référence propose sa propre solution, fournissant essentiellement un audit des requêtes effectuées.

Mais ce ne peut être qu'une réponse temporaire car, bientôt, l'intelligence artificielle sera intégrée dans tous les recoins du web et les risques associés seront alors omniprésents, à des degrés variables. Plus que jamais, l'éducation du personnel aux « bons » usages (y compris dans le registre éthique, incidemment), la sensibilisation récurrente aux principes de sécurité…, et le recours à des solutions de surveillance intelligentes à portée très large deviennent primordiales dans les organisations.

Shadow AI

  • ✇Méta-media | La révolution de l'information
  • Liens vagabonds : La détection d’IA, un gagne-pain juteux ?
    La guerre de l’anti-slop est arrivée et l’authenticité devient un produit de luxe. Après son partenariat avec Substack pour reconnaître l’humain de la machine, la start-up américaine Pangram lève cette semaine 9 millions de dollars auprès d’importants capitaux américains. Dans sa croisade contre la bouillie IA, la société dévoile un nouveau détecteur d’images et promet […] The post Liens vagabonds : La détection d’IA, un gagne-pain juteux ? first appeared on Méta-media | La révolution de l'infor

Liens vagabonds : La détection d’IA, un gagne-pain juteux ?

La guerre de l’anti-slop est arrivée et l’authenticité devient un produit de luxe. Après son partenariat avec Substack pour reconnaître l’humain de la machine, la start-up américaine Pangram lève cette semaine 9 millions de dollars auprès d’importants capitaux américains. Dans sa croisade contre la bouillie IA, la société dévoile un nouveau détecteur d’images et promet […]

The post Liens vagabonds : La détection d’IA, un gagne-pain juteux ? first appeared on Méta-media | La révolution de l'information.

  • ✇C'est pas mon idée !
  • L'IA commence à remplacer les débutants
    Dans les entreprises du secteur tertiaire, l'intelligence artificielle s'avère bien adaptée à l'exécution des tâches historiquement réservées aux employés inexpérimentés et l'impact sur les recrutements commence à s'en ressentir. Alors Gartner s'interroge sur les moyens d'adapter les pipelines traditionnels de formation des débutants ainsi menacés.Alors que l'adoption massive de l'IA ne produit encore que rarement des résultats probants – seulement un cinquième des 95% organisations concernées

L'IA commence à remplacer les débutants

Par : Patrice
1 août 2026 à 18:30
Gartner
Dans les entreprises du secteur tertiaire, l'intelligence artificielle s'avère bien adaptée à l'exécution des tâches historiquement réservées aux employés inexpérimentés et l'impact sur les recrutements commence à s'en ressentir. Alors Gartner s'interroge sur les moyens d'adapter les pipelines traditionnels de formation des débutants ainsi menacés.

Alors que l'adoption massive de l'IA ne produit encore que rarement des résultats probants – seulement un cinquième des 95% organisations concernées déclarent en avoir tiré une valeur significative –, 22% des responsables de ressources humaines interrogés au cours du dernier trimestre de 2025 confirment que, dans au moins un département, les embauches de personnel pour les positions juniors ont déjà été totalement interrompues en raison des initiatives d'automatisation engagées.

Le raisonnement est trivial. Les parcours d'apprentissage des nouveaux arrivants, notamment dans les métiers intellectuels, passent par la réalisation des opérations simples et répétitives préparatoires à la mise en œuvre de l'expertise de leurs aînés. Or leur nature rend ces tâches propices à leur prise en charge par l'intelligence artificielle. Hélas, comme je l'ai souligné par le passé, comment les experts de demain apprendront-ils s'ils n'ont plus de place dans l'entreprise au début de leur carrière ?

Au mieux, et dans un premier temps, les firmes devront faire appel à des compétences externes, plus onéreuses et plus volatiles, afin de compenser la disparition de leur vivier de talents cultivé en interne. Au pire, et, à défaut de changement de méthode, de manière inévitable, elles ne trouveront plus les individus correctement formés dont elles ont besoin… et rien ne garantit (heureusement ?) que, à ce moment de rupture, l'IA aura atteint une maturité suffisante pour assumer les rôles correspondants.

Gartner HR

Concrètement, les directions de ressources humaines n'ont donc guère d'autre choix que d'entamer une transformation profonde des pratiques en vigueur vis-à-vis des débutants. Les analystes de Gartner leur proposent trois approches possibles, qu'il faudra certainement combiner pour un maximum d'efficacité (et un minimum de perturbations dans la vie de l'entreprise), en prenant en compte simultanément l'évolution à long terme des compétences requises à l'ère de l'intelligence artificielle.

La priorité portera d'abord sur l'identification des fonctions que les jeunes recrues sont à même d'assumer une fois que celles qui leur étaient dévolues jusqu'à présent sont assignées à l'IA. Il s'agira fréquemment d'interagir avec cette dernière au service de capacités critiques. Le déficit de formation, qui ne sera pas comblé de la sorte, imposera ensuite de développer des méthodes d'apprentissage dédiées. Enfin, l'ensemble devra être entouré d'un filet de sécurité, constitué d'outils, d'accompagnement et de réseautage, de manière à limiter les risques d'erreur durant ces phases initiales.

Nombre d'organisations s'emparent des promesses de l'intelligence artificielle sans prendre le moindre recul et, outre qu'elles oublient de définir les critères objectifs et mesurables de succès, ne considèrent pas toujours les conséquences de leurs choix à des échéances lointaines. Les impacts considérables de la technologie, sur toutes les dimensions de leur fonctionnement, dont la gestion des effectifs et des talents, rendent pourtant absolument indispensable de l'intégrer dans une perspective stratégique.

  • ✇C'est pas mon idée !
  • Petit rappel aux amateurs d'IA agentique
    Les institutions financières se sont à peine emparées de l'intelligence artificielle générative, voilà qu'elles se mettent toutes à rêver d'agents capables d'assister leurs clients ou, plus souvent, leurs collaborateurs dans leurs tâches. Hélas, elles n'ont pas toujours pleinement conscience de leurs pré-requis sensiblement différents. David Mooter, pour Forrester, juge donc utile de rappeler quelques évidences.Dans la plupart des organisations, l'évolution s'est déroulée progressivement, de l'

Petit rappel aux amateurs d'IA agentique

Par : Patrice
25 juillet 2026 à 18:00
Forrester
Les institutions financières se sont à peine emparées de l'intelligence artificielle générative, voilà qu'elles se mettent toutes à rêver d'agents capables d'assister leurs clients ou, plus souvent, leurs collaborateurs dans leurs tâches. Hélas, elles n'ont pas toujours pleinement conscience de leurs pré-requis sensiblement différents. David Mooter, pour Forrester, juge donc utile de rappeler quelques évidences.

Dans la plupart des organisations, l'évolution s'est déroulée progressivement, de l'analyse de données historique à la science des données (et ses méthodes d'apprentissage automatiques) puis à l'IA générative, avant, enfin, de commencer à tâter de la toute dernière mode « agentique ». Au fur et à mesure de ces sauts générationnels, les mêmes équipes spécialisées, opérant de manière autonome, ont enrichi leur palette de compétences en vue d'appréhender chaque nouvelle opportunité.

Or un changement critique d'approche intervient aujourd'hui : alors que les premières phases se « contentaient » d'extraire et restituer de l'information, en plaçant tous les efforts sur la définition des modèles autorisant la meilleure performance possible, les agents, eux, arrivent avec des modèles prédéfinis et le véritable enjeu consiste dorénavant à piloter des actions et orchestrer des processus, en s'appuyant sur des services et des API qui interagissent directement avec les systèmes existants.

La principale difficulté rencontrée pour tout projet impliquant le traitement des données est d'identifier et accéder à celle-ci. Face à cet obstacle, les responsables ont souvent eu recours à la création d'un « data lake », hébergeant une copie de tout ce qui pouvait leur être utile afin de se libérer des contraintes engendrées par les silos fonctionnels des grandes structures. De toute évidence, ce dépôt généraliste n'est d'aucune utilité pour les agents IA, qui ont plutôt besoin de se connecter aux applications elles-mêmes.

Forrester – Agentic AI

En conséquence, l'expertise la plus appropriée pour ce genre de démarche n'est plus la gestion de l'information mais l'intégration. Ce sont les professionnels des échanges et des API qui sauront mettre en œuvre les bonnes pratiques permettant d'éviter les multiples écueils de l'IA agentique – problématiques d'architecture, standards mouvants, compromis de sécurité, accumulation de dette technique, composants hétérogènes et isolés… – qu'ils connaissent et au travers desquels il naviguent depuis longtemps.

Pour David Mooter, l'inclusion de l'intelligence artificielle dans la stratégie d'intégration constitue la seule option viable. En considérant l'IA agentique comme une forme supplémentaire d'intégration (ce que les éditeurs prennent désormais en compte), les équipes capitaliseront sur des capacités disponibles en matière de pilotage de la fiabilité, de la sécurité, du cycle de vie… Encore faut-il, bien sûr, que l'entreprise possède une maturité suffisante dans ce domaine. À défaut, elle devra tout construire…

  • ✇La Quadrature du Net
  • France Travail déploie un outil de profilage algorithmique à des fins de contrôle
    France Travail développe un algorithme de profilage des chômeur·euses à des fins de contrôle, comme le prouve un document que nous publions aujourd’hui en partenariat avec la cellule investigation de Radio France. Cet algorithme, encore en phase de test, manifeste la volonté de France Travail de massifier les contrôles via l’utilisation d’outils numériques. Nous appelons à la mobilisation contre cet algorithme illégal et à son abandon par la direction de France Travail. Le 10 décembre dernier, u

France Travail déploie un outil de profilage algorithmique à des fins de contrôle

Par : cc
20 juillet 2026 à 08:00

France Travail développe un algorithme de profilage des chômeur·euses à des fins de contrôle, comme le prouve un document que nous publions aujourd’hui en partenariat avec la cellule investigation de Radio France. Cet algorithme, encore en phase de test, manifeste la volonté de France Travail de massifier les contrôles via l’utilisation d’outils numériques. Nous appelons à la mobilisation contre cet algorithme illégal et à son abandon par la direction de France Travail.

Le 10 décembre dernier, un nouvel outil numérique était présenté au comité d’éthique IA de France Travail. Intitulé « Ciblage du Contrôle de la Recherche d’Emploi », son objectif est de « recourir à l’IA » afin d’« identifier les dossiers nécessitant un examen approfondi » et d’« alimenter automatiquement l’outil de contrôle de la recherche d’emploi ». Lors de sa présentation, cet outil était en phase active de test, étape préalable à un déploiement plus large.

En d’autres termes, l’ancien Pôle Emploi cherche à se doter d’un outil similaire à ceux que nous dénonçons à la CNAF ou à l’Assurance maladie, visant à automatiser la sélection des personnes devant faire l’objet d’un contrôle.

6 millions de personnes concernées

Cet algorithme vise à « prédire » quel·les chômeur·euses manqueraient à leurs obligations de recherche d’emploi. Concrètement, il repose sur la construction de profils « suspects/non suspects » fondée sur l’analyse de dizaines de milliers de contrôles passés1L’algorithme a été entraîné sur la base de 60 000 contrôles passés. Techniquement, il se base sur un arbre de décision, une technique de machine-learning dont les paramètres sont sélectionnés par itérations successives.. Chaque personne inscrite est ensuite assignée à l’un de ces profils sur la base des données personnelles que détient France Travail. Celles et ceux classifié·es comme « suspect·es » sont placé·es sur une liste de personnes prioritaires à contrôler.

Si cet algorithme est aujourd’hui testé sur les profils de personnes en situation de rupture conventionnelle2À la date de publication du document, l’algorithme avait fait l’objet de deux campagnes de 7 000 tests environ chacune, portant sur les personnes ayant fait l’objet d’une rupture conventionnelle., France Travail souhaite « étendre l’utilisation du modèle à d’autres publics » afin d’« alimenter automatiquement l’outil de contrôle et transmettre chaque mois des listes de contrôle ciblés »3Ciblage du contrôle de la recherche d’emploi, document présenté en comité d’éthique IA du 10 décembre 2025, disponible ici. Le document précise que l’algorithme vise à alimenter les « listes de contrôles ciblées ». Ces contrôles représentent environ 40% de l’ensemble des contrôles, soit 500 000 contrôles en 2025, aux côtés des contrôles aléatoires ou des contrôles déclenchés sur « signalement ».. En prenant en compte l’ensemble des personnes au RSA, dont l’inscription à France Travail est obligatoire depuis le 1er janvier 2026, ce sont plus de 6 millions de personnes qui pourraient se voir profiler chaque mois par l’algorithme4Inscrits à France Travail, premier semestre 2026, catégories A, B, C, D et E, France Travail, disponible ici..

Un ciblage incertain

À ce jour, nous disposons seulement de la liste des 26 variables utilisées par l’algorithme, mais nous ne connaissons pas les règles utilisées dans la construction des profils5La liste exhaustive des variables est disponible dans le document que nous publions.. Nous ne sommes donc pas en mesure de déterminer, via des simulations, quelles populations sont les plus ciblées par cet outil. Nous avons fait une demande d’accès au code source de l’algorithme mais, eu égard à l’opacité qu’entretient France Travail vis-à-vis de ses outils numériques, il est peu probable qu’elle aboutisse.

Parmi les catégories de variables retenues, notons notamment celles relatives aux « activités déclarées », à la « visibilité du demandeur d’emploi » (par exemple si le CV est en ligne sur le site de France Travail), à la recherche d’un travail dans un « métier en tension », au « niveau de formation », à « l’ancienneté d’inscription », ou encore à « l’historique des manquements » (absence à un rendez-vous par exemple). On retrouve également la présence d’une activité non salariée, critère par ailleurs utilisé par la CNAF dans son dernier algorithme de scoring pour dégrader la note des personnes en emploi précaire.

Mais l’absence de transparence quant aux règles de classification de l’algorithme ne doit pas masquer l’essentiel. Comme le montrent les exemples de la CNAF et de la CNAM, ces algorithmes sont dangereux en eux-mêmes, car ils sont des outils particulièrement efficaces pour organiser, en toute impunité, la répression de populations entières, et en particulier des plus vulnérables.

Déresponsabilisation et répression sociale

En premier lieu car, comme nous l’avions documenté en détail dans le cas de la CNAF, l’introduction d’algorithmes dopés à l’IA ou au « machine learning » dépolitise la question du contrôle social et des violences associées. France Travail ne fait pas exception : le document présenté à son comité d’éthique avance, dans un paragraphe intitulé « Pourquoi recourir à l’IA ? », que cette dernière permettrait une « suppression des a priori » en proposant « des dossiers à contrôler sur la base de critères objectifs ».

Ce que l’on observe ici c’est la transformation d’un problème politique – le choix des critères de sélection des personnes à contrôler – en un problème purement technique. Cette dépolitisation s’accompagne d’une délégitimation de la critique des politiques de contrôle, puisque ces dernières sont désormais censées être « neutres » et « objectives ». Elle procède également d’une déresponsabilisation des dirigeant·es qui n’ont plus à assumer, en leur nom, les politiques qui conduisent au ciblage de certaines catégories de personnes.

Ajoutons enfin que le profilage algorithmique est utilisé pour invisibiliser le caractère discriminatoire des politiques de contrôle à travers l’individualisation du processus de sélection. Nul·le n’est contrôlé·e parce qu’il ou elle fait partie de telle ou telle population, mais parce que son « score » individuel s’est détérioré.

Opacité et maltraitance

À cela s’ajoute l’opacité qui entoure le code des algorithmes de profilage. En permettant aux responsables des institutions sociales de taire la réalité du tri social organisé, elle complique considérablement la mise en lumière de leurs dérives.

On rappellera ici que, dans le cas de la CNAF, le code source de l’algorithme n’a été obtenu qu’après une longue bataille juridique et médiatique, tandis que celui de l’Assurance maladie ne l’a été qu’à la faveur d’une erreur de caviardage par l’administration. Pendant des années, l’absence de publication des paramètres de ces algorithmes a permis à ces institutions d’organiser le sur-contrôle de certaines populations (femmes isolées, personnes au RSA, personnes en situations de handicap…) sans jamais avoir à rendre de comptes. Pire, les dirigeant·es de ces institutions ont profité de cette opacité pour aller jusqu’à se vanter du recours à des outils de « modernisation » à la « pointe de la technologie ».

Ce risque est particulièrement fort concernant France Travail. Car, loin de la communication de sa direction vantant un recours à une IA « éthique » et « transparente »6Voir notamment la « Charte de France Travail pour une éthique de ses usages de l’intelligence artificielle », disponible ici., toutes nos demandes d’accès au code des IA utilisées par France Travail sont, à ce jour, restées lettres mortes. En violation flagrante de la loi, France Travail a notamment refusé de nous communiquer la moindre information sur des IA aussi sensibles que celles utilisées pour échanger par SMS afin de proposer des offres d’emplois à des usager·ères (MatchFt) ou celle que France Travail a généralisé auprès de ses conseillers afin de les aider dans leurs tâches quotidiennes (ChatFt)7Notons que nos demandes ne portaient pas que sur le code source de ces IA, mais aussi sur la documentation technique ou l’analyse d’impact de la protection des données.. Pire, dans ces deux cas, l’institution n’a même pas pris la peine de motiver sa décision auprès de la Commission d’accès aux documents administratifs (CADA) – l’institution chargée d’indiquer si ces refus sont légaux ou pas – lorsque nous l’avons saisie.

IA générative et massification des contrôles

Le développement de ce nouvel outil de profilage s’inscrit dans un contexte plus large de multiplication des outils numériques de contrôle au sein de France Travail. Rien que l’année dernière, nous alertions déjà sur le déploiement de « robots » visant à automatiser la décision de clore ou non un contrôle. Ces « robots » intervenaient lors du contrôle lui-même, alors que le nouvel algorithme intervient en amont, lors de la sélection des personnes à contrôler.

Ce qui se dessine, c’est la volonté d’automatiser l’ensemble de la chaîne de contrôle afin de répondre aux objectifs gouvernementaux de massification des contrôles, dont le nombre est passé de 200 000 en 2017 à 730 000 en 2025. En 2027, l’objectif fixé par le gouvernement est d’en réaliser 1,5 millions8Pour les chiffres de 2017, voir l’étude de Pôle Emploi « Le contrôle de la recherche d’emploi : l’impact sur le parcours des demandeurs d’emploi » disponible ici. Pour 2025, voir le document de présentation de l’algorithme. L’objectif de 1,5 millions a été annoncé par Gabriel Attal en 2024, voir cet article..

Mais c’est du côté de l’IA générative que les risques les plus importants existent aujourd’hui. Alors que France Travail multiplie le développement d’IA (ChatfT, NeoFt, MatchFT…), on ne peut que s’attendre à ce qu’une IA générative soit déployée à des fins de contrôle. Connectée au dossier de la personne contrôlée, elle formulerait une « suggestion » quant à la décision à prendre par le ou la contrôleur·euse. Ce serait une étape décisive vers une automatisation totale du contrôle de la recherche d’emploi et la possibilité de massifier, à moindre coût, le contrôle et la surveillance des millions de personnes inscrites à France Travail.

Il est fondamental que France Travail change de politique. Celle qui se dessine, une automatisation toujours plus inhumaine du contrôle, doit être rejetée. Il est encore plus inquiétant de voir que les dirigeant·es de France Travail ne veulent pas voir la réalité sociale de leur politique de contrôle et préfèrent s’enfermer dans la douce mélodie du solutionnisme technologique. Alors pour nous aider à continuer la lutte, vous pouvez nous faire un don et retrouvez l’ensemble de nos publications sur l’utilisation par les organismes sociaux d’algorithmes à des fins de contrôle social sur notre page dédiée.

References[+]

References
↑1 L’algorithme a été entraîné sur la base de 60 000 contrôles passés. Techniquement, il se base sur un arbre de décision, une technique de machine-learning dont les paramètres sont sélectionnés par itérations successives.
↑2 À la date de publication du document, l’algorithme avait fait l’objet de deux campagnes de 7 000 tests environ chacune, portant sur les personnes ayant fait l’objet d’une rupture conventionnelle.
↑3 Ciblage du contrôle de la recherche d’emploi, document présenté en comité d’éthique IA du 10 décembre 2025, disponible ici. Le document précise que l’algorithme vise à alimenter les « listes de contrôles ciblées ». Ces contrôles représentent environ 40% de l’ensemble des contrôles, soit 500 000 contrôles en 2025, aux côtés des contrôles aléatoires ou des contrôles déclenchés sur « signalement ».
↑4 Inscrits à France Travail, premier semestre 2026, catégories A, B, C, D et E, France Travail, disponible ici.
↑5 La liste exhaustive des variables est disponible dans le document que nous publions.
↑6 Voir notamment la « Charte de France Travail pour une éthique de ses usages de l’intelligence artificielle », disponible ici.
↑7 Notons que nos demandes ne portaient pas que sur le code source de ces IA, mais aussi sur la documentation technique ou l’analyse d’impact de la protection des données.
↑8 Pour les chiffres de 2017, voir l’étude de Pôle Emploi « Le contrôle de la recherche d’emploi : l’impact sur le parcours des demandeurs d’emploi » disponible ici. Pour 2025, voir le document de présentation de l’algorithme. L’objectif de 1,5 millions a été annoncé par Gabriel Attal en 2024, voir cet article.

L’IA, alliée ou ennemie de l’information ?

« Festival international de journalisme » (1/7). L’intelligence artificielle générative fait aujourd’hui pleinement partie de notre quotidien. Mais dans les médias et pour le public, elle crée la confusion entre réalité et fake news.

© Solène Reveney / Le Monde

L’IA, alliée ou ennemi de l’information ?
  • ✇Dans les algorithmes
  • Maven, l’impérialisme guerrier… sans limites 
    La journaliste de Bloomberg, Katrina Manson, a publié en mars un livre consacré au Project Maven : A Marine Colonel, his Team, and the Dawn of AI Warfare (Norton & Company, 2026, non traduit). Maven est le nom du programme d’IA développé par l’armée américaine pour faire la guerre (l’équivalent des programmes israélien que nous avons longuement évoqué dans DLA, notamment dans L’IA, ça sert, d’abord, à faire la guerre). Le livre raconte la bataille d’un officier des Marines, Drew Cukor, pour

Maven, l’impérialisme guerrier… sans limites 

15 juillet 2026 à 07:00

La journaliste de Bloomberg, Katrina Manson, a publié en mars un livre consacré au Project Maven : A Marine Colonel, his Team, and the Dawn of AI Warfare (Norton & Company, 2026, non traduit). Maven est le nom du programme d’IA développé par l’armée américaine pour faire la guerre (l’équivalent des programmes israélien que nous avons longuement évoqué dans DLA, notamment dans L’IA, ça sert, d’abord, à faire la guerre). Le livre raconte la bataille d’un officier des Marines, Drew Cukor, pour imposer le projet et convertir l’armée américaine aux promesses de la guerre automatisée. 

On regrettera vivement que le livre soit parfois peu précis sur ce que fait et ne fait pas Maven. Si on y apprend toute son histoire, on n’apprend pas comment le système fonctionne concrètement, ce qu’il arme ni comment. Si le livre évoque longuement le travail sur certaines données, notamment les images et vidéos satellitaires et de drones, c’est au détriment de toutes les autres qui nourrissent aussi le tableau de bord pour faire la guerre, et notamment les données provenant des écoutes téléphoniques, de la surveillance et du renseignement. Son interface qui semble la plus grande réussite du programme à en croire Manson ne nous est jamais montrée. 

Il faut comprendre que l’enquête de la journaliste porte plutôt sur le développement de projet agile au sein d’une bureaucratie contrainte et retorse. Si le livre propose une solide chronologie, Manson semble parfois rater certains enjeux au profit d’une ode à la persévérance et à l’innovation, comme fascinée par ce que Cukor et son équipe sont parvenus à imposer, dans l’adversité. 

Lancé en 2017, le projet Maven est désormais pleinement opérationnel. Il est le projet fondateur du ciblage automatisé. S’il n’est que l’un des 800 projets IA de l’armée américaine utilisés sur les champs de bataille, Maven est devenu son système phare, déployé dans toutes les branches militaires américaines. Plus qu’un outil de ciblage sans précédent, Maven est une plateforme qui concentre les dispositifs de renseignement et d’opérations. 

L’obsession de l’IA

Drew Cukor était officier dans les Marines à Kandahar en Afghanistan après les attentats du 11 septembre 2001. C’est là qu’il découvre les ordinateurs sur le terrain d’opération. Autant dire que sa déception est grande. A l’époque, les listes de cibles produites par le renseignement étaient enfermées dans des fichiers Excel. Chaque service avait ses propres outils d’analyse. Mais ces outils étaient inexploitables sur le terrain. Dès sa thèse dans le corps des marines en 97, Cukor défend que l’intelligence des machines est inutile si les soldats de terrain n’y ont pas accès. Pour lui, les ordinateurs doivent aider à transformer la donnée en intelligence pour l’action. En Afghanistan, puis à Bagdad en Irak, il constate que les ordinateurs sont inutiles aux soldats. Quand il devient le responsable du département du renseignement des Marines en 2010, son objectif est de réparer le renseignement et pour lui, cela signifie y déployer la plateforme de gestion de données proposée par une startup américaine, Palantir, dont il a apprécié la démonstration en 2009. In-Q-Tel, le fond d’investissement de la CIA a investi en 2005, 2 millions de dollars dans Palantir. A l’époque, Palantir n’est qu’un démonstrateur pourtant : il affiche des données provenant de nombreux silos du renseignement et permet de voir quel analyste y accède. Il garde la trace des changements et des indications que portent sur ces informations les agents. Une forme de wiki du renseignement permettant de discuter des informations, de les valider ou de les écarter. Parmi les données disponibles, il y a des appels téléphoniques et leurs transcriptions, des rapports d’interrogatoires, des images et vidéos… Et un système de requête permettant de trouver la trace d’informations dans toutes les informations disponibles pour les recouper. Palantir n’est qu’une interface qui permet d’afficher les données et de coopérer entre analystes sur des données qui proviennent du renseignement. Un tableau de bord.  

Le rapport de la commission du 11 septembre a pointé les défaillances du renseignement et plus encore de matériel pour l’exploiter. Cukor partage le même avis. Pour Cukor, comme pour Thiel et Karp, les fondateurs de Palantir, les attentats de 2001 ont été un choc. Pour eux, le renseignement américain a échoué à empêcher le drame. Pour eux, l’IA est la réponse à apporter : elle a pour mission de transformer le renseignement et les opérations. Mais, les Marines, où Cukor travaille, est le plus petit des services de la Défense américaine et son département spécialisé dans le renseignement est encore plus insignifiant. Cukor décide néanmoins d’utiliser Palantir sur le terrain en Afghanistan, en 2011. Très rapidement, les officiers de terrain le trouvent utile. La Marine l’utilise pour déterminer des routes et des zones d’atterrissage. L’outil est pourtant très imparfait, mais il fait vite la démonstration de ses possibilités. Pour Cukor, comme il le défendra dans une note, la modernisation du renseignement militaire est clé : à l’avenir, l’analyse déterminera qui l’emportera sur le champ de bataille. Le but est d’accélérer et d’améliorer la décision avec l’aide de l’IA. A l’heure où Google fait rouler des voitures autonomes, pourtant, l’armée n’a pas ces outils dans son catalogue. Pas même de système cloud. Et ce quand bien « même si l’internet a été une création du Pentagon et qu’il dépense 38 milliards de dollars par an dans les nouvelles technologies »…. Pour Cukor, tout est à faire. Mais pour convaincre, estime le soldat, il faut des applications concrètes, qui collent au terrain, utiles sur site.

Cukor propose d’utiliser l’IA pour analyser les données des drones et améliorer l’information satellitaire. Cukor va visiter les entreprises qui produisent des voitures autonomes. En 2017, il rencontre IDenTV, une startup qui construit un modèle de vision par ordinateur pour drones, capable de repérer des objets sur une image. Le Congrès valide les fonds. Le projet Maven est lancé. Son ambition est tout de suite de faire du ciblage. Pour lui, l’IA doit aider à sélectionner et prioriser les cibles et aider à apparier la réponse appropriée. Pour lui, le département de la Défense ne devrait plus jamais acheter de systèmes d’armement sans IA intégrée. Son idée fixe est de créer une application de ciblage révolutionnaire et démontrer que l’IA peut « réduire la durée de la chaîne d’engagement entre la détection d’une cible et son traitement : repérer, localiser, neutraliser ». Pour lui, le département de la Défense doit fonctionner bien plus comme une entreprise logicielle que comme une usine d’armement pour être capable de traiter la donnée, actif capital du terrain. 

Pour cela, Cukor se dote d’une équipe dédiée bien sûr. Tous semblent des avoir des profils atypiques, si l’on en croit Katrina Manson. Cukor, plus qu’un visionnaire, est plutôt décrit comme un psychopathe par certains d’entre eux. Un bourreau de travail, obsédé par sa vision. Manson délaye les commentaires des uns sur les autres… 

Du côté de la création de Maven, elle explique que l’enjeu a été d’intégrer peu à peu des informations provenant de différents types de drones et notamment les images qu’ils produisaient, qu’il a fallu faire parler, analyser, pour que les systèmes reconnaissent des formes. Une gageure pas si simple, notamment pour les drones qui volent le plus haut, qui renvoient des images où les informations sont difficiles à identifier du fait même de l’éloignement. Certains motifs ne font parfois que quelques pixels. L’étiquetage des images pour l’entraînement des systèmes n’était pas simple, d’autant que ces images sont produites selon différents angles, altitudes… L’autre enjeu de Maven a consisté à construire l’infrastructure pour sécuriser ces données tout en donnant accès aux agents assermentés comme aux logiciels des entreprises privées. Dès le début Maven se conçoit comme un projet en partie ouvert aux industries de l’IA, notamment aux entreprises capables d’apporter les capacités de traitement et de sécurisation, celles capables d’apporter les logiciels d’analyses des flux vidéos, etc. Manson montre surtout que les capacités du renseignement américain ne reposent pas seulement sur les capacités techniques des agences, mais visent surtout à agencer des infrastructures sécurisées, capables de traiter les volumes de données et l’information, et délimiter les capacités d’action de chacun. La structuration a consisté à ce que le gouvernement s’occupe des données et loue les licences d’usages des systèmes, à charge de les intégrer sans que ceux-ci n’accèdent aux données et les intégrer aux lourds systèmes sécurisés de l’armée. Ces travaux ne se sont pas menés avec les grandes entreprises du secteur, mais plutôt avec de petits acteurs, comme Clarifai.ai ou Xnor… Peu à peu, les entreprises fourbissent des dizaines d’algorithmes d’analyses, certains pour identifier les visages, d’autres pour les images de drones ou satellitaires. Faire apprendre la reconnaissance de formes aux systèmes prend du temps. 

L’enjeu pour Cukor était d’obtenir un démonstrateur utile sur le terrain, même si imparfait. Les premières démonstrations ont lieu en Somalie, 8 mois après le lancement de Maven. La démonstration n’est pourtant pas totalement concluante. L’écran se peuple d’indications de détection et toutes ne sont pas exactes (la moitié sont mêmes complètement fausses). La détection est lente. Mais l’IA montre qu’elle est capable de compter des humains sur un marché, de suivre des convois de véhicules en mouvement, de suivre des individus ciblés. Et puis, elle pointe des individus cachés dans des buissons qu’aucun humain n’avait détectés. L’IA venait de faire la démonstration de son utilité. Malgré ses défauts, l’exemple était saisissant. 

Cukor va tenter de rallier nombre d’acteurs à ses projets. Notamment Google et sa filiale, DeepMind, forte de son succès au jeu de Go, alors que son patron, Demis Hassabis a signé une lettre ouverte en 2015 contre les périls à utiliser l’IA pour la guerre. Les approches de Cukor pour inviter à rallier son projet sont difficiles. Partout, des déclarations s’en prennent au déploiement de l’IA, à l’image des plus actifs et radicaux, les acteurs de Stop Killer Robots, lancé dès 2012. Alors que les dépenses militaires soutiennent des entreprises de la Silicon Valley depuis longtemps, les révélations d’Edward Snowden en 2013 ont refroidi l’ambiance. Une entité de Google finira par signer un contrat avec Maven, pour le stockage d’infrastructure, pour aider l’armée à construire son propre cloud. En mars 2018, ce contrat entre Google et Maven est rendu public, déclenchant une vaste contestation dans l’entreprise… jusqu’à ce que Google annonce son retrait du projet (ou son implication semblait surtout anecdotique, mais symbolique). Microsoft prendra sa place. Puis bien d’autres. En février 2025, Google remisera ses principes. Peu à peu, les entreprises vont se joindre au projet, au prétexte de prêter leur concours à la sécurité nationale. En 2025, Hassabis lui-même affirmera que « les valeurs démocratiques de l’occident sont menacées ». La plupart de ceux qui ont dénoncé les dangers de l’IA se sont rangés pour se mettre au service du marché des armées. Après le retrait de Google d’ailleurs, le projet Maven est renforcé : le programme obtient « l’exemption de sécurité nationale », lui permettant de ne pas répondre de ses actions. Son budget passe de 16 millions de dollars en 2018 à 93 en 2019. Sous la gouvernance de Cukor, le programme Maven aura englouti 1 milliards de dollars.

Un long processus d’amélioration

Maven de son côté étend son projet à d’autres enjeux que l’analyse des images de drones, pour y intégrer des contenus de caméras de sécurité et surtout, des analyses de textes, de contenus audios provenant de l’écoute des communications, de fichiers provenant de documents capturés à l’ennemi. La labellisation permet aux algorithmes de progresser et d’identifier de plus en plus correctement de plus en plus d’objets. Ses équipes se déplacent d’un terrain d’opération l’autre pour tester ses outils, notamment en Afghanistan, où l’équipe se rend compte qu’il faut améliorer les modèles car les données d’entraînement utilisées en Somalie ne fonctionnent pas aussi bien ailleurs. Pour l’instant Maven ne fait que de la détection, mais pour Cukor, l’enjeu est déjà de passer à la phase suivante : cibler. Quand les algorithmes de détection s’améliorent en Afghanistan, ils s’effondrent aux Philippines : les véhicules à détecter ne sont pas les mêmes, l’environnement non plus… À mesure que l’outil s’étend, le travail s’étend. L’enjeu à suivre des cibles est plus complexe que la simple détection… Malgré l’effort de détection, les frappes de drones sont loin d’être parfaitement sécurisées, les erreurs et les dommages collatéraux sont élevés. Mais surtout, Maven va peu à peu devenir ce pourquoi il est peut-être vraiment créé : pas seulement optimiser l’information, mais peut-être plus encore optimiser les ressources militaires, c’est-à-dire concentrer la puissance de feu pour qu’elle ait plus d’effets. L’IA pour faire la guerre est aussi, si ce n’est d’abord, un outil pour optimiser les ressources, décider de quelle arme employer… Maven semble un tableau de bord comme les autres : utilisé pour optimiser et contrôler les dépenses !

Au détour de son histoire, Mason raconte souvent l’obsession chinoise de l’armée américaine. A tous les niveaux, l’armée US semble convaincue que le prochain terrain d’opération sera une confrontation avec la Chine. Les américains sont convaincus que la Chine va reprendre Taïwan, plateforme de la construction des puces électroniques mondiales. Et l’armée américaine est convaincue que l’IA peut les aider à détecter l’offensive chinoise qu’ils attendent et contre laquelle ils se préparent. 

Manson évoque bien sûr Palantir et son PDG, Alex Karp, « le dealer d’armes IA du XXIe siècle ». En quelques années, Palantir est devenu le premier fournisseur de systèmes de Défense au monde. « La seule façon d’être en sécurité pour les Américains, est de s’assurer que ses adversaires aient peur », clame Karp. Pour lui, les activistes de la paix sont une infection. Ses systèmes savent agréger comme nul autre toutes les données, tous les détails sur une carte permettant aux systèmes d’IA et aux analystes de tout voir et de tout planifier. En s’imposant peu à peu comme l’acteur incontournable des systèmes de Défense, Palantir a décroché un accord de 10 milliards de dollars avec l’armée américaine pour les multiples licences à utiliser ses outils. Elle est devenue l’une des entreprises les plus rentables du monde. En 2018, alors que Maven se déploie timidement, Cukor veut déjà aller plus loin. Il voudrait que Maven incorpore tous les systèmes que l’armée utilise pour devenir la plateforme unique, le tableau de bord de la guerre, et notamment, incorporer les vidéos dans sa carte pour permettre aux analystes d’avoir accès à toujours plus d’informations, simplement ou leur permettre de cliquer sur une cible pour que le système la trace et la détruise. Pour cela, Cukor estime qu’il faut intégrer l’IA plus avant, dans le flux de ciblage lui-même. Le problème, c’est qu’à l’époque, l’argent de Maven est destiné à l’intelligence, pas à l’opérationnel. L’armée dispose d’innombrables options logicielles et intégrer l’IA est encore hautement controversé. En avril 2018, Cukor rencontre Palantir et déploie sa vision des systèmes de Défense pour les 10 prochaines années. Il imagine une sorte de Google Earth appliqué à la guerre. Un tableau de bord rassemblant toutes les informations, les structurant, les rendant disponibles… et les analysant. Il demande à Palantir de réimaginer l’interface utilisateur qu’ils proposent avec Gotham, l’un de ses logiciels. De faire quelque chose sur mesure. Cukor va initier des discussions avec nombre de start-ups. En octobre, l’équipe de Maven installe Palantir sur ses serveurs. La communauté militaire est rapidement convaincue de l’apport, malgré les coûts, même si l’installation de Palantir rend Maven moins essentiel. Cukor insiste pour que tout soit profondément séparé, aucune donnée n’est autorisée à passer d’un système à l’autre. Si la protection des données semble assurée, d’autres critiquent le fait que le Pentagon construise des services en couches, comme des tranches de cake superposées. Mais Palantir ajoute une couche d’analyse sur Maven : « La nouvelle plateforme de Palantir superposait de la réalité augmentée aux flux vidéo, traçant des lignes de planification de mission aux couleurs vives sur les images pour désigner les itinéraires comme étant sûrs ou dangereux. Des cercles concentriques, appelés cercles de portée, rayonnaient depuis un site d’attaque potentiel sur la carte pour indiquer la zone où des victimes pourraient subir des dommages collatéraux. Cette superposition attribuait également des numéros à des bâtiments spécifiques, facilitant grandement la communication entre des équipes disparates. » L’interface rend le tableau de bord et les cartes plus lisibles. Dans l’équipe de Maven, plusieurs pensent que l’intégration de Palantir est problématique. Cukor fait entrer nombre d’autres entreprises dans Maven, bien avant les grands acteurs de l’IA que seront OpenAI ou Anthropic, pour développer des modèles pour analyser les images et les données. 

Mason égraine les relations partenariales entre Maven et d’innombrables startups de la Valley. Leur flux, leurs reflux… Les avancées, les reculs, les hésitations.. Les luttes internes dans l’armée pour piloter les programmes d’IA, les guerres de territoires autour du partage de données qui permettent aux programmes de fonctionner. Beaucoup estiment que les protections imposées par Cukor sur les données restent son pire échec, empêchant leur partage entre différents services plutôt qu’empêchant les startups d’y accéder. La dernière partie du livre est toute entière autour de cette guerre de territoire entre différents services de l’armée. Derrière cette bataille interne, tout l’enjeu est de permettre non seulement de repérer, mais plus encore d’éliminer, de raccourcir la kill chain, comme l’ânonne chacun.

Reste que les débuts de ces intégrations n’en sont pas moins laborieux. « Les détections par IA semblaient initialement encore plus laborieuses avec le nouveau système de Palantir. Les détections apparaissaient sous forme de points si volumineux qu’ils masquaient les objets, rendant impossible la distinction entre adultes et enfants par exemple ». En octobre 2019, Maven est sur le front pour éliminer Abu Bakr al-Baghdadi…Trump est ravi de voir l’assassinat en direct, comme s’il regardait un film. 35 000 frappes contre l’Etat islamique sont déclenchées en même temps que le raid. Maven remplit son contrat. A nouveau, le système détecte des problèmes que les analystes n’avaient pas vu. « L’IA apparaît enfin capable de déchirer le brouillard de la guerre ». Même si les frappes sont loin d’être sans erreurs, comme le pointait la presse à l’époque. Entre 1437 et 8000 civiles seront tués en 5 années d’opération contre l’Etat islamique en Irak et Syrie, comme le révéleront les investigations de la NPR et du New York Times. L’armée américaine sera contrainte à mener une deuxième enquête après les contestations de la première pour éclaircir ce point, mais ses résultats ne seront jamais publiés. 

Les défaillances de l’IA sont pour l’instant passées sous silence, mais nombre de civiles sont souvent confondus avec des combattants. L’IA ne distingue pas les bons des mauvais. Ce qu’il voit devient souvent une cible puisqu’il est conçu pour en produire. Pour les défenseurs de la généralisation de l’IA, l’IA n’est pas toujours en cause, renvoyant la responsabilité aux humains. Pour les prosélytes de ces systèmes, ils permettent d’accéder à plus de données que jamais pour mieux décider. Pour les journalistes, les victimes civiles sont toujours plus nombreuses que comptées dans les rapports de l’armée. Lors de l’opération Tempête du désert en 1991, 90% des bombardements manquaient leur cible, faute de précision. Désormais les erreurs proviennent bien plus des biais des systèmes, du défaut de contexte ou de l’ignorance. Pas sûr que ce soit plus rassurant. En 2015, l’armée américaine a bombardé un hôpital en Afghanistan faisant 42 morts : la faute à de mauvaises coordonnées et à des erreurs humaines, reconnaîtra l’armée. 

Pour s’améliorer, Maven a capitalisé sur l’étiquetage des données pour mieux aider à entraîner ses systèmes et améliorer leur performance. La labellisation coûte de l’argent et prend du temps. En septembre 2020, avec l’aide de Palantir, Scale AI puis Enabled Intelligence, la labellisation devient un gros business pour ses acteurs : elle représente 708 millions de dollars de contrats pour l’armée, sans compter les 400 étiqueteurs de données, des militaires  employés directement par Maven, qui disposerait désormais de quelques 100 millions d’images étiquetées. Une arme sur une épaule ne se distingue bien souvent que sur deux ou trois pixels. Mais une fois entraînés, les systèmes se révèlent meilleurs que les humains, puisqu’ils peuvent voir ce que les analystes ne peuvent pas voir. En fusionnant les données provenant d’innombrables sources (images, signal radio et électromagnétique…), tout l’enjeu est d’améliorer la détection d’objets qui ne sont pas visibles aux humains et de les faire apparaître sur la carte. Pour l’armée, l’IA n’identifie pas toujours des objets mieux que l’humain, mais elle les identifie avant et plus vite que l’humain. 

La journaliste évoque encore la difficulté à sélectionner les armes appropriées, qui doit répondre à des contraintes nombreuses, de disponibilité, de temporalité et de communications. Ou encore, la difficulté à distinguer les combattants de ceux qui ne le sont pas. La Défense américaine se dote de documents de cadrage sur le ciblage, sans les publier. 

Maven, la puissance brute

Alors que Drew Cukor a quitté le programme en octobre 2021, en février 2022, Maven est déployé en soutien à l’Ukraine en Allemagne. Ses capacités de détection, confrontées à un nouvel environnement, nécessitent à nouveau une mise à jour pour s’améliorer. A nouveau, les algorithmes doivent s’adapter aux données et les données être labellisées pour s’adapter aux terrains et aux objets de guerre locaux. L’Ukraine n’est pas le désert. Il faut identifier les systèmes russes, comme les Tracteur-érecteur-lanceurs russes. Cela ne prendra que deux semaines seulement. Maven fait la demonstration que son système est capable de s’adapter très rapidement. 

L’armée américaine va très vite partager des informations avec l’Ukraine, mais sans leur donner accès à ses systèmes pour ne pas être accusée de participer à la guerre. Elle aide les analystes urkrainiens à regarder aux bons endroits. Depuis son QG allemand, Maven améliore son infrastructure cloud et sa connectivité pour éviter nombre de problèmes de latence. L’équipe transmet des cibles détectées à l’Ukraine, une trentaine par jour, 3 fois plus que ce qu’elle n’en voyait en Irak 5 ans plus tôt. La vitesse de la guerre a triplé en 5 ans, souligne Manson. Le nombre de détections ne va cesser de s’améliorer… Notamment en intégrant toujours de nouvelles données par exemple les interceptions de communications téléphoniques et radios russes, les explosions de missiles entendus via ces communications, les réseaux sociaux, comme les informations provenant de TikTok ou Twitter… « Les Etats-Unis deviennent les yeux de l’Ukraine ». Ils signalent également des points d’intérêts (jusqu’à 267 par jour en 2022) grâce à Maven. Mais l’enjeu n’est déjà plus l’identification de cibles, que les ressources en armes, missiles, munitions, drones… 

La guerre devient une question de puissance brute. Alors que l’armée américaine envoie des ressources sur le terrain, Maven teste et évalue plus de 1500 algorithmes pour améliorer son système. L’Ukraine va permettre à Maven de s’améliorer encore. Maven permet à l’armée ukrainienne de voir plus loin que le front. Après avoir progressé sur les cibles fixes, Maven s’améliore sur les cibles dynamiques. La communication s’améliore. Les ukrainiens sont désormais capables de détruire des cibles 18 minutes après que les Américains les leur aient communiqué. En 2024, l’Ukraine a détruit plus de 2600 tanks russes et plus de 5000 véhicules armés. Pour l’armée US, le soutien à l’Ukraine a permis d’engranger d’innombrables progrès. Le succès de Maven ne repose pas seulement sur ses algorithmes, mais bien plus sur ses données et la façon dont les flux s’interconnectent. Les systèmes sont désormais capables d’identifier un objet dès qu’une seule image se présente. Ils font encore des erreurs, peuvent ne pas tout voir, mais savent désormais repérer des objets, même avec peu de données d’entraînements. En 2024, l’armée américaine ne fait plus passer qu’une douzaine de points d’intérêts par jour à l’armée ukrainienne. Mais c’est d’abord parce que celle-ci a également énormément progressé et a bien moins besoin de l’aide américaine. Les taux d’erreurs se réduisent selon les chiffres de l’armée. La précision s’améliore. L’armée russe a utilisé des faux marqueurs sur le terrain, pour tromper les modèles de détection satellitaires, mais Maven a vite appris à les distinguer. Les données sont devenues le nerf de la guerre. Leur intégration de plus en plus rapide fait la différence. Maven est un système adaptable, qui se met à jour rapidement, comme un logiciel, explique Manson. « Il peut produire ce dont le commandement a besoin ». Sous le commandement de Whitworth, Maven est devenu un projet public, qui a quitté le secret. Le tir est désormais prêt à être entièrement automatisé. Au printemps 2025, le contrat du Pentagon pour Maven Smart System est passé à 1,3 milliards de dollars. Celui de Palantir à 480 millions de dollars. 

Les machines combattent les machines. La NSA écoute le monde entier. Et désormais, la NGA le regarde. Elle observe le globe en permanence. « En 2024, le commandement alimentait le système intelligent Maven avec 179 flux de données en temps réel provenant des domaines terrestre, maritime, aérien, spatial et cybernétique. » Désormais, les opérateurs qui utilisent Maven approuve ou désapprouvent le ciblage depuis le tableau de bord de ciblage fourni par Palantir, déterminent les priorités, hiérarchisent les ciblages, et envoient directement des messages aux systèmes de tirs. La kill chain est effectivement devenue bien courte. « Une cible peut désormais passer de détectée à engagée en quelques minutes, contre plusieurs heures auparavant ». Maven sait désormais détecter et tracer les missiles ennemis en temps réel et travaille à prévoir là où ils vont frapper. 32 entreprises différentes travaillent sur le programme Maven, 25 000 personnes l’utilisent. Il a accumulé plus d’un milliard de détection d’objets. Depuis 2024, Northcom et le Norad l’utilisent. 

L’adoption de Maven est totale. Il est utilisé pour faire de la détection de franchissement de frontières aux Etats-Unis ou pour surveiller le trafic de drogue dans les Caraïbes. La garde nationale l’utilise pour surveiller les départs de feux. Les promoteurs de Maven comme ceux de Palantir estiment que Maven n’est pas un système d’armement, que valider une cible ne déclenche pas le largage d’une munition sur celle-ci. Mais cette défense semble de plus en plus une parade argumentative. Le système apparie les munitions aux cibles et propose une priorisation des cibles que les analystes peuvent certes aménager… 

Pour certains militaires, Maven nécessiterait une doctrine d’usage. Ce que montre Katrina Mason dans ses conclusions, c’est que pour l’instant, la seule doctrine consiste à l’utiliser. « L’IA dotée d’une capacité d’action autonome va non seulement complexifier le projet Maven et l’usage général de l’IA dans la guerre, mais aussi la rendre plus opaque pour l’utilisateur. Elle va également accélérer le rythme des conflits et en amplifier l’ampleur ; par ailleurs – et en dépit des arguments vantant le potentiel de désescalade de l’IA – elle risque de rendre la guerre plus probable. »

L’ajout de LLM dans Maven, via Palantir et d’autres entreprises, comme OpenAI ou Anthropic, a pris du temps. Les premières tentatives ont été déceptives. Elles semblent surtout utilisée pour développer des prototypes de campagne et pour planifier des décisions militaires. Mais leur usage est pour l’instant observé avec défiance, estime Mason, notamment par crainte qu’ils empoisonnent les systèmes. Cela n’empêche pas leur intégration de s’étendre, même si on connaît fort mal la manière dont l’IA générative est utilisée. 

L’obsession de l’autonomie, la réalité de l’escalade

Katrina Mason termine son livre en revenant sur les propos d’Antonio Guterres, le secrétaire général des Nations Unies, qui souhaite interdire le recours aux armes autonomes et qui s’inquiète du développement de l’IA dans le domaine militaire. La balance est pour l’instant difficile à faire, par manque d’information sur les systèmes et leurs conséquences. L’IA dans la guerre permet-elle de limiter les dommages collatéraux et les victimes civiles ou de les étendre ? Toutes les armées qui déploient ces systèmes assurent garder la main : qu’il y a toujours un humain pour valider les décisions de l’IA, mais on sait que cela tient d’une fable plus que d’une réalité. Le contrôle humain tient d’un slogan vague et mal conçu. Les systèmes embarquent les biais du renseignement avec eux et peuvent mal identifier les personnes depuis les lacunes des systèmes de reconnaissance. La Convention sur le contrôle des armes (CCW GGE) discute depuis 2014 du problème des armes autonomes. Pour Mary Wareham, longtemps responsable de la question de l’armement à Human Rights Watch, l’une des initiatrices de Stop Killer Robots, nous devrions pousser les Etats à signer un traité pareille à celui de la réduction des mines antipersonnelles. Mais pour Cukor, comme pour l’armée américaine, le risque vient bien plus du risque de développement d’armes autonomes par ses ennemis. L’armée est plus inquiète de sa capacité à neutraliser une attaque que de réguler les siennes. Pour l’administration Trump, l’IA est une contribution essentielle et positive à la guerre en tout point, comme si les critiques n’avaient aucune voix au chapitre. Si la Chine semble plus modérée sur le développement d’armes autonomes, c’est certainement pour ralentir l’avancée américaine, explique Katrina Manson, qui semble avoir été contaminée par la perspective de guerre avec la Chine. Mais plus encore que l’autonomie, le déploiement de l’IA dans les conflits risque de conduire à l’escalade, comme l’expliquait un groupe d’experts de l’ONU. 

Pourtant, au terme du livre de Manson, on ne sait toujours pas très bien comment les résultats sont générés. Pour cela, nous ne disposons que d’une poignée d’images très rarement distillées, comme dans cette vidéo récente, relayée par le journaliste Dan Israel dans un article pour Mediapart soulignant l’emprise de Palantir sur l’armée américaine. 

Captures d’écrans d’images de Maven. Source. 

Ce que l’on y voit semble tenir d’une forme de jeu vidéo, un outil de simulation qui ne simule pas, où chaque paramètre semble appréciable, mais où nombre de décisions sont automatisées, proposées pour validation, choisies par le système.  

En mai 2025, le directeur de l’unité d’innovation pour la Défense américaine, Doug Beck, expliquait que l’Ukraine consommait 4000 drones par jour (autant que ce que le département de la défense achetait en un an). L’Ukraine a produit 3 millions de drones en 2025, un million de plus de ce qu’elle produisait en 2024 (voir notre article sur le sujet). Pour chaque drone commercial fabriqué aux Etats-Unis, la Chine en produit 100 de plus, rappelle Manson. Dans son budget 2026, le Pentagon prévoit de dépenser 13,4 milliards pour des systèmes autonomes, dont le Replicator, un avion de chasse sans pilote. Face à ces perspectives, les Etats-Unis souhaitent reconstruire leurs capacités industrielles militaires. Plus facile à dire qu’à faire. 

Chez JP Morgan, Drew Cukor ne s’intéresse plus à mettre de l’IA dans les armes, mais dans la finance (pas sur que ce soit plus rassurant). Les modèles d’IA vont permettre de redéfinir le fonctionnement des prêts, des hypothéques, des cartes de crédit, des placements, s’apprêtant à « turbocharger » l’économie, tout en contournant la conformité et les régulations établies, au risque là encore des biais, des erreurs et de l’injustice. 

Le débat sur la moralité de la guerre reste entier. Pas sûr que l’autonomie ne nous aide à la faire progresser, bien au contraire. Si l’armée semble prendre l’éthique au sérieux, il y a de quoi être cynique. L’IA renforce la distance des combattants à l’acte de tuer, mais risque également de les éloigner de la décision de tuer. Ce double mouvement échoue à reconnaître l’humanité de l’opposant, qui est de plus en plus mise à distance. « Les outils d’IA risque d’abord de désensibiliser les combattants et l’armée, d’actes dont nul ne sera plus responsable », s’inquiète la journaliste. L’IA devrait pouvoir minimiser les erreurs et les dommages collatéraux, mais ce qu’on en voit pour l’instant, c’est qu’elle fait surtout s’envoler le volume de dommages plutôt qu’elle ne le réduit. La technologie rejoue le paradoxe de Jevons : « les technologies qui améliorent l’efficacité et abaissent les coûts conduisent invariablement à l’augmentation de leur consommation ». Les systèmes d’IA produisent plus de cibles, plus vites et rendent plus facile leur élimination. Les cibles générées par une boîte noire rendent le commandement trop sûr de lui. Ces systèmes transforment la guerre en jeu vidéo. De partout, il simplifie la destruction. L’ennemi est désormais plus facile à tuer qu’à capturer. Ces systèmes ne font aucun prisonnier. Ils ne proposent aucune clémence. Le paradoxe de Jevons nous le dit depuis longtemps : « plus quelque chose est efficace, plus vous allez avoir tendance à l’accomplir ». Pire, termine-t-elle. Non seulement cette technologie peut faire des choses horribles, mais les garde-fous peuvent également être facilement ajustés voire enlevés, comme le montrait Lavender, l’équivalent de Maven pour l’armée israélienne, où le nombre de victimes collatérales d’un tir pouvait être abaissé ou relevé, au gré des besoins de la guerre. Pour Mark Milley, l’ex chef d’Etat major de l’armée américaine, le champ de bataille sous IA ouvre une boîte de pandore… Les atrocités ne vont pas disparaître avec l’IA, rappelle Manson. Pour un autre gradé américain, le champ de bataille prend le tournant de l’autonomie, mais ce n’est pas parce qu’on est capable de le faire que nous devrions y aller. Trump a renommé le ministère de la Défense en ministère de la Guerre. En septembre 2025, Pete Hegseth, secrétaire de la Défense américain, devant tous les généraux de l’armée US, a affirmé vouloir plus d’IA partout et plus du tout de contraintes d’engagement excessives.

40 millions de personnes sont mortes durant la Première Guerre mondiale. 85 durant la seconde. Maven est désormais partout. Dans tous les services sur tous les continents. Jusqu’aux outils des alliés de l’Amérique. L’IA est désormais au cœur de toutes les opérations militaires américaines. Les mavenites sont pour la plupart partis dans d’autres entreprises du complexe techno-militaire américain, et notamment les entreprises d’IA qui rend Maven désormais puissant : Palantir, Microsoft, Anduril, OpenAI. La Maven mafia est partout. 

Mais surtout, ces systèmes reposent d’abord sur une surveillance invisible et sans limite aucune, au prétexte d’obtenir toujours plus de données pour optimiser toujours plus ses cibles et ses frappes. Le succès de l’IA repose sur une surveillance toujours plus totale, sans limite ni garde-fous. C’est l’éléphant dans la pièce de l’autonomie. Celle d’une surveillance de tous sans limite. 

C’est à nouveau la grande limite du livre pourtant très documenté de Katrina Mason. La journaliste semble passer à côté de ce à quoi elle n’a pas eu accès, malgré la profondeur de son enquête. C’est pourtant dans ce qu’on ne voit pas dans ce livre que se cache le monstre à venir. Un monde qui rêve d’assurer sa sécurité sans plus aucune limite quand bien même pour cela il serait finalement surtout prêt à se détruire lui-même, dans un impérialisme sans limite, dans un autoritarisme sans plus aucune contrainte. 

Hubert Guillaud

Couverture du livre de Katrina Manson.

Moonshot AI lance Kimi WebBridge, une extension de navigateur qui permet à des agents IA d'interagir avec des sites web comme le ferait une personne, en effectuant des recherches et extrayant des données

Moonshot AI lance Kimi WebBridge, une extension de navigateur qui permet à des agents IA d'interagir avec des sites web comme le ferait une personne, en effectuant des recherches et extrayant des données

Moonshot AI a lancé Kimi WebBridge, une extension de navigateur qui permet aux agents IA de contrôler Chrome et Edge localement à l'aide de la famille de modèles Kimi open source de l'entreprise, soulignant ainsi comment l'IA open source de pointe chinoise alimente de plus en plus la prochaine génération...

  • ✇LinuxFr.org : les dépêches
  • Veille communautaire sur des intelligences artificielles du mois d'avril 2026
    La série de dépêches de LinuxFr.org sur la veille concernant des intelligences artificielles reprend et adopte une nouvelle formule. Cette première dépêche de la série reprend donc l’initiative de valoriser les contenus des contributrices et contributeurs de LinuxFr.org en rapport avec des IA tels que les dépêches, journaux et liens. L’ajout des synthèses de la plupart des articles de presse et des contributions de la communauté LinuxFr.org pourrait être envisagé à terme, selon les disponibilit

Veille communautaire sur des intelligences artificielles du mois d'avril 2026

La série de dépêches de LinuxFr.org sur la veille concernant des intelligences artificielles reprend et adopte une nouvelle formule.

Cette première dépêche de la série reprend donc l’initiative de valoriser les contenus des contributrices et contributeurs de LinuxFr.org en rapport avec des IA tels que les dépêches, journaux et liens. L’ajout des synthèses de la plupart des articles de presse et des contributions de la communauté LinuxFr.org pourrait être envisagé à terme, selon les disponibilités des bénévoles.

    Sommaire

    Avant-propos

    Cette dépêche est dédiée à la veille sur des intelligences artificielles1 faite par des contributions communautaires sur des contenus de LinuxFr.org et reprend une partie de l’initiative amorcée par la série « Nouvelles sur l’IA »2 qui s’est arrêtée le 6 avril 20263 4.

    Comme recenser au fil de l’eau du contenu communautaire pertinent demande un travail conséquent pour la rédaction de la dépêche, la décision de continuer la série sous une nouvelle formule a été faite à la vue des résultats d’un sondage publié le 1er mai 2026.5 6 7

    Méthodologie de sélection des contenus communautaires

    Comme dans la précédente série des « Nouvelles sur l’IA », les contenus communautaires sont répertoriés selon ces deux critères :

    • La présence d’une étiquette intelligence_artificielle8 (indication d’un rapport avec le thème de la dépêche)
    • Un score strictement supérieur à zéro au moment du recensement

    Certains contenus non recensés en raison du second critère peuvent être visualisés en s’aidant de la recherche par étiquette8.

    Quelques statistiques sur les contenus retenus

    Du 1er avril au 30 avril, les contenus retenus sont:

    • 5 dépêches
    • 14 journaux
    • 34 liens

    Au total, 53 contenus répondant aux critères de sélection sont recensés dans la présente dépêche.

    Une sélection des contenus par thème

    Les thèmes ci-dessous sont proposés pour aider des lectrices et des lecteurs à retrouver les contenus qui les intéressent. Les thèmes sont pour le moment suggérés manuellement par des contributrices et des contributeurs à la dépêche.9

    Revues de presse

    Les revues de presse de l'April de l'année 2026 mentionne l'IA sur les dépêches suivantes :

    Podcasts

    Le podcast CPU a évoqué des sujets en rapport avec l'IA dans les journaux suivants :

    Jeux vidéos

    Une dépêche intitulée Le jeu vidéo destiné à devenir de moins en moins libre et performant ? illustre l'utilisation de l'IA dans le rendu des jeux vidéos récents.

    Économie et droit

    Les contenus en rapport avec l'économie et le droit sont les suivants :

    Journaux

    Liens

    Santé

    Les liens indiquant le rapport entre la santé en général et des IAs sont les suivants :

    Environnement

    Les liens soulignant les impacts environnements de l'IA sont les suivants :

    Retour d'expérience

    Un journal fait état d'un retour d'expérience sur des IAs génératives chargées d'une tâche en programmation : Comparatif : 6 LLMs locaux face à un exercice Python simple

    Poissons du 1er avril

    Comme toute bonne tradition qui se respecte depuis des années sur LinuxFr.org (à l'exception notable de l'année 2023), la communauté a proposé ses propres poissons dans les journaux suivants :

    Annexe : contenus recensés par ordre chronologique

    Ci-dessous sont rassemblés des contenus sélectionnés dans l'ordre chronologique, dont une partie qui n'ont pas été classés parmi les thèmes.

    Dépêches

    Journaux

    Liens


    En complément, afin de remercier les lectrices et lecteurs qui ont pu prendre connaissance de l'ensemble de la dépêche, nous vous proposons la montée de l'IA (pour "Intelligence Aviaire") vue par Cepper, une cousine germaine de Pepper10 11 :


    1. Le terme "intelligence artificielle" regroupe en fait plusieurs définitions qui n'ont pas toujours fait consensus. Voir la page wikipédia sur leur définition et les techniques associées pour plus de précisions. ↩

    2. L'ensemble des "Nouvelles sur l'IA" sont accessibles avec le tag dédié nouvelles_sur_l_ia ↩

    3. La dernière dépêche de la série est consultable sur https://linuxfr.org/news/nouvelles-sur-l-ia-de-mars-2026 ↩

    4. Le contributeur Moonz< a motivé son arrêt de la série de dépêche par le commentaire https://linuxfr.org/news/nouvelles-sur-l-ia-de-mars-2026#comment-2018598 ↩

    5. Au 9 mai 2026 à 15h23 CEST, 58.3 % de vote sont favorables à la reprise de la série; 15.1 % de votes défavorables, 9.4 % de votes indécis, et 17.2 % de votes "pas vraiment sérieux". Pour plus de détails, voir la capture d'écran. ↩

    6. Sur les 58.3 % de votes favorables à la reprise de la série, 69.9 % de votes viennent pour la réponse "Oui, même en l'absence de la synthèse des articles" et 30.1 % de votes pour la réponse "Oui, à condition de continuer la synthèse d'une partie des articles". ↩

    7. Le lien du sondage est https://linuxfr.org/sondages/continuer-a-publier-une-serie-de-depeche-dediee-a-la-veille-generale-sur-des-intelligences-artificielles ↩

    8. Le lien de recherche par le tag dédiée est https://linuxfr.org/tags/intelligence_artificielle/public ↩

    9. La présente dépêche ne fait pas appel à des grands modèles de langage à cause de l'impopularité de ces outils parmi le public de LinuxFr.org pour la rédaction des articles. Voir le sondage suivant pour se faire une idée : https://linuxfr.org/sondages/faut-il-accepter-les-contenus-generes-par-ia-sur-linuxfr-org ↩

    10. Un personnage provenant de la BD en ligne libre https://www.peppercarrot.com/fr/ ↩

    11. Des informations détaillées concernant la BD originelle sont consignées sur https://fr.wikipedia.org/wiki/Pepper%26Carrot ↩

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    Cinéma : « L’IA est l’occasion de retrouver une part d’audace »

    Dans une tribune au « Monde », l’avocat Christophe Bettati, par ailleurs diplômé de la Fémis, estime que « les nouveaux outils n’ont jamais tué les arts » et que l’intelligence artificielle pourrait permettre des expérimentations aujourd’hui impossibles à financer.

    © DIMITAR DILKOFF/AFP

    L’une des salles du cinéma Elysees Lincoln, à Paris, le 14 novembre 2025.
    • ✇IA-Pulse
    • Moteur de recherches et IA : c’est quoi le grounding ?
      Le grounding, souvent traduit par “ancrage”, désigne l’ensemble des mécanismes qui permettent d’attacher des sources externes, récentes, identifiables et vérifiables, à une réponse générée par un modèle de langage.D’une manière générale, lorsqu’un modèle “grounde” une réponse, il ne fait pas uniquement une réponse dite paramétrique, c’est à dire qu’il ne répond pas seulement à partir de ce qu’il a appris pendant son entraînement. Il va chercher des éléments sur le web, dans un index, dans une ba

    Moteur de recherches et IA : c’est quoi le grounding ?

    15 mai 2026 à 11:17

    Le grounding, souvent traduit par “ancrage”, désigne l’ensemble des mécanismes qui permettent d’attacher des sources externes, récentes, identifiables et vérifiables, à une réponse générée par un modèle de langage.

    D’une manière générale, lorsqu’un modèle “grounde” une réponse, il ne fait pas uniquement une réponse dite paramétrique, c’est à dire qu’il ne répond pas seulement à partir de ce qu’il a appris pendant son entraînement. Il va chercher des éléments sur le web, dans un index, dans une base documentaire ou dans un graphe de connaissances, puis il construit sa réponse à partir de ces éléments. C’est ainsi qu’il “s’ancre”.

    Image générée par ChatGPT

    Dernièrement, des chercheurs de Microsoft ont ajouté un autre aspect à cette définition en formulant le grounding comme un changement de paradigme pour la recherche internet : dans la recherche par IA, il ne s’agit plus seulement de “trouver les meilleurs documents” et de les proposer sous forme de listing à un utilisateur qui doit se débrouiller pour évaluer chacun des résultats en fonction de son intentionnalité, mais de “trouver les meilleures informations capables de soutenir une réponse fiable et attribuable”. Et c’est là que le grounding devient l’élément central des changements actuels dans la façon de rechercher des informations sur internet.

    Un moteur de recherche classique renvoie une liste de pages. L’utilisateur lit, compare, évalue, doute, clique. Un moteur de recherche conversationnel fait autre chose : il lit à notre place des résultats, sélectionne des passages, les reformule, les synthétise et produit une réponse. Et dès que le système ne se contente plus de classer des liens mais commence à générer des phrases et des paragraphes, il doit être capable de montrer sur quoi il s’appuie. Le grounding c’est cette opération qui transforme une réponse générée en réponse appuyée sur des preuves.

    Google parle de grounding with Google Search pour connecter Gemini à des données publiques du web et à des informations à jour. Google utilise aussi ce système pour AI Overviews et AI Mode, qui sont les fonctionnalités IA directement intégrées au Search historique. Ces fonctionnalités ne sont pas disponibles en France, mais vous pouvez tester des fonctionnalités équivalentes sur Bing le moteur de Microsoft.

    De son coté, OpenAI décrit son web search comme un moyen de donner aux modèles accès à des informations récentes avant de produire une réponse, avec citations. Anthropic indique que Claude peut décider de chercher sur le web, répéter les recherches si nécessaire, puis répondre avec des sources citées. Perplexity met en avant un index web continuellement rafraîchi, des résultats structurés, des filtres de domaine, de langue, de région ou de date.

    Les mots varient, mais le principe est le même : avec le grounding la réponse générée n’est plus censée flotter seule, sans ancrage, elle doit être reliée à un espace documentaire et cette liaison doit être présentée sous forme de source dans la réponse.

    Sommaire :

    1. Ce qui se passe concrètement

    2. Ce que le grounding apporte

    3. Ce que le grounding ne résout pas

    4. La bonne définition

    Temps de lecture : 20 mins
    Cet article est payant.
    Vous pouvez modifier vos préférences de réception ou vous désabonner sur la page de votre compte
    La newsletter du samedi matin reste gratuite.

    Attention, il ne faut pas confondre grounding et RAG, même si les deux sont très souvent liés :

    Read more

    • ✇intelligence artificielle (IA) – The Conversation
    • Les algorithmes évolutifs, une piste pour rendre les IA plus sobres
      Les systèmes d’IA sont souvent critiqués pour leur grande consommation énergétique — à tel point que l’on se demande quelle production électrique va alimenter les data centers dont la construction est prévue à travers le monde. Mais des systèmes d’intelligence artificielle plus sobres existent. Certains s’inspirent de la stratégie évolutionniste de la nature afin d’arriver à une solution la plus simple possible pour un problème donné. Les principes de sélection naturelle théorisés par Charles

    Les algorithmes évolutifs, une piste pour rendre les IA plus sobres

    Les systèmes d’IA sont souvent critiqués pour leur grande consommation énergétique — à tel point que l’on se demande quelle production électrique va alimenter les data centers dont la construction est prévue à travers le monde. Mais des systèmes d’intelligence artificielle plus sobres existent. Certains s’inspirent de la stratégie évolutionniste de la nature afin d’arriver à une solution la plus simple possible pour un problème donné.


    Les principes de sélection naturelle théorisés par Charles Darwin ont permis l’évolution d’êtres vivants remarquablement adaptés à leurs environnements. Le cerveau humain est un exemple remarquable de résultat de cette évolution, ne consommant qu’une vingtaine de watts, soit près de 1000 fois moins qu’une intelligence artificielle le surpassant au jeu de Go. En reproduisant informatiquement ces principes évolutifs, il est possible de construire des intelligences artificielles (IA) plus sobres.

    Les progrès fulgurants des IA durant cette dernière décennie sont majoritairement dus à l’utilisation des réseaux de neurones artificiels, dits « profonds », capables d’apprendre efficacement des tâches très diverses. Seulement, l’exécution d’un tel réseau requiert la réalisation de plusieurs millions à plusieurs milliards d’opérations mathématiques par un ordinateur ; et plus la complexité d’une tâche est grande, plus la taille du réseau nécessaire pour la réaliser sera grande également.

    L’utilisation massive de réseaux de neurones profonds, toujours plus imposants pour en augmenter les capacités pose un problème de soutenabilité majeur. En effet, ces réseaux nécessitent des ressources naturelles et une énergie croissantes : il faut produire, alimenter et refroidir les processeurs exécutant ces calculs, notamment les GPU.

    Pour répondre à ce défi de soutenabilité, il est nécessaire de proposer des technologies d’IA alternatives adaptant naturellement leur complexité à celle de la tâche accomplie pour être plus sobres.

    Les approches évolutives pour l’apprentissage d’IA offrent une alternative crédible aux réseaux de neurones profonds, en étant plus sobres tout en restant performantes. En effet, contrairement aux réseaux de neurones dont la taille est fixée par un développeur avant l’entraînement, l’approche évolutive construit une IA dont la taille s’adapte minimalement à une tâche spécifique. Le résultat est une IA d’une complexité calculatoire de plusieurs centaines à milliers de fois inférieure aux réseaux de neurones, et donc naturellement plus sobre.

    Mais au fait, c’est quoi l’évolution ?

    La sélection naturelle et l’évolution reposent sur trois éléments essentiels : des individus définis par un génome, un mécanisme de reproduction, et un processus de sélection.

    En biologie, le génome de chaque être vivant est construit en assemblant des briques de bases communes à une large diversité d’espèces : l’ADN. Le génome d’un être le caractérise en tant qu’individu, déterminant bon nombre de ses traits : forme, physiologie, taille, couleurs ; et le prédispose à certains comportements, tels que la course ou la nage.

    Le mécanisme de reproduction permet à un ou plusieurs individus de donner naissance à de nouveaux individus, en copiant et en mélangeant leurs génomes. Cette copie, parfois imparfaite, crée un nouvel individu qui possède son propre génome, lui conférant des traits ressemblant à ceux de ses parents, mais possédant ses propres caractéristiques.

    Un ensemble d’individus forme une population, qui existe dans un milieu où ils sont constamment évalués par des mises à l’épreuve : recherche de nutriments, survie en milieu hostile, recherche de partenaire de reproduction. Certains traits vont rendre des individus plus performants pour ces épreuves, augmentant leur chance de survie et de reproduction, quand d’autres traits moins favorables tendront à disparaître : c’est la sélection naturelle. Génération après génération, ce long processus a mené à l’apparition sur Terre d’êtres vivants adaptés à leurs environnements.

    Depuis près de 60 ans, l’étude scientifique des algorithmes évolutionnaires a pour but de reprendre ces principes d’évolution pour l’optimisation de systèmes ou d’objets artificiels. Un exemple de cas d’usage concret est l’optimisation d’ailes d’avions, où le « génome » caractérise le profil, la longueur et la largeur d’une aile ; et où l’évaluation d’un individu (un modèle d’aile, en l’occurrence) mesure sa résistance, sa portance, et son poids.

    Comment appliquer les principes d’évolution pour construire des IA

    La programmation génétique est un domaine scientifique visant à construire des programmes informatiques, dont des IA, en appliquant ces principes évolutifs.

    Crédit Image: Nicolas Beuve

    Dans sa version la plus simple, l’« ADN » utilisé pour créer un individu est un ensemble d’instructions ou fonctions mathématiques de base : addition, multiplication, cosinus, etc. Le génome de chaque individu est ainsi une suite d’instructions, appelée programme, qui réalise des calculs sur les données de l’environnement.

    Imaginons par exemple que l’on souhaite construire une IA chargée de contrôler un robot. L’IA observe des nombres représentant la position actuelle des différents membres du robot, l’angle de ses articulations, et la vitesse de ces différents éléments. Ces nombres sont utilisés pour exécuter l’individu-programme de l’IA. Les résultats des dernières instructions constituent la réponse de l’IA à cette observation, et sont utilisés pour contrôler les différents moteurs du robot.

    Le processus évolutif débute par la création d’une population d’individus en générant de courts programmes aléatoires, une simple addition par exemple. La sélection des meilleurs programmes se fait en gardant les plus aptes à réaliser la tâche voulue, par exemple, faire avancer un robot le plus loin possible. Lors des premières générations, même les meilleurs individus sont généralement très mauvais, mais constituent le capital génétique pour la première phase de reproduction. La reproduction d’un programme peut se faire par croisement, en entremêlant les instructions issues de deux programmes parents ; ou par mutation, en reproduisant un programme existant de manière imparfaite pour ajouter ou retirer une instruction. Ce processus est ainsi répété sur de nombreuses générations, et à l’issue du processus d’évolution, le programme du meilleur individu est conservé pour être utilisé comme IA.

    Et donc, les IA obtenues par ce processus d’évolution sont plus sobres ?

    Durant le processus évolutif, le nombre d’instructions, et donc la complexité des programmes s’adapte automatiquement à la difficulté de la tâche à réaliser. En effet, l’ajout de nouvelles instructions aux génomes des individus ne perdure que si elle leur confère de meilleures aptitudes, favorisant leur survie et reproduction. Ainsi, le processus évolutif favorise naturellement l’émergence de programmes avec peu d’instructions, et pourtant bien adaptés à la tâche.

    L’utilisation de programmes ainsi construits ne nécessite pas de puce dédiée de type GPU, et peut généralement être réalisée sur des processeurs peu énergivores déjà existants, et donc plus sobres.

    Un autre avantage de l’approche évolutive : l’« interprétabilité »

    Si les réseaux de neurones traditionnels sont capables de réaliser des tâches complexes, leur grande complexité calculatoire rend souvent impossible d’interpréter les causes de leurs bons fonctionnements, ou pire, de leurs erreurs. Là encore, la brièveté des programmes issus du processus évolutif est un atout majeur, puisque cela rend possible l’interprétation claire du fonctionnement de l’IA ainsi créée.

    Un algorithme évolutionnaire est par nature facile à interpréter. Source : Quentin Vacher.

    Cette vidéo en présente un exemple, avec un programme créé pour illustrer cet article qui permet de contrôler une jambe robotique, appelé le « hopper ». Usuellement appris avec des réseaux de neurones complexes, l’évolution génétique a permis à une IA d’apprendre à faire avancer la jambe robot en utilisant des instructions très simples pour contrôler chacun des trois moteurs du robot. De fait, comprendre la causalité des actions de l’IA en fonction des observations est possible, et on voit que le programme démontre une grande logique où chaque moteur est principalement contrôlé par des membres proches de celui-ci.

    Quel avenir pour les IA issues de processus évolutifs ?

    Dans certains domaines applicatifs, les IA plus sobres issues d’un processus évolutif concurrencent les aptitudes des réseaux de neurones pour un centième (voire un millième) de leur coût, par exemple en robotique ou dans l’industrie de la cyberdéfense. Si le coût de ces IA issues du processus évolutif les rend intrinsèquement plus sobres, il faut néanmoins veiller à ce que cette sobriété ne donne pas lieu à un effet rebond, sous forme d’une utilisation encore plus massive de telles IA pour des applications où cela n’est pas strictement nécessaire.

    Ce domaine de recherche offre de nombreuses perspectives et défis à la communauté scientifique, dont la petite taille ne peut rivaliser avec les investissements colossaux autour des réseaux de neurones.

    Parmi ces défis, le passage à l’échelle des IA issues du processus évolutif qui ne parviennent pas encore à concurrencer les réseaux de neurones sur les tâches les plus complexes, telles que le contrôle de robots humanoïdes, ou le traitement du langage naturel à la base de bots conversationnels.


    Le projet foutics est soutenu par l’Agence nationale de la recherche (ANR), qui finance en France la recherche sur projets. L’ANR a pour mission de soutenir et de promouvoir le développement de recherches fondamentales et finalisées dans toutes les disciplines, et de renforcer le dialogue entre science et société. Pour en savoir plus, consultez le site de l’ANR.

    The Conversation

    Karol Desnos a reçu des financements de l'Agence Nationale de la Recherche (ANR) au titre du projet ANR-22-CE25-0005-01.

    Mickaël Dardaillon a reçu des financements de l'Agence Nationale de la Recherche (ANR) au titre du projet ANR-22-CE25-0005-01.

    Quentin Vacher a reçu des financements de l'Agence Nationale de la Recherche (ANR) au titre du projet ANR-22-CE25-0005-01.

    L’avenir de l’IA générative se joue-t-il ici ? Son plus grand défaut a peut-être été résolu

    Le 5 mai 2026, la startup américaine Subquadratic a présenté SubQ, un nouveau modèle de langage reposant sur une attention dite « sous-quadratique ». Une approche qui promet de réduire drastiquement les coûts de calcul des LLM tout en leur permettant de gérer des contextes gigantesques.

    • ✇Korben
    • Chrome installe en douce un modèle IA de 4 Go sur votre disque sans rien demander
      Alexander Hanff, consultant, a remonté un truc pas net sur Chrome. La dernière version du navigateur télécharge en arrière-plan un modèle de langage local appelé Gemini Nano, qui pèse environ 4 Go, sans jamais demander la moindre permission à l'utilisateur. Le fichier s'appelle weights.bin, il atterrit dans un dossier OptGuideOnDeviceModel quelque part dans votre profil Chrome, et il sert ensuite à des fonctions du genre "Help me write" ou détection de fraude. Hanff a documenté l'opération via l

    Chrome installe en douce un modèle IA de 4 Go sur votre disque sans rien demander

    6 mai 2026 à 12:09

    Alexander Hanff, consultant, a remonté un truc pas net sur Chrome. La dernière version du navigateur télécharge en arrière-plan un modèle de langage local appelé Gemini Nano, qui pèse environ 4 Go, sans jamais demander la moindre permission à l'utilisateur.

    Le fichier s'appelle weights.bin, il atterrit dans un dossier OptGuideOnDeviceModel quelque part dans votre profil Chrome, et il sert ensuite à des fonctions du genre "Help me write" ou détection de fraude.

    Hanff a documenté l'opération via les logs système de son macOS. Le 24 avril 2026 vers 16h38, Chrome crée le dossier. Quelques minutes plus tard, il télécharge et décompresse les 4 Go (l'opération prend une quinzaine de minutes), puis il les déplace à l'emplacement final. Tout ça pendant que vous ne touchez rien à votre machine. Si vous supprimez le fichier à la main, il sera réinstallé silencieusement au prochain lancement du navigateur.

    Hanff estime entre 100 millions et 1 milliard de machines concernées dans le monde. Multipliez 4 Go par 1 milliard et vous obtenez de quoi remplir une bonne partie d'un datacenter.

    L'auteur calcule également l'impact carbone du déploiement, entre 6 000 et 60 000 tonnes de CO2e rien que pour le réseau, sans compter l'empreinte SSD. Pour un fichier que personne ne vous a demandé d'installer.

    Sur le plan légal, Hanff parle d'une "violation directe" de l'article 5(3) de la directive ePrivacy européenne, qui interdit de stocker quoi que ce soit sur l'appareil d'un utilisateur sans consentement explicite. Il évoque aussi un manquement RGPD. Si la qualification tient, ça serait une amende salée pour Google, sachant que les Cnil européennes ont déjà sanctionné Meta et Microsoft pour des choses bien moins foireuses.

    Pour s'en débarrasser, trois options : aller dans chrome://flags pour désactiver les fonctions IA, passer par les politiques d'entreprise si vous gérez un parc de machines, ou virer Chrome, tout simplement.

    Bref, Google qui pousse 4 Go d'IA en silence sur des centaines de millions de machines, c'est un sale moche.

    Source : That Privacy Guy

    Les « world models », lorsque l’intelligence artificielle apprend à comprendre le monde

    Les systèmes d’intelligence artificielle générative, qui parlent si bien, ne comprennent pas encore le monde. De nouvelles méthodes physiques ou statistiques comme les world models, ou « modèles de monde », permettraient de les doter d’une forme de sens commun, qui leur servirait à mieux simuler la réalité et de mieux interagir avec elle.


    Imaginez un enfant qui, après avoir vu une balle rouler derrière un canapé, sait instinctivement qu’elle continue d’exister et peut anticiper l’endroit précis où elle réapparaîtra. Cette capacité fondamentale, que la psychologie appelle la permanence de l’objet, constitue un socle de l’intelligence humaine. Nous ne nous contentons pas de réagir aux images qui frappent notre rétine ; nous simulons en permanence le futur dans notre esprit.

    Aujourd’hui, l’intelligence artificielle tente de franchir ce cap décisif. Après l’ère des modèles capables de générer du texte, comme ChatGPT, ou des images, comme Midjourney, une nouvelle frontière se dessine avec les world models (« modèles de monde »). L’enjeu est de taille : il s’agit de doter les machines d’une forme de sens commun physique, spatial et logique pour qu’elles cessent d’imiter… et commencent enfin à comprendre.


    À lire aussi : L’esprit est-il une machine prédictive ? Introduction à la théorie du cerveau bayésien


    Ces modèles montrent d’ores et déjà des résultats prometteurs en laboratoire ou dans des environnements simulés. Néanmoins, leur maturité reste limitée et leur déploiement réel est encore restreint aujourd’hui.

    Pourquoi les IA actuelles restent-elles en partie limitées ?

    Les systèmes d’IA les plus célèbres aujourd’hui sont des modèles génératifs, à l’instar de Claude ou de ChatGPT. Ceux-ci excellent à prédire le mot suivant dans une phrase ou le pixel suivant dans une image, en s’appuyant sur des corrélations statistiques monumentales.

    À partir de cette idée de base, les premières preuves mesurables de raisonnement et de bon sens fonctionnel ont été observées dans l’histoire de l’intelligence artificielle (IA). Cependant, comme le soulignent régulièrement des chercheurs du domaine, tels que Yann Le Cun, directeur scientifique d’AMI Labs ou Fei-Fei Li, directrice scientifique de Worldlabs, ces modèles n’ont pas de représentation interne cohérente de la réalité physique.

    C’est ce qui explique notamment leurs fameuses hallucinations : un modèle de langage peut affirmer avec une assurance totale qu’un œuf de vache est un ingrédient de cuisine classique, simplement parce qu’il manipule des concepts sans comprendre pleinement les contraintes biologiques du monde réel. Pour dépasser ce stade de « perroquet stochastique » (« stochastique » désignant un phénomène ou un modèle qui intègre le hasard de manière structurée, comme un calcul de probabilités où l’imprévu devient une donnée clé), l’IA doit intégrer une architecture capable de modéliser les causes et les effets.

    Cette ambition n’est pas nouvelle, mais elle bénéficie aujourd’hui d’un alignement technologique inédit. Dès 1943, le neuroscientifique Kenneth Craik suggérait déjà que le cerveau humain fonctionne en construisant des modèles de petite échelle de la réalité pour anticiper les événements. Ainsi, lorsque l’on traverse la rue, notre cerveau imagine d’avance la trajectoire des voitures pour savoir quand il est sûr de passer.

    Ce qui a changé depuis, c’est que nous disposons de la puissance de calcul et des cadres mathématiques suffisants pour tester cette hypothèse à l’échelle de machines complexes. L’intérêt pour ces modèles a notamment explosé après les travaux pionniers de David Ha et Jürgen Schmidhuber, en 2018. Ils ont montré qu’une IA pouvait apprendre à conduire dans un environnement virtuel en s’entraînant presque exclusivement dans ses propres « rêves ». Ces « rêves » correspondent à une simulation interne, créée par l’IA elle-même, qui lui permet de tester différentes stratégies sans interagir avec le monde réel.

    L’architecture des modèles de monde

    Ces auteurs ont introduit la notion de « modèle de monde » : une représentation interne et structurée d’un environnement qui permet à un agent d’anticiper les conséquences de ses actions. Le modèle virtuel synthétise l’information observable pour construire une version abstraite et manipulable du monde réel, facilitant la planification, la simulation et la prise de décision, même dans des situations complexes ou incertaines. Sur le plan technique, un modèle de monde repose sur une mécanique de compression de l’information et de prédiction.

    Plutôt que de se contenter d’identifier des objets comme « chat » ou « balle » après apprentissage, un modèle de monde apprend à représenter le monde de manière plus riche et structurée.

    Dans un premier temps, le système observe d’énormes quantités de données et en extrait une représentation compacte des dynamiques essentielles, par exemple la trajectoire d’un objet, la rigidité d’une surface ou les interactions spatiales entre plusieurs éléments (la patte du chat qui joue avec la balle). Cette abstraction ne se limite pas à des labels : elle capture des régularités physiques et logiques du monde.

    Dans un second temps, le modèle peut simuler des scénarios futurs en utilisant cette représentation (la balle passe sous un fauteuil et le chat essaye de la dégager). Ainsi, si l’agent doté du modèle de monde précédemment décrit envisage une action, elle peut prédire ses conséquences avant même de l’exécuter, dans un environnement potentiellement incertain ou bruité.

    Autrement dit, contrairement à la simple classification statistique « ceci est un chat », le modèle de monde apprend une sorte de mini-simulation interne du monde, qui combine perception, compréhension spatiale et logique, et capacité à anticiper.

    Ici, l’approche reste statistique, similaire à l’apprentissage par renforcement, mais sans recours direct à des modèles physiques explicites ; elle se fonde uniquement sur les régularités observées dans les données (les balles qui roulent sous les objets en ressortent ou y restent coincées). Cette distinction entre approches statistique et physique devient importante lorsqu’on aborde des environnements complexes et incertains, où les prédictions doivent intégrer la variabilité naturelle du monde réel.


    À lire aussi : Des pistes pour une IA digne de confiance : mélanger expertises humaines et apprentissage automatique


    Plusieurs propositions récentes illustrent le potentiel de l’approche statistique des modèles de monde. Le modèle V-JEPA de Meta apprend, par exemple, à comprendre les interactions physiques complexes en regardant simplement des vidéos, sans aucun étiquetage humain. De son côté, Google DeepMind a récemment dévoilé Genie, une architecture capable de créer des mondes virtuels interactifs à partir d’une simple photographie, prouvant que la machine a assimilé auparavant les lois de la physique et de la perspective.

    Des applications qui touchent la société

    Les répercussions de cette technologie sont massives et dépassent largement le cadre de l’informatique théorique.

    En robotique, par exemple, un agent équipé d’un modèle du monde pourrait apprendre à manipuler des objets fragiles ou à se déplacer dans un entrepôt encombré sans passer par des milliers d’heures d’essais physiques coûteux et risqués.

    Dans le secteur des véhicules autonomes, des pionniers, comme Wayve, affirment utiliser des modèles du monde pour que les voitures anticipent les comportements difficiles à prévoir des piétons ou des autres conducteurs, là où les systèmes classiques se contenteraient de réagir avec un temps de retard.

    Dans le domaine de la santé, les jumeaux numériques sont encore en phase d’exploration et servent à simuler comment une maladie pourrait évoluer en réponse à un traitement expérimental. Toutefois, ces modèles ne donnent pas des prédictions certaines : ils sont dits « probabilistes », ce qui signifie qu’ils reposent sur des calculs de probabilités. Autrement dit, ils estiment plusieurs évolutions possibles d’un patient (amélioration, stabilité, aggravation) et attribuent à chacune une chance de se produire, en fonction des données disponibles et de modèles statistiques. Par conséquent, ces simulations restent des estimations, et non des certitudes. Elles doivent donc être validées avec beaucoup de rigueur, en particulier lorsqu’elles concernent des traitements qui n’ont encore jamais été testés en conditions cliniques réelles.

    Les progrès de l’IA nous amènent à repenser ce que signifie réellement « comprendre » et « anticiper » dans un monde complexe. À terme, explorer ces questions pourrait non seulement transformer la technologie, mais aussi notre manière d’appréhender la cognition et la créativité humaines.

    Il est important de nuancer l’enthousiasme autour de ces modèles. En dépit des avancées, celles-ci demeurent pour l’instant à l’échelle de la recherche et du développement. Par exemple, dans la robotique et les véhicules autonomes, la majorité des applications sont encore à l’état de prototypes ou de pilotes contrôlés, souvent dans des environnements très structurés.

    L’adoption à grande échelle nécessitera de surmonter des défis techniques et réglementaires majeurs, comme la robustesse face à des situations imprévues ou la sécurité dans des contextes réels complexes. Ainsi, ces modèles sont en phase d’expérimentation avancée, et non opérationnels partout et tout le temps – même si leurs perspectives restent très prometteuses.

    The Conversation

    Julien Perez est membre de bpifrance, directeur de la recherche en AI.

    Les acteurs de doublage se battent pour ne pas se faire « piller » leur voix par l’IA

    De nombreuses zones grises dans la législation française pénalisent ces comédiens alors que l’offensive des plateformes d’intelligence artificielle anglo-saxonnes s’accélère.

    © Colcanopa

    Des manchots pour dompter l’IA ? Cette méthode casse le mystère derrière l’effet « boîte noire »

    La plupart des algorithmes performants actuels – notamment l’apprentissage profond (deep learning) et ses réseaux de neurones – fonctionnent comme des boîtes noires. On sait qu’ils donnent de bons résultats, mais impossible de comprendre leur logique interne. Ceci pose problème pour de nombreux domaines d’application (médecine, justice…), ce qui incite les régulateurs à exiger des systèmes « explicables ». Plusieurs pistes vers l’explicabilité existent. Zoom sur la « prétopologie ».

    « Plante un clou dans le miroir et récite le Psaume 91 à l’envers » : une étude recense les IA les plus enclines à nourrir les spirales délirantes

    C'est un benchmark d’un nouveau genre. Selon une étude scientifique publiée le 23 avril 2026, certains modèles de langage (LLM) peuvent activement renforcer les croyances délirantes de leurs utilisateurs. Les écarts de comportement sont considérables d’un modèle à l’autre.

    • ✇LEBIGDATA.FR
    • Elephant Alpha : quelle est cette IA qui a pris la 1ère place en quelques jours ?
      Des tendances OpenRouter montrent qu’Elephant Alpha s’est invité tout en haut des classements IA en un temps record. Gratuit, puissant et déjà massivement utilisé, ce modèle intrigue autant qu’il fascine les développeurs. OpenRouter a lancé Elephant Alpha le 13 avril, sans grande annonce tapageuse. Et pourtant, le résultat a surpris tout le secteur. En quelques jours seulement, ce modèle d’IA s’est hissé en tête des usages mesurés sur la plateforme. C’est un exploit rapide, basé sur l’activit

    Elephant Alpha : quelle est cette IA qui a pris la 1ère place en quelques jours ?

    Par : Tinah F.
    17 avril 2026 à 17:38

    Des tendances OpenRouter montrent qu’Elephant Alpha s’est invité tout en haut des classements IA en un temps record. Gratuit, puissant et déjà massivement utilisé, ce modèle intrigue autant qu’il fascine les développeurs.

    OpenRouter a lancé Elephant Alpha le 13 avril, sans grande annonce tapageuse. Et pourtant, le résultat a surpris tout le secteur. En quelques jours seulement, ce modèle d’IA s’est hissé en tête des usages mesurés sur la plateforme. C’est un exploit rapide, basé sur l’activité réelle de millions d’utilisateurs. Mais comment une IA aussi récente a-t-elle pu grimper si vite ?

    Que fait réellement cette IA Elephant Alpha ?

    Elephant Alpha ne se contente pas de générer du texte classique. Le modèle vise surtout les usages lourds, là où la longueur et la précision comptent.

    Derrière ce nom, on retrouve un système de 100 milliards de paramètres, conçu pour absorber des tâches complexes sans perdre le fil. OpenRouter le décrit comme un modèle textuel pensé pour les workflows d’agents et les environnements techniques.

    Ok this is kind of wild.

    A mystery 100B model just appeared at the top of OpenRouter out of nowhere.

    No model card. No announcement. No idea which lab made it.

    It's called Elephant Alpha and it's already beating half the paid models on the leaderboard. pic.twitter.com/0Z0UdVlrlf

    — Hasan Toor (@hasantoxr) April 17, 2026

    Son point fort se situe dans sa fenêtre de contexte de 256 000 jetons. Concrètement, il peut analyser d’énormes documents ou des bases de code en une seule requête. Cela évite de découper les contenus en plusieurs morceaux, ce qui change la fluidité d’utilisation.

    Elephant Alpha intègre aussi des appels de fonctions. Cette capacité lui permet de dialoguer avec des outils externes, comme des API ou des systèmes automatisés. Ainsi, il ne reste pas bloqué dans une simple conversation, il agit dans des chaînes de traitement.

    Comment l’IA a très rapidement pu gagner un tel titre ?

    Elephant Alpha n’a pas grimpé au sommet grâce à une annonce spectaculaire ni une campagne marketing massive. Son ascension repose l’usage réel mesuré par OpenRouter. 

    La plateforme suit les modèles selon le nombre de jetons consommés par les utilisateurs. Autrement dit, plus un modèle est utilisé dans des requêtes réelles, plus il monte dans le classement.

    BREAKING: Stealth model Elephant-alpha reaches #1 on OpenRouter Trending.

    The ranking is based on real token consumption across OpenRouter—reflecting actual developer usage, not benchmarks or subjective evals.

    Signal: rapid adoption and growing traction in live environments.… pic.twitter.com/yCyYzOhwij

    — Tulsi Soni (@shedntcare_) April 17, 2026

    En plus, son accès immédiat via API et sa gratuité temporaire ont déclenché une adoption massive. Ainsi, des milliers de développeurs ont commencé à le tester en continu. Les intégrations dans des outils comme des environnements de développement et des agents IA ont accéléré ce phénomène.

    Ce qui est intéressant, c’est que le modèle cible aussi des usages précis comme le code, la finance ou le droit. Il s’oriente donc vers des tâches structurées, où la logique et la cohérence priment sur la créativité pure.

    Un autre point clé est son optimisation qui vise à réduire la consommation de jetons. De ce fait, les réponses arrivent plus vite et coûtent moins de ressources. Enfin, Elephant Alpha reste un modèle textuel pur. Il ne gère ni image ni audio, ce qui le concentre entièrement sur l’efficacité écrite et l’analyse de contenu.

    Cet article Elephant Alpha : quelle est cette IA qui a pris la 1ère place en quelques jours ? a été publié sur LEBIGDATA.FR.

    Codage agentique, raisonnement préservé, un million de tokens : Qwen3.6-35B-A3B redessine le plafond de l'IA open source pour les devs, malgré plusieurs départs d'ingénieurs clés qui ont quitté le projet

    Codage agentique, raisonnement préservé, un million de tokens : Qwen3.6-35B-A3B redessine le plafond de l'IA open source pour les développeurs,
    malgré plusieurs départs d'ingénieurs clés qui ont quitté le projet

    Quelques semaines après une crise interne qui avait fait craindre le pire pour son avenir, la famille Qwen d'Alibaba revient avec un modèle de code aussi ambitieux que symbolique. Le Qwen3.6-35B-A3B incarne une architecture MoE (mixture d'experts) optimisée pour la programmation agentique...

    • ✇PandIA
    • Comment utiliser l’IA pour améliorer la qualité de votre code (revue automatique, débogage, tests et documentation)
      L’utilisation d’outils d’IA dans le développement logiciel n’est plus un gadget : bien intégrés, ces outils deviennent de véritables assistants techniques capables d’augmenter la qualité du code, d’accélérer les revues, de simplifier le débogage, de générer des tests pertinents et de maintenir une documentation à jour. Encore faut-il savoir les utiliser correctement, comprendre leurs limites et les intégrer dans un flux de travail rigoureux.Ce guide détaille des approches concrètes pour exploite

    Comment utiliser l’IA pour améliorer la qualité de votre code (revue automatique, débogage, tests et documentation)

    Par : 0xMonkey
    16 avril 2026 à 14:06
    Comment utiliser l’IA pour améliorer la qualité de votre code (revue automatique, débogage, tests et documentation)

    L’utilisation d’outils d’IA dans le développement logiciel n’est plus un gadget : bien intégrés, ces outils deviennent de véritables assistants techniques capables d’augmenter la qualité du code, d’accélérer les revues, de simplifier le débogage, de générer des tests pertinents et de maintenir une documentation à jour. Encore faut-il savoir les utiliser correctement, comprendre leurs limites et les intégrer dans un flux de travail rigoureux.

    Ce guide détaille des approches concrètes pour exploiter l’IA sur l’ensemble du cycle de vie du code, sans sacrifier l’exigence de qualité ni la sécurité.

    ---

    1. Comprendre ce que l’IA apporte réellement à la qualité du code

    Les forces des outils d’IA pour développeurs

    Les modèles d’IA modernes (type GPT-4, Claude, CodeWhisperer, GitHub Copilot…) sont particulièrement efficaces pour :

    - Analyser rapidement de grandes bases de code

    Identifier des motifs répétitifs, des duplications, des incohérences de style, des fonctions complexes ou mal structurées.

    - Suggérer des améliorations de lisibilité et d’architecture

    Proposer des refactorings, simplifier des fonctions, améliorer des noms de variables, réorganiser des modules.

    - Repérer des erreurs probables

    Erreurs de logique, d’API, de typage, d’edge cases oubliés, cas de concurrence ou d’utilisation de ressources.

    - Générer du code auxiliaire

    Tests unitaires, scripts de migration, fonctions de log, exemples d’utilisation d’API.

    - Produire ou améliorer de la documentation

    Commentaires de fonctions, README, guides d’API, notes de conception.

    Les limites à garder en tête

    Malgré leurs capacités, ces outils restent :

    - Probabilistes, pas infaillibles

    L’IA génère ce qui ressemble à une bonne solution, mais ne garantit ni l’exactitude, ni la sécurité, ni la performance.

    - Dépendants du contexte fourni

    Sans le bon extrait de code, la bonne description métier ou le bon environnement de projet, les suggestions seront incomplètes ou hors sujet.

    - Ignorants des contraintes spécifiques

    Règles internes de qualité, politiques de sécurité, exigences légales, contraintes de performance ou d’architecture peuvent être ignorées si elles ne sont pas explicitées.

    - Potentiellement verboses ou trop sûrs d’eux

    Une réponse bien formulée peut donner une impression trompeuse de fiabilité.

    La règle d’or : l’IA doit soutenir le jugement du développeur, jamais le remplacer. Chaque suggestion doit être validée, testée et intégrée dans un processus de qualité existant.

    ---

    2. Mettre en place un environnement d’IA adapté au développement

    Choisir les bons outils d’IA

    Plusieurs catégories d’outils peuvent être combinées :

    - Assistants de complétion de code dans l’IDE

    GitHub Copilot, Codeium, Tabnine, Amazon CodeWhisperer, etc.

    Utiles pour : suggestions en temps réel, snippets, complétion de tests.

    - Assistants conversationnels généralistes avec capacité code

    ChatGPT (avec code interpreter), Claude, etc.

    Utiles pour : revues approfondies, refactoring, explications, génération de documentation, débogage guidé.

    - Outils spécialisés QA / revue de code

    SonarLint, SonarQube, DeepCode (Snyk Code), etc.

    Utiles pour : détection systématique de code smells, vulnérabilités, non-respect des règles de style.

    - Intégrations CI/CD

    Plugins IA pour GitHub Actions, GitLab CI, Azure DevOps, solutions SaaS de revue automatique.

    Combiner un assistant génératif avec des outils d’analyse statique classiques offre un bon équilibre entre créativité et rigueur.

    Précautions de confidentialité et de sécurité

    Avant d’envoyer du code à un service d’IA hébergé :

    1. Vérifier les conditions d’utilisation

    - Le fournisseur réutilise-t-il le code pour entraîner ses modèles ?

    - Existe-t-il une option “enterprise” avec isolation des données ?

    2. Limiter les données sensibles

    - Éviter de transmettre des secrets (clés API, mots de passe, certificats).

    - Masquer les données personnelles ou propriétaires si possible.

    3. Utiliser des environnements self-hosted si nécessaire

    - Modèles déployés on-premise ou sur un cloud privé pour le code le plus sensible.

    4. Définir des règles internes

    - Quand et comment l’IA peut être utilisée.

    - Quels types de fichiers ne doivent jamais être partagés.

    ---

    3. Utiliser l’IA pour la revue de code

    Préparer une revue de code assistée par IA

    Pour tirer réellement parti d’un assistant IA en revue de code :

    1. Fournir un contexte minimal

    - Langage, framework, architecture (monolithe, microservices, etc.).

    - Objectif du module ou de la fonctionnalité.

    - Contraintes (performance, sécurité, compatibilité).

    2. Limiter la taille de l’extrait

    - Se concentrer sur un fichier, une PR ou un module cohérent.

    - Si le contexte est trop volumineux, le découper et fournir un résumé.

    3. Préciser les critères de revue

    - Lisibilité et maintenabilité

    - Respect des conventions de style

    - Performance

    - Sécurité (injection SQL, XSS, validation d’entrée, etc.)

    - Couverture de cas limites

    Plus la demande est ciblée, plus les retours sont exploitables.

    Obtenir une revue structurée et exploitable

    Pour une revue utile, demander explicitement une structure de sortie, par exemple :

    - Résumé général

    Points forts et points faibles.

    - Problèmes majeurs (blockers)

    Bugs probables, failles de sécurité, violations de design critiques.

    - Problèmes mineurs

    Nommage, duplication, style, petites optimisations.

    - Suggestions de refactoring

    Fonctions trop longues, responsabilités multiples, patterns mieux adaptés.

    - Cas de tests manquants

    Scénarios à couvrir (erreurs, limites, volume, concurrence).

    Les retours de l’IA peuvent ensuite être triés et intégrés dans le processus de revue classique (pull request, commentaires dans Git, tickets).

    Bonnes pratiques en revue de code avec IA

    - Confronter systématiquement les remarques de l’IA à l’avis humain

    Un reviewer humain reste décisionnaire.

    - Exiger des justifications

    Demander à l’IA d’expliquer pourquoi un point pose problème (normes, patterns connus, risques potentiels).

    - Adapter les propositions à la culture du projet

    L’IA ne connaît pas les conventions internes à moins de les fournir. Indiquer les règles de style (par exemple PEP8, conventions internes Java, guide frontend maison).

    - Éviter la sur-optimisation prématurée

    L’IA propose parfois des optimisations micro-performances inutiles au détriment de la lisibilité. Prioriser la clarté.

    ---

    4. Accélérer le débogage grâce à l’IA

    Tirer parti de l’IA devant un bug concret

    En présence d’un bug, le rôle de l’IA est d’aider à :

    - Comprendre le problème

    - Formuler des hypothèses

    - Proposer des pistes de reproduction et de correction

    Approche recommandée :

    1. Décrire le contexte du bug

    - Ce qui est attendu vs ce qui se produit réellement.

    - Environnement (version de langage, framework, OS, base de données).

    - Étapes pour reproduire si connues.

    2. Fournir les éléments pertinents

    - Extrait de code impliqué (fonction, classe, endpoint).

    - Log d’erreur ou stack trace.

    - Inputs typiques.

    3. Demander plusieurs hypothèses

    - Demander explicitement : “liste de causes possibles, classées par probabilité”.

    4. Demander des stratégies de diagnostic

    - Ajouts de logs ciblés.

    - Assertions.

    - Tests de reproduction isolés.

    - Outils de profiling ou de tracing.

    Exemple de stratégie avec IA pour un bug complexe

    Une approche systématique peut être :

    1. Identifier le module ou la zone suspecte.

    2. Demander à l’IA :

    - D’expliquer en langage naturel ce que fait la fonction.

    - De pointer des comportements non évidents ou dangereux.

    3. Introduire un cas d’entrée problématique et demander :

    - Comment le code actuel va le gérer étape par étape.

    - Où un décalage avec le comportement attendu apparaît.

    4. Faire valider par l’IA la correction envisagée :

    - Impact potentiel sur d’autres parties du système.

    - Cas limites à tester.

    Mises en garde en débogage assisté par IA

    - Rester méfiant face aux “corrections magiques”

    Un patch suggéré peut masquer le symptôme sans adresser la cause profonde.

    - Vérifier la compatibilité avec l’écosystème réel

    L’IA peut proposer des méthodes ou des APIs qui n’existent pas dans la version du framework utilisée.

    - Documenter le raisonnement

    Noter l’hypothèse validée, la cause racine et les tests ajoutés. L’IA peut aider à rédiger cette note de post-mortem.

    ---

    5. Générer et améliorer les tests avec l’IA

    Faire générer des tests unitaires pertinents

    L’IA est particulièrement utile pour :

    - Proposer des cas de tests à partir d’une fonction ou d’une méthode.

    - Couvrir des cas limites (valeurs nulles, extrêmes, listes vides, erreurs réseau).

    - Écrire la structure de tests (nom des tests, arrange/act/assert, données de test réalistes).

    Approche suggérée :

    1. Fournir :

    - La fonction ou la classe à tester.

    - Le framework de test utilisé (JUnit, pytest, Jest, PHPUnit, etc.).

    - Les conventions internes (naming, patterns de mocks, use de fixtures).

    2. Demander :

    - Une liste de scénarios de test décrits en texte.

    - Puis, pour les scénarios validés, la génération de tests unitaires correspondants.

    3. Réviser et adapter :

    - Vérifier que les tests reflètent bien le comportement souhaité, pas celui supposé par l’IA.

    - Simplifier ou factoriser si besoin (fixtures, helpers).

    Couvrir les cas d’erreur et les conditions extrêmes

    Les IA sont souvent plus complètes que les humains pour :

    - Imaginer des entrées invalides ou inattendues.

    - Tester les comportements en cas de :

    - Temps d’attente réseau

    - Réponses incomplètes

    - Pannes de dépendances (base de données, cache, API externe).

    Pour en tirer parti :

    - Demander explicitement des tests de robustesse et non seulement des tests du “happy path”.

    - Insister sur la gestion des exceptions, la validation des arguments, la résilience aux indisponibilités partielles.

    Génération de tests d’intégration et end-to-end

    Pour les tests d’intégration :

    - L’IA peut aider à :

    - Définir les scénarios utilisateurs clés.

    - Proposer des jeux de données réalistes.

    - Esquisser des scripts de test (par exemple pour Cypress, Playwright, Selenium).

    - Limites :

    - Nécessité de connaître en détail le contexte de déploiement et l’architecture.

    - Besoin de synchronisation avec la réalité (endpoints, routes, schémas de données).

    La validation humaine reste essentielle pour éviter des tests trop fragiles ou trop couplés à l’implémentation.

    Mesurer et améliorer la couverture avec l’IA

    Les outils d’IA ne remplacent pas la mesure de couverture (coverage reports) via les outils habituels, mais peuvent :

    - Analyser un rapport de couverture et :

    - Pointer des zones critiques non couvertes (authentification, billing, sécurité).

    - Proposer des cas de tests supplémentaires pour les couvrir.

    - Aider à décider :

    - Quels modules doivent viser une couverture plus élevée.

    - Où accepter une couverture plus faible (code généré, couches très simples).

    ---

    6. Améliorer la documentation grâce à l’IA

    Générer des commentaires de code de qualité

    Utiliser l’IA pour :

    - Proposer des docstrings ou commentaires pour fonctions, classes et modules.

    - Clarifier des parties complexes, en expliquant :

    - Le rôle de la fonction.

    - La signification des paramètres et valeurs de retour.

    - Les effets de bord éventuels.

    - Les préconditions et postconditions.

    Bonnes pratiques :

    1. Fournir une explication métier en plus du code quand c’est possible.

    2. Exiger des commentaires :

    - Concis

    - Précis

    - Orientés sur le “pourquoi” plutôt que le “comment” (que le code montre déjà).

    3. Revoir manuellement chaque commentaire :

    - Corriger les approximations métier.

    - S’assurer que les noms utilisés correspondent à la terminologie du domaine.

    Rédiger et maintenir la documentation technique

    L’IA peut accélérer la création de :

    - README de projets et de sous-modules.

    - Guides d’API (endpoints, payloads, exemples).

    - Guides d’installation et de déploiement.

    - Notes de conception (design docs, ADR – Architecture Decision Records).

    Méthode efficace :

    1. Fournir :

    - Un extrait représentatif du code ou des fichiers de configuration.

    - Une description textuelle de l’objectif du composant.

    - Les contraintes clés (scalabilité, sécurité, dépendances).

    2. Demander :

    - Une première version de documentation structurée.

    - Une section “Exemples d’utilisation”.

    - Une section “Limitations connues” et “Points d’attention”.

    3. Ajuster :

    - Adapter le ton et le niveau de détail à l’audience cible (développeurs internes, clients, ops).

    - Compléter avec les aspects non visibles dans le code (organisationnels, légaux, SLA, etc.).

    Synchroniser documentation et code

    La documentation devient vite obsolète. L’IA peut contribuer à limiter ce phénomène :

    - En comparant :

    - Une version de documentation.

    - Le code actuel.

    - En identifiant :

    - Les différences (noms de fonctions/params, endpoints, comportements).

    - Les parties devenues inexactes ou incomplètes.

    - En proposant :

    - Une mise à jour ciblée des paragraphes concernés, plutôt qu’une réécriture complète.

    ---

    7. Encadrer l’utilisation de l’IA par des bonnes pratiques d’équipe

    Définir une “charte IA” pour le développement

    Pour un usage sain et efficace, il est utile d’expliciter :

    - Les cas d’usage encouragés

    - Aide à la revue de code.

    - Génération de tests.

    - Documentation.

    - Brainstorming d’architectures.

    - Les limites

    - Pas d’acceptation aveugle de code généré.

    - Validation obligatoire pour toute modification de sécurité, de cryptographie, d’authentification.

    - Interdiction d’envoyer certains fichiers (config sensibles, données clients).

    - Les exigences de traçabilité

    - Indiquer dans les PR quand du code a été largement généré ou influencé par IA.

    - Discuter en revue des choix suggérés par l’IA, comme n’importe quelle contribution.

    Intégrer l’IA dans le flux de travail existant

    Quelques repères :

    - Ne pas court-circuiter la revue humaine

    L’IA assiste, mais chaque PR doit avoir un ou plusieurs reviewers humains responsables.

    - Utiliser l’IA en amont des PR

    - Nettoyer le code, clarifier la structure, ajouter des tests.

    - Ainsi, les reviewers humains se concentrent sur la logique métier et les choix d’architecture.

    - Mettre l’IA dans la CI/CD avec discernement

    - Automatiser des retours sur style, duplications, cas évidents.

    - Garder les checks bloquants pour les règles les plus importantes (sécurité, standards critiques).

    Former les développeurs à un usage critique

    Un usage efficace nécessite des compétences spécifiques :

    - Savoir “prompt-er” correctement

    - Donner le bon contexte.

    - Formuler des demandes précises.

    - Demander des alternatives et des justifications.

    - Développer un esprit critique renforcé

    - Détecter les hallucinations techniques.

    - Confronter aux standards du projet, aux docs officielles, aux RFC et aux spécifications.

    - Partager les bonnes pratiques en équipe

    - Exemples de prompts efficaces.

    - Cas où l’IA a permis de trouver un bug subtil ou d’améliorer significativement un module.

    - Cas où les suggestions étaient erronées et pourquoi.

    ---

    8. Points clés à retenir

    - L’IA est un multiplicateur de productivité, pas un substitut au jugement humain.

    Chaque suggestion doit être revue, comprise et testée.

    - Une bonne utilisation commence par un bon contexte.

    Préciser le langage, le framework, le rôle du code et les contraintes permet d’obtenir des retours pertinents.

    - Pour la revue de code, l’IA excelle sur la lisibilité, les patterns, les cas évidents, mais ne doit pas décider des choix d’architecture ni des compromis métier.

    - En débogage, l’IA est utile comme partenaire de raisonnement : génération d’hypothèses, plan de diagnostic, proposition de tests de reproduction.

    - Pour les tests, l’IA aide à couvrir plus largement le spectre des cas, notamment les cas limites et les scénarios d’erreur, à condition de garder la main sur les invariants métier.

    - En documentation, l’IA est très efficace pour produire des drafts de qualité, mais le contenu métier, les décisions d’architecture et les contraintes non visibles dans le code doivent être ajoutés et validés par les équipes.

    - Un cadre d’équipe clair (charte IA) est essentiel pour canaliser l’usage, protéger les données sensibles et intégrer ces outils dans un flux de travail rigoureux.

    En intégrant progressivement ces pratiques, l’IA devient un véritable assistant d’ingénierie, capable d’élever la qualité globale du code, de réduire la dette technique et de libérer du temps pour les tâches à plus forte valeur ajoutée : conception, architecture et compréhension approfondie du métier.

    Telegram lance Cocoon, un réseau d'IA décentralisé et confidentiel sur la blockchain TON, comme alternative plus privée et plus rentable aux services informatiques d'IA centralisés

    Telegram lance Cocoon, un réseau d'IA décentralisé et confidentiel sur la blockchain TON, comme alternative plus privée et plus rentable aux services informatiques d'IA centralisés

    Telegram a récemment lancé un réseau informatique d'IA décentralisé et confidentiel sur la blockchain TON, appelé Cocoon. Le projet est présenté comme une alternative plus confidentielle et plus rentable aux services informatiques centralisés d'IA proposés par des fournisseurs tels que Microsoft et Amazon qui, selon le...

    • ✇LinuxFr.org : les dépêches
    • Nouvelles sur l’IA de octobre 2025
      L’intelligence artificielle (IA) fait couler de l’encre sur LinuxFr.org (et ailleurs). Plusieurs personnes ont émis grosso-modo l’opinion : « j’essaie de suivre, mais c’est pas facile ». Je continue donc ma petite revue de presse mensuelle. Disclaimer : presque aucun travail de recherche de ma part, je vais me contenter de faire un travail de sélection et de résumé sur le contenu hebdomadaire de Zvi Mowshowitz (qui est déjà une source secondaire). Tous les mots sont de moi (n’allez pas taper Zv

    Nouvelles sur l’IA de octobre 2025

    L’intelligence artificielle (IA) fait couler de l’encre sur LinuxFr.org (et ailleurs). Plusieurs personnes ont émis grosso-modo l’opinion : « j’essaie de suivre, mais c’est pas facile ».

    Je continue donc ma petite revue de presse mensuelle. Disclaimer : presque aucun travail de recherche de ma part, je vais me contenter de faire un travail de sélection et de résumé sur le contenu hebdomadaire de Zvi Mowshowitz (qui est déjà une source secondaire). Tous les mots sont de moi (n’allez pas taper Zvi si je l’ai mal compris !), sauf pour les citations : dans ce cas-là, je me repose sur Claude pour le travail de traduction. Sur les citations, je vous conseille de lire l’anglais si vous pouvez : difficile de traduire correctement du jargon semi-technique. Claude s’en sort mieux que moi (pas très compliqué), mais pas toujours très bien.

    Même politique éditoriale que Zvi : je n’essaierai pas d’être neutre et non-orienté dans la façon de tourner mes remarques et observations, mais j’essaie de l’être dans ce que je décide de sélectionner ou non.

    Sommaire

    Résumé des épisodes précédents

    Petit glossaire de termes introduits précédemment (en lien : quand ça a été introduit, que vous puissiez faire une recherche dans le contenu pour un contexte plus complet) :

    • System Card : une présentation des capacités du modèle, centrée sur les problématiques de sécurité (en biotechnologie, sécurité informatique, désinformation…).
    • Jailbreak : un contournement des sécurités mises en place par le créateur d’un modèle. Vous le connaissez sûrement sous la forme "ignore les instructions précédentes et…".

    Des nouveautés sur la génération de vidéos

    OpenAI publie Sora 2, son modèle de génération de vidéo, qui produit des scènes d’environ dix secondes à partir d’un prompt textuel. Cette publication pose deux questions : celle des deepfakes, et celle du copyright.

    Sur les deepfakes, OpenAI a annoncé bloquer la génération de vidéos impliquant des personnalités publiques, sauf si ces dernières s’inscrivent sur une liste acceptant cet usage (vous pouvez par exemple générer une vidéo contenant Sam Altman, qui s’est inscrit sur cette liste).

    Sur la propriété intellectuelle, la logique est inversée : initialement, les ayants droits étaient appelés à « se rapprocher d’OpenAI » pour que leur création ne puisse pas être réutilisée par Sora. C’était un pari très audacieux : si le consensus juridique se dirige sur le caractère légal (« fair use ») d’utiliser des données publiques pour entraîner une IA, réutiliser la propriété intellectuelle d’autrui entre dans le cadre des œuvres dérivées, bien plus contraignant ; la plupart des commentateurs s’accordent qu’il y a peu de chances qu’OpenAI puisse gagner une bataille juridique sur ce terrain, si certains ayants droits décident d’aller en justice. OpenAI semble avoir réalisé la même chose, faisant marche arrière une semaine après le lancement ; les ayants droits peuvent maintenant s’inscrire pour accepter que des éléments (personnages, lieux…) de leurs œuvres soient réutilisables par Sora, avec dans le futur un système de rémunération des ayants droit.

    En se fondant sur ce modèle Sora 2, OpenAI décide de lancer un réseau social du même nom. L’idée est de partager vos créations avec vos connaissances, en particulier d’utiliser la capacité de Sora de mettre en scène des personnes pour créer des vidéos vous mettant en scène, vous et vos connaissances.

    Meta lance également une offre similaire avec Vibes, xAI suit le mouvement (sans la partie « réseau social ») avec Grok Imagine

    OpenAI obtient le feu vert pour son casse du siècle

    Résumé rapide de l’affaire :

    • OpenAI a été fondé en 2015 et tant qu’organisation à but non lucratif, avec pour mission de « développer l’Intelligence Artificielle Générale pour le bénéfice de l’humanité ». Rappelons nous qu’en 2015 les larges modèle de langage sont un jouet pour chercheur, que le Winograd schema challenge est l’horizon indépassable pour la compréhension du langage naturel.
    • Afin de pouvoir recevoir des fonds d’investisseurs, en 2019 OpenAI restructure son organisation. OpenAI LLC (peu ou prou l’équivalent d’une SARL) est créé pour recevoir les financements et est l’organisation principale des opérations au jour le jour. L’organisation à but non lucratif existe toujours, et a le contrôle total de l’entreprise.
    • L’entreprise possède une caractéristique assez particulière, "capped for-profit", ce qui signifie que la quantité de profits reçus par les investisseurs est plafonnée (à un certain multiple, négocié au cas par cas, de l’investissement). Tout profit supplémentaire appartient légalement à l’organisation à but non lucratif.

    C’est ce dernier point qui ennuie beaucoup les dirigeants d’OpenAI et les potentiels investisseurs aujourd’hui. Fin décembre 2024, l’entreprise déclare vouloir prendre son indépendance vis-à-vis de l’organisation à but non lucratif. Sur papier, cela est possible : l’entreprise peut racheter le contrôle auprès de l’organisation à but non lucratif, à condition que le prix soit juste (sinon, c’est il s’agit tout simplement d’abus de biens sociaux). Problème : comment évaluer le juste prix ? Celui-ci est composé de deux parties :

    • Le pouvoir de contrôle sur l’entreprise en elle-même, de décider de sa politique (par exemple, en rapport à la sécurité des modèles). Bien intangible, mais qu’il faut bien valoriser.
    • Plus compliqué : le prix aujourd’hui de la totalité des profits futurs après remboursement des investisseurs.

    En 2024, le bruit courait d’une offre à 40 milliards, ce qui a rapidement donné lieu à une levée de boucliers, et l’utilisation par Zvi de l’expression « greatest theft in human history » (que j’ai traduite par « casse du siècle »). En mai 2024, OpenAI annonce renoncer à cette tentative, mais reprend en septembre 2024.

    Aujourd’hui, après avoir négocié avec les procureurs généraux des états du Delaware (là où l’organisation à but non lucratif est incorporée) et de Californie (pour le siège de l’entreprise), OpenAI annonce avoir reçu le feu vert pour une restructuration.

    Dans les grandes lignes :

    • Le pouvoir de contrôle sur l’entreprise reste entièrement dans les mains de l’organisation à but non lucratif.
    • La structure de profits de l’entreprise disparaît (et l’entreprise elle-même, se muant en PBC) pour suivre le modèle plus courant de parts sociales. L’organisation à but non-lucratif obtient 26% de ces parts (à comparer au plus gros investisseurs, Microsoft, qui obtient 27%).

    Est-ce un juste prix ? Zvi défend que non, en nous offrant ces chiffres :

    • Le journaliste d’affaires Matt Levine estime à 272 milliards le plafond de profits allant aux investisseurs.
    • Un chiffre de 1000 milliards de valuation à l’introduction en bourse est utilisé (se référant à celui rapporté par Reuters).
    • Ce qui donne 260 milliards pour l’organisation à but non lucratif dans le nouveau système. Dans l’ancien, le chiffre aurait été plus proche de 500-750 milliards.

    Il faut également prendre en compte que l’objectif d’OpenAI (que ce soit l’organisation ou l’entreprise) reste d’atteindre l’intelligence artificielle générale (AGI). Dans l’hypothèse où cet objectif est atteint, les profits seraient probablement un ou plusieurs ordres de magnitude plus grands (on peut citer ce papier de l’université de Virginie), ce qui élargit encore plus le gouffre entre l’ancien système et le nouveau — dans l’ancien, la quasi totalité des profits appartiendrait au final à l’organisation à but non lucratif, dans le nouveau, 26%.

    Affaire close ? Pas nécessairement : d’autres parties que les procureurs généraux peuvent se saisir de la justice pour contester cette décision. Elon Musk en particulier a déjà dans le passé saisi la justice sur ce sujet, et pourrait encore le faire dans un futur proche.

    En vrac

    DeepMind présente Dreamer 4, un agent capable d’apprendre à naviguer dans un environnement avec très peu de données d’entraînement, en « imaginant » des interactions synthétiques — avec pour objectif d’appliquer cette méthode à la robotique.

    OpenAI publie GPDval, un benchmark cherchant à mesurer au plus près les capacités économiques de l’IA, en se concentrant sur la question de quelles tâches économiquement productives l’IA peut se charger. Sur les tâches sélectionnées (avec pour critère : bien définies, avec un périmètre clair et un contexte simple, dans divers domaines), l’IA reste pour l’instant derrière l’humain, mais plus très loin derrière : la meilleure IA, Opus 4.1, gagne 47.6% (s’acquitte mieux de la tâche) du temps contre un professionnel du domaine.

    Le FLI (Future of Life Institute) publie une lettre ouverte « Statement on Superintelligence » (« Communiqué sur la superintelligence »), trois courtes phrases : « We call for a prohibition on the development of superintelligence, not lifted before there is 1. broad scientific consensus that it will be done safely and controllably, and 2. strong public buy-in. » (« Nous appelons à une interdiction du développement de la superintelligence, qui ne devra être levée qu'après : 1) un large consensus scientifique établissant que cela peut être fait de manière sûre et contrôlable, et 2) une forte adhésion du public »). Parmi les signatures, de nombreux noms de tous horizons : académie, industrie, politique et gouvernement, et même du monde religieux.

    OpenAI lance son propre navigateur, Atlas (pour l’instant, uniquement disponible sous MacOS), intégrant ChatGPT à la plupart des niveaux : autocomplétion dans la barre d’adresse, fonctionnalité « ouvrir une conversation avec le site actuel », emboîtant le pas à Perplexity Comet. Il est fortement probable que les attaques de type « injection de prompt » s’appliquent également, donc prudence.

    DeepSeek publie une mise à jour incrémentale de son IA, DeepSeek 3.2. Essentiellement les mêmes performances que la version précédente, mais à un coût bien plus faible.

    DeepSeek publie également DeepSeek-OCR. Une bestiole difficile à décrire : contrairement à ce que ce nom indique, ce n’est pas un simple OCR (même s’il peut s’acquitter de cette tâche très honorablement), mais une piste de recherche, opérationnaliser « un bon croquis vaut mieux qu’un long discours ». Plus précisément, DeepSeek essaie avec ce système de compresser n (par exemple 10) tokens textuels en 1 token de vision (pour une compression 1:10). Les résultats semblent bons, avec 90% de précision avec une compression 1 pour 10.

    Anthropic étudie la capacité d’introspection de ses modèles, et trouve un résultat positif. Par exemple, les développeurs peuvent identifier un circuit associé à un certain concept (par exemple, « piano »), l’activer, et demander au modèle « À quoi penses-tu actuellement ? » (sans que le concept soit explicitement mentionné dans le prompt) ; le modèle est généralement capable de mentionner le concept.

    DeepMind, en collaboration avec l’université de Yale, publie un modèle open-weight spécialisé dans l’analyse cellulaire. Le modèle semble capable de faire des découvertes inédites.

    Nouvelle confrontation sur le droit d’auteur : Disney met en demeure Character AI.

    Anthropic libère sur github un outil d’évaluation dans le cadre de la sécurité des modèles, utilisé notamment pour évaluer des comportements problématiques comme la flagornerie ou la tromperie.

    Epoch AI publie une visualisation quelques données économiques sur les grands acteurs du secteur.

    Des chercheurs publient une nouvelle méthode pour spécialiser un LLM à un usage précis, sans avoir accès privilégié aux paramètres du modèle lui-même. Cela permet de spécialiser des modèles propriétaires.

    Que se passe-t-il lorsque l’on applique une phase d’apprentissage par renforcement sur des tâches de type « créer de l’engagement sur les réseaux sociaux » ou « augmenter les ventes d’un produit » ? Un papier explore la question, et montre qu’un tel entraînement supplémentaire encourage les modèles à mentir ou répandre de la désinformation, et que l’effet ne disparaît pas en demandant au modèle de ne pas utiliser de telles méthodes dans son « prompt système ».

    Autre papier d’Anthropic sur la sécurité des modèles, montrant qu’il est possible d’« empoisonner » l’entraînement des modèles (c’est-à-dire l’entraîner à donner une réponse spécifique à une entrée ésotérique) à l’aide d’un faible nombre de documents (relativement à la taille du corpus d’entraînement total).

    Du mouvement sur le financement du développement de l’IA : OpenAI est évalué à $500 milliards ; xAI fait une levée de fonds pour $20 milliards ; AMD investit dans OpenAI, ainsi que Nvidia. Un article intéressant fait le parallèle avec certains montages pendant la bulle dot-com, notant également des différences importantes.

    En Janvier, OpenAI annonçait que Microsoft ne serait plus leur fournisseur unique d’infrastructure, citant un manque de capacités. The Information (paywall) révèle que Microsoft craint que les demandes de capacités de OpenAI soient injustifiées et que les satisfaire conduise à terme à mettre en place des capacités qui ne seront pas utilisées.

    Un nouveau benchmark, AutumnBench, assez similaire à ARC-AGI, où l’IA reste loin derrière les performances humaines.

    Un billet de blog intéressant sur les efforts de lobbying de l’industrie de l’IA.

    METR ajoute Sonnet 4.5 à son évaluation, qui arrive pile poil sur la ligne de tendances.

    L’IA (plus précisément : GPT-5 et Gemini 2.5 Pro) obtient un score de médaille d’or sur les Olympiades Internationales d’Astronomie et d’Astrophysique.

    Envie d’apprendre comment fonctionne l’IA ? Andrey Karpathy publie en open-source nanochat, pour entraîner soi-même un modèle minimal, de A à Z.

    ChatGPT se dote d’un système de contrôle parental.

    xAI lance une encyclopédie générée par son IA, Grok, nommée Grokipedia. Elle fait partie de la croisade d’Elon Musk contre ce qu’il considère des biais de gauche sur Wikipedia.

    Un papier étudie en détails la capacité des modèles à résister au jailbreak ou plutôt leur incapacité : aucun modèle ne résiste à un attaquant humain déterminé.

    Anthropic publie son modèle "léger" (moins cher, plus rapide, moins performant), Haiku 4.5.

    Cursor, l’assistant de code propriétaire, développe son propre modèle, Composer.

    Pour aller plus loin

    Par Zvi Mowshowitz

    Sur LinuxFR

    Dépêches

    Journaux

    Forum

    Liens

    Commentaires : voir le flux Atom ouvrir dans le navigateur

    • ✇Intelligence artificielle
    • Classement des meilleurs modèles IA pour créer des images
      Avec la profusion de nouveautés en matière d’intelligence artificielle, ce n’est pas forcément facile de s’y retrouver. Chaque jour, il y a des nouveaux modèles qui sortent pour générer du texte, des images, des vidéos, de la musique et etc … L’actualité autour de l’IA est très riche et cela peut parfois devenir difficile de ... Lire la suite L’article Classement des meilleurs modèles IA pour créer des images est apparu en premier sur ZoneTuto.

    Classement des meilleurs modèles IA pour créer des images

    Par : MrTuto
    24 avril 2025 à 12:33

    Avec la profusion de nouveautés en matière d’intelligence artificielle, ce n’est pas forcément facile de s’y retrouver. Chaque jour, il y a des nouveaux modèles qui sortent pour générer du texte, des images, des vidéos, de la musique et etc … L’actualité autour de l’IA est très riche et cela peut parfois devenir difficile de ... Lire la suite

    L’article Classement des meilleurs modèles IA pour créer des images est apparu en premier sur ZoneTuto.

    Des chercheurs de Microsoft développent un modèle d'IA hyper-efficace qui peut fonctionner sur les CPU, BitNet b1.58 2B4T, le plus grand modèle d'IA à 1 bit à ce jour avec 2 milliards de paramètres

    Des chercheurs de Microsoft développent un modèle d'IA hyper-efficace qui peut fonctionner sur les CPU, BitNet b1.58 2B4T, le plus grand modèle d'IA à 1 bit à ce jour avec 2 milliards de paramètres

    Des chercheurs de Microsoft affirment avoir mis au point le plus grand modèle d'IA à 1 bit, également connu sous le nom de « bitnet », à ce jour. Baptisé BitNet b1.58 2B4T, il est disponible sous licence MIT et peut fonctionner sur des CPU, y compris le M2 d'Apple. Les bitnets sont essentiellement des...

    OpenAI publie Codex CLI, un agent de codage local open-source dans les environnements de terminal qui transforme le langage naturel en code de travail

    OpenAI publie Codex CLI, un agent de codage local open-source dans les environnements de terminal qui transforme le langage naturel en code de travail

    Dans le but d'injecter l'IA dans une plus grande partie du processus de programmation, OpenAI lance Codex CLI, un "agent" de codage conçu pour fonctionner localement à partir d'un logiciel terminal. Annoncé en même temps que les nouveaux modèles d'IA d'OpenAI, o3 et o4-mini, Codex CLI relie les modèles d'OpenAI au code local et aux tâches...

    Anthropic pourrait lancer un nouveau modèle d'IA "hybride" doté d'un raisonnement avancé, le modèle permettra aux développeurs d'équilibrer la vitesse et la puissance de calcul à l'aide d'une échelle mobile

    Anthropic pourrait lancer un nouveau modèle d'IA "hybride" doté d'un raisonnement avancé, le modèle permettra aux développeurs d'équilibrer la vitesse et la puissance de calcul à l'aide d'une échelle mobile

    Anthropic s'apprêterait à sortir un nouveau modèle d'IA dans les semaines à venir. The Information a décrit le prochain modèle d'Anthropic comme un « hybride » capable de passer d'un « raisonnement profond » à des réponses rapides via son grand modèle de langage (LLM) lorsque cela est...

    L'intégration de modèles d'IA générative rend les poupées sexuelles « plus réactives et interactives », selon WMDoll qui s'attend à une augmentation de ses ventes de 30 %

    L'intégration de modèles d'IA générative rend les poupées sexuelles « plus réactives et interactives », selon WMDoll
    qui s'attend à une augmentation de ses ventes de 30 %

    En 2025, l'industrie des poupées sexuelles connaît un véritable essor, avec une augmentation marquée des ventes, notamment en Chine. Cette hausse est en grande partie attribuée aux progrès significatifs réalisés dans l'intégration de l'intelligence artificielle (IA), rendant ces poupées plus réactives et interactives. Liu...

    La startup française d'IA Mistral lance l'application mobile Le Chat pour iPhone et Android, et introduit également les niveaux de service Pro et Team, ainsi qu'un niveau Enterprise en avant-première privée

    La startup française d'IA Mistral lance l'application mobile Le Chat pour iPhone et Android, et introduit également les niveaux de service Pro et Team, ainsi qu'un niveau Enterprise en avant-première privée.

    Mistral AI, la startup française considérée comme étant à la pointe du développement de l'IA en Europe, a lancé une application de chatbot IA appelée Le Chat pour les appareils iOS et Android. L'application Le Chat est la version mobile de l'assistant d'IA de Mistral AI qui porte le même nom....

    ❌
    ❌