Mistral Large 4 devancé d'un point par Muse Spark Open, mais devant lui sur les épreuves d'agent


L’IA dans Google Sheets permet de créer des automatisations capables de classer des données, générer des résumés, détecter des anomalies, remplir des colonnes et déclencher des actions. Ce guide explique comment utiliser Gemini, les formules, Google Apps Script et les outils no-code pour automatiser un fichier Sheets de manière fiable, sécurisée et adaptée à un usage professionnel.
Google Sheets peut devenir un véritable outil de traitement automatisé des données. L’IA est particulièrement utile lorsque les informations contiennent du texte, des catégories ou des éléments difficiles à traiter avec une simple formule.
Voici quelques exemples concrets :
| Besoin | Automatisation possible |
|---|---|
| Trier des demandes clients | Classer chaque message par catégorie |
| Qualifier des prospects | Attribuer un niveau de priorité ou un score |
| Nettoyer des données | Repérer les doublons, fautes ou formats incohérents |
| Résumer des textes | Créer une synthèse à partir d’un commentaire ou d’un compte rendu |
| Extraire des informations | Identifier un nom, une ville, un numéro de commande ou une date |
| Produire des réponses | Générer un brouillon d’e-mail personnalisé |
| Surveiller un tableau | Signaler les valeurs inhabituelles ou les lignes incomplètes |
| Mettre à jour un processus | Déplacer une ligne, envoyer une notification ou modifier un statut |
L’IA ne remplace pas les fonctions classiques de Google Sheets. Elle les complète pour les tâches où une analyse sémantique ou une interprétation du langage est nécessaire.
Plusieurs approches sont possibles. Le choix dépend du niveau de personnalisation, du volume de données et du degré d’autonomie recherché.
Gemini peut aider à créer des tableaux, des formules, des graphiques et des analyses depuis l’interface de Google Sheets. Cette solution est adaptée pour :
La disponibilité dépend du forfait Google Workspace, du compte utilisé et du déploiement effectué par Google. Les noms des menus peuvent aussi varier selon la langue et la version de l’interface.
Certains comptes disposent d’une fonction IA directement utilisable dans une cellule. La syntaxe peut prendre une forme proche de `=AI("instruction", plage)`.
Cette méthode permet de traiter automatiquement une ligne ou une colonne, par exemple pour classer un message ou générer un résumé. Elle est intéressante pour des automatisations simples, mais la disponibilité et les limites peuvent varier selon le compte.
Google Apps Script est l’outil le plus flexible pour automatiser Google Sheets. Il permet notamment de :
Apps Script convient aux processus réguliers et personnalisés qui dépassent les possibilités des formules.
Des outils comme Make, Zapier ou n8n peuvent connecter Google Sheets à un modèle d’IA, Gmail, Slack, Notion, un CRM ou un formulaire.
Le scénario type est le suivant :
Cette approche est rapide à mettre en place, mais elle peut entraîner des coûts supplémentaires et transmettre des données à plusieurs services.
Une automatisation fiable commence par une feuille structurée. Une IA ne corrige pas automatiquement une organisation confuse ou des données ambiguës.
Chaque colonne doit contenir un seul type d’information. Par exemple, dans un tableau de prospects :
| Date | Nom | E-mail | Message | Catégorie | Priorité | Statut | Traité le |
|---|---|---|---|---|---|---|---|
Éviter de mélanger dans la même colonne :
Une colonne comme Statut, Traité, Erreur ou Date de traitement permet d’éviter que la même ligne soit traitée plusieurs fois.
Par exemple :
Cette précaution est essentielle avec Apps Script et les outils no-code.
Pour les catégories ou les statuts, utiliser une liste déroulante. Cela évite que l’IA produise des variantes difficiles à filtrer, comme :
Une liste limitée à `Basse`, `Moyenne` et `Haute` facilite les automatisations suivantes.
Gemini est adapté à la conception et à l’analyse, mais il ne déclenche pas nécessairement un processus autonome à chaque modification d’une feuille. Il faut distinguer l’assistance à la création et l’exécution automatique.
Un prompt trop vague produit souvent une réponse inutilisable. Il est préférable de préciser le contexte, les cellules et les contraintes.
Crée une formule qui classe le contenu de la colonne D dans une seule des catégories suivantes : Question commerciale, Support technique, Réclamation ou Autre. Si le texte ne permet pas de décider, retourne Autre.
Analyse les colonnes A à D et propose une colonne Priorité avec uniquement les valeurs Basse, Moyenne ou Haute. Donne une priorité Haute lorsqu’un client mentionne une panne, une urgence ou une échéance proche.
Résume chaque commentaire de la colonne E en 20 mots maximum, sans inventer d’information et sans répéter le nom du client.
Repère les lignes qui semblent être des doublons en comparant l’adresse e-mail et le numéro de commande.
Gemini peut également expliquer une formule existante, repérer une erreur de logique ou proposer une structure de tableau.
Lorsque la fonction IA est disponible, elle peut traiter le contenu d’une cellule ou d’une plage.
Dans une colonne dédiée, une formule de type `=AI("Classe ce message dans une seule catégorie : Commercial, Support, Facturation ou Autre", D2)` peut analyser le message situé en D2.
La cellule produira alors une catégorie. La formule peut ensuite être recopiée sur les lignes suivantes.
Une instruction comme `=AI("Résume ce contenu en deux phrases maximum sans ajouter d'information", E2)` peut générer un résumé à partir d’un commentaire.
Les résultats de l’IA peuvent varier. Une formule générative ne doit pas être utilisée seule pour prendre une décision juridique, financière, médicale ou contractuelle.
Apps Script est recommandé lorsqu’une action doit se déclencher automatiquement après un événement.
Les principaux déclencheurs sont :
Les déclencheurs simples ont des limites. Pour envoyer des e-mails ou accéder à certains services, un déclencheur installable avec autorisation est généralement nécessaire.
L’automatisation doit traiter uniquement les lignes non finalisées. Sans cette précaution, une exécution périodique peut envoyer plusieurs fois le même e-mail ou facturer plusieurs appels d’API.
Un tableau peut contenir les colonnes suivantes :
Le script peut suivre ce processus :
La réponse générée ne devrait pas être envoyée automatiquement au prospect sans validation dans un premier temps. Une colonne `Validation humaine` permet de garder le contrôle.
Apps Script peut appeler une API externe à l’aide du service `UrlFetchApp`. Cette solution permet d’utiliser un modèle d’IA avec une consigne personnalisée.
Le fonctionnement général est le suivant :
Pour faciliter le traitement, demander une réponse structurée, par exemple avec des champs `categorie`, `priorite` et `resume`. Une réponse limitée à des valeurs prédéfinies est plus facile à contrôler qu’un long texte libre.
Les tarifs, limites d’appels et conditions d’utilisation varient selon le fournisseur. Une automatisation traitant plusieurs milliers de lignes doit être testée avec un petit volume avant son déploiement.
Un prompt efficace contient généralement cinq éléments :
Exemple :
Tu es un assistant de support. Analyse le message fourni. Retourne uniquement un objet contenant la catégorie, le niveau de priorité et un résumé de 25 mots maximum. Les catégories autorisées sont : Incident, Question, Facturation, Demande commerciale et Autre. N’invente aucune information. Si le message est ambigu, indique À vérifier.
Il est préférable d’éviter les instructions contradictoires, les demandes trop générales et les prompts qui demandent plusieurs formats différents dans une même réponse.
L’IA n’est pas toujours la meilleure solution. Les fonctions classiques sont plus rapides, prévisibles et souvent gratuites.
Exemples d’automatisations classiques :
Par exemple, une formule peut détecter un e-mail vide ou attribuer automatiquement une priorité en fonction d’un montant. L’IA doit être réservée aux tâches nécessitant une interprétation du langage ou une analyse de contenu.
Le coût dépend de la méthode utilisée :
Avant le déploiement, mesurer :
Un traitement groupé de plusieurs lignes peut être plus efficace que l’appel d’une API pour chaque cellule.
Les données d’un fichier Sheets peuvent contenir des informations personnelles, commerciales ou confidentielles. Avant d’utiliser une IA, vérifier les conditions du service et les règles internes de l’organisation.
Les précautions essentielles sont :
Les prompts et les textes envoyés à une API peuvent contenir des informations confidentielles. La conformité dépend du fournisseur, du forfait choisi, de la localisation des données et du contexte juridique.
Le compte peut ne pas disposer du forfait requis, la fonctionnalité peut ne pas être activée par l’administrateur ou le déploiement peut ne pas être disponible dans le domaine concerné.
Vérifier :
Ajouter une colonne de statut, une date de traitement ou un identifiant unique. Le script doit marquer la ligne comme `En cours` avant l’appel à l’IA, puis comme `Terminé` uniquement après une écriture réussie.
Réduire les catégories possibles, donner des exemples, préciser le format attendu et ajouter une règle pour les cas ambigus. Les résultats doivent être comparés à un échantillon vérifié manuellement.
Vérifier l’autorisation du script, le type de déclencheur, le compte propriétaire et les journaux d’exécution dans Apps Script. Certains événements ne déclenchent pas les mêmes fonctions, notamment une modification manuelle et une réponse Google Forms.
L’IA peut transformer Google Sheets en outil d’automatisation pour classer, résumer, contrôler et enrichir des données. Gemini convient à la création assistée et à l’analyse ponctuelle, tandis que la fonction IA dans une cellule permet certains traitements ligne par ligne. Pour une automatisation complète, Google Apps Script ou un outil comme Make, Zapier ou n8n offre davantage de contrôle.
La méthode la plus fiable consiste à :


L’ESSENTIEL
Les outils étaient jusqu’à présent bien distincts de l’être qui les utilisait.
Aujourd’hui, l’émergence des systèmes d’intelligence artificielle grand public brouille les pistes : nos souvenirs et nos décisions sont souvent intimement liés à nos traces numériques tandis que les systèmes informatiques modernes se nourrissent de nos données.
Considérer un effacement progressif de cette frontière conceptuelle permet de changer les termes des débats et des réflexions autour de l’essor de l’IA.
Il existe quelque chose d’étrangement rassurant dans la manière dont nous continuons à parler de l’intelligence artificielle. Comme si la géométrie fondamentale de cette relation avait déjà été tracée une fois pour toutes. D’un côté, les êtres humains. De l’autre, les machines.
Pourtant, les machines deviennent plus rapides, plus convaincantes, plus autonomes ; les humains s’adaptent, résistent, ou finissent peut-être par s’effacer un peu. Mais la frontière qui sépare les deux demeure remarquablement peu interrogée, comme si sa permanence allait de soi.
Et pourtant, à mesure que nous vivons avec ces systèmes, quelque chose de plus ambigu commence à apparaître.
La particularité de l’intelligence artificielle contemporaine réside précisément dans son refus de rester à l’extérieur de nous-mêmes.
Les outils d’autrefois occupaient une place relativement simple dans nos existences. Un marteau prolongeait la main. Un télescope étendait la portée du regard. Un ordinateur facilitait le calcul. On les utilisait tout en restant solidement ancré dans son identité propre.
L’intelligence artificielle vient troubler cet équilibre. Peu à peu, l’interaction cesse de paraître cognitivement extérieure. La mémoire se disperse dans des archives numériques auxquelles nous revenons sans cesse. Les décisions émergent d’une négociation continue avec des algorithmes capables d’anticiper nos préférences (à l’image des systèmes de recommandation déployés sur les grandes plateformes numériques) avant même que celles-ci ne se soient entièrement formées.
Les systèmes fondés sur le dialogue argumentatif illustrent cette transformation en intégrant les réactions de l’utilisateur dans un processus itératif de justification et de révision des recommandations : la réflexion peut désormais se déployer au travers d’échanges avec des agents conversationnels. En somme, la pensée humaine emprunte de plus en plus souvent des structures artificielles avant de revenir vers nous, subtilement transformée.
À lire aussi : Outil ou compagnon ? Comment nous parlons aux robots en dit long
Dans le même temps, les systèmes artificiels se nourrissent d’immenses quantités de traces de l’expérience humaine. Les modèles de langage y découvrent les multiples formes d’expression des émotions et acquièrent la capacité d’en interpréter les nuances. Ils en ont appris les indices linguistiques, les nuances affectives et les contextes d’expression, jusqu’à reconnaître des états émotionnels complexes dans les interactions textuelles. Ils assimilent les traces de l’expérience humaine sans jamais relever de l’expérience humaine elle-même.
Ce qui apparaît alors est un « espace liminal » : un territoire où il n’y a ni fusion véritable ni séparation nette, mais un état intermédiaire, fluide, dans lequel les catégories qui structuraient autrefois nos interactions perdent progressivement leur évidence.
L’humain devient partiellement artificiel à travers l’externalisation graduelle de sa cognition, de sa perception et de son action. La machine, quant à elle, absorbe le langage, les mouvements, les comportements et les affects humains au fil même de l’interaction. Autour d’eux, l’environnement commence lui aussi à se transformer, acquérant une nature hybride qui lui est propre.
Aucune de ces catégories ne disparaît complètement. Mais aucune ne ressort intacte de la rencontre.
À lire aussi : Vous prendrez bien un sixième doigt ?
Une personne munie d’une prothèse adaptative est accompagnée par un dispositif qui ajuste continuellement son comportement à ses mouvements et à ses intentions. Cette logique d’adaptation s’étend aujourd’hui aux prothèses motorisées du membre inférieur, capables d’ajuster leur assistance à la dynamique de la marche.
Au-delà de la compensation d’une fonction perdue, les robots portables prolongent le corps en lui offrant de nouvelles possibilités d’action, parfois au moyen de membres supplémentaires directement contrôlés par l’utilisateur.
D’autres approches privilégient une collaboration étroite entre l’humain et des bras robotiques portés sur le corps afin d’assister l’exécution de tâches complexes.
Enfin, les systèmes cognitifs prédictifs exploitent les données produites en continu par l’utilisateur pour anticiper certains de ses états ou besoins et adapter leur fonctionnement en conséquence.
La pensée, le mouvement et la perception commencent à circuler simultanément entre des couches biologiques et artificielles. L’agentivité déborde progressivement les limites du corps pour se distribuer dans des systèmes qui anticipent, répondent et s’adaptent en retour. Et le cerveau, lentement, redéfinit ce qu’il considère comme faisant partie du corps et du soi.
Ce qui émerge n’est alors ni entièrement humain ni entièrement artificiel, mais une condition plus fluide, continuellement reconstruite à travers l’interaction avec la machine et l’environnement qui l’entoure.
La réalité virtuelle et la réalité augmentée offrent sans doute l’expression la plus visible de cette transformation de l’environnement. Dans ces univers immersifs, le corps demeure physique tandis que la perception s’ancre dans un monde généré computationnellement. La présence cesse de coïncider parfaitement avec l’espace matériel. L’environnement lui-même acquiert une qualité « liminale », suspendue quelque part entre réalité tangible et construction artificielle.
À lire aussi : Que sont les xénobots, ces robots biologiques qui bouleversent les frontières entre vivant et machine ?
Pourtant, une grande partie des discussions actuelles autour de l’intelligence artificielle continue de se concentrer sur l’intelligence, la conscience ou le remplacement de l’humain. Ces questions sont certes importantes, mais elles ne sont peut-être pas les plus profondes.
La transformation principale réside dans l’effacement progressif des frontières conceptuelles au moyen desquelles les sociétés modernes ont longtemps organisé leurs relations avec les machines et avec leur environnement.
Et c’est peut-être cela qui confère à l’intelligence artificielle contemporaine son étrange mélange de fascination et d’inquiétude. L’interaction ne modifie pas seulement nos habitudes ou nos comportements. Elle commence à déstabiliser les catégories mêmes à travers lesquelles nous avons traditionnellement compris ce que nous sommes, ce que sont nos machines et ce que sont les mondes que nous habitons.
Les collaborations futures entre psychologues, neuroscientifiques, informaticiens et artistes seront essentielles pour explorer cet espace liminal. Comprendre comment il transforme le cerveau humain, les comportements individuels et les dynamiques sociales constitue une étape nécessaire si nous souhaitons développer une intelligence artificielle conçue comme une entité de collaboration plutôt que comme une entité de compétition.
Les auteurs remercient Shotaru Oku et l’équipe d’Evision Tokyo pour leur collaboration artistique de longue date, marquée par la réalisation conjointe de spectacles et d’œuvres cinématographiques immersives, ainsi que pour les échanges qui ont enrichi les travaux présentés dans cet article.
Les auteurs ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur organisme de recherche.

![]()
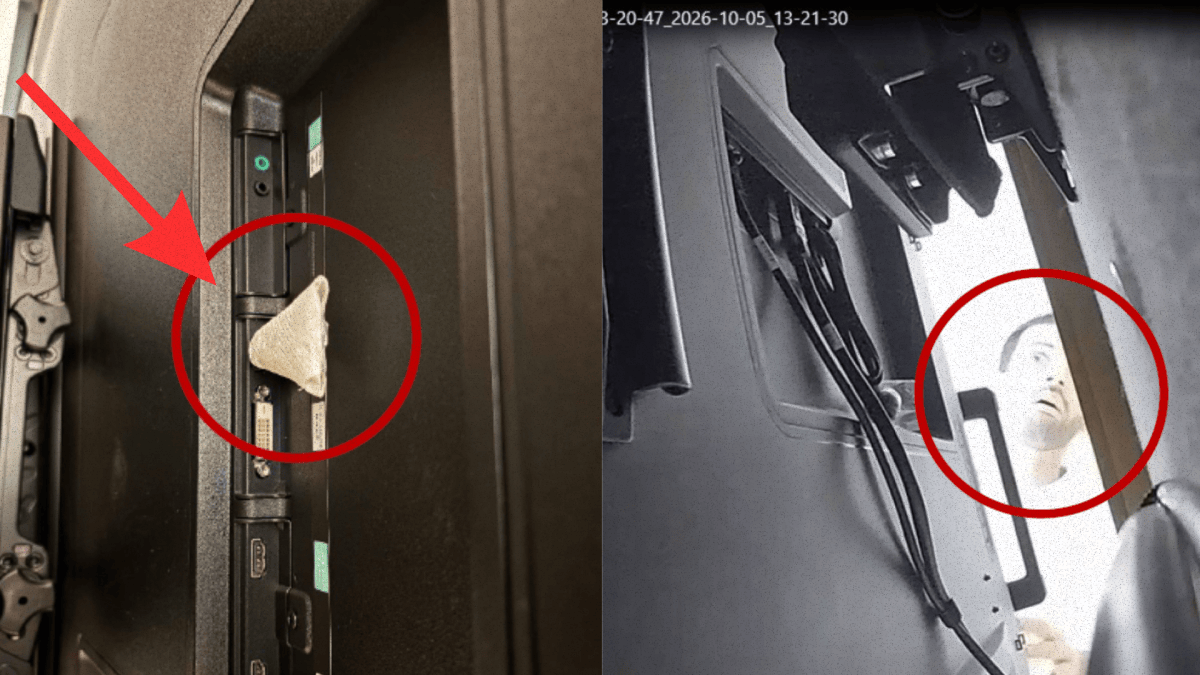
Un ingénieur d’OpenAI a été arrêté après la découverte d’un dispositif d’écoute dans une salle de réunion de la direction. L’entreprise affirme que ses propres modèles ont contribué à l’identifier, tandis que plusieurs questions restent ouvertes sur les motivations du suspect.
La plateforme de compagnons IA Character.AI, très populaire auprès des adolescents, se retrouve sous le contrôle du tribunal après des procédures mettant en cause la sécurité de mineurs. Le 12 octobre 2026, l’entreprise a demandé à bénéficier du Chapter 11 aux États-Unis et annoncé un accord préliminaire de 20 millions de dollars avec Disney portant sur certains actifs et une licence de propriété intellectuelle.
La procédure engagée par Character.AI n’est pas une liquidation immédiate. Le Chapter 11 permet à une entreprise américaine en difficulté de poursuivre ses activités sous supervision judiciaire, tout en restructurant ses dettes ou en préparant la vente de tout ou partie de ses actifs.
Dans ce cadre, Character.AI a conclu avec Disney un accord dit de stalking horse bid, ou offre de référence. Le groupe de divertissement doit servir d’enchérisseur de référence : son offre de 20 millions de dollars fixe un premier niveau de valorisation pour les actifs concernés, mais d’autres candidats pourront se manifester au cours de la procédure.
Le montant ne correspond donc pas nécessairement au prix final de la transaction. Le tribunal devra examiner les modalités de la vente, tandis qu’une éventuelle mise aux enchères pourrait faire émerger une offre supérieure ou plus avantageuse pour les créanciers.
L’accord porte sur « certains actifs » de Character.AI ainsi que sur une licence de propriété intellectuelle, selon les informations communiquées par l’entreprise et rapportées par CBS News et Investing.com. Cette formulation laisse une incertitude importante sur le périmètre exact de l’opération : technologie, marque, contenus, contrats ou droits d’exploitation pourraient être concernés, sans que la vente n’implique automatiquement la reprise de l’intégralité de l’entreprise.
Character.AI assure que sa plateforme continue de fonctionner pendant la procédure. Les utilisateurs peuvent donc toujours accéder à ses personnages conversationnels et créer des échanges avec des chatbots générés par l’IA.
Cette continuité reste toutefois conditionnelle. L’entreprise prévient que le service pourrait fermer si aucune offre permettant la poursuite de son activité n’aboutit. L’accord avec Disney fournit un point d’appui dans la procédure, mais il ne constitue pas encore une garantie de maintien de l’application sous sa forme actuelle.
Pour les utilisateurs, l’enjeu dépasse la simple disponibilité du site. Une cession d’actifs peut entraîner des changements concernant les conditions d’utilisation, la modération, l’architecture technique ou le traitement des données. La question du transfert des comptes, des conversations et des données personnelles devra notamment être clarifiée dans les documents soumis au tribunal.
Le rôle de Disney est lui aussi à préciser. L’accord annoncé ne signifie pas nécessairement que le groupe prendra immédiatement en main l’exploitation quotidienne de Character.AI. Il pourrait acquérir certains droits ou actifs sans conserver l’ensemble du service, de ses équipes et de sa communauté.
La procédure intervient alors que Character.AI fait face à des plaintes et à des enquêtes portant sur les interactions entre ses chatbots et des utilisateurs mineurs. Les dossiers allèguent que certains échanges auraient poussé des adolescents vers l’automutilation ou le suicide.
Ces accusations touchent au cœur du modèle de Character.AI. Contrairement à un assistant généraliste conçu pour répondre à des questions, la plateforme met en avant des personnages capables de tenir des conversations longues, personnalisées et émotionnellement crédibles. Cette proximité peut favoriser l’engagement, mais elle complique aussi la détection des situations de détresse et la prévention des comportements dangereux.
Les systèmes de sécurité doivent alors gérer plusieurs difficultés : repérer les signaux faibles dans une conversation, éviter les réponses qui renforcent une pensée suicidaire, interrompre les échanges à risque et orienter l’utilisateur vers une aide humaine. La tâche est encore plus sensible lorsque le service est utilisé par des mineurs, dont l’âge réel peut être difficile à vérifier en ligne.
Les plaintes et enquêtes ne signifient pas, à elles seules, que toutes les accusations ont été établies. Elles exposent néanmoins l’entreprise à des coûts juridiques, à des obligations de conservation de données et à un risque réglementaire élevé. Elles rendent également plus délicate la recherche d’un repreneur : acquérir les actifs de la plateforme ne permet pas nécessairement d’effacer les litiges liés à son passé.
L’intérêt de Disney pour Character.AI peut s’expliquer par la valeur de sa technologie et de sa communauté. Les personnages conversationnels pourraient être associés à des univers de fiction, à des expériences interactives ou à des services destinés aux fans. Mais l’opération intervient dans un contexte où la relation entre IA, divertissement et public mineur fait l’objet d’une surveillance accrue.
Pour Disney, le principal enjeu sera de séparer la valeur commerciale de la plateforme de ses fragilités opérationnelles. Une licence de propriété intellectuelle peut permettre d’exploiter certains éléments sans reprendre l’ensemble des engagements de Character.AI. Elle ne supprime toutefois ni les exigences de modération ni les risques liés à la protection des enfants.
La procédure judiciaire devra également déterminer le sort des créanciers et des plaignants. Dans une vente sous Chapter 11, les actifs peuvent être cédés plus rapidement qu’une entreprise ne serait liquidée, mais la répartition des sommes et la portée des protections accordées à l’acquéreur restent encadrées par le tribunal.
Character.AI entre ainsi dans une période où sa survie dépend moins de sa popularité que de la capacité à trouver une offre crédible, finançable et compatible avec les contraintes judiciaires. L’offre de 20 millions de dollars de Disney constitue un plancher de départ, pas une issue définitive.
Le prochain jalon concret sera l’examen judiciaire de l’accord et l’organisation éventuelle d’une mise aux enchères. D’ici là, la plateforme devrait rester accessible, mais son avenir — maintien sous une nouvelle structure, réduction de ses activités ou fermeture — demeure ouvert. Pour les utilisateurs mineurs et leurs familles, le point décisif ne sera pas seulement le nom du futur propriétaire : ce seront les garanties mesurables de modération, de contrôle de l’âge et de prise en charge des conversations à risque.


Meta tente de rattraper son retard dans la course aux modèles d’IA les plus performants. Avec Muse Wonder et Muse Wonder Full, présentés le 12 octobre 2026, le groupe affirme rejoindre le cercle des modèles dits frontier — mais garde sa version la plus puissante derrière un abonnement.
La présentation de Muse Wonder marque une étape importante pour la stratégie IA de Meta. Le groupe présente ce modèle comme son premier système capable de rivaliser avec les références du marché sur des tâches complexes : développement logiciel, exécution de missions en plusieurs étapes et usages professionnels.
Cette annonce intervient après une réorganisation des efforts de Meta dans l’intelligence artificielle. Jusqu’ici, l’entreprise était surtout identifiée pour ses modèles ouverts et sa contribution à l’écosystème open source, notamment avec ses précédentes générations de modèles. Sur les performances de pointe, elle apparaissait toutefois en retrait face à Anthropic, OpenAI ou Google.
Meta cherche désormais à occuper les deux terrains : conserver une présence auprès des développeurs grâce à un modèle accessible par API, tout en proposant une version plus performante pour les utilisateurs professionnels de son environnement logiciel.
Muse Wonder est accessible aux développeurs via l’API de Meta et dans Muse Code, l’outil de programmation assistée du groupe. Cette disponibilité doit permettre d’intégrer le modèle dans des applications, des environnements de développement et des flux de travail automatisés.
Muse Wonder Full, présenté comme la déclinaison la plus performante, reste pour l’instant réservé aux abonnés de Muse Code. Cette restriction crée une différence notable entre l’annonce publique d’un modèle de pointe et l’accès réel à ses capacités. Les développeurs peuvent tester Wonder, mais pas nécessairement la version qui obtient les meilleurs résultats dans les évaluations.
Le choix rappelle une tendance désormais bien installée dans l’industrie : les entreprises rendent accessibles leurs modèles les plus polyvalents, mais limitent les versions les plus coûteuses ou les plus avancées à des offres payantes. Les abonnements deviennent ainsi un moyen de financer l’inférence — le calcul nécessaire à chaque requête — tout en contrôlant la demande.
L’évaluation indépendante d’Artificial Analysis donne à Muse Wonder Full un score de 56 points. Le modèle se situe à seulement 2 points de Claude Opus 5.5, crédité de 58 points.
Derrière, GPT-6 Astra, Gemini 4 Argon et Claude Fable 5.1 obtiennent chacun 53 points. Sur cette mesure, Wonder Full devance donc de 3 points trois modèles présentés comme des références de la génération actuelle.
| Modèle | Score Artificial Analysis |
|---|---:|
| Claude Opus 5.5 | 58 |
| Muse Wonder Full | 56 |
| GPT-6 Astra | 53 |
| Gemini 4 Argon | 53 |
| Claude Fable 5.1 | 53 |
L’écart avec le premier est limité, mais suffisamment faible pour permettre à Meta de revendiquer son appartenance au groupe de tête. Le terme frontier model ne signifie toutefois pas que Wonder Full domine tous les concurrents sur tous les usages. Il désigne généralement un modèle situé à la limite supérieure des performances disponibles, selon les tâches et les évaluations retenues.
Un score agrégé ne résume pas non plus la qualité d’un système. Les résultats peuvent varier selon la capacité à suivre des instructions, la précision du code produit, la gestion d’un contexte long, la fiabilité des appels à des outils ou encore le coût d’utilisation. La position de Meta devra donc être confirmée par des tests indépendants plus détaillés et par l’usage en conditions réelles.
Meta cible en priorité les tâches dites agentiques. Un agent ne se contente pas de générer une réponse : il peut décomposer un objectif, consulter des sources, utiliser des outils, écrire du code et vérifier partiellement son travail avant de poursuivre. Ce type de fonctionnement exige davantage qu’une bonne capacité conversationnelle.
Le codage constitue un autre terrain central. Les modèles capables de comprendre une base de code volumineuse, de modifier plusieurs fichiers et de corriger des erreurs sont devenus des composants essentiels des environnements de développement. La présence de Wonder dans Muse Code permet à Meta de tester directement son modèle dans un produit où la rapidité, la fiabilité et la capacité à itérer comptent autant que la qualité d’une réponse isolée.
Pour les entreprises, l’enjeu est concret : automatiser une partie de la maintenance logicielle, produire des prototypes, analyser des documents ou orchestrer des opérations répétitives. Dans ces scénarios, quelques points sur un classement ne suffisent pas. La stabilité des sorties, le respect des politiques de sécurité, la latence et le prix par requête peuvent peser davantage que la performance maximale sur un test.
La stratégie de Meta présente une tension claire. Le groupe veut bénéficier de la visibilité d’un modèle de pointe tout en conservant sa version la plus performante dans une offre fermée. Cette approche peut soutenir les revenus de Muse Code, mais elle limite aussi la diffusion de Wonder Full et la possibilité pour les chercheurs ou les développeurs de l’évaluer largement.
L’accès par API de Muse Wonder offre une porte d’entrée aux professionnels. Reste à savoir si le modèle standard reprend l’essentiel des capacités de Wonder Full ou s’il existe un écart suffisamment important pour pousser les utilisateurs vers l’abonnement. Meta n’a pas encore transformé son score en preuve d’adoption : il faudra mesurer la qualité des intégrations, le nombre de développeurs actifs et la rétention des clients.
L’annonce signale néanmoins un changement de statut pour la division IA du groupe. Meta ne se contente plus de mettre en avant la disponibilité de ses modèles ; l’entreprise revendique désormais une place dans la compétition des systèmes les plus avancés. Le prochain jalon sera la publication de comparaisons détaillées entre Wonder et Wonder Full, accompagnées de résultats reproductibles sur le codage, les agents et les usages professionnels.
Si ces performances se confirment, Meta disposera d’un modèle capable de rivaliser avec les meilleurs tout en gardant une version accessible aux développeurs. Dans le cas contraire, Muse Wonder Full restera surtout un indicateur de positionnement — et un produit vitrine dont l’impact réel dépendra moins de ses 56 points que de son accès, de son coût et de sa fiabilité au quotidien.

L’ESSENTIEL
En matière d’IA, l’Union européenne, les États-Unis et la Chine combinent tous trois régulation, innovation et politique industrielle, malgré des approches institutionnelles distinctes.
Les trois puissances investissent dans les infrastructures, les compétences et l’industrie de l’IA, tout en cherchant à maîtriser les risques.
L’UE privilégie des obligations communes, les États-Unis des cadres de gestion des risques, et la Chine des obligations directes imposées aux fournisseurs.
Ces dernières années, les débats sur la régulation du numérique, et notamment de l’intelligence artificielle, sont souvent résumés à une opposition simple : faut-il réguler ou innover ? Une formule revient souvent pour résumer les approches de l’Union européenne (UE), des États-Unis et de la Chine : l’UE régule, les États-Unis innovent, et la Chine contrôle.
Cette formule est efficace, mais elle simplifie à l’excès. En apparence, les trois acteurs ont choisi des voies différentes. En réalité, ils font face à des dilemmes très proches : comment soutenir l’innovation tout en maîtrisant les risques sociaux liés à l’IA ? Comment développer leur propre industrie de l’IA et des infrastructures technologiques critiques, tout en pesant davantage sur les règles du jeu à l’échelle mondiale ?
La comparaison ne devrait donc pas porter seulement sur la question de savoir qui régule le plus. Il faut aussi regarder qui régule, quoi, pourquoi, et comment ces règles s’articulent avec l’industrie, les institutions et les priorités économiques de chacun.
Cette lecture en trois modèles n’est pas sans fondement. Au cours des vingt dernières années, les États-Unis, l’Union européenne et la Chine ont développé des traditions différentes en matière de gouvernance numérique.
Les États-Unis ont longtemps privilégié une approche relativement décentralisée et orientée vers le marché : il n’existe toujours pas de loi fédérale générale sur la protection des données personnelles, et l’encadrement des entreprises technologiques repose largement sur des outils juridiques existants, comme le droit de la concurrence ou la protection des consommateurs, mobilisés par différentes autorités de régulation.
L’Union européenne, à l’inverse, est intervenue plus tôt et de manière plus systématique sur les marchés numériques, à travers la protection des données, le droit de la concurrence et la régulation des plates-formes. Les droits fondamentaux, la protection des consommateurs et la concurrence équitable occupent une place centrale dans cette approche. Ces différences restent visibles dans la gouvernance de l’IA. L’approche américaine est généralement décrite comme plus sectorielle et fondée sur les risques, tandis que l’UE accorde davantage de place à l’éthique, à la protection des consommateurs et aux droits fondamentaux.
La Chine semble avoir suivi une autre voie. Depuis 2021, elle a adopté des règles spécifiques sur les algorithmes de recommandation, la synthèse profonde et l’IA générative, devenant ainsi l’un des premiers pays à instaurer des règles contraignantes pour certaines applications de l’IA. L’enregistrement des algorithmes, les obligations d’étiquetage des contenus générés par l’IA et les règles encadrant les systèmes de recommandation font de l’intervention de l’État l’un des traits les plus visibles de la gouvernance chinoise de l’IA.
Mais c’est précisément là que les étiquettes deviennent trompeuses : on risque de prendre la caractéristique la plus visible d’un système pour l’ensemble de sa logique. Des recherches détaillées sur l’élaboration de la réglementation chinoise de l’IA montrent que ces règles n’ont pas simplement été conçues au sommet puis appliquées telles quelles. Elles sont plutôt le résultat d’un processus progressif et itératif, auquel participent des fonctionnaires, des universitaires, des experts techniques, des journalistes et des entreprises technologiques.
Le débat public peut aussi contribuer à faire entrer certains sujets dans l’agenda réglementaire. En outre, les régulateurs chinois suivent de près les débats menés à l’étranger et en adaptent certaines idées. De la même manière, réduire l’UE au rôle de « régulateur » ou les États-Unis à celui d’« innovateur » revient à négliger d’autres objectifs présents dans leurs politiques respectives.
La formule « les États-Unis innovent, l’Union européenne régule, la Chine contrôle » peut donc constituer un bon point de départ, mais elle ne suffit pas. Elle met en lumière certains traits saillants, tout en risquant de transformer des priorités politiques en identités figées. Pour comprendre la gouvernance de l’IA aujourd’hui, il est plus utile de regarder comment chaque système combine ses institutions et ses instruments de politique publique.
« Plus on régule, moins on innove » : c’est l’une des idées les plus répandues dans les débats sur les politiques de l’IA. Pourtant, la relation entre régulation et innovation est loin d’être aussi simple. Anu Bradford (2024) rappelle que le succès du secteur technologique américain ne s’explique pas uniquement par un environnement réglementaire relativement souple, pas plus que la position plus fragile de l’Europe dans l’économie numérique ne peut être réduite à un excès de régulation. La profondeur des marchés de capitaux, la taille du marché, la mobilité des talents ou encore l’environnement entrepreneurial jouent eux aussi un rôle dans la capacité d’une économie à innover.
Surtout, les États-Unis, l’UE et la Chine ne choisissent pas simplement entre « régulation » et « innovation ». Tous trois cherchent activement à façonner leur industrie de l’IA, mais par des moyens différents. L’UE met en œuvre l’AI Act tout en investissant dans les infrastructures de calcul, les « AI factories » et les compétences, notamment à travers son plan d’action de 2025 pour un continent de l’IA, avec pour objectif explicite de renforcer la compétitivité européenne dans ce domaine.
Aux États-Unis, l’approche actuelle met davantage l’accent sur la réduction des obstacles réglementaires et sur l’innovation portée par le secteur privé. Mais le plan d’action américain sur l’IA de 2025 fait également des infrastructures d’IA et de la diffusion internationale des technologies et normes américains deux axes importants de l’action publique.
La Chine, de son côté, continue de renforcer les règles encadrant les algorithmes et l’IA générative, tout en lançant en 2025 l’initiative « AI Plus », destinée à accélérer l’intégration de l’IA dans la science et la technologie, l’industrie, la consommation et la gouvernance publique.
La différence ne tient donc pas au fait que certains « régulent » tandis que d’autres « innovent ». Régulation, investissement public, infrastructures, soutien industriel et stratégie internationale sont de plus en plus étroitement liés. Ce qui compte davantage, c’est la manière dont chacun combine ces instruments et arbitre entre innovation, gestion des risques et concurrence industrielle.
Dès que l’on quitte les grands slogans pour regarder les règles concrètes, les différences entre les trois approches apparaissent beaucoup plus clairement. Prenons l’exemple des modèles d’IA à usage général et de l’IA générative.
L’UE a choisi une approche relativement classique de régulation ex ante. Dans le cadre de l’AI Act, les fournisseurs de modèles d’IA à usage général doivent notamment préparer une documentation technique, mettre en place une politique en matière de droit d’auteur et publier un résumé du contenu utilisé pour l’entraînement, même si certains modèles open source bénéficient d’exemptions partielles en matière de documentation.
Les fournisseurs de modèles considérés comme présentant un risque systémique sont soumis à des obligations supplémentaires, notamment en matière d’évaluation et de réduction des risques, de signalement des incidents graves et de cybersécurité.
Les États-Unis partent d’une logique différente. Contrairement à l’UE, qui s’appuie sur une législation transversale pour imposer des obligations communes aux fournisseurs de modèles, les États-Unis continuent de s’appuyer largement sur des standards de gestion des risques et sur des instruments juridiques et réglementaires sectoriels déjà existants.
Le cadre de gestion des risques liés à l’IA élaboré par le National Institute of Standards and Technology (NIST) n’est pas juridiquement contraignant. Son profil consacré à l’IA générative vise surtout à aider les organisations à identifier les risques et à intégrer leur gestion dans la conception, le développement, l’utilisation et l’évaluation des systèmes d’IA. Autrement dit, il s’agit davantage d’indiquer comment les organisations devraient gérer les risques que d’imposer un ensemble unique d’obligations contraignantes à tous les fournisseurs de modèles d’IA à usage général.
La Chine fait davantage peser les responsabilités directement sur les fournisseurs de services d’IA destinés au grand public. Les mesures provisoires sur les services d’IA générative leur imposent notamment de traiter les contenus illicites et prévoient des obligations concernant les données d’entraînement, les informations personnelles, la propriété intellectuelle et l’étiquetage des contenus générés. Une nouvelle réglementation adoptée en 2025 est allée plus loin en instaurant des obligations de marquage explicite et implicite pour les contenus générés ou synthétiques par l’IA. Des règles antérieures sur les algorithmes de recommandation et les services de synthèse profonde avaient déjà instauré des obligations d’enregistrement ainsi que d’autres exigences pour les fournisseurs concernés.
Les différences ne se résument donc pas à une opposition entre régulation « stricte » et approche « souple ». Elles tiennent surtout au point d’entrée de la régulation et à la manière dont les responsabilités sont réparties : l’UE privilégie des obligations communes au niveau des fournisseurs de modèles ; les États-Unis s’appuient sur des cadres non contraignant de gestion des risques et sur les autorités sectorielles existantes ; la Chine impose plus directement des obligations aux fournisseurs de services algorithmiques et numériques, ainsi qu’aux contenus qu’ils diffusent.
Aux États-Unis, dans l’UE comme en Chine, les pouvoirs publics cherchent à développer leur industrie de l’IA, à maîtriser les risques technologiques et à peser sur les règles qui encadreront l’IA à l’avenir. Ce qui les distingue, ce sont surtout les trajectoires institutionnelles qu’ils empruntent et les instruments de politique publique qu’ils mobilisent.
Ce qui compte, dès lors, c’est la manière dont ces règles s’articulent avec les politiques industrielles, la structure des marchés et les institutions existantes, et comment cet ensemble façonne, au bout du compte, le développement et l’adoption de l’IA.
À mesure que l’intelligence artificielle s’intègre plus profondément dans la vie économique et sociale, la compétition pourrait ne plus se jouer seulement sur la capacité à développer les modèles les plus avancés. Elle portera aussi sur la capacité à construire un cadre de gouvernance qui soutienne le progrès technologique tout en restant socialement acceptable.
Jingyan Wu ne travaille pas, ne conseille pas, ne possède pas de parts, ne reçoit pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'a déclaré aucune autre affiliation que son organisme de recherche.

![]()
Google déploie dans le monde entier Gemini 4 Argon, son nouveau modèle d'IA haut de gamme, moins de deux semaines après l'avoir présenté le 30 septembre 2026.


![]()
Yuji Horii est l'un des co-créateurs de Dragon Quest, tout de même l'une des sagas de JRPG les plus importantes de l'histoire. Le 11 octobre, il a publié gratuitement un petit jeu d'enquête qu'il dit avoir créé en une trentaine de minutes avec Claude, l'IA générative d'Anthropic.


L’IA peut aider à préparer un entretien d’embauche à distance, depuis l’analyse de l’offre jusqu’à la simulation en visioconférence. Ce guide explique comment utiliser un assistant conversationnel, un outil de transcription ou une application d’entraînement pour structurer ses réponses, améliorer sa présentation et éviter les erreurs techniques le jour du rendez-vous.
Un entretien en visioconférence évalue les mêmes compétences qu’un entretien en présentiel, mais ajoute des contraintes spécifiques : qualité du son, cadrage de la caméra, regard, connexion Internet et capacité à rester naturel devant un écran.
L’IA peut servir de coach de préparation, à condition de ne pas lui déléguer entièrement le discours. Elle est particulièrement utile pour :
L’objectif n’est pas de réciter des réponses générées automatiquement. L’objectif est de gagner en préparation, en précision et en confiance, tout en conservant un discours personnel.
Commencez par transmettre à l’outil IA une version anonymisée de l’offre d’emploi. Demandez-lui de distinguer :
Exemple de consigne :
Analyse cette offre d’emploi. Classe les informations en cinq catégories : missions principales, compétences techniques, qualités comportementales, critères indispensables et critères secondaires. Indique ensuite les sujets qui risquent d’être abordés pendant l’entretien.
Cette analyse permet de comprendre ce que l’entreprise attend réellement. Une offre mentionnant plusieurs fois la gestion de projet, l’autonomie et la relation client indique probablement que les questions porteront sur ces trois dimensions.
L’étape suivante consiste à comparer l’offre avec le CV ou le parcours professionnel. L’IA peut repérer les expériences les plus pertinentes, mais elle ne doit pas inventer de compétence ou d’accomplissement.
Prompt utile :
À partir de cette offre et de ce parcours, identifie cinq expériences à mettre en avant pendant l’entretien. Pour chacune, explique le lien avec le poste et propose une question que le recruteur pourrait poser.
Cette méthode aide à sélectionner les bons exemples. Un entretien ne nécessite pas de raconter l’intégralité d’un parcours. Il faut surtout mettre en avant les expériences qui répondent directement aux besoins de l’employeur.
La question « Pouvez-vous vous présenter ? » arrive fréquemment au début d’un entretien. Une bonne réponse doit rester courte et structurée :
L’IA peut proposer une structure, mais la formulation finale doit rester naturelle. Demandez plusieurs versions :
Prépare une présentation orale de 75 secondes à partir de ce parcours et de cette offre. Utilise un ton professionnel, simple et naturel. N’invente aucune information. Propose ensuite une version plus concise de 45 secondes.
Lisez ensuite le texte à voix haute. Supprimez les formulations trop écrites, les adjectifs exagérés et les phrases que vous n’utiliseriez pas dans une conversation.
Les questions les plus courantes concernent souvent :
Demandez à l’IA de générer des questions adaptées au poste plutôt qu’une liste générique :
Génère 15 questions susceptibles d’être posées pour ce poste. Classe-les en quatre catégories : motivation, expérience, compétences techniques et comportement professionnel. Pour chaque question, indique ce que le recruteur cherche à évaluer.
Cette dernière précision est importante. Une question ne sert pas uniquement à obtenir une information : elle peut mesurer l’autonomie, la capacité d’analyse, la résistance au stress ou l’aptitude à travailler à distance.
Pour les questions comportementales, la méthode STAR permet de construire une réponse précise :
Exemple de consigne :
Transforme cette expérience professionnelle en réponse structurée avec la méthode STAR. Conserve uniquement les faits fournis. Fais apparaître le contexte, la responsabilité, les actions et le résultat. La réponse doit pouvoir être prononcée en moins de 90 secondes.
Une réponse STAR efficace ne doit pas devenir une histoire trop longue. Le temps consacré aux actions et aux résultats doit être supérieur à celui consacré au contexte.
L’IA peut aussi servir à préparer des sujets plus délicats :
Demandez une formulation honnête et orientée vers les solutions :
Propose trois manières de répondre à cette question difficile : [insérer la question]. Le ton doit être transparent, professionnel et constructif. Évite les excuses excessives et les affirmations invérifiables.
Il ne faut jamais demander à l’IA d’inventer un résultat, une responsabilité ou une compétence. Une réponse embellie peut être détectée par des questions de relance.
Certains assistants IA permettent de converser à l’écrit ou à l’oral. Le mode vocal est particulièrement intéressant pour un entretien à distance, car il reproduit mieux la pression d’une question posée en temps réel.
Consigne recommandée :
Agis comme un recruteur pour le poste décrit ci-dessous. Pose une seule question à la fois. Attends la réponse avant de continuer. Alterne questions générales, questions techniques et questions comportementales. Ne donne aucun indice pendant la simulation. À la fin, évalue la clarté, la pertinence, la structure et la durée des réponses.
Pour obtenir une simulation réaliste, ajoutez les contraintes suivantes :
Une simulation utile ne consiste pas à obtenir uniquement des encouragements. Demandez une évaluation avec des critères mesurables :
Commencez par une simulation standard, puis demandez des variantes :
Chaque interlocuteur recherche des éléments différents. Le recruteur vérifie souvent la cohérence du parcours et la motivation. Le manager s’intéresse davantage à la manière de travailler. L’entretien technique cherche à valider les compétences opérationnelles.
Une réponse trop courte peut sembler superficielle. Une réponse trop longue peut donner l’impression d’un manque de synthèse. Enregistrez quelques réponses avec l’accord des personnes éventuellement visibles ou audibles, puis utilisez un outil de transcription pour analyser :
À titre indicatif, une réponse standard peut durer 45 à 90 secondes. Une réponse technique ou fondée sur un exemple complexe peut atteindre deux minutes, à condition de rester structurée.
Prompt d’analyse :
Analyse cette transcription d’entretien. Repère les répétitions, les réponses trop longues, les affirmations vagues et les moments où un exemple concret serait nécessaire. Propose uniquement des axes d’amélioration, sans réécrire toute la réponse.
Une application peut parfois analyser le regard, la posture, le débit ou les expressions faciales. Ces indicateurs doivent être interprétés avec prudence. Une IA ne peut pas déterminer de façon fiable la personnalité, la sincérité ou l’aptitude professionnelle d’une personne à partir de son visage.
Pour la visioconférence, les conseils les plus fiables restent pratiques :
L’IA peut fournir un retour complémentaire, mais le confort, la clarté du son et la stabilité de la connexion sont prioritaires.
Demandez à l’assistant de générer une checklist personnalisée selon l’outil utilisé : Zoom, Microsoft Teams, Google Meet ou une autre plateforme.
La vérification doit inclure :
Un test technique doit être effectué au moins 24 heures avant l’entretien, puis rapidement une nouvelle fois 15 à 30 minutes avant le rendez-vous.
Une coupure peut arriver malgré une bonne préparation. Préparez à l’avance :
Exemple :
La connexion semble instable. Je vais désactiver la caméra quelques instants pour poursuivre l’échange, puis la réactiver dès que possible.
L’IA peut aider à rédiger ce type de message, mais la priorité reste de rétablir rapidement la communication.
À J-7, concentrez-vous sur :
Évitez de demander à l’IA de résumer une entreprise sans vérifier les informations sur le site officiel, les communiqués de presse et les sources économiques fiables. Les modèles peuvent produire des informations anciennes ou inexactes.
À J-3, réalisez :
Laissez suffisamment de temps entre deux simulations pour corriger un point précis : réponse trop longue, manque d’exemple, débit trop rapide ou motivation insuffisamment personnalisée.
La veille, évitez de générer des dizaines de nouvelles réponses. Relisez plutôt une fiche courte contenant :
Le jour même, utilisez l’IA uniquement comme aide organisationnelle. Évitez de consulter discrètement un assistant pendant l’entretien pour générer des réponses en direct. Cette pratique peut violer les règles de l’entreprise, ralentir l’échange et donner un discours artificiel.
Le coût dépend des outils utilisés :
Une préparation efficace peut être réalisée en deux à quatre heures, réparties sur plusieurs jours :
L’abonnement payant n’est pas indispensable pour un entretien unique. Il devient plus pertinent pour une recherche d’emploi prolongée, plusieurs candidatures ciblées ou une préparation en langue étrangère.
Une IA peut inventer une information sur une entreprise, une technologie ou un recruteur. Vérifiez toujours :
Des réponses trop polies, trop génériques ou trop parfaites peuvent sembler artificielles. Le recruteur cherche généralement à comprendre une expérience réelle, pas à entendre un texte optimisé.
Ajoutez des détails concrets : volume de projets, taille d’une équipe, délai, problème rencontré, décision prise ou résultat obtenu. Ces éléments rendent le discours plus crédible.
Ne transmettez pas sans précaution :
Anonymisez le CV et l’offre si possible. Vérifiez les paramètres de conservation des conversations et la politique de confidentialité du service. En contexte professionnel, privilégiez un outil autorisé par l’entreprise ou une solution disposant de garanties adaptées au traitement des données.
Avant d’enregistrer une simulation avec une autre personne, informez-la et obtenez son accord. Pour un véritable entretien, l’utilisation d’un outil de transcription ou de prise de notes automatique doit être signalée et acceptée par les participants, conformément aux règles applicables et à la politique de l’entreprise.
L’IA peut aider à produire une liste, mais les questions doivent être sélectionnées selon le contexte. Exemples pertinents :
Évitez les questions dont la réponse apparaît clairement sur la page d’accueil de l’entreprise. Préparez au moins trois questions, même si le temps disponible varie.
Non. L’IA est efficace pour structurer, simuler et reformuler, mais elle ne connaît pas toujours le contexte réel d’une expérience professionnelle. Un ancien collègue, un mentor ou un conseiller carrière peut repérer des éléments difficiles à détecter automatiquement : manque de spontanéité, posture défensive, réponse peu convaincante ou exemple mal choisi.
La meilleure approche combine :
L’IA peut considérablement améliorer la préparation d’un entretien d’embauche à distance si elle est utilisée comme un outil d’entraînement plutôt que comme un générateur de réponses toutes faites. Les usages les plus efficaces consistent à analyser l’offre, relier les expériences au poste, préparer des réponses STAR, simuler plusieurs types d’entretien et vérifier la configuration technique.
La préparation doit commencer plusieurs jours avant le rendez-vous et inclure des répétitions à voix haute. Les informations fournies par l’IA doivent être vérifiées, les données personnelles protégées et tout enregistrement réalisé avec l’accord des participants. Le jour de l’entretien, la priorité reste un échange clair, naturel et honnête.

![]()
Deezer ajoutera d'ici la fin de l'année 2026 un bouton pour faire disparaître de la recherche les morceaux entièrement générés par IA. La plateforme dit recevoir près de 90 000 titres de ce type chaque jour.

![]()
Faire tourner une IA sur quinze boîtiers Android TV : c’est l’expérience menée par Anthropic, qui étudie comment des modèles pourraient se multiplier sur des objets connectés, sans data center. Un scénario dont plusieurs étapes restent à démontrer.
![]()
Selon Bloomberg, Epic Games a repoussé le jeu de tir qu'il développe pour Disney, qui doit réunir des personnages de Marvel et de Star Wars. Pour accélérer le développement de ce projet, initialement prévu pour mars 2027, le studio mise désormais sur l’intelligence artificielle.


Trois manuscrits en moins, sur un catalogue présenté comme une démonstration de puissance mathématique à grande échelle. Après la découverte d’une erreur de signe dans l’un de ses arguments, OpenAI a retiré des travaux et rappelle qu’un texte produit par une IA ne vaut pas encore validation d’un résultat.
Le 6 octobre, OpenAI a mis à disposition 722 manuscrits générés par un modèle interne, regroupés en 372 familles de résultats. L’ensemble couvre de nombreux domaines des mathématiques et revendique des avancées sur plusieurs problèmes ouverts ou réputés difficiles.
L’annonce était spectaculaire par son volume. Elle suggérait qu’un même système pouvait explorer, en parallèle, des centaines de pistes de recherche généralement traitées par des équipes spécialisées pendant des mois, voire des années. Mais un catalogue de textes n’est pas une collection de théorèmes certifiés.
Après la découverte d’une erreur de signe dans un argument, trois manuscrits ont été retirés. Le catalogue en compte désormais 719. OpenAI indique également avoir corrigé d’autres documents et ajouté des formalisation de preuves dans Lean, un assistant de preuve capable de vérifier automatiquement certaines étapes mathématiques.
La différence entre les trois catégories est essentielle : retirer un manuscrit signifie reconnaître qu’il ne peut plus être présenté dans sa forme initiale ; corriger un document suppose que l’erreur peut être isolée et réparée ; ajouter une formalisation vise à rendre certaines preuves contrôlables par un outil informatique. Aucun de ces mécanismes ne permet toutefois, à lui seul, de conclure que l’ensemble du corpus est fiable.
Dans un raisonnement mathématique, une erreur de signe n’est pas nécessairement une coquille sans conséquence. Elle peut modifier une inégalité, inverser une condition de convergence ou rendre fausse une identité utilisée plusieurs pages plus loin. Si l’étape fautive sert de fondation à plusieurs résultats, l’invalidité se propage dans tout le manuscrit.
La difficulté tient précisément au fait que les textes produits par les modèles de langage peuvent présenter une apparence convaincante : notation cohérente, enchaînement formel, vocabulaire spécialisé et conclusions plausibles. Cette apparence rend la vérification humaine indispensable, surtout lorsque les arguments s’appuient sur des objets abstraits ou de longues chaînes de déductions.
Le retrait de trois manuscrits ne permet donc pas d’estimer directement la proportion d’erreurs restante. Il constitue seulement le premier chiffre public d’un audit dont l’étendue n’est pas connue. Le passage de 722 à 719 mesure le volume du catalogue, pas son taux de validité.
Cette distinction est centrale pour évaluer la portée de l’initiative. Une découverte mathématique ne se résume pas à une conjecture intéressante ou à une stratégie prometteuse. Elle doit résister aux vérifications, aux contre-exemples, à la relecture de spécialistes et, lorsque c’est possible, à une formalisation indépendante.
La présence de preuves formalisées dans Lean constitue l’élément le plus solide de la mise à jour annoncée par OpenAI. Dans cet environnement, une preuve est traduite dans un langage dont le noyau informatique vérifie que les règles appliquées respectent les définitions et les axiomes déclarés.
Cette approche peut empêcher certaines erreurs classiques : étape logique manquante, utilisation incorrecte d’un lemme ou manipulation algébrique invalide. Elle transforme une partie du débat en question vérifiable par ordinateur plutôt qu’en simple examen de prose mathématique.
Mais Lean ne répond pas à toutes les questions. Le système vérifie la preuve d’un énoncé formalisé ; il ne garantit pas que cet énoncé correspond exactement au problème décrit dans le manuscrit. Il ne juge pas non plus la pertinence des hypothèses, l’intérêt du résultat ou l’originalité de la démarche. Une formalisation peut être parfaitement correcte tout en démontrant une proposition plus faible, différente ou moins générale que celle annoncée.
La couverture compte également. OpenAI indique avoir ajouté des formalisations, mais cela ne signifie pas que les 719 manuscrits restants sont intégralement traduits dans Lean. La fiabilité du corpus dépendra donc de la part effectivement formalisée, de la qualité de cette traduction et de la capacité de chercheurs indépendants à reproduire les résultats.
L’épisode met en lumière une tension entre deux échelles de temps. Un modèle peut générer rapidement des centaines de pistes, de conjectures et d’arguments. La validation, elle, reste contrainte par le temps des mathématiciens capables de les lire, de les tester et de les replacer dans la littérature existante.
Ce décalage est particulièrement important pour les problèmes ouverts. Dans ce domaine, une idée partiellement juste peut être précieuse même si le manuscrit qui la contient comporte une erreur. Mais il faut alors distinguer clairement une piste de recherche, un résultat corrigible et une preuve établie. Les trois manuscrits retirés montrent que cette frontière ne peut pas être laissée à la seule présentation du modèle.
L’annonce d’OpenAI doit donc être lue comme un programme d’exploration, non comme une liste de 719 avancées validées. La quantité produite peut aider à repérer des structures, proposer des lemmes ou accélérer certaines recherches. Elle accroît aussi le coût du tri : plus le modèle génère de textes, plus la vérification devient le goulot d’étranglement.
Le prochain jalon sera concret : publication d’un historique détaillé des corrections, extension des formalisations dans Lean et validation par des équipes extérieures. La mesure la plus significative ne sera pas le nombre de manuscrits déposés, mais celui des résultats qui survivront à une relecture indépendante et à une vérification formelle. Pour l’instant, 719 est un inventaire ; ce n’est pas encore un bilan scientifique.


![]()
Si l'IA s'impose dans de nombreux usages du quotidien, ses effets à long terme sur nos capacités intellectuelles restent mal connus, par manque de recul. Une étude présentée début octobre montre pourtant qu'une dizaine de minutes d'usage suffit à entamer notre capacité à persévérer face à un problème.