❌

Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hierFlux principal
  • ✇ActuIA
  • IA & Multimodalité : entretien avec Cordelia Schmid, spécialiste de la vision par ordinateur
    Mondialement reconnue pour ses recherches et ses contributions à la représentation d’images et de vidéos pour la reconnaissance visuelle, Cordelia Schmid est une figure majeure de la vision par ordinateur. Dans le cadre des jeux olympiques 2024, nous vous offrons chaque jour un article d’archive issu du magazine ActuIA n°4 (avril 2021), dont le dossier principal est “Le sport à l’ère de l’IA”. Afin de découvrir le magazine ActuIA, nous vous invitons à vous rendre sur notre boutique. Tout nouvel

IA & Multimodalité : entretien avec Cordelia Schmid, spécialiste de la vision par ordinateur

Par : ActuIA
29 juillet 2024 à 14:30

Mondialement reconnue pour ses recherches et ses contributions à la représentation d’images et de vidéos pour la reconnaissance visuelle, Cordelia Schmid est une figure majeure de la vision par ordinateur.


Dans le cadre des jeux olympiques 2024, nous vous offrons chaque jour un article d’archive issu du magazine ActuIA n°4 (avril 2021), dont le dossier principal est “Le sport à l’ère de l’IA”. Afin de découvrir le magazine ActuIA, nous vous invitons à vous rendre sur notre boutique. Tout nouvel abonnement d’un an vous donne droit à l’ensemble des archives au format numérique.


Une chercheuse internationalement réputée

Cordelia Schmid est titulaire d’une maîtrise en informatique de l’Institut de technologie de Karlsruhe et d’un doctorat en informatique de l’Institut polytechnique de Grenoble (INPG). Sa thèse de doctorat traite des « Appariement d’images par invariants locaux de niveaux de gris : application à l’indexation d’une base d’objets » et a reçu le prix de la meilleure thèse de l’INPG en 1996. Elle a reçu son habilitation universitaire en 2001 pour son travail intitulé “From Image Matching to Learning Visual Models”. Le Dr Schmid a été assistant de recherche postdoctoral au sein du Robotics Research Group de l’université d’Oxford en 1996-1997. Depuis 1997, elle est directrice de recherche à l’Inria. Auteure de plus de trois cents publications techniques, elle a été rédactrice adjointe pour IEEE Transactions on Pattern Analysis and Machine Intelligence (IEEE PAMI) (2001-2005), pour International Journal of Computer Vision (IJCV) (2004-2012), rédactrice en chef d’IJCV (2013–), présidente de programme d’IEEE Conference on Computer Vision and Pattern Recognition (CVPR) 2005 et ECCV 2012 et présidente générale de l’IEEE CVPR 2015, ECCV 2020 et ICCV 2023.

En 2006, 2014 et 2016, elle a reçu le prix Longuet-Higgins pour ses contributions fondamentales en vision par ordinateur qui ont résisté à l’épreuve du temps. Elle est membre de l’IEEE. Elle a reçu une bourse ERC Advanced Grant en 2013 pour
son projet ALLEGRO “Active Large-scale LEarninG for visual RecOgnition”, le
Prix de recherche Humbolt en 2015 et le Grand Prix Inria & Académie française des
sciences en 2016. Elle a été élue à l’Académie nationale allemande des sciences,
Leopoldina, en 2017. En 2018, elle a reçu le Prix Koenderink pour ses travaux sur
la vision par ordinateur. Elle a reçu le prix de la Royal Society Milner en 2020.
Depuis 2018, elle travaille à mi-temps sur l’intelligence artificielle au sein de Google
Research.

Qu’est-ce qui vous a menée vers l’intelligence artificielle ?

J’ai réalisé ma thèse en vision par ordinateur. Depuis vingt ans, l’apprentissage n’a cessé de jouer un rôle grandissant. Il y a vingt ans, les recherches en vision par ordinateur portaient par exemple sur la conception de caractéristiques invariantes comme les points d’intérêt robustes et répétables et leur mise en correspondance. Ces composantes « conçues par l’homme » (hand-crafted features) ont été remplacées au fur et à mesure
par des algorithmes d’apprentissage directement à partir de données.

Il y a trente ans, la classification de chiffres manuscrits était un objectif ambitieux. Depuis, les progrès en vision par ordinateur n’ont cessé, tant sur le plan de l’analyse que de la génération d’images. Quels sont les grands challenges actuels et futurs de la vision par ordinateur ?

Il existe aujourd’hui plusieurs grands challenges. Tout d’abord la compréhension d’images et vidéos est loin d’être résolue. Il est aujourd’hui possible de détecter des objets, mais
nous sommes loin de pouvoir décrire de façon précise le contenu d’images et de vidéos, c’est-à-dire obtenir une description complète comme « La maison est dans un champ et il y a des enfants qui jouent au ballon ». Un autre défi est d’obtenir une confiance et une explication pour la réponse d’un algorithme. Il est aujourd’hui dans la majorité des cas impossible de savoir quelle est la probabilité d’erreur d’une réponse algorithmique et pourquoi l’algorithme est arrivé à cette réponse. Un des buts à long terme est de pouvoir utiliser la vision pour interagir avec le monde, par exemple en conduite autonome, où les défis sont l’apprentissage de la reconnaissance de l’environnement et l’apprentissage de la conduite de façon interactive avec l’environnement, dont les autres véhicules, qu’ils soient
autonomes ou pas.

Les champs de recherche de la vision par ordinateur et du traitement automatisé du langage semblent se rapprocher, un parallèle pouvant être fait entre les séquences vidéo et les phrases. Comment l’expliqueriez-vous à nos lecteurs ?

Les approches dans les deux domaines, vision par ordinateur et traitement automatisé du langage, reposent sur des méthodes traditionnellement basées sur des caractéristiques fabriquées « à la main » (hand-crafted features) et très spécifiques au problème.

Depuis quelques années, ces deux domaines ont adopté le paradigme de l’apprentissage à partir de données supervisées telles que « il y a un chat dans l’image ». Si dans un premier temps les approches d’apprentissage étaient propres au domaine : des réseaux de neurones récurrents en traitement automatisé du langage et des réseaux de neurones à convolution en vision par ordinateur, aujourd’hui les approches dites transformer sont utilisées pour modéliser des séquences de mots dans un texte et des séquences d’images
dans des vidéos, où le mot correspond à l’image et la phrase à la séquence vidéo.

Pour aller plus loin, des projets comme VideoBert, ouvrent des portes vers un apprentissage croisé. Ce type d’approche peut aider la vision artificielle à s’appuyer sur
les dialogues, et inversement, permettre aux modèles de TAL de tenir compte des expressions faciales pour détecter, par exemple, l’ironie, dans le langage… quelles sont les dernières avancées et limites en la matière ?

En effet, plus récemment les approches dites transformer ont permis l’apprentissage à partir de données multimodales (bande son et/ou texte et images d’une vidéo). Par exemple, l’approche VideoBERT utilise les données vidéo représentées par un ensemble de
descripteurs temporels, chacun extrait sur une seconde, et les dialogues sont transcrits automatiquement par une approche de reconnaissance automatique de la parole pour obtenir une représentation plus riche de la vidéo.

Une telle approche permet ainsi d’aider autant la vision artificielle que les modèles de TAL. Par ailleurs, elle permet l’apprentissage sans exemples annotés à la main. Un tel apprentissage est appelé « faiblement supervisé » (zeroshot recognition).

Les dernières avancées portent sur des architectures logicielles plus performantes, rendues possibles grâce à l’évolution de la puissance de calcul et des architectures matérielles, et des manières nouvelles de collecter des données représentatives du problème.
En effet, ces modèles, tels que VideoBERT, ont besoin d’une grande quantité de données pour que l’apprentissage converge. Ceci est dû au nombre important de paramètres définissant le modèle. Ce paramétrage est à la fois une force puisque beaucoup
d’information peut être stockée dans le modèle et une limite puisque cela rend
l’approche coûteuse et difficilement applicable à des domaines comportant peu de données. En fonction des données utilisées, ces modèles peuvent montrer des biais importants. L’étude de ces biais et comment les éviter est un des nouveaux sujets de recherche.

Que doit-on conclure du développement de l’apprentissage multimodal ? Nous rapprochons-nous d’une intelligence artificielle générale ?

Nous avons fait des progrès significatifs dans le domaine de l’intelligence artificielle depuis dix ans. En vision artificielle par exemple, de nombreuses tâches, la détection d’objets et l’identification de personnes, sont possibles aujourd’hui et ne l’étaient pas il y a dix ans. Par ailleurs, la recherche en IA commence à se pencher sur des problèmes qui adressent plusieurs modalités et domaines, comme l’apprentissage croisé qui apprend à partir de données multimodales (vision, audio et texte) et l’exploration autonome par un robot doté d’un système de vision.

Toutefois, nous sommes encore très loin de ce que l’on appelle « l’intelligence artificielle générale », c’est-à-dire pouvoir raisonner et agir dans un environnement inconnu. Un exemple de test pour voir si une machine possède une telle intelligence est le “coffee test
(Wozniak): a machine is required to enter an average American home and figure out how to make coffee : find the coffee machine, find the coffee, add water, find a mug, and brew the coffee by pushing the proper buttons.” Nous sommes encore loin d’une telle capacité d’apprentissage et il s’agit d’une question ouverte en recherche.

Dans et hors du champ pur de la recherche, quels sont vos sujets d’intérêt et de préoccupation liés à l’IA dans sa globalité ?

Mes recherches actuelles portent tout d’abord sur la conception d’algorithmes de vision par ordinateur, notamment pour améliorer la compréhension des vidéos. Au-delà, mes sujets d’intérêt concernent les problèmes d’apprentissage faiblement supervisés à partir de données multimodales, donc en combinant vision, son et texte.

À plus long terme l’une de mes préoccupations sera d’apprendre des modèles interagissant avec l’environnement et donc apprenant de façon autonome en fonction de leur échec et de leur réussite. Nous pouvons citer comme exemple récent AlphaGo, même si dans un contexte de vision par ordinateur, le problème est plus complexe. J’ai par exemple commencé récemment à examiner des problèmes de type « vision, langage, navigation » qui demandent à un agent de se déplacer dans un environnement naturel avec des instructions en langue naturelle. Un autre exemple est celui de l’utilisation
de l’apprentissage pour guider un robot manipulateur. Une application intéressante me semble être le robot cuisinier. Il est regrettable qu’il n’existe pas déjà. Lors d’une pandémie comme celle que nous vivons actuellement, un tel robot serait fort utile pour les « nuls en
cuisine ». Côté recherche il s’agit d’un problème complexe qui nécessite à la fois la planification, la reconnaissance visuelle et une interaction précise avec
des objets.

À titre personnel, quelles sont les applications concrètes de l’intelligence artificielle qui ont le plus attiré votre attention dernièrement ?

À titre personnel, ce sont la voiture autonome et les systèmes d’accompagnement des personnes handicapées (dont celles à vision réduite). Selon moi, le but de l’intelligence artificielle est d’aider un humain à réaliser des tâches fastidieuses ou dangereuses
ou de lui faire gagner du temps. La voiture autonome permet de gagner
les heures passées au volant, de réduire l’accidentologie, de fluidifier la circulation et de rendre celle-ci accessible à des personnes n’y ayant pas accès (handicap, âge…). Côté recherche, le problème m’intéresse de par la très grande quantité de données supervisées accessible.

Ces données prises dans des environnements relativement bien structurés permettent d’évaluer des algorithmes d’apprentissage dans des environnements nouveaux avec des
moyens d’évaluations des échecs et des réussites non ambigus. Concernant les systèmes d’accompagnement des personnes handicapées, il s’agit de comprendre l’environnement pour alerter l’humain et interagir avec lui, une combinaison de plusieurs sources de données.


Cet article est extrait du magazine ActuIA. Afin de ne rien manquer de l’actualité de l’intelligence artificielle, procurez vous ActuIA n°16, actuellement en kiosque et sur abonnement :

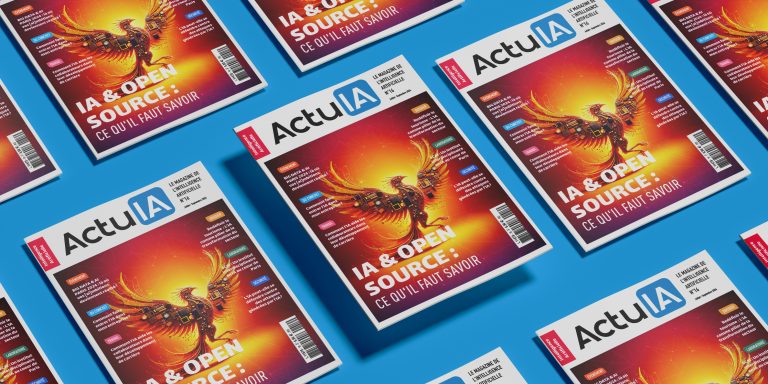
Entretien avec Cordelia Schmid
  • ✇ActuIA
  • ActuIA n°16 : ce que vous réserve le nouveau numéro du magazine de l’intelligence artificielle
    L’été est déjà là et la nouvelle édition du magazine ActuIA est dans les starting-blocks pour vous accompagner. En version numérique ou papier, ce sera la lecture idéale pour les professionnels et passionnés de l’IA, en vacances ou au bureau ! Ce nouveau numéro, disponible dès le 16 juillet, sera l’occasion pour vous de profiter de nos traditionnelles rubriques, comme le condensé d’actus du trimestre, les levées de fonds, notre sélection culturelle, mais aussi des dossiers d’analyse sur l’open s

ActuIA n°16 : ce que vous réserve le nouveau numéro du magazine de l’intelligence artificielle

Par : Amira Hadak
18 juillet 2024 à 15:00

L’été est déjà là et la nouvelle édition du magazine ActuIA est dans les starting-blocks pour vous accompagner. En version numérique ou papier, ce sera la lecture idéale pour les professionnels et passionnés de l’IA, en vacances ou au bureau !

Ce nouveau numéro, disponible dès le 16 juillet, sera l’occasion pour vous de profiter de nos traditionnelles rubriques, comme le condensé d’actus du trimestre, les levées de fonds, notre sélection culturelle, mais aussi des dossiers d’analyse sur l’open source, l’impact de l’IA dans le tourisme, secteur en plein bouleversement et sur la sécurité de l’IA, sujet on ne peut plus central.

Si vous n’êtes pas encore abonné(e), inscrivez-vous dès aujourd’hui et recevez-le directement chez vous ou sur votre lieu de travail.

Au sommaire du n° 16 d’ActuIA :

Actualités
Une revue de toutes les actualités de ces derniers mois : droit, éthique, santé, projets de recherche, business… Retrouvez toutes les informations qu’il ne fallait pas louper ce dernier trimestre en France comme à l’étranger.

Levées de fonds
Une sélection de levées de fonds récentes dont bien évidemment celle de Mistral AI, agrémentée d’une analyse de Chadi Hantouche, Partner chez Wavestone.

Comment faire entrer l’IA dans mon entreprise ?
Virginie Desbordes, Responsable du pôle Confiance numérique du groupe AFNOR, nous apporte son regard sur le déploiement de l’IA dans les entreprises et comment en profiter.

Sélection du comité scientifique
Zoom sur deux publications scientifiques qui ont retenu l’attention de notre comité scientifique au cours des derniers mois.

IA & open source : ce qu’il faut savoir
Nous savons ce qu’est l’open source, comment cela fonctionne, mais que cache-t-elle ?

La fonction RH du futur : comment l’IA aide les collaborateurs dans le développement de leur carrière
Emmanuelle Blons, vice-présidente associée chez Infosys France et spécialiste de la transformation digitale et des RH, ainsi que Belkacem Laïmouche, pilote du groupe « Ressources humaines » du Hub France IA, explorent les aspects de la transformation des RH par l’IA.

SCAI : un institut interdisciplinaire en IA au cœur de Paris
Zoom sur le SCAI, Sorbonne Center for Artificial Intelligence, dirigé par Gérard Biau. Nous vous proposons de découvrir les activités et plusieurs des projets phares de ce centre qui est l’une des références françaises en IA.

Big Data et AI Paris 2024 : l’événement de référence de l’innovation data & IA revient pour accélérer le futur des entreprises
Nous nous penchons sur la 13e édition de l’événement français de référence du big data et de l’intelligence artificielle qui se tiendra cet automne. Avec l’intervention de Yassine El Manouar, directeur de Big Data & AI Paris.

AI Index de Stanford : les principaux enseignements
Quelques chiffres clés sur, entre autres, la recherche IA, la production de modèles IA ou encore les investissements en IA générative.

Phil’IA : sommes-nous tous des Narcisse suspendus à nos selfies et à nos amis virtuels ?
Laurence Vanin, philosophe et essayiste, met notre réflexion philosophique à l’épreuve avec ce texte dans lequel elle nous compare, nous et nos écrans, à Narcisse. Ne manquez pas la publication de son nouveau livre qui offre une réflexion pointue autour de cette thématique.

Redéfinir le tourisme : l’IA comme pilier de la transformation du secteur
Dans ce dossier, nous abordons l’IA dans le tourisme. Entre des entretiens avec Edouard Gerondeau, responsable conseil secteur Tourisme chez Bpifrance, et Sébastien, créateur d’une IA influenceuse de Bretagne, l’utilisation de l’IA dans le tourisme n’aura plus de secret pour vous ! Steve Bellart et Nicolas de Bufala, ingénieurs R&D chez Talan, viennent compléter le dossier.

Portrait de Margaret Masterman Braithwaite
C’est la linguiste et philosophe britannique Margaret Masterman Brathwaite qui sera mise à l’honneur dans cette édition de notre rubrique pop culture.

LENS : lueurs d’Explicabilité pour les modèles de Vision artificielle
Focus sur le projet de recherche de Thomas Fel, candidat au doctorat en intelligence artificielle, à l’ANITI.

Comment l’IA transforme-t-elle les entreprises : insights de Stéphane Roder
Entretien avec Stéphane Roder, ingénieur Télécom Paris-Tech 92 et professeur à l’ESSEC. Il accompagne les directions générales, métiers et Data dans cette nouvelle transformation.

Sécurité de l’IA : l’IA peut-elle se défendre contre des attaques générées par l’IA ?
Françoise Soulié-Fogelman, conseillère scientifique chez Hub France IA, s’interroge sur la capacité de défense des systèmes d’IA face à des attaques d’un nouveau type.

Sécurité de l’IA : Les agents LLM piratent des sites internet en toute autonomie
Alexandra Benamar, ingénieure en R&D chez Talan, soulève une question très importante à l’heure actuelle, alors que les piratages se multiplient : en renforçant nos défenses, les IA contribuent-elles involontairement à affiner les stratégies offensives des hackers ?

Parole d’experts
Ce numéro met en lumière quatre experts en intelligence artificielle. Découvrez les expertises d’Iana Iatsun, spécialiste en intelligence artificielle à la Banque de France, Simone Vannuccini, titulaire de la Chaire de professeur junior en économie de l’intelligence artificielle et de l’innovation à l’Université Côte d’Azur (UCA), Nadia Guerouaou, docteure en neurosciences cognitives et Arnaud Muller, co-fondateur de Cleyrop.

Transformer la microbiologie en simplifiant l’analyse d’échantillons
Focus sur la start-up NeuralTeks, fondée par Mehdi Nasreddine et Souheil Hanoune. NeuralTeks mélange l’intelligence artificielle aux biotechnologies, avec comme objectif de transformer le paysage des laboratoires de microbiologie.

L’IA au Brésil : Stratégies, défis et opportunités dans un marché émergent
Alors que l’IA occupe une place de plus en plus importante au Brésil, découvrez comment le géant de l’Amérique latine aborde les premières étapes de cette transformation et les défis que le pays rencontre. Ce dossier est assemblé par Jean-Pierre Briot, directeur de recherche émérite CNRS au LIP6 et Giordano Cabral, professeur à l’UFPE. Cet article est complété par un entretien avec Fabio Cozman et Giordano Cabral disponible sur ActuIA et qui vous permettra d’aller plus loin sur le sujet. Le Brésil rencontre des défis très intéressants et intéressera également les entrepreneurs à la recherche de nouveaux prospects à l’international.

Sélection culturelle
Notre sélection de livres consacrés à l’intelligence artificielle avec différents axes : éthique, développement durable de la technologie, business, recherche, etc.
Je m’abonne !

ActuIA n 16 ce que vous réserve le nouveau numéro du magazine de l’intelligence artificielle
  • ✇ActuIA
  • PERSEPHONE : Prophesée développe une IA neuromorphique pour les smartphones avec le soutien de Bpifrance
    Prophesee, start-up parisienne spécialisée dans les systèmes de vision artificielle basés sur l’ingénierie neuromorphique, annonce un investissement de 15 millions d’euros pour développer la prochaine génération d’IA neuromorphique dédiée aux téléphones mobiles. Ce projet, baptisé PERSEPHONE, cofinancé par Bpifrance dans le cadre de l’appel à projet “IA Embarquée” de France 2030, vise au développement d’une nouvelle génération de capteurs neuromorphiques, fabriqués en France. La vision neuromorp

PERSEPHONE : Prophesée développe une IA neuromorphique pour les smartphones avec le soutien de Bpifrance

Par : Thomas Calvi
12 juillet 2024 à 11:00

Prophesee, start-up parisienne spécialisée dans les systèmes de vision artificielle basés sur l’ingénierie neuromorphique, annonce un investissement de 15 millions d’euros pour développer la prochaine génération d’IA neuromorphique dédiée aux téléphones mobiles. Ce projet, baptisé PERSEPHONE, cofinancé par Bpifrance dans le cadre de l’appel à projet “IA Embarquée” de France 2030, vise au développement d’une nouvelle génération de capteurs neuromorphiques, fabriqués en France.

La vision neuromorphique est une technologie inspirée du fonctionnement du système visuel humain, en particulier du couple œil-cerveau. Elle se base sur des capteurs et des algorithmes qui imitent la manière dont le cerveau humain traite les informations visuelles. Contrairement aux caméras traditionnelles, qui capturent des images à des intervalles de temps fixes (par exemple, 30 images par seconde), les capteurs neuromorphiques capturent les changements dans une scène de manière asynchrone, en se concentrant uniquement sur les variations locales de luminosité.

Elle est utilisée dans différents domaines comme les véhicules autonomes, la robotique, la surveillance et la sécurité, la santé et les appareils mobiles.

Appliquée aux téléphones mobiles, l’IA neuromorphique rend possible de nombreuses avancées technologiques significatives en termes de qualité d’image, de très basse consommation énergétique, de traitement beaucoup plus rapide et de confidentialité des données puisque le traitement embarqué ne nécessite pas l’utilisation et le stockage dans un cloud.

Le projet PERSEPHONE

Le projet de Prophesee permettra l’exécution de modèles avancés d’IA appliqués à la vision directement au cœur des appareils mobiles, améliorant ainsi la qualité des photos et des vidéos.

Les capteurs neuromorphiques Metavision de Prophesee se distinguent par leur capacité à capturer les mouvements dans une scène de manière continue et à des vitesses extrêmes. Chaque pixel du capteur intègre une intelligence dédiée, lui permettant d’agir comme un neurone et de s’activer de manière autonome en fonction du mouvement qu’il détecte. Cette approche innovante permet non seulement un défloutage de haute performance mais également une synchronisation parfaite entre le capteur d’image et le capteur neuromorphique, comblant ainsi les vides d’information à l’échelle de la microseconde pour extraire algorithmiquement les informations de mouvement.

Luca Verre, CEO de Prophesee commente :

“Ce nouveau financement dans le cadre de France 2030 confirme le leadership technologique de Prophesee. Avec nos partenaires de référence, nous avons l’ambition de faire émerger la nouvelle génération d’IA neuromorphique embarquée à destination du marché du téléphones mobiles où notre technologie assure un saut technologique”.

PERSEPHONE Prophesée développe une IA neuromorphique pour smartphone avec le soutien de Bpifrance
❌
❌