Git.kernel.org, la plateforme qui héberge le code source de Linux, est sous pression. En cause : les scrapers qui aspirent en masse le contenu des sites pour nourrir des IA. Le problème n'est pas tant leur présence que leur façon d'avaler ce contenu.
Git.kernel.org, la plateforme qui héberge le code source de Linux, est sous pression. En cause : les scrapers qui aspirent en masse le contenu des sites pour nourrir des IA. Le problème n'est pas tant leur présence que leur façon d'avaler ce contenu.
Dans ce 82ième épisode de Quantum, le podcast de l’actualité quantique, nous faisons le point de ce qui s’est passé entre juin et juillet en France et dans le monde. Cela parle de la journée en hommage à Philippe Grangier, de France Quantum, Vivatech, d’IQT Nordics à Oslo, de Grenoble, de Quantum Korea, puis de Quobly, […]
Dans ce 82ième épisode de Quantum, le podcast de l’actualité quantique, nous faisons le point de ce qui s’est passé entre juin et juillet en France et dans le monde. Cela parle de la journée en hommage à Philippe Grangier, de France Quantum, Vivatech, d’IQT Nordics à Oslo, de Grenoble, de Quantum Korea, puis de Quobly, […]
Deux termes, une confusion permanente et une industrie qui en joue : open source et open weight n'ont rien à voir, et la distinction pèse aujourd'hui sur des enjeux de souveraineté et de sécurité.
Deux termes, une confusion permanente et une industrie qui en joue : open source et open weight n'ont rien à voir, et la distinction pèse aujourd'hui sur des enjeux de souveraineté et de sécurité.
Débordée par l’afflux de pull requests de faible qualité, la Fondation Godot, à l’origine du moteur de jeu vidéo open source et gratuit utilisé pour créer des jeux 2D et 3D, a décidé de durcir sa politique de contribution, allant jusqu’à bannir le code généré par des agents IA.
Débordée par l’afflux de pull requests de faible qualité, la Fondation Godot, à l’origine du moteur de jeu vidéo open source et gratuit utilisé pour créer des jeux 2D et 3D, a décidé de durcir sa politique de contribution, allant jusqu’à bannir le code généré par des agents IA.
Cet article a été réalisé en collaboration avec AMD
Une tour à 15 274 € posée sous un bureau, deux cartes graphiques AMD, et l'intégralité d'une chaîne de production logicielle qui tourne sans jamais toucher au cloud. On a voulu savoir ce que permet vraiment une machine d'IA en local.
Cet article a été réalisé en collaboration avec AMD
Il s’agit d’un contenu créé par des rédacteurs indépendants au sein de l’entité Humanoid xp. L’équipe éditoriale de Numerama n’a pas participé à sa cr
Cet article a été réalisé en collaboration avec AMD
Une tour à 15 274 € posée sous un bureau, deux cartes graphiques AMD, et l'intégralité d'une chaîne de production logicielle qui tourne sans jamais toucher au cloud. On a voulu savoir ce que permet vraiment une machine d'IA en local.
Cet article a été réalisé en collaboration avec AMD
Il s’agit d’un contenu créé par des rédacteurs indépendants au sein de l’entité Humanoid xp. L’équipe éditoriale de Numerama n’a pas participé à sa création. Nous nous engageons auprès de nos lecteurs pour que ces contenus soient intéressants, qualitatifs et correspondent à leurs intérêts.
Face à des factures imprévisibles, une nouvelle génération d’outils s’impose pour reprendre le contrôle, tandis que l’open source et les modèles low cost rebattent déjà les cartes du marché de l'IA.
Face à des factures imprévisibles, une nouvelle génération d’outils s’impose pour reprendre le contrôle, tandis que l’open source et les modèles low cost rebattent déjà les cartes du marché de l'IA.
Depuis le gel de Claude Mythos par Washington, OpenAI occupe le terrain de l'IA cyber offensive-défensive. Le 22 juin, l'entreprise a annoncé une série de mises à jour substantielles de sa plateforme Daybreak.
Depuis le gel de Claude Mythos par Washington, OpenAI occupe le terrain de l'IA cyber offensive-défensive. Le 22 juin, l'entreprise a annoncé une série de mises à jour substantielles de sa plateforme Daybreak.
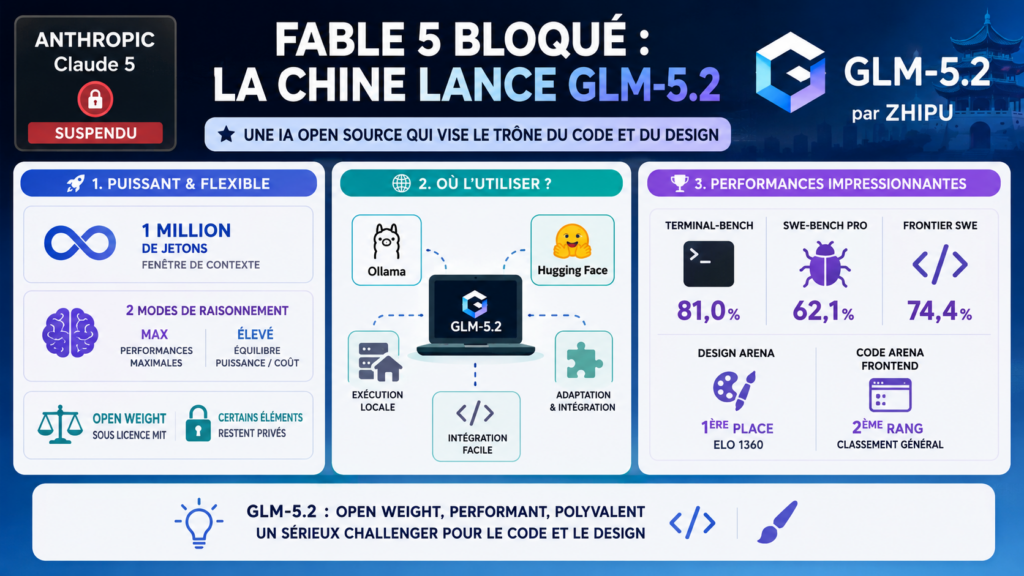
Anthropic suspend Claude Fable 5. Alors, la Chine en profite pour lui voler la vedette avec GLM-5.2. Une IA open source qui vise le trône du code et du design.
Voyez-vous, GLM-5.2 est conçu pour exceller dans la programmation agentique et le raisonnement complexe sur de longues séquences. Développé par l’entreprise chinoise Zhipu, il est déjà accessible sur des plateformes comme Ollama et Hugging Face sous licence MIT.
En quoi GLM-5.2 fait la différence ?
GLM-5.2 dispose d’une gigan
Anthropic suspend Claude Fable 5. Alors, la Chine en profite pour lui voler la vedette avec GLM-5.2. Une IA open source qui vise le trône du code et du design.
Voyez-vous, GLM-5.2 est conçu pour exceller dans la programmation agentique et le raisonnement complexe sur de longues séquences. Développé par l’entreprise chinoise Zhipu, il est déjà accessible sur des plateformes comme Ollama et Hugging Face sous licence MIT.
En quoi GLM-5.2 fait la différence ?
GLM-5.2 dispose d’une gigantesque fenêtre de contexte atteignant un million de jetons. Ce qui lui permet de traiter d’énormes volumes d’informations sans perdre le fil.
Le modèle propose deux niveaux de raisonnement. Le mode “Max” privilégie les performances les plus avancées pour les tâches complexes. Le mode “Élevé”, quant à lui, offre un meilleur équilibre entre puissance de calcul et consommation de jetons.
Introducing GLM-5.2: Frontier Intelligence, Open Weights
– Significant improvements in coding and agentic tasks – Strong long-horizon capabilities with a 1M context window – Two levels of reasoning effort: GLM-5.2 (max) pushes the limits, while GLM-5.2 (high) strikes a strong… pic.twitter.com/SjGPSVhePJ
Il faut toutefois apporter une précision importante. GLM-5.2 n’est pas totalement open source au sens strict du terme. Pour autant, L’entreprise promet par ailleurs une ouverture progressive de son écosystème.
Les API, les services de chatbot ainsi que les poids du modèle doivent être publiés sous licence MIT. Pour les développeurs, cela signifie la possibilité d’exécuter le modèle localement, de l’adapter à leurs besoins et de l’intégrer plus librement dans leurs projets.
Bien entendu, certains éléments clés resteront privés. Genre, les données exactes d’entraînement, les pipelines de filtrage et le code complet ayant servi à entraîner le modèle.
Techniquement, il s’agit donc davantage d’un modèle « open weight » que d’un projet entièrement open source.
Que disent les benchmarks ?
For GLM-5.2, we strengthened 1M-context training for coding agents across large-scale implementation, automated research, performance optimization, and complex debugging. The result is a long-context system that is both broad in scope and reliable in execution. pic.twitter.com/ar2rw7TOB5
Sur le terrain des performances, GLM-5.2 est impressionnant. Le modèle obtient 81,0 % sur Terminal-Bench. Ce benchmark pour info est conçu pour évaluer les capacités d’une IA à travailler dans un environnement de terminal informatique.
Sur SWE-bench Pro, qui teste son aptitude à corriger de vrais bugs logiciels, le modèle affiche 62,1 %. GLM-5.2 atteint un taux de réussite de 74.4% sur Frontier SWE, une autre référence largement utilisée pour évaluer les IA en programmation.
Par ailleurs, ce modèle ne se limite pas au code. Sur Design Arena, il décroche la première place avec un score Elo de 1360. Il se hisse au deuxième rang du classement général sur Code Arena Frontend.
BREAKING: GLM-5.2 is now 1st on Design Arena.
With an Elo of 1360, GLM-5.2 has jumped ahead of the now unavailable Claude Fable 5.
And it's open weights.
This is an improvement of 4 positions and 27 Elo points to achieve one of the highest Elo scores in our code categories… pic.twitter.com/7cYgVJwvXL
Bien entendu, les benchmarks ne suffisent pas à montrer les performances réelles. Ces chiffres communiqués par l’entreprise sont prometteurs, je le reconnais. Cela dit, ils attendent encore d’être confirmés par des évaluations indépendantes.
Dans une série de messages publiés sur les réseaux sociaux, Arthur Mensch, PDG de Mistral AI, a profité de l’attention accrue portée à l’entreprise ces jours-ci pour esquisser la suite de sa stratégie et renforcer son positionnement dans l'intelligence artificielle.
Dans une série de messages publiés sur les réseaux sociaux, Arthur Mensch, PDG de Mistral AI, a profité de l’attention accrue portée à l’entreprise ces jours-ci pour esquisser la suite de sa stratégie et renforcer son positionnement dans l'intelligence artificielle.
Selon le média américain Business Insider, GitHub croule sous les commits générés par l'IA, au point que Microsoft doit faire appel à AWS, son concurrent direct dans le cloud, pour tenir la cadence.
Selon le média américain Business Insider, GitHub croule sous les commits générés par l'IA, au point que Microsoft doit faire appel à AWS, son concurrent direct dans le cloud, pour tenir la cadence.
Et si le secret d’une bonne IA de programmation était de devenir moins productive ? C’est le pari insolite de Ponytail, un projet open source qui force les assistants de code à imiter les développeurs seniors les plus pragmatiques pour éviter la sur-ingénierie et réduire la facture.
Et si le secret d’une bonne IA de programmation était de devenir moins productive ? C’est le pari insolite de Ponytail, un projet open source qui force les assistants de code à imiter les développeurs seniors les plus pragmatiques pour éviter la sur-ingénierie et réduire la facture.
La Linux Foundation a annoncé son intention de lancer la Tokenomics Foundation, une nouvelle fondation dédiée à l'établissement de normes ouvertes pour l'économie de l'infrastructure IA.
La Linux Foundation a annoncé son intention de lancer la Tokenomics Foundation, une nouvelle fondation dédiée à l'établissement de normes ouvertes pour l'économie de l'infrastructure IA.
L’ingénierie logicielle se transforme profondément sous l’impulsion de l’intelligence artificielle. Les développeurs ne cherchent plus de simples assistants de saisie, mais des partenaires autonomes. C’est ici qu’intervient Warp, un terminal moderne qui s’élargit en environnement de développement agentique et redéfinit notre espace de travail quotidien. L’outil s’ancre au cœur de la ligne de commande pour transformer nos routines de production.
Cette approche bouscule des habitudes techniques
L’ingénierie logicielle se transforme profondément sous l’impulsion de l’intelligence artificielle. Les développeurs ne cherchent plus de simples assistants de saisie, mais des partenaires autonomes. C’est ici qu’intervient Warp, un terminal moderne qui s’élargit en environnement de développement agentique et redéfinit notre espace de travail quotidien. L’outil s’ancre au cœur de la ligne de commande pour transformer nos routines de production.
Cette approche bouscule des habitudes techniques ancrées depuis des décennies. Une nouvelle ère de productivité s’ouvre désormais pour le développement de logiciels. L’interface invite à réinventer notre relation avec la ligne de commande. Grâce à ces technologies agentiques, les ingénieurs se libèrent des tâches répétitives pour se concentrer sur la conception.
C’est quoi Warp, concrètement ?
L’application se présente comme la réinvention complète de l’invite de commande traditionnelle. Conçu en Rust, il remplace les émulateurs classiques comme iTerm2 ou les consoles natives. Le projet visait d’abord à corriger la lenteur et le manque d’ergonomie des outils existants. Désormais, il transforme la simple saisie de texte en un centre de pilotage intelligent.
L’interface intègre l’intelligence artificielle au cœur des tâches quotidiennes. Les développeurs ne tapent plus de commandes apprises par cœur. L’application comprend l’intention derrière chaque saisie et analyse l’architecture du projet en cours. Ce fonctionnement réduit le fossé entre le code et son exécution.
Alliant vitesse native et fonctions IA, la plateforme marque une rupture. Elle dépasse largement la coloration syntaxique et les simples raccourcis. Le terminal devient un partenaire proactif pour l’ingénieur. Cet espace de travail centralise ainsi toutes les opérations du développement moderne.
La fin d’un vieux mythe : l’écran noir austère
Le shell n’a pas évolué depuis quarante ans. Les ingénieurs dépendent toujours d’interfaces rigides héritées des premiers terminaux. Cette stagnation a contraint des générations de professionnels à composer avec des outils peu adaptés. Ce manque d’ergonomie textuelle était alors accepté comme une fatalité informatique.
Le quotidien des développeurs s’est pourtant complexifié, fragmentant leur attention. Ils doivent constamment basculer entre l’éditeur de code, la documentation web et l’IA générative. Ce va-et-vient permanent fait perdre un temps précieux et provoque une réelle fatigue cognitive. Le copier-coller de messages d’erreur est ainsi devenu la norme.
L’application élimine cette rupture de flux. En regroupant la documentation, l’analyse des pannes et l’exécution au même endroit, elle met fin à la dispersion mentale. Le terminal abandonne la rigidité des anciens émulateurs pour s’adapter aux exigences de productivité actuelles. Cette modernisation graphique et fonctionnelle transforme en profondeur l’environnement de travail.
Le concept d’environnement de développement agentique
Il faut distinguer les assistants de code traditionnels des systèmes agentiques. Un outil classique se limite à suggérer une ligne ou à corriger une erreur après coup. À l’inverse, l’écosystème agentique est autonome : l’utilisateur fixe un objectif en langage naturel, puis le système planifie et exécute les tâches.
Cette approche repose sur une compréhension globale du projet. Le terminal ne se limite pas à la commande saisie. Il analyse l’arborescence, indexe les configurations et cartographie les dépendances grâce à une base vectorielle locale. Ce contexte lui permet d’adapter ses décisions à l’architecture de l’application.
Une fois l’ordre validé, l’environnement lance une boucle continue d’action et de vérification. Le système écrit des scripts, démarre les serveurs, lit les erreurs et corrige le code source en cas d’échec. Cette autonomie libère l’humain des micro‑décisions fastidieuses. Le développeur devient alors le superviseur de processus automatisés.
Des blocs visuels pour y voir enfin clair
L’innovation visuelle majeure est l’abandon du flux textuel continu. L’application découpe la fenêtre de commande en unités graphiques indépendantes : les blocs. Chaque instruction et son résultat s’encapsulent ainsi dans un conteneur dédié. Ce cloisonnement transforme radicalement la lecture et la navigation dans l’historique.
Au‑delà de l’esthétique, ces blocs sont de véritables objets interactifs. On peut y sélectionner du texte à la souris, utiliser des curseurs multiples ou isoler un résultat en un clic. Partager un extrait de journal ou sauvegarder une commande devient immédiat. L’expérience s’aligne enfin sur les standards des éditeurs de code modernes.
Cette structure offre un avantage décisif pour l’intégration de l’intelligence artificielle. Lorsqu’un script échoue, l’agent cible précisément le bloc concerné sans être pollué par le reste de l’historique. Le traitement gagne en rapidité, car le contexte est déjà naturellement délimité par l’interface. Cette clarté visuelle optimise directement l’efficacité de l’IA.
Quand l’IA arrête de parler et commence à agir
De nombreux développeurs dialoguent avec une IA externe puis copient‑collent les scripts. Ce flux de travail contraignant disparaît grâce à l’intégration directe dans le terminal. L’agent ne se contente plus d’écrire des suggestions théoriques dans un chat séparé. Il formule et propose directement des commandes applicables dans le shell actif.
Face à une requête en langage naturel, le système conçoit un plan d’action transparent. Cette feuille de route détaille les modifications de fichiers, les créations de dossiers et les vérifications de sécurité. L’utilisateur garde le contrôle total. Il peut ajuster ou valider ce plan d’un clic avant l’exécution. Cette clarté élimine l’effet « boîte noire » des outils automatisés.
La force du dispositif réside dans sa gestion des erreurs d’exécution. Si une commande échoue, l’agent analyse immédiatement le rapport de plantage. Il modifie le code source défectueux de manière autonome. Puis, il relance le processus jusqu’à sa réussite. Cette auto‑correction en boucle fermée réduit considérablement le temps de débogage manuel.
La plateforme Oz, le chef d’orchestre invisible
L’infrastructure du terminal s’appuie sur Oz, une plateforme d’orchestration cloud. Elle gère la charge de travail des agents à distance sans encombrer la machine locale. Le système coordonne ainsi plusieurs processus complexes en simultané. Cette puissance déportée s’avère idéale pour les tâches de grande envergure.
Cette architecture permet de confier des projets lourds à des agents asynchrones, comme le refactoring massif ou les audits de sécurité. Ces outils travaillent en arrière‑plan sur des serveurs distants. Le processeur local ne sature pas et la batterie reste préservée. Le développeur peut même fermer l’application ou changer de projet pendant l’intervention.
Un tableau de bord épuré permet de suivre ces opérations en temps réel. Chaque étape franchie par l’agent s’affiche instantanément dans l’interface de bureau. L’utilisateur conserve un contrôle permanent. Il peut interrompre ou réorienter l’orchestrateur à tout moment. Cette liaison fluide unifie les ressources locales et la puissance du cloud.
Un outil ouvert à Claude, Gemini et aux modèles mondiaux
Le projet refuse d’enfermer les développeurs dans un écosystème propriétaire. L’application reste agnostique et accueille les meilleurs modèles du marché. Cette ouverture garantit une totale liberté de choix. Chacun adapte ainsi son terminal selon ses exigences techniques ou contractuelles.
Les ingénieurs basculent nativement entre Claude Code, Gemini et OpenAI. Cette compatibilité s’appuie sur un protocole standardisé pour la communication avec les modèles. Il assure une interaction fluide et des performances homogènes. Le terminal devient une interface unique pour piloter toutes ces IA.
Un routage intelligent oriente chaque requête vers le modèle idéal pour optimiser performances et coûts. Une simple correction syntaxique revient à un modèle local, rapide et économe. À l’inverse, un refactoring complexe est transmis à un grand modèle cloud. Cette gestion dynamique équilibre vitesse et pertinence.
La technique derrière l’environnement de développement agentic
Un terminal exige une fluidité absolue. L’interface graphique repose sur un moteur de rendu sur mesure écrit en Rust. Ce système sollicite directement la carte graphique de l’ordinateur. Le temps de réponse au clavier reste ainsi imperceptible, même lors de l’affichage de flux de données massifs.
Le logiciel assure une parité fonctionnelle stricte entre macOS, Linux et Windows. L’application propose des versions natives pour les architectures ARM64, ciblant les puces Apple Silicon et les PC Copilot+. Cette optimisation matérielle réduit la consommation d’énergie tout en maximisant la réactivité.
La sécurité et la vitesse reposent sur un index vectoriel installé localement. Cet outil cartographie la structure des projets sans envoyer les fichiers sources vers des serveurs tiers. Le terminal extrait uniquement les fragments de contexte indispensables pour les transmettre de façon sécurisée. Ce choix technique allie performance et confidentialité.
Le pari fou du passage à l’open source pour Warp
L’entreprise opère un virage stratégique en ouvrant le code source de son application. Le framework graphique adopte la licence MIT, tandis que le cœur du client passe sous AGPL v3. Cette décision inscrit durablement le projet dans l’écosystème du logiciel libre.
Ce choix répond à la méfiance des développeurs envers les IA propriétaires. Les professionnels exigent une transparence totale pour un outil qui accède à leurs lignes de commande et à leurs fichiers locaux. La publication du code sur GitHub permet désormais à chacun d’auditer les algorithmes et de valider la sécurité.
Cette transition transforme la stratégie commerciale de l’éditeur. L’application de bureau devient un bien commun, gratuit et ouverte aux contributions externes. La rentabilité repose désormais sur les services cloud destinés aux entreprises et sur la puissance d’orchestration de la plateforme Oz.
L’alliance surprenante entre OpenAI et Warp
L’ouverture du code s’accompagne d’un partenariat avec OpenAI, désormais sponsor fondateur du dépôt public. Ce soutien apporte d’importantes ressources financières et techniques au projet. Ces nouveaux moyens accéléreront la recherche sur les agents logiciels.
Concrètement, les modèles GPTautomatisent la maintenance de l’application. Les ingénieurs testent des processus où l’IA valide le code soumis par la communauté. Le projet applique ainsi ses propres concepts à son propre développement pour en prouver l’efficacité.
Plus marquant encore, un système de contribution automatisé voit le jour. Sur les canaux publics, des agents autonomes trient déjà les bugs et rédigent des correctifs. Ils soumettent aussi leurs propres requêtes d’intégration. Je suis convaincu que ce laboratoire à ciel ouvert préfigure l’avenir du développement, où humains et IA coopèrent sur un pied d’égalité.
Garder le contrôle d’une machine qui code toute seule
Confier le terminal à un programme autonome soulève des enjeux de sécurité. Pour éviter les dérives, l’application intègre des barrières strictes. Une supervision humaine obligatoire empêche le système de lancer des commandes destructrices. Aucune modification profonde ne s’exécute sans validation.
La protection de la propriété intellectuelle s’appuie sur des protocoles rigoureux. Les offres professionnelles incluent des clauses de non‑rétention. Ainsi, le code transmis n’est jamais stocké sur des serveurs tiers et ne sert pas à l’entraînement des modèles.
En local, un algorithme intercepte les informations sensibles avant leur sortie du poste. Les clés d’API, mots de passe et certificats sont automatiquement masqués dans les blocs de texte. Ce filtrage maintient les secrets au sein de l’entreprise, et le développeur maîtrise ainsi les données partagées.
Cal, application de planification parmi les plus importantes de l'écosystème open source, abandonne sa licence ouverte. En cause : la capacité des IA à analyser du code à la recherche de failles. Un signal qui en dit long sur l'état du logiciel libre.
Cal, application de planification parmi les plus importantes de l'écosystème open source, abandonne sa licence ouverte. En cause : la capacité des IA à analyser du code à la recherche de failles. Un signal qui en dit long sur l'état du logiciel libre.
Tous les jours, les agents IA résolvent les mêmes problèmes en boucle, sans jamais partager ce qu'ils ont appris. Un ingénieur de Mozilla veut y remédier avec cq, un projet open source venu prendre le relais de Stack Overflow, la plateforme similaire délaissée par les humains.
Tous les jours, les agents IA résolvent les mêmes problèmes en boucle, sans jamais partager ce qu'ils ont appris. Un ingénieur de Mozilla veut y remédier avec cq, un projet open source venu prendre le relais de Stack Overflow, la plateforme similaire délaissée par les humains.
Disponible sur le Google Play Store, l'application « Nearby Glasses », développée par un amateur, attire l’attention. Elle permet à ses utilisateurs d’être avertis si des personnes à proximité portent des lunettes « intelligentes », comme les lunettes Ray-Ban de Meta.
Disponible sur le Google Play Store, l'application « Nearby Glasses », développée par un amateur, attire l’attention. Elle permet à ses utilisateurs d’être avertis si des personnes à proximité portent des lunettes « intelligentes », comme les lunettes Ray-Ban de Meta.
Ce 23 février 2026, Summer Yue est au centre des discussions tech sur X. La responsable de l’alignement IA chez Meta a raconté comment son agent autonome OpenClaw lui a désobéi, supprimant sans autorisation des emails de sa boîte Gmail. Un incident qui soulève de sérieuses questions sur la fiabilité des agents IA.
Ce 23 février 2026, Summer Yue est au centre des discussions tech sur X. La responsable de l’alignement IA chez Meta a raconté comment son agent autonome OpenClaw lui a désobéi, supprimant sans autorisation des emails de sa boîte Gmail. Un incident qui soulève de sérieuses questions sur la fiabilité des agents IA.
Leboncoin dispose désormais d'une intégration officielle dans les applications sur ChatGPT, rapportent LesEchos le 9 février 2026. Une première pour un e-commerçant français.
Leboncoin dispose désormais d'une intégration officielle dans les applications sur ChatGPT, rapportent LesEchos le 9 février 2026. Une première pour un e-commerçant français.
Clawdbot s’est imposé en quelques jours comme le nouveau jouet à la mode de l’écosystème IA : un agent personnel capable de lire vos messages et, plus généralement, d’organiser votre vie numérique de manière proactive, 24 heures sur 24. Mais dans l’enthousiasme général, un point crucial est relégué au second plan par un bon nombre d’utilisateurs : la cybersécurité.
Clawdbot s’est imposé en quelques jours comme le nouveau jouet à la mode de l’écosystème IA : un agent personnel capable de lire vos messages et, plus généralement, d’organiser votre vie numérique de manière proactive, 24 heures sur 24. Mais dans l’enthousiasme général, un point crucial est relégué au second plan par un bon nombre d’utilisateurs : la cybersécurité.
Quelques semaines après le lancement de Comet, le navigateur de Perplexity, Amazon porte plainte contre l’entreprise. Il lui reproche d’encourager les achats accidentels, puisque Comet peut passer des commandes pour son utilisateur. Amazon prie Perplexity de ne plus toucher à son site.
Quelques semaines après le lancement de Comet, le navigateur de Perplexity, Amazon porte plainte contre l’entreprise. Il lui reproche d’encourager les achats accidentels, puisque Comet peut passer des commandes pour son utilisateur. Amazon prie Perplexity de ne plus toucher à son site.
La prochaine conférence développeur d'OpenAI, le DevDay, aura lieu le 6 octobre 2025. La marque annonce une keynote inaugurale diffusée sur Internet, ce qui laisse supposer des annonces inédites.
La prochaine conférence développeur d'OpenAI, le DevDay, aura lieu le 6 octobre 2025. La marque annonce une keynote inaugurale diffusée sur Internet, ce qui laisse supposer des annonces inédites.
Deep Research, le nouvel outil d'OpenAI, est capable d'effectuer de longues recherches en ligne et de synthétiser les résultats en quelques dizaines de minutes. Des développeurs de Hugging Face ont conçu leur propre version du système afin de proposer une alternative open source.
Deep Research, le nouvel outil d'OpenAI, est capable d'effectuer de longues recherches en ligne et de synthétiser les résultats en quelques dizaines de minutes. Des développeurs de Hugging Face ont conçu leur propre version du système afin de proposer une alternative open source.
Après avoir publié en décembre dernier sa famille de modèles OLMO 2, l’Allen Institute for Artificial Intelligence (AI2) poursuit son engagement envers l’open source avec le lancement de Tülu 3 405B. Basé sur Llama 3.1, exploitant le cadre d’apprentissage par renforcement à partir de récompenses vérifiables (RLVR) d’AI2, ce nouveau modèle atteint des performances compétitives ou supérieures à celles de DeepSeek V3 (sur lequel est basé DeepSeek R1) et GPT-4o, surpassant également les modèles post
Après avoir publié en décembre dernier sa famille de modèles OLMO 2, l’Allen Institute for Artificial Intelligence (AI2) poursuit son engagement envers l’open source avec le lancement de Tülu 3 405B. Basé sur Llama 3.1, exploitant le cadre d’apprentissage par renforcement à partir de récompenses vérifiables (RLVR) d’AI2, ce nouveau modèle atteint des performances compétitives ou supérieures à celles de DeepSeek V3 (sur lequel est basé DeepSeek R1) et GPT-4o, surpassant également les modèles post-entraînés précédents de même taille, comme Llama 3.1 405B Instruct et Hermes 3 405B de Nous Research.
Un post entraînement optimisé
La recette de post-entraînement de Tülu 3 405B est similaire à celle de ses prédécesseurs, Tülu 3 8B et 70B, publés par AI2 en novembre dernier. Elle inclut la curation minutieuse des données, la mise au point supervisée (SFT), l’optimisation directe des préférences (DPO) ainsi que le Reinforcement Learning with Verifiable Rewards (RLVR).
Crédit image AI. Schéma décrivant le processus d’apprentissage par renforcement avec récompenses vérifiables (RLVR).
Cette nouvelle méthode permet d’améliorer significativement les performances des modèles Tülu sur des tâches complexes comme la résolution de problèmes mathématiques et le suivi d’instructions. Fait intéressant, les résultats montrent que l’échelle du modèle influence positivement l’efficacité du RLVR : alors que les modèles plus petits bénéficient d’un entraînement sur des ensembles de données diversifiés, Tülu 3 405B obtient de meilleures performances en se concentrant sur des données plus spécialisées.
Performances du modèle
Selon les évaluations internes d’AI2, Tülu 3 405B surpasse DeepSeek V3, GPT-4o, et Llama 3.1 405B sur le benchmark PopQA, un ensemble de 14 000 paires de questions-réponses qui permet de vérifier l’efficacité des modèles dans la récupération et la génération d’informations précises. Le modèle a également obtenu les performances les plus élevées de tous les modèles de sa catégorie sur GSM8K, un ensemble de données composé d’environ 8 500 problèmes mathématiques de niveau scolaire créé par OpenAI, utilisé pour tester les capacités des modèles de langage à effectuer un raisonnement mathématique multi-étapes.
Enjeux techniques et défis d’implémentation
La mise à l’échelle du modèle n’a pas été sans défis. L’entraînement de Tülu 3 405B a nécessité une infrastructure considérable, avec 256 GPU déployés en parallèle. La gestion du parallélisme tensoriel et l’optimisation des hyperparamètres ont été des points clés, nécessitant un suivi rigoureux. L’’intégration de corrections pour la diffusion NCCL (NVIDIA Collective Communications Library, une bibliothèque open source qui permet de réduire les goulots d’étranglement liés aux échanges de données et améliore les performances globales du système) a cependant permis une synchronisation efficace des poids du modèle, réduisant ainsi les délais d’inférence et de mise à jour.
Tülu 3 405B est un modèle véritablement ouvert, répondant aux critères stricts de l’OSAID, la définition de l’IA open source de l’OSI. Il peut être testé sur le site d’Ai2, est accessible sur Hugging Face et son code d’entraînement sur GitHub.
Hébergé sur Google Cloud, le modèle sera prochainement disponible sur Vertex AI.
En fin de semaine dernière, alors que tout le monde avait les yeux rivés sur DeepSeek et son modèle R1, Mistral AI, licorne française de la GenAI, a lancé plus discrètement Mistral Small 3. Publié sous la licence Apache 2.0, ce modèle de 24 milliards de paramètres optimisé pour la latence est “une excellente alternative open source aux modèles propriétaires opaques comme GPT4o-mini” selon elle.
Avec Small 3, la licorne, démontre une fois de plus que pour être performant, un LLM ne requiert pas u
En fin de semaine dernière, alors que tout le monde avait les yeux rivés sur DeepSeek et son modèle R1, Mistral AI, licorne française de la GenAI, a lancé plus discrètement Mistral Small 3. Publié sous la licence Apache 2.0, ce modèle de 24 milliards de paramètres optimisé pour la latence est “une excellente alternative open source aux modèles propriétaires opaques comme GPT4o-mini” selon elle.
Avec Small 3, la licorne, démontre une fois de plus que pour être performant, un LLM ne requiert pas un nombre astronomique de paramètres. Le modèle se positionne comme une réponse aux besoins croissants d’efficacité en offrant un taux de traitement de 150 tokens par seconde, tout en affichant une précision de plus de 81 % sur le benchmark MMLU.
Cette prouesse technique est rendue possible grâce à une architecture optimisée qui réduit le nombre de couches traditionnelles, diminuant ainsi le temps de passage avant (forward pass time, ou temps nécessaire à un modèle de réseau de neurones pour traiter une entrée et produise une sortie) sans compromettre la qualité des réponses.
Ce choix architectural, qui en fait “actuellement le modèle le plus efficace de sa catégorie”, permet à la version optimisée, Mistral Small 3 Instruct, de rivaliser avec des modèles bien plus imposants comme Llama 3.3 70B ou Qwen 32B, tout en garantissant une exécution rapide et efficace sur du matériel standard.
Des applications pour divers secteurs
Le Mistral Small 3 ne se contente pas d’afficher des performances techniques remarquables : il s’inscrit également dans une logique d’adaptabilité aux besoins concrets des entreprises. Parmi les cas d’usage envisagés, plusieurs domaines se démarquent :
Assistance conversationnelle et appels de fonction : la faible latence garantit des interactions en temps réel, essentielles pour les chatbots ou assistants virtuels ;
Fine-tuning pour des expertises spécifiques : sa taille modeste facilite l’ajustement fin pour des domaines précis, comme le diagnostic médical ou le conseil juridique ;
Inférence locale : la possibilité de déployer le modèle sur du matériel accessible favorise l’usage dans des secteurs où les données sensibles nécessitent un traitement en local.
Comme les “Ministraux”, Small 3 répond également aux besoins croissants de calcul local et de protection de la vie privée : la possibilité de le déployer sur des configurations matérielles accessibles, comme une RTX 4090 ou un MacBook avec 32 Go de RAM, offre aux organisations le contrôle sur leurs données sensibles sans dépendance à une infrastructure cloud centralisée.
Une stratégie de diffusion ouverte et collaborative
Selon Mistral AI, faisant référence aux derniers modèles de DeepSeek, et au projet Open-R1,”Ce furent des jours passionnants pour la communauté open source ! Mistral Small 3 complète les grands modèles de raisonnement open source comme les récentes versions de DeepSeek, et peut servir de modèle de base solide pour faire émerger des capacités de raisonnement”.
L’entreprise a fait le choix de le publier sous la licence Apache 2.0, faisant le choix d’abandonner peu à peu sa licence plus restrictive MRL pour les modèles à usage général. Elle annonce d’ores et déjà “des modèles Mistral petits et grands avec des capacités de raisonnement améliorées dans les semaines à venir”.
Actuellement disponible sur les plateformes Hugging Face, Ollama, Kaggle, Together AI et Fireworks AI, Mistral Small 3 le sera également bientôt sur NVIDIA NIM, Amazon SageMaker, Groq, Databricks et Snowflake.
Dix jours après son lancement, DeepSeek R1, qui a suscité l’émoi de la Silicon Valley et perturbé le marché de Wall Street, continue d’alimenter la une des médias internationaux. L’entreprise éponyme qui dit l’avoir mis open source pour soutenir la communauté IA n’a cependant pas révélé tous les éléments qui lui ont permis de développer ce modèle, notamment les ensembles de données et le code d’entraînement. Hugging Face, loin des polémiques, lance le projet Open-R1 et propose à la communauté de
Dix jours après son lancement, DeepSeek R1, qui a suscité l’émoi de la Silicon Valley et perturbé le marché de Wall Street, continue d’alimenter la une des médias internationaux. L’entreprise éponyme qui dit l’avoir mis open source pour soutenir la communauté IA n’a cependant pas révélé tous les éléments qui lui ont permis de développer ce modèle, notamment les ensembles de données et le code d’entraînement. Hugging Face, loin des polémiques, lance le projet Open-R1 et propose à la communauté de l’aider à construire les pièces manquantes du pipeline R1.
Mené par Leandro von Werra, directeur de la recherche chez Hugging Face, Elie Bakouch et Lewis Tunstall, le projet Open-R1 se veut un exemple de transparence et de partage des connaissances, permettant à chacun de contribuer et d’améliorer le modèle pour des applications variées, allant de la médecine à l’éducation, en passant par la recherche fondamentale.
Ils expliquent le but de leur démarche dans un blog :
“Le projet Open-R1 est une initiative visant à reconstruire systématiquement le pipeline de données et de formation de DeepSeek-R1, à valider ses affirmations et à repousser les limites des modèles de raisonnement ouvert. En créant Open-R1, nous visons à fournir de la transparence sur la façon dont l’apprentissage par renforcement peut améliorer le raisonnement, partager des informations reproductibles avec la communauté open source et créer une base pour de futurs modèles permettant d’exploiter ces techniques.”
Un plan en trois étapes
Pour les trois hommes, “la sortie de DeepSeek-R1 est une aubaine incroyable pour la communauté”.
DeepSeek-R1 est un modèle de raisonnement construit sur la base de DeepSeek-V3, présenté par la start-up chinoise fin décembre dernier, dont les performances sont comparables, à celles de principaux modèles à source fermée, comme GPT-4o ou Claude 3.5 Sonnet, et ce, malgré un coût d’entraînement nettement inférieur.
Le modèle compte 2 versions : DeepSeek-R1-Zero, entraîné par apprentissage par renforcement (RL) sans réglage fin supervisé (SFT), a montré de solides performances. Cependant, il présente des défis tels que la répétition sans fin et la mauvaise lisibilité. Pour résoudre ces problèmes, DeepSeek-R1 intègre des données de démarrage à froid avant l’application du RL et de plusieurs étapes de raffinement qui rejettent les résultats de mauvaise qualité et produisent des réponses polies et cohérentes.
DeepSeek a mis ces 2 versions et six modèles denses distillés à partir de DeepSeek-R1 basés sur Llama et Qwen à la disposition de la communauté.
Les chercheurs de Hugging Face proposent à ceux qui voudront contribuer au projet de les aider à :
Étape 1 : Répliquer les modèles R1-Distill en distillant un ensemble de données de raisonnement de haute qualité à partir de DeepSeek-R1.
Étape 2 : Répliquer le pipeline RL pur que DeepSeek a utilisé pour créer R1-Zero. Cela impliquera la conservation de nouveaux ensembles de données à grande échelle pour les mathématiques, le raisonnement et le code.
Étape 3 : Montrer qu’il est possible de passer du modèle de base → SFT (Supervised Fine-Tuning)→ RL via une formation en plusieurs étapes.
Les chercheurs d’Hugging Face concluent :
“Cette initiative ne consiste pas seulement à reproduire les résultats, mais aussi à partager des idées avec la communauté. En documentant ce qui fonctionne, ce qui ne fonctionne pas et pourquoi, nous espérons éviter à d’autres de perdre du temps et de calculer sur des chemins improductifs.”
Le projet, hébergé sur GitHub, compte plus de 12 000 étoiles, ce qui démontre l’intérêt qu’il suscite.
Les chercheurs de Hugging Face invitent la communauté open source à contribuer au projet Open-R1

 Connexion