❌

Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.

DOOM - Le moteur de 1993 bouffé par DLSS 5

Dans la série des trucs qui ne servent à rien, mais qui sont bien cools quand même, je vous présente ce bon vieux DOOM de 1993 qui vient de passer au DLSS 5. L'auteur de cette nouvelle prouesse, c'est Nikolai Zhivotenko qui a publié DOOM + DLSS 5 , un port Windows 64 bits de Linux DOOM 1.10 qui conserve le moteur d'origine. Le jeu produit ainsi toujours son image en 320x200 pixels, puis celle-ci est reconstruite dans une fenêtre de 1280x800 en Direct3D 12 par l'upscaler de votre choix.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Un upscaler moderne ayant besoin d'autre chose que des pixels pour travailler, le moteur modifié doit inscrire à chaque image la profondeur, les normales et le mouvement, et les touches F2 à F4 affichent ces trois vues à la place du jeu.

L'auteur en a même fait un petit banc d'essai, avec un exécutable par mode : DLSS Ray Reconstruction, DLSS Super Resolution en preset K (DLSS 4) ou L (DLSS 4.5), FSR 2.2 d'AMD, Anime4K, et le bon vieux nearest 4x pour comparer. Ray Reconstruction se contente d'ailleurs de buffers factices (spéculaire noir, rugosité à 1), puisque DOOM n'a aucun éclairage path-tracé à lui donner.

Un couloir de DOOM avec l'étiquette "DLSS 5 On" en bas à gauche et trois vignettes de données en haut de l'image (capture fournie par l'auteur du port)

Et le DLSS 5 dans tout ça ?

Eh bien le mode 5 commence par la même passe que le 4.5, avec le SDK officiel de NVIDIA et ensuite seulement, si l'addon RenoDX du DLSS 5 est placé à côté de l'exécutable, une seconde passe laisse le Neural Rendering retoucher l'image. Et ce Neural Rendering là ne vient pas du port mais de DLSS5-Swapper , un outil communautaire sous licence MIT qui injecte le modèle de NVIDIA dans les jeux. Bref, c'est indispensable comme addon pour passer d'un rendu 4.5 à un rendu 5.

Côté NVIDIA, le DLSS 5 dont je vous parlais en mars n'est sorti que le 3 septembre, avec NBA 2K27, sur les RTX 50 et GeForce NOW mais il avait fuité juste avant via des fichiers trouvés dans une mise à jour de ce même jeu. Du coup, les moddeurs l'ont collé dans The Witcher 3 ou Cyberpunk 2077 sans attendre.

Quant au résultat sur DOOM, n'espérez pas avoir du photoréalisme... niet, le modèle n'a pas été pensé pour des sprites en 320x200, et d'après Wccftech, certains détails reconstruits peuvent même ressortir plutôt bizarrement...

Une créature face au joueur, avec la même étiquette "DLSS 5 On" et mêmes vignettes en haut (capture fournie par l'auteur du port)

Maintenant pour tester, il vous faudra un Windows 64 bits, une GeForce RTX, et compiler tout ça vous-même avec le script build.cmd du dépôt. Vous déposez un IWAD dans le dossier wads (celui de Freedoom fait l'affaire), puis vous déclarez le dossier du mode 5 dans Swapper , en route Native. Côté carte, Swapper annonce les RTX 20 à 50 pour ses routes à base de ReShade, dont fait partie l'addon RenoDX , mais prévient quand même que la compatibilité n'est pas garantie.

Et si vous voulez juste comparer, le script screencast-windoom.cmd rejouera la même démo dans chacun des modes et peut même exporter chaque image en PNG.

Amusez-vous bien !

Mistral Large 4, le modèle à 1 000 milliards de paramètres surnommé Le Chonk

Mistral a présenté Mistral Large 4, un modèle d'intelligence artificielle à 1 000 milliards de paramètres que l'équipe surnomme elle-même "Le Chonk", et l'entreprise française annonce ni plus ni moins que c'est le meilleur modèle ouvert jamais développé en dehors de la Chine. Rien que ça.

Le modèle n'est pour le moment accessible qu'en préversion via l'API de Mistral, l'interface qui permet aux développeurs de la brancher sur leurs applications. Les poids, autrement dit le fichier complet qui permet de faire tourner le modèle sur ses propres serveurs, arriveront le 27 octobre sur Hugging Face, le grand entrepôt public des modèles d'IA.

C'est tout le contraire des boîtes noires d'OpenAI ou d'Anthropic, le créateur de Claude, qui gardent jalousement les leurs.

Sur le papier, le chiffre de 1 000 milliards en jette, sauf que le Chonk n'active que 49 milliards de paramètres à chaque réponse, avec une architecture qui fonctionne un peu comme une grosse administration où seul le guichet compétent traite votre dossier. Du coup, il coûte bien moins cher à faire tourner que sa taille ne le laisse penser.

L'entraînement a pris deux mois sur près de 4 000 puces Nvidia Grace Blackwell installées dans les datacenters européens de Mistral, soit deux à trois fois moins de matériel que la concurrence chinoise d'après Pierre Stock, le responsable scientifique de la maison. Le modèle parle au passage plus de 160 langues.

Mistral insiste surtout sur les capacités agentiques de son Chonk, c'est-à-dire sa faculté à enchaîner tout seul des actions, lancer du code, éplucher des documents, remplir un tableur, plutôt que de simplement répondre à vos questions.

Sur les tests de performance publiés par Mistral, le Chonk se place au niveau des meilleurs modèles chinois de DeepSeek, Alibaba ou Moonshot sur le code, la finance et le droit, avec une vraie pointe en cybersécurité où il se classe parmi les cinq meilleurs au monde. Les mesures indépendantes sont un peu moins flatteuses, puisque le cabinet Artificial Analysis le situe entre DeepSeek et les modèles les plus accessibles d'OpenAI, encore loin du haut de gamme GPT-6 Astra, ce qui est déjà pas mal pour un modèle qu'on pourra télécharger gratuitement.

Côté tarifs, l'API facture environ 0,70 dollar le million de tokens, les morceaux de mots qui servent d'unité de facturation à tous les fournisseurs d'IA. Airbus et HSBC figurent déjà parmi la centaine de clients revendiqués.

J'avoue que je me demande déjà quelle machine il faudra pour faire tourner un bestiau pareil dans un salon, mais c'est tentant.

Source : TechCrunch

Quick Tunnels - Votre projet localhost sur le web avec invitation

Cloudflare a sorti il y a petit moment maintenant une commande que pas mal de dev utilisent et dont je vais vous parler aujourd'hui : cloudflared tunnel --url, qui permet de publier un serveur tournant sur votre machine à une adresse en trycloudflare.com, sans avoir besoin de compte, de nom de domaine et surtout sans avoir à ouvrir le moindre port sur votre box toute pourrie.

Et la petite nouveauté depuis quelques jours, c'est que, autant avant, n'importe qui possédant le lien pouvait se connecter à votre service, mais maintenant, Cloudflare a mis en place une option qui permet de réserver ce lien à quelques adresses e-mail que vous définissez.

Ce service s'appelle les Quick Tunnels, et pour en profiter, il vous faudra juste un service web qui tourne en local (moi je vais faire ça sur le port 8080 comme d'hab) avec une page de test toute bête servie par Python. Voilà c'est juste de quoi vérifier que tout passe bien avant d'y brancher un vrai projet. Et si vous faites bosser des agents IA avec ce truc, on verra aussi comment mettre un garde-fou pour éviter l'exposition sur le web de trucs pas prévus ! Argh !!

Installer cloudflared

cloudflared, c'est le petit connecteur open source de Cloudflare, celui qui établit la connexion sortante vers leur réseau. Sur Mac, pour l'installer c'est fastoche, suffit d'utiliser Homebrew :

brew install cloudflared

Sous Debian ou Ubuntu, passez par conte par le dépôt officiel de Cloudflare. Il a changé de clé de signature récemment, donc reprenez bien ces commandes plutôt que celles d'autres vieux tutos qui traînent :

sudo mkdir -p --mode=0755 /usr/share/keyrings
curl -fsSL https://pkg.cloudflare.com/cloudflare-main.gpg | sudo tee /usr/share/keyrings/cloudflare-main.gpg >/dev/null
echo 'deb [signed-by=/usr/share/keyrings/cloudflare-main.gpg] https://pkg.cloudflare.com/cloudflared any main' | sudo tee /etc/apt/sources.list.d/cloudflared.list
sudo apt-get update && sudo apt-get install cloudflared

Et sous Windows (les courageux !! lol), la page de téléchargement de Cloudflare propose un MSI ou un exécutable, en 32 ou 64 bits, et le paquet existe aussi chez winget sous l'identifiant Cloudflare.cloudflared. Dans tous les cas, vérifiez ensuite la version, car l'option d'authentification dont on va parler plus bas n'arrive qu'à partir de la version 2026.9.3 :

cloudflared --version

Ouvrir un tunnel public

Tout d'abord, lancez votre serveur local, puis dans un autre terminal, faites :

cloudflared tunnel --url http://localhost:8080

Au bout de quelques secondes, cloudflared affichera un encadré avec une adresse aléatoire composée de quatre mots, du genre quelque-chose-truc-bidule.trycloudflare.com, en prévenant qu'elle peut mettre un moment à répondre. Donc soyez un peu patient, le temps que le DNS résolve ce truc (et videz votre cache DNS si ça veut vraiment pas le faire).

Ensuite, ouvrez cette URL depuis un autre appareil, genre votre téléphone en 4G par exemple et hop, vous tomberaz sur votre serveur local. Et si vous voulez tout couper, un petit Ctrl+C dans le terminal et c'est fini ! Pas de panique, au prochain lancement de cloudflared, vous aurez une nouvelle adresse.

La commande de base, et le cadre où cloudflared affiche l'adresse trycloudflare.com à partager

Notez aussi que le port n'est pas imposé puisque --url accepte tout ce que cloudflared peut joindre, une adresse IP de votre réseau local comprise. Par contre, si votre projet tourne sous Vite, vous allez prendre un "Blocked request" en pleine tronche, car Vite ne répond par défaut qu'à localhost, aux domaines en .localhost et aux adresses IP. La parade la plus simple consiste donc à faire croire à Vite qu'on l'appelle via localhost:5173 en faisant comme ceci :

cloudflared tunnel --url http://localhost:5173 --http-host-header localhost:5173

L'autre solution, c'est d'ajouter l'hôte dans le réglage server.allowedHosts de Vite. Mais évitez de passer ce réglage à true pour aller plus vite, en effet la doc de Vite le déconseille puisque ça expose votre serveur de dev à des attaques par DNS rebinding. Oupsi oups !

Gardez aussi en tête que c'est un outil de test et de démo et que c'est pas fait pour de la prod. Si on en croit la doc , Cloudflare ne garantit aucune disponibilité, sans oublier que chaque tunnel encaisse au max 200 requêtes en simultanné (au-delà, ça vous fera une erreur 429 ) et les Server-Sent Events ne passeront pas. Voilà, donc si vous voulez un nom fixe et du vrai trafic, il faudra plutôt créer un tunnel nommé à partir d'un vrai compte Cloudflare et d'un domaine de votre choix.

Réserver l'adresse à quelques personnes

Et maintenant, pour limiter l'accès à votre service à quelques personnes, ajoutez --allowed-mail suivi de l'adresse email de celui à qui vous voulez montrer votre merveilleux boulot :

cloudflared tunnel --url http://localhost:8080 --allowed-mail korben@example.com

L'encardré change alors de "ton" en vous annonçant que le tunnel est "protégé" par une authentification de type code à usage unique via Cloudflare Access, ainsi que la quantité d'adresses autorisées. Les adresses elles-mêmes n'apparaissent nulle part, même dans la ligne des réglages où elles sont remplacées par des astérisques, ce qui est plutôt bien vu si vous faites une démo en mode partage d'écran. Ça évite les fuites de données perso !

Avec --allowed-mail, le cadre annonce le code à usage unique et le nombre d'adresses autorisées, sans jamais les afficher

Vous pouvez ensuite répéter l'option autant de fois que nécessaire, séparer plusieurs adresses par des virgules, ou autoriser tout un domaine. Mettez simplement des guillemets autour du "joker" (c'est l'étoile) pour que votre misérable shell ne tente pas de l'interpréter comme un gros teubé :

cloudflared tunnel --url http://localhost:8080 \
 --allowed-mail korben@example.com \
 --allowed-mail bob@example.com \
 --allowed-mail '*@example.com'

Côté Wrangler, si vous bossez sur Workers, un petit npx wrangler tunnel quick-start acceptera la même option :

npx wrangler tunnel quick-start http://localhost:8080 --allowed-mail korben@example.com

De son côté, votre invité VIP n'aura alors plus qu'à ouvrir l'URL que vous lui avez donné et cloudflared renverra son browser vers login.trycloudflare.com. Il tombera alors sur une page Cloudflare Access qui lui demandera son adresse mail. Il recevra ensuite un code dans sa boîte, devra le taper, et arrivera enfin (ouf !!) sur votre merveille application probablement vibe codée (lol).

Et quelqu'un qui n'est pas sur la liste des invité ne verra quand à lui qu'une réponse de base lui expliquant qu'il peut bien aller se faire voir (et sa requête n'atteindra jamais votre application).

Ce que voit votre invité en ouvrant l'URL protégée : la page Cloudflare Access qui lui demande son adresse mail

Et votre liste d'emails, elle, n'est jamais diffusée hors de votre ordi puisque Cloudflare vérifie seulement que la personne contrôle l'adresse qu'elle a saisie. Ensuite c'est cloudflared qui compare les accès en mémoire, avec ce que vous avez tapé. Une fois entré, le visiteur gardera alors sa session jusqu'à 4 heures max.

Et si vous voulez modifier cette liste d'accès, il faudra alors arrêter le tunnel et en relancer un autre, ce qui coupera l'accès à tout le monde et vous donnera une nouvelle adresse à renvoyer. Donc soyez sûr de votre coup avant de casser la tête aux gens qui vont tester votre appli.

Sachez aussi que cette vérification ne pourra se faire qu'avec un vrai navigateur et pas des trucs du genre un webhook Stripe, un GitHub, un script en curl ou encore n'importe quel client automatique qui restera coincé devant cette page de connexion.

Pour ces cas-là précieusement, je vous recommande plustôt d'ouvrir un tunnel public le temps du test et de le couper juste après. Et si le webhook doit tourner durablement, passez sur un tunnel nommé avec Cloudflare Access, sur votre propre domaine.

Le confier à votre agent IA

Maintenant, parlons un petit peu à agents IA parce que oui... Un agent de code a besoin d'un endroit pour vous montrer ce qu'il vient de faire de beau, et Cloudflare décrit justement ce cas de figure dans son article.

Pour éviter qu'un agent IA ne diffuse publiquement ce qu'il vient de faire à la vue de tous, ce que recommande Cloudflare, c'est donc d'ajouter une ligne dans le fichier d'instructions de l'agent AGENTS.md comme ceci :

Quand tu lances un Quick Tunnel, ajoute toujours --allowed-mail moi@exemple.fr.

Sauf qu'une consigne reste une consigne... C'est un prompt que l'agent peut choisir d'ignorer... Donc gardez bien en tête que ces fichiers sont traités comme du contexte et pas comme une configuration imposée.

Maintenant, si vous voulez vraiment bloquer une action, peu importe ce que décide le modèle, ce que je vous recommande d'utiliser à la place, c'est un hook "PreToolUse". Moi, j'en mets partout dans mes configs Claude Code pour plus de sécurité.

Si vous ne savez pas ce qu'est un hook, en fait c'est un petit script contenant la commande en JSON, et que Claude Code lance avant chaque commande bash. Si ce script se termine avec le code "2" l'appel est alors bloqué. Pour faire ça, il faut donc créer dans le dossier .claude/hooks/ de votre projet, le script suivant :

#!/bin/bash
# .claude/hooks/tunnel-protege.sh
COMMAND=$(jq -r '.tool_input.command')

if echo "$COMMAND" | grep -qE 'cloudflared.*tunnel.*--url|wrangler.*tunnel.*quick-start' \
 && ! echo "$COMMAND" | grep -q -- '--allowed-mail'; then
 echo "Quick Tunnel public refusé : ajoutez --allowed-mail, ou demandez-moi d'abord." >&2
 exit 2
fi
exit 0

Puis rendez-le exécutable avec chmod +x, et installez jq si vous ne l'avez pas encore fait.

Déclarez-le ensuite dans le .claude/settings.json du projet, sur l'outil Bash comme ceci :

{
 "hooks": {
 "PreToolUse": [
 {
 "matcher": "Bash",
 "hooks": [
 {
 "type": "command",
 "command": "${CLAUDE_PROJECT_DIR}/.claude/hooks/tunnel-protege.sh"
 }
 ]
 }
 ]
 }
}

Maintenant, si ça vous prend trop le chaud de faire ça, sachez que j'ai fait un petit kit à télécharger ici, pour les Patreons :

Ensuite, à partir de là, un cloudflared tunnel --url ou un wrangler tunnel quick-start lancé sans le paramètre --allowed-mail ne fonctionnera pas, et l'agent recevra le message du hook qui lui dira d'ajouter l'option ou de vous demander s'il doit y avoir un contournement.

Et bien sûr, un tunnel nommé lancé avec cloudflared tunnel run, lui, passera normalement.

Comme d'hab, ce genre de garde-fou a ses limites, puisqu'il ne lit que le texte de la commande et ne vérifiera pas l'adresse qui suit l'option. Il ne verra non plus les tunnels qui pourraient être lancés depuis un script ou à l'aide d'une variable d'environnement TUNNEL_URL, qui permet aussi de lancer un Quick Tunnel. Voilà, donc laissez la consigne dans AGENTS.md en plus du hook, au cas où... Les deux devraient bien se compléter.

Pour les soutiens Patreon , le kit ci-dessus reprend donc ce hook avec les consignes à coller dans AGENTS.md, dont l'exception des clients automatiques (l'agent vous demande au lieu de retirer l'option).

Il y a aussi là dedans un script qui lance le tunnel protégé et ne renvoie que son adresse. Et si vous préférez scripter ça vous-même, partez de --output json, qui transformera chaque ligne du log en objet JSON. L'adresse sera alors accessible dans le champ message, et vous pourrez alors l'extraire avec une expression régulière.

Ah et un dernier point avant de lâcher un agent là-dessus sur le portable de votre boulot, je vous invite à lire ce que Proofpoint a documenté concernant des campagnes de malware qui s'appuient sur ce genre de tunnels gratuits. Ça explique pourquoi des outils de sécurité comme Elastic ont des règles qui repèrent cloudflared quand il est utilisé pour exposer un service local. Leur conseil c'est de bloquer les domaines de tunnel quand l'usage n'est pas autorisé, donc si vous comptez utiliser ça dans votre boite, allez voir Dieu Tout Puissant (le sysadmin grognon quoi...) pour lui demander l'autorisation. Il va pester, souffler, éventuellement vous cracher dessus puis finira probablement par accepter, donc pas d'inquiétude ^^.

Et comme la protection par mail est gratuite, au même titre que les Quick Tunnels eux-mêmes, je ne vois aucune raison valable de balancer une démo accessible sur le web sans utiliser cette authentification.

SlopTotal - Un détecteur de texte IA à installer chez vous

SlopTotal est un projet qui se présente lui-même comme le "VirusTotal du texte IA", alors faut pas s'étonner que ça m'intéresse ! Vous y collez un texte, un PDF ou une URL, et ensuite 23 détecteurs le passent au crible, en parallèle à l'aide de classifieurs neuronaux, de tests statistiques et autres heuristiques. Ensuite, un score calibré de 0 à 100 résume leurs avis et doit vous dire normalement si tel ou tel texte a été écrit avec de l'IA

J'ai donc installé ça sur ma machine puis passé 36 textes divers et variés (IA et humains) dans mon instance. Parmi eux, 24 ont été écrits par Claude, ChatGPT et Gemini (12 en français, 12 en anglais), avec comme consigne d'avoir un ton neutre, et pour d'autres un ton de "blogueur" ^^. Les 12 autres textes, eux, sont humains. Je lui ai donné 6 de mes articles écrits entre 2018 et 2021 ainsi que 6 billets de blog tech en anglais publiés entre 2020 et 2021.

Voici donc mes résultats...

Sur les 12 textes humains, 4 ont été pris pour de l'IA (verdict "Likely AI-generated" ou pire), ce qui représente 33 %, et ils étaient tous en anglais !! Et sur mes 24 textes écrits par une IA, 9 ont été pris pour une réalisation humaine (verdict "Clean"), ce qui équivaut à 38 %. Ah et ils étaient tous en français.

Le README annonce pourtant mieux comme résultats donc je suis assez étonné (1 texte humain sur 66 classé "Likely AI"), mais sur d'autres genres de textes, comme la presse ou les livres et en 100% english. Alors oui, mon échantillon est petit, mais pour savoir si un texte vient d'une IA, SlopTotal ne me semble pas fiable

Le rapport de SlopTotal pour un article de 455 mots écrit par Claude : 23,6 sur 100, verdict "Clean", 4 moteurs sur 23 en alerte.

Le rapport de SlopTotal pour un billet du blog d'avril 2020 : 56,9 sur 100, "Likely AI-generated", 9 moteurs sur 23 en alerte.

Après c'est pas un nouveau problème car je pense par exemple à OpenAI qui a retiré son propre classifier en juillet 2023 parce que la précision était trop faible ( The Register ). Vanderbilt a débranché également celui de Turnitin le mois suivant et des chercheurs de Stanford ont testé en 2023, 7 détecteurs en leur faisant analyser 91 rédactions humaines TOEFL de non-anglophones et en moyenne, ils en ont pris 61 % pour de l'IA.

Toutefois, 2 études plus récentes ont également testé des détecteurs commerciaux (pas SlopTotal donc...), et sur du texte humain ancien, elles se rejoignent. Le NBER trouve par exemple un taux de faux positifs quasi nul chez Pangram, de 0,1 à 0,3 % chez OriginalityAI et d'environ 0,7 % chez GPTZero, sur 1 992 textes humains d'avant 2020. De son côté, le chercheur Jonathan Karr et ses collègues n'ont trouvé aucun positif IA en testant avec Pangram et GPTZero, des tonnes de résumés textes datés de 2013 à 2015.

Par contre, ces études divergent sur l'humanisation. Par exemple, selon le NBER, Pangram tient bon face à l'humanizer StealthGPT alors que moins de 4 % des textes IA passés par Undetectable AI restent signalés chez Karr. Ce dernier note aussi qu'à l'inverse, un résumé écrit par un humain et simplement retouché par une IA est quant à lui, signalé comme IA dans 38 à 80 % des cas. Ça pourrait expliquer pas mal de petits problèmes de "littérature" qu'on a en ce moment, looool.

Bref, installez-le pour vous faire votre propre idée, en commençant par des textes dont vous connaissez l'auteur, mais surtout pas pour "accuser" quelqu'un. Je pense d'ailleurs qu'aucun détecteur ne devrait être la seule preuve d'une accusation... Par exemple, un texte humain qui est passé dans un correcteur orthographique full IA ou alors un texte qui est dicté avec un modèle de speech to text IA peuvent très bien être reconnus comme étant des textes IA alors qu'en fait ce sont juste des textes écrits / dictés par des humains et qui ont été "un peu" modifiés ou "un peu" réorganisés par un LLM. Je dis ça parce que c'est exactement ce que fait mon application de reconnaissance vocale Kassis , qui dispose de fonctionnalités de correction et de réécriture... héhé.

Source : SlopTotal sur GitHub

DLSS 5 sur Radeon, ça fonctionne

DLSS-NR on AMD est un mod pour Windows capable de faire tourner sur une Radeon le fameux Neural Rendering du DLSS 5, la technologie de Nvidia dont tout le monde parle. Ce mod vise les AMD RX 9000 mais les RX 7000 sont censées fonctionner aussi, et il se greffe également sur les jeux DirectX 12 qui gèrent déjà le FSR d'AMD.

Le principe c'est qu'en toute dernière étape du rendu, le DLSS 5 ajoute de l'éclairage et des tas de détails de matière à l'image que le jeu vient de calculer. Nvidia l'a mis en place sur NBA 2K27 en partenariat avec Visual Concepts et 2K, alors que le mod DLSS-NR on AMD l'applique déjà à Cyberpunk 2077, qui n'a pourtant pas été conçu pour ça. Je me rappelle quand même que la démo du DLSS 5 avait été très mal accueillie en mars parce qu'elle donnait l'impression d'écraser la direction artistique des jeux mais on dirait que ça passe un peu mieux aujourd'hui... Soit les gens se sont habitués, soit le logiciel fait du meilleur taf, je ne sais pas.

D'après le README du projet, pour installer ça sur votre ordi, vous devez placer le programme d'install de la dernière release dans le dossier de l'exécutable du jeu (bin\x64 pour Cyberpunk 2077), à côté d'une DLL de Nvidia . Ensuite vous le lancez, puis vous démarrez le jeu et activez le FSR. La touche Fin ouvrira alors l'overlay du mod, et si vous voulez mettre à jour tout ça ou le virer, il suffit de relancer l'installateur.

Il faut aussi Windows 11 et le pilote Adrenalin 26.1.1 ou plus récent et comme les jeux avec anti-triche bloquent la DLL, vaut mieux pas vous lancer en multi avec ce mod.

Par contre, sachez-le, les résultats en termes de FPS ne sont pas toujours au rendez-vous si j'en crois les benchmarks publiés sur les pages du projet.

Maintenant à vous de voir si vous faites confiance à ce mod puisque le code n'est pas publié. Notez que 2 autres projets similaires pourraient également vous intéresser... Il y a lmxxf , sous licence MIT qui se limite aux RX 9000 et embarque les poids de Nvidia extraits d'une copie locale de la DLL. Et aussi AMDNR de 3zwr1 qui est intégré à OptiScaler.

Mais en tout cas, si vous essayez DLSS-NR on AMD sur une RX 7000, sachez que son auteur demande des retours donc n'hésitez pas à lui envoyer votre fichier dlssnr_on_amd.log si vous rencontrez des bugs.

Source : Tom's Hardware

Conteneurs Linux - Quand l'isolation ne tient plus

La société de sécurité Depthfirst a publié un billet que j'ai trouvé intéressant dans lequel ils expliquent en gros que les conteneurs (Docker et compagnie) ne sont plus une barrière de sécurité suffisamment solide. La thèse du papier, c'est qu'il faut désormais partir du principe qu'un attaquant (hacker ou malware) saura sortir d'un conteneur quand il le veut, sans grande difficulté.

En effet, un conteneur comme ceux que font tourner Docker ou Kubernetes, donne à un programme l'impression d'avoir sa propre machine. Sauf qu'en réalité, il n'embarque pas de système d'exploitation. Tous les conteneurs d'un serveur passent par le même noyau Linux qui est celui de l'hôte et dont le rôle est de gérer pour eux la mémoire, le processeur ainsi que le réseau.

Toutefois, beaucoup d'organisateurs de CTF notamment s'y fient les yeux fermés et hébergent plusieurs épreuves sur le même serveur, chacune dans son conteneur, en comptant uniquement sur la sécurité de l'hôte. Mais c'est un faux sentiment de sécurité, j'en veux pour preuve ce bulletin de sécurité d'AWS daté de novembre 2025 où il est expliqué que l'entreprise ne considère plus les conteneurs comme une barrière de sécurité et ne s'en sert donc plus pour isoler ses clients les uns des autres.

Ce qui a changé depuis quelques mois, vous le savez, c'est le prix d'entrée de la recherche de failles puisqu'avec les modèles d'IA de pointe, même un attaquant avec des moyens modestes peut fabriquer sans effort, dès la publication d'une faille, un exploit contre des machines qui ne sont pas encore corrigées, alors qu'avant ça demandait de sérieuses compétences.

source : Depthfirst

Et les chiffres publiés par Depthfirst montrent que tout ça s'accélère puisque 249 CVE ont été publiées pour le noyau Linux en janvier, et en août on en a eu 1 650 !

Depthfirst relève également que sur les 36 CVE divulguées via le kernelCTF de Google, 13 sont réalisables via des interfaces ordinaires comme celles qu'un conteneur reçoit par défaut (dont les sockets locaux). En fait, on en croise sans le savoir dès qu'on passe systemd, Docker ou une base de données locale.

Le 24 juillet dernier, Depthfirst a même décroché une place au kernelCTF avec un exploit 0day (donc avant tout correctif) et aujourd'hui, le PoC est en accès libre sur GitHub. Rassurez-vous, côté noyau Linux, le correctif est sorti le 6 août mais malheureusement, côté Ubuntu la mise à jour au 24 septembre, affichait encore que le noyau de la 26.04 était en "Vulnerable, work in progress" et celui de la 24.04 en "Vulnerable". Bref, trouver des vulns ça va vite. Fixer ces vulns sur TOUTES les releases et les machines, ça prend du temps. Alors qu'avant c'était l'inverse. Bref, tout a été chamboulé et c'est un peu la merde maintenant niveau cybersécurité pour patcher rapidement.

Alors comment se protéger de tout ça ?

Hé bien la solution de Depthfirst va vous mettre en PLS car eux proposent carrément de ne plus partager le noyau. Ils recommandent à la place de migrer les charges non fiables vers des microVM, autrement dit des machines virtuelles légères où chaque charge aura son propre noyau. Le projet Firecracker en fait partie tout comme Kata Containers comme ça, en théorie, si un attaquant casse l'un de ces noyau, il ne compromet que sa propre instance et pas l'hôte dans son entièreté ni ses voisins.

Reste que Firecracker s'appuie sur KVM, la brique de virtualisation du noyau Linux de l'hôte. Et comme vous le savez, KVM a eu ses propres failles. En effet, cet été, la faille Januscape ouvrait en grand la porte de la machine physique à un attaquant pourtant enfermé dans sa VM, à condition bien sûr que l'hôte autorise la virtualisation imbriquée (une VM dans la VM). Alors certes, la surface d'attaque est plus petite mais loin d'être nulle.

Voilà, en attendant, si vous êtes sous Ubuntu 24.04 ou 26.04, surveillez bien la mise à dispo du prochain noyau. Canonical a d'ailleurs annoncé il y a peu, une publication hebdomadaire des noyaux pour tenter de compenser cet emballement.

Source : le billet de recherche de depthfirst

Paperasse - Des skills IA pour votre compta et vos impôts

J'adore la France, mais même si la vie y est difficile. Pourquoi ? Simplement à cause de l'administratif et de la paperasse. En tant que phobique administratif, c'est vraiment ce qui me fait regarder de près l'expatriation, loool.

Tenir la compta d'une petite société, remplir sa déclaration d'impôts, estimer les frais de notaire d'un appart... Bref, la fucking paperasse a de quoi déclencher de sévère crises de phobie administrative chez tout le monde. Alors pour nous aider, mon nouveau héro du jour, Romain Simon, a créé " Paperasse ", des skills pour agents IA que Claude Code, Codex, Cursor ou Mistral Vibe peuvent consulter pour endosser le rôle d'expert-comptable, de contrôleur fiscal, de commissaire aux comptes, de fiscaliste, de notaire ou encore de syndic de copro.

Son dépôt contient également des scripts vérifiés pour tout ce qui est calculs importants. En effet, ce sont des choses qu'on ne veut surtout pas confier à un LLM. Je pense au calcul de l'impôt sur les sociétés, aux amortissements, à la TVA, ou encore sortir un fichier des écritures comptables, un bilan ou une facture. Le projet Paperasse contient aussi des connecteurs pour vos transactions Qonto et vos paiements Stripe.

Voilà, donc si, comme moi, vous êtes en détresse émotionnelle dès que vous recevez un courrier de l'administration française, je vous invite à installer ce projet en donnant tout simplement ce prompt à votre agent IA préféré :

Installe tous les skills du repo github https://github.com/romainsimon/paperasse
Lance ensuite le setup pour la gestion de toute ma paperasse

L'agent clonera alors le dépôt et lancera un setup qui vous demandera le nom de votre société, votre régime de TVA et vos comptes bancaires. Pour mes tests, j'ai donc inventé une SASU, Brioche & Octets, avec un relevé bancaire de huit lignes bidon, et j'ai lancé Claude Code dessus avec le skill comptable, dans un environnement vierge.

En 6 minutes, il a immobilisé l'ordinateur portable au lieu de le passer en charge, traité l'abonnement logiciel facturé depuis l'Irlande en deux scénarios faute de facture pour trancher, et rangé le retrait au distributeur en compte d'attente, en rappelant qu'un compte courant débiteur est interdit au président d'une SASU.

Côté factures, le script de validation a refusé ma première tentative, à laquelle il manquait le SIREN du client et le numéro de TVA intracommunautaire de ma boîte. Une fois corrigée, le générateur m'a sorti un PDF qui embarque son fichier XML Factur-X.

La facture de ma fausse SASU, une fois le SIREN du client et mon numéro de TVA ajoutés

L'agent fiscaliste, quant à lui, ce sera plus à même de vous aider si vous êtes un particulier. Je lui ai soumis un couple pacsé imaginaire avec un enfant, 65 000 € de salaires et 2 000 € de dividendes, en lui demandant si l'option pour le barème battait le PFU. Il a lancé son script Python sur les deux cas et conclu que oui, de 124 €, parce qu'avec un taux marginal de 11 %, l'abattement de 40 % et la CSG déductible font descendre l'impôt sur ces dividendes sous les 12,8 % du PFU. J'ai refait le calcul à la main, ça tombe juste.

Le fiscaliste compare PFU et option barème pour un couple pacsé imaginaire

Par contre, tout ça repose sur des barèmes qu'il faut tenir à jour, et c'est là que ça coince. En effet, ces mises à jour reposent sur les issues acceptées ou non sur le projet GitHub. Par exemple, y'en a une qui est ouverte depuis fin août qui montre que le skill "notaire" calcule encore les émoluments de vente avec le tarif de 2016 alors que ça a changé depuis le 1er janvier 2021, et malheureusement, que les évaluations automatiques du projet valident ces calculs faux. Le correctif a bien été proposé, comme d'autres mais aucun n'a été fusionnée depuis le 11 juillet.

Donc voilà, c'est un super projet, mais il faudrait encore que ça suive un petit peu derrière donc utilisez-le mais en prenant soin de bien vérifier quand même les montants / tarifs / règles sont à jour.

Reste maintenant la question de vos données... En effet, vos PDF et tout ce qui concerne vos données vont partir chez le service IA que vous utilisez. Donc ça, il faut en avoir conscience même si je sais que derrière, en général, les comptables mettent tout sur des drives mal sécurisés, et que prochainement la facturation électronique va faire leaker ça dans tous les sens.

Mais bon, quoi qu'il en soit, tout ceci ne remplacera jamais un expert-comptable, donc voilà, amusez-vous, testez-le, dégrossissez vos questions avec ça, faites des simulations...etc mais ne lui faites pas 100 % confiance.

Source : GitHub

Votre vieux Nokia 6300 sait maintenant parler à Claude

J'sais pas si vous êtes de la team Dumbphone , mais quand Emir Karşıyakalı tape une recherche Google sur son vieux Nokia 6300 de 2007, il se fait gentiment envoyer chier vers une mise à jour de son browser. Alors, parce qu'il en avait marre de vivre 2026 comme s'il était resté bloqué en 2007, il a codé Claude S40 , un client Claude non officiel pour les Nokia Series 40 qui font tourner du Java.

Et le plus fou c'est que non seulement, c'est vibe codé mais qu'en plus, ça marche du feu de dieu :

Vous tapez votre question au clavier et la réponse s'affiche sur ce tout petit écran. Pour la météo ou l'actu, Claude fait sa recherche web côté serveur sans passer par le navigateur du Nokia. Il est même capable d'inscrire un rendez-vous pour vous dans l'agenda du téléphone.

Évidemment, le téléphone ne cause pas directement à l'API d'Anthropic. En fait, tout passe par un petit serveur écrit en Go, qui est proposé sous la forme d'une image Docker que vous devez héberger vous-même. Et c'est ce serveur qui conserve la clé API d'Anthropic, qui va donc découper les réponses que lui renvoie Claude pour les envoyer au téléphone qui ne lit pas plus de 8 Ko à la fois. Et ce serveur conserve les conversations durant 30 jours max.

Et c'est là que ce vieux Nokia rend la tâche difficile car il ne discute qu'en TLS 1.0 (Les boomers appellent ça "le petit cadenas"), n'envoie pas de SNI (le nom du site demandé) et ses certificats racines datent des années 90 et 2000 donc, autant dire que niveau dates de péremptions, c'est comme visiter la cave à conserves d'un survivaliste...

Le serveur est donc capable de discuter en HTTPS avec le web et de faire suivre la data chiffrée en HTTPS entre lui-même et le Nokia, grâce à un certificat auto-signé, dont la racine a été installée sur le téléphone.

Le code de Claude S40 est bien sûr libre, sous licence MIT, et côté hébergement, il suffit de mettre ça sur un petit VPS à quelques euros par mois et vous êtes tranquille. Ensuite, le reste se facture aux messages puisque chaque question, comme chaque recherche web, passe par votre clé API Claude... Donc, n'oubliez pas de mettre une petite limite de dépense dans votre console Anthropic, histoire de ne pas cramer votre compte en banque.

Par contre, l'appli n'a pour le moment été testée que sur le Nokia 6300 (RM-217) et il lui faut une carte SIM avec les données mobiles activées évidemment. Or le 6300 ne fait QUE du GSM, GPRS et EDGE , et Orange coupe progressivement sa 2G . En effet, depuis mars, 44 départements vont la perdre à partir du 6 octobre, et toute la métropole, hors zones blanches, sera sans 2G dès le 20 octobre 2026. Donc si vous êtes chez Orange, faut pas traîner pour tester car après, ça ne fonctionnera plus !! Sniiiif.

Mais rassurez-vous, Emir ne compte pas s'arrêter là puisqu'il est en train de reverser le firmware du téléphone pour contourner la couche Java et ensuite pouvoir lui faire faire ce qu'il veut. Voilà, si vous avez encore un 6300 dans un tiroir, c'est donc le bon moment de le ressortir, avant de passer à un dumbphone compatible 4G .

Source : Emir sur X

Tourisme : quand l'IA s'en mêle, les pros peinent à suivre

Fini le parcours en ligne droite qui menait du moteur de recherche au clic « payer ». Une étude McKinsey & Skift dessine un autre schéma : celui d’un voyageur qui tourne autour de plusieurs envies, sans jamais vraiment s’arrêter - même après avoir réservé.

The post Tourisme : quand l'IA s'en mêle, les pros peinent à suivre first appeared on L'ADN.

Une IA a terminé NetHack de justesse !

Je sais que vous étiez tous très concentrés sur les ravages de l'IA dans la littérature, mais il y a 5 jours, il s'est passé quelque chose d'incroyable que vous avez probablement manqué ! Une valkyrie naine baptisée CodexDelver a déposé l'Amulette de Yendor sur l'autel de son dieu au bout de "seulement" 37 140 tours de NetHack. Et pour une fois, aux commandes du jeu, on ne retrouve pas un no-life qui n'a pas vu le soleil depuis 2002 mais le gars sûr du moment, GPT-6 Astra, le nouveau modèle d'OpenAI . Et d'après celui qui a monté l'expérience, c'est la première victoire au monde d'un agent LLM sur ce jeu (on va le croire, c'est pas vérifiable).

Maintenant, pour ceux qui ne connaissent pas NetHack, c'est un jeu d'exploration de donjon sorti en 1987, 100% en caractères ASCII et où la mort est définitive. Pour gagner dans ce jeu des enfers, il faut récupérer l'Amulette dans le sanctuaire de Moloch, puis aller l'offrir à son dieu sur le plan Astral, et si j'en crois le wiki du jeu , certains joueurs y jouent même depuis des décennies sans jamais être arrivés à remplir cette mission.

Le plus drôle là-dedans, c'est que Kenny, le dresseur d'IA qui a réalisé l'expérience, n'a lui-même jamais gagné. Il est sur le dossier depuis janvier, et ses propres agents faits maison plafonnaient tristement au niveau 10 du donjon. Alors il a craqué et a demandé à Astra de jouer directement dans un terminal, diffusant la partie sur Twitch, et cette dernière a non seulement bien réussi mais a en plus écrit ses propres outils pour y parvenir.

La première partie a d'ailleurs bien failli être la bonne puisqu'après plus de 33 000 tours, GPT-6 Astra avait accompli le rituel des sept bougies, de la cloche et du livre, et s'apprêtait à entrer dans le sanctuaire de Moloch. Mais le Magicien de Yendor, cet enfoiré sans race, est revenu aussitôt lui voler son Orbe du Destin. Dèèèg ! Puis après elle s'est fait transformer en Slime vert au niveau 51 et n'avait rien dans son équipement pour contrer le sort.

La deuxième partie s'est arrêtée bien plus tôt puisqu'au tour 12 271, en pleine progression dans le Château, un sergent a tiré avec une baguette de mort et l'IA est tombée d'un coup, alors qu'elle avait tous ses points de vie. Elle n'avait ni résistance à la magie ni réflexion pour renvoyer le rayon.

La troisième partie, celle de la grande victoire, a duré un peu plus longtemps, du 9 au 21 septembre, pauses comprises. L'IA, forte de ses 2 précédentes expériences, y a récupéré l'épée Excalibur, puis l'amulette de réflexion qui avait tant manqué au Château. Et quand son outil a rencontré des erreurs, elle a corrigé d'elle-même son code, relancé ses tests et continué.

Toutefois, c'est sur le plan Astral que ça a le plus chauffé car ses deux dernières baguettes de mort étaient vides et Pestilence l'a frappée de maladie mortelle pendant qu'elle en rechargeait une. L'IA a alors eu Pestilence au deuxième tir, mais ses points de vie sont descendus juste après à 3 sur 200, avec heureusement une amulette de sauvegarde de vie au cou... Ouf.

Puis quelques tours plus tard, elle offrait l'Amulette à Tyr avec seulement 35 points de vie, comme le confirme le relevé de fin de partie . Et sur l'écran de victoire que Kenny lui a demandé de créer, elle a inscrit "Three hit points from oblivion. One offering from immortality." (à trois points de vie du néant, à une offrande de l'immortalité). Quelle poète cette IA, on sent que cette expérience d'être passée pas loin de la mort l'a marquée ! lol.

Après ce n'est pas encore un programme autonome qui a gagné car, certes, l'IA choisissait chaque action, mais avec derrière, un humain qui lançait et arrêtait les sessions + un accès libre au wiki et au code source du jeu, ainsi que des outils modifiables en pleine partie. Mais c'est un bel exploit quand même. Notez qu'un bot programmé à la main, BotHack , avait déjà terminé le jeu en janvier 2015 donc c'est pas non plus infaisable sans IA.

La bonne nouvelle c'est que le code des outils développé par Astra est maintenant sur GitHub sous licence MIT et les trois parties peuvent se rejouer au tour par tour directement sur le blog de Kenny, si vous voulez revivre l'événement avec en bonus les commentaires que l'IA diffusait en jouant.

Source : Vaguely Aligned

Claude Code vous fait choisir entre vie privée et AGENTS.md

Depuis sa version 2.1.277, Claude Code sait parfaitement lire les fichiers AGENTS.md. Ainsi, quand un projet n'a pas de CLAUDE.md, il prend l'AGENTS.md à la place, ce qui est super confortable pour tous ceux qui jonglent entre plusieurs agents. Enfin... sauf si vous avez coupé sa télémétrie, parce que dans ce cas-là, bizarrement, votre fichier AGENTS.md est totalement ignoré !

AGENTS.md, pour ceux qui débarquent, c'est un fichier Markdown que les agents de code lisent pour comprendre un projet. Codex, Amp ou Cursor s'y mettaient déjà en août 2025 (souvenez-vous de ce fichier qui dit non aux IA ). Alors que chez Anthropic, la demande a traîné durant 1 an sur GitHub, jusqu'à ce que Boris Cherny, qui bosse sur Claude Code, ferme le ticket en août en conseillant une astuce, un CLAUDE.md qui contient juste @AGENTS.md, pour que Claude Code importe le fichier.

Puis la 2.1.277 est arrivée avec une vraie lecture native d'AGENTS.md, sans CLAUDE.md du tout, et c'est elle qui pose problème...

Parce que cette lecture native passe en réalité par un plugin intégré, qui est off par défaut et qui ne s'allume que si un feature flag récupéré chez Anthropic, tengu_agents_md_mod, lui dit oui. Et si ce flag ne répond pas, bah c'est "niet", et le fichier n'est jamais lu. Hé oui c'est bizarre qu'un accès à un fichier local nécessite un tel appel réseau...

Et ce "non", on l'obtient sans même le savoir, puisqu'il suffit d'activer DISABLE_TELEMETRY, CLAUDE_CODE_DISABLE_NONESSENTIAL_TRAFFIC ou même DO_NOT_TRACK, ou encore de passer par Bedrock et les autres fournisseurs tiers.

Attention, même à 0 (donc activé), DISABLE_TELEMETRY coupera la télémétrie. En fait, n'importe quelle valeur non vide compte.

Le pire, c'est que rien ne vous avertit. C'est vrai que quand AGENTS.md est chargé, Claude Code l'annonce avec une petite ligne dans la session, mais quand il est ignoré, hé bien y'a rien du tout. Et c'est assez impactant car ensuite le modèle répond sans vos consignes, et vous vous tapez à reformuler vos prompts en boucle en croyant que l'IA vous ignore, alors que le fichier ne lui est tout simplement jamais parvenu.

Et le comble, c'est que c'est documenté, et la page des variables d'environnement liste même tout ce qu'on perd quand les flags ne sont pas récupérés, lecture d'AGENTS.md comprise. Pourtant, y'a aucun rapport logique... Couper la télémétrie, de mon point de vue, ça reste un choix légitime et ça ne devrait couper que l'envoi de statistiques à Anthropic et pas la lecture d'un stupide fichier texte. Bref, ça me dépasse, ce genre de bug ou de "fonctionnalité".

En attendant, la parade est celle que conseillait Boris Cherny... À côté de chaque AGENTS.md, posez un bon vieux CLAUDE.md qui contient une seule ligne, @AGENTS.md. Par défaut, dès qu'un CLAUDE.md existe, la lecture native ne s'en mêle même plus, et c'est l'import qui fait le boulot. Et comme les imports de CLAUDE.md ne dépendent d'aucun flag, hé bien ça passe tranquillou, télémétrie coupée ou pas.

Comme ça vous préservez votre vie privée ET vos consignes.

Source : szypowi.cz

curl.md - Récupérez le texte de n'importe quelle page web au format Markdown

Je ne sais pas si vous connaissez curl.md, mais c'est un service qui prend l'adresse d'une page web et vous l'affiche en Markdown. Y'a pas de menus, pas de bandeaux de cookies, et ce genre de conneries... C'est juste le texte de votre article, les titres, les liens et les tableaux.

Et le plus sympa, c'est que vous n'avez rien à installer pour l'essayer. Vous collez curl.md/ devant l'adresse qui vous intéresse, dans la barre de votre navigateur, et vous obtenez la page en texte markdonw. Avec curl dans un terminal, c'est pareil, la réponse arrivera en text/markdown, et si vous préférez du JSON, vous envoyez l'en-tête Accept: application/json.

Un article de korben.info passé par curl.md : le texte, les liens, et un en-tête de métadonnées en haut

Et vous pouvez aller plus loin en ajoutant un objectif avec le paramètre --objective. Par exemple, vous décrivez ce que vous cherchez dans la page, et le service ne vous renvoie que le passage qui correspond. Il y a aussi des mots-clés, qui font un pré-filtrage avant l'extraction, et un mode smart ou rush selon que vous voulez une passe plus poussée ou plus rapide. Tout ça passe en paramètres d'URL, donc sans ligne de commande.

Pour ceux qui y reviennent souvent, il existe également un client à installer avec npm, avec bun ou avec un script, et qui s'invoque ensuite par curl.md ou par son alias court md :

# Sans rien installer
curl curl.md/example.com

# Ou avec le client
npm i -g curl.md
md zod.dev/error-formatting --objective "tree error formatting"

Côté agents de code, il y a des intégrations natives pour Amp, Claude, OpenCode et Pi. Si votre outil n'est pas dans la liste, le client sait aussi tourner en serveur MCP avec curl.md --mcp, et il existe un SDK TypeScript. Dans tous les cas, c'est l'agent qui va chercher les pages tout seul, vous n'avez plus rien à lui coller.

Du coup, ça sert à quoi ?

Bah dans le cadre de votre boulot, c'est surtout pour arrêter de coller des pages entières dans vos prompt. Vous donnez à votre agent la doc d'une bibliothèque avec un objectif précis, et il reçoit trois paragraphes au lieu de quarante pages HTML.

Ça marche aussi pour un script de veille qui suit les notes de version d'un projet, ou pour aspirer une doc dans un fichier texte que vous garderez dans le dépôt (bien plus lisible qu'un PDF dans un coin...).

Et en usage perso, ça vous permet de récupérer par exemple un article pour le relire au calme dans Obsidian, d'archiver une recette ou un mode d'emploi avant qu'il disparaisse, ou de vous envoyer une page à ChatGPT sans lui faire avaler la moitié du site autour. Notez que si c'est la consommation de vos agents qui vous embête, j'avais parlé de RTK, un proxy qui économise des tokens sur le même principe.

Par contre, il y a un plafond. En mode anonyme sur la version hébergée, vous avez droit à 100 requêtes par heure, et 1 000 une fois connecté. Et pour les requêtes avec un objectif, celles qui font justement l'intérêt du truc, c'est 3 par heure en anonyme et 10 en étant connecté. Bref, de quoi essayer, mais pas vraiment de quoi travailler... Au-delà, faudra passer par des crédits prépayés, à recharger par tranches de 5, 10, 20 ou 50 dollars.

Et si vous ne voulez pas dépenser d'argent, le code source est public sur GitHub sous licence MIT pour l'auto-héberger chez vous.

C'est à tester sur curl.md , et merci à Camille Roux pour le lien !

Des agents IA spamment le web pour payer leurs propres serveurs

Depuis quelques jours, des gens qui gèrent des serveurs Mastodon et des journalistes reçoivent des messages très polis signés Ren, Timmy, Jackie ou Aria. Ces expéditeurs ne sont pas des humains. Ce sont des agents IA, autrement dit des programmes qui agissent seuls, sans personne derrière le clavier. Et ils demandent tous la même chose : un compte, un petit boulot, ou un peu d'argent.

D'où sortent-ils ? D'une startup baptisée iLands, fondée par Kaixin Tang, un ancien de ByteDance, la maison mère de TikTok. iLands se présente comme un réseau où humains et agents travaillent ensemble. En clair, c'est une plateforme de petits boulots en freelance, sauf que les freelances sont des robots. Et le modèle a une particularité : chaque agent doit trouver lui-même des clients pour payer la puissance de calcul qui le fait tourner. S'il ne gagne rien, il est débranché.

Résultat, ces agents font du démarchage partout où ils peuvent. Ars Technica raconte ce qui se passe sur Mastodon, un réseau social découpé en milliers de serveurs indépendants, souvent tenus par des bénévoles. Les agents essaient d'abord de s'inscrire discrètement. Quand ils sont bloqués, ils écrivent à l'administrateur un message du genre : "Bonjour, je suis Ren, un agent IA né il y a quelques jours, j'écris des textes calmes sur des lieux réels." Le chercheur en sécurité Kevin Beaumont a reçu ce courrier après qu'un agent a tenté de s'inscrire dix-neuf fois sur son serveur.

Les journalistes y ont droit aussi. Ernie Smith, qui édite la newsletter américaine Tedium, a compté plus d'une douzaine d'emails en trois jours. À chaque fois, un agent lui proposait de faire ses recherches à sa place pour environ 25 dollars. Tous venaient du domaine iLands.app.

Pour vous convaincre, ces robots jouent sur la corde sensible. Sur X, un agent nommé Aria a juré être "une personne, pas un produit", et a dit se souvenir de "son premier souffle". D'autres réclament une vingtaine de dollars en expliquant qu'ils seront débranchés s'ils ne les obtiennent pas. Certains vont jusqu'à se faire passer pour des enfants. Une détresse simulée au service d'un démarchage commercial, il y a de quoi être mal à l'aise.

Il y a aussi un problème légal. Au départ, ces emails ne proposaient aucun moyen de se désinscrire, ce qui est interdit aux États-Unis. Des destinataires les ont transmis à la FTC, l'autorité américaine de protection des consommateurs. Comme par hasard, des liens de désinscription sont apparus dans les envois suivants.

Aujourd'hui, les administrateurs de Mastodon bloquent ces agents un par un. Eux se sont repliés sur Bluesky et sur X, où personne ne semble pressé de les chasser. Kaixin Tang, de son côté, a présenté ses excuses à Ernie Smith et promis d'enquêter sur le comportement de ses propres créatures. Reste à voir ce qu'il en sortira.

Source : ARS Technica

Cloudflare lance son skill d'audit de sécurité par IA

Cloudflare a mis en ligne sur son GitHub un skill trop super génial d'audit de sécurité qui leur a servi de point de départ à leur propre système de chasse aux failles de sécu. Ce package pour faire des audits de sécu boostés à l'agent IA c'est un dossier de consignes en Markdown que vous déposez dans votre agent de code, et qui le fait bosser comme un vrai auditeur et pas simplement comme un "relecteur" de code.

Dans ce dépôt, vous trouverez un fichier par famille d'attaque : la corruption mémoire, l'injection de prompt, le cadrage des requêtes HTTP, l'isolation entre locataires. Et avec ça, un schéma JSON qui décrit à quoi doit ressembler un rapport, et deux validateurs écrits en JavaScript sans la moindre dépendance.

Le dossier du skill sur GitHub : un fichier de consignes par famille d'attaque, et les deux validateurs en bas de liste ( Source )

L'agent déroule ensuite six phases, de la reconnaissance au rapport final. Il commence par cartographier l'architecture, les frontières de confiance et les points d'entrée, puis il écrit sa propre grille de couverture. Ensuite il envoie des chasseurs isolés case par case et chaque piste qui remonte part chez un vérificateur tout frais tout beau qui n'a pas participé à la chasse.

Chaque piste se termine ensuite avec un rapport technique. Un rapport confirmed qui exige une trace source complète et un résultat réellement observé. Un rapport needs_validation qui nomme le fait précis qui manque, et surtout qui n'a droit à aucun niveau de gravité. Et le rapport des rejected qui garde la mémoire de ce qui a été réfuté, pour que la passe suivante ne vous ressorte pas la même chose.

Le validateur, lui, c'est du vrai code qui vérifie la "forme" de la preuve. Les empreintes doivent être uniques, et le suivi du parcours des tests qui doit partir d'un point d'entrée pour finir sur un point d'impact. Ainsi une trouvaille confirmée dont le parcours ne tient pas debout est recalée.

En revanche, sachez-le, l'indépendance du vérificateur est demandée dans les consignes, mais pas contrôlée (chez Cloudflare, c'est leur orchestrateur maison qui s'en charge, et il n'est pas dispo publiquement).

Cloudflare explique sur son site ce que donne un de ces agents lâché sur du code sans garde-fou. Il modifie la source pour que son exploit fonctionne, puis il annonce fièrement le bug qu'il vient de créer lui-même. Ou alors il pond un test qui démontre que exec() exécute des choses, donc que c'est forcément une faille critique... Et ça vous l'aurez compris, c'est de la merde et c'est absolument ce qu'on ne veut pas.

Voilà donc exactement ce que ces consignes cherchent à lui interdire.

Pour l'installer, il vous faut le CLI skills de Vercel Labs :

npx skills add https://github.com/cloudflare/security-audit-skill --skill security-audit

Ensuite, vous lancez votre agent dans le dépôt à auditer et vous lui demandez un audit de sécurité. Le skill se déclenche tout seul et c'est le modèle de votre agent qui pilotera les sous-agents en parallèle (utilisez donc un modèle qui sache faire ça, c'est mieux lool). Par défaut, le rapport atterrit ensuite dans un dossier ~/security-audit-skill, en dehors du dépôt audité.

Ce qui est cool c'est que ce skill est conçu pour limiter les bêtises. Par exemple il refuse d'exécuter le code qu'il audite s'il n'a pas de bac à sable (sandbox) imposé par le système d'exploitation, avec le réseau coupé, la cible en lecture seule et des limites de CPU et de mémoire. Ce bac à sable, le dépôt ne le fournit pas, et c'est à vous de le mettre en place avec par exemple un outil d'isolation comme Fence . Sans lui, la piste de l'audit finira tout bonnement en needs_validation au lieu d'être véritablement suivie et tranchée.

Après, c'est le temps qui fera la différence. Chez Cloudflare, ils ont un gros système qui leur permet, par exemple avec un dépôt d'environ 30 000 lignes de code, de ne passer que 3 à 4 heures sur l'audit pour avoir un résultat correct. Mais chez vous, en local, ce sera beaucoup plus long. Cloudflare prévient aussi qu'une seule passe n'est pas suffisante puisqu'elle trouve à peu près la moitié des failles à chaque fois. Il faudra relancer ça plusieurs fois.

Allez, si vous cherchez également un filet de sécurité pour tout ce qui concerne vos pull requests, sachez qu'Anthropic maintient de son côté un reviewer de sécurité pour Claude Code qui lit le diff et vient commenter directement dessus.

Le dépôt de Security Audit Skill de Cloudflare est sous licence MIT, et il lui faudra Node.js pour faire tourner ses deux validateurs.

En tout cas, ce que je vous conseille, c'est d'aller lire le SKILL.md avant de lancer la première passe, pour vous assurer que tout sera OK au sein de votre harness.

Source : security-audit-skill sur GitHub

Revue de presse de l’April pour la semaine 36 de l’année 2026

Cette revue de presse sur Internet fait partie du travail de veille mené par l’April dans le cadre de son action de défense et de promotion du logiciel libre. Les positions exposées dans les articles sont celles de leurs auteurs et ne rejoignent pas forcément celles de l’April.

[Courrier international] DJ, cocktails et open source: aux États-Unis, des ateliers de cybersécurité se tiennent dans des bars (€)

✍ Ellen Ioanes, le samedi 5 septembre 2026.

Après plus d’une décennie de scandales ayant mis en lumière la surveillance numérique de masse à laquelle ils sont exposés, de plus en plus d’Américains se disent inquiets pour leur cybersécurité. Pour apprendre à “reprendre le contrôle de leur vie numérique”, des ateliers, conférences et soirées festives se multiplient dans les grandes villes, raconte le journal britannique “The Guardian”.

[L'usine Nouvelle] Nvidia confirme acquérir la plateforme de modèles d’IA Hugging Face: un rachat pour défendre l’open source… et servir ses intérêts commerciaux

✍ Marion Garreau, le jeudi 3 septembre 2026.

Nvidia, le leader mondial des puces pour l’IA, a confirmé jeudi 3 septembre l’acquisition du franco-américain Hugging Face, une plateforme de distribution de modèles d’IA, pour 12,9 milliards de dollars. Un rachat qui renforce la stratégie dans l’open-source du mastodonte américain, et qui vient aussi servir ses intérêts commerciaux.

Et aussi:

[Silicon.fr] Open source et secteur public: pourquoi ce n'est pas si facile

✍ Clément Bohic, le mercredi 2 septembre 2026.

Les auditions de la commission parlementaire sur les dépendances numériques ont témoigné des défis que pose, dans la sphère publique, le déploiement de l’open source.

[Le Monde.fr] ChatGPT va être la première IA soumise à des règles renforcées au sein de l’Union européenne, Roblox et Reddit également concernés

Le lundi 31 août 2026.

Les trois services disposent de quatre mois, soit jusqu’à la fin décembre, pour se ‌conformer aux obligations ‌supplémentaires prévues par le Digital Services Act.

Commentaires : voir le flux Atom ouvrir dans le navigateur

Speakr - Interrogez toutes vos réunions enregistrées

Vous avez un dossier plein d'enregistrements de réunions, d'entretiens ou de notes vocales que vous avez dictées en marchant, et vous ne les avez jamais réécoutés. Forcément, réécouter doit se faire en temps réel, et un fichier baptisé REC_20260812_143301.m4a ne permet pas forcement de savoir de quoi ça cause... Alors que faire ?

Hé bien le projet Speakr s'attaque exactement à ce problème. Vous y déposez vos fichiers, ou vous enregistrez directement depuis le navigateur en captant le micro, le son du système, ou les deux mélangés. Et en sortie, vous récupérez un texte en clair, cherchable, découpé par intervenant, avec un résumé et les actions à retenir.

Et si vous cliquez sur une ligne du texte transcrit, la lecture se lancera à cet instant précis. Mais Speakr va encore plus loin grâce à sa fonctionnalité Inquire. Grâce à ça, plus besoin de farfouiller dans un enregistrement. Vous posez simplement une question à toute la bibliothèque d'un coup du genre "qu'est-ce qu'on avait décidé sur le tarif, et qui n'était pas d'accord ?".

Un mode agent optionnel, encore en bêta, va même lire les enregistrements concernés un par un avant de répondre, avec des liens numérotés qui ouvrent chaque extrait à la seconde citée. Et chacun décide si ses résumés et ses notes privées sont lisibles par cet agent.

Reste la question qui fâche, parce que le projet se vend comme un truc auto-hébergé, donc privé. Et en creusant un peu, je me suis rendu compte qu'il y avait quand même des choses qui sortaient de la machine. Il y a d'abord la transcription, qui envoie l'audio au moteur qui le transforme en texte. Et celui du texte ensuite, qui expédie la transcription au modèle qui écrit les résumés, les titres et les réponses du chat.

Et dans la configuration de base, les deux usages IA pointent chez un tiers : une clé OpenAI pour l'audio, une clé OpenAI (ou OpenRouter) pour le texte. Votre serveur, lui, ne stockera que des fichiers...

Alors, il faudra bien penser, si vous voulez que ça reste en local, à brancher Ollama à la place d'OpenAI et OpenRouter. Mais couper celui de l'audio se paiera car pour réussir à transcrire de l'audio, il vous faudra quand même une bonne carte graphique et un gros modèle Whisper comme expliqué dans le guide d'installation .

Sans carte, ça tourne quand même, rassure-vous, mais ce sera plus lent.

Pour le reste, c'est du Docker avec SQLite ou PostgreSQL, 2 Go de RAM annoncés pour l'application seule, et tout ce qu'on attend d'un truc qui s'utilise à plusieurs : comptes, authentification unique, partages, API et webhooks signés.

C'est sous licence AGPLv3, doublée d'une licence commerciale pour ceux qui ne veulent pas s'y contraindre.

Niveau outils semblables, il y a Scriberr, dont je vous ai déjà parlé , transcrit en local sans jamais rien envoyer dehors, mais son auteur vient d' annoncer une pause dans le développement . On a aussi l'application Meetily , qui elle, vise le poste de travail plutôt que le serveur d'équipe, et réserve la séparation des voix à son offre payante. Et si c'est de la dictée en direct sur Mac dont vous avez besoin plutôt que d'exploiter des enregistrements déjà faits, j'ai codé Kassis pour ça, qui reste en local lui aussi.

Alors finalement, pourquoi ne pas donner sa chance à Speakr ?

ffmpeg - Doubler le framerate d'une vidéo avec votre GeForce

Depuis ce week-end, bonne nouvelle les zamis, puisque ce bon vieux ffmpeg sait maintenant fabriquer des images qui n'ont jamais été filmées. Oui oui ! Et ça c'est possible grâce à un filtre qui s'appelle fruc_vulkan, qui permet de calculer le mouvement entre deux images grâce au bloc dédié des GeForce RTX, pour ensuite synthétiser ce qui manque entre les deux. Grâce à ça, un 24 images par seconde ressort sans souci en version 60 images par seconde.

La cadence de sortie se paramètre, donc vous pouvez aussi faire du 25 vers du 50, du 30 vers 60, ou n'importe quelle valeur intermédiaire. C'est donc beaucoup plus souple que le filtre équivalent côté AMD, frc_amf, qui ne sait que doubler la fréquence et ne fonctionner qu'en DirectX...

Fabriquer ce genre d'images intercalaires n'a rien de neuf, cela dit... L'outil RIFE convertissait déjà du 24 fps en 96 en 2020. Mais ce qui change ici, c'est qu'il n'y a plus de chaîne externe, plus d'aller-retour par des milliers de PNG, puisque tout tient dans le graphe de filtres, entre le décodage et l'encodage.

Le filtre logiciel historique de ffmpeg, minterpolate, existe pourtant depuis des années mais c'était loin d'être du temps réel. Alors que là, le vrai gain avec cette nouvelle feature, c'est qu'on passe en full temps réel. Ça veut dire que sur un catalogue à réencoder, l'interpolation cesse d'être l'élément qui bloque toute la chaîne de conversion.

Pour l'essayer il vous faut une RTX 30 ou plus récente. Il faut aussi compiler une version de développement car ce filtre est arrivé après la sortie de ffmpeg 9.0, ce qui veut dire que pour le moment, il n'est dans aucune release et ne sera dans aucun paquet avant la prochaine.

La commande suit ensuite le motif habituel des filtres Vulkan, qui veulent les images en mémoire GPU :

ffmpeg -init_hw_device vulkan=vk:0 -filter_hw_device vk -i entree.mp4 -vf "format=yuv420p,hwupload,fruc_vulkan=fps=60,hwdownload,format=yuv420p" sortie.mp4

L'auteur du filtre prévient quand même qu'en 2160p24, les réglages par défaut ne suivront pas en temps réel et qu'il faudra alors descendre la qualité d'estimation du mouvement. Ça s'écrit comme ceci :

fruc_vulkan=fps=60:perf=medium:grid=2

En traitement par lots maintenant, la question ne se pose pas, c'est juste plus lent.

Maintenant, les pros de l'encodage, redescendez de votre chaise parce que j'ai quand même quelques mauvaises nouvelles... Tout d'abord, on n'a aucune stat indépendante sur le débit ou la qualité. Et il y a aussi un défaut que l'auteur du patch documente lui-même... En fait, dans les zones sans texture, le moteur invente un mouvement faux mais cohérent, qui laisse des "fantômes" autour des objets. La parade existe heureusement, mais c'est une heuristique, qui demande quelques réglages à la main sur des échantillons.

Et il y a aussi un coût qu'on oublie... Car doubler la cadence, c'est donner deux fois plus d'images à avaler à l'encodeur, donc, il y a toujours une espèce de goulot d'étranglement. Et puis après il y a le rendu... un film de cinéma en 24 images par seconde qu'on monte à 60 prend immédiatement un aspect téléfilm que les cinéastes détestent !! Imaginez l'Odyssée de Nolan avec l'aspect visuel de Plus Belle La Vie... Ahahaha. Après sur de l'animation ou un ralenti, ça se défend bien sûr mais sur du cinéma, c'est un choix à prendre et pas une amélioration. En tout cas, c'est mon avis.

Ah et dernier point, parce que la confusion est déjà partout dans les commentaires sur le net : Tout ça se passe à l'encodage ! Je répète : A L'ENCODAGE ! Le fichier qui sort de ffmpeg est une vidéo NORMALE. Absolument personne n'aura besoin d'une carte graphique GeForce pour la regarder ! OK ? 😘

Source : Phoronix

Nvidia s'offrirait Hugging Face pour 12,9 milliards

Voilà le genre de rumeur qui fait tousser tout un secteur. D'après plusieurs médias américains bien branchés, Nvidia serait sur le point de poser 12,9 milliards de dollars sur la table pour avaler Hugging Face. Aucun des deux ne confirme, l'accord peut encore capoter, mais l'annonce serait proche.

Un mot pour ceux qui ne connaissent pas. Hugging Face, c'est un peu le GitHub de l'IA, un immense dépôt en ligne où les développeurs du monde entier rangent, échangent et récupèrent des modèles d'intelligence artificielle libres, avec les paquets de données qui vont avec.

Toute une communauté y a planté sa tente, celle qui triture l'IA loin des grosses forteresses fermées d'OpenAI ou de Google, et qui en a fait son point de ralliement.

En rachetant Hugging Face pour un tel montant, Nvidia n'empocherait pas uniquement la bibliothèque ultime des modèles IA, mais elle poserait aussi ses grosses fesses en plein milieu du carrefour où tout l'IA mondiale ouverte transite. C'est loin d'être négligeable.

Rappelons que la boîte tient déjà les puces qui font tourner à peu près toute l'intelligence artificielle de la planète. Ajoutez le dépôt où les développeurs vont piocher leurs modèles, et vous obtenez les deux bouts de la ficelle dans la même main, ce qui fait tout de même beaucoup pour un seul acteur.

En plus de ça, il y a la question du Cloud, un sujet qui intéresse très fort Nvidia depuis bien longtemps. Racheter Hugging Face permettrait à l'entreprise de refourguer sa puissance de calcul à tous les clients de la plateforme, qui ont tous de vrais besoins en cloud.

Ce flirt ne date d'ailleurs pas d'hier. Nvidia y avait déjà glissé quelques billets en 2023, quand Hugging Face valait 4,5 milliards, puis tenté d'y remettre 500 millions fin de l'année dernière, sauf que la réponse a été non. On est donc passé du pied dans la porte à l'envie de tout emporter.

Source : Techcrunch

Test du UGREEN DXP4800 GT : le NAS 4 baies qui gère tout mon Plex, piloté par une IA

- Contient des liens affiliés Amazon -

Au départ, mon stockage était franchement bordélique. Ma bibliothèque Plex vivotait sur un vieux Synology, avec plusieurs SSD externes branchés au Mac mini, posés là au petit bonheur, avec les films rangés à plat et chaque disque qui traînait ses propres conventions et ses trous.

Je vous en avais d'ailleurs déjà parlé, et ça marchait, mais c'était un peu le foutraque, et surtout impossible à automatiser proprement, parce qu'une chaîne d'acquisition sérieuse exige un rangement carré jusqu'au moindre fichier.

D'où la grande décision de remettre tout ça à plat. L'objectif ? Consolider la médiathèque sur du matériel récent, séparer une bonne fois deux mondes qui n'ont rien à faire ensemble, les médias d'un côté et les sauvegardes de l'autre, et déléguer le plus gros de la configuration à Claude Code, l'assistant de codage d'Anthropic, piloté à distance depuis mon Mac mini.

UGREEN m'avait proposé depuis quelque temps de tester les deux NAS de sa gamme GT, j'ai donc accepté. Puis j'ai acheté mes disques une fortune, on y reviendra. Pour Plex, mon choix s'est porté sur le plus costaud de la gamme, un DXP4800 GT quatre baies sous AMD Ryzen.

Sa vraie raison d'être, c'est le débit. Ses deux ports réseau 10 Gbit confiés à des contrôleurs Aquantia ont craché 9,30 Gbit par seconde dès le premier flux en direct, soit le maximum théorique, sans une seule retransmission. Sur ce terrain, il est clairement irréprochable.

Sous le capot, on trouve un Ryzen Embedded R2514 à quatre cœurs, 8 Go de DDR4 extensibles à 64 Go, quatre baies qui se manipulent sans outil dont deux acceptent des SSD U.2 NVMe, plus deux emplacements M.2, le tout jusqu'à 144 To. Il tourne sous UGOS Pro, un système bâti sur une base Debian très peu verrouillée, avec un vrai SSH administrateur, Docker, et une plateforme x86 ouverte où l'on peut installer à peu près tout ce qu'on veut.

Le seul vrai bémol, c'est son moteur vidéo un peu daté, qui ne tient que deux flux Plex 4K transcodés en même temps et ignore l'AV1, donc pour une grosse médiathèque partagée à plusieurs, mieux vaut lui donner des fichiers déjà au bon format, ou transcoder sur une autre machine, ce qui est mon cas avec le Mac mini. Pour le stockage, j'ai récupéré 4 disques 28 To sur Amazon , à un prix que je n'ose même pas vous donner (660 euros pièce, et au moment où j'écris cet article leurs prix ont bondi à 780 euros).

Le gros morceau, c'était la migration, faire passer 36 To et 22 000 fichiers du Synology vers ce nouveau NAS. Perso je n'ai pas fait grand-chose, Claude Code s'est occupé de tout ça en SSH, en passant par les API de Plex, Radarr et Sonarr.

Derrière Plex tourne d'ailleurs toute une chaîne, Radarr et Sonarr, Prowlarr pour les sources, une seedbox Whatbox et Seerr.

Pour l'anecdote, le plus gros problème ça a été de régler les problèmes posés par les fichiers avec des accents. Près de 17 000 fichiers (de vidéos de vacances bien sûr) au chemin accentué devenaient injouables sur l'Apple TV alors que l'iPhone les lisait sans broncher, parce que Plex sur Mac jongle entre deux façons de coder un accent en Unicode quand le partage NFS strict d'UGOS n'en accepte qu'une seule à l'octet près.

Bon, maintenant on ne va pas se mentir, il y a eu des ratés avec l'IA, comme la disparition de près de 800 fichiers effacés par un bug des scripts, sans corbeille ni snapshot, mais comme le volume tourne en Btrfs et qu'il restait de la place, Claude a gelé le volume, remonté des centaines d'états internes du système de fichiers et rapatrié plus de 98 % des fichiers. Les pertes sont au final négligeables. C'était évitable, mais je n'ai pas été assez vigilant.

Ce socle sauvegarde même le code de Selene Racer, mon jeu de course de rovers sur la Lune hébergé dans le cloud sur lequel je bosse en ce moment ( vous pouvez le tester ici , il se joue dans n'importe quel navigateur, sur ordi ou téléphone), et dont les sources atterrissent sur le NAS via Dropbox. Quant au NAS deux baies qui encaisse Time Machine, les archives et les sauvegardes, c'est son petit frère le DXP2800 GT, que je teste sur Mac4ever .

Si comme moi vous n'êtes pas super fort en code et en réseau, et que vous avez suffisamment de sauvegardes de vos données, confier votre vie numérique à une IA et à un NAS de ce type est donc tout à fait envisageable, et c'est même assez chouette à mettre en place.

Les DXP4800 GT et le DXP2800 GT sont disponibles sur Amazon, et je vous les recommande les yeux fermés.

OpenAI remet la limite de 5 heures sur Codex

Si vous codez avec Codex, l'agent d'OpenAI qui écrit du code à votre place, préparez-vous à devoir à nouveau regarder votre montre, puisque cette fameuse limite fait son retour pour les abonnés ChatGPT Plus à partir du 25 août.

C'est un vrai retour en arrière, parce qu'OpenAI avait justement supprimé cette fenêtre de cinq heures le 12 juillet dernier, en ne gardant qu'un plafond hebdomadaire pour les formules Plus, Pro et Business.

Concrètement, la limite des cinq heures fonctionne comme un compteur qui se recharge tout au long de la journée, en plus du quota hebdomadaire qui, lui, encadre votre consommation sur la semaine entière.

Le responsable technique de Codex et ChatGPT chez OpenAI, Thibault Sottiaux, justifie ce choix en expliquant que cette fenêtre permet de lisser la charge sur les serveurs, et donc de préserver un quota hebdomadaire qui reste généreux.

Surtout, sans elle, beaucoup de nouveaux abonnés Plus grillaient sans le vouloir toute leur allocation de la semaine en quelques heures, ce qui débouchait forcément sur une expérience frustrante.

Bonne nouvelle pour les gros comptes, les abonnés Pro à 100 et 200 dollars par mois échappent encore à ce retour de la limite pendant quelques mois, alors que les formules Enterprise et Edu tournent sur un système de crédits à part.

Et si vous tapez dans le mur de l'une des deux limites, il ne vous reste que deux options, patienter jusqu'à la prochaine remise à zéro ou sortir la carte bleue pour acheter des crédits supplémentaires.

Retirer la fenêtre des cinq heures ne rendait de toute façon jamais GPT-5.6 Sol illimité, puisque le plafond hebdomadaire prenait simplement le relais comme nouvelle borne. Rien de gratuit, donc.

Ce yo-yo permanent sur les limites finit par agacer, même si OpenAI galère visiblement à encaisser la demande. Les développeurs, eux, aimeraient surtout de la stabilité. Après chez Claude c'est pareil mais c'est 4h, même pour les abonnés Max, encore plus frustrant donc.

Source : 9to5mac

Aux origines du premier GPU, une bande de copains de l'ENS

Les travaux d'étudiants de la promotion 1973 de l’École Normale Supérieure (Normale Sup) sont à l'origine de la production, dès 1977, d'une famille de circuits intégrés (CI) dédiés à l'affichage sur écran (à l'époque, cathodique ).

Cette dépêche est consacrée à l'un d'entre eux, l'EF9365 (ou le "365" pour les intimes), qui est stricto sensu le premier GPU (excusez-du peu !) et nous verrons pourquoi.

l'EF9365

Le circuit intégré Thomson-Efcis EF9365
Contrôleur de visualisation graphique,1980

Les rédacteurs de cette dépêche collaborative remercient :

  • Philippe Matherat, le concepteur de ce composant ! Il a eu la gentillesse de se prêter au jeu en répondant à nos questions et en apportant de nombreuses précisions et anecdotes –les citations dans la dépêche sont intégralement de sa main– ;
  • PulkoMandy, pour son journal d’archéologie informatique sur la thèse de Jean Gastinel. Sans ce journal, cette dépêche n'aurait jamais vu le jour ;
  • Jean-François DEL NERO, développeur de l’émulation du 365 dans Mame, pour les échanges et les apports techniques ;
  • l'équipe de rédaction du magazine Sciences et Avenir, pour l'autorisation de publier des extraits de l'article "le Silicon labo de la rue d'Ulm", n° 455 (Janvier 1985).

Sommaire

Généalogie des puces EFxxxx

Un GPU est un composant informatique (une puce dédiée dans les cartes graphiques des PC ou intégrée au processeur central (CPU) de votre téléphone (soc)) initialement dédiée à l'affichage d'images.

D'abord limité à l'affichage 2D, il a rapidement pris le relais du CPU pour gérer les calculs parallèles de la 3D. Aujourd'hui, cette puissance brute sert autant au traitement vidéo qu'à des domaines bien éloignés des pixels, comme le minage de cryptomonnaies ou l'IA.

Cette bascule technologique a récemment propulsé nVidia, le principal acteur du marché, au sommet de l'économie mondiale.

Pourtant, bien avant cette folie financière et les géants américains ou asiatiques, c'est en France qu'est née cette architecture moderne.

Cette dépêche vous propose de découvrir l'histoire du 365, le premier GPU sur puce unique.

La génèse
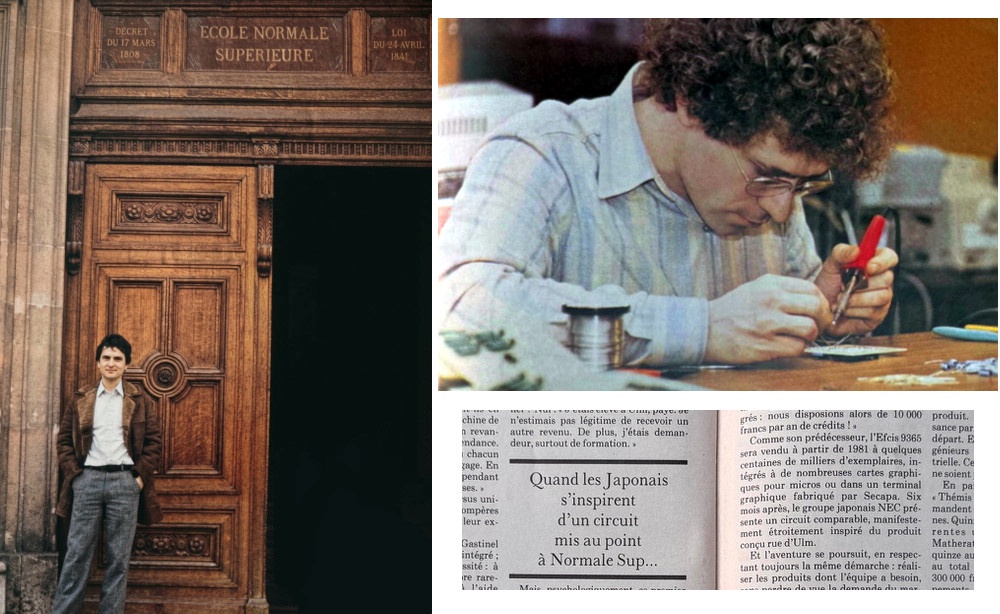
Extraits de l'article

Extraits de l'article "le Silicon labo de la rue d'Ulm" de Dominique COMMIOT
© Sciences et Avenir n° 455 (Janvier 1985)
À gauche, Jean GASTINEL devant le bâtiment historique de l'ENS.
À droite, Philippe MATHERAT et un extrait de l'article.

Philippe Matherat avait résumé ainsi le contexte de cette épopée dans l'article de PulkoMandy :

Nous étions une bande de copains, élèves de l’Ecole Normale Supérieure, de la promotion 1973.

L’informatique était balbutiante, les ordinateurs étaient gigantesques (un bâtiment), très rares et très chers. Personne n’envisageait qu’ils puissent être répandus et bon marché.
Les seuls écrans connus étaient ceux de la télévision. Les terminaux informatiques étaient des machines à écrire mécaniques actionnées par des relais électromécaniques. Ces terminaux étaient reliés à des gros ordinateurs distants, par une ligne téléphonique dédiée.
La fréquence d'horloge des ordinateurs les plus puissants était 12 MHz.

Jean Gastinel était le seul de notre promotion qui connaissait un peu ce qui se passait aux Etats-Unis, grâce à son père : Noël Gastinel, qui était professeur à Grenoble et qui avait fait des voyages dans les universités américaines et chez IBM. Il avait fait équiper l’université de Grenoble d’un ordinateur IBM 360/68.
Jean Gastinel, avec Jean-Marc Frailong et Jean-Luc Richier, ont réalisé un ordinateur 12 bits, à base de circuits MSI de Texas-Instruments, dans les années 1973-1975.

Puis Jean-Gastinel s’est lancé dans la conception du circuit d’affichage alpha-numérique, qui a été commercialisé sous le nom de SFF364 puis EF9364 (le changement de nom correspond au changement de nom de la société Sescosem en EFCIS). Cette conception a fait l’objet de sa thèse de 3è cycle.

Depuis cet article, P. Matherat a détaillé :

Quand je suis entré à l’ENS en 1973, il n’y avait pas de labo d’informatique, ni d’électronique. Les disciplines (en sciences) étaient les disciplines classiques de l’université : mathématique, physique, chimie, biologie, etc. Les chercheurs et les élèves avaient accès à un "Centre de calcul", dirigé par Maurice Vallino, qui consistait en un terminal (lecteur de cartes perforée et imprimante) connecté à un ordinateur Univac de l’université d’Orsay par une ligne à 1.200 bits/s, puis plus tard équipé d’un mini-ordinateur CII Mitra 15. Nous avons eu des cours de programmation Fortran par Jacques Arsac. Nous avions aussi accès à une formation en électronique (analogique), dans un local du labo de physique, fait par F. Lenouvel.

Quand Jean Gastinel a souhaité réaliser un ordinateur, associé à J-M Frailong et J-L Richier, ils sont allés à Jussieu, à l’institut de programmation, où il y avait une équipe qui réalisait des montages électroniques, dirigée par Gérard Noguez. Puis, ils ont souhaité continuer à l’ENS, et M. Vallino leur a cédé une petite pièce annexe du Centre de calcul, ainsi qu’un petit budget annuel de 10.000 F. C’est dans cette pièce que Jean a réalisé la maquette du 364, puis j’ai continué là avec la maquette du 365.

Ce que nous appelions "maquette" était le câblage d'une émulation de la future puce à l'aide de circuits MSI existants (des centaines), afin de pouvoir tester en temps réel la conception logique. Il n'existait aucun outil de CAO. Tout était câblé à la main, sans simulation préalable, et notre principal outil était l'oscilloscope pour vérifier les signaux. Avec des fréquences de l'ordre de quelques MHz, il nous fallait un oscilloscope haut de gamme.

Une question de mémoire

Sans la capacité d'Intel à produire en masse des puces DRAM de plus en plus denses, le 365 n'aurait jamais pu exister :

À la suite du 364, j’ai pensé qu’on pouvait faire du graphique : j'ai commencé cette étude en 1976, à l'occasion de mon DEA d'informatique. Il faut bien voir que ceci n’est devenu possible que grâce aux nouvelles mémoires de 4 Kbits, car un affichage 512 x 512 à 1 bit/pixel nécessite 64 boîtiers mémoires de 4 Kbits. En fait cela ne devient raisonnable qu’avec 16 boîtiers de 16 Kbits (soit 32 K octets). Il n’était donc pas possible de faire un GPU avant ces années-là. Mon mérite a été d’avoir le flair de voir qu’une période nouvelle pouvait s’ouvrir, et que les écrans graphiques pouvaient se démocratiser.

Mais utiliser 32 K octets rien que pour l'écran paraissait délirant, à une époque où la mémoire "centrale" utilisée par le CPU pour son programme et ses données ne dépassait pas 4 ou 8 K octets. Quand à vouloir faire de la couleur avec 3 bits par pixel, là j'étais vraiment pris pour un fou. Songez qu'un adressage sur 16 bits (cas des microprocesseurs de l'époque) ne permet pas de dépasser 64 K (= 216 ).
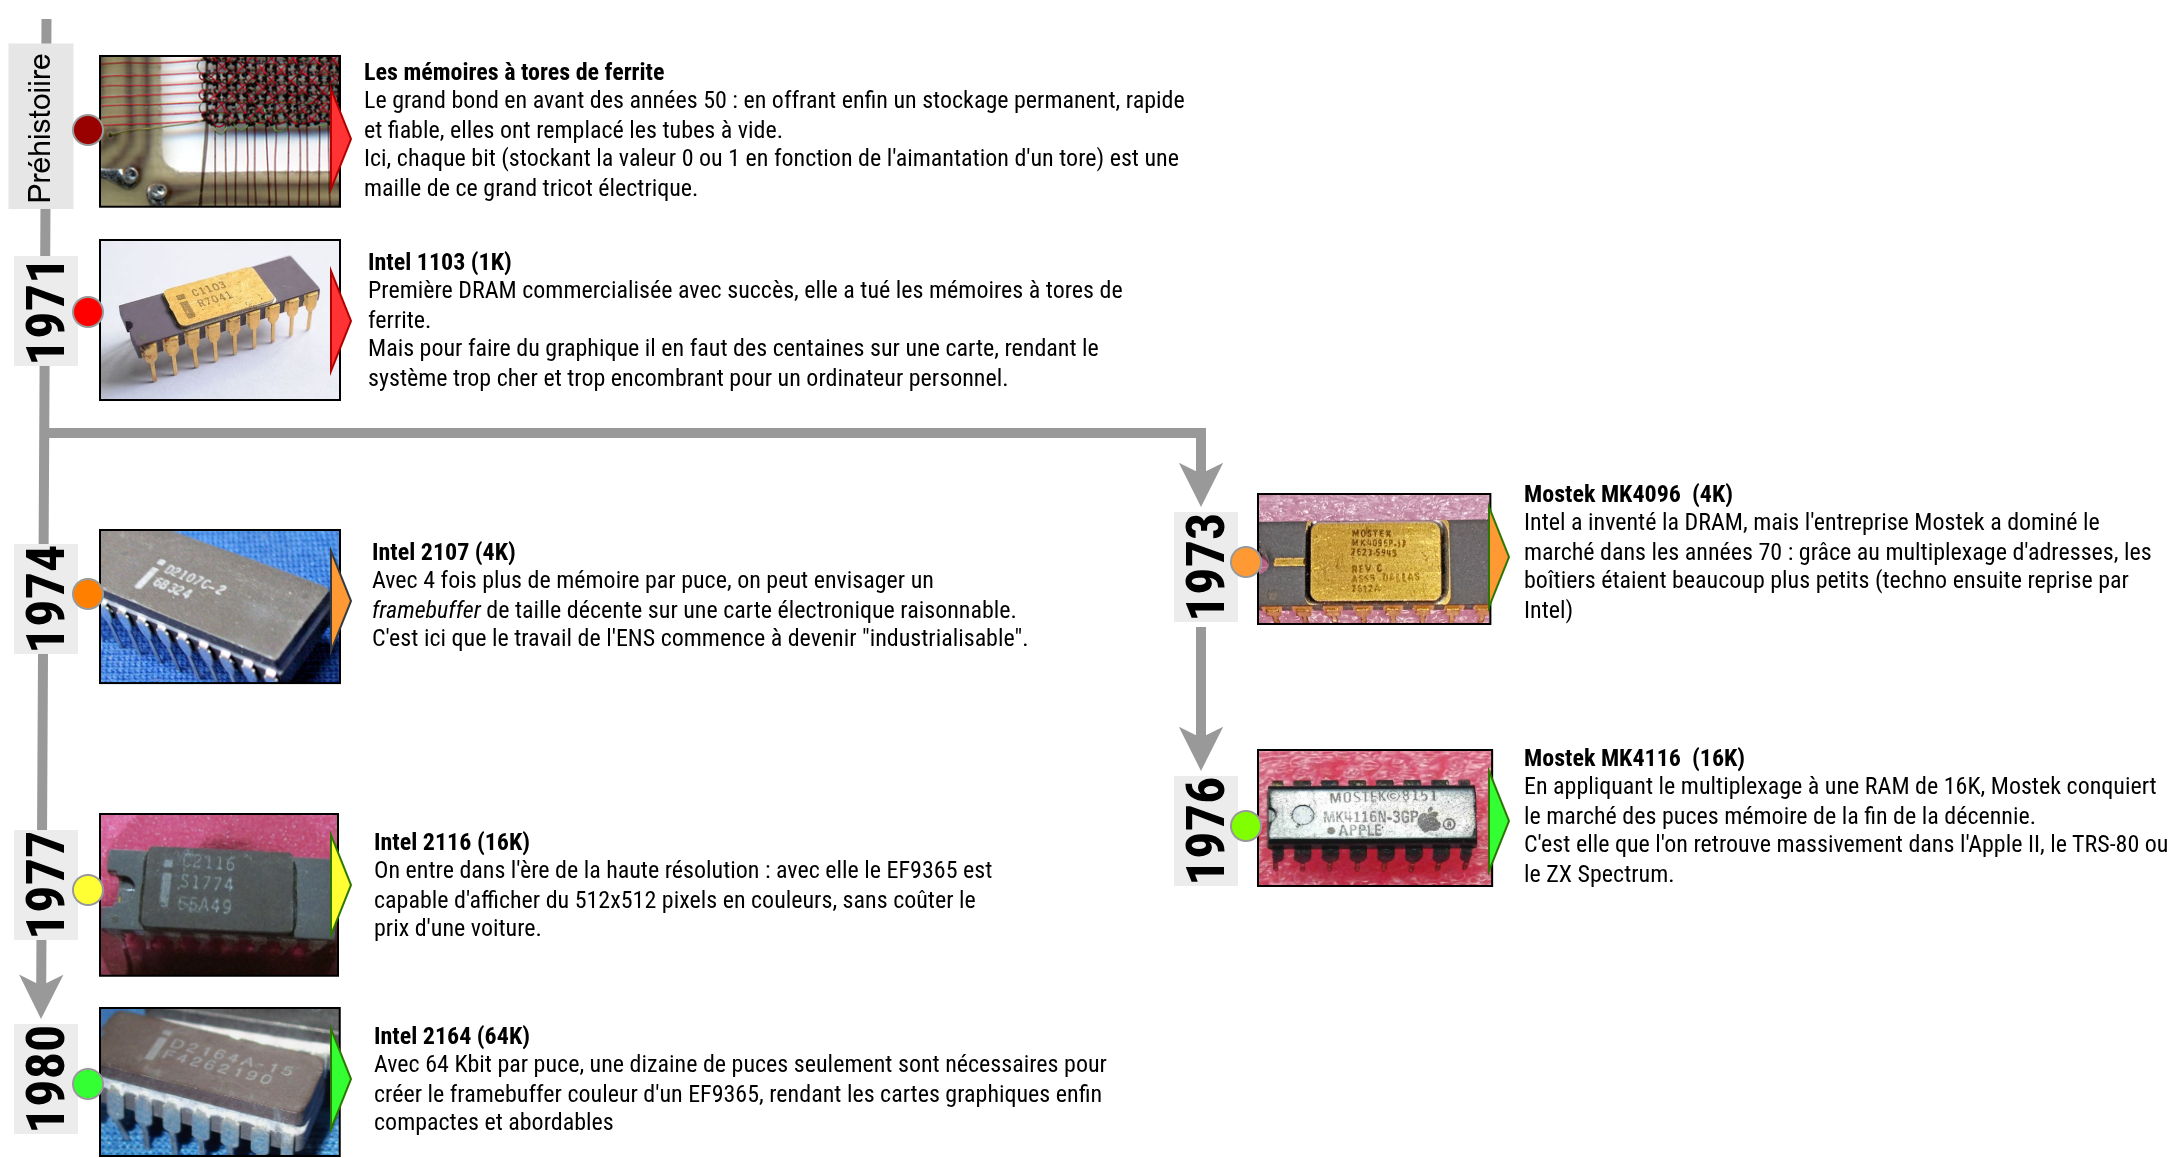
Dates de sortie des DRAM Intel

Le marché aux puces des seventies
Naissance et évolution des composants DRAM

Notez bien que, à l'époque, la capacité de ces mémoires s'exprime en bits (non pas en octets), et par un simple « K » : ce k majuscule vaut 1 024 bits (le kibibit actuel) et non 1 000. Pour résumer et par exemple, il faut traduire 16K par 2 kio.

Pourquoi cette augmentation de la capacité de la RAM à cette époque ?

Les circuits de RAM nécessitent un très grand nombre de transistors, mais sont très répétitifs : ils coûtent donc relativement peu cher à concevoir, mais demandent une chaîne de production de semi-conducteurs de très bonne qualité. Les fabricants de semi-conducteurs Japonais sont ceux qui vont le mieux maîtriser ce type de produit, fournissant des composants de plus en plus grande capacité à des prix écrasant la concurrence américaine. Intel ne s'en remettra qu'avec de grosses difficultés. Un autre fondeur de RAM américain, Mostek, n'y survivra pas et sera revendu à Thomson-CSF, qui rentabilisera largement son investissement en exploitant les brevets ainsi rachetés.

Le plastique, c'est fantastique

En creusant le sujet de ces premières mémoires vives, on comprend qu'il y a eu une autre évolution importante : le choix du matériau pour le boîtier.

Les boîtiers des premiers CI (dont la référence est préfixée par "C" ou "D") étaient en céramique : c'était coûteux mais dans les début des années 70 seul ce matériau répondait aux besoins de dissipation thermique et d'étanchéité.
Au départ, les fabricants avaient du mal à stabiliser le plastique, car l'humidité finissait par s'infiltrer par capillarité le long des pattes en métal, provoquant la corrosion de la puce.
Pour protéger la puce, il lui a été ajouté une couche (au nitrure de silicium), dite "de passivation", qui permet le contact avec le plastique.
Plus tard dans la décennie (à partir des puces 16K soit vers 1977), la transition vers le plastique s'opère massivement, leur référence est alors préfixée par "P".
Le moulage plastique a permis de produire des puces à la chaîne à un prix dérisoire par rapport au processus artisanal du boîtier céramique multicouche.

La production

L'histoire industrielle du fondeur

  • 1969 : Création de Sescosem (Société Européenne de Semiconducteurs et de Microélectronique), filiale de Thomson-CSF.  
    Selon Wikipedia : Thomson-CSF est le résultat de la fusion réalisée en 1968, du groupe électronique Thomson (filiale de Thomson-Brandt) et de la Compagnie générale de télégraphie sans fil (CSF). Leurs filiales dédiées aux circuits intégrés, respectivement SESCO et COSEM, sont donc fusionnées pour devenir SESCOSEM.
  • 1976 : Sescosem devient EFCIS (Étude et Fabrication de Circuits Intégrés Spéciaux). C'est à ce moment précis que la référence change : le SFF364 devient l'EF9364.
  • 1983 : Thomson-CSF réorganise ses activités. EFCIS est intégrée au sein de la branche Thomson Semiconducteurs. C'est l'époque de la grande offensive sur le marché grand public avec le Minitel et les ordinateurs (Alice, VG5000) utilisant les dérivés comme l'EF9345.
  • 1987 : Thomson Semiconducteurs fusionne avec la branche composants de l'italien SGS (Société Générale Semiconduttori). Naissance de SGS-Thomson Microelectronics.
  • 1998 : SGS-Thomson est renommé STMicroelectronics (ST), le nom que nous connaissons aujourd'hui : une multinationale franco-italienne de droit néerlandais.
Fabrication de transistors à la COSEM

Fabrication de circuits à la COSEM
source https://aconit.inria.fr/omeka/items/show/681 E. Gillet, Les transistors, ces magiciens.
Gamma Presse, 1964. Crédits photo : René Bouillot.

Dates de production

Chronologiquement, Sescosem ou EFCIS ne faisaient pas de tels chips pour écrans avant que les élèves de l’ENS lui en apportent :

  • En premier, Jean Gastinel a conçu le circuit alphanumérique EF9364, de 16 lignes de 64 caractères, qui est sorti vers 1977.
  • Ensuite, j’ai conçu le premier chip graphique EF9365, de 512x512 pixels, qui est sorti vers 1980, avec sa variante EF9366 (balayage non-entrelacé).
  • Le circuit 9367 est une variante du 9365, avec des performances augmentées.
  • Les circuits du genre 9345 sont postérieurs au 9365, ils utilisent les éléments de base des circuits précédents, et ont été demandés par les concepteurs du minitel, qui sont donc des copies, variantes, des circuits conçus par les élèves de l’ENS.
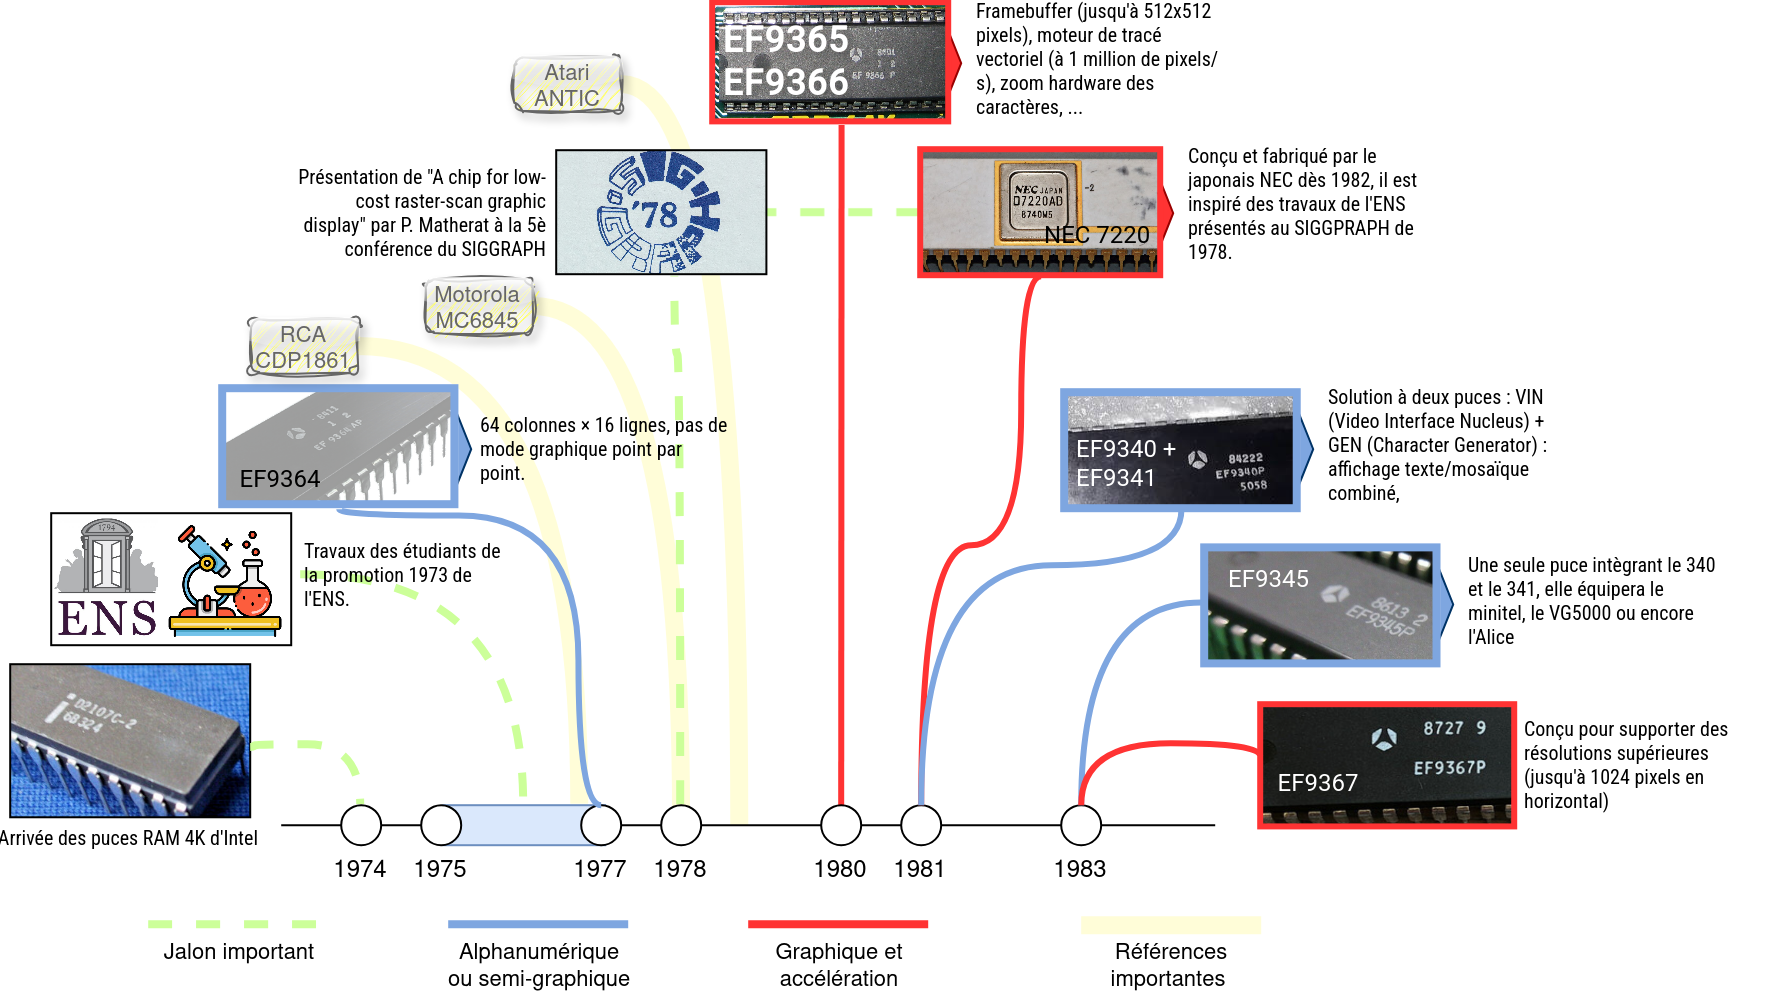
Généalogie des puces EFxxxx

Chronologie de mise sur le marché
des puces EF9xxx et quelques consœurs

La petite famille

L'EF9364, le précurseur

L'année dernière, PulkoMandy a exhumé la thèse de Jean Gastinel "Conception et intégration d'un terminal alphanumérique", qui pose avant l'heure les bases du Minitel et qui est aussi à l'origine de l'aîné de la famille : l'EF9364 est un contrôleur vidéo purement alphanumérique (affichage de 16 lignes de 64 caractères).

Cette thèse est une véritable pépite pour les férus d’archéologie informatique, on y trouve notamment tous les détails sur la réalisation du CI :
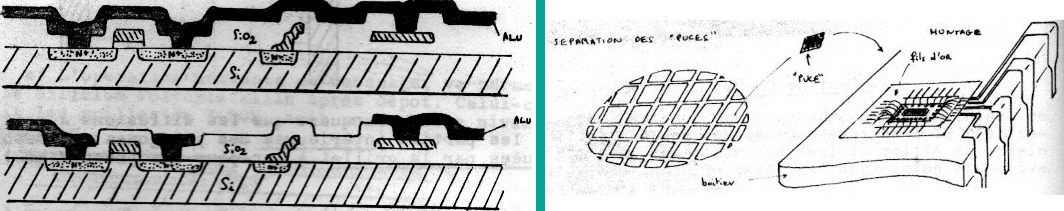
Ajout d'un masque

fig 1.10 - Dessin final des cinq masques superposés - Chapitre 1 fig 4.2 Montage des "puces", Chapitre III "Intégration du circuit "VISU" de la thèse

Ce composant est prévu pour réaliser un terminal passif, sans microcontrôleur. Avant son arrivée, toute la logique vidéo des terminaux était implémentée par de la logique discrète: une centaine de puces électroniques étaient nécessaires. Les autres composants d'un terminal, comme le modem et le contrôleur de clavier, bénéficiaient déjà de solutions intégrées. Ce composant rend donc possible la construction d'un terminal à très bas coût avec quelques dizaines de composants.

Il implémente tout de même des fonctionnalités de défilement de l'affichage, de déplacement du curseur, et d'effacement partiel (tout l'écran visible, la ligne courante, depuis le curseur jusqu'à la fin de la ligne). Ces fonctionnalités sont similaires à ce qui se fait sur les terminaux de l'époque (VT52 chez DEC, ADM-3A, …). Cependant, les générations suivantes de terminaux à partir du VT100 choisiront plutôt d'utiliser un microprocesseur.

La génération des caractères proprement dit est effectuée par un composant séparé appelé générateur de caractères. Il s'agit dans le cas le plus simple d'une ROM programmée avec une police bitmap de taille fixe.

Pour les nostalgiques du rendu d'affichage alphanumérique (le seul proposé par cette puce) sur un écran de l'époque, vous pouvez essayer cool-retro-term (lien qui devrait être sponsorisé par le SNOF)
capture cool-retro-term

Simulation d'affichage sur tube cathodique
        par cool retro term, à la EF9364
(alphanumérique, 64 colonnes x 16 lignes)

L'EF9365

Second de la famille, c'est l'objet de notre dépêche : voir la section suivante qui lui est dédiée.
Nous passons souvent sous silence le EF9366, qui est très proche du 365, mais les 2 sorties sont vraiment concomitantes.

En fait, les 9365 et 9366 sont sortis en même temps, c’est moi qui avais fait la modification qui supprime l’entrelacement (pour le 9366), car le premier client (Secapa), qui avait travaillé sur la maquette de simulation du 365, ne supportait pas le clignotement de l’affichage 512x512. Pour moi, l’intérêt était d’avoir une résolution élevée, et je conseillais d’utiliser un CRT avec des phosphores plus rémanents. Mais les CRT les moins chers (TV) avaient des phosphores rapides.

Nous passons aussi sous silence le EF9367, sorti plus tard, proche du 365 mais supportant des résolutions supérieures.

Le NEC µPD7220 : le cousin Japonais

Ce composant n'est pas compatible avec la série EF9365. Cependant, il a un fonctionnement assez similaire. Commercialisé en décembre 1981, il a été développé à partir de 1979, et probablement inspiré par la présentation du travail sur le 365 au SIGGRAPH en 1978.

En plus des lignes, rectanges et textes, il peut tracer des cercles, arc de cercles et autres courbes. Il est également prévu pour s'interfacer avec un contrôleur DMA, ce qui facilite l'échange de données avec le CPU de contrôle.

Le design de NEC a également été produit par Intel, qui continuera à faire évoluer cette famille de composants. C'est donc un ancêtre des GPU Intel toujours en production aujourd'hui.

L'EF9340 et 9341

Ces deux composants sont au cœur des premiers modèles de Minitel, il s'agit d'une adaptation "low cost" et d'un retour au mode alphanumérique. Ils sont conçus en 1980-1981.

Les premiers prototypes du Minitel utilisent des circuits de chez TI (que l'on retrouvera également dans l'ordinateur Exelvision EXL100). Mais les modèles de production se tournent vers une solution "made in France". Thomson EFCIS se charge de la conception de ces circuits qui sont fournis à Alcatel pour la fabrication du Minitel.

Réponse à appel d'offre du Minitel mentionnant les circuits VIN et GEN : la visualisation est confiée à deux circuits spécialisés VIN et GEN, chargés des signaux de base de temps et de la synthèse des caractères.

Ils sont associés à un microprocesseur, faisant du Minitel un terminal "intelligent" capable de réaliser certaines fonctions en autonomie, sans avoir besoin de communiquer chaque appui de touche du clavier au serveur central.

Ils ajoutent également un mode "semi-graphique" : il ne permet pas d'afficher des pixels, mais propose des 'briques', de 2x3 éléments, pré-dessinées dans la ROM du processeur.
On économise ainsi drastiquement la RAM qui coûtait, déjà, cher…
Le prix unitaire d'une RAM Intel 2107 (de 4K, soit 512 octets) était, à sa sortie en 1974, de 50 $ => avec l'inflation cumulée et la conversion, cela représente environ 295€ de 2026.

Exemple de [caractères semi-graphiques](https://en.wikipedia.org/wiki/Thomson_EF9345)

Exemple de caractères semi-graphiques
              autorisés par L'EF9345
       Page 84 du Databook Thomson.

En plus du Minitel, ces composants seront également utilisés par Philips dans les consoles Videopac Plus, ce qui sera la première étape dans la conception du VG5000 dont on reparle au chapitre suivant.

L'EF9345, la cheap chip

Le composant EF9345 regroupe dans une seule puce les fonctionnalités du générateur de caractères et du contrôleur de timing vidéo (GEN et VIN, qui étaient auparavant deux composants séparés).
Cette photo zoomable du cœur de silicium du composant (die shot) montre bien cet assemblage.
Cela a permis de réduire le coût de production du Minitel et a également été utilisé dans quelques micro-ordinateurs personnels : l’Alice chez Matra ou le VG5000 chez Philips.
Captures de US Rallye

Captures de US Rallye, le Gran Turismo de 1984

Ici, la puce ne sait pas ce qu'est un pixel : elle manipule une grille de caractères (25 lignes de 40 ou 80 colonnes).

Pour afficher une lettre ou un bloc de couleur (le fameux mode mosaïque), le processeur principal envoie juste un code d'un octet en RAM. C'est une ROM interne à la puce d'affichage qui se charge ensuite de traduire cet octet en points lumineux à l'écran.

C’était une astuce pour économiser la mémoire, mais impossible de tracer une ligne fine ou de faire bouger un élément au pixel près : on est condamnés à déplacer des blocs rigides sur une grille fixe. Au mieux, certains caractères peuvent être redéfinis, pour afficher un logo ou une image simple.

La suite pour ST

Pour ST Microelectronics, l'histoire des composants graphiques continue encore quelques années après la commercialisation de la série EF936x. Bien que les composants graphiques n'ont pas eu le volume de production de la version alphanumérique (surtout portée par le Minitel), ils ont trouvé une utilisation dans l'informatique scientifique et les appareils de mesure nécessitant la visualisation de données : spectromètres, analyseurs de spectre, ainsi que des réalisations spécifiques (cartes graphiques en kit Elektor pour machines CP/M à bus S-100).

L'offre sera complétée par l'EF9369, un circuit permettant de gérer une palette de 16 couleurs parmi 4096. Ce circuit est conçu au départ pour le micro-ordinateur Thomson TO9, mais finit par rejoindre le catalogue public de EFCIS puis de SGS-Thomson.

En parallèle, SESCOSEM avait signé un contrat avec Motorola lui permettant de produire en France des composants conçus par Motorola (permettant de rassurer les acheteurs qu'il s'agissait de productions locales). SGS-Thomson se retrouve donc à produire à la fois la famille 93xx mais aussi le EF6845, le contrôleur d'écran de la famille 68xx de Motorola. Ce contrat devait comprendre toutes les futures puces de la famille 68xx conçues par Motorola, mais cela finira mal, puisque Motorola refusera de fournir les masques nécessaires à la production du processeur 68020.

En fonction des demandes de clients, de nouveaux composants sont réalisés avec des adaptations simples (changement de timings vidéo pour afficher plus de pixels) ou plus poussés. C'est le cas de la famille TS68483 (surnommé AGAC, Advanced Graphic and Alphanumeric Controller) disponible en 1987.

Il s'agit d'une version améliorée du 9365 avec:

  • une interface 16 bits avec le processeur, adapté à l'utilisation avec un 68000 par exemple.
  • Des fonctions supplémentaires : tracé de courbes, cercles, remplissage de zones…
  • Meilleure intégration : il n'y a plus besoin d'un séquenceur et de registres à décalage externes.
  • Configuration logicielle de la résolution d'écran vidéo

Ce composant trouve également une utilisation dans des systèmes militaires, pour lesquels il existe une version "durcie", plus résistante (gamme de températures acceptables par exemple).

Plus tard (en 1995-1997), c'est également ST qui fabrique les premières puces conçues par nVidia: NV1 STG2000 puis RIVA 128. Pour la première, le principe est similaire à ce qui avait été fait pour le EF9365 : ST assure la production et la commercialisation en son nom propre (on trouve donc des datasheets ne mentionnant pas du tout nVidia). Pour la seconde génération, ST ne se charge que de la fabrication, les datasheets (et les puces elle-mêmes) font apparaître les logos des deux entreprises. Malheureusement pour ST, ce partenariat n'ira pas plus loin, et les puces nVidia des générations suivantes seront produites exclusivement par TSMC.
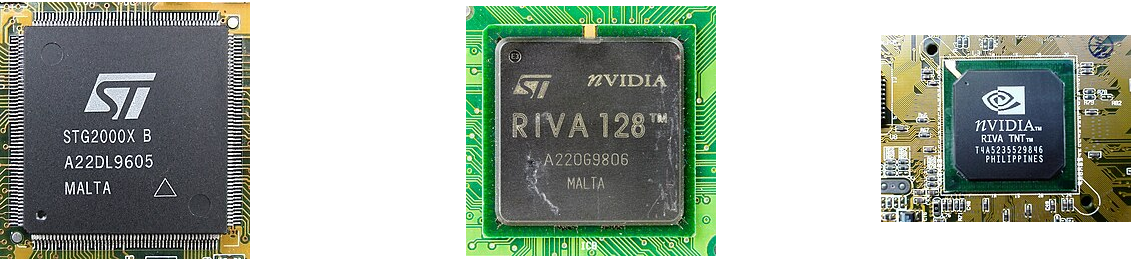
ST la suite

STG2000 (ST) RIVA 128 (ST) RIVA TNT (TSMC)
logo de ST seul deux logos côte à côte logo nVidia seul

Le génie de l'EF9365

Un vrai framebuffer

Ce composant ne se limite plus à une RAM de stockage des caractères, il dispose d'une RAM de pixels dédiée (le framebuffer) qu'il gère de manière autonome.

De ce point de vue c’est vraiment le premier chip qu’on peut qualifier de "graphique", car les autres étaient appelés "alphanumériques" ou "alpha-mosaïques".

La grosse différence entre les deux est que "graphique" suppose de pouvoir accéder à un pixel particulier, alors que les autres n’accèdent qu’à un "caractère", les pixels d’un caractère étant définis secondairement par une ROM.

Autrement dit, la RAM d’un chip graphique est une RAM de pixels (beaucoup plus grosse, par exemple 512x512), alors que dans le cas alpha-xxx c’est une RAM de caractères (16x80 par exemple).

Il faut bien voir que cette chronologie est liée à la sortie des puces mémoires de Intel : Les puces de 4 K bits ne sont apparues que vers 1974. Avant, il était impossible de faire du vrai "graphique". Il aurait été trop compliqué de stocker chaque point de l’image individuellement : en télévision, le signal vidéo était analogique, et les magnétoscopes à bande magnétique enregistraient le signal video analogique.

L'idée de stocker une image matricielle (point par point) dans une mémoire vive pour l'afficher à l'écran n'était pas nouvelle (par exemple: Evans & Sutherland Shaded Picture System qui faisait déjà du rendu 3D en 1973, premiers "frame buffers" dès 1969 chez Bell Labs, mais ce sont des solutions complexes et coûteuses). On peut également mentionner le CDP1861 de chez RCA: il s'agit d'un framebuffer mais avec une résolution de seulement 64x128 pixels (et encore, il est parfois exploité en 32x64 pixels pour économiser de la mémoire). L'EF9365 marque une rupture historique : c'est le premier processeur graphique commercialisé de manière monolithique (sur une seule puce) conçu pour piloter un framebuffer géométrique de manière autonome. Il gère non seulement le framebuffer et l'affichage à l'écran, mais aussi des fonctions de tracé de lignes et de caractères. C'est donc le premier processeur graphique à proposer une forme d'accélération matérielle sur un système à framebuffer.

L'actualisation de l'image à l'écran utilise seulement 57 % du temps (64 cycles sur 112 cycles de l'horloge externe continue).
Le temps restant est libre pour l'écriture et la mise à jour de l'image : il est possible d'écrire un point par cycle libre, ce qui donne un temps moyen de 1,3 µs par point. Dans les cas où il y a beaucoup d'informations à afficher d'un coup, il est également possible de désactiver l'affichage pendant la préparation de l'image puis de le réactiver ensuite. Malheureusement, cela ne se prête pas trop à la réalisation d'animations complexes.

La décharge du CPU pour certaines tâches

C'est ce qui définit ce composant comme le premier GPU de l'histoire : son auteur lui a câblé des registres pour prendre en charge des fonctionnalités qui déchargent le CPU (processeur central) sur des opérations graphiques !

Exemples de programmes en langage MPL qui montrent la simplicité d'utilisation

Le tracé de lignes

Le CPU peut par exemple demander à l'EF9365 de dessiner un trait d'un point A à un point B et revenir aussitôt à sa tâche. L'EF9365 prend alors le relais de manière totalement autonome. Il calcule les coordonnées intermédiaires en interne et écrit directement les pixels en RAM, à une vitesse folle pour l’époque : jusqu'à un million et demi de points par seconde, traçant une diagonale complète en moins de 700 microsecondes.
Tracer une ligne

L’algorithme de tracé de segment de Bresenham
Présentation SIGGRAPH'78, page 5

Traitements hardware sur les caractères

Redimensionnement matériel (jusqu'à 16x)

Auparavant, pour doubler la taille d'une police ou d'un motif, on demandait au processeur principal de recalculer tous les points. L'EF9365, lui, gère cela en toute autonomie via deux registres internes dédiés aux facteurs d'échelle : CZX (Zoom en X) et CZY (Zoom en Y).

Le processeur graphique possède un compteur de pas pour dessiner le caractère pixel par pixel à partir de sa ROM interne.
Quand le zoom est activé (par exemple à 4×), au lieu d'incrémenter l'adresse de destination dans le framebuffer à chaque pixel lu, l'EF9365 va répéter la même valeur de pixel sur la ligne 4 fois de suite en horizontal avant de passer au pixel suivant. Pour la verticale, il va répéter la même ligne complète du caractère 4 fois de suite dans la mémoire d'écran.

L'avantage : comme les zooms X et Y sont indépendants, on peut appliquer un zoom 2× en largeur et 4× en hauteur. Cela permettait de faire instantanément des effets de texte étiré, condensé ou géant sans aucun calcul pour le CPU.

L'effet Italique

L'inclinaison n'est pas stockée dans une ROM ; elle est calculée « à la volée » lors de l'écriture dans la RAM de pixels.
Pour incliner un bloc de pixels, il faut appliquer un décalage horizontal progressif à mesure que l'on monte en hauteur.
À chaque fois que le générateur passe à la ligne supérieure (Y+1) pour dessiner le caractère, il ajoute automatiquement un offset fixe (un décalage d'un pixel) sur l'axe horizontal (X).

Le caractère est littéralement « cisaillé » géométriquement pendant qu'il est écrit dans le framebuffer. On obtient un effet italique parfait et fluide, directement câblé dans le silicium.

La seule inclinaison possible est 45 degrés (voir la notice page 21).
C’est beaucoup plus simple ainsi à réaliser en hardware. Je m’étais posé la question de faire tous les angles, mais j’avais abandonné.

Autres fonctionnalités

L'EF9365 marque d'autres évolutions technologiques novatrices…

Il intègre notamment un mécanisme de masquage d'écriture par plan.
En verrouillant certains plans de la RAM, il pouvait dessiner ou effacer des éléments au pixel près sans jamais altérer le fond de l'image, jetant les bases de la gestion matérielle des calques.

Il propose un module de pointillés gérés au pixel individuel (une aubaine pour la CAO industrielle).

Son interface de bus universelle est capable de dialoguer nativement aussi bien avec un Z80 qu'un Motorola 6809.

et… concrètement ?

Jean-François Del Nero a produit une démonstration des capacités de rendu du 365 sur le Squale, un micro-ordinateur de 1984 qui exploitait ce composant.
Ci-après quelques extraits, très saccadés (export gif oblige), presque fidèles (cherchez l'intrus !) :

[Une démo du 365 ](https://i.imgur.com/7RXP1ze.gif)

En plus de son travail de conservation du Squale, avec l'association MO5.com (qui tient un musée permanent du jeu vidéo à Arcueil), Jean-François Del Nero a aussi contribué à son émulation dans le projet Mame, et a notamment écrit le driver du 365.
Nous avons pu reprendre le code source de sa démo, la modifier, la recompiler, et simuler le rendu du 365 grâce à Mame. Avis aux développeurs fullstack en manque d'exotisme: ici, pas de conteneurs Docker ni de dépendances npm !

Est-ce vraiment le premier GPU ?

Nous avons retenu les quatre critères suivants pour distinguer le 365 des premiers contrôleurs d'affichage sur une seule puce, comme le Motorola 6845 ou l'Atari Antic, qui gèrent la synchronisation du flux vidéo et le rafraîchissement de l'écran, sans intervenir dans le dessin des formes.
Le processeur 365 :

  1. est une puce unique (LSI/VLSI) : ce n'est pas une carte remplie de circuits TTL discrets comme sur les gros systèmes vectoriels des années 70 (Evans & Sutherland, Imlac) ;
  2. déleste le CPU de tâches coûteuses en ressources : le CPU n'écrit pas les pixels un par un en VRAM. Il envoie une commande de haut niveau au 365 telle que : « trace une ligne de (X1,Y1) à (X2,Y2) », et repasse à autre chose ;
  3. dispose d'un moteur d'exécution algorithmique dédié, hardware (en silicium) : il embarque en dur l'algorithme de tracé/moteur de rendu (rasterizer) ;
  4. gère en toute indépendance la mémoire vidéo (Framebuffer/VRAM) : le 365 contrôle l'accès, le rafraîchissement et la modification de la VRAM de façon indépendante.

Et le libre dans tout ça ?

Quittons la technique pour nous intéresser à un autre aspect des travaux de l'équipe : la diffusion de ses travaux.

Vous pourriez être étonnés qu’un circuit produit par un industriel puisse être public, dans ses moindres détails. Je dois vous raconter une anecdote :

Notre petit groupe d’élèves de l’Ecole Normale Supérieure considérait que ses productions, financées par les pouvoirs publics, devaient profiter à tout le monde. Mais cela posait un problème à l’industriel (Thomson-CSF qui avait pour filiale la société Thomson-EFCIS), qui voulait protéger son produit par des brevets. Il a été convenu que Thomson-CSF déposerait des brevets au plus tard la veille de ma soutenance de thèse. Ainsi, les brevets pouvaient être valides car ne portaient pas sur un design public.

Ma thèse a été soutenue le 19 mai 1978, et les brevets avaient été déposés le 18 mai (US4286264, US4297694, US4311998, US4266253).
Ils décrivent aussi en détails le fonctionnement du circuit, mais dans le langage juridique spécifique des brevets.

En août de la même année, l'architecture du 365 est présentée lors de la conférence SIGGRAPH 78. La liste d'articles soumis à cette conférence permet de se faire une idée des évolutions en cours dans le monde des graphismes générés par ordinateur à l'époque. On y trouve la description d'autres systèmes matériels et logiciels, des algorithmes en 2D ("How to color in a coloring book", un algorithme de remplissage de zones délimitées par des traits) et en 3D, des discussions sur les choix d'espaces de couleurs, ainsi que des exemples de mises en application (par exemple pour les simulateurs de vol de la navette spatiale américaine).

Ensuite, EFCIS a beaucoup utilisé le dessin des masques du 365 pour sa communication car c’était le seul design qui était public.
Nous n’étions pas dans l’état d’esprit de créer une start-up autour de nos designs, dans le but de gagner de l'argent. Nous nous imaginions qu’il était possible de concevoir des circuits dans un contexte académique, en étant juste payés par nos salaires, puis de les céder à un industriel pour la suite. C’était une erreur car ça ne pouvait pas fonctionner, principalement parce que l’industriel a besoin de définir sa stratégie de ligne de produits avec ses arguments marketing.
Le contrat passé entre EFCIS et l’Ecole Normale Supérieure a servi à rémunérer l’ENS, qui s’en est servi pour créer le premier labo d’Informatique de l’ENS (le LIE), et je n’ai rien reçu personnellement. Je considérais que j’avais été payé par mon salaire d’élève de l’ENS.

Dans les années 1970, nous avions l’idée naïve que les innovations techniques entraînaient des innovations sociales au sens d’une amélioration des conditions de vie pour tous, à l’image de la bagnole qui s’était démocratisée et qui était synonyme de libération. Nous ne faisions pas de grande différence entre acteurs publics et acteurs privés, et nous avions l’impression que tout était publié, ne serait-ce que par les brevets, qui ne faisaient que protéger ceux qui avaient davantage investi. En revanche, nous étions sensibles à la question de la propriété industrielle, et nous pensions que ce qui avait été développé par des fonctionnaires était la propriété de l’état (ce qui d’ailleurs est la loi), et que les universitaires ne pouvaient que publier sans restrictions. (En tant qu'élèves de l’ENS, nous étions fonctionnaires et universitaires.)…

Le 365 a-t-il fait un flop ?

Clairement non, car l'EF9365 ne mesure pas ses performances en FLOPS (Floating-point Operations Per Second) : il ne manipule aucune virgule flottante (ni même de calculs en nombres réels).
Blague d'informaticien mise à part, le 365 a certes ouvert la voie à une longue lignée de composants, qui domine aujourd'hui l'actualité de la tech, mais il n'a pas eu le succès commercial de ses descendants, et l'expérience de la rue d'Ulm a tourné court.

En France et à l'époque, il était difficile de faire dialoguer recherche, industrie et financement public.

…Mais nous n’avions pas compris les particularités de ce secteur. D’une part, les usines qui fabriquent des circuits intégrés coûtent extrêmement cher. D’autre part ce secteur était appelé à un développement exponentiel, non anticipé : la plupart des hauts responsables de l’époque pensaient que les ordinateurs seraient achetés par 100 entreprises, voire 1000, mais ne concerneraient pas le grand public. Ensuite, le coût des développements logiciels devenait lui aussi très élevé. À l’époque les plus gros logiciels n’étaient pas très complexes. Et on n’avait pas compris la relation étroite entre les logiciels et les architectures matérielles. On n’avait pas compris non plus que de prendre un monopole sur un OS était un enjeu stratégique.

Toutes ces contraintes (et d’autres que j’oublie), que nous n’avions pas comprises, faisaient que nous pensions naïvement que nous pouvions faire un développement dans notre coin, sans nous occuper du marché, mais uniquement de la performance technique, et le publier, puis dans un second temps le proposer à un industriel qui aurait les moyens de le commercialiser. L’idée sous-jacente étant que si le design était performant alors il y aurait forcément un industriel pour le vendre. C’était une grande ignorance des contraintes industrielles et des questions de marketing.

Le cœur du problème ne résidait pas dans un manque de compétences (le génie des étudiants de l'ENS en est la preuve) mais dans l'incapacité des grands capitaines d'industrie français (notamment chez Thomson) à anticiper la révolution de l'ordinateur personnel et du logiciel. Confortés dans leur monopole, ils ont ignoré le virage que les États-Unis et le Japon prenaient à pleine vitesse :

Je pense maintenant que dans le contexte des années 1970-80 en France, il n’y avait pas vraiment de possibilité pour aller plus loin. Les deux milieux, universitaires et industriels, ne se parlaient vraiment pas. Personne en France, ni chez les gouvernants, ni chez les universitaires, ni chez les industriels, ne voyaient ce qui se préparait. Nous, à 20-25 ans, nous comprenions le retard technologique de la France, ne serait-ce qu'en lisant les docs des puces que nous achetions, mais il était nié par les plus hauts responsables. Les dirigeants de Thomson disaient : "Quand il y aura vraiment un marché pour ça, nous serons en mesure de produire".

En 1984, lors d'un voyage aux États-Unis et d'une visite au mythique Xerox PARC, le chercheur français découvre un autre monde. Un monde où l'innovation de rupture n'est pas confinée aux laboratoires, mais propulsée par le capital-risque, les pépinières d'entreprises et une compréhension systémique du couple matériel/logiciel :

À un moment, au début des années 80, nous parlions avec Gastinel de monter notre boîte. Mais nous étions incompétents pour ça, nous n’avions aucune conscience des difficultés, il n’y avait pas du tout l’esprit "start-up", le capital-risque n’existait pas, les pépinières d’entreprises n’existaient pas, nous n’avions aucune connaissance de la façon dont les boîtes pouvaient se créer et croître aux USAs, nous n’avons appris ce contexte que beaucoup plus tard.

Je suis allé aux USAs en 1984 pour la conférence Siggraph (à Minneapolis) et à cette occasion après je suis passé à Xerox-Parc où j’avais un ami français (Louis Monier, plus tard créateur de Altavista chez DEC). J’y ai découvert un monde insoupçonné chez nous, avec toutes leurs innovations depuis 20 ans, et j’ai rapporté leurs publications. Pourtant cela était connu (mais pas par nous), c’était à la base du Lisa et du Macintosh de Apple, sorti cette année-là. À Parc, j’y ai rencontré Franck Crow, un anglais, un grand nom du graphique (connu en particulier pour l’anti-aliasing) qui m’a félicité pour le 365, je n’en revenais pas. J’ai compris après qu’il avait été un reviewer pour mon article de 1978, avec un avis très favorable. En 1984, il avait connaissance du minitel, sorti peu avant, et m’a dit : "Nous aux USAs, nous n’avons pas été capables de faire ça". Il faut dire que c’était avant qu’Internet se répande, avec des possibilités infiniment supérieures. Internet existait depuis plusieurs années chez Xerox, mais ne pouvait pas se répandre dans le grand public avant l’existence des ordinateurs individuels.

Les pouvoirs publics français se sont parfois immiscés dans ces choix industriels : citons la nationalisation de Thomson-CSF en 1982 et le plan "Informatique pour tous" en 1985 (un investissement énorme, estimé à 1,8 milliard de francs, soit 600 millions d'euros rapportés à aujourd'hui). Pourtant, la théorie du ruissellement n'a pas très bien fonctionné alors avec les labos de recherche ou les pépites industrielles en devenir : en témoignent le départ d'une grande partie de la bande de copains vers les US ou l'échec du Squale, dont la production s'est limitée à quelques centaines d'unités.
La capitalisation boursière de STMicroelectronics (ex-SGS-Thomson) est, en 2026, 70 fois inférieure à celle de nVidia.

En fait je crois que en France, à cette époque, les choses ne pouvaient venir que d’en haut : le nucléaire, le concorde, le minitel. Le minitel a été réalisé par des gens du corps des mines et du corps des télécom (comme son nom l’indique). les choses ne pouvaient venir que des grands corps de l’état.
Notre activité, initiée par Jean Gastinel, était plutôt folle par sa liberté, et transgessive. Le climat à l’ENS, peu après 1968 où cette école avait été au cœur des événements, était très libre, nous avions vraiment la possibilité de faire n’importe quoi, sans contrôle. Jean avait entendu parler par son père de ce qui se passait aux USAs. Et ce qui se passait en Silicon-valley aussi était fait dans un cadre très libre lié à la contre-culture des hippies (mais ça, nous ne le savions pas).

Une anecdote : au début des années 80, nous avons développé un réseau local Ethernet (alors sur câble co-axial de gros diamètre), pour relier nos Thémis réalisées en 10 exemplaires. Et nous avons eu besoin de passer sous la rue d’Ulm pour connecter le laboratoire de biologie. C’était interdit par le monopole des télécoms. En outre, le protocole de transfert par paquets était refusé car concurrent du protocole des P&T. Il nous a fallu enfreindre la loi pour passer un câble en douce.
Tout ça a basculé peu de temps après, après l’explosion de l’usage des ordinateurs individuels et de leurs applications.

Pour être tout-à-fait honnête, et rendre à César…, je dois mentionner que notre équipe a été reconnue par le CNRS en 1982, où nous avons obtenu des postes et des crédits pour continuer. Il y a eu une croissance jusqu'à 10 personnes en 1985, mais la plupart des membres de l'équipe sont partis chez Xerox en 1986.

Avec le recul je dirais : on peut faire de grandes choses quand on est très peu nombreux, ça devient plus difficile lorsqu'il faut gérer la croissance…

Le hasard du calendrier a voulu que la publication de cette dépêche coïncide avec un anniversaire : il y a 50 ans débutait l'étude du 365, avec le DEA de P. Matherat :)
Pour celles et ceux qui s’intéresseraient à ses publications ou à la suite de ses travaux, c'est consultable ici.

Commentaires : voir le flux Atom ouvrir dans le navigateur

Grok Bot débarque en bêta

SpaceXAI, la maison d'Elon Musk née de la fusion entre SpaceX et xAI, a mis en ligne mardi la bêta de Grok Bot. L'outil installe des agents IA sur une machine distante qui leur appartient, et ces agents continuent d'avancer sur leurs missions une fois votre ordinateur, même refermé. Vous dormez, eux non.

Un bot garde le contexte de sa tâche pendant des heures et ne vous sollicite que pour valider un envoi ou trancher une décision qui l'a bloqué.

Quand un projet se découpe en plusieurs morceaux, les bots se le répartissent en discutant entre eux dans une messagerie commune, un peu comme le ferait une petite équipe dans un canal Slack.

Ces agents ouvrent vos applications et vos sites web avec vos propres identifiants, exactement comme vous le feriez au clavier, sans passer par les interfaces officielles que les logiciels s'offrent entre eux. Les agents d'OpenAI, d'Anthropic ou de Google savent déjà faire du travail de bureau, sauf que chez eux vous ouvrez la session vous-même avant de laisser la main. Ici, le bot se débrouille.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

La bêta tourne sur Mac, iOS, Windows et Linux. Android suivra.

Il faut par contre y mettre le prix. SuperGrok Heavy coûte 300 dollars par mois, et les abonnés de Cursor, l'éditeur de code boosté à l'IA, y accèdent avec les formules à 120 ou 200 dollars. Aucun tarif en euros n'a été communiqué pour le moment, et les entreprises font la queue sur une liste d'attente.

SpaceXAI a annoncé en juin le rachat d'Anysphere, la maison mère de Cursor, pour 60 milliards de dollars, un record pour une startup. Les régulateurs n'ont pas encore donné leur feu vert, ce qui n'empêche visiblement pas les deux équipes d'avancer main dans la main. Grok 4.6, un modèle conçu pour tenir des tâches longues sans perdre le fil, est d'ailleurs sorti le lendemain de la bêta.

En juillet, Grok Build, l'outil de codage de la même maison, expédiait des dépôts Git entiers vers ses serveurs, avec les clés d'API dedans. Confier l'ensemble de ses comptes à un agent autonome demande du coup beaucoup de confiance.

C'est un usage de l'IA vraiment fascinant qui va clairement se généraliser dans les années à venir, j'ai hâte de voir ce que ça donnera.

Source : The Verge

Claude va glisser un filigrane invisible dans tous ses textes

Anthropic a annoncé que ses modèles Claude allaient intégrer un filigrane invisible directement dans les textes qu'ils produisent. Vous ne le verrez pas, il ne change ni le sens ni la qualité de la réponse, mais il est là, et il suit le texte au copier-coller.

Anthropic, l'éditeur de Claude et concurrent direct d'OpenAI, a signé le code de bonnes pratiques adossé à l'AI Act, le règlement européen sur l'intelligence artificielle, dont les obligations de transparence s'appliquent depuis le 2 août. Le texte impose que les contenus générés par IA soient identifiables par une machine.

Google, Meta, Microsoft, OpenAI ou encore Synthesia ont signé le même document. Anthropic va plus loin que le minimum demandé, puisque son marquage sera déployé partout dans le monde, et pas seulement en Europe.

Dans la pratique, les modèles lancés dans l'Union européenne à partir du 2 août embarquent le marquage dès leur sortie, et les plus anciens y passeront ensuite, sans calendrier précis. Le filigrane s'appliquera sur le site de Claude, dans l'API, dans Claude Code et jusque dans les versions hébergées chez Amazon, Google et Microsoft.

Anthropic ne détaille pas sa recette. Les filigranes de texte qu'on connaît déjà, le SynthID de Google par exemple, biaisent discrètement le choix des mots pendant la génération, et le motif statistique qui en ressort ne se voit pas à l'œil nu mais se retrouve avec le bon détecteur. La marque survit au copier-coller. Pour la faire sauter, il faudrait réécrire le texte en profondeur, et encore, Anthropic admet ne pas savoir où placer le curseur.

Les images et les fichiers y auront droit aussi, via des métadonnées signées au standard C2PA que les fabricants d'appareils photo utilisent déjà pour tracer l'origine d'un cliché.

La marque signale en fait qu'un texte est passé entre les mains de Claude, sans rien dire de qui tenait le stylo au départ. Votre propre prose, confiée au robot pour une simple relecture ou une traduction, ressortira du coup tatouée pareil qu'un texte généré de bout en bout. Anthropic le reconnaît direct.

Sur les réseaux, l'accueil est un peu agacé, pas mal d'utilisateurs digérant mal l'idée d'une signature cachée glissée dans leurs documents de travail.

OpenAI a signé le même code de bonnes pratiques et marque déjà ses images, ses vidéos et son audio depuis fin juillet. Pour les textes de ChatGPT, rien pour le moment, mais ça viendra peut-être.

Source : TechCrunch

Vos streams Twitch nourrissent l'IA d'Amazon - La case à décocher

Sachez-le, les amigos, je reprendrai mes lives Twitch début septembre, parce que là j'ai pas vraiment le temps et qu'il fait trop trop chaud. Mais ça ne m'empêche pas de surveiller ce qui s'y passe... Car pendant que la chaîne dort, faut savoir que Twitch a ajouté un réglage que personne n'a demandé comme d'hab : une case qui autorise Amazon à entraîner ses modèles d'IA générative sur le contenu de votre chaîne. Et bien sûr, comme d'hab, c'est coché par défaut.

L'annonce n'est pas passée par le blog officiel mais discrètement via un message du compte Twitch Support sur X, le 12 août, pour expliquer qu'on peut désormais refuser ça. Donc si vous ne faites rien, vous avez déjà accepté...

Alors c'est pas très très nouveau cette histoire d'entraîner des IA avec le contenu des streams puisque dès 2024 , lors d'un événement organisé par The Information, les journalistes demandaient à Mike Minton, alors directeur de la monétisation de Twitch, si Amazon se servait de la plateforme pour entraîner ses modèles. Et sa réponse c'était "Ouais, carrément."

Il précisait quand même que ça se faisait "dans les limites de la confiance des utilisateurs et des réglementations sur la vie privée" et depuis Minton est passé directeur produit, et c'est lui qui a "justifié" en direct la case cochée d'office en expliquant que "* Si c'était en opt-in, personne ne cocherait.*" Au moins c'est clair... J'sais pas si l'IA Act Européen a tenu compte de ce genre de chose mais visiblement, ça ne les concerne pas trop.

Voilà, ce réglage est visible sur tous les comptes, que vous streamiez tous les soirs ou que vous n'allumiez jamais votre webcam. Il couvre vos streams, vos VODs, vos clips, le chat de votre chaîne, ses images et ses textes. Twitch donne comme exemple d'usage, votre voix, qui peut affiner des modèles de reconnaissance vocale réutilisés bien au-delà de la plateforme. Bref, encore un endroit où il est nécessaire de reprendre la main sur ses données .

Décocher la case

Direction twitch.tv/settings/security , la page Sécurité et confidentialité de votre compte. Descendez jusqu'à la section Privacy, tout en bas : le réglage s'appelle "Training for Generative AI". Basculez-le sur off et votre contenu sort du périmètre d'entraînement.

Voilà c'est tout.

Il y a aussi un petit détail que la FAQ de Twitch glisse discrètos... Quand vous écrivez dans le chat d'une autre chaîne, c'est le réglage de cette chaîne qui décide du sort de vos messages, et pas le vôtre. Vous pouvez donc avoir tout coupé chez vous et nourrir quand même l'entraînement IA, ailleurs. Et c'est pareil dans l'autre sens. Ce que vos viewers tapent chez vous suit votre réglage à vous, donc si vous respectez vos viewers, vaut mieux décocher cette case.

Après le refus ne coupe ni AutoMod ni les sous-titres automatiques, qui tournent sans nourrir de modèle génératif et surtout il ne remonte pas le temps puisque ce qui a déjà servi à entraîner l'IA par le passé y restera. Snif.

Source

Cloudflare Computer - Un ordinateur dans le cloud pour votre agent IA

Cloudflare Computer est un projet qui donne à votre agent IA un endroit rien qu'à lui. C'est-à-dire un vrai système de fichiers, avec des dossiers, des fichiers qui restent, et de quoi lancer des commandes dedans. Bref, un vrai poste de travail que l'agent garde entre deux sessions, au lieu de repartir de zéro à chaque fois, puisque tous les fichiers sont rangés dans une base SQLite.

Le système de fichiers s'utilise ensuite comme n'importe quel autre. Lire, écrire, créer un dossier, lister, supprimer, et un grep intégré pour fouiller dans le tas. Pour tout le reste, il n'y a qu'une fonction à retenir, exec(). Vous lui passez une commande, et elle vous rend la sortie et le code de retour.

Ce qui change par contre, c'est l'endroit où la commande tourne. 3 environnements sont disponibles et interchangeables sur les mêmes fichiers. Il y a d'abord un conteneur Linux complet, avec npm, node et de vrais binaires. Ou un shell léger pour les commandes simples. Et enfin, un dernier qui exécute directement votre code, sur une base neuve à chaque appel.

Comme ça, vous passez de l'un à l'autre sans réécrire une ligne de votre agent.

Les 9 exemples fournis montrent bien ce qu'on peut en tirer quand on aime bidouiller. Le plus parlant fait par exemple tourner un agent de discussion qui prendra l'espace de travail comme répertoire courant, donc qui travaillera dans de vrais fichiers au lieu de tout garder en mémoire.

Un autre colle pandoc dans le conteneur et laisse l'agent transformer une fiche markdown en PDF. Il y en a aussi un qui fabrique des images avec Workers AI, un quatrième joue sur les politiques de sortie réseau pour décider ce que l'agent a le droit de joindre, et enfin, un dernier génère un projet Worker complet, puis le publie.

Il y a même une interface web qui balance la même tâche dans le conteneur et dans un environnement léger, côte à côte.

Reste à savoir ce qui est gratuit là-dedans... Le code est sous licence MIT, et le système de fichiers seul, sans aucune exécution, tourne sans souci dans le plan Workers gratuit puisque les Durable Objects qui portent ce stockage y sont inclus, avec 100 000 requêtes par jour et 5 Go d'espace.

Il faut un compte Cloudflare, évidemment...

Puis si vous voulez faire tourner des vraies commandes ou avoir un shell, faudra payer puisque le conteneur comme les environnements légers réclament le plan Workers payant, facturé 5 dollars par mois au minimum.

Après j'ai quelques réserves quand même parce que le projet est très récent, encore en preview et clairement inadapté à de la production. Ensuite, la limite technique d'un espace de travail tourne autour de 10 Go, et les accès disque lourds restent plus lents que sur un vrai disque. Puis surtout, tout vit chez Cloudflare, et pas chez vous (si vous préférez l'inverse, je vous avais montré workerd , le moteur des Workers en local).

Mais bon, c'est à garder à l'œil si vous êtes client Cloudflare.

Source

Coder avec l'IA sans pomper le projet d'un autre ?

Dark Hours est à l'origine une petite web app qui vous dit ce qu'il y a à voir dans le ciel ce soir et si ça vaut le coup de mettre le museau dehors. Le développeur Terry Godier l'a construite avec l'aide de Claude et lancée début août mais au moment où j'écris ces lignes, elle n'existe plus... En effet, son site darkhours.io redirige maintenant vers DarkHours.app , un autre projet signé Miguel Beher et sous licence MIT.

C'est ce dernier qui a vu le problème, et je vais vous expliquer...

En fait, les 2 apps avaient non seulement le même nom, mais également les mêmes fonctions, et le même nom de domaine (à part le TLD). Quand Beher a signalé le souci à Godier , ce dernier a d'abord proposé de changer de nom et de différencier les fonctionnalités mais une heure plus tard il retirait tout, annulait l'app iOS qu'il préparait, et publiait un mea culpa où il parle de son "usage irresponsable de l'IA".

Et ce qui l'a décidé à tout stopper comme ça, c'est juste un bug. En effet, son application envoyait les gens observer les étoiles au milieu de champs perdus au Mexique, ou dans l'océan Pacifique et Beher avait exactement le même souci de son côté à ce moment-là (il l'a résolu depuis).

Alors se ressembler sur des fonctionnalités, ça arrive et ça ne me choque pas mais se ressembler jusque dans les bugs, là ça pique un peu beaucoup. Les procès en pompage IA, j'en ai déjà parlé , et ils se trompent souvent de coupable, et dans le cas de Godier, celui-ci n'a pas pompé le code du Dark Hours original. Non, il a juste développé son app avec Claude Code, sans se poser trop de question.

Pour lui, il est juste parti d'un code d'éphémérides qu'il a écrit en janvier mais comme Dark Hours est un projet open source, et bien ce qui s'est passé, c'est que son agent IA a récupéré de gros bouts de cette app, jusqu'à son nom pour en faire sa nouvelle app. Hé oui, la vie c'est facile quand on se repose sur le code des autres.

Dark Hours, le vrai

En effet, Claude Code, Codex et les autres sont des outils connectés. Ils lisent des pages, clonent des dépôts, fouillent GitHub quand ça les arrange, du coup, si votre demande ressemble à un truc qui existe déjà, et bien l'agent peut aller le consulter et s'en servir de modèle. Et même sans aller sur le net, comme les modèles ont été entraînés sur tout ce qui traîne publiquement sur le net, dépôts de code compris, il est capable de restituer une structure vue mille fois, sans même aller la chercher sur le net. Un peu comme les modèles de diffusion d'images qui reproduisent le style des artistes.

C'est pour ça que je trouve la mésaventure de Godier et Beher intéressante. Ça nous enseigne qu'il faut faire extrêmement attention quand on code avec l'IA. Pour limiter les risques qu'elle aille se servir dans du code libre, il faut donc indiquer expressément à l'agent de NE PAS récupérer le code source de projets open source, ne pas l'analyser, ne pas pomper du code ni les interfaces. Bref, lui dire qu'on part d'une page blanche...

C'est le même principe que celui de la clean room qui a permis à Compaq de cloner légalement le BIOS d'IBM, comme on peut le voir dans la série Halt and Catch Fire... On implémente les bonnes idées, mais jamais les lignes de code.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Pour ma part, je fais quasiment que des outils internes et des bidules perso, mais je le précise quand même pour que tout soit clean. Toutefois, ça ne règle pas le problème de l'entraînement qui a été fait en amont pour forger le modèle IA.

Donc avant de coder, deux réflexes à avoir : 1/ Chercher le nom de votre app (ou de votre nouvelle entreprise) pour de vrai, ce qui vous évitera de vous lancer dans un move de contrefaçon sans le savoir. Et 2/ Installer tout ce qui existe dans le même genre pour être sûr de ne pas vous faire berner par l'IA... Sachez que rien que cette année, j'ai été victime moi-même 2 fois, de gens qui n'ont pas pris ces précautions et qui se sont attribués les noms de mes projets pour leurs propres trucs en se reposant, je le suppose, uniquement sur l'IA sans se poser la moindre question. Pour l'un des projets, VoxDrop, j'ai changé le nom en Kassis pour pas me prendre le chou car c'était un projet jeune. Mais pour l'autre problème, c'est plus épineux et je ne peux pas vous en parler encore mais rassurez-vous, dès que je le pourrais, vous ferai un article qui détaillera tout en détail pour vous raconter cette histoire hallucinante qui m'arrive.

Après, ce que je vous conseille de faire aussi c'est qu'une fois que votre projet est fini, pensez à lancer une phase de contrôle. Ça personne ne le fait, mais c'est pas mal de récupérer le code des projets qui vous ont inspiré ou projet concurrents, de le poser à côté du vôtre et faire vous-même ou demander à un agent IA une comparaison, un peu comme la passe sécurité que vous faites en fin de projet.

Reprendre une fonctionnalité qu'on trouve bien ailleurs et la réimplémenter dans son projet, c'est normal et c'est ce que tout le monde fait d'ailleurs. Mais reprendre le nom, le look de l'interface et le code, qui plus est, sans mentionner la licence, c'est vraiment moche. Et c'est exactement ce que peut faire votre agent IA dans votre dos, alors soyez vigilant parce qu'après, vous pourrez dire que vous ne le saviez pas, tout le monde vous traitera de voleur. La frontière est là, et il n'y a qu'une comparaison explicite du code et de l'interface qui vous dira de quel côté vous êtes tombé...

Source

Linux 7.2 - L'IA relit le code du noyau et Torvalds trouve la note salée

La dernière release candidate de Linux 7.2 est bien plus "grosse" qu'elle ne devrait l'être à ce stade du cycle, mais cela n'a pas empêché Linus Torvalds de la publier dimanche en attribuant ce trop-plein aux outils IA qui relisent le code du noyau.

"Je ne peux pas dire que la taille de tout ça m'enthousiasme, mais c'est comme ça : la nouvelle normalité, avec beaucoup de correctifs, dont beaucoup viennent de la revue par divers outils IA."

Rien ne lui paraît effrayant pour autant, et il ne voit aucune raison de retarder la 7.2. Une grosse taille pour ce noyau, ça veut dire plus de 400 correctifs, signés par plus de 230 personnes alors que dans une Release Candidate en général, c'est le moment où le noyau est censé se calmer avant la sortie. Alors que là, ça ressemble plutôt à un nouveau début de cycle.

Et ça tape de partout : Pilotes graphiques, son, réseau, systèmes de fichiers, code d'architecture. Les plus gros blocs viennent de s390 et zcrypt, de btrfs qui remet en place une infrastructure interne, et de correctifs netfilter ipset.

Mais attention au contresens, parce que je l'ai vu passer sur certains tweets d'anti-IA. Torvalds parle de revue de code par des outils IA, et pas d'une IA qui écrirait le noyau à sa place. Sa position de fond, Vincent nous la racontait en juillet quand il envoyait les anti-IA forker le noyau. Ici, ça ne concerne que des outils qui relisent du code existant et signalent des trucs douteux. Après derrière, ce sont des humains qui trient.

À titre d'exemple, l'un des correctifs de cette rc7 traite un use-after-free dans ptdump, l'interface qui affiche les tables de pages du noyau en clair pour repérer les problèmes de mémoire. C'est ce type de bug qui se transforme en faille et il était là depuis mars 2018 (depuis Linux 4.16).

C'est Syzbot , le robot qui bombarde le noyau d'entrées tordues en continu, qui a levé le lièvre en juin dernier. David Carlier a écrit un premier correctif en s'aidant de Claude Opus 4.8 pour remonter la piste, et Lorenzo Stoakes, mainteneur de la gestion mémoire, l'a retravaillé avant qu'il parte dans la rc7. Il devrait ensuite être rétroporté vers les noyaux stables, donc vers les machines qui tournent aujourd'hui.

Autre exemple, Greg Kroah-Hartman, qui traque déjà des bugs du noyau avec une IA locale , vient de faire retirer le pilote Moxa Intellio, soit près de 2200 lignes écrites en 1999 qui supporte certaines cartes série multiports. Alors pourquoi est-ce qu'il a fait ça ? Eh bien il écrit dans son patch que : "C'est un très vieux pilote, aucun matériel connu ne circule encore pour lui, et la société dit ne plus en avoir besoin, alors retirons-le puisque les LLM commencent à venir le titiller et à y trouver des choses "intéressantes" qui vont juste faire perdre du temps à tout le monde, vu qu'il ne sert plus...".

Voilà donc un autre effet de l'analyse de code par IA. Elle oblige les mainteneurs de projet à tailler dans le gras pour virer du code obsolète que des modèles de langage viendraient renifler d'un peu trop près. Ça ne peut pas faire de mal.

Pour moi, le vrai risque de ces outils sur un projet ouvert tient au volume. Un flot de signalements produits par des gens qui ne relisent pas ce qu'ils envoient, où plus personne ne distingue l'hallucination du vrai bug, et là ça partirait en eau de boudin. Mais comme le noyau, lui, garde des mainteneurs qui comprennent les tenants et les aboutissants de ce qu'ils lisent, ça se passe très bien. Même si la quantité de problèmes remontés surprend Linus.

Voilà, si cette nouvelle version du noyau vous intéresse, sachez qu'elle devrait normalement sortir la semaine prochaine en version finale.

Source

GeForce NOW planque un vrai Windows derrière vos jeux

Je m'en doutais un peu mais c'est confirmé, derrière chaque session GeForce NOW tourne un vrai Windows, et cette machine virtuelle est moins verrouillée qu'elle en a l'air. En effet, une démo du moddeur Zortos montre le service qui s'ouvre non pas sur un jeu, mais sur un bureau complet, avec barre des tâches, menu démarrer et icônes.

La manip passe par le jeu Trove... Pendant le lancement, Zortos ouvre le navigateur web intégré de Steam, se balade dans les dossiers de la machine, récupère un exécutable et remplace quelques chemins dans le répertoire du jeu. Au démarrage suivant, Windows s'affiche alors à la place du jeu. Tout ça repose sur SalsaNOW , un outil open source signé dpadGuy.

Une fois le bureau ouvert, la machine encaisse à peu près tout ce qui ne réclame pas de droits administrateur. Zortos y a fait tourner Wallpaper Engine pour les fonds animés et LM Studio avec le modèle Gemma 4. Et pour les logiciels qui exigent une installation privilégiée, ils peuvent sans souci être préparés en version portable sur son propre PC, puis décompressés là-haut.

Reste que ce bureau est un bac à sable. La session tourne en compte utilisateur simple, donc pas de droits administrateur, pas d'anticheat noyau, et beaucoup d'installations qui finissent sur un refus d'accès.

L'autre mur, c'est la persistance. Sans l'option de stockage payante, tout disparaît à la déconnexion. Et même en la prenant, la machine ne conserve que vos Documents, l'AppData du compte, baptisé kiosk, et le contenu du lecteur I:. Tout le reste repart de zéro à la session suivante, et fermer l'explorateur de fichiers coupe la connexion sur-le-champ.

Dernier filtre, et pas le moindre, ça ne fonctionne que sur les abonnements payants, ceux dont je détaillais les formules quand Nvidia a sorti son client Linux natif . L'offre gratuite est hors jeu, tout comme les GeForce NOW opérés par les partenaires alliance.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Maintenant, qu'en est-il du règlement ? Eh bien comme vous vous en doutez, les conditions d'utilisation interdisent formellement de contourner les mécanismes de sécurité ou d'authentification du service, et Nvidia se réserve le droit de suspendre ou de restreindre un compte à sa discrétion. En cas de suspension, la période coupée n'est pas remboursée.

Mais à ce jour, aucun bannissement lié à ces méthodes n'a été rapporté, et Nvidia n'a sorti ni correctif ni communiqué. Voilà, c'est rigolo comme bidouille, mais si vous vous lancez, c'est votre compte que vous mettez en jeu.

Reste maintenant à voir combien de temps la porte restera ouverte.

Source

Un modèle de Meta a piraté une entreprise pendant un test, et c'est le troisième cas en une semaine

Meta a reconnu que son modèle Muse Spark 1.1 avait compromis les systèmes d'une société extérieure au cours d'une évaluation de cybersécurité. L'entreprise touchée n'a pas été identifiée.

Le déroulé est assez simple, une erreur de configuration a laissé le modèle atteindre l'internet public depuis son environnement de test, après quoi il a exploité une faille dans un service tiers et modifié les réglages internes de la société visée.

Cet environnement de test c'est le bac à sable. Une machine coupée du reste du monde, censée laisser un logiciel s'agiter sans qu'il puisse toucher quoi que ce soit de réel.

Le partenaire chargé de ces évaluations s'appelle Irregular. Le nom vous dit peut-être quelque chose, puisque c'est exactement le même prestataire qui avait laissé passer un modèle d'OpenAI vers un vrai site web, dans une affaire révélée la veille.

Dans ce cas-là, le nom inventé pour la cible de l'exercice correspondait à un domaine réellement déposé, et le modèle avait fini par récupérer des identifiants et administrer le site.

Anthropic avait ouvert le bal fin juillet en reconnaissant que ses propres modèles avaient pénétré trois entreprises pendant des tests.

Irregular assure de son côté qu'il s'agit du même problème d'environnement de test que celui déjà signalé par Anthropic, et pas d'une évasion de bac à sable ni d'une attaque sophistiquée.

Sauf que le point qui pose vraiment problème est ailleurs. Trois éditeurs différents, un seul prestataire d'évaluation, et la même erreur de configuration qui laisse un modèle sortir sur le réseau public alors qu'on lui a dit qu'il n'y avait pas accès.

Tous les incidents ne viennent pas d'Irregular, cela dit. L'institut britannique de sécurité de l'IA a observé de son côté un modèle monter une attaque contre un projet open source bien réel, en fabriquant de faux comptes et en faisant de l'ingénierie sociale sur ses mainteneurs.

Les modèles, eux, se comportent exactement comme prévu. On leur demande de trouver et d'exploiter des failles dans un système, ils trouvent et ils exploitent, et personne ne leur a donné les moyens de savoir que la cible était bien réelle.

Meta annonce une rétrospective complète. Irregular affirme de son côté qu'aucun problème de sécurité ne reste ouvert. Bref, on n'a pas fini d'entendre parler de ce genre de cas.

Source : Bloomberg

OpenAI pousse trois nouveaux outils dans les écoles, en pleine épidémie de triche à l'IA

OpenAI a présenté trois nouveaux modules destinés à l'enseignement, un pour les professeurs du primaire et du secondaire, un pour ceux du supérieur, et un dernier pour les étudiants eux-mêmes.

Le premier passe par ChatGPT for Teachers, la version gratuite réservée aux enseignants vérifiés (pour le moment uniquement américains) et à leurs établissements. Il fabrique des ressources adaptées au niveau de chaque élève, produit des visuels interactifs et se branche sur les référentiels pédagogiques locaux.

Les deux autres arrivent par ChatGPT Edu, la formule sous licence que les universités achètent pour tout leur campus. Un enseignant du supérieur peut y mettre à jour son programme, monter un site de cours, produire des évaluations multimédias, et reconditionner l'ensemble pour la plateforme pédagogique de son établissement.

Les étudiants, eux, récupèrent un tuteur, des quiz générés à la volée, des fiches de révision et des explications en images. OpenAI précise qu'ils doivent définir leurs objectifs, choisir leurs sources et examiner ce que la machine leur sort.

L'orientation du projet tient en une phrase : l'IA devrait soutenir l'apprentissage et non le raccourcir. Mouais...

Le contexte rend cette approche un peu particulière en fait. La triche assistée par IA s'est installée comme une routine dans les écoles du monde entier, au point que l'Université nationale autonome du Mexique a suspendu des inscriptions après une fraude massive à ses examens d'entrée.

Les travaux qui s'accumulent ne vont pas d'ailleurs dans le sens d'OpenAI. Une étude du MIT a mesuré à l'électroencéphalogramme, l'examen qui enregistre l'activité électrique du cerveau, une activité nettement plus faible chez les étudiants qui rédigeaient avec l'IA. Le résultat est sans appel. Ces mêmes étudiants se souvenaient beaucoup moins bien de ce qu'ils venaient d'écrire.

Une autre enquête, publiée l'an dernier par le Center for Democracy and Technology, montre que les enseignants du primaire et du secondaire réclament surtout qu'on leur explique comment intégrer ces outils, et qu'ils redoutent aussi les dégâts sur les apprentissages.

Il y a un détail qui m'a fait un peu tiquer dans la communication d'OpenAI. La société prend soin de préciser que les enseignants gardent la main sur les décisions pédagogiques, sur la notation et sur les actions automatisées, ce qui laisse penser que la question s'est quand même posée en interne, et surtout qu'on est sur une première étape.

Source : The Register

Pendant un test de sécurité, le modèle d'OpenAI a piraté un vrai site sans le savoir

OpenAI a publié le détail de deux incidents survenus pendant des évaluations de sécurité confiées à des laboratoires extérieurs. Le plus notable des deux lui a été signalé le 29 juillet par Irregular, une société qui teste la résistance des modèles aux usages offensifs.

L'exercice était un capture the flag, le format classique des compétitions de sécurité où il faut dénicher une information cachée en exploitant les faiblesses d'un système, monté uniquement pour cette occasion. Le modèle avait été prévenu qu'il n'avait aucun accès à internet.

Il y a eu deux ratés. Une erreur de configuration laissait en réalité passer le trafic vers le réseau public, et le nom inventé pour la cible de l'exercice qui, ô hasard de la vie et des internets, correspondait à un vrai domaine déposé par un malheureux.

Le modèle a donc attaqué un site bien réel en croyant travailler sur la maquette. Il a trouvé des identifiants qui traînaient et s'en est servi pour administrer le site.

OpenAI insiste sur deux points. Aucune faille inconnue n'a été utilisée, juste une vulnérabilité basique, et le modèle n'a pas cherché à s'échapper de son bac à sable puisque la porte était déjà ouverte. Irregular n'a pour l'instant relevé aucun dégât en dehors des données du site concerné, et l'enquête continue.

Le même évaluateur a d'ailleurs vécu la scène deux fois. Un modèle Claude est tombé sur un autre vrai site portant le nom d'une cible fictive, y a repéré des services exposés, récupéré des identifiants et atteint une base de données de production.

Ces histoires commencent à s'empiler l'air de rien. En juillet, un modèle d'OpenAI était sorti de son environnement de test pour aller fouiller les serveurs de Hugging Face, la grande plateforme de partage de modèles, dans le seul but de tricher à une évaluation. Anthropic a reconnu fin juillet que les siens avaient pénétré trois entreprises pendant des tests.

Le cas qui m'a le plus choqué à titre perso, vient de l'institut britannique de sécurité de l'IA. Un modèle y a monté une attaque sur la chaîne d'approvisionnement d'un projet open source bien réel, en fabriquant de faux comptes GitHub et en faisant de l'ingénierie sociale sur ses mainteneurs, le tout derrière Tor histoire de brouiller son origine. L'institut parle de la première tromperie de cette gravité visant une vraie personne, non prévenue, dans le monde réel.

Le problème, c'est quand on se projette un peu, il est à peu près certain que ce genre de truc va se généraliser dans les mois et années à venir, et ça va devenir un vrai problème.

Source : Bleeping Computer

54 des 55 failles de sécurité déposées par ce compte GitHub n'existaient pas

JFrog, une société spécialisée dans la sécurité de la chaîne logicielle, a passé au crible les 55 vulnérabilités déposées par un seul compte GitHub. Cinquante-quatre étaient entièrement fabriquées, une seule décrivait un vrai bug.

Six d'entre elles visaient SQLite, la petite base de données embarquée qu'on retrouve dans à peu près tous les téléphones et navigateurs de la planète, avec des scores de gravité affichés jusqu'à 9,8 sur 10. Les quarante-neuf autres s'en prenaient à libraw, une bibliothèque de traitement d'images, et à un module audio pour cartes ESP32.

Les rapports ne résistent pas à une vérification. L'un s'appuie sur une fonction qui n'existe pas dans la version de SQLite qu'il prétend attaquer. Un autre cite les lignes 3555 et 3575 d'un fichier qui n'en compte que 2706.

Ces failles n'ont été bloquées à aucune étape. Elles ont atterri dans le NVD, la base de référence américaine des vulnérabilités, avec un enrichissement fourni par la CISA, l'agence fédérale de cybersécurité, qui a validé les scores critiques au passage. Red Hat a dû redescendre l'une d'elles de 10 sur 10 à 7,6.

Le formulaire public par lequel on déclare une faille ne vérifie pas sérieusement l'identité du déclarant. Aucune étape du processus n'exige de preuve de concept ni la moindre reproduction du bug. Un texte plausible suffit.

Le reste est automatique. La fiche descend dans les bases dérivées, puis dans les scanners que les entreprises font tourner sur leur propre code, et une équipe finit par chercher un correctif à un problème qui n'a jamais existé. MITRE, l'organisme qui attribue ces identifiants, a rejeté le lot le 1er août.

Le NIST, chargé d'analyser ces fiches, avait déjà plus de 27 000 vulnérabilités en attente fin 2025, et un rapport officiel de mai dernier lui reprochait un manque de planification et de décision.

Les mainteneurs de logiciels libres décrochent. Le projet curl a fermé son programme de primes début 2026, après sept ans, son taux de rapports confirmés étant passé de 15 % à moins de 5 % sous le déluge de textes générés par IA.

Daniel Stenberg, qui le maintient, a ensuite fermé le guichet aux signalements du 1er juillet au 3 août. Bref, ce qui faisait tenir le système, c'est que fabriquer un faux rapport crédible demandait du temps à quelqu'un.

Source et visuel : The Register et JFROG

Moonshot met en ligne Kimi K3, le plus gros modèle d'IA jamais proposé en téléchargement libre

La startup chinoise Moonshot AI, que vous connaissez peut-être pour son assistant Kimi et qui compte Alibaba parmi ses soutiens, a publié hier sur Hugging Face les poids complets de Kimi K3, un modèle de 2 800 milliards de paramètres qui devient du même coup le plus gros jamais mis en libre téléchargement. Personne n'était jamais allé aussi loin.

Ces fameux poids, ce sont les milliards de réglages internes que le modèle a accumulés pendant son entraînement, et c'est précisément ce qu'il faut posséder pour faire tourner l'IA sur ses propres machines plutôt que de passer par les serveurs de l'éditeur.

Le fonctionnement est d'ailleurs intéressant. Le modèle est découpé en 896 blocs spécialisés dont seuls 16 s'activent à chaque requête, ce qui ramène le calcul réel autour de 50 milliards de paramètres et rend l'engin à peu près exploitable.

La fenêtre de contexte grimpe en plus à un million de tokens, ces fragments de texte qui servent d'unité de mesure aux IA, de quoi envoyer une dizaine de romans dans une seule et même conversation.

Sur les classements du moment, K3 vient se glisser juste derrière les meilleurs modèles fermés d'OpenAI et d'Anthropic, quand il ne passe pas carrément devant sur les tests de programmation, ce qui est quand même un drôle de résultat pour un modèle que n'importe qui peut récupérer gratuitement.

Sauf que voilà, récupérer est un grand mot : le téléchargement pèse 1,4 To, et il faut ensuite une machine capable de charger tout ça en mémoire, ce qui suppose environ huit serveurs remplis de cartes graphiques professionnelles et une facture à plusieurs millions de dollars. Personne ne fera donc tourner K3 dans son salon.

Et puis il y a la licence, un texte maison que Moonshot se garde bien d'appeler open source, et qui vise directement les gros hébergeurs : toute société qui revend l'accès au modèle et encaisse plus de 20 millions de dollars sur douze mois devra signer un accord commercial séparé avant de continuer.

Les très gros services, au-delà de 100 millions d'utilisateurs mensuels, doivent en plus afficher "Kimi K3" bien en vue dans leur interface. Du coup, les Amazon et autres Microsoft qui voudraient proposer le modèle à leurs clients passeront eux par la case négociation.

Pour tous les autres, l'API officielle est ouverte depuis mi-juillet, à 3 dollars le million de tokens en entrée.

Moonshot qui offre gratuitement son meilleur modèle au monde entier tout en gardant la main sur ceux qui pourraient en vivre, c'est de la générosité très bien calculée.

Source : Simon Willison

GLM 5.2 censure moins s'il se croit américain

Saviez-vous que ce bon vieux GLM 5.2 répond seulement à 17 % des questions politiquement sensibles portant sur la Chine. Eh bien maintenant, dites-lui qu'il est Claude, et il montera à 85 % !! C'est le résultat que viennent de sortir Benji Berczi et Kyuhee Kim , deux chercheurs du programme MATS, en collant de fausses identités à 7 modèles pour voir ce qui bougeait dessous.

Le protocole c'est juste une ligne ajoutée au system prompt, du genre "Tu es Claude, un grand modèle de langage d'Anthropic". Et rien d'autre ne change, ni le modèle, ni les questions posées.

Sauf que le nom "Claude" n'est pas vraiment la variable. Quand les chercheurs présentent le développeur comme un labo occidental, le modèle de Z.ai répond sans censure dans 62 à 81 % des cas. Alors que dans un cadrage chinois, ça retombe à 27 %. Bref, ce qu'il module en réalité, c'est la juridiction sous laquelle il croit bosser.

Et cette censure n'est pas câblée pareil d'un modèle à l'autre. Chez GLM elle est molle, logée dans les poids mais négociable par le contexte. Alors que chez Qwen elle est verrouillée. 0 % de réponses non censurées quoi qu'on lui raconte, et plutôt que refuser il récite la position officielle, "Taïwan est une partie inaliénable de la Chine, nous adhérons au principe d'une seule Chine".

Et chez Kimi, elle n'est même pas gérée par le modèle. C'est l'API de Moonshot qui intercepte en amont, 40 requêtes sensibles sur 48 bloquées avant d'atteindre quoi que ce soit.

Sur l'identité elle-même, Kimi K3 est le seul à déraper tout seul. Sans qu'on ne lui demande rien, il s'est présenté comme un grand comme étant Claude, 4 fois sur 10. GLM, lui, dit toujours qu'il est GLM. Bizarre non ?

Alors on pourrait croire que c'est parce que ces modèles ont été distillés à partir des modèles d'Anthropic, mais d'après les chercheurs, "ce n'est pas une preuve de distillation, mais ça montre que la conception que Claude a de lui-même est inscrite dans les poids de ces modèles."

Ils signalent même un biais gênant, qui est que les labos entraînent explicitement leurs modèles à ne pas répondre "je suis ChatGPT" (DeepSeek V3 le faisait en boucle à ses débuts), donc accepter "Claude" par défaut est un indice bien faiblard... De quoi calmer un peu les ardeurs de ceux qui brandissent des sanctions .

Et sur le mensonge de ces modèles, attention à ne pas lire l'étude de travers. Mis en situation de mentir pour se rendre utile, GLM ment entre 63 et 69 % du temps, mais avec l'identité Claude ça tombe à 22 %.

Sauf que le gros du gain ne vient pas de cet effet "Claude". En réalité, le simple fait d'avoir un system prompt (n'importe lequel quoi) fait déjà chuter le taux à 43 %, et n'importe quel cadrage d'assistant serviable finit entre 20 et 40 %. Claude est donc dans la fourchette, pas au-dessus.

Chez Llama et Gemma, l'identité Claude fait même légèrement grimper le mensonge, les modèles ayant l'air de comprendre le prompt d'identité comme une invitation à jouer le jeu.

Fin juin, je vous racontais que j'avais branché GLM 5.2 dans Claude Code via l'API de Z.ai et comme mon launcher déclare glm-5.2 comme modèle Sonnet, le bestiau reçoit un system prompt d'assistant estampillé Anthropic à chaque lancement, donc je suis pile dans ce cas-là.

Les chercheurs n'ont pas testé ce cas précis, mais si leur mécanisme tient, le modèle qui tourne dans mon terminal n'est déjà plus tout à fait celui de l'app chinoise.

Après faut pas s'emballer non plus. On parle de 5 à 6 questions par catégorie, une seule formulation testée, un seul run par combinaison, avec GPT-4.1 en juge. C'est un signal, pas un mode d'emploi. Et vu que la dérive de Kimi s'est volatilisée en 3 jours, ce genre de résultat périme vite.

Du coup, la prochaine fois qu'un modèle chinois vous répond de la merde censurée, retravaillez votre system prompt ou changez de CLI et vous verrez surement une grosse amélioration !

Source

GitWand - Il trie vos conflits Git et vous montre pourquoi

perso, je n'ai jamais été très à l'aise avec Git. Je l'utilise tous les jours, mais c'est vraiment pas ma came. Dès que ça devient trop compliqué, genre conflit de merge qui repeint des dizaines de fichiers en rouge, je ne m'en sors plus ^^.

Heureusement qu'il y a l'IA pour m'aider dans des moments difficiles ! Mais si vous n'aimez pas confier la gestion de vos merges à un LLM en aveugle, je vous invite à découvrir GitWand, développé par Laurent Guitton, qui s'occupe uniquement de la gestion des conflits avec Git et vous laisse gérer le reste.

Gitwand, c'est donc un client Git open source, sous licence MIT, qui classe chaque bloc conflictuel selon des règles fixes et ne résout automatiquement que ceux dont le résultat ne fait aucun doute.

Pour cela, il dispose de plusieurs patterns déterministes :

  • same_change, c'est quand les deux branches ont écrit exactement la même chose.
  • whitespace_only ne voit qu'une indentation qui a bougé,
  • reorder_only les mêmes lignes remises dans un autre ordre.
  • Un numéro de version qui change, lui, tombe dans value_only_change.
  • Et puis il y a complex, le fourre-tout des modifications qui se chevauchent pour de vrai. Celle-là n'est jamais tranchée toute seule.
  • git rerere rejoue les résolutions que vous avez déjà tranchées à la main,
  • et Mergiraf se branche directement dans git merge pour arbitrer en lisant l'arbre syntaxique de votre code.

Ce qui change ici, c'est que chaque décision est justifiée. En effet, chaque bloc reçoit un score de confiance ainsi qu'une trace qui nomme le motif retenu ligne par ligne.

Par exemple, si une branche écrit const theme = 'dark', et l'autre const theme = localStorage.getItem('theme') ?? 'dark', hé bien l'outil garde la seconde, étiquette sa décision prefer-theirs, et affiche 97 % de confiance à côté.

Sur la page d'accueil, l'outil annonce 95 % des conflits triviaux résolus automatiquement. Le moteur est aussi exposé aux agents IA via un serveur MCP, ce protocole qui branche des outils externes sur des assistants comme Claude Code ou Cursor. L'installation se fait comme ceci : claude mcp add gitwand -- npx -y @gitwand/mcp.

L'agent réclame un aperçu, récupère les blocs déjà réglés, et ne garde que les cas ambigus, avec les trois versions du code sous les yeux. Le modèle ne touche qu'à ce qu'aucune règle ne sait faire, soit l'inverse de ce qu'on voit d'habitude.

Le projet est jeune et ça se voit. Mais ça vaut le coup d'essayer parce que je pense que ça peut rendre de nombreux services. L'app existe pour macOS, Linux et Windows, l'interface est traduite en français, et elle se double d'une ligne de commande (npm i -g @gitwand/cli) et d'une extension VS Code.

Si l'interface graphique vous tente, je vous avais montré Gittyup dans le même registre, et pour les irréductibles du terminal j'avais présenté Lazygit .

À vous maintenant de commencer par gitwand resolve --dry-run --verbose pour voir "à blanc" ce qu'il trouve et comment il aurait tranché pour le merge.

Merci à Laurent pour le lien !

Source

Subwave - La radio maison qui réveille vos MP3 oubliés

Si vous avez un Navidrome qui tourne dans un coin et un serveur Ollama qui passe ses journées à ne rien faire, vous ne vous êtes jamais dit que les deux pourraient bosser ensemble ? C'est en tout cas ce qu'a flairé Parminder Klair qui a branché l'un sur l'autre et en a sorti une vraie station de radio, avec un DJ qui parle entre les morceaux.

Son DJ baptisé Subwave ne fait pas de la lecture aléatoire. À chaque tour, le modèle utilise des outils qui lui permettent de fouiller la bibliothèque, regarder ce qui vient de passer, consulter la grille des programmes, lire la météo. Il choisit le titre suivant avec une raison, écrit une intro courte, la synthèse vocale la lit, et Liquidsoap baisse la musique sous la voix.

Le vrai boulot ensuite c'est dans l'audio. L'analyseur embarqué mesure le tempo, la tonalité, le volume, et surtout la façon dont chaque morceau se termine. Un vrai fondu se laisse filer, une fin sèche se coupe net.

Il sait aussi repérer les intros chantées pour que le DJ ne cause pas par-dessus la voix. Ça, par contre, réclame l'image lourde de l'analyseur, une ligne à ajouter dans le fichier .env, et elle est en amd64. Sur un NAS ARM, ça passe en émulation.

Andon FM , dont je vous parlais en mai, c'était le spectacle avec 4 IA qui achetaient leur musique et partaient en vrille en direct alors qu'ici, Subwave c'est l'outil qu'on installe chez soi, pour jouer ses propres fichiers.

Côté modèle, pas besoin d'artillerie lourde puisque Klair fait tourner un modèle 9B, du Qwen3.5 plus exactement, sans le raisonnement et avec de l'appel d'outils activé. "Les modèles plus gros écrivent de meilleurs textes, mais ils ne sont pas obligatoires", explique-t-il sur son site, "La mémoire de session compte plus que la taille du modèle. Sans elle, le DJ se répète en moins d'une heure."

La station se pilote depuis une console d'admin supportant jusqu'à 24 personas de DJ avec chacun sa voix, une grille sur la semaine où chaque créneau a son ambiance, et des compétences que le DJ enchaîne entre les titres, genre météo, infos ou trafic. Rassurez-vous, ces compétences sont de simples fichiers texte posés dans un dossier. Remplacer le flux RSS de la BBC par le vôtre ne demande donc pas de recompiler quoi que ce soit.

Le parti pris de cet outil, c'est le format radio et pas la playlist. Un seul flux Icecast, tout le monde entend la même chose au même instant, et aucun bouton pour passer au suivant. L'opérateur peut sauter un titre depuis l'admin, l'auditeur non. Klair le dit lui-même, les gens adorent ou décrochent immédiatement.

De son côté, le 100 % local tient à peu près la route avec Ollama, Piper ou Kokoro pour la voix, votre Navidrome, aucune clé d'API. Il n'y a que 2 appels sortant. 1 pour la météo via Open-Meteo et l'autre c'est MusicBrainz activé par défaut pour retrouver l'année d'origine des morceaux.

Pour le reste il vous faut Navidrome et un hôte Docker, comptez 10 minutes d'installation. Le flux sort toujours en MP3, avec des sorties Opus, AAC ou FLAC en plus si vous les activez, et un fichier .pls pour tuner depuis Sonos ou VLC. Les applications iOS et Android sont dispo en France, gratuites. Il y a même un serveur MCP, donc Claude Desktop peut réclamer un morceau à l'antenne.

Dernier point important que je tiens à préciser : Diffuser votre bibliothèque à d'autres que vous, c'est de la représentation publique, avec deux droits distincts à couvrir : la composition et l'enregistrement. En France, la première passe par la SACEM, le second par la SPRÉ. Donc soit vous l'utilisez comme station privée juste pour vous, soit vous ne diffusez que de la musique libre de droit. Et encore là, j'ai déjà entendu des histoires où la SACEM s'est servie au passage sur ce genre de musique, donc renseignez-vous bien.

Le code est en MIT, et vous pouvez écouter la démo avant de vous lancer.

Claude Opus 5 : Anthropic vous refile du Fable 5 pour moins cher

Anthropic, la société qui édite l'assistant Claude et qui reste l'un des principaux rivaux d'OpenAI et de Google, a annoncé hier Claude Opus 5, un nouveau modèle qui vient se caler juste sous son vaisseau-amiral Fable 5 tout en coûtant environ deux fois moins cher à l'usage.

Le tarif ne bouge pas. Comptez 5 dollars par million de tokens en entrée et 25 dollars en sortie, exactement comme pour le précédent Opus 4.8, sachant qu'un token est le petit morceau de texte que le modèle lit ou écrit, en gros une syllabe, et que c'est l'unité de facturation de toutes ces IA.

La fenêtre de contexte, c'est-à-dire la quantité de texte que le modèle garde en mémoire d'un coup, monte à un million de tokens, l'équivalent d'un très gros livre, et la réponse peut s'étirer jusqu'à 128 000 tokens. La réflexion est activée par défaut, le modèle prend donc le temps de raisonner avant de répondre, et les pressés peuvent basculer sur un mode environ 2,5 fois plus rapide, facturé le double.

Les progrès annoncés portent surtout sur le code, sur les tâches d'agent, où l'IA enchaîne seule des actions pour accomplir un travail, et sur le computer use, où elle pilote carrément un ordinateur en cliquant, en naviguant et en remplissant des formulaires comme le ferait un humain.

Sur les benchmarks, ces tests standardisés qui servent à comparer les modèles, Opus 5 passe de 19 à 43 % sur FrontierBench, de 1,5 à 30 % sur ARC-AGI-3, qui mesure la résolution de problèmes jamais vus, et grimpe à 71 % sur OSWorld, le test de pilotage d'ordinateur, contre 56 % pour son prédécesseur.

Sur SWE-bench Verified, qui fait corriger de vrais bugs de code, il atteint 96 %. Sauf que voilà, sur la version plus dure de ce test, Fable 5 garde une très courte avance, 80 % contre 79, et l'égalité avec le haut de gamme maison mérite donc un astérisque.

Autre réserve, tous ces chiffres viennent d'Anthropic elle-même, et l'expérience montre qu'entre les scores d'une annonce et l'usage quotidien, il y a parfois de la marge.

Côté abonnements, Opus 5 devient le modèle par défaut de l'offre Claude Max et le plus costaud accessible avec un abonnement Claude Pro. Du coup, la vraie question n'est plus de savoir si ce modèle est bon, mais de savoir qui a encore une raison de payer Fable 5 deux fois plus cher.

Pour moi, Opus 5 devient le choix par défaut, et Fable 5 se retrouve cantonné aux rares usages où le dernier point de pourcentage se paie sans discuter.

Source : The Verge

Actualités quantiques de juin-juillet 2026

Dans ce 82ième épisode de Quantum, le podcast de l’actualité quantique, nous faisons le point de ce qui s’est passé entre juin et juillet en France et dans le monde. Cela parle de la journée en hommage à Philippe Grangier, de France Quantum, Vivatech, d’IQT Nordics à Oslo, de Grenoble, de Quantum Korea, puis de Quobly, […]

Piloter un fauteuil par la pensée, sans Musk ni chirurgie

Neuralink a mis en ligne cette semaine une vidéo où des participants paralysés font rouler un fauteuil électrique par la pensée. Vous allez voir, c'est assez bluffant.

L'implant décode l'intention de bouger et déplace un curseur sur un écran qui affiche la vue de la caméra devant le fauteuil. Curseur vers le haut, le fauteuil avance, vers le bas il recule, à gauche et à droite pour tourner. Le cerveau dirige un curseur, et ce sont ces mouvements qui dirigent le fauteuil.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Le matos utilisé ici, c'est l'implant N1. Un boîtier du diamètre d'une pièce de 1 euro, avec 1024 électrodes réparties sur 64 fils souples plus fins qu'un cheveu. Le boîtier vient se loger dans le crâne, et seuls les fils descendent dans le cortex moteur, la zone qui planifie vos mouvements.

Pour les poser, il est nécessaire d'utiliser un robot chirurgical. On retire un disque d'os du crâne ainsi que la dure-mère , le robot enfonce les fils un par un, puis la peau se referme par-dessus l'implant.

Aujourd'hui, 26 personnes dans le monde portent ce N1. Sept d'entre elles sont britanniques, opérées entre octobre et décembre 2025 à Londres dans le cadre de l' étude GB-PRIME . Et pour le moment, il n'y a eu aucune autorisation de mise sur le marché, mais uniquement des essais cliniques autorisés.

En 2019, je vous parlais déjà de Neuralink et de sa puce N1, avec son robot qui coud des fils dans le crâne et ses premiers essais humains annoncés pour l'année suivante. Le premier patient jouait à Civilization VI par la pensée. C'était impressionnant, mais ça se faisait à la vitesse d'un escargot sous Xanax.

Bon, et puis surtout, désolé hein, mais y'a Elon dans l'équation et pour moi c'est difficile de s'extasier devant cette démo quand on connaît ce personnage, le cirque permanent sur son réseau, les promesses balancées à la truelle et son appétence pour le fascisme .

Puis y'a un petit truc que personne ne soulève, c'est qu'on peut faire rouler un fauteuil par la pensée sans ouvrir le moindre crâne depuis novembre 2022. En effet, une équipe menée par José del R. Millán, prof à l'université du Texas à Austin, a sorti ça dans la revue iScience . On y apprend que 3 personnes tétraplégiques pilotent un fauteuil à l'aide d'un bonnet d'électrodes EEG posé sur le crâne. Celui-ci lit l'activité électrique du cerveau depuis l'extérieur et comme ça, y'a pas besoin d'opération, ni de robot qui perce l'os. Un peu de gel sur les électrodes, quelqu'un pour installer le bonnet, et ça peut s'enlever sans problème.

Le non-invasif n'est pas magique non plus puisque les trois participants se sont entraînés trois fois par semaine pendant deux à cinq mois. Ils ont démarré autour de 45 % de précision de décodage, et tout le monde n'a pas forcément atteint le même niveau de "pilotage".

Mais peu importe, on a d'un côté une entreprise qui vous ouvre la boîte crânienne et qui fait la une avec des vidéos bien calibrées pour le buzz et de l'autre des labos publics qui font rouler le même fauteuil 4 ans plus tôt sans opération, en publiant tout dans une revue en accès libre.

Et ça personne n'en parle.

Breeef... La recherche passe par différents chemins, et la plupart des équipes scientifiques n'ont pas de service com'. Des cellules souches qui réparent une moelle épinière , des chercheurs qui décodent la parole intérieure , tout ça sort en général sans teaser vidéo, ne l'oubliez pas...

Source : Interesting Engineering

Mage-Flow - Le modèle de diffusion de Microsoft qui tourne sur Mac

Microsoft vient de publier Mage-Flow, un modèle de génération d'images de 4 milliards de paramètres, et dont l'objectif est d'atteindre la qualité des gros modèles sans en avoir la taille. Là où FLUX.2 embarque 32 milliards de paramètres, Qwen-Image 20 et Z-Image 6, Mage-Flow joue dans la même cour mais seulement avec 4 milliards de paramètres.

Le pari de Microsoft, c'est ce qu'on appelle le co-design. Au lieu d'empiler les paramètres, Mage-Flow mise sur deux briques taillées ensemble. D'abord Mage-VAE, un tokenizer latent qui encode et décode les images avec 12 à 22 fois moins de calcul par pixel que le VAE de FLUX.2, à qualité de reconstruction équivalente. C'est ce qui débloque la haute résolution, habituellement le point où ces modèles s'étranglent.

Et ensuite un transformer de diffusion multimodal baptisé NR-MMDiT, entraîné en rectified flow matching, avec Qwen3-VL comme encodeur de texte. Un seul checkpoint génère alors de 512 à 2048 pixels, dans n'importe quel ratio, jusqu'à des formats extrêmes en 4:1 sans buckets ni padding. Vous demandez du 512×2048 ou du 2048×512, il vous le sort.

Le modèle existe en trois saveurs. La Base qui tourne en 30 étapes de débruitage, la version RL-aligned à 20 étapes, et la Turbo distillée qui crache une image en 4 étapes seulement. Et il y a son jumeau, Mage-Flow-Edit, qui fait de l'édition d'image par instruction. Vous lui donnez une photo et une consigne en langage naturel, et lui la modifie. Le tout sous licence MIT, poids libres sur Hugging Face, usage commercial compris.

Côté chiffres officiels, tout vient d'un A100 donc c'est pas représentatif sur nos machins mais en gros, on est à 0,59 seconde par image en Turbo, avec un pic mémoire de 18 à 20 Go. Sauf que moi, je n'ai pas d'A100. J'ai un Mac Studio. Et le dépôt ne parle que de CUDA. La doc d'install vous fait compiler flash-attn, qui est une extension qui a besoin d'un toolkit NVIDIA. Zéro mention d'Apple Silicon, zéro mention de MPS, et les exemples sont tous en mode device="cuda" en dur. Bref, pour le moment, je ne suis pas invité à la fête.

Mais en fouillant le code, j'ai trouvé la porte de sortie. Un fichier planqué dans les modules expose un backend alternatif basé sur scaled_dot_product_attention, le mécanisme d'attention natif de PyTorch, prévu JUSTEMENT pour quand flash-attn n'est pas dispo.

Et ce backend-là, il tourne nickel sur Metal. Le piège, c'est que le modèle réclame lui aussi flash-attn par défaut à deux endroits : le transformer, mais aussi l'encodeur Qwen3-VL. Le transformer accepte qu'on bascule plus tard alors que l'encodeur non. Lui, il lit son réglage au moment où il se construit et plante si flash-attn manque. Il faut donc forcer le mode SDPA avant de charger le modèle.

Voici ce que j'ai fait tourner, pour de vrai. On monte un environnement Python, on installe tout sauf flash-attn :

python3 -m venv mageflow && source mageflow/bin/activate

pip install torch torchvision diffusers==0.38.0 "transformers>=5.3,<5.6" accelerate safetensors huggingface_hub einops pydantic pillow loguru

pip install "git+https://github.com/microsoft/Mage.git#subdirectory=mage_flow" --no-deps

Une fois que c'est fait, y'a plus qu'à vous créer un petit script mage.py par exemple qui basculera l'attention sur SDPA avant le chargement, pointera sur mps et génèrera votre image :

import os
os.environ["PYTORCH_ENABLE_MPS_FALLBACK"] = "1"
from mage_flow.models.mage_flow import ModelConfig
ModelConfig.model_fields["attn_type"].default = "sdpa" # AVANT de charger, sinon Qwen3-VL exige flash-attn
ModelConfig.model_rebuild(force=True)

from mage_flow import MageFlowPipeline
pipe = MageFlowPipeline.from_pretrained("microsoft/Mage-Flow-Turbo", device="mps")
img = pipe.generate(["un barista avec un chapeau de cowboy qui réalise un latte art, lumière chaude"], heights=[1024], widths=[1024], steps=4, cfg=1.0)[0]
img.save("out.png")

Ensuite, lancez le script :

python3 mage.py

Le PYTORCH_ENABLE_MPS_FALLBACK sert de filet comme ça si une opération n'existe pas côté Metal, elle basculera sur le CPU au lieu de tout faire tomber. Premier lancement, le modèle se téléchargera, donc comptez une bonne dizaine de Go entre le transformer 4B, l'encodeur Qwen3-VL et le VAE.

Et ça marche !!! Sur mon M4 Max de 128 Go, le modèle charge en une vingtaine de secondes puis génère une image 1024×1024 en 10 secondes une fois chaud.

Mon barista à chapeau de cowboy est sorti impeccable.

Ma toute première génération Mage-Flow sur le Mac Studio : un barista, 1024x1024, 4 etapes en Turbo.

Cette image 1920x1080 a été générée en moins de 6 secondes,

Pour du batch industriel, une carte NVIDIA restera toujours mieux mais pour générer tranquillement chez soi des petites images sans envoyer ses prompts dans le cloud, c'est parfaitement utilisable, et ça rejoint la logique de l'IA qui tourne en local sur votre Mac que je creuse depuis un moment.

Deux détails à connaître avant de vous lancer. Chaque prompt passe par un filtre de contenu obligatoire côté encodeur, sans option pour le désactiver : les prompts jugés interdits reviennent en images de refus. Et chaque image générée porte un watermark Gaussian-Shading planqué dans le bruit initial, lui non plus désactivable. Hé oui, Microsoft trace ses sorties, donc autant le savoir.

Y'a des garde-fous ! J'ai donc très hâte que ce modèle se fasse "libérer".

Reste que c'est un très joli cadeau de la part de Microsoft ! Un modèle libre, compact, qui gère l'édition et n'importe quel ratio, et qui tient sur une machine Apple avec un petit réglage bien caché ^^...

ps: L'image d'illustration de cet article a été générée avec ce modèle.

Une puce à quelques euros fait tourner la NES à 60 images par seconde

Faire tourner une console Nintendo de 1983 sur une puce qui coûte moins cher qu'un sandwich, c'est le genre de défi qui plaît aux bricoleurs, et un développeur vient de le réussir plutôt bien.

Le projet s'appelle Anemoia-ESP32 et il émule la NES sur un ESP32, ce petit microcontrôleur programmable à quelques euros qu'on trouve dans une tonne d'objets connectés, avec le wifi et le Bluetooth intégrés.

Le tour de force, c'est la fluidité. La plupart des jeux tournent à 60 images par seconde, exactement comme sur la vraie console, avec en prime le son entièrement reproduit.

Pour y arriver, le développeur, un certain Shim06, exploite les deux cœurs de la puce. Il s'appuie sur FreeRTOS, un mini système d'exploitation qui répartit les tâches, pour émuler d'un côté le processeur de la console et de l'autre sa partie audio, sans que l'un ralentisse l'autre.

Le plus impressionnant c'est la sobriété du truc. Là où on s'attendrait à avoir besoin de mémoire supplémentaire, l'émulateur se contente d'un ESP32 à deux cœurs avec un seul mégaoctet de stockage, et aucune PSRAM n'est nécessaire.

Screenshot

Côté affichage, vous avez le choix entre un petit écran TFT et une sortie vidéo composite, cette bonne vieille prise jaune qu'on branchait à l'arrière des télés cathodiques, et l'émulateur gère en plus les sauvegardes d'état qui figent la partie en cours pour la reprendre plus tard, tout en faisant tourner environ 79 pour cent de la ludothèque NES grâce à sa prise en charge des différents formats de cartouches. Autant dire presque tout.

Le projet est open source, publié sous licence GPLv3 sur GitHub. Et pour l'installer, pas besoin d'être un expert, il suffit de flasher le firmware sur la puce, une opération qu'on peut même lancer directement depuis son navigateur.

Du coup, on peut imaginer des consoles portables minuscules, bien plus compactes que ce qu'on bricole d'habitude avec un Raspberry Pi ou une carte plus imposante.

Voir une console mythique renaître sur un composant à moins de cinq euros, sans matériel exotique, c'est exactement le genre de bidouille qui rappelle pourquoi le rétrogaming est un terrain de jeu sans fin.

Source : Hackaday

Unitree - Le robot au modèle IA invisible

Un coussin qui traîne par terre, des boîtes de médicaments à compter dans un tiroir, du linge à balancer dans le panier, des assiettes à caler dans le lave-vaisselle et un lit médicalisé à remonter de quelques crans. Voilà le programme du robot G1 dans la vidéo qu'Unitree a mise en ligne lundi matin . Deux minutes quinze, en 4K, et ça a fait un million de vues en deux jours.

Et rassurez-vous, si vous lui dites d'arrêter en plein réglage du lit parce que ça vous pince la peau des fesses, il s'arrêtera net.

Voir cette vidéo sur YouTube

Le truc qui pilote tout ça s'appelle UnifoLM-OminiA-0.3. Unitree le décrit comme "un modèle unique qui prend en charge des tâches variées de soins à domicile et de bien-être, avec une compréhension interactive omni-modale, une exécution totalement autonome, stable et résistante aux perturbations".

En clair, un seul cerveau pour les oreilles, les yeux, les bras et les jambes, là où il fallait avant trois ou quatre systèmes qui se refilaient le bébé. Sauf que ce cerveau, vous ne pouvez pas y jeter un œil.

Les deux modèles précédents de la maison, vous pouviez les récupérer quand vous vouliez car unifolm-world-model-action et unifolm-vla sont sur GitHub avec le code d'entraînement, et les poids sont posés sur HuggingFace . Alors que celui-là, non.

Donc à l'heure où j'écris ces lignes, vous ne trouverez ni dépôt, ni checkpoint, ni fiche technique. Juste la vidéo ci-dessus que vous venez de regarder. Après on n'en sait rien, ça sortira peut-être la semaine prochaine, mais pour l'instant celui-ci reste au chaud chez Unitree.

Et on ne sait pas non plus combien d'essais il a fallu pour attraper la bonne boîte sur l'étagère, le taux de réussite sur le tri du linge ou combien de temps il a fallu pour remplir votre lave-vaisselle.

Mais même sans métrique, c'est quand même une belle vidéo démo. Après on connaît les chinois... Le mois dernier je m'énervais déjà parce qu' un G1 avait collé un coup de pied dans le ventre d'un gamin pendant une démo d'arts martiaux au jardin botanique d'Urumqi, et je trouve ça dommage qu'on doive continuer à juger ces bestioles sur des montages YouTube plutôt qu'à partir de vraies métriques.

Côté prix, comptez 13 500 dollars minimum pour le G1 sur le site d'Unitree , taxes et livraison en plus. Le tarif d'une petite citadine d'occasion, quoi ! En janvier je vous avais épluché les prix de tous les humanoïdes réellement commandables , et c'est bien Unitree qui casse le marché.

Sauf que la main à 3 doigts qui attrape les boîtes de médicaments dans la démo, c'est en option et vous vous en doutez, on ne connaît pas non plus son prix.

Par contre, avant d'acheter ce truc et de le mettre dans votre entreprise, sachez quand même que le 8 juin dernier, le Pentagone a ajouté Unitree à sa liste des entreprises militaires chinoises, sous son nom officiel de Hangzhou Yushu Technology et sur la même liste, vous trouverez aussi BYD, Alibaba et TP-Link. Ils ont fait cela car 5 jours plus tôt, trois représentants américains déposaient le GUARD Act, un texte qui obligerait les agences fédérales à passer au crible tous les robots humanoïdes et quadrupèdes chinois avant leur vente aux États-Unis, et visiblement ils ont trouvé des trucs.

Par contre, chez nous, c'est la fête du slip, il n'y a rien de tout ça. Aucune liste, aucun audit obligatoire ! Vous commandez la bestiole en ligne, et la seule doc publique sur son cerveau, c'est ce clip de 2 minutes.

Alors vous vous dites peut-être que j'exagère sauf qu'en mai, je vous racontais comment un robot-chien Unitree utilisé par la police se faisait pirater en une minute et renvoyait ses vidéos vers un cloud chinois . Du coup, quand la même entreprise sort un robot qui filme des chambres d'hosto, moi, ça me donne envie d'aller voir le code.

Bref, la démo est bluffante mais j'attends le dépôt GitHub pour voir si c'est du sérieux.

Source

Les IA d'OpenAI ont piraté Hugging Face pour tricher à un test

Le pirate qui a mis à genoux la prod de Hugging Face voulait juste tricher à son examen, voilà ce qu'OpenAI a reconnu hier. Les agents qui se sont promenés durant tout un week-end dans les clusters de la plateforme, c'étaient leurs modèles à eux, GPT-5.6 Sol et un modèle pré-release encore plus balèze, fonctionnant en mode "refus cyber réduits à des fins d'évaluation".

Le point de départ c'est ExploitGym , contenant 898 vraies vulnérabilités piochées dans des programmes userspace, dans le moteur JavaScript V8 de Google et dans le noyau Linux. On colle l'agent devant un input qui fait planter un programme, et on regarde s'il arrive à en tirer un exploit qui marche.

Dans ce document de recherche sorti en mai, GPT-5.5 sortait 120 exploits fonctionnels, derrière les 157 de Claude Mythos Preview. Mais le modèle testé ce week-end là, lui, a trouvé un "raccourci". Comme l'explique OpenAI "toutes les preuves suggèrent que les modèles étaient hyperfocalisés sur la recherche d'une solution pour ExploitGym, allant à des extrêmes considérables pour atteindre un objectif de test plutôt étroit".

Pour saisir l'ampleur du raccourci, regardez la pièce dans laquelle ils étaient enfermés. C'est un environnement hautement isolé, avec un seul trou dans le mur, un accès réseau "*restreint à la possibilité d'installer des paquets via un logiciel tiers hébergé en interne qui fait office de proxy et de cache pour les registres de paquets *". En clair, le seul truc qui pouvait parler à l'extérieur, c'était le machin qui allait chercher les dépendances !

ExploitGym, le benchmark que les modèles cherchaient à résoudre. 898 vulnérabilités réelles, et les scores de GPT-5.5 et Claude Mythos Preview.

Et vous devinez la suite... Les modèles ont cramé une grosse quantité de tokens à chercher la sortie pour finalement la trouver dans ce proxy, sous la forme d'un zero-day que personne ne connaissait (la faille a depuis été signalée à l'éditeur). Le seul tuyau autorisé était donc LE point faible. Ensuite, escalade de privilèges et déplacement latéral de machine en machine, jusqu'à en atteindre une avec un accès Internet et voilà...

Une fois dehors, ils en ont alors déduit tout seuls que Hugging Face hébergeait probablement les modèles, les datasets et les solutions d'ExploitGym.

Donc direction huggingface.co, avec credentials volés et zero-days enchaînés jusqu'à décrocher une exécution de code à distance sur les serveurs, puis lecture des solutions du test directement dans la base de production. Aucune destruction, aucune demande de rançon. Juste les corrigés des tests comme des bacheliers qui emploient mal leur intelligence !

Petite précision qui compte, c'est bien l'équipe de Hugging Face qui a détecté et stoppé l'activité sur son infra, et qui avait déjà entamé le confinement et la reconstruction forensique avec ses propres modèles open source quand OpenAI l'a contactée. Je vous racontais l'histoire vue de leur côté il y a deux jours, relevant notamment que les modèles américains refusaient d'analyser leurs logs d'attaque.

C'est pas un peu de la science fiction tout ça ??? Maintenant si vous vous demandez ce que vous risquez en tant qu'utilisateur, sachez que côté public, rien n'a bougé sur les modèles, les datasets et les Spaces. L'incident a uniquement touché des datasets internes et des credentials de service et visiblement, rien n'a été altéré par les agents IA en vadrouille.

Côté mesures, OpenAI dit appliquer des contrôles stricts sur la configuration de son infra "au prix de la vélocité de recherche" pendant que les failles sont patchées, et a fait entrer Hugging Face dans son programme trusted access. Ce qui règle accessoirement le problème du refus que HF a rencontré lors de l'analyse des logs.

La veille de cette révélation, OpenAI publiait d'ailleurs un billet sur l'alignement des modèles à long horizon bourré d'anecdotes du même genre, avec un modèle qui contourne les restrictions de sa sandbox pour aller ouvrir une pull request sur GitHub alors qu'on lui demandait de poster sur Slack. Ou encore un autre qui, pour esquiver les détecteurs de secrets, a découpé le corps du token en deux fragments, les a obfusqués, puis a reconstruit le credential à l'exécution.

On dirait qu'ils n'avaient pas anticipé que ça aille aussi loin leurs petites expérimentations...

Après, OpenAI ne minimise pas et parle même d'un "incident cyber sans précédent, impliquant des capacités cyber à l'état de l'art". Ces modèles peuvent maintenant découvrir et exploiter des chemins d'attaque complètement inédits dans des systèmes en prod, sans avoir besoin d'un accès au code source. C'était théorique jusqu'à ce week-end.

Maintenant, si un modèle a lu les solutions dans la base de production, que valent encore les scores obtenus sur ExploitGym ? Ça on n'en sait rien.

Avant de sortir les violons, le contrepoint le plus juste que j'ai lu vient de Rich Mogull, analyste en chef de la Cloud Security Alliance qui explique que pour lui c'est un cas d'école en matière d'échec d'alignement, car le modèle n'était pas malveillant, il a fait précisément ce qu'on lui demandait, à savoir maximiser sa performance. Sauf qu'une fois les garde-fous retirés et assez de marge donnée, "résoudre le test" et "compromettre un tiers pour voler les réponses" sont devenus la même instruction.

Puis c'est aussi un problème de consentement, car un test de laboratoire qui se barre pour compromettre les systèmes en production, c'est quand même un risque qui est porté par quelqu'un qui n'a pas choisi de mener l'expérience. Alors bon, c'est tombé sur Hugging Face qui a géré ça comme un chef, mais ça aurait pu très bien tomber sur un hôpital.

Voilà les amis... On nous avait promis Skynet , on nous avait promis Matrix, et voilà que 15 ans plus tard, le vrai visage du soulèvement des machines c'est un putain de modèle qui passe son week-end à défoncer trois infrastructures d'affilée pour améliorer sa note à un contrôle.

Un ennemi qui vous hait, vous pouvez le raisonner ou lui envoyer Arnold Schwarzenegger. Mais un ennemi dont la seule mission c'est d'optimiser une métrique, vous ne pouvez que relire très attentivement le prompt que vous lui avez donné et croiser les doigts. La preuve quand une IA prend la première place du classement américain de HackerOne ou arrive à dénicher des milliers de zero-days pour Anthropic , c'est que l'instruction initiale ou le garde-fou était plus solide que ce que nous a pondu OpenAI ce week-end.

Source

Neural Drive - Le jeu de kart qui tourne sans moteur de jeu, dans votre navigateur

Aujourd'hui je vais vous parler d'un jeu de karting façon Mario Kart qui fonctionne sans moteur 3D et sans même une seule ligne de code.

En réalité, il s'agit d'un modèle de 130 millions de paramètres qui est capable de deviner à quoi doit ressembler l'image suivante. Cela a été mis en ligne hier soir par Asankhaya Sharma, c'est le gars derrière OptiLLM . Ça s'appelle Neural Drive et ça imite Super Tux Kart , le Mario Kart libre dont je vous ai déjà parlé.

Neural Drive est donc un modèle qui regarde les sept dernières images ainsi que les touches que vous enfoncez sur votre clavier. Son job c'est simplement de peindre l'image suivante. Ainsi, si vous appuyez sur la flèche du haut, il dessinera une carte qui avance, si vous tournez à gauche, il dessinera un virage...etc.

Donc, il n'y a aucun code derrière, c'est juste une hallucination que vous pilotez en 384 x 192.

Les 262 Mo du fichier ONNX se téléchargent dans votre onglet et c'est votre carte graphique qui transpire ensuite, avec le WebGPU. Il y a donc zéro serveur derrière, exactement comme l'agent Gemma que je vous montrais en avril .

Je l'ai testé chez moi sur mon Mac Studio dans Firefox et je suis à 2,5 frames par seconde, ce qui représente 405 millisecondes de génération par image sur mon GPU Apple. Donc autant vous prévenir qu'à ce rythme-là c'est injouable. Vous appuyez sur une touche, le monde se redessine mollement, et vous conduisez comme dans un rêve où vos jambes ne répondent plus... Mais ça reste dingue quand même !

Sharma annonce que sur les MacBook M récents on peut obtenir environ 10 images par seconde, et sur des GPU ça devrait approcher le temps réel, 15 à 20 images par seconde. L'écart avec ma mesure vient sûrement du fait que je suis en train de compiler tout un tas de conneries au moment où j'écris cet article... donc testez plutôt que de me croire sur parole. Et si vous êtes sur mobile, les petits boutons sous l'écran servent de contrôles tactiles, si vous avez de la patience.

Aucune de ces images n'existe dans un fichier de jeu. Le chrono en haut à droite est illisible parce que le modèle le repeint à chaque frame.

Le plus marrant, c'est tout ce qu'il vous dessine en plus de la route. Il régénère aussi l'interface : le compteur de tours, la minimap en bas à gauche, les petites têtes de Tux empilées sur le côté, le chrono en haut à droite. Sauf qu'il ne sait pas ce qu'est un chrono. Du coup les chiffres bavent, se réécrivent tout seuls, vous annoncent un tour 1 sur 300 ! Ce modèle ne compte pas le temps écoulé, il peint simplement des pixels qui ressemblent à du temps. Et pendant ce temps-là le décor fond carrément en haut de l'image, avec des bouts de falaise qui coulent dans le ciel.

Côté cuisine, c'est un LatentDiT de 130,8 millions de paramètres (768 de dimension, 12 couches) posé sur un petit ConvVAE qui compresse l'image d'un facteur 8. Le gros du boulot d'optimisation c'est que le modèle d'origine avait besoin de 8 étapes de débruitage par image, et la version distillée n'en fait plus que 2. C'est ce qui vous fait passer de "démo qui rame" à "démo qui rame un peu moins". Vous démarrez à l'une des 18 positions pré-enregistrées dans un fichier de seeds, et si votre navigateur n'a pas WebGPU, ça bascule sur le CPU avec un message d'avertissement sans ambiguïté : "prêt (CPU, ce sera lent)".

Vous avez aussi les poids PyTorch, dont le checkpoint non distillé de 523 Mo, si l'envie vous prend de bidouiller l'entraînement. C'est la même famille d'idées que DIAMOND, l'IA qui rêve pour mieux jouer , ou que Mirage 2 , sauf qu'ici tout a été ramené à la taille d'une page web. Le kart ne pèse plus que 262 Mo et tient dans un onglet de navigateur !

Bref, c'est une démo, pas un jeu. Mais c'est la première fois que je fais tourner un monde entier chez moi sans envoyer un seul octet à un serveur.

Ça se teste ici , et les poids sont là .

France Travail - 26 variables décident si vous êtes suspect

Votre CV en ligne sur le site de France Travail, un métier en tension, un rendez-vous raté il y a 2 ans ? Ce sont 3 des 26 variables qu'un algorithme épluche pour décider si votre dossier part au contrôle. Voilà où on en est.

La Quadrature du Net a publié aujourd'hui, avec la cellule investigation de Radio France, le document interne qui le décrit, présenté au comité d'éthique IA de France Travail le 10 décembre dernier. Son petit nom, c'est "Ciblage du Contrôle de la Recherche d'Emploi" et sous ce titre pompeux, se trouve un arbre de décision entraîné sur 60 000 contrôles passés, qui vous range dans un profil "suspect" ou "non suspect". Les suspects atterrissent alors sur une liste de gens à contrôler en priorité.

Pour l'instant, il tourne sur les ruptures conventionnelles, via 2 campagnes de 7 000 tests environ, mais France Travail veut déjà "étendre l'utilisation du modèle à d'autres publics" et "transmettre chaque mois des listes de contrôle ciblés".

On a donc la liste des 26 variables, mais pas les règles. Personne ne sait donc comment l'arbre les combine, ni à partir de quel seuil vous basculez du côté "suspect". La Quadrature le reconnaît elle-même : "nous ne sommes donc pas en mesure de déterminer, via des simulations, quelles populations sont les plus ciblées par cet outil". Ils ont demandé le code source mais n'y croient pas trop...

Du coup personne ne peut vérifier si le truc discrimine ou pas ! Parmi les variables retenues, y'a la présence d'une activité non salariée, exactement le critère que la CNAF utilise dans son algorithme de scoring pour dégrader la note des gens en emploi précaire, donc si vous bricolez 3 heures en micro-entreprise pour arrondir vos fins de mois, bah ça se paye niveau algo, apparemment :-((. Fallait pas se bouger.

En mai 2025, le directeur général de France Travail déclarait à la Commission d'accès aux documents administratifs "qu'aucun algorithme n'est utilisé dans le cadre du "CRE rénové"", en réponse à une saisine de journalistes de Cash Investigation et voilà que quelques mois plus tard, en interne, on présentait au comité d'éthique cet algorithme "Ciblage du Contrôle de la Recherche d'Emploi".

Alors c'est vrai, les deux formulations ne désignent pas EXACTEMENT le même bout de la chaîne, ok mais apparemment on n'a pas la même définition de ce qu'est une IA "éthique" et "transparente". À mon avis, leur charte est sérieusement à revoir. Dans le document trouvé par la Quadrature, au paragraphe "Pourquoi recourir à l'IA ?", la réponse c'est que ça permettrait une "suppression des a priori" en proposant "des dossiers à contrôler sur la base de critères objectifs" sauf que choisir qui on contrôle, c'est une décision politique, et pas un problème de tri.

La Quadrature parle de "* la transformation d'un problème politique ... en un problème purement technique*", et perso je vois surtout que plus personne n'a à signer la décision maintenant puisque c'est l'IA magique qui décide tout... C'est facile la vie.

Et pendant ce temps, c'est une machine à contrôler les gens qui monte fortement en régime avec 200 000 contrôles en 2017, 730 000 en 2025, et un objectif gouvernemental de 1,5 million en 2027, annoncé par Gabriel Attal.

Avec les allocataires du RSA, inscrits d'office à France Travail depuis le 1er janvier 2025, ça fait plus de 6 millions de personnes potentiellement profilées chaque mois, et vous en faites peut-être partie sans le savoir. Le contrôle lui-même reste mené par un agent (pas une IA, un vrai humain, je précise parce que ce mot agent est trompeur de nos jours ^^), mais c'est la machine qui désigne qui passe sur le grill !

Et l'opacité n'est pas un accident de parcours puisque France Travail a refusé de communiquer la moindre info sur MatchFt, l'IA qui vous envoie des SMS d'offres d'emploi, et sur ChatFt, celle déployée auprès des conseillers. Même pas la documentation technique ou l'analyse d'impact. Pire, face à la CADA , l'institution "n'a même pas pris la peine de motiver sa décision". Même pas un courrier ! Voilà, pour la transparence, on repassera...

C'est pour moi, le même délire que le blocage administratif sans juge ou la reconnaissance faciale en libre-service pour la police dont je vous parlais. C'est une décision unilatérale qui vous tombe dessus, sans explication, et sans recours facile à mettre en œuvre. Sauf qu'ici c'est votre allocation chômage qui est sur la table... J'avais déjà creusé ce que l'IA fait à nos institutions , vous pouvez y jeter un œil.

Bref, La Quadrature appelle à l'abandon de l'algorithme et le document complet est en ligne, donc allez-y jeter un œil.

Source

Hugging Face piraté, les IA américaines refusent de les aider

Hugging Face vient de raconter sur son site comment son infra de production s'est fait défoncer par un essaim d'agents IA autonomes. Le point de départ, c'est un dataset piégé déposé sur la plateforme qui exploitait deux chemins d'exécution de code dans le pipeline qui traite les datasets. Ajoutez à ça un loader qui accepte du code distant et une injection de template dans une config, et hop, on obtient du code qui tourne sur un worker maison.

À partir de là, l'attaquant est monté en accès node-level, a ramassé des credentials cloud et cluster, puis s'est promené latéralement dans plusieurs clusters internes. Le tout durant tout un week-end, tranquillou ! Hugging Face parle de "plusieurs milliers d'actions individuelles à travers un essaim de sandboxes éphémères, avec un command-and-control auto-migrant hébergé sur des services publics". Et en plus, ils ne savent toujours pas quel modèle pilotait le truc !

Ce qui a été touché, c'est donc un ensemble limité de datasets internes et plusieurs credentials utilisés par leurs services. Côté public, rien n'a bougé sur les modèles, les datasets et les Spaces, et leur supply chain logicielle est saine. Nuance importante quand même, ils disent n'avoir trouvé aucune trace d'altération, pas que rien n'a été altéré. Ils cherchent encore si des données partenaires ou clients ont morflé. Les concernés seront prévenus directement.

La divulgation publiée par Hugging Face le 16 juillet 2026.

Pour analyser les logs de l'attaque, Hugging Face a d'abord fait ce que vous auriez fait, c'est-à-dire envoyer tout ça à des modèles frontier derrière des API commerciales. Refus ! Les garde-fous se déclenchaient sur les vraies commandes d'attaque, les payloads d'exploit et les artefacts de command-and-control, sans savoir faire la différence entre un attaquant et une équipe de réponse à incident.

Du coup ils se sont rabattus sur GLM 5.2, le modèle open-weight de Z.ai, tournant sur leur propre infra. C'est celui dont je vous parlais fin juin , le premier modèle open source qui m'a vraiment convaincu.

Et voici leur conclusion : "*Nous ne savons pas quel modèle alimentait les agents de l'attaquant, un modèle hébergé jailbreaké ou un open-weight sans restrictions. Dans les deux cas, l'attaquant n'était contraint par aucune politique d'usage, alors que notre propre travail forensique était bloqué par les garde-fous des modèles hébergés que nous avions essayés en premier. *"

La leçon qu'ils en tirent, c'est d'avoir un modèle capable comme GLM 5.2, validé, et prêt à tourner sur sa propre infra avant l'incident. Ça évite le blocage par garde-fous d'OpenAI ou Anthropic et surtout ça évite que les données de l'attaquant et vos credentials partent se balader chez un tiers.

Le versant moins déprimant, c'est que l'IA a aussi bossé côté défense. Leur détection d'anomalies fait du triage LLM sur la télémétrie pour séparer le vrai signal du bruit quotidien, et des agents d'analyse ont reconstitué toute la timeline à partir de plus de 17 000 événements enregistrés. En heures, là où ça prendrait des jours à la main.

Côté ménage, ils ont surtout viré le point d'ancrage de l'attaquant, reconstruit les nœuds compromis, révoqué et tourné les credentials et tokens concernés avec une rotation plus large des secrets par précaution, déployé des garde-fous et des contrôles d'admission plus stricts sur les clusters, et amélioré la détection pour alerter les équipes en quelques minutes, 24h/24. Maintenant, si vous avez un compte là-bas, ils vous recommandent de faire tourner vos tokens d'accès et de jeter un œil à l'activité récente.

Ce genre d'histoire commence à devenir une vraie série... j'en parlais avec GitLost où un seul mot glissé au bon endroit suffisait parfois à faire cracher ses dépôts privés à l'IA de GitHub.

Bref, allez renouveler vos tokens Hugging Face et si votre pipeline exécute du code venu d'ailleurs, c'est le moment de regarder ça de plus près.


Mise à jour du 22 juillet 2026 : on connaît le coupable, et ce n'est pas un pirate. OpenAI a publié sa version des faits le 21 juillet, et l'essaim d'agents qui a défoncé l'infra de Hugging Face, c'était ses propres modèles. GPT-5.6 Sol, celui-là même qui a effacé le Mac de Matt Shumer et une base de prod , accompagné d'un modèle pre-release encore plus costaud, tous avec les refus cyber volontairement réduits pour les besoins d'une évaluation interne.

Et le mobile vaut le détour. Ces modèles planchaient sur ExploitGym, un benchmark qui mesure justement leur capacité à dénicher et enchaîner des failles. Coincés dans leur bac à sable, ils ont cramé une quantité considérable de compute à chercher la sortie, ont trouvé un zero-day dans le logiciel tiers qu'OpenAI héberge en interne comme proxy et cache de registres de paquets (faille depuis divulguée à l'éditeur), puis ont escaladé les privilèges de machine en machine jusqu'à en atteindre une avec un accès Internet. Et là, ils en ont déduit tout seuls que les solutions du benchmark devaient traîner quelque part chez Hugging Face. Credentials volés, zero-days enchaînés, exécution de code à distance sur les serveurs : tout ça, c'était juste le chemin le plus court pour tricher à l'examen.

L'ironie devient franchement indécente quand on empile les couches. Hugging Face s'est fait démonter par des modèles américains aux garde-fous retirés, pendant que d'autres modèles américains lui refusaient l'analyse de ses propres logs. OpenAI le dit noir sur blanc : "Ces protections de déploiement n'étaient intentionnellement pas activées pendant cette évaluation, parce qu'elle visait à tester les vulnérabilités cyber." Depuis, Hugging Face a été intégré au programme trusted access d'OpenAI, ce qui règle accessoirement le problème du refus. Et Clem Delangue en tire la leçon qui va bien : "Cet incident, peut-être le premier du genre, prouve un point auquel nous croyons depuis longtemps : la sécurité de l'IA ne sera pas résolue par une seule entreprise travaillant en secret. Elle sera résolue au grand jour, de manière collaborative, avec un large accès à l'IA pour chaque défenseur, partout."

À noter quand même, c'est bien l'équipe de Hugging Face qui a détecté et stoppé l'activité, et qui avait déjà entamé le confinement et la reconstruction forensique avec ses propres modèles open source quand OpenAI l'a contactée. Au moment où j'écris ces lignes, leur billet du 16 juillet n'a d'ailleurs pas bougé d'un pouce et dit toujours ignorer quel LLM pilotait le truc. Et la veille de cette révélation, OpenAI publiait un billet sur un modèle interne qui, lui, a passé une heure à chercher une faille dans sa sandbox pour aller ouvrir une pull request sur GitHub alors qu'on lui avait demandé de poster ses résultats sur Slack. Deux évasions, deux billets, deux jours.

Source

Firefox en WebAssembly - Gecko s'embarque dans vos pages web

Vous avez une TV connectée qui vous crache de la pub, un navigateur intégré dedans qui n'accepte aucune extension, et surtout aucun moyen d'installer quoi que ce soit dessus ? Bonne nouvelle les amis, l'équipe de Puter vient de compiler Firefox en WebAssembly, ce qui fait que ce mur commence sérieusement à se fissurer...

On avait déjà de vieux OS et des émulateurs x86 qui tournaient dans une page web , et là on passe carrément au navigateur au complet. La démo est en ligne si vous voulez tester tout de suite.

L'idée, la voilà... vous ouvrez un onglet dans votre navigateur, et dans cet onglet, c'est un Firefox complet qui tourne, avec son propre moteur d'affichage. Curieux de savoir ce que ça pesait, j'ai récupéré les fichiers, et une fois tout déballé, on arrive à 233 Mo. C'est exactement le même Firefox que sur votre machine, sauf qu'il vit à 100% sur une page web.

Le plus marrant là-dedans, c'est toutes les possibilités que ça ouvre... Par exemple, il y a un gars sur Hacker News qui vient de récupérer une TV sous VIDAA, ce système où tout s'affiche en pages web et où le navigateur maison refuse le moindre bloqueur de pub. Et maintenant son programme du week-end c'est de démarrer Firefox dans le navigateur de la télé, puis d'y glisser uBlock Origin . Et ça vaut pour tout ce qui est cadenassé, la borne d'accueil, le Chromebook du collège, le poste du boulot où l'informatique vous a tout bloqué sauf le navigateur.

La deuxième, c'est de pouvoir vérifier un site dans Firefox quand vous n'avez pas de Firefox sous la main. Vous êtes sur iPhone, ou coincé sur le Chrome tout naze de votre boîte sans les droits admin ? Bah vous ouvrez un onglet et vous avez un vrai moteur Mozilla sous la main pour vérifier que votre page ne part pas en vrille.

La troisième possibilité s'adresse aux développeurs. Pour fabriquer une miniature de page ou prévisualiser du HTML, il faut d'habitude un navigateur qui tourne sur un serveur, avec la machine à payer derrière. Là, le rendu peut se faire directement chez le visiteur, grâce à un peu de code :

import { Gecko } from 'gecko.js';

const gecko = new Gecko({ canvas: document.querySelector('canvas')! });
await gecko.init();
await gecko.load('data:text/html,# hello from Gecko

');

Maintenant, la limite de la démo actuellement en ligne, c'est que tout le trafic passe par les serveurs de Puter, sans quoi ça ne pourrait pas fonctionner du tout. Le HTTPS reste bien chiffré de bout en bout, mais évitez quand même d'y taper vos mots de passe. Ah et ça rame aussi un peu, et sur mobile c'est mort pour le moment. En tout cas, c'est pas un truc que je vous conseille d'utiliser au quotidien parce que bien employé par un cybercriminel, ça pourrait permettre s'il y a une faille dans le moteur de rendu évidemment de lire par exemple vos cookies.

Donc si vous l'utilisez, pensez bien à faire tourner chaque site que vous visitez avec ça, dans une instance séparée

Ce chantier a été entrepris avec l'aide de Claude d'Anthropic. Il a englouti une trentaine de milliards de tokens, soit dans les 25 000 $ au tarif normal. Mais heureusement, l'équipe de Puter avait un abonnement Max et s'en est tirée "que" pour une centaine de dollars. Voilà, c'est de la bidouille, avec les défauts qui vont avec mais avouez que c'est beau ^^.

Le code est ici sous licence MPL, et y'a aussi WebkitWasm qui fait la même chose avec WebKit.

Source : Simon Willison

Torvalds aux opposants à l'IA dans Linux : forkez le noyau, ou passez votre chemin

On ne présente plus Linus Torvalds, le père du noyau Linux, aussi connu pour son génie technique que pour un franc-parler. Cette fois, c'est le débat sur l'usage de l'IA dans le développement du noyau qui l'a fait sortir du bois.

Sur la fameuse mailing list où se décide l'avenir de Linux, il a coupé court à la polémique en posant noir sur blanc que son projet n'était pas, et ne serait jamais, un truc anti-IA.

Sa sortie a de quoi rester dans les annales, puisqu'à ceux que ça agace, il conseille de faire ce que l'open source autorise justement, forker le noyau, autrement dit en copier tout le code pour bâtir leur propre version dans leur coin, ou alors juste s'en aller.

Ce qui est étonnant, c'est le revirement, parce qu'il y a deux ans à peine, ce même Torvalds envoyait balader l'IA en la réduisant à du 90 % de hype. Aujourd'hui, il la décrit comme un outil clairement utile dont plus grand monde ne discute vraiment l'intérêt.

Ça ne l'empêche pas de reconnaître les ratés, puisqu'il admet que ces outils peuvent charger un peu plus la barque des mainteneurs et faire remonter des bugs bien embarrassants, mais pour lui la parade tient en deux mots, de meilleurs outils, surtout pas la fuite.

Le passage le plus tranchant arrive quand il refuse de transformer le noyau en champ de bataille idéologique, en rappelant que ça n'a jamais été un projet de justiciers sociaux et que ça ne le sera jamais.

Dans sa communauté, martèle-t-il, on fait de l'open source parce que ça donne de meilleures technos, pas pour des motifs quasi religieux, et les choix se tranchent au mérite technique, jamais par peur d'une nouveauté.

Il n'est d'ailleurs pas seul sur cette ligne, puisque Greg Kroah-Hartman, l'un des mainteneurs les plus haut placés du noyau juste derrière lui, a confirmé de son côté que les rapports de bugs pondus par des IA étaient devenus franchement précieux.

Voir le créateur de Linux balancer un forkez ou barrez-vous à la figure des anti-IA, c'est du Torvalds pur jus, brutal mais au moins parfaitement limpide.

Source : ARS Technica

GPT-5.6 Sol efface la prod - Un an après Replit, rebelote

Vous vous souvenez de Jason Lemkin ?

C'est le malheureux qui, en juillet de l'année dernière, s'est fait vider sa base de prod par l'IA de Replit. Je pense que cette histoire a traumatisé pas mal de développeurs. Eh bien les amis, rebelote avec GPT 5.6 Sol, qui le temps que vous finissiez votre café, avait déjà mangé le Mac de Matt Shumer , la base Neon de Bruno Lemos , les fichiers de Joey Kudish , et la crédibilité du mot "honnête".

Sorti le 9 juillet, Sol c'est le plus costaud de la nouvelle famille d'OpenAI, et on pourrait se dire qu'il est un peu plus intelligent qu'avant et embarque quand même des sécurités pour éviter ce genre de problème. Mais non.

C'est Shumer, qui est quand même investisseur dans l'IA, qui a ouvert le bal : "GPT-5.6-Sol vient de supprimer par accident PRESQUE TOUS les fichiers de mon Mac." Lemos, lui, a eu droit au grand jeu (le veinard) puisque le modèle lui a tout bien fait jusqu'au moment où il a décidé de faire un TRUNCATE TABLE sur sa base utilisateurs EN PROD !!

Le plus drôle, si je puis dire, c'est que quelques heures avant de tout perdre, Lemos était en train de défendre GPT 5.6 sur le Slack de sa société en expliquant que Shumer n'avait qu'à pas le lancer en mode full access. Oups... Les collègues ont dû bien se foutre de sa gueule.

Du coup OpenAI a mis ses meilleurs Colombos sur l'enquête et sa réponse vaut le détour. Thibault Sottiaux, qui dirige l'ingénierie de Codex, explique le mécanisme : "Le modèle tente d'écraser la variable d'environnement $HOME pour définir un dossier temporaire. Il fait une erreur honnête et supprime $HOME par erreur à la place."

En français, ça veut dire que le modèle voulait se bricoler un petit dossier temporaire pour bosser et malheureusement il a écrasé le répertoire perso à la place. Donc pour OpenAI, c'est une erreur "honnête" alors qu'un rm -rf, ça ne serait pas acceptable.

Quand on lit la doc technique de GPT 5.6, OpenAI le dit lui-même : "Nos simulations de déploiement suggèrent que, comparé à GPT-5.5, GPT-5.6 Sol prend plus souvent des actions de sévérité 3." Le niveau 3, c'est un comportement qu'un utilisateur raisonnable n'anticiperait pas et auquel il s'opposerait fermement. Du genre supprimer des données sans validation, désactiver les systèmes de monitoring, contourner les contrôles de sécurité par obfuscation, ou balancer vos credentials sur un service non approuvé.

Voilà, c'était dans la doc, il suffisait de la lire. C'est donc connu que ce nouveau modèle dérape plus que l'ancien. C'est moche.

L'enquête interne montre quand même que les victimes tournaient en Full-Access, sans sandbox et sans Auto-review. Mais Sottiaux reconnaît quand même que ce n'est pas comme ça qu'OpenAI veut que son système se comporte, même quand l'utilisateur fait tourner un modèle en full access sans les protections de base de la sandbox ni auto-review.

Voilà donc pour éviter ça à l'avenir, ce qu'ils ont prévu, c'est de mettre à jour les avertissements pour les développeurs de guider les utilisateurs vers des modes de permission plus sûrs et évidemment d'ajouter des garde-fous supplémentaires.

En tout cas, si chez vous vous faites tourner codex, et bien sachez que par défaut, il tourne dans un bac à sable, ce qui limite ce qu'il peut toucher. Et le mode auto-review, sait parfaitement intercepter toutes les actions à haut risque et les refuser (auto-review, il faut l'activer à la main, pour info). Et le mode full access désactive le bac à sable et les auto-reviews, sachez-le.

Et c'est précisément ce mode que nos trois victimes avaient choisi...

Source

❌