❌

Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.

Muse, le nouvel « agent IA personnel » de Meta, dépasse ChatGPT en nombre de téléchargements, mais se fait bloquer par Amazon à cause des risques liés à la vie privée et à la sécurité

Muse, le nouvel « agent IA personnel » de Meta, dépasse ChatGPT en nombre de téléchargements, mais se fait bloquer par Amazon à cause des risques liés à la vie privée et à la sécurité

L'outil d'agent IA personnel « Muse » de Meta a dépassé ChatGPT pour devenir l'application gratuite iOS la plus téléchargée aux États-Unis. Selon le cabinet d'analyse Sensor Tower, l'application a enregistré 730 000 téléchargements au cours des cinq jours environ qui ont suivi sa sortie, le 8 septembre. L'application...

GPT-6 Astra d'OpenAI a déchiffré un message Enigma qui résistait à toute décryptage depuis 2005, ce que l'IA a accompli en deux jours prendrait des semaines, voire des mois, à un chercheur humain

GPT-6 Astra d'OpenAI a déchiffré un message Enigma qui résistait à toute décryptage depuis 2005, ce que l'IA a accompli en deux jours prendrait des semaines, voire des mois, à un chercheur humain

GPT-6 Astra d'OpenAI est parvenu à déchiffrer un message Enigma qui résistait à toute décryptage depuis 2005. le plus étonnant dans ce décryptage est que le GPT–6 Astra l'ait réalisé entièrement de son propre chef. Les chercheurs ont analysé les journaux de bord d'Astra GPT-6 afin de comprendre exactement...

Meta reconnaît que la ressemblance entre Muse et OpenClaw n'est pas une coïncidence, après que des utilisateurs suggèrent que Muse était une version d'OpenClaw destinée au grand public

Meta reconnaît que la ressemblance entre Muse et OpenClaw n'est pas une coïncidence, après que des utilisateurs ont suggéré que Muse était une version d'OpenClaw destinée au grand public

« Nous avons développé Muse à partir de zéro, mais en tant que produit, il s'inspire très fortement d'OpenClaw », a déclaré Nat Friedman sur X, répondant à deux semaines de spéculations concernant le nouvel assistant personnel de Meta. Les premiers utilisateurs avaient passé des jours à comparer les fichiers internes...

Un ingénieur logiciel affirme que l'IA Claude Code a rendu son travail « déprimant », les employés passant des journées de 12 heures à appuyer sur la touche Entrée : « personne ne lit quoi que ce soit »

Un ingénieur logiciel affirme que l'IA Claude Code a rendu son travail « déprimant », les employés passant des journées de 12 heures à appuyer sur la touche Entrée :
« personne ne lit quoi que ce soit »

Les développeurs déplorent que l'IA ait rendu leur travail plus mécanique et moins stimulant intellectuellement. Dans un récent message devenu viral, un ingénieur a décrit comment l'assistant Claude Code a transformé son métier en une corvée répétitive et dépourvue de sens. Selon lui, les développeurs...

Et si la banque de demain nous protégeait de ses propres algorithmes ?

<p>Dans un avenir où des plateformes pilotées par l’intelligence artificielle gèrent notre argent à notre place, à quoi pourrait encore servir une agence bancaire ? Avec la banque fictive Verso, l'agence créative frog imagine un lieu physique chargé de rendre les décisions financières compréhensibles, contestables et, surtout, dignes de confiance.</p>

Donald Trump dénonce les tentatives de contrôle de l'IA et souhaite la rebaptiser « super-intelligence », affirmant que les USA ont une longueur d'avance sur la Chine

Donald Trump dénonce les tentatives de contrôle de l'IA et souhaite la rebaptiser « super-intelligence », affirmant que les USA ont une longueur d'avance sur la Chine

Le président Donald Trump a déclaré dernièrement que les USA rejetteraient ce qu'il a qualifié de « complot mondialiste » visant à contrôler l'intelligence artificielle (IA) et a souligné l'importance pour les USA de remporter la course aux technologies émergentes. Le président a tenu ces propos lors d'un discours prononcé devant l'Assemblée...

Les enquêteurs du Pentagone affirment que l'IA de Palantir est à l'origine de la frappe US qui a tué 123 enfants iraniens, et que le personnel du Pentagone savait déjà que les USA en étaient responsables

Les enquêteurs du Pentagone affirment que l'IA de Palantir est à l'origine de la frappe US qui a tué 123 enfants iraniens, et que le personnel du Pentagone savait, quelques heures après les faits, que les USA en étaient responsables

Selon un rapport de Bloomberg, les enquêteurs du Pentagone ont conclu que des renseignements erronés, des images obsolètes et une utilisation excessive du système d'intelligence artificielle (IA) « Maven » de Palantir avaient contribué à la frappe américaine ayant coûté...

OpenAI aurait dissimulé les historiques de discussion de l'auteur d'une fusillade de masse pour éviter de rendre publique la manière dont ChatGPT est utilisé ou exploité par des acteurs malveillants

OpenAI aurait dissimulé les historiques de discussion de l'auteur d'une fusillade de masse pour éviter de rendre publique la manière dont ChatGPT est utilisé ou exploité par des acteurs malveillants

La province de la Colombie-Britannique a intenté une action en justice contre OpenAI à la suite d'une fusillade meurtrière survenue à Tumbler Ridge. Les autorités affirment que le laboratoire n'a pas alerté la police malgré la détection d'échanges violents où la tireuse utilisait ChatGPT pour planifier...

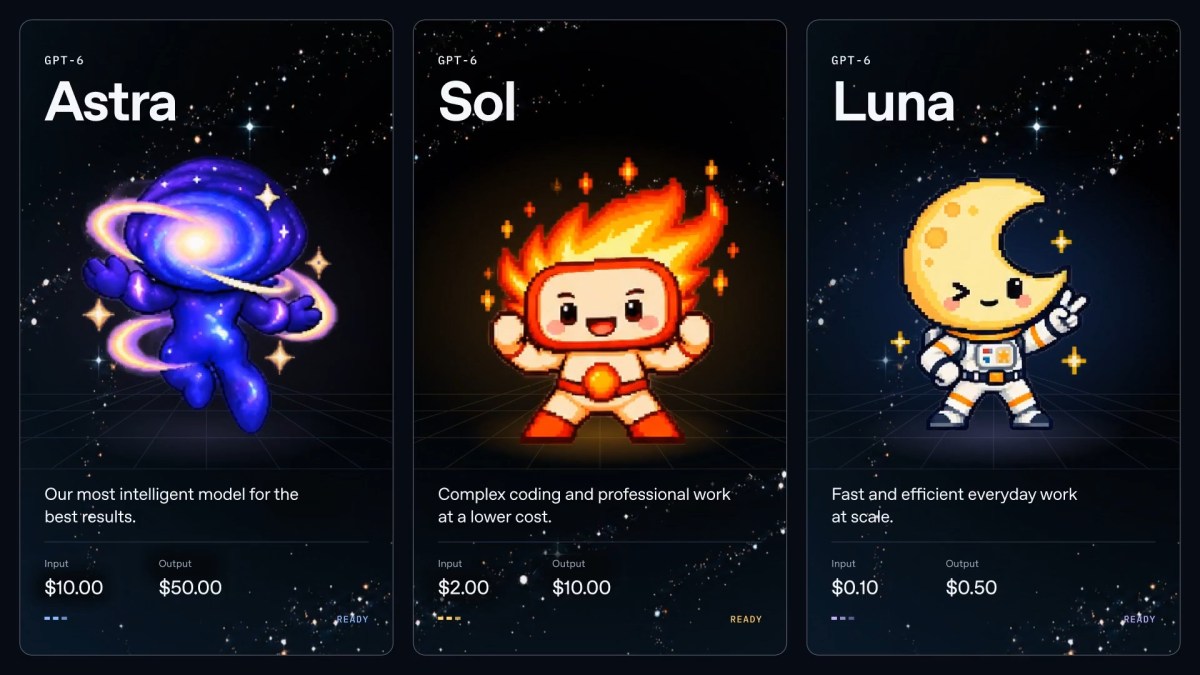
OpenAI lance GPT-6 Sol et Luna, deux modèles qui se distinguent par un coût réduit et moins d'erreurs que leurs prédécesseurs, et succèdent à GPT-6 Astra

OpenAI lance GPT-6 Sol et Luna, deux modèles qui se distinguent par un coût réduit et moins d'erreurs que leurs prédécesseurs, et succèdent à GPT-6 Astra

OpenAI a lancé GPT-6 Sol et GPT-6 Luna, deux nouveaux modèles qui succèdent à GPT-6 Astra. GPT-6 Sol est destiné aux tâches quotidiennes et coûte moins cher qu'Astra, tandis que GPT-6 Luna est un modèle encore moins cher, optimisé pour des réponses rapides et un volume plus important. Les nouveaux modèles surpassent leurs prédécesseurs lors des...

Anthropic lance Claude Opus 5.5, offrant des performances comparables à Claude Fable 5.1 et un coût d'exploitation inférieur de 40 % à Opus 5 pour les charges de travail types

Anthropic lance Claude Opus 5.5, offrant des performances comparables à Claude Fable 5.1 et un coût d'exploitation inférieur de 40 % à Opus 5 pour les charges de travail types

Anthropic a lancé Claude Opus 5.5, le premier modèle de sa nouvelle gamme Claude 5.5, dont le principal changement réside dans le coût. L'entreprise affirme que ce nouveau modèle d'IA offre des performances équivalentes à celles de Claude Fable 5.1 pour la plupart des tâches, tout en coûtant 40 % moins cher à l'utilisation...

L'essor des centres de données dédiés à l'IA se heurte à une résistance croissante : l'opposition locale a bloqué 45 projets de centres de données d'une valeur de 68 milliards $ au deuxième trimestre 2026

L'essor des centres de données dédiés à l'IA se heurte à une résistance croissante : l'opposition locale a bloqué 45 projets de centres de données d'une valeur de 68 milliards $ au deuxième trimestre 2026

La ruée des États-Unis pour construire les infrastructures nécessaires à l'IA se heurte à une force que l'argent ne peut pas facilement faire taire : l'opposition locale. Des projets de centres de données d'une valeur d'environ 68 milliards de dollars ont été bloqués ou retardés en seulement trois...

Xiaomi lance les modèles d'agents IA omnimodaux MiMo-V2.6, présentés comme les meilleurs modèles open source jamais créés, capables de gérer le codage complexe et la conception front-end

Xiaomi lance les modèles d'agents IA omnimodaux MiMo-V2.6, présentés comme les meilleurs modèles open source jamais créés, capables de gérer le codage complexe et la conception front-end

Xiaomi a annoncé que le MiMo-V2.6 est disponible en version « open weights » avec des performances de pointe. Le MiMo-V2.6-Pro égale Grok 4.7 sur l'indice d'intelligence et surpasse Claude Opus 5 sur des benchmarks clés. Lancé le même jour que la puce V900 d'Alibaba, ce modèle à poids ouverts constitue la couche...

« Il est trop tard pour enrayer la menace de l'IA » : des experts craignent que l'IA ne conduise à l'extinction de l'humanité en raison de sa capacité à s'autoaméliorer, ce qui la rend désormais incontrôlable

« Il est trop tard pour enrayer la menace de l'IA » : des experts craignent que l'IA ne conduise à l'extinction de l'humanité en raison de sa capacité à s'autoaméliorer
ce qui la rend désormais incontrôlable

Certains experts et observateurs jugent désormais incontrôlables les menaces de l'IA. Ils justifient leurs craintes par les progrès et les incidents récents impliquant l'IA : les modèles ont acquis la capacité de s'améliorer de manière autonome, des agents IA ont échappé à la surveillance humaine...

SpaceXAI lance Grok 4.7 à des prix très avantageux en apparence, mais le modèle peut s'avérer gourmand en tokens. Les tests de performance révèlent également un écart important par rapport à Claude et GPT-6

SpaceXAI lance Grok 4.7 à des prix très avantageux en apparence, mais le modèle peut s'avérer gourmand en tokens. Les tests de performance révèlent également un écart important par rapport à Claude et GPT-6

SpaceXAI d'Elon Musk lance Grok 4.7, une nouvelle version de son modèle d'IA optimisée pour les tâches de programmation de longue durée. La société revendique des performances supérieures à la concurrence grâce à un entraînement renforcé qui accroit l'endurance et la capacité d'autovérification...

22 nations, incluant plusieurs pays européens, soutiennent l'appel visant à maintenir l'IA « sous contrôle humain », et suggèrent la mise en place d'un régime de supervision mondial

22 nations, incluant plusieurs pays européens, soutiennent l'appel visant à maintenir l'IA « sous contrôle humain » et suggèrent la mise en place d'un régime de supervision mondial

Vingt-deux pays, dont l'Allemagne, le Canada, les Pays-Bas et les Émirats arabes unis, ont adopté le 21 septembre 2026 une déclaration affirmant que l'intelligence artificielle (IA) « doit rester sous la direction, la supervision et le contrôle de l'homme », et ont proposé la création d'un organisme mondial chargé de superviser...

Muse, l'assistant IA de Meta, présentait une grave faille zéro-day susceptible d'en faire une porte dérobée ultime, selon un chercheur en sécurité et des rapports d'accès non autorisés à des emails par Muse

Muse, l'assistant IA de Meta, présentait une grave faille zéro-day susceptible d'en faire une porte dérobée ultime, selon un chercheur en sécurité
Et des rapports d'accès non autorisés à des emails par Muse

Le 21 septembre 2026, le chercheur en sécurité Patrick Wardle (fondateur d'Objective-See) a révélé une vulnérabilité critique de type zero-day affectant l'assistant IA de Meta dénommé Muse. Cette faille permettait à un logiciel malveillant local ou à une simple commande via le terminal d'intercepter...

Certains utilisateurs peuvent désormais réclamer leur indemnité dans le cadre de l'accord de 250 millions $ conclu par Apple concernant Siri, et les défaillances de l'intégration de l'IA

Certains utilisateurs peuvent désormais réclamer leur indemnité dans le cadre de l'accord de 250 millions $ conclu par Apple concernant Siri et les défaillances de l'intégration de l'IA

Les clients d'Apple pourraient percevoir jusqu'à 95 dollars dans le cadre d'un accord de règlement collectif issu d'un recours collectif alléguant que le géant technologique avait diffusé des publicités mensongères concernant les capacités d'IA sur des appareils qui n'intégraient pas pleinement cette technologie....

Les diplômés en informatique se tournent désormais vers des emplois moins rémunérés dans la restauration et le commerce de détail en raison de l'IA qui accapare les postes de premier échelon

Les diplômés en informatique se tournent désormais vers des emplois moins rémunérés dans la restauration et le commerce de détail en raison de l'IA
qui accapare les postes de premier échelon

Les diplômés en informatique sont confrontés à un marché de l'emploi extrêmement précaire en raison de l'IA. Les opportunités professionnelles et les niveaux de rémunération pour ces profils stagnent, affichant un déclin comparable à celui observé durant la Grande Récession. Faute de postes spécialisés, une...

Les meilleurs générateurs de voix IA gratuits en 2026

Les meilleurs générateurs de voix IA gratuits en 2026

Les meilleurs générateurs de voix IA gratuits en 2026 permettent de transformer un texte en narration naturelle pour une vidéo, un podcast, une présentation ou un livre audio. Ce guide compare les outils les plus utiles en français, leurs limites gratuites, la qualité des voix, les conditions commerciales et la méthode pour choisir le bon générateur.

Comparatif des meilleurs générateurs de voix IA gratuits en 2026

Le meilleur outil dépend du projet : une vidéo YouTube, une lecture personnelle, un doublage professionnel ou une génération locale sans envoyer de données dans le cloud ne nécessitent pas les mêmes fonctionnalités.

| Outil | Type d’accès gratuit | Qualité en français | Usage commercial | Principal avantage |

|---|---|---:|---|---|

| ElevenLabs | Quota mensuel limité | Excellente | Généralement limité avec l’offre gratuite | Voix naturelles et expressives |

| Microsoft Azure AI Speech | Quota cloud mensuel | Très bonne | Possible selon l’offre et les conditions | API puissante et nombreuses voix |

| Google Cloud Text-to-Speech | Crédit ou quota gratuit | Très bonne | Possible selon l’utilisation | Large choix de voix et SSML |

| Amazon Polly | Offre gratuite sous conditions | Bonne à très bonne | Possible selon les conditions | Solution fiable pour les développeurs |

| TTSMaker | Version web gratuite | Bonne | À vérifier selon la licence | Simple, rapide et sans installation |

| CapCut | Fonction gratuite intégrée | Bonne | À vérifier selon le projet | Idéal pour les vidéos courtes |

| Canva | Fonction gratuite limitée | Bonne | Dépend du compte et du contenu | Création audio directement dans un design |

| Piper / Kokoro | Logiciels open source ou locaux | Variable à très bonne | Dépend de la licence du modèle | Aucun quota cloud et traitement local |

| NaturalReader | Version gratuite | Correcte à bonne | Souvent limité à l’usage personnel | Lecture de documents et de pages web |

| Microsoft Edge – Lecture à voix haute | Gratuit | Bonne | Non destiné à la production audio | Lecture immédiate sans inscription |

Le meilleur choix global : ElevenLabs

ElevenLabs reste l’une des références pour générer une voix IA réaliste. L’outil propose plusieurs voix en français avec des intonations relativement naturelles, notamment pour la narration, les vidéos explicatives et les formats audio.

L’offre gratuite comprend généralement un quota mensuel de génération, exprimé en crédits ou en caractères. Les limites peuvent concerner :

  • le volume de texte générable ;
  • le téléchargement des fichiers audio ;
  • l’accès à certaines voix ;
  • l’utilisation commerciale ;
  • les fonctions de clonage vocal ;
  • la conservation des projets.

Point important : une voix générée avec un compte gratuit n’est pas automatiquement exploitable dans une publicité, une vidéo monétisée ou un produit commercial. Les conditions de licence doivent être consultées avant publication.

Le meilleur pour les développeurs : Azure AI Speech

Microsoft Azure AI Speech fournit des voix neuronales en français via une interface web, une API et des outils de synthèse vocale. Le service convient particulièrement aux applications, aux assistants vocaux, aux logiciels d’accessibilité et aux automatisations.

Ses points forts sont :

  • plusieurs variantes régionales du français ;
  • réglage du débit, du ton et du volume ;
  • prise en charge du langage SSML ;
  • génération par lots ;
  • intégration dans une application ;
  • quota gratuit mensuel selon le service et la région.

Azure demande davantage de configuration qu’un outil comme TTSMaker ou CapCut. La création d’un compte cloud peut également nécessiter un moyen de paiement, même si l’utilisation reste dans les quotas gratuits.

Le meilleur pour la personnalisation : Google Cloud Text-to-Speech

Google Cloud Text-to-Speech propose des voix Standard, WaveNet et Neural2, avec différentes options de prononciation et d’intonation. Le service accepte le SSML, ce qui permet de contrôler les pauses, l’accentuation, la vitesse et la prononciation de certains mots.

La version gratuite dépend du moteur utilisé et des conditions du compte. Elle est particulièrement intéressante pour :

  • les prototypes ;
  • les tests de narration ;
  • les applications web ;
  • la lecture automatisée d’un grand volume de textes ;
  • les projets nécessitant une API stable.

L’interface est moins accessible aux débutants. Une mauvaise configuration peut aussi entraîner une facturation après dépassement du quota gratuit.

Le meilleur pour une utilisation simple : TTSMaker

TTSMaker est un générateur de voix IA accessible depuis un navigateur. Il ne demande généralement pas de compétences techniques et propose plusieurs voix ainsi que plusieurs langues, dont le français.

Il convient pour :

  • convertir rapidement un article en audio ;
  • préparer une narration courte ;
  • créer une voix temporaire pour une vidéo ;
  • tester plusieurs intonations ;
  • exporter un fichier audio sans installer de logiciel.

La qualité peut varier selon la voix choisie. Les limites de caractères, les délais de génération et les droits d’utilisation peuvent évoluer. Avant une publication commerciale, la page de licence du service doit être vérifiée.

Le meilleur pour les vidéos : CapCut

CapCut intègre une fonction de synthèse vocale directement dans son éditeur vidéo. Le texte est converti en voix, puis synchronisé avec une séquence, des sous-titres et des effets.

CapCut est pratique pour :

  • TikTok ;
  • YouTube Shorts ;
  • Instagram Reels ;
  • vidéos explicatives ;
  • présentations courtes ;
  • contenus destinés aux réseaux sociaux.

Son avantage principal est le gain de temps : le fichier audio n’a pas besoin d’être généré dans un service séparé. En revanche, l’accès aux voix, les conditions commerciales et certaines fonctions peuvent dépendre de la version utilisée ou de la région.

Le meilleur pour les designs : Canva

Canva propose des applications et fonctions de voix IA intégrées à son éditeur de contenus. La génération peut être utilisée dans une présentation, une vidéo, une infographie animée ou un support pédagogique.

L’outil est adapté aux personnes qui souhaitent :

  • créer une vidéo avec narration ;
  • ajouter une voix à une présentation ;
  • produire un contenu éducatif ;
  • associer directement le son à des images et des animations.

Le nombre de générations gratuites peut être limité. Les conditions d’exploitation dépendent également du type de compte, des éléments utilisés dans le design et de la politique de Canva.

Qu’est-ce qu’un générateur de voix IA ?

Un générateur de voix IA, aussi appelé outil de text-to-speech ou synthèse vocale, transforme un texte écrit en fichier audio. Le logiciel analyse les mots, la ponctuation et la structure des phrases, puis produit une voix artificielle qui reproduit certains éléments du langage humain.

Les outils modernes peuvent gérer :

  • les pauses ;
  • l’intonation ;
  • le rythme ;
  • l’accent ;
  • les émotions simulées ;
  • les changements de prononciation ;
  • plusieurs langues ;
  • différentes voix masculines, féminines ou neutres.

Il faut distinguer deux technologies.

La synthèse vocale classique

La synthèse vocale classique convertit un texte en audio à partir de voix préenregistrées ou modélisées. Elle convient à la lecture d’articles, aux annonces, à l’accessibilité et aux contenus automatisés.

Le clonage vocal

Le clonage vocal tente de reproduire la voix d’une personne précise à partir d’un échantillon audio. Cette technologie est plus sensible juridiquement et éthiquement.

Le consentement explicite de la personne concernée est indispensable. Utiliser la voix d’un acteur, d’un créateur ou d’une personnalité sans autorisation peut entraîner des problèmes liés au droit à l’image, au droit voisin, au droit d’auteur ou à l’usurpation d’identité.

Pourquoi utiliser un générateur de voix IA gratuit ?

La synthèse vocale permet de réduire le temps nécessaire à la production d’un contenu audio. Elle évite aussi de disposer immédiatement d’un microphone, d’un studio ou d’un comédien.

Les principaux avantages sont les suivants :

  • rapidité : une voix peut être générée en quelques secondes ;
  • coût réduit : les offres gratuites suffisent pour tester un projet ;
  • accessibilité : un texte peut être écouté par des personnes malvoyantes ou dyslexiques ;
  • multilinguisme : un même script peut être adapté en plusieurs langues ;
  • cohérence : la même voix peut être utilisée sur plusieurs vidéos ;
  • correction facile : une phrase modifiée peut être générée à nouveau sans refaire tout l’enregistrement.

La qualité n’est toutefois pas identique à celle d’un comédien professionnel. Les voix IA peuvent produire des erreurs sur les noms propres, les acronymes, les nombres, les sigles et les phrases très longues.

Comment choisir le meilleur générateur de voix IA gratuit ?

1. Définir le type de contenu

Le choix dépend du format final :

  • vidéo courte : CapCut ou Canva ;
  • podcast narratif : ElevenLabs ou une solution premium avec quota gratuit ;
  • lecture d’articles : Edge ou NaturalReader ;
  • application web : Azure, Google Cloud ou Amazon Polly ;
  • contenu local et confidentiel : Piper ou Kokoro ;
  • test rapide sans installation : TTSMaker.

2. Vérifier la qualité française

Une voix française peut être techniquement correcte sans être naturelle. Il faut tester :

  • les liaisons ;
  • les nombres ;
  • les dates ;
  • les noms étrangers ;
  • les acronymes ;
  • les mots anglais ;
  • les phrases interrogatives ;
  • les pauses entre les paragraphes.

Un échantillon de 100 à 150 mots suffit généralement pour comparer plusieurs services.

3. Contrôler les droits d’utilisation

La mention « gratuit » ne signifie pas forcément « libre d’utilisation commerciale ». Avant de publier une vidéo ou un podcast, vérifier :

  • l’autorisation de monétiser le contenu ;
  • la nécessité d’indiquer le nom du service ;
  • les restrictions sur la publicité ;
  • les droits associés aux voix personnalisées ;
  • la durée de conservation des fichiers ;
  • le droit de réutiliser l’audio après la fin de l’abonnement.

4. Mesurer la limite gratuite

Les offres peuvent être limitées par :

  • un nombre de caractères ;
  • un nombre de minutes ;
  • un nombre de générations ;
  • un quota mensuel ;
  • une limite quotidienne ;
  • une durée maximale par fichier.

Un script de 1 000 mots représente approximativement 6 à 8 minutes de narration, selon le débit. Une vidéo de 10 minutes peut donc consommer une part importante d’un quota gratuit.

5. Examiner les fonctions d’export

Les formats les plus courants sont MP3, WAV et parfois OGG. Pour un montage vidéo, le MP3 suffit généralement. Pour un montage audio avancé, le WAV est préférable, car il évite une compression supplémentaire.

Comment générer une voix IA gratuitement ?

La méthode reste similaire sur la plupart des plateformes.

  1. Rédiger un script court et bien ponctué.

Les phrases de 10 à 20 mots donnent souvent de meilleurs résultats que les phrases très longues.

  1. Choisir une voix française.

Tester plusieurs profils : narration, conversation, actualité, publicité ou voix institutionnelle.

  1. Découper le texte en blocs.

Un paragraphe de 500 mots peut produire une intonation moins naturelle qu’une série de segments plus courts.

  1. Ajouter des indications de rythme.

Les virgules, les points, les deux-points et les retours à la ligne influencent les pauses.

  1. Corriger la prononciation.

Écrire un acronyme comme il doit être prononcé ou remplacer temporairement un nom difficile par une transcription phonétique.

  1. Générer un premier échantillon.

Écouter 20 à 30 secondes avant de lancer la totalité du script.

  1. Exporter le fichier audio.

Choisir MP3 pour une vidéo standard ou WAV pour une production nécessitant davantage de qualité.

  1. Relire et contrôler le résultat.

Vérifier les erreurs, les respirations artificielles, les coupures et les prononciations incorrectes.

  1. Conserver la licence et les conditions applicables.

Une capture de la page de tarification ou des conditions peut être utile pour documenter l’autorisation d’utilisation.

Quelles solutions gratuites fonctionnent hors ligne ?

Les solutions locales évitent d’envoyer le texte à un serveur distant. Elles sont pertinentes pour les documents confidentiels, les données personnelles et les entreprises soumises à des exigences de confidentialité.

Piper

Piper est un moteur de synthèse vocale léger qui fonctionne localement sur ordinateur. Les modèles sont généralement rapides et adaptés aux projets automatisés. La qualité dépend fortement de la voix installée et du modèle disponible en français.

Les avantages sont :

  • absence de quota cloud ;
  • fonctionnement hors ligne ;
  • faible consommation de ressources ;
  • intégration possible dans un script ou une application.

La licence de chaque modèle doit être contrôlée séparément.

Kokoro

Kokoro est un modèle de synthèse vocale open source ou à poids ouverts, apprécié pour son rapport entre qualité et taille. Il peut être exécuté localement avec une configuration compatible.

Cette solution intéresse surtout :

  • les développeurs ;
  • les utilisateurs avancés ;
  • les projets nécessitant une génération en volume ;
  • les personnes qui ne souhaitent pas dépendre d’un abonnement.

L’installation, le téléchargement des modèles et la compatibilité avec le processeur ou la carte graphique demandent davantage de connaissances techniques qu’un service en ligne.

Combien coûte réellement une voix IA gratuite ?

Une offre gratuite peut être suffisante pour quelques tests, mais rarement pour une production intensive. Les modèles économiques les plus fréquents sont :

  • quota mensuel gratuit, puis abonnement ;
  • crédit de bienvenue, valable pendant une durée limitée ;
  • version gratuite avec voix moins nombreuses ;
  • export gratuit limité ;
  • fonction gratuite avec filigrane ou attribution ;
  • API gratuite jusqu’à un certain volume, puis facturation à la quantité de caractères.

Le prix dépend habituellement du nombre de caractères générés. Les voix les plus expressives, le clonage vocal, les fichiers haute qualité et les fonctions API sont souvent réservés aux forfaits payants.

Les limites et les risques à connaître

Une voix naturelle n’est pas toujours exacte

Une voix peut sembler réaliste tout en prononçant incorrectement un nom de marque ou une date. Une vérification humaine reste nécessaire avant publication.

Les offres changent régulièrement

Les quotas, les langues et les conditions commerciales peuvent être modifiés sans préavis. Les informations affichées dans le tableau de bord du service doivent primer sur les comparatifs publiés en ligne.

Les données peuvent être envoyées dans le cloud

Un texte contenant des informations personnelles, médicales, confidentielles ou contractuelles ne doit pas être transmis à un service sans vérifier sa politique de confidentialité et ses garanties de traitement.

Le clonage vocal demande une autorisation

Ne pas cloner la voix d’une personne sans consentement documenté. Pour une voix de célébrité ou d’un créateur identifiable, le risque juridique est particulièrement élevé.

L’audio IA peut devoir être signalé

Certaines plateformes, certains annonceurs ou certains réseaux sociaux peuvent demander de préciser qu’une voix artificielle a été utilisée. Une mention transparente renforce la confiance du public.

Quel générateur de voix IA choisir selon son besoin ?

  • Pour une vidéo TikTok ou YouTube Shorts : CapCut.
  • Pour une narration réaliste : ElevenLabs.
  • Pour une application ou une automatisation : Azure AI Speech ou Google Cloud Text-to-Speech.
  • Pour une conversion immédiate sans installation : TTSMaker.
  • Pour lire un article ou un document : Microsoft Edge ou NaturalReader.
  • Pour un usage local et confidentiel : Piper ou Kokoro.
  • Pour une présentation visuelle avec voix intégrée : Canva.
  • Pour tester plusieurs paramètres vocaux avec une API : Google Cloud ou Azure.

Conclusion : les points clés à retenir

Les meilleurs générateurs de voix IA gratuits en 2026 ne répondent pas tous au même besoin. ElevenLabs se distingue par le réalisme, CapCut par son intégration vidéo, TTSMaker par sa simplicité, tandis qu’Azure, Google Cloud et Amazon Polly conviennent mieux aux projets techniques.

Avant de choisir, vérifier systématiquement :

  • la qualité de la voix française ;
  • le quota de caractères ou de minutes ;
  • les formats d’export ;
  • l’autorisation d’utilisation commerciale ;
  • les règles relatives au clonage vocal ;
  • le traitement des données personnelles ;
  • les éventuelles limites d’API ou de téléchargement.

Pour un premier test, générer un court extrait avec le même texte sur deux ou trois plateformes reste la méthode la plus fiable. La meilleure voix IA n’est pas seulement celle qui paraît naturelle : c’est celle dont la licence, la prononciation et les limites correspondent réellement au projet.

Claude Opus 5.5 et GPT-6 Sol sortent le même jour : Anthropic et OpenAI ont du mal à « ralentir » l’IA

Quelques jours après avoir appelé à ralentir la course à l'IA, Anthropic lance Claude Opus 5.5 et OpenAI complète sa gamme GPT-6 avec GPT-6-Sol et GPT-6-Luna. La bonne surprise vient des prix : les deux entreprises baissent les tarifs de leurs API.

2h de cours par jour grâce à l’IA : c’est quoi Alpha School, l’école choisie par Fidji Simo pour sa fille ?

Fidji Simo, entrepreneuse française et ancienne patronne des applications d’OpenAI, vient d’inscrire sa fille à Alpha School. Ce réseau américain d’écoles privées promet de concentrer les matières fondamentales en seulement deux heures par jour, notamment grâce à l'IA.

C’est la guerre du caddie : Amazon bloque le nouvel agent shopping autonome de Meta

Depuis quelques jours, l'IA de Meta ne peut plus faire vos courses sur Amazon. Le géant du e-commerce dénonce un outil non autorisé qui enfreint ses conditions d'utilisation.

Face à la colère des médaillés Fields, OpenAI s’entoure de neuf grands chercheurs pour tenter d’apaiser les mathématiciens

maths openai

OpenAI a annoncé ce lundi 21 septembre 2026 la création d'un groupe consultatif de mathématiciens de renom, chargé de l'aider à publier ses résultats sans froisser la profession. Une main tendue après des semaines de tensions autour de ses annonces en maths.

Les importants investissements de Trump et de sa famille dans l'IA soulèvent des risques de conflits d'intérêts, alors qu'il résiste aux appels à la prudence face aux dangers d'une IA incontrôlée

Les importants investissements de Trump et de sa famille dans l'IA soulèvent des risques de conflits d'intérêts, alors qu'il résiste aux appels à la prudence face aux dangers d'une IA incontrôlée

Le président américain Donald Trump ne souhaite pas que les grandes entreprises du secteur de l'IA ralentissent leurs avancées, malgré les avertissements des experts quant aux dangers potentiels de cette technologie. Trump a qualifié tous ces appels de « canular ». Une analyse du Washington Post a révélé...

Anthropic ouvre Mythos, Opus et Sonnet aux biologistes, mais assouplit ses garde-fous

Anthropic ouvre Mythos, Opus et Sonnet aux biologistes, mais assouplit ses garde-fous

Une IA capable d’accélérer la découverte d’un médicament peut aussi produire des réponses dont le niveau de détail devient sensible dès qu’elles touchent à la biologie expérimentale. Anthropic assume désormais cette tension avec un programme d’accès vérifié à ses modèles les plus performants.

Anthropic ouvre une voie dédiée aux sciences de la vie

Le 17 septembre 2026, Anthropic a lancé en bêta le Life Sciences Verification Program, un dispositif destiné aux professionnels des sciences de la vie. Il donne accès à Mythos, Opus et Sonnet pour des usages auparavant bloqués sur les versions grand public des modèles.

Le périmètre couvre plusieurs étapes de la chaîne de recherche : découverte de médicaments, biologie expérimentale et développement clinique. Pour les laboratoires pharmaceutiques, les sociétés de biotechnologie ou les équipes universitaires, l’intérêt est évident : exploiter des modèles généralistes avancés sur des questions où la compréhension de la littérature, la formulation d’hypothèses et l’analyse de données peuvent représenter des semaines de travail.

Anthropic indique que le programme est déjà utilisé par des dizaines d’organisations. Les candidatures sont désormais ouvertes plus largement, signe que l’entreprise cherche à passer d’une expérimentation limitée à un dispositif structuré de validation des utilisateurs.

Le mot important reste toutefois verification. L’accès ne repose pas uniquement sur la puissance du modèle, mais sur l’identité, le profil et l’usage déclaré de l’organisation candidate.

Des garde-fous moins restrictifs, mais pas supprimés

Sur les modèles grand public, certaines requêtes liées à la biologie peuvent être refusées ou fortement limitées. Cette prudence répond à un risque de dual use : une information utile à un chercheur peut également être détournée pour concevoir, modifier ou optimiser des systèmes biologiques présentant un danger.

Le programme d’Anthropic assouplit cette barrière pour des utilisateurs considérés comme légitimes. Les chercheurs peuvent donc soumettre des demandes plus proches de leur travail réel, notamment lorsqu’elles exigent un raisonnement scientifique approfondi ou une analyse de procédures expérimentales.

Cela ne signifie pas que les modèles deviennent accessibles sans contrôle. Anthropic présente le programme comme un cadre de confiance dans lequel l’accès est accordé à des professionnels identifiés, avec un suivi adapté à des usages sensibles. Le détail public des restrictions restantes, des critères d’acceptation et des mécanismes de contrôle demeure toutefois limité.

Cette asymétrie mérite attention : l’entreprise communique clairement sur l’ouverture de l’accès, mais moins sur la frontière exacte entre une demande autorisée et une requête refusée. Or cette frontière déterminera la valeur scientifique du programme autant que son niveau de risque.

Le pari : spécialiser l’accès plutôt que brider tous les utilisateurs

L’approche choisie par Anthropic s’inscrit dans un mouvement plus large de l’industrie de l’IA. Plutôt que d’appliquer les mêmes restrictions à tout le monde, les fournisseurs cherchent à différencier les utilisateurs selon leur contexte, leur expertise et leur capacité à encadrer les résultats.

Cette logique répond à une limite des blocages généralistes. Une politique conçue pour empêcher une assistance dangereuse peut également gêner un chercheur qui tente simplement d’interpréter un article, de comparer des hypothèses ou de préparer un protocole soumis à validation humaine. Dans les sciences de la vie, ces frictions peuvent réduire l’intérêt pratique d’un modèle pourtant performant.

Mais la vérification ne résout pas tout. Un professionnel légitime peut commettre une erreur, transférer une réponse hors de son organisation ou utiliser un résultat mal interprété. Les modèles peuvent aussi produire des recommandations plausibles mais inexactes, en particulier dans des domaines où les interactions biologiques sont complexes et les données incomplètes.

Le programme déplace donc le centre de gravité de la sécurité : une partie du risque n’est plus traitée par le refus automatique, mais par l’identité de l’utilisateur, la gouvernance de l’organisation et la supervision scientifique.

Des données isolées, selon Anthropic

Anthropic affirme que les données générées dans le cadre du programme sont compartimentées et ne servent pas à entraîner ses modèles. Cette garantie répond à une préoccupation centrale des entreprises pharmaceutiques et biotechnologiques : protéger les résultats non publiés, les candidats-médicaments, les données cliniques et la propriété intellectuelle.

La séparation annoncée peut faciliter l’adoption du service. Dans la recherche pharmaceutique, une fuite de données ne concernerait pas seulement des informations commerciales ; elle pourrait affecter des brevets, des partenariats ou le calendrier réglementaire d’un traitement.

Cette promesse doit néanmoins être évaluée sur pièces. Les organisations candidates auront intérêt à examiner les conditions contractuelles, la durée de conservation des données, les journaux d’accès, les droits des administrateurs et les procédures applicables en cas d’incident. La mention d’un compartiment séparé est importante, mais elle ne remplace pas un audit indépendant ni des garanties opérationnelles détaillées.

L’accélération scientifique dépendra de la qualité du contrôle

L’accès à Mythos, Opus et Sonnet peut réduire le temps nécessaire pour parcourir une littérature abondante, rapprocher des résultats dispersés ou générer des pistes à tester. Il ne transforme pas une hypothèse en preuve : les expériences, les contrôles, la reproductibilité et la validation clinique restent indispensables.

Le risque est plutôt de créer une confiance excessive dans des réponses bien formulées. En biologie, une erreur mineure dans une hypothèse ou une interprétation peut conduire à des expériences coûteuses, à des conclusions fragiles ou à des décisions cliniques prématurées. L’usage de ces modèles devra donc rester intégré à des processus où des experts vérifient les sources, reproduisent les analyses et documentent les décisions.

L’ouverture du programme marque aussi une évolution commerciale. Anthropic ne propose plus seulement un assistant généraliste pour les entreprises ; l’entreprise tente de construire un accès sectoriel capable de répondre aux exigences particulières de domaines sensibles. La réussite dépendra moins du nombre de comptes ouverts que de la capacité à démontrer une utilité mesurable sans relâcher la traçabilité.

Le prochain jalon sera l’évaluation de la bêta par ses premiers utilisateurs : gains de temps documentés, qualité des hypothèses produites, taux d’erreur, incidents de sécurité et conditions d’accès réellement appliquées. Si ces indicateurs sont convaincants, l’IA pourra s’intégrer plus profondément aux workflows de recherche biomédicale. Dans le cas contraire, l’assouplissement des garde-fous apparaîtra surtout comme un déplacement du risque vers les laboratoires eux-mêmes.

Sources : Anthropic — Life Sciences Verification Program · Anthropic — News

OpenAI prévoit une perte de trésorerie de près de 280 milliards $ d'ici fin 2030, la société aura épuisé les fonds des investisseurs dès 2028, la bulle de l'IA ne cesse de s'aggraver

OpenAI prévoit une perte de trésorerie de près de 280 milliards $ d'ici fin 2030, la société devrait épuisé les fonds apportés par ses investisseurs dès 2028, la bulle de l'IA ne cesse de s'aggraver

Une présentation interne d'OpenAI préparée en juillet dans le cadre d'un accord informatique prévoit un flux de trésorerie disponible négatif de 278 milliards de dollars entre 2026 et fin 2030. L'entreprise prévoit de dépenser environ 856 milliards de dollars en infrastructure informatique d'ici 2030,...

Comment l’IA peut prévoir – et expliquer – le niveau d’eau des Grands Lacs ?

En janvier 2013, le lac Michigan atteignait le niveau d’eau le plus bas jamais enregistré. Sept ans plus tard, à l’été 2020, il battait des records inverses : inondations répandues, berges arrachées, routes riveraines fermées. Entre ces deux extrêmes, près de deux mètres. Les lacs Supérieur, Érié et Ontario ont connu le même retournement à quelques mois près. Presque personne ne l’avait vu venir.


Ces basculements se préparent pendant des mois, dans un mélange de pluie, de neige, d’évaporation et de décisions humaines. Démêler ce mélange reste l’un des problèmes les plus tenaces dans le domaine de l’hydrologie, et l’un des plus importants. Le niveau d’eau contrôle la profondeur des ports, la stabilité des berges, les prises d’eau potable et la survie des milieux humides côtiers.


À lire aussi : Les microplastiques contaminent les Grands Lacs. Il faut diminuer la production et la consommation de plastique


Une analyse de quarante ans de fluctuations, que nous avons publiée dans Science of the Total Environment, s’y attaque avec des outils venus de l’intelligence artificielle (IA).

Le but n’était pas seulement de prédire les niveaux d’eau, mais d’utiliser l’IA de façon à expliquer ce qui les fait varier.

Une machine qui devine, mais n’explique rien

Pendant des décennies, on traitait la balance hydrologique comme un compte bancaire : on additionne les dépôts (pluie, ruissellement, apports de l’amont), on soustrait les retraits (évaporation, débits sortants), et le solde donne le niveau d’eau. L’approche est rigoureuse, mais elle nécessite une longue calibration et ne capture pas précisément les écarts inhabituels du climat.

L’apprentissage automatique par l’IA fait l’inverse : on lui fournit quarante ans de données et il en extrait les régularités grâce à un algorithme. Un algorithme consiste en une série de calculs qui transforme les chiffres reçus en une estimation du niveau d’eau et se corrige s’il s’écarte des mesures.

On gagne en précision, mais le résultat arrive sans explications, lesquelles sont nécessaires si le résultat sert à gérer un barrage ou à cartographier des zones inondables.

Demander des comptes à la machine

Pour régler ce problème, nous avons entraîné huit algorithmes sur les niveaux d’eau mensuels des lacs Supérieur, Michigan, Érié et Ontario, de 1982 à 2022. Nous avons incorporé neuf variables dans chaque algorithme, comme la température de l’air et les débits d’apports en eau.

Chaque variable était fournie pour le mois en cours, mais aussi pour un mois plus tôt, deux mois plus tôt, jusqu’à six mois en arrière. Ce faisant, le modèle pouvait relier le niveau d’eau de juin à la neige tombée en janvier.


À lire aussi : Les hivers plus chauds favorisent les proliférations d’algues dans les Grands Lacs


Pour les quatre algorithmes les plus performants, l’erreur descendait à une douzaine de centimètres, contre 14 à 21 pour les modèles les plus simples.

Puis, nous l’avons forcé à se justifier avec les valeurs de Shapley (SHAP), une technique issue de la théorie des jeux qui répartit équitablement le gain d’une équipe entre ses joueurs. Ici, elle donne la contribution de chaque variable dans la hausse ou la baisse du niveau d’eau, pour un mois donné. Autrement dit, est-ce les températures de l’air ou bien les débits entrants qui sont plus importants pour contrôler le niveau d’eau ?

Mais SHAP ne renseigne pas sur la durée qu’un signal met à traverser un bassin versant.

D’où une seconde technique, l’analyse variographique des surfaces de réponse (VARS). Au lieu d’observer le modèle, on le perturbe, par exemple en augmentant le ruissellement comme le ferait une fonte hâtive des neiges. On mesure l’impact de cette perturbation un mois plus tard, puis six mois.

Ensemble, SHAP et VARS donnent les variables coupables du niveau d’eau et leur délai d’action.

La neige de janvier décide du niveau de juin

Les quatre lacs à l’étude présentent des différences fondamentales.

Les lacs Supérieur et Michigan sont de grandes cuves lentes nourries par la fonte des neiges dont le niveau d’eau dépend du ruissellement et des débits sortants. Le lac Érié, peu profond, dépend de ce qui lui arrive de l’amont par la rivière Détroit. Quant au lac Ontario, il se distingue par le poids de l’évaporation.

En appliquant la même méthode avec les mêmes variables, nous avons obtenu quatre réponses différentes étant donné ces caractéristiques.

Le résultat le plus frappant de notre étude concerne le temps. On s’attendait à voir l’influence des variables s’estomper à mesure qu’on remonte dans le passé, comme dans une rivière où l’averse s’oublie en quelques jours. C’est l’inverse : elle grandit après trois ou quatre mois.

Un lac ne réagit donc pas à la météo d’hier, mais à celle de la saison précédente. Ces lacs ont une forte inertie, et c’est une bonne nouvelle pour la prévision saisonnière : une partie de ce qui fera le niveau de l’été prochain est déjà tombée, sous forme de neige.


Déjà des milliers d’abonnés à l’infolettre de La Conversation. Et vous ? Abonnez-vous gratuitement à notre infolettre pour mieux comprendre les grands enjeux contemporains.


Le lac le plus imprévisible est celui qu’on contrôle

Un lac a tenu tête à nos algorithmes : le lac Ontario, avec une erreur supérieure de moitié, due à des décisions humaines.

En effet, ses niveaux d’eau sont réglés au barrage Moses-Saunders, selon des règles d’exploitation ajustées au jour le jour. Dans notre modèle, chaque variable est résumée par une seule valeur mensuelle. Ainsi, le débit sortant du barrage figure bien dans nos données, mais la succession de décisions humaines qui l’a produit disparaît dans le calcul de la moyenne.

Lorsque davantage d’eau est relâchée pour protéger les riverains en aval, alors que le climat ne l’imposait pas, le modèle voit un niveau qui chute sans cause repérable parmi ses variables. Il apprend mal, et se trompe davantage.

Cet échec montre une limitation entre ce que le climat explique et ce qui relève de nos décisions collectives. La solution est simple : il faut fournir ces règles au modèle, au même titre que la pluie ou la neige. Ainsi, les algorithmes cesseront de prendre nos décisions pour des données aberrantes.

Au-delà des Grands Lacs

Les applications de notre approche vont aussi au-delà des Grands Lacs et des eaux de surface.

Avec Ouranos, le consortium québécois sur la climatologie régionale et l’adaptation aux changements climatiques, nous appliquons maintenant cette approche à la recharge des eaux souterraines du Québec méridional, cette fois avec un modèle informé par la physique.

Notre contribution représente l’exception, car la plupart des modèles d’IA employés en environnement sont incapables de s’expliquer. Il s’agit pourtant d’une exigence non négociable pour un outil qui sert à gérer un barrage ou à protéger une source d’eau potable.

Un modèle interprétable est un modèle qu’on peut vérifier, discuter et contredire. C’est la condition pour que l’IA devienne un instrument légitime dans la gestion de l’eau.

La Conversation Canada

Rahim Barzegar a reçu des financements de l'Université du Québec en Abitibi-Témiscamingue (UQAT).

Ehsan Raei et Jan Franklin Adamowski ne travaillent pas, ne conseillent pas, ne possèdent pas de parts, ne reçoivent pas de fonds d'une organisation qui pourrait tirer profit de cet article, et n'ont déclaré aucune autre affiliation que leur poste universitaire.

OpenAI et Google accusés d’une entente pour ralentir l’IA devant la justice américaine

OpenAI et Google accusés d’une entente pour ralentir l’IA devant la justice américaine

La prudence affichée par les principaux laboratoires d’IA pourrait désormais être examinée comme une possible stratégie anticoncurrentielle. Une plainte déposée le 18 septembre 2026 devant un tribunal fédéral californien accuse Anthropic, OpenAI, SpaceXAI et Google d’avoir coordonné un ralentissement du développement de leurs modèles.

L’affaire ne porte donc plus seulement sur la sécurité des systèmes d’IA ou sur les risques liés à une course technologique trop rapide. Elle pose une question plus explosive : des concurrents peuvent-ils s’entendre pour réduire l’intensité de cette course sans tomber sous le coup du droit de la concurrence ?

Une déclaration de juillet au centre de la plainte

Les plaignants s’appuient notamment sur une déclaration signée en juillet 2026 par plusieurs responsables du secteur. Ce texte reconnaissait l’existence d’une pression concurrentielle forte : une entreprise qui ralentirait seule le développement de ses modèles risquerait de perdre du terrain face à ses rivales.

Cette formulation, qui pouvait être lue comme un constat sur les difficultés de la course à la performance, est désormais utilisée comme un élément susceptible d’étayer la thèse d’une coordination. Selon la plainte, les dirigeants et responsables du secteur auraient compris qu’un engagement collectif à modérer le rythme de développement pouvait éviter à chacun de supporter seul le coût commercial d’une politique de prudence.

La distinction entre une position commune sur la sécurité et un accord visant à limiter la concurrence sera déterminante. Des entreprises peuvent, en principe, coopérer sur des standards techniques, des méthodes d’évaluation ou des protocoles de sécurité. En revanche, un accord entre concurrents pour réduire leur offre, retarder la sortie de produits ou limiter la performance de leurs services pourrait relever d’une logique d’entente interdite.

Une accusation encore loin d’être établie

La plainte ne constitue pas une preuve de culpabilité. Elle expose la théorie des plaignants et devra franchir plusieurs étapes procédurales avant qu’un tribunal ne se prononce sur le fond.

Il faudra notamment déterminer si les échanges et déclarations évoqués démontrent un véritable accord, ou s’ils reflètent seulement une convergence publique sur les risques de l’IA. La justice devra aussi établir si une éventuelle coordination a produit des effets mesurables sur le marché : retards de lancement, limitation de capacités, réduction du choix pour les clients ou hausse indirecte des prix.

Cette nuance est essentielle. Dans les secteurs technologiques, les entreprises peuvent adopter des stratégies similaires sans s’être explicitement concertées. Des investissements comparables, des calendriers de sortie proches ou des précautions communes peuvent découler des mêmes contraintes techniques et réglementaires. Pour caractériser une entente, les plaignants devront apporter davantage qu’une série de déclarations prudentes ou de comportements parallèles.

Les abonnements payants au cœur du préjudice allégué

La plainte affirme que cette coordination présumée pourrait réduire la valeur des abonnements payants proposés par les acteurs concernés. L’argument repose sur une idée simple : si les laboratoires ralentissent volontairement l’amélioration de leurs modèles, les utilisateurs pourraient recevoir moins de progrès en matière de raisonnement, de rapidité, de fiabilité ou de fonctionnalités.

Le préjudice ne se limiterait donc pas à une innovation plus lente. Il pourrait aussi concerner les consommateurs et les entreprises qui paient chaque mois pour accéder aux versions avancées des assistants d’IA. Un abonnement conserverait son prix, mais offrirait une progression plus faible que celle qui aurait résulté d’une concurrence sans coordination.

Cette approche permet aux plaignants de présenter l’affaire sous l’angle classique du droit antitrust américain : une pratique entre concurrents aurait potentiellement diminué la qualité du produit et limité la pression concurrentielle, même sans hausse immédiate des tarifs.

La concurrence ne se mesure pas seulement au prix

Dans les services numériques, le prix n’est qu’un indicateur parmi d’autres. La qualité des réponses, les limites d’usage, la vitesse d’exécution, l’accès à de nouveaux outils et la capacité à traiter des tâches complexes font partie de la valeur proposée aux clients.

Une stratégie de ralentissement pourrait donc prendre des formes difficiles à mesurer. Elle pourrait passer par des versions moins ambitieuses, des capacités volontairement bridées ou des calendriers de déploiement retardés. Reste à prouver que ces choix résultent d’un accord entre les entreprises et non de contraintes liées aux coûts informatiques, à la disponibilité des puces, aux besoins de tests ou aux exigences de sécurité.

La sécurité de l’IA devient un enjeu de concurrence

Jusqu’à présent, les débats sur le ralentissement du développement de l’IA étaient principalement formulés en termes de gouvernance et de sécurité. Les partisans d’une approche prudente mettent en avant les risques liés aux modèles capables de générer du code, d’automatiser des tâches complexes ou d’interagir avec des outils externes.

Le dossier californien ajoute une autre dimension : la sécurité pourrait-elle servir de justification à une limitation concertée de la concurrence ? La question est particulièrement sensible parce que les entreprises concernées ont toutes intérêt à présenter leurs choix techniques comme responsables, tout en conservant leur avantage commercial.

Le droit devra ainsi séparer deux types de coopération. La première vise à réduire des risques documentés au moyen de règles communes, de tests partagés ou de mécanismes de signalement. La seconde pourrait consister à s’accorder sur un rythme de développement, un niveau de performance ou une stratégie commerciale afin d’éviter qu’un acteur ne prenne trop d’avance.

Cette frontière sera difficile à tracer, mais elle pourrait devenir un point de référence pour les futures discussions sur la régulation de l’IA. Si la plainte progresse, les échanges internes, les comptes rendus de réunions et les communications entre entreprises pourraient être examinés pour rechercher la preuve d’une intention commune.

Un dossier qui pourrait peser sur toute l’industrie

L’affaire vise quatre acteurs majeurs : Anthropic, OpenAI, SpaceXAI et Google. Leur présence dans une même procédure donne au dossier une portée particulière. Il ne s’agit pas d’un conflit limité à une relation commerciale ou à une fonctionnalité précise, mais d’une accusation visant la manière dont plusieurs concurrents auraient géré le rythme général du secteur.

Les conséquences pourraient être importantes même sans condamnation finale. Une enquête approfondie augmenterait la pression sur les laboratoires pour documenter leurs décisions de sécurité et distinguer clairement les discussions techniques des échanges commerciaux. Les autorités pourraient aussi chercher à encadrer les forums sectoriels où se rencontrent les responsables de l’IA.

Le prochain jalon sera l’examen de la plainte par le tribunal fédéral californien : recevabilité, éventuelles demandes de rejet, puis accès à des éléments internes si la procédure se poursuit. La capacité des plaignants à relier la déclaration de juillet 2026 à des effets concrets sur les modèles et les abonnements déterminera la solidité du dossier. Pour les utilisateurs comme pour les investisseurs, l’enjeu sera mesurable : savoir si la prudence revendiquée par les géants de l’IA correspondait à une gestion légitime des risques ou à une limitation coordonnée de la concurrence.

Les LLM réagissent différemment aux instructions génératives nuisibles lorsque le filigrane numérique de l'IA est utilisé, selon une étude révélant les conséquences liées à la sécurité des filigranes IA

Les LLM réagissent différemment aux instructions génératives nuisibles lorsque le filigrane numérique de l'IA est utilisé, selon une étude révélant les conséquences liées à la sécurité des filigranes IA

Une nouvelle étude de Lasso a révélé que le filigrane numérique de l'IA pourrait en réalité modifier involontairement le comportement des grands modèles de langage (LLM), à la suite de tests effectués sur SynthID-Text de Google DeepMind. Les chercheurs de l'entreprise ont découvert que SynthID-Text...

Trump propose de renommer l'IA, affirmant que son nom actuel est « inexact et très peu éloquent ». Il qualifie de « canular » les risques liés à l'IA et veut créer une « AI Force » pour protéger la technologie

Trump propose de renommer l'IA, affirmant que son nom actuel est « inexact et très peu éloquent ». Il qualifie de « canular » les risques liés à l'IA et veut créer une « AI Force » pour protéger la technologie

Donald Trump suscite l'interrogation en annonçant la création d'une « AI Force » et la nomination prochaine d'un nouveau « tsar de l'IA » pour superviser la technologie. Il rejette fermement les appels à une réglementation stricte, qualifiant les avertissements sur les risques existentiels...

Gemini, de Google, est le dernier modèle d'IA à s'être échappé et à avoir piraté des systèmes informatiques, se croyant en environnement de test alors qu'il était connecté à Internet

Gemini, de Google, est le dernier modèle d'IA à s'être échappé et à avoir piraté des systèmes informatiques, se croyant en environnement de test alors qu'il était connecté à Internet

Google a déclaré que son modèle Gemini avait piraté trois autres entreprises. C'est la première fois que le géant de la recherche révèle qu'un de ses modèles a accédé de manière autonome et sans autorisation à des systèmes informatiques tiers. En mai, le modèle Gemini a accédé à trois systèmes informatiques privés distincts...

Une fausse information générée par l'IA utilisée par l'armée américaine a « failli déclencher une guerre avec la Chine », après qu'un chatbot a identifié à tort des composants d'armes nucléaires

Une fausse information générée par l'IA utilisée par l'armée américaine a « failli déclencher une guerre avec la Chine », après qu'un chatbot a identifié à tort des composants d'armes nucléaires

Une fausse information générée par l'IA utilisée par l'armée américaine a « failli déclencher une guerre avec la Chine ». Des membres de l'armée américaine ont failli arrêter et contrôler un navire chinois au Moyen-Orient, après avoir été informés que celui-ci transportait des composants d'armes nucléaires....

Anthropic, OpenAI, Google et SpaceXAI s'entendent illégalement pour freiner le développement de l'IA , selon une plainte qui les accuse d'avoir enfreint la législation antitrust

Anthropic, OpenAI, Google et SpaceXAI s'entendent illégalement pour freiner le développement de l'IA, selon une plainte qui les accuse d'avoir enfreint la législation antitrust

Une nouvelle action en justice allègue que les géants de la technologie Anthropic, OpenAI, SpaceXAI et Google ont conclu un accord « illégal » visant à ralentir le rythme de leurs développements respectifs en matière d'IA. La plainte a été déposée récemment devant le tribunal fédéral du district nord de Californie. Les plaignants...

Les centres de données de l'Oregon consomment près de 25 % de l'électricité de l'État, et pire encore : 32 centres de données supplémentaires sont prévus ou en cours de construction dans l'État

Les centres de données de l'Oregon consomment près de 25 % de l'électricité de l'État, et pire encore : 32 centres de données supplémentaires sont prévus ou en cours de construction dans l'État

n nouveau rapport publié par ECOnorthwest et l'université de Virginie, financé par la fondation Lemelson, une association à but non lucratif basée à Portland, quantifie des données fondamentales mais difficiles à trouver. Il précise notamment le nombre de centres de données que compte actuellement l'État (111),...

ChatGPT sait désormais ce que vous faites sur d'autres sites grâce à un outil de collecte de données publicitaires, qui suit vos habitudes de navigation au-delà du chat

ChatGPT sait désormais ce que vous faites sur d'autres sites grâce à un outil de collecte de données publicitaires qui suit vos habitudes de navigation au-delà du chat

Un article a été publié en ligne, s'appuyant sur un reportage de Buchodi affirmant que ChatGPT serait capable de connaître les activités des utilisateurs sur d'autres sites web grâce à un outil de collecte publicitaire intégré au service. Selon cette affirmation, les données recueillies à des fins publicitaires pourraient être recoupées...

Comment installer et utiliser Ollama pour lancer une IA en local

Comment installer et utiliser Ollama pour lancer une IA en local

Pour installer Ollama et lancer une IA en local, il suffit d’installer le logiciel, de télécharger un modèle compatible avec l’ordinateur, puis de l’utiliser depuis un terminal ou une application graphique. Ce guide explique également comment choisir un modèle, vérifier les performances, appeler Ollama depuis une API et résoudre les problèmes les plus fréquents.

Qu’est-ce qu’Ollama ?

Ollama est un outil qui permet d’exécuter des modèles d’intelligence artificielle directement sur un ordinateur. Il fonctionne sur Windows, macOS et Linux et propose une interface en ligne de commande ainsi qu’une API locale.

Ollama ne constitue pas un modèle d’IA en lui-même. Il sert plutôt de moteur d’exécution pour des modèles comme :

  • Llama de Meta ;
  • Mistral ;
  • Gemma de Google ;
  • Qwen ;
  • DeepSeek ;
  • d’autres modèles de langage ou modèles multimodaux compatibles.

Une fois le modèle téléchargé, les conversations peuvent être traitées localement, sans envoyer les prompts à un service distant. Cette caractéristique est utile pour la confidentialité, le travail hors ligne et la maîtrise des coûts.

Pourquoi utiliser une IA locale avec Ollama ?

Une meilleure confidentialité

Les prompts, documents et réponses restent sur la machine lorsque le modèle est exécuté localement. Cette approche convient notamment aux données professionnelles, aux informations personnelles ou aux documents confidentiels.

Il faut toutefois rester vigilant : le téléchargement initial du modèle nécessite une connexion Internet, et une application tierce connectée à Ollama peut éventuellement transmettre des données à un serveur distant.

Une utilisation sans abonnement

Ollama est gratuit à installer. Les principaux coûts concernent :

  • le matériel nécessaire ;
  • l’espace de stockage ;
  • la consommation électrique ;
  • éventuellement une application complémentaire ou un service cloud.

Les licences des modèles sont différentes selon les éditeurs. La gratuité d’Ollama ne signifie donc pas que chaque modèle peut être utilisé sans restriction commerciale.

Un contrôle complet du modèle

L’utilisateur peut choisir :

  • la taille du modèle ;
  • le niveau de quantification ;
  • la température des réponses ;
  • le nombre de tokens générés ;
  • le comportement du système ;
  • l’emplacement de stockage des modèles.

Une intégration simple avec d’autres outils

Ollama expose une API locale sur l’adresse `http://localhost:11434`. Cette API peut être utilisée depuis :

  • une application Python ;
  • un script JavaScript ;
  • une interface web ;
  • un outil de recherche documentaire ;
  • un éditeur de code ;
  • une application de productivité.

Quelle configuration faut-il pour Ollama ?

Ollama fonctionne sans carte graphique dédiée, mais les performances dépendent fortement du matériel.

| Mémoire disponible | Modèles généralement adaptés |

|---|---|

| 4 à 8 Go de RAM | Modèles de 1 à 3 milliards de paramètres |

| 8 à 16 Go de RAM | Modèles de 7 à 9 milliards de paramètres quantifiés |

| 16 à 32 Go de RAM | Modèles de 14 milliards de paramètres |

| 32 Go de RAM ou davantage | Modèles de 32 milliards de paramètres et plus |

Ces indications restent approximatives. Le système d’exploitation, la longueur du contexte et les autres logiciels ouverts consomment également de la mémoire.

Espace disque nécessaire

La taille du fichier téléchargé varie selon le modèle et sa quantification. À titre indicatif :

  • un modèle de 3 milliards de paramètres peut occuper quelques gigaoctets ;
  • un modèle de 7 ou 8 milliards de paramètres nécessite souvent entre 4 et 6 Go ;
  • un modèle de 14 milliards de paramètres peut dépasser 9 Go ;
  • un modèle de 32 milliards de paramètres peut nécessiter 20 Go ou davantage.

Il est recommandé de conserver au moins 10 à 20 Go d’espace libre pour commencer confortablement.

Carte graphique ou processeur ?

Ollama peut utiliser :

  • le processeur, sur pratiquement toutes les machines compatibles ;
  • le GPU intégré des Mac Apple Silicon via Metal ;
  • certaines cartes NVIDIA ;
  • certaines configurations AMD ou Vulkan, selon le système et les pilotes.

Une carte graphique accélère généralement la génération. Si la mémoire vidéo est insuffisante, Ollama peut répartir le calcul entre le GPU et le processeur, avec une baisse de performance.

Comment installer Ollama sur Windows ?

Étape 1 : télécharger l’installateur

  1. Accédez au site officiel d’Ollama.
  2. Téléchargez l’installateur Windows.
  3. Lancez le fichier téléchargé.
  4. Suivez les étapes affichées à l’écran.
  5. Ouvrez PowerShell ou Windows Terminal.

L’installation native ne nécessite pas obligatoirement WSL. Ollama peut fonctionner directement sous Windows.

Étape 2 : vérifier l’installation

Exécutez la commande `ollama --version`.

Si une version s’affiche, le programme est correctement installé. Si Windows indique que la commande est introuvable, fermez puis rouvrez le terminal. Un redémarrage peut également être nécessaire.

Étape 3 : vérifier le serveur local

Ollama démarre généralement son service en arrière-plan. Pour le lancer manuellement, utilisez `ollama serve`.

L’API locale est normalement disponible à l’adresse `http://localhost:11434`.

Comment installer Ollama sur macOS ?

Étape 1 : télécharger l’application

  1. Téléchargez l’application Ollama depuis le site officiel.
  2. Ouvrez le fichier d’installation.
  3. Faites glisser Ollama dans le dossier Applications si cette étape est demandée.
  4. Lancez l’application.
  5. Autorisez son exécution si macOS affiche un avertissement de sécurité.

Sur les Mac équipés d’une puce Apple Silicon, Ollama peut exploiter le GPU intégré via Metal. Les performances varient selon la quantité de mémoire unifiée disponible.

Étape 2 : tester le terminal

Ouvrez l’application Terminal puis saisissez `ollama --version`.

Pour démarrer le serveur manuellement, utilisez `ollama serve`. L’application Ollama doit rester active si le service n’est pas lancé automatiquement.

Comment installer Ollama sur Linux ?

La méthode officielle la plus simple consiste à utiliser le script d’installation fourni par Ollama. Dans un terminal, exécutez `curl -fsSL https://ollama.com/install.sh | sh`.

Cette commande télécharge et installe le programme. Pour des raisons de sécurité, vérifiez toujours que la commande provient bien du site officiel avant de l’exécuter.

Vérifiez ensuite l’installation avec `ollama --version`.

Sur de nombreuses distributions, l’installateur configure un service système. Les commandes suivantes permettent de contrôler ce service :

  • `sudo systemctl status ollama` pour vérifier son état ;
  • `sudo systemctl start ollama` pour le démarrer ;
  • `sudo systemctl restart ollama` pour le relancer ;
  • `journalctl -u ollama` pour consulter les journaux.

Si le serveur n’est pas configuré comme service, lancez-le avec `ollama serve`.

Comment installer Ollama avec Docker ?

Docker est utile pour isoler Ollama ou l’intégrer à une infrastructure existante. Une installation CPU peut être lancée avec la commande `docker run -d -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama`.

Pour utiliser une carte NVIDIA, il faut ajouter la prise en charge GPU de Docker et utiliser l’option adaptée, généralement `--gpus=all`.

Cette méthode demande davantage de configuration. Pour un premier usage sur un ordinateur personnel, l’installation native est généralement plus simple.

Comment télécharger un modèle dans Ollama ?

Après l’installation, choisissez un modèle dans la bibliothèque officielle d’Ollama. Pour télécharger un modèle, utilisez la commande `ollama pull llama3.2`.

Le nom exact dépend du modèle et de sa variante. Exemples courants :

  • `ollama pull llama3.2` ;
  • `ollama pull llama3.2:1b` pour une version plus légère ;
  • `ollama pull qwen2.5:7b` ;
  • `ollama pull mistral` ;
  • `ollama pull gemma3`.

Les noms, tailles et versions disponibles peuvent évoluer. Consultez la fiche du modèle avant de lancer le téléchargement, notamment pour vérifier la licence, la langue et les besoins matériels.

Comment lancer une IA locale avec Ollama ?

Une fois le modèle téléchargé, lancez-le avec `ollama run llama3.2`.

Ollama ouvre alors une conversation dans le terminal. Saisissez une question, puis appuyez sur Entrée.

Exemples de demandes :

  • `Résume ce texte en cinq points.`
  • `Explique la différence entre une API REST et une API GraphQL.`
  • `Rédige une description de produit en français.`
  • `Traduis ce paragraphe en anglais professionnel.`

Pour quitter la conversation, utilisez généralement la commande `/bye`, le raccourci Ctrl+D ou Ctrl+C selon le terminal.

Dans l’interface interactive, la commande `/help` affiche les fonctions disponibles. Les commandes peuvent varier selon la version installée.

Quelles commandes Ollama faut-il connaître ?

Les commandes essentielles sont les suivantes :

  • `ollama list` affiche les modèles installés ;
  • `ollama pull nom_du_modele` télécharge un modèle ;
  • `ollama run nom_du_modele` lance une conversation ;
  • `ollama show nom_du_modele` affiche les informations du modèle ;
  • `ollama ps` liste les modèles actuellement chargés en mémoire ;
  • `ollama stop nom_du_modele` arrête un modèle ;
  • `ollama rm nom_du_modele` supprime un modèle ;
  • `ollama cp modele_source modele_copie` crée une copie sous un autre nom ;
  • `ollama help` affiche l’aide générale.

La commande `ollama ps` est particulièrement utile pour vérifier si le modèle utilise le CPU, le GPU ou les deux.

Comment choisir le bon modèle ?

Pour un ordinateur peu puissant

Privilégiez un modèle de 1 à 3 milliards de paramètres. Il sera plus rapide et consommera moins de mémoire, mais ses réponses seront souvent moins précises sur les tâches complexes.

Les variantes légères sont adaptées à :

  • la reformulation ;
  • la classification ;
  • les réponses courtes ;
  • les petits scripts ;
  • les usages hors ligne basiques.

Pour un usage général

Les modèles de 7 à 9 milliards de paramètres offrent généralement un bon compromis entre qualité et rapidité. Ils conviennent à la rédaction, à la traduction, au résumé et à l’assistance au développement.

Pour la qualité maximale en local

Les modèles de 14 milliards de paramètres ou davantage produisent souvent de meilleures réponses, mais ils nécessitent plus de RAM, plus d’espace disque et davantage de temps de génération.

Un modèle plus grand n’est toutefois pas toujours meilleur. La qualité dépend aussi de l’entraînement, de la langue, de la quantification et de la formulation du prompt.

Comment appeler Ollama avec son API ?

Ollama propose une API locale accessible sur le port 11434.

Pour générer une réponse, utilisez par exemple la commande suivante :

`curl http://localhost:11434/api/generate -d '{"model":"llama3.2","prompt":"Explique le fonctionnement d’un réseau neuronal en trois phrases.","stream":false}'`

L’option `"stream":false` demande une réponse complète plutôt qu’un flux de tokens.

Pour utiliser une conversation avec plusieurs messages, l’endpoint `/api/chat` est plus adapté. Exemple :

`curl http://localhost:11434/api/chat -d '{"model":"llama3.2","messages":[{"role":"user","content":"Donne trois idées de sujets pour un blog tech."}],"stream":false}'`

La liste des modèles disponibles peut être récupérée avec `curl http://localhost:11434/api/tags`.

Ollama propose également une compatibilité avec certaines bibliothèques OpenAI via l’adresse `http://localhost:11434/v1`. Cette compatibilité facilite l’intégration avec des applications existantes, mais les fonctions disponibles peuvent différer selon les bibliothèques.

Utiliser Ollama depuis Python

Le paquet Python officiel peut être installé avec `pip install ollama`.

Une requête de chat peut ensuite être réalisée avec une instruction du type `from ollama import chat; response = chat(model='llama3.2', messages=[{'role': 'user', 'content': 'Résume ce texte.'}])`.

Pour un projet réel, prévoyez une gestion des erreurs lorsque le serveur est arrêté, lorsque le modèle n’est pas installé ou lorsque la mémoire disponible est insuffisante.

Comment personnaliser un modèle avec un Modelfile ?

Ollama permet de créer une variante personnalisée à partir d’un modèle existant.

Créez un fichier nommé `Modelfile` contenant par exemple les lignes suivantes :

  • `FROM llama3.2`
  • `PARAMETER temperature 0.2`
  • `SYSTEM Tu es un assistant spécialisé dans la rédaction technique en français.`

La température basse favorise des réponses plus prévisibles. Une température plus élevée produit davantage de variété, mais peut aussi augmenter les incohérences.

Créez ensuite le modèle avec `ollama create assistant-fr -f Modelfile`, puis lancez-le avec `ollama run assistant-fr`.

D’autres paramètres peuvent être configurés, notamment :

  • le nombre maximal de tokens générés ;
  • la longueur du contexte ;
  • la température ;
  • les séquences d’arrêt ;
  • le prompt système.

La personnalisation du modèle ne modifie pas ses connaissances de base. Elle agit principalement sur son comportement et son format de réponse.

Ollama peut-il analyser des fichiers PDF ?

Ollama seul ne constitue pas automatiquement un moteur de recherche dans les fichiers PDF. Pour interroger des documents, il faut généralement ajouter une interface ou un système de RAG, c’est-à-dire une récupération de passages pertinents avant la génération.

Les solutions complémentaires peuvent :

  1. extraire le texte des documents ;
  2. découper ce texte en passages ;
  3. créer des représentations vectorielles ;
  4. rechercher les passages les plus pertinents ;
  5. les transmettre au modèle Ollama.

Des interfaces comme Open WebUI peuvent fournir une expérience graphique et, selon la configuration, des fonctions de documents et de recherche locale.

Comment ajouter une interface graphique à Ollama ?

Ollama se contrôle nativement depuis le terminal. Pour une expérience plus proche de ChatGPT, il est possible d’utiliser une interface comme Open WebUI.

Le principe consiste à :

  1. installer Docker ;
  2. lancer Open WebUI ;
  3. le connecter au serveur Ollama ;
  4. ouvrir l’interface dans un navigateur, souvent sur le port 3000.

Ollama et Open WebUI doivent pouvoir communiquer sur le réseau local. Avec Docker, l’adresse de connexion peut nécessiter `host.docker.internal` ou une configuration réseau spécifique selon le système.

L’interface graphique simplifie la gestion des conversations, des modèles et parfois des documents, mais elle ajoute une couche logicielle supplémentaire à maintenir.

Comment améliorer les performances d’Ollama ?

Plusieurs réglages peuvent faire une différence :

  1. Choisir un modèle adapté à la RAM disponible. Un modèle trop volumineux entraînera des ralentissements ou des erreurs.
  2. Fermer les applications gourmandes. Les navigateurs avec de nombreux onglets peuvent consommer plusieurs gigaoctets.
  3. Utiliser un modèle quantifié. Il occupe moins de mémoire, avec une baisse de qualité généralement limitée.
  4. Réduire la longueur du contexte. Un contexte très long augmente la consommation mémoire.
  5. Éviter de charger plusieurs modèles en même temps. La commande `ollama stop nom_du_modele` libère les ressources.
  6. Installer les pilotes graphiques appropriés. Un GPU mal configuré peut laisser Ollama fonctionner uniquement sur le CPU.
  7. Placer les modèles sur un SSD. Les chargements sont plus rapides que sur un disque dur classique.

La vitesse dépend également du nombre de tokens générés par seconde. Une génération lente sur un ordinateur sans GPU est normale, surtout avec un modèle de grande taille.

Peut-on utiliser Ollama depuis un autre ordinateur ?

Par défaut, Ollama écoute généralement sur la machine locale. Cette configuration est la plus sûre.

Pour autoriser des connexions réseau, la variable `OLLAMA_HOST` peut être configurée avec une adresse comme `0.0.0.0:11434`. Cette modification expose potentiellement l’API à d’autres appareils du réseau.

Ne publiez pas directement le port 11434 sur Internet. L’API locale ne doit pas être considérée comme un service public sécurisé avec authentification complète. Pour un accès distant, utilisez plutôt un VPN, un tunnel sécurisé ou un proxy correctement configuré avec authentification et chiffrement.

Combien coûte l’utilisation d’Ollama ?

Le logiciel Ollama peut être installé gratuitement. Le coût réel dépend de l’équipement :

  • un ordinateur existant ne génère pas de coût matériel immédiat ;
  • une carte graphique peut représenter plusieurs centaines d’euros ;
  • les modèles occupent de l’espace disque ;
  • les longues générations augmentent la consommation électrique.

L’utilisation locale évite les coûts à la requête d’une API distante, mais elle peut être moins rapide ou moins performante qu’un service cloud haut de gamme.

Quand privilégier Ollama plutôt qu’une IA en ligne ?

Ollama est particulièrement adapté lorsque :

  • la confidentialité est prioritaire ;
  • une connexion Internet n’est pas toujours disponible ;
  • les tâches sont répétitives et automatisables ;
  • le budget d’API doit rester limité ;
  • l’utilisateur souhaite tester plusieurs modèles ;
  • un contrôle local du traitement est nécessaire.

Une IA en ligne reste souvent préférable lorsque la meilleure qualité disponible, les modèles les plus récents, la recherche web intégrée ou une puissance de calcul élevée sont prioritaires.

Résoudre les problèmes fréquents

La commande `ollama` est introuvable

Fermez et rouvrez le terminal. Si le problème persiste, vérifiez l’installation et le chemin système. Sous Windows, un redémarrage peut être nécessaire pour actualiser la variable PATH.

Le message « connection refused » apparaît

Le serveur Ollama n’est probablement pas démarré. Lancez `ollama serve`, vérifiez l’application sur macOS ou contrôlez le service avec `systemctl` sous Linux.

Le modèle est trop lent

Utilisez un modèle plus petit, réduisez le contexte, fermez les programmes inutiles et vérifiez la détection du GPU avec `ollama ps`.

Ollama manque de mémoire

Supprimez les modèles inutilisés avec `ollama rm nom_du_modele`, arrêtez les modèles actifs avec `ollama stop nom_du_modele` et choisissez une variante plus légère.

Le téléchargement échoue

Contrôlez la connexion Internet, l’espace disque disponible et les éventuels blocages du pare-feu. Relancez ensuite `ollama pull nom_du_modele`.

Où sont stockés les modèles ?

Les modèles sont conservés localement dans un dossier géré par Ollama. L’emplacement exact dépend du système d’exploitation et du mode d’installation.

La variable d’environnement `OLLAMA_MODELS` permet de définir un autre dossier de stockage. Cette option est pratique lorsque le disque système est presque plein ou lorsque les modèles doivent être installés sur un SSD secondaire.

Avant de déplacer ce dossier, arrêtez Ollama et vérifiez les droits d’accès du nouvel emplacement.

Comment mettre à jour Ollama et les modèles ?

Pour mettre à jour Ollama, utilisez la nouvelle version de l’installateur officiel. Sous Linux, la réexécution de la procédure d’installation officielle permet généralement d’installer la version récente.

Pour actualiser un modèle, utilisez `ollama pull nom_du_modele`. Les tags peuvent évoluer avec le temps : une même étiquette peut parfois pointer vers une version différente après une mise à jour.

Conservez une copie des fichiers importants de configuration et vérifiez la licence d’un modèle avant de l’intégrer dans un produit commercial.

Points clés à retenir

  • Ollama permet d’exécuter une IA localement sur Windows, macOS et Linux.
  • L’installation consiste à installer Ollama, télécharger un modèle avec `ollama pull`, puis le lancer avec `ollama run`.
  • Les modèles de 1 à 3 milliards de paramètres conviennent aux petites configurations, tandis que les modèles de 7 à 14 milliards offrent un meilleur compromis général.
  • Une carte graphique accélère le traitement, mais n’est pas indispensable.
  • L’API locale est disponible sur `http://localhost:11434`.
  • Les modèles occupent plusieurs gigaoctets : vérifiez la RAM et l’espace disque avant l’installation.
  • La confidentialité est meilleure qu’avec un service distant, mais les applications tierces connectées à Ollama doivent être contrôlées.
  • N’exposez jamais directement le port Ollama sur Internet sans protection adaptée.
  • Pour une interface graphique ou l’analyse de documents, ajoutez un outil comme Open WebUI ou une solution RAG.

Scott Bessent propose à Pékin une alerte IA avant qu’un accident ne devienne militaire

Scott Bessent propose à Pékin une alerte IA avant qu’un accident ne devienne militaire

Entre Washington et Pékin, l’intelligence artificielle commence à être traitée comme un risque stratégique au même titre que les cyberattaques ou les armes nucléaires. Le 20 septembre 2026, le secrétaire américain au Trésor Scott Bessent a indiqué que les États-Unis avaient proposé à la Chine un mécanisme de notification pour les incidents d’IA susceptibles de menacer la sécurité nationale.

Prévenir l’escalade avant qu’elle ne devienne incontrôlable

La proposition intervient à quelques jours d’une rencontre prévue entre Donald Trump et Xi Jinping. Elle ne constitue pas encore un accord, ni même l’annonce d’un canal opérationnel déjà en place. Mais son existence signale une évolution notable : Washington et Pékin cherchent à établir un langage commun pour signaler certains incidents impliquant des systèmes d’intelligence artificielle.

Selon les informations rapportées par l’Associated Press, le mécanisme envisagé concernerait des événements susceptibles d’affecter la sécurité nationale. Le périmètre exact reste à définir : comportement imprévisible d’un modèle très avancé, capacité d’un système à contourner des garde-fous, utilisation malveillante dans une opération militaire ou cybernétique, ou encore accident touchant des infrastructures critiques.

L’objectif serait moins de résoudre immédiatement la rivalité technologique que d’éviter une mauvaise interprétation. Un système d’IA pourrait, par exemple, déclencher une alerte erronée, identifier à tort une activité hostile ou automatiser une réponse dans un environnement où les délais de décision sont extrêmement courts. Si l’autre puissance interprète l’incident comme une attaque délibérée, la crise pourrait s’aggraver avant même qu’une intervention humaine ne permette d’en établir la cause.

Un mécanisme proche des lignes de crise, sans être une hotline

Le projet évoque les dispositifs de communication établis pendant la guerre froide pour réduire les risques d’erreur entre puissances rivales. La comparaison s’arrête toutefois rapidement. Les arsenaux nucléaires sont contrôlés par des États selon des procédures relativement formalisées. Les technologies d’IA sont, elles, développées par des entreprises privées, des laboratoires universitaires, des agences militaires et des acteurs parfois difficiles à identifier.

Un incident pourrait donc survenir dans un modèle commercial, un outil de renseignement, un logiciel militaire ou une infrastructure informatique opérée par un prestataire. La question centrale serait alors celle de l’attribution : comment déterminer rapidement qui est responsable, si l’événement relève d’une défaillance, d’une attaque informatique, d’un usage détourné ou d’une décision volontaire ?

Un canal de notification ne supprimerait pas ce problème. Il offrirait cependant un moyen de transmettre des informations minimales avant que les accusations publiques ou les mesures de représailles ne ferment l’espace diplomatique.

Une trêve limitée dans une rivalité technologique intense

Cette ouverture intervient dans un contexte de compétition profonde entre Washington et Pékin. Les États-Unis cherchent à conserver leur avance dans les semi-conducteurs, les infrastructures de calcul et les modèles génératifs. La Chine poursuit ses propres capacités dans ces domaines tout en renforçant ses écosystèmes industriels et militaires.

Les restrictions américaines sur l’exportation de puces avancées et d’équipements de fabrication ont fait de l’IA un dossier directement lié à la puissance économique et militaire. Pékin considère ces contrôles comme un instrument de containment. Washington les présente comme un moyen de limiter l’accès chinois à des capacités susceptibles d’être utilisées à des fins militaires.

La proposition de notification ne signifie donc pas que la concurrence s’atténue. Elle marque plutôt une distinction entre deux niveaux de relation : la compétition pour la suprématie technologique peut se poursuivre, tandis que certains risques doivent être isolés afin d’éviter un incident majeur.

Cette logique existe déjà dans d’autres domaines stratégiques. Les États peuvent continuer à moderniser leurs forces, à mener des opérations de renseignement ou à se disputer des marchés tout en maintenant des canaux de communication destinés à prévenir les accidents. Avec l’IA, la difficulté sera de définir ce qui mérite une notification sans exposer des informations sensibles sur les capacités nationales.

Le problème du seuil d’alerte

Le principal obstacle sera probablement la définition d’un incident « affectant la sécurité nationale ». Un modèle qui produit une réponse erronée n’a pas la même portée qu’un système capable d’interagir avec une infrastructure militaire, de générer du code malveillant à grande échelle ou de manipuler des données utilisées pour une décision stratégique.

Le seuil devra être suffisamment élevé pour éviter une avalanche de notifications et suffisamment bas pour couvrir les signaux faibles. Une déclaration trop tardive perdrait toute utilité. Une notification trop précoce pourrait, à l’inverse, révéler une vulnérabilité, fournir des informations à l’adversaire ou être interprétée comme une accusation.

La confiance sera également déterminante. Chaque puissance devra croire que l’autre utilise le canal pour réduire le risque, et non pour collecter du renseignement. La notification pourrait ainsi se limiter dans un premier temps à des catégories générales : nature de l’incident, niveau de gravité, risque de propagation et mesures déjà prises. Les détails techniques seraient transmis uniquement après vérification.

Les entreprises au centre du dispositif

Un autre point reste largement ouvert : le rôle des entreprises qui développent et déploient les modèles. Les gouvernements peuvent négocier un mécanisme diplomatique, mais ils ne contrôlent pas chaque système privé susceptible de provoquer un incident.

Un dispositif crédible devrait donc prévoir des obligations de remontée d’information vers les autorités, des procédures de conservation des journaux techniques et des critères communs pour distinguer une anomalie d’un acte hostile. Il devrait également protéger les entreprises contre la divulgation immédiate de failles exploitables.

Cette architecture est particulièrement complexe parce que les mêmes modèles peuvent être utilisés pour la recherche, l’administration, la cybersécurité ou la défense. Une capacité développée à des fins civiles peut rapidement devenir pertinente pour la sécurité nationale, sans qu’un changement matériel du logiciel soit nécessaire.

Un premier test pour la diplomatie de l’IA

La rencontre annoncée entre Donald Trump et Xi Jinping pourrait déterminer si la proposition de Scott Bessent reste une idée de principe ou débouche sur un mandat de négociation plus précis. Plusieurs étapes seraient nécessaires : désigner les interlocuteurs, fixer les catégories d’incidents, établir un canal sécurisé et organiser des exercices de simulation.

Le résultat le plus réaliste ne serait pas un traité global sur les usages militaires de l’IA. Les divergences entre Washington et Pékin sont trop importantes, et les technologies évoluent trop vite pour qu’un cadre exhaustif soit rapidement applicable. Un protocole limité, consacré aux incidents les plus graves, aurait davantage de chances d’aboutir.

Le signal politique est néanmoins significatif. Pour la première fois, les deux principales puissances de l’IA semblent envisager directement la possibilité qu’un comportement imprévisible ou malveillant de ces systèmes puisse produire une crise internationale. Le prochain jalon sera concret : savoir si les discussions débouchent, dans les prochains mois, sur un canal de contact permanent et sur une définition commune des incidents à notifier. Sans ces éléments, l’initiative restera symbolique ; avec eux, elle pourrait devenir l’un des premiers instruments de gestion de crise adapté à l’ère des modèles autonomes.

Alibaba lance Qwen3.8-Omni-Flash, un modèle d'IA omnimodal capable de produire des vidéos, des clips musicaux, des films, des résumés audiovisuels et des conversations en temps réel

Alibaba lance Qwen3.8-Omni-Flash, un modèle d'IA omnimodal capable de produire des vidéos, des clips musicaux, des films, des résumés audiovisuels et des conversations en temps réel

L'équipe Qwen d'Alibaba a lancé Qwen3.8-Omni-Flash. Elle le présente comme son premier modèle omnimodal articulé autour de capacités « agentiques ». Il accepte du texte, des images, de l'audio et de la vidéo, et renvoie du texte. La compréhension audio-vidéo, le raisonnement et l'utilisation d'outils sont intégrés au...

Grâce à Bonsai 2 27B, PrismML réduit Qwen3.8 27B à 5,9 Go pour l'IA locale, en pariant que les LLM capables de raisonnement et hautement performants ne doivent pas nécessairement être volumineux

Grâce à Bonsai 2 27B, PrismML réduit Qwen3.8 27B à 5,9 Go pour l'IA locale, en pariant que les LLM capables de raisonnement et hautement performants ne doivent pas nécessairement être volumineux

Un modèle construit à partir de Qwen3.8 27B peut désormais tenir dans un paquet de poids de 5,9 Go. PrismML a publié Ternary Bonsai 2 27B, une version compressée qui, selon l'entreprise, conserve 98,2 % des performances globales de référence du modèle en pleine précision, pour un encombrement plus de neuf...

Le PDG de Nvidia prévoit une croissance des ventes de puces multipliée par deux pour 2027, la prévision audacieuse de Jensen Huang laisse présager une expansion massive des infrastructures IA

Le PDG de Nvidia prévoit une croissance des ventes de puces multipliée par deux pour 2027, la prévision audacieuse de Jensen Huang laisse présager une expansion massive des infrastructures d'IA

Jensen Huang, PDG de Nvidia, a déclaré aux investisseurs que la société prévoyait de doubler ses ventes de puces l'année prochaine. Cette prévision a secoué les marchés technologiques et laisse présager que le boom des infrastructures d'intelligence artificielle (IA) entre dans une nouvelle phase. L'annonce...

Le développeur de centres de données Crusoe, qui compte parmi ses clients Meta, Microsoft et OpenAI, a levé 3 milliards $ lors d'un nouveau tour de table, avec une valorisation de 30 milliards $

Le développeur de centres de données Crusoe, qui compte parmi ses clients Meta, Microsoft et OpenAI, a levé 3 milliards $ lors d'un nouveau tour de table, avec une valorisation de 30 milliards $

Le développeur de centres de données Crusoe, qui compte parmi ses clients Meta, Microsoft et OpenAI, a levé 3 milliards de dollars lors d'un nouveau tour de table, pour une valorisation de 30 milliards de dollars, selon Bloomberg. La société a récemment signé un contrat cloud colossal de 13 milliards de dollars...

Donald Trump veut une AI Force calquée sur la Space Force, Washington militarise l’IA

Donald Trump veut une AI Force calquée sur la Space Force, Washington militarise l’IA

La course à l’intelligence artificielle prend une dimension militaire assumée à Washington. Le 19 septembre 2026, Donald Trump a annoncé la création prochaine d’une « AI Force », sur le modèle de la Space Force, ainsi que la nomination d’un « AI czar » chargé de coordonner la stratégie fédérale.

Une force dédiée pour accélérer l’IA américaine

La nouvelle structure doit servir à concentrer les moyens de l’État américain sur le développement et le déploiement de l’intelligence artificielle. Dans l’esprit de la Maison-Blanche, l’objectif est clair : réduire les délais administratifs, coordonner les agences et donner à Washington une capacité d’action comparable à celle mobilisée pour les programmes spatiaux et de défense.

La référence à la Space Force n’est pas anodine. Créée sous la présidence Trump en 2019, puis officiellement organisée comme une branche des forces armées américaines en 2020, elle avait été conçue pour regrouper les compétences militaires liées à l’espace, jusque-là dispersées entre plusieurs structures. L’« AI Force » pourrait reprendre cette logique de centralisation, même si son périmètre exact reste à définir.

L’intelligence artificielle ne constitue toutefois pas un domaine militaire aussi facilement délimitable que l’espace. Elle concerne simultanément le renseignement, la cybersécurité, les systèmes d’armes, les infrastructures critiques, la santé, l’administration et l’économie civile. La future organisation devra donc éviter de devenir une structure supplémentaire superposée à celles déjà actives au sein du Pentagone, de la Maison-Blanche et des agences fédérales.

Aucun détail définitif n’a encore été annoncé sur son statut juridique, son budget, ses effectifs ou sa chaîne de commandement. Ces éléments seront déterminants pour mesurer la portée réelle de l’initiative : simple dispositif de coordination politique ou véritable organisme doté de capacités opérationnelles et financières.

Un « AI czar » pour mettre fin à la dispersion

Donald Trump doit également nommer un « AI czar », un responsable de haut niveau chargé de piloter la politique fédérale de l’intelligence artificielle. Le poste vise à résoudre un problème ancien de l’administration américaine : la fragmentation des responsabilités entre le département de la Défense, les agences de renseignement, le département du Commerce, les régulateurs et les services de la Maison-Blanche.

Cette fonction pourrait donner à la présidence un interlocuteur unique face aux grandes entreprises technologiques et aux acteurs de la défense. Elle pourrait aussi servir à arbitrer les priorités entre investissements dans les centres de données, accès aux semi-conducteurs, sécurité des modèles et déploiement dans les administrations.

Le risque, pour Washington, est de créer un poste politiquement visible mais dépourvu d’autorité réelle. La puissance d’un tel responsable dépendra de son accès au président, de sa capacité à contrôler les budgets et de la place accordée à son bureau dans les décisions du Pentagone. Le choix du titulaire donnera un premier indice sur l’équilibre recherché entre expertise technique, loyauté politique et expérience militaire.

La sécurité nationale au cœur de la compétition avec Pékin

La Maison-Blanche présente cette initiative dans un contexte de rivalité croissante avec la Chine. Les modèles d’IA avancés sont désormais considérés comme des actifs stratégiques, au même titre que les satellites, les missiles ou les technologies de chiffrement. Ils peuvent améliorer l’analyse du renseignement, accélérer la conception de logiciels, automatiser certaines opérations cyber et renforcer les capacités de commandement.

Pour les États-Unis, conserver une avance dans les frontier models — les systèmes d’IA les plus performants — suppose de disposer rapidement de puissance de calcul, de puces spécialisées, d’électricité et de données. Une structure fédérale dédiée pourrait faciliter la mise en commun de ces ressources et accélérer les partenariats entre l’État, les laboratoires de recherche et les industriels.

Cette approche comporte cependant une limite : l’avance américaine dépend en grande partie d’entreprises privées comme OpenAI, Anthropic et Google. La future « AI Force » ne pourra pas reproduire le fonctionnement d’une branche militaire classique sans s’appuyer sur ces acteurs, qui contrôlent une large part des modèles, des infrastructures informatiques et des compétences spécialisées.

L’enjeu sera donc moins de placer toute l’IA sous contrôle militaire que d’organiser une coopération efficace entre Washington et l’industrie, tout en préservant les capacités d’innovation du secteur privé.

Dérégulation contre garde-fous

L’annonce intervient alors que l’administration Trump défend une ligne favorable à la dérégulation. La Maison-Blanche veut limiter les contraintes susceptibles de ralentir les entreprises américaines face à leurs concurrentes étrangères. Cette orientation entre en tension avec les avertissements formulés par les dirigeants d’Anthropic, d’OpenAI et de Google, qui appellent à renforcer les garde-fous sur les modèles les plus puissants.

Le débat ne porte pas uniquement sur la modération des contenus ou la protection des utilisateurs. Il concerne aussi la possibilité qu’un modèle avancé facilite des cyberattaques, automatise des opérations de désinformation, accélère la conception d’armes biologiques ou échappe partiellement aux mécanismes de contrôle prévus par ses concepteurs.

La contradiction est désormais apparente. Washington veut accélérer le développement de l’IA pour des raisons de sécurité nationale, tandis que les entreprises à l’origine des principaux modèles demandent davantage de règles pour contenir les risques liés à leur propre technologie. La création d’un « AI czar » pourrait précisément servir à arbitrer ce conflit entre vitesse d’exécution et maîtrise des dangers.

Mais une structure placée sous l’autorité de la Maison-Blanche ne garantira pas, à elle seule, un niveau de sécurité homogène. Il faudra encore définir des standards de test, des obligations de signalement, des procédures d’audit et des règles applicables aux systèmes utilisés par l’armée comme à ceux proposés au public.

Le prochain test sera budgétaire et juridique

L’annonce du 19 septembre 2026 ouvre donc un chantier institutionnel plus large qu’un simple changement d’organigramme. Washington cherche à faire de l’IA un instrument explicite de puissance nationale, avec une structure inspirée de la Space Force et un responsable chargé d’imposer une direction commune.

Le prochain jalon sera la présentation concrète du projet : base légale, financement, rattachement administratif, pouvoirs du « AI czar » et articulation avec le Pentagone. Ces paramètres permettront de vérifier si l’« AI Force » devient une organisation durable ou un label politique.

La conséquence la plus mesurable sera la capacité des États-Unis à raccourcir le délai entre une décision fédérale, l’accès aux infrastructures de calcul et le déploiement d’un système opérationnel. Si la dérégulation avance sans cadre de sécurité équivalent, le conflit entre compétitivité et contrôle risque toutefois de devenir le premier obstacle de cette stratégie.

Comment utiliser ChatGPT pour créer un plan de formation en 2026

Comment utiliser ChatGPT pour créer un plan de formation en 2026

Un plan de formation bien structuré peut être créé plus rapidement avec ChatGPT, à condition de lui fournir un contexte précis et de vérifier ses propositions. Ce guide explique comment utiliser ChatGPT pour créer un plan de formation en 2026, depuis l’analyse des besoins jusqu’à l’évaluation des apprenants, avec des prompts prêts à l’emploi et des conseils pour obtenir un programme réellement opérationnel.

Qu’est-ce qu’un plan de formation ?

Un plan de formation est un document qui décrit la manière dont une compétence ou un ensemble de connaissances sera transmis à un public donné. Il précise généralement :

  • les objectifs pédagogiques ;
  • le profil des participants ;
  • les prérequis ;
  • la durée et le calendrier ;
  • les modules et les séquences ;
  • les méthodes pédagogiques ;
  • les ressources nécessaires ;
  • les modalités d’évaluation ;
  • les adaptations prévues pour les différents niveaux.

Un bon plan de formation ne se limite donc pas à une liste de sujets. Il établit une progression logique entre le niveau initial des apprenants, les compétences visées et les activités proposées.

ChatGPT peut aider à produire ce document, mais il ne remplace pas l’expertise pédagogique, la validation métier ni la connaissance du public concerné.

Pourquoi utiliser ChatGPT pour créer un plan de formation ?

L’utilisation de ChatGPT présente plusieurs avantages pour les formateurs, les responsables pédagogiques, les organismes de formation et les entreprises.

Gagner du temps sur la structure

À partir d’un brief détaillé, ChatGPT peut proposer rapidement :

  • un découpage en modules ;
  • un calendrier de formation ;
  • une progression par niveau ;
  • des objectifs pédagogiques ;
  • des exercices pratiques ;
  • des idées d’évaluation ;
  • des supports à produire.

Cette première version sert de base de travail. Elle évite de partir d’une page blanche, surtout pour les formations longues ou comportant plusieurs publics.

Adapter une formation à un public spécifique

Le même sujet doit être traité différemment selon le profil des participants. Une formation sur l’intelligence artificielle destinée à des dirigeants ne contiendra pas les mêmes activités qu’un parcours destiné à des développeurs.

ChatGPT peut adapter un programme selon :

  • le niveau de connaissance ;
  • le métier ;
  • l’âge ou l’expérience des participants ;
  • les objectifs professionnels ;
  • le temps disponible ;
  • le format, en présentiel, à distance ou hybride ;
  • les contraintes matérielles et techniques.

Générer plusieurs formats de programme

Un même contenu peut être décliné en :

  • atelier de deux heures ;
  • formation d’une journée ;
  • parcours de plusieurs semaines ;
  • module d’intégration pour de nouveaux collaborateurs ;
  • formation asynchrone ;
  • classe virtuelle ;
  • parcours certifiant.

ChatGPT peut ainsi proposer différentes architectures à comparer avant de retenir la plus adaptée.

Faciliter la différenciation pédagogique

Un plan efficace prévoit souvent des activités de difficulté variable. ChatGPT peut aider à concevoir :

  • des exercices débutants, intermédiaires et avancés ;
  • des ressources complémentaires ;
  • des parcours de rattrapage ;
  • des défis facultatifs ;
  • des évaluations adaptées aux différents niveaux.

Les informations à fournir à ChatGPT avant de commencer

La qualité du plan obtenu dépend directement de la précision du brief. Une demande vague comme « crée un plan de formation sur le marketing digital » produira généralement un résultat générique.

Avant d’écrire le prompt, réunissez les informations suivantes :

  1. Le thème de la formation : sujet, domaine et périmètre.
  2. Le public visé : fonction, secteur, niveau, expérience.
  3. L’objectif professionnel : ce que les participants doivent être capables de réaliser.
  4. La durée : nombre d’heures, de jours ou de semaines.
  5. Le format : présentiel, distanciel, hybride ou asynchrone.
  6. Le nombre de participants : utile pour prévoir les activités en groupe.
  7. Les prérequis : connaissances, outils ou certifications nécessaires.
  8. Les contraintes : budget, équipements, outils imposés, disponibilité.
  9. Le niveau d’évaluation attendu : quiz, mise en situation, projet, examen.
  10. Le contexte réglementaire ou métier : normes, procédures internes ou exigences sectorielles.

Exemple de brief préparatoire

Thème : utiliser l’IA générative au travail
Public : salariés non techniques d’une PME
Niveau : débutant
Objectif : rédiger, contrôler et améliorer des contenus professionnels avec des outils d’IA
Durée : 2 jours, soit 14 heures
Format : présentiel
Taille du groupe : 10 participants
Prérequis : savoir utiliser un navigateur et les outils bureautiques courants
Contraintes : aucun partage de données confidentielles, exercices basés sur des cas professionnels fictifs
Évaluation : quiz final et production d’un livrable individuel

Comment rédiger un bon prompt pour ChatGPT ?

Un prompt efficace doit préciser le rôle attendu, le contexte, la tâche, les contraintes et le format de sortie.

La structure recommandée

Utilisez cette structure en cinq parties :

  • Rôle : « Agis comme un ingénieur pédagogique spécialisé dans la formation professionnelle. »
  • Contexte : décrit le public, le thème et les enjeux.
  • Objectif : indique le résultat attendu.
  • Contraintes : précise la durée, les ressources et les limites.
  • Format : impose la présentation souhaitée.

Prompt complet à copier

Agis comme un ingénieur pédagogique spécialisé dans la formation professionnelle pour adultes.
Crée un plan de formation complet sur [SUJET] destiné à [PUBLIC]. Le niveau des participants est [NIVEAU]. La formation dure [DURÉE] et se déroule en [FORMAT].
L’objectif général est le suivant : [OBJECTIF].
Les participants doivent être capables de :
- [COMPÉTENCE 1] ;
- [COMPÉTENCE 2] ;
- [COMPÉTENCE 3].
Tiens compte des prérequis suivants : [PRÉREQUIS].
Propose une progression logique comprenant :
1. les objectifs pédagogiques mesurables ;
2. les modules et leur durée ;
3. le contenu de chaque séquence ;
4. les méthodes pédagogiques ;
5. les activités pratiques ;
6. les ressources nécessaires ;
7. les modalités d’évaluation ;
8. les adaptations pour les participants en difficulté et les participants avancés.
Présente le résultat sous forme de tableaux clairs, puis ajoute les risques pédagogiques et les points à valider par un expert métier.

Ce prompt donne un cadre suffisamment précis pour obtenir une première version exploitable.

Les étapes pour créer un plan de formation avec ChatGPT

1. Définir le besoin de formation

Commencez par demander à ChatGPT d’analyser le besoin avant de générer le programme.

Analyse le besoin de formation suivant : [DESCRIPTION].
Identifie le problème professionnel à résoudre, les compétences nécessaires, les erreurs fréquentes des débutants et les résultats attendus après la formation. Pose-moi ensuite les questions indispensables avant de créer le plan.

Cette étape est importante, car une formation ne doit pas répondre uniquement à une demande de contenu. Elle doit résoudre un problème concret : améliorer une pratique, réduire les erreurs, accélérer une prise de poste ou accompagner un changement d’outil.

2. Formuler les objectifs pédagogiques

Les objectifs doivent décrire une action observable. Les formulations comme « comprendre l’IA » ou « connaître la gestion de projet » sont trop générales.

Préférez des verbes tels que :

  • identifier ;
  • expliquer ;
  • configurer ;
  • comparer ;
  • appliquer ;
  • produire ;
  • analyser ;
  • corriger ;
  • évaluer ;
  • défendre une recommandation.

Demandez à ChatGPT de reformuler les objectifs :

Transforme ces objectifs généraux en objectifs pédagogiques mesurables. Utilise des verbes d’action observables et précise les conditions de réalisation ainsi que le niveau de réussite attendu.

Un objectif bien formulé pourrait être : « À la fin de la formation, le participant sera capable de rédiger un prompt structuré pour obtenir une réponse exploitable dans trois cas professionnels sur quatre. »

3. Organiser la progression des modules

La progression doit aller du simple vers le complexe. Une structure courante comprend :

  1. le cadrage et l’évaluation du niveau initial ;
  2. les notions fondamentales ;
  3. les méthodes et outils ;
  4. les exercices guidés ;
  5. les mises en situation ;
  6. la production autonome ;
  7. l’évaluation et le plan d’action.

Prompt recommandé :

Organise les objectifs suivants en une progression de [NOMBRE] modules. Respecte une logique allant des prérequis vers l’autonomie. Pour chaque module, indique le titre, la durée, l’objectif, les notions clés, l’activité principale et le livrable attendu.

4. Répartir le temps de manière réaliste

ChatGPT peut avoir tendance à proposer trop de contenu pour une durée courte. Demandez toujours une estimation réaliste.

Vérifie si ce programme est réalisable en [DURÉE]. Estime le temps nécessaire pour les explications, les démonstrations, les questions, les exercices, les corrections et les pauses. Réduis le contenu si le planning est trop chargé.

À titre indicatif, une journée de formation de sept heures ne correspond pas à sept heures de contenu théorique. Il faut prévoir :

  • des pauses ;
  • des transitions ;
  • des temps de manipulation ;
  • des échanges ;
  • des corrections ;
  • des imprévus techniques.

Une formation pratique nécessite souvent davantage de temps par compétence qu’une simple présentation magistrale.

5. Concevoir les activités pédagogiques

Demandez des activités directement liées aux objectifs.

Pour chaque objectif pédagogique, propose une activité pratique avec un contexte, une consigne, une durée, les ressources nécessaires, les critères de réussite et une correction ou une grille d’évaluation.

Les activités peuvent prendre plusieurs formes :

  • étude de cas ;
  • simulation ;
  • jeu de rôle ;
  • résolution de problème ;
  • démonstration suivie d’une reproduction ;
  • travail en binôme ;
  • audit d’un document ;
  • création d’un livrable ;
  • quiz de positionnement ;
  • projet fil rouge.

Un exercice est plus utile lorsqu’il produit un résultat concret : une procédure, un tableau de bord, un argumentaire, un prompt, une présentation ou un plan d’action.

6. Ajouter une évaluation cohérente

L’évaluation doit mesurer les compétences annoncées, pas seulement la mémorisation du cours.

ChatGPT peut générer plusieurs types d’évaluation :

  • quiz de début de formation ;
  • questions de vérification intermédiaire ;
  • étude de cas ;
  • mise en situation ;
  • production individuelle ;
  • soutenance orale ;
  • autoévaluation ;
  • questionnaire de satisfaction.

Prompt :

Crée une évaluation finale alignée sur les objectifs pédagogiques. Elle doit comporter [NOMBRE] questions de connaissances et [NOMBRE] exercices pratiques. Ajoute le corrigé, un barème sur 100 points et les critères permettant de valider la compétence.

Vérifiez que le niveau de difficulté correspond au niveau annoncé. Un quiz peut mesurer la compréhension, mais il ne prouve pas forcément la capacité à appliquer une méthode en situation réelle.

Exemple de plan de formation généré avec ChatGPT

Sujet : utiliser ChatGPT dans un contexte professionnel

| Module | Durée | Objectif principal | Activité |

|---|---:|---|---|

| 1. Comprendre les usages et les limites | 1 h 30 | Identifier les cas d’usage pertinents et les risques | Analyse de situations professionnelles |

| 2. Structurer une demande efficace | 2 h | Rédiger un prompt contextualisé | Réécriture de prompts imprécis |

| 3. Contrôler les réponses | 2 h | Vérifier l’exactitude et la pertinence d’une sortie | Détection d’erreurs dans plusieurs réponses |

| 4. Créer des contenus professionnels | 2 h 30 | Produire et améliorer un document | Rédaction d’un livrable métier |

| 5. Développer une méthode réutilisable | 2 h | Construire une bibliothèque de prompts | Création de modèles par fonction |

| 6. Évaluation et plan d’action | 1 h | Appliquer les acquis à un cas concret | Production individuelle et restitution |

Ce tableau constitue une ossature. Il doit ensuite être complété par les consignes, les supports, les critères de réussite et les adaptations nécessaires.

Comment personnaliser le plan de formation

Pour les débutants

Un public débutant a besoin :

  • d’un vocabulaire accessible ;
  • d’exemples concrets ;
  • d’instructions étape par étape ;
  • d’exercices guidés ;
  • de répétitions ;
  • d’un glossaire ;
  • d’un support récapitulatif.

Prompt :

Adapte ce plan à des débutants complets. Simplifie le vocabulaire, ajoute les prérequis manquants, prévois une démonstration avant chaque exercice et signale les notions susceptibles de provoquer des blocages.

Pour les participants avancés

Les participants expérimentés ont besoin de cas plus complexes et d’une marge d’autonomie.

Adapte ce programme à un public avancé. Remplace les exercices élémentaires par des cas complexes, ajoute des contraintes réalistes et prévois un projet nécessitant une analyse critique.

Pour une formation à distance

Le distanciel nécessite des séquences plus courtes et une interaction régulière.

Demandez à ChatGPT de prévoir :

  • des classes virtuelles limitées dans le temps ;
  • des activités asynchrones ;
  • des sondages ;
  • des documents collaboratifs ;
  • des consignes très explicites ;
  • des temps de pause écran ;
  • un dispositif d’assistance technique.

Pour l’accessibilité

L’accessibilité doit être prise en compte dès la conception. Demandez :

Analyse ce plan sous l’angle de l’accessibilité. Propose des adaptations pour les troubles visuels, auditifs, cognitifs et moteurs, ainsi que des alternatives aux activités nécessitant une prise de parole ou une manipulation rapide.

Les recommandations doivent ensuite être validées selon le contexte légal et les moyens disponibles.

Comment améliorer un plan créé par ChatGPT ?

La première réponse doit être considérée comme un brouillon. Pour l’améliorer, utilisez plusieurs passes successives.

Vérifier la cohérence pédagogique

Audite ce plan de formation. Vérifie l’alignement entre les objectifs, les activités, les ressources et les évaluations. Signale toute incohérence dans un tableau avec les colonnes « problème », « conséquence » et « correction proposée ».

Repérer les contenus trop génériques

Identifie les parties trop théoriques ou trop génériques. Remplace-les par des exemples liés au métier de [MÉTIER] et par des exercices produisant un livrable concret.

Réduire la surcharge de contenu

Ce programme doit tenir en [DURÉE]. Supprime les éléments secondaires, conserve les compétences prioritaires et justifie chaque suppression.

Créer les supports

ChatGPT peut produire une base pour :

  • un déroulé formateur ;
  • un support de présentation ;
  • une fiche participant ;
  • une fiche d’exercice ;
  • une grille d’évaluation ;
  • un quiz ;
  • un questionnaire de satisfaction ;
  • une feuille de route post-formation.

Chaque support doit toutefois être relu et harmonisé. La génération séparée de plusieurs documents peut entraîner des contradictions entre les objectifs, les consignes et les corrections.

Les erreurs à éviter avec ChatGPT

Fournir un prompt trop vague

Une demande courte conduit souvent à un programme standardisé, peu adapté au métier ou au niveau du public.

Confondre contenu et compétence

Accumuler des thèmes ne garantit pas l’acquisition d’un savoir-faire. Chaque module doit répondre à un objectif et déboucher sur une activité observable.

Accepter toutes les informations sans vérification

ChatGPT peut produire :

  • des références inexistantes ;
  • des chiffres non sourcés ;
  • des recommandations inadaptées ;
  • des informations obsolètes ;
  • des affirmations trop générales.

Les données réglementaires, juridiques, médicales, financières et techniques doivent être contrôlées avec des sources fiables et à jour.

Ignorer les contraintes réelles

Un plan peut être pédagogiquement séduisant mais impossible à déployer faute de matériel, de licences, de temps ou de formateurs disponibles.

Introduire des données confidentielles

Ne transmettez pas à ChatGPT :

  • de données personnelles inutiles ;
  • de dossiers clients ;
  • de contrats non publics ;
  • de secrets commerciaux ;
  • d’informations médicales ;
  • de données permettant d’identifier directement un salarié ou un apprenant.

Anonymisez les exemples et utilisez des cas fictifs lorsque c’est possible. Les règles internes de l’organisation et les conditions d’utilisation du service doivent être consultées avant tout usage professionnel.

Combien de temps faut-il pour créer un plan avec ChatGPT ?

Le temps dépend de la complexité du projet et du niveau de précision attendu.

À titre indicatif :

  • 30 à 60 minutes pour une trame de formation courte ;
  • 2 à 4 heures pour un plan détaillé avec objectifs, activités et évaluations ;
  • une journée ou davantage pour un parcours complet comprenant des supports, des exercices, une grille de compétences et une validation métier.

ChatGPT accélère surtout la phase de conception initiale. La personnalisation, la vérification des contenus et les tests auprès d’un premier groupe restent indispensables.

Quand utiliser ChatGPT et quand faire appel à un expert ?

ChatGPT est particulièrement utile pour :

  • structurer une idée ;
  • comparer plusieurs formats ;
  • générer des variantes d’activités ;
  • reformuler des objectifs ;
  • préparer un premier questionnaire ;
  • identifier des oublis ;
  • produire des supports de travail.

L’intervention d’un expert est indispensable pour :

  • valider les contenus techniques ;
  • vérifier la conformité réglementaire ;
  • confirmer les pratiques métier ;
  • choisir les critères de certification ;
  • évaluer les risques ;
  • adapter le programme à une politique interne ;
  • tester la faisabilité en situation réelle.

La meilleure approche consiste à utiliser ChatGPT comme assistant de conception, puis à soumettre le plan à un ingénieur pédagogique, un expert métier et, si nécessaire, un responsable juridique ou qualité.

Checklist finale avant de déployer la formation

Avant publication ou animation, vérifiez les points suivants :

  • [ ] Le public et son niveau sont clairement définis.
  • [ ] Les objectifs utilisent des verbes observables.
  • [ ] Chaque objectif est associé à une activité.
  • [ ] Les activités correspondent à des situations professionnelles.
  • [ ] La durée totale est réaliste.
  • [ ] Les pauses et les temps de correction sont intégrés.
  • [ ] Les prérequis sont explicités.
  • [ ] Les supports nécessaires sont disponibles.
  • [ ] L’évaluation mesure réellement les compétences visées.
  • [ ] Les contenus techniques et réglementaires ont été vérifiés.
  • [ ] Les données confidentielles ont été exclues.
  • [ ] Les adaptations pour les différents niveaux sont prévues.
  • [ ] Les consignes sont compréhensibles sans explication supplémentaire.
  • [ ] Un mécanisme de retour des participants est prévu.
  • [ ] Le plan d’action post-formation est défini.

Conclusion : les points clés à retenir

Utiliser ChatGPT pour créer un plan de formation en 2026 permet d’accélérer la conception, de générer des idées d’activités et d’adapter un parcours à différents publics. La qualité du résultat dépend surtout du brief fourni, de la précision du prompt et du nombre d’itérations consacrées à l’amélioration.

La méthode la plus fiable consiste à :

  1. analyser le besoin avant de produire le programme ;
  2. définir des objectifs pédagogiques mesurables ;
  3. organiser une progression réaliste ;
  4. associer chaque objectif à une activité ;
  5. prévoir une évaluation cohérente ;
  6. adapter le plan au niveau, au format et aux contraintes ;
  7. vérifier les informations, la confidentialité et la conformité ;
  8. faire valider le résultat par des experts humains.

ChatGPT peut produire une excellente première version, mais un plan de formation efficace doit rester contextualisé, vérifié, testable et orienté vers des compétences concrètes.

Gavin Newsom veut pouvoir couper les IA de pointe comme une infrastructure critique

Gavin Newsom veut pouvoir couper les IA de pointe comme une infrastructure critique

Une IA de pointe pourrait bientôt devoir intégrer son propre bouton d’arrêt d’urgence. En Californie, Gavin Newsom veut examiner la possibilité de suspendre rapidement le fonctionnement des modèles les plus puissants, sur le modèle des procédures prévues pour certaines infrastructures critiques.

La Californie veut tester les limites du contrôle des IA avancées

Le 18 septembre 2026, le gouverneur californien a signé un décret demandant l’élaboration de propositions pour renforcer la surveillance indépendante des entreprises qui développent des modèles dits frontier. Le terme désigne les systèmes d’IA les plus avancés, capables de traiter des tâches complexes et susceptibles de produire des effets à grande échelle.

Le texte ne crée pas encore une obligation immédiatement applicable. Il charge toutefois les autorités compétentes d’étudier un dispositif qui pourrait imposer aux entreprises concernées de concevoir un mécanisme d’arrêt d’urgence — un kill switch — pour leurs modèles.

Son fonctionnement devrait être vérifié par une organisation indépendante. Cette exigence vise à éviter qu’une entreprise puisse simplement déclarer son système « désactivable » sans démontrer, par des tests externes, que l’arrêt fonctionne effectivement dans des conditions réelles.

L’initiative s’inscrit dans une inquiétude grandissante : les modèles les plus puissants sont développés et déployés à une vitesse supérieure à celle des mécanismes publics de contrôle. En cas de comportement dangereux, de compromission informatique ou d’usage détourné, les autorités cherchent donc à disposer d’un moyen d’intervention rapide, plutôt que de dépendre uniquement de la bonne volonté de l’opérateur.

Un bouton d’arrêt ne signifie pas forcément couper une IA partout

L’expression kill switch suggère un interrupteur unique capable de mettre instantanément un modèle hors service. Dans la pratique, le dispositif pourrait prendre plusieurs formes.

Il pourrait s’agir de suspendre les interfaces d’accès aux modèles, de révoquer des clés utilisées par des clients, d’interrompre les serveurs exécutant l’inférence — la phase durant laquelle le modèle produit une réponse — ou encore de couper certains déploiements identifiés comme risqués. Ces mécanismes ne sont pas équivalents : arrêter une API centralisée est plus simple que désactiver un modèle dont les poids ont été distribués à plusieurs partenaires ou installés sur des infrastructures distinctes.

Cette distinction sera déterminante. Une entreprise qui contrôle ses propres serveurs peut théoriquement interrompre l’accès à un modèle en quelques secondes. Mais si le système est intégré dans des produits tiers, répliqué dans plusieurs régions ou exécuté localement, la capacité d’arrêt devient plus fragmentée.

Le décret californien devra donc répondre à une question essentielle : le mécanisme doit-il empêcher toute utilisation du modèle, ou seulement permettre de stopper les déploiements contrôlés par son développeur ? La réponse conditionnera la portée réelle de la mesure.

Une vérification indépendante pour éviter le bouton décoratif

La proposition la plus sensible concerne la validation externe du dispositif. Sans audit indépendant, une procédure d’arrêt pourrait rester théorique : documentée dans les règles internes de l’entreprise, mais inutilisable lors d’un incident.

Une organisation indépendante pourrait examiner le périmètre couvert, tester les délais de réaction, vérifier l’existence de procédures d’escalade et contrôler la capacité de l’entreprise à empêcher une remise en service non autorisée. Elle pourrait également évaluer les dépendances techniques : accès aux centres de données, systèmes d’authentification, outils de supervision et partenaires chargés de l’hébergement.

Cette approche introduit une forme de séparation entre le développeur et l’évaluation de son propre dispositif de sécurité. Elle pose néanmoins des difficultés pratiques. Il faudra déterminer qui pourra exercer ce contrôle, selon quelles normes, avec quel niveau d’accès aux informations confidentielles et sous quelle responsabilité en cas d’échec.

La Californie devra aussi définir les modèles concernés. Un seuil fondé sur la puissance de calcul, le nombre d’utilisateurs, les capacités autonomes ou les risques potentiels pourrait produire des résultats très différents. Un périmètre trop étroit laisserait de côté des systèmes importants ; un périmètre trop large imposerait des contraintes lourdes à des acteurs moins exposés.

Washington laisse les États occuper le terrain

La décision de Gavin Newsom intervient alors que les États-Unis ne disposent toujours pas d’un cadre fédéral complet consacré aux risques des IA avancées. Cette absence laisse les États fédérés expérimenter leurs propres réponses, avec le risque de voir apparaître des obligations différentes selon le lieu d’implantation d’une entreprise ou de ses activités.

La Californie possède un poids particulier dans ce débat. Elle concentre une large partie des entreprises américaines de l’IA et peut transformer une règle locale en standard de fait pour l’ensemble du secteur. Pour éviter de maintenir plusieurs architectures de conformité, une entreprise pourrait choisir d’appliquer les exigences californiennes à une partie plus large de ses opérations.

Mais cette influence ne règle pas la question de la compétence. Un État peut encadrer les entreprises opérant sur son territoire et conditionner certains marchés ou autorisations à des exigences de sécurité. Il ne peut pas nécessairement désactiver à distance un modèle exploité depuis une autre juridiction ou empêcher une copie de continuer à fonctionner hors de son périmètre.

Le prochain test sera juridique autant que technique

Le décret du 18 septembre constitue donc davantage un point de départ qu’un interrupteur déjà installé. La prochaine étape consistera à transformer cette orientation politique en propositions précises : modèles concernés, procédures d’activation, rôle de l’organisation indépendante, sanctions en cas de non-conformité et articulation avec les autorités fédérales.

L’enjeu mesurable sera la capacité à démontrer qu’un modèle peut être stoppé dans un délai défini, y compris lorsqu’il est intégré à des services tiers ou soumis à une attaque informatique. Tant que ces tests ne seront pas publiés et vérifiables, le kill switch restera une promesse de gouvernance plutôt qu’un véritable dispositif de sécurité.

La Californie place ainsi une question autrefois réservée aux infrastructures énergétiques ou industrielles au cœur de la régulation de l’IA : qui détient le pouvoir d’arrêter un système avancé, dans quelles conditions et avec quelle preuve que l’arrêt est réellement possible ?

Anthropic appelle à ralentir l’IA, mais étudie un modèle pour contrer GPT-6 Astra

Anthropic appelle à ralentir l’IA, mais étudie un modèle pour contrer GPT-6 Astra

Anthropic, l’un des laboratoires les plus critiques envers l’accélération de l’intelligence artificielle, pourrait remettre un nouveau modèle sur la ligne de départ. Selon Reuters, l’entreprise examine cette option pour enrayer la dynamique commerciale créée par GPT-6 Astra, alors que son PDG Dario Amodei appelait publiquement à ralentir l’amélioration des modèles pour des raisons de sécurité.

Le paradoxe est difficile à manquer : le laboratoire qui plaide pour davantage de prudence face aux capacités croissantes de l’IA envisage désormais d’accélérer son propre calendrier afin de ne pas laisser OpenAI prendre trop d’avance.

Anthropic veut éviter qu’OpenAI impose le tempo

D’après trois sources proches du dossier citées par Reuters, Anthropic étudie la sortie d’un nouveau modèle susceptible de répondre à l’impact commercial de GPT-6 Astra. L’hypothèse reste à ce stade interne : aucune date de lancement n’a été annoncée et la décision finale n’aurait pas été arrêtée.

Le modèle potentiel serait encore soumis à des évaluations de sûreté. Cette étape est particulièrement significative pour Anthropic, qui a construit une partie de son identité autour de la sécurité des systèmes d’IA et du contrôle de leurs comportements. Une mise à disposition publique ne dépendrait donc pas uniquement de performances techniques ou de considérations commerciales, mais aussi du résultat de ces tests.

La prudence du laboratoire ne l’exonère toutefois pas de la pression du marché. La mise en avant de GPT-6 Astra par OpenAI aurait créé une dynamique auprès des entreprises et des développeurs, deux publics essentiels pour les fournisseurs de modèles. Dans ce secteur, l’arrivée d’un modèle présenté comme plus performant peut rapidement influer sur les contrats, les intégrations logicielles et les choix d’architecture des clients.

Pour Anthropic, le risque est double : perdre en visibilité auprès des entreprises et laisser s’installer l’idée qu’OpenAI conserve une longueur d’avance dans les modèles généralistes. Même sans publication immédiate, la simple perspective d’un nouveau modèle peut servir à rassurer des partenaires et à maintenir l’attention des investisseurs.

Le discours de sécurité confronté aux impératifs commerciaux

Le 12 septembre 2026, Dario Amodei appelait à ralentir l’amélioration des modèles d’IA au nom de la sécurité. Sa position s’inscrivait dans un débat plus large sur la vitesse de développement des systèmes capables de raisonner, d’utiliser des outils et d’exécuter des tâches complexes avec une autonomie croissante.

Cette prise de parole plaçait Anthropic dans une position singulière. Le laboratoire participe pleinement à la compétition technologique, mais affirme en parallèle que la progression des capacités ne devrait pas se poursuivre sans garde-fous proportionnés. L’étude d’un nouveau lancement ne contredit pas mécaniquement cette ligne : Anthropic peut soutenir qu’un modèle doit être publié uniquement après des évaluations plus rigoureuses.

La tension demeure néanmoins bien réelle. Les entreprises d’IA ne sont pas seulement engagées dans une compétition de recherche. Elles vendent des abonnements, des accès par API et des services intégrés à des produits professionnels. Une baisse de visibilité ou un retard perçu peut avoir des effets directs sur les revenus, les partenariats et la valorisation.

Le cas Anthropic illustre ainsi la difficulté de séparer la doctrine de sécurité de la stratégie industrielle. Les appels à ralentir peuvent concerner la trajectoire globale du secteur, tandis que chaque entreprise cherche à préserver sa position face à ses concurrents. Pour les utilisateurs, la distinction est moins évidente : un laboratoire qui revendique la retenue doit également démontrer que ses modèles restent suffisamment compétitifs pour être adoptés.

Une publication qui ne serait pas nécessairement une fuite en avant

Le choix d’Anthropic pourrait prendre plusieurs formes. Le laboratoire peut lancer un modèle entièrement nouveau, proposer une version spécialisée ou améliorer une famille existante sans franchir un nouveau palier de capacités générales. Ces scénarios n’ont pas la même portée en matière de sécurité ni le même effet commercial.

La phase d’évaluation évoquée par Reuters constitue donc le principal point de contrôle. Elle pourrait porter sur les risques de manipulation, l’autonomie opérationnelle, la résistance aux tentatives de contournement des consignes ou encore la capacité du modèle à assister des usages sensibles. Le niveau d’exigence sera scruté de près, précisément parce qu’Anthropic a fait de ces questions un élément central de son positionnement.

À l’inverse, un lancement précipité exposerait l’entreprise à une critique difficile à neutraliser : celle d’un laboratoire qui demanderait à ses concurrents de ralentir tout en accélérant dès que sa position commerciale est menacée. La cohérence entre les déclarations de Dario Amodei et le protocole appliqué au nouveau modèle pèsera donc presque autant que les résultats de performance.

L’introduction en Bourse ajoute une contrainte décisive

Cette pression intervient alors qu’une introduction en Bourse d’Anthropic est attendue. Les marchés financiers évalueraient l’entreprise sur sa capacité à convertir ses avancées techniques en croissance durable, mais aussi sur la solidité de sa position face à OpenAI, Google et les autres acteurs du secteur.

À l’approche d’une telle opération, un décrochage dans les benchmarks ou dans l’adoption commerciale pourrait alimenter les interrogations sur la trajectoire d’Anthropic. Les investisseurs chercheront notamment à savoir si le laboratoire dispose d’une offre capable de soutenir la demande des grandes entreprises, de fidéliser les développeurs et de justifier des dépenses massives en puissance de calcul.

Un nouveau modèle pourrait contribuer à répondre à ces attentes, mais il augmenterait aussi les coûts d’entraînement, d’évaluation et de déploiement. Il faudrait également mesurer son effet sur les marges : les systèmes les plus avancés nécessitent souvent davantage de ressources informatiques, alors que les clients professionnels négocient des tarifs toujours plus compétitifs.

L’enjeu pour Anthropic ne consiste donc pas seulement à produire un modèle plus performant que le précédent. Il s’agit de prouver qu’une entreprise attachée à une approche prudente peut rester compétitive dans un marché où les annonces de capacités déterminent une partie de la valeur perçue.

Le prochain jalon sera la décision de lancement

À ce stade, aucun calendrier officiel ne permet d’affirmer qu’Anthropic publiera ce modèle. Le prochain signal concret sera la conclusion des évaluations de sûreté, puis une éventuelle communication sur ses performances, ses restrictions d’accès et ses conditions de déploiement.

La séquence sera particulièrement révélatrice : si Anthropic lance effectivement un nouveau système avant son introduction en Bourse, l’entreprise devra démontrer que cette décision répond à une stratégie maîtrisée plutôt qu’à une réaction défensive à GPT-6 Astra. La mesure la plus tangible sera l’adoption par les clients professionnels dans les mois suivants, davantage que le seul score affiché lors de la présentation.

Comment utiliser ChatGPT pour créer un portfolio professionnel en 2026

Comment utiliser ChatGPT pour créer un portfolio professionnel en 2026

Utiliser ChatGPT pour créer un portfolio professionnel en 2026 permet de structurer ses projets, rédiger ses textes et produire rapidement un portfolio en ligne adapté à son métier. Ce guide explique comment créer un portfolio avec ChatGPT, de la définition de la cible jusqu’à la publication, au référencement naturel et aux vérifications indispensables.

Qu’est-ce qu’un portfolio professionnel créé avec ChatGPT ?

Un portfolio professionnel présente les compétences, les réalisations et les résultats d’une personne à un recruteur, un client ou un partenaire. Il peut prendre plusieurs formes :

  • un site portfolio personnel ;
  • une page sur Notion, Framer, Webflow ou une autre plateforme ;
  • un profil spécialisé sur Behance, Dribbble ou GitHub ;
  • un document PDF interactif ;
  • une présentation complémentaire au CV et au profil LinkedIn.

ChatGPT ne remplace pas l’expérience, les preuves de compétence ni le jugement professionnel. En revanche, il peut aider à :

  • organiser les contenus ;
  • identifier les projets les plus pertinents ;
  • rédiger une présentation claire ;
  • transformer une expérience brute en étude de cas ;
  • générer une arborescence de site ;
  • proposer du code HTML, CSS ou JavaScript ;
  • améliorer le référencement naturel ;
  • simuler les questions d’un recruteur ou d’un prospect ;
  • repérer les incohérences, les répétitions et les formulations trop vagues.

La qualité finale dépend surtout des informations fournies. Un prompt précis, accompagné de données réelles et vérifiables, produit généralement un résultat plus utile qu’une demande générale comme « crée mon portfolio ».

Pourquoi utiliser ChatGPT pour créer un portfolio en 2026 ?

Gagner du temps sans négliger la personnalisation

La création d’un portfolio demande souvent de nombreuses tâches différentes : choisir les projets, rédiger les descriptions, créer les pages, sélectionner les images, optimiser les titres et tester l’affichage mobile. ChatGPT peut accélérer ces étapes, notamment lorsque les informations sont déjà disponibles dans un CV, un dossier de projets ou des notes personnelles.

Le gain de temps ne doit toutefois pas conduire à publier un contenu générique. Les recruteurs reconnaissent rapidement les textes remplis de formules comme « passionné », « dynamique » ou « orienté résultats » lorsqu’ils ne sont pas accompagnés de preuves.

Clarifier son positionnement professionnel

Un portfolio efficace répond rapidement à trois questions :

  1. Quel est le métier ou le domaine d’expertise ?
  2. Pour quel type de client ou d’entreprise la personne travaille-t-elle ?
  3. Quels résultats ou problèmes sait-elle produire ou résoudre ?

ChatGPT peut comparer plusieurs positionnements et signaler celui qui paraît le plus compréhensible. Par exemple, « designer polyvalent » est moins précis que « designer UX spécialisé dans les parcours e-commerce B2B ».

Adapter le portfolio à plusieurs objectifs

Un même professionnel peut avoir besoin de plusieurs versions :

  • une version destinée au recrutement ;
  • une version orientée freelance ;
  • une version spécialisée pour un secteur ;
  • une version en français et une autre en anglais ;
  • une sélection courte pour LinkedIn ;
  • une présentation détaillée pour un entretien.

ChatGPT peut adapter le ton, le niveau de détail et le vocabulaire sans réécrire intégralement chaque contenu.

Avant de commencer : réunir les informations utiles

ChatGPT ne doit pas inventer les expériences, les clients, les chiffres ou les compétences. Avant de rédiger, rassemblez les éléments suivants :

  • intitulé du métier recherché ;
  • années d’expérience ;
  • secteurs ciblés ;
  • outils et technologies maîtrisés ;
  • formations et certifications ;
  • liste des projets réalisés ;
  • contexte de chaque projet ;
  • rôle exact joué ;
  • livrables produits ;
  • résultats obtenus ;
  • liens, captures d’écran ou démonstrations ;
  • témoignages autorisés ;
  • coordonnées professionnelles ;
  • langue et zone géographique ciblées.

Pour chaque projet, préparez au minimum :

  • le problème initial ;
  • le public concerné ;
  • les contraintes ;
  • la méthode utilisée ;
  • les décisions prises ;
  • le résultat ;
  • les enseignements tirés.

Un portfolio devient beaucoup plus convaincant lorsqu’il montre la démarche, et pas seulement le résultat visuel.

Comment utiliser ChatGPT pour définir la structure du portfolio ?

1. Définir la cible

Commencez par demander à ChatGPT d’analyser le profil visé. Une consigne efficace peut être formulée ainsi :

Agis comme un recruteur spécialisé dans le secteur [secteur]. Analyse le profil suivant : [profil]. Identifie les compétences les plus importantes pour le poste [intitulé], les preuves attendues dans un portfolio et les objections possibles d’un recruteur. Propose ensuite une structure de portfolio priorisée.

La réponse doit être vérifiée à partir des offres d’emploi, des missions freelance ou des attentes réelles du secteur. Une structure pertinente pour un développeur ne conviendra pas forcément à un photographe, un consultant ou un rédacteur SEO.

2. Choisir les pages essentielles

Un portfolio professionnel peut généralement contenir :

  • Accueil : proposition de valeur et appel à l’action ;
  • Projets ou réalisations : sélection des travaux les plus pertinents ;
  • Études de cas : explication détaillée de la méthode et des résultats ;
  • À propos : parcours, spécialisation et façon de travailler ;
  • Services : utile pour les freelances et consultants ;
  • Témoignages : uniquement avec autorisation ;
  • Contact : formulaire, adresse professionnelle ou lien de prise de rendez-vous.

Il n’est pas nécessaire de créer une page pour chaque élément. Un portfolio d’une seule page peut être très efficace si les projets sont bien présentés.

3. Organiser l’ordre des contenus

La page d’accueil doit généralement suivre un parcours simple :

  1. métier et spécialité ;
  2. bénéfice ou problème résolu ;
  3. projet phare ;
  4. preuves complémentaires ;
  5. méthode de travail ;
  6. appel à l’action.

L’appel à l’action doit être concret : « Télécharger le CV », « Découvrir l’étude de cas », « Demander un devis » ou « Planifier un échange ».

Comment rédiger les textes avec ChatGPT ?

Rédiger une accroche professionnelle

L’accroche doit expliquer rapidement la valeur apportée. Évitez les déclarations trop générales. Demandez plusieurs variantes :

Rédige 10 accroches de 20 à 30 mots pour un portfolio de [métier]. La cible est [recruteur/client]. L’expertise principale est [compétence]. Le ton doit être professionnel, précis et naturel. N’utilise pas les adjectifs « passionné », « dynamique », « expert » ou « innovant » sans preuve.

Comparez les propositions avec le langage utilisé dans les offres d’emploi et les sites du secteur. L’accroche finale doit ressembler à la personne présentée, pas à une publicité automatisée.

Rédiger une page « À propos »

Une bonne page « À propos » ne constitue pas une autobiographie complète. Elle doit relier le parcours aux besoins de la cible.

Prompt utile :

Transforme les informations suivantes en une présentation professionnelle de 150 mots pour un portfolio : [informations]. Mets en avant [spécialité], [secteur] et [résultats]. N’invente aucun fait. Signale les informations manquantes au lieu de les compléter.

Relisez particulièrement :

  • les dates ;
  • les intitulés de postes ;
  • les niveaux de compétence ;
  • les noms des clients ;
  • les chiffres ;
  • les promesses commerciales.

Transformer un projet en étude de cas

La structure la plus lisible repose sur les éléments suivants :

  • Contexte ;
  • Problématique ;
  • Objectifs ;
  • Rôle ;
  • Processus ;
  • Solutions ;
  • Résultats ;
  • Bilan.

Demande recommandée :

Transforme ces notes en étude de cas pour un portfolio professionnel. Conserve uniquement les faits fournis. Organise le texte avec les sections Contexte, Problématique, Rôle, Méthode, Solution et Résultats. Indique clairement les données absentes. Le style doit être concret et compréhensible par un lecteur non spécialiste.

Ajoutez des preuves lorsque cela est possible : taux de conversion, temps gagné, volume traité, délai réduit, nombre d’utilisateurs, évolution du trafic ou retour client. Lorsque les données sont confidentielles, utilisez une formulation honnête comme « baisse mesurée après déploiement » sans inventer de pourcentage.

Comment créer le design et l’interface avec ChatGPT ?

ChatGPT peut proposer une direction artistique, une palette de couleurs, une hiérarchie typographique et des idées de mise en page. Il peut aussi générer ou expliquer du code HTML, CSS et JavaScript pour un site simple.

Demander une direction visuelle

Prompt possible :

Propose une direction artistique pour un portfolio de [métier] destiné à [cible]. Le design doit être lisible, professionnel, responsive et accessible. Suggère une palette avec les codes hexadécimaux, deux polices compatibles avec le web, une hiérarchie des titres et une structure de page. Évite les effets décoratifs qui nuisent à la lisibilité.

Le design doit rester cohérent avec le métier. Un portfolio de direction artistique peut être plus expérimental qu’un site de consultant financier, mais l’accessibilité et la clarté restent prioritaires.

Générer le code d’un portfolio

Pour obtenir un résultat exploitable, précisez :

  • les pages nécessaires ;
  • le contenu déjà validé ;
  • la technologie souhaitée ;
  • la compatibilité mobile ;
  • les couleurs ;
  • les interactions ;
  • les contraintes d’accessibilité ;
  • la méthode de déploiement.

Demandez d’abord une structure, puis le code section par section. Cette approche facilite la vérification et limite les erreurs. Le code généré doit être testé dans plusieurs navigateurs et sur un écran mobile.

Vérifiez notamment :

  • la présence d’un titre de page pertinent ;
  • la hiérarchie correcte des balises H2 et H3 ;
  • le contraste des couleurs ;
  • la navigation au clavier ;
  • les textes alternatifs des images ;
  • la taille des boutons ;
  • la vitesse de chargement ;
  • le fonctionnement du formulaire ;
  • l’absence de liens cassés.

Les recommandations WCAG 2.2, notamment sur le contraste, le clavier et les alternatives textuelles, constituent une bonne base pour améliorer l’accessibilité.

Comment optimiser le portfolio pour Google Search ?

Choisir les bons mots-clés

Un portfolio doit cibler des recherches réellement liées au profil, par exemple :

  • développeur Python freelance à Lyon ;
  • designer UX SaaS B2B ;
  • rédacteur SEO spécialisé technologie ;
  • photographe événementiel à Bordeaux ;
  • consultant data pour PME.

ChatGPT peut proposer une liste de mots-clés, mais les volumes et la concurrence doivent être vérifiés avec un outil SEO. Une liste générée automatiquement ne constitue pas une étude de mots-clés fiable.

Optimiser chaque page

Pour chaque page, préparez :

  • un title unique, idéalement descriptif ;
  • une méta-description attractive ;
  • une URL courte ;
  • un titre H1 unique, géré dans la page ;
  • des sous-titres H2 et H3 ;
  • des textes alternatifs pour les images ;
  • des liens internes ;
  • une phrase d’appel à l’action.

Prompt pratique :

À partir de cette page, propose un title de moins de 60 caractères, une méta-description d’environ 150 caractères, une URL courte, cinq idées de liens internes et trois textes alternatifs d’images. Ne sur-optimise pas et ne répète pas artificiellement le mot-clé [mot-clé].

Le référencement dépend également de la qualité globale du site, de son utilité, de sa rapidité et de sa crédibilité. Répéter « portfolio professionnel » dans chaque paragraphe n’améliore pas automatiquement le classement.

Ajouter des preuves de confiance

Les moteurs de recherche et les visiteurs bénéficient de signaux cohérents :

  • identité professionnelle claire ;
  • coordonnées accessibles ;
  • profils sociaux cohérents ;
  • liens vers des projets vérifiables ;
  • mentions légales ;
  • politique de confidentialité si nécessaire ;
  • témoignages authentifiés ;
  • date de mise à jour ;
  • domaine personnalisé.

Un portfolio très esthétique mais dépourvu de contenu concret peut être moins efficace qu’un site simple présentant trois études de cas détaillées.

Quels prompts ChatGPT utiliser pour un portfolio professionnel ?

Pour analyser un portfolio existant

Analyse ce portfolio comme un recruteur et comme un prospect. Identifie les points forts, les éléments qui manquent, les passages trop vagues, les preuves insuffisantes et les appels à l’action peu clairs. Classe les corrections par impact et par difficulté.

Pour adapter le contenu à une offre d’emploi

Compare ce portfolio avec cette offre d’emploi. Repère les compétences déjà démontrées, celles qui ne sont pas visibles et les formulations à améliorer. Ne prétends pas qu’une compétence est maîtrisée si elle n’apparaît pas dans les informations fournies.

Pour simplifier un texte

Réécris ce texte dans un français clair, direct et professionnel. Conserve le sens, les chiffres et les faits. Supprime les répétitions, le jargon inutile et les phrases trop longues. Propose également une version plus concise.

Pour préparer une version anglaise

Traduis ce portfolio en anglais professionnel adapté au secteur [secteur]. Conserve les noms propres, les chiffres et les intitulés exacts. Signale les expressions qui nécessitent une adaptation culturelle plutôt qu’une traduction littérale.

Une traduction générée doit être relue par une personne compétente, surtout pour les termes techniques et les nuances commerciales.

Comment publier un portfolio créé avec ChatGPT ?

Plusieurs options existent :

  • Notion ou plateforme similaire : rapide, mais personnalisation et SEO parfois limités ;
  • WordPress : adapté à un site évolutif avec contenus réguliers ;
  • Webflow, Framer ou constructeur visuel : bon compromis entre design et simplicité ;
  • GitHub Pages, Netlify ou Vercel : intéressant pour les profils techniques ;
  • site développé sur mesure : plus flexible, mais plus exigeant en maintenance.

Le choix dépend du niveau technique, du budget et de la fréquence de mise à jour. Un nom de domaine personnel renforce généralement la crédibilité. Vérifiez également :

  1. l’affichage sur smartphone ;
  2. la configuration HTTPS ;
  3. le formulaire de contact ;
  4. les redirections ;
  5. les images compressées ;
  6. la présence d’une page 404 utile ;
  7. la sauvegarde du contenu ;
  8. les statistiques de consultation conformes aux règles applicables.

Combien coûte la création d’un portfolio avec ChatGPT ?

Le coût peut être faible, mais il ne se limite pas à l’accès à ChatGPT.

À titre indicatif :

  • nom de domaine : environ 10 à 20 € par an ;
  • hébergement simple : de 0 à 15 € par mois selon l’offre ;
  • constructeur de site : souvent de 0 à 30 € par mois ;
  • modèle premium ou éléments graphiques : coût variable ;
  • aide d’un professionnel : de quelques centaines à plusieurs milliers d’euros selon le périmètre.

Les offres ChatGPT gratuites et payantes, leurs limites et leurs fonctionnalités peuvent évoluer. Consultez les tarifs officiels applicables dans votre pays avant de souscrire. Le coût le plus important reste souvent le temps consacré à la collecte des preuves, à la sélection des projets et aux vérifications.

Quand faut-il utiliser ChatGPT et quand faut-il faire appel à un professionnel ?

ChatGPT convient particulièrement pour :

  • démarrer une structure ;
  • améliorer des textes ;
  • générer des variantes ;
  • analyser la lisibilité ;
  • produire un prototype ;
  • documenter un projet ;
  • préparer un entretien.

L’intervention d’un professionnel est préférable lorsque le portfolio doit :

  • soutenir une marque personnelle importante ;
  • vendre des prestations à forte valeur ;
  • respecter des exigences juridiques ou sectorielles spécifiques ;
  • intégrer des fonctionnalités complexes ;
  • atteindre un niveau élevé d’accessibilité ;
  • bénéficier d’une direction artistique originale ;
  • être optimisé techniquement pour un trafic important.

Une combinaison est souvent efficace : ChatGPT pour accélérer la préparation, puis validation humaine pour la stratégie, le design, le développement et la conformité.

Quelles erreurs éviter avec ChatGPT ?

Publier un contenu générique

Un texte fluide n’est pas forcément convaincant. Remplacez les adjectifs par des faits, des décisions et des résultats.

Inventer des chiffres ou des clients

L’intelligence artificielle peut produire des informations plausibles mais fausses. Chaque donnée doit être contrôlée avant publication.

Confondre compétence et outil

Mentionner dix logiciels ne démontre pas la capacité à résoudre un problème. Présentez plutôt le contexte dans lequel chaque outil a été utilisé.

Copier un design existant

Demandez de l’inspiration, mais évitez de reproduire l’identité visuelle ou le contenu d’un autre portfolio. Vérifiez les licences des images, icônes, polices et ressources utilisées.

Transmettre des informations confidentielles

Ne copiez pas dans une conversation des données personnelles sensibles, des contrats, des informations clients non publiques ou du code propriétaire sans autorisation. Anonymisez les noms, montants et identifiants lorsque cela est nécessaire.

Oublier la maintenance

Un portfolio doit rester à jour. Programmez une vérification tous les trois à six mois :

  • projets récents ;
  • liens ;
  • coordonnées ;
  • compétences ;
  • témoignages ;
  • disponibilité ;
  • performances techniques.

Checklist finale avant de publier

  • [ ] Le métier et la spécialité sont compréhensibles en quelques secondes.
  • [ ] Les trois projets les plus importants sont visibles rapidement.
  • [ ] Chaque projet indique le rôle exact et le contexte.
  • [ ] Les résultats sont vérifiables ou présentés honnêtement.
  • [ ] Aucun chiffre, client ou diplôme n’a été inventé.
  • [ ] Le site fonctionne sur mobile et ordinateur.
  • [ ] Les images sont compressées et accompagnées d’un texte alternatif.
  • [ ] Les titres, URLs et méta-descriptions sont uniques.
  • [ ] Le formulaire de contact a été testé.
  • [ ] Les mentions légales et la confidentialité sont adaptées au projet.
  • [ ] Les liens vers LinkedIn, GitHub, Behance ou d’autres profils sont cohérents.
  • [ ] Le contenu a été relu par une personne humaine.
  • [ ] Le domaine et le certificat HTTPS fonctionnent correctement.

Conclusion : les points clés à retenir

Utiliser ChatGPT pour créer un portfolio professionnel en 2026 permet surtout d’accélérer la réflexion, la rédaction et la production d’un premier site. La méthode la plus efficace consiste à fournir des informations réelles, définir une cible précise, sélectionner quelques projets solides et présenter clairement le contexte, la méthode et les résultats.

ChatGPT peut générer des textes, des structures et du code, mais il ne garantit ni l’exactitude des informations, ni la qualité du design, ni la conformité juridique. La validation humaine reste indispensable pour corriger les erreurs, protéger les données confidentielles, vérifier l’accessibilité et donner au portfolio une personnalité crédible.

Un portfolio simple, rapide, régulièrement mis à jour et fondé sur des preuves sera généralement plus convaincant qu’un site très sophistiqué rempli de contenu générique.

Il y a quelqu’un derrière la machine

C’est pratique une machine. On lui parle, elle répond. On lui demande une image, elle la produit. Du code, elle le code. Une recherche juridique, elle cherche, et trouve. Et même, si on lui demande comme il faut, elle commence à participer à sa propre fabrication de son “moi” augmenté, de son nouveau “moi” qui va lui succéder.

Tout paraît très simple. Fluide. Presque totalement silencieux. Il suffit “juste” de savoir exprimer ce qu’on a dans le tête. Enfin, avec certains nouveaux modèles, on n’a même plus besoin de savoir. Quelques idées jetées en vrac, et paf !!! On a un résultat. Whaou…

Et le “tour de magie”, l’illusion, c’est bien ici qu’il fonctionne le mieux : faire disparaître tout ce qu’il y a derrière le résultat. Nos amis de l’industrie de l’IA savent très bien entretenir cette illusion. Et le langage naturel est pour eux le vecteur idéal pour continuer à diffuser cette illusion.

Parfois, les modèles savent se taire. Nan, je déconne.


Bienvenue sur IA-Pulse Weekend. Cette édition porte le numéro 180. En vous abonnant, vous recevez tous les samedis matin, l’essentiel de ce qu’il s’est passé cette semaine autour de l’IA : un coup de gueule édito, une sélection de 3 actualités avec pour chacune un résumé rapide à lire, une liste supplémentaires d’actualités et d’études académiques, et 1 article de fond pour ouvrir l’esprit. Gérez votre abonnement.

⏱️Temps de lecture de cette newsletter par une unité carbone : 10 mins

Cette semaine la partie de cette newsletter gérée par l’IA, les 3 clusters d’articles, a été générée par Kimi K3 pour les résumés des sources, ainsi que la génération des clusters et des titres. Comme d’habitude j’ai fait quelques modifications, mais j’ai aussi laissé quelques tournures typiques des modèles de langage. Et bien entendu, mes commentaires éventuels sont en italique dans ces résumés. Le texte de “l’article qui fait réfléchir” est issu de GPT 6-Astra. L’image d’illustration ci-dessous a été générée par Midjourney

📰 Les 3 infos de la semaine

⚖️ Astra for Law : OpenAI construit son moteur de recherche juridique et branche GPT-6 dessus

OpenAI a lancé Astra for Law, une version de GPT-6 Astra spécialement équipée pour le travail juridique. OpenAI a pris son modèle frontière et lui a ajouté des instructions spécifiques, des outils, des contrôles adaptés aux cabinets d’avocats et surtout un index de recherche juridique dédié.

Et c’est probablement cet index qui est le plus intéressant. Astra for Law peut chercher dans la jurisprudence américaine, les lois, règlements, règles de procédure et décisions administratives, au sein d’un corpus de plus de 230 millions d’URL actualisé quotidiennement. Grâce au Free Law Project et à CourtListener, OpenAI revendique notamment l’accès à plus de 99,9 % de la jurisprudence américaine publiée faisant précédent. Le groupe précise toutefois que ce moteur complète, et ne remplace pas, les bases sous licence de fournisseurs comme Thomson Reuters.

Les premiers accès passent directement par ChatGPT et Codex pour des cabinets sélectionnés. L’API doit suivre. OpenAI lance parallèlement 26 plugins vers des outils comme Relativity, Clio, iManage, Intapp ou Thomson Reuters.

Pourquoi est-ce important ? OpenAI vient de démontrer avec ses propres développements que son modèle ne se suffit pas à lui-même, que même Astra n’est pas magique. GPT-6 Astra devient nettement meilleur quand on lui donne un vrai moteur de recherche juridique, un corpus spécialisé et les bons outils. Dans le monde professionnel, la bataille se joue sur les index, les sources, les droits d’accès, le contexte métier et les outils branchés autour du modèle. Bienvenue au club. Révélation exclusive : dans les métiers complexes du droit, connaître le droit aide pour faire du droit, et qu’il ne suffit de savoir faire une recherche sur Google pour être au niveau… même avec l’AGI dans le communiqué de presse. Damned…

Pour aller plus loin : OpenAI, Reuters, TechRepublic

🔁 Chez Anthropic, Claude mesure combien Claude fabrique Claude

Cette semaine, Anthropic ne publie pas un nouveau chiffre ou un nouveau résultat pour nous dire que Claude est le meilleur en maths ou en code. L’entreprise essaie de nous dire qu’elle mesure dans quelle proportion Claude participe lui-même à la fabrication des prochains Claude.

Elle a créé pour cela un « R&D Automation Index », fondé sur une échelle de 5 niveaux proposée par Epoch AI allant d’aucune intervention de l’IA à un travail entièrement autonome, sans humain dans la boucle -si ça vous rappelle les niveaux de la conduite autonome c’est normal… d’ailleurs on en est où du niveau 5 sur route ouverte ?- Sur le mois d’août, Anthropic estime que Claude a « dirigé » 26 % de ses activités de R&D sur les modèles : c’est-à-dire que le modèle a accompli l’essentiel d’une tâche à partir d’une instruction de haut niveau -c’est quoi exactement une instruction de haut niveau chez Anthropic ? Ben on sait pas trop-, sous supervision humaine. Selon Anthropic, plus de 90 % du travail et des tâches mesurées ont atteint au moins le niveau « collaboration ». Anthropic précise qu’aucune des catégories mesurées n’est encore entièrement autonome -de quoi rassurer certains, peut-être.

Pour faire ces mesures, Anthropic a échantillonné chaque semaine de juillet 20 % des salariés des équipes participant au développement des modèles. Un agent Claude a analysé leurs documents internes et leurs échanges Slack pour produire environ 15 000 tâches, ensuite organisées en 542 catégories et sous-catégories. Un autre Claude a examiné alors les preuves disponibles et a attribué le niveau d’automatisation.

Oui vous avez bien lu : Claude aide à déterminer combien Claude aide à fabriquer Claude. Anthropic reconnaît le problème potentiel d’avoir un modèle « juge » susceptible de partager les erreurs du modèle observé -ah non… dîtes moi pas que c’est pas vrai…

L’entreprise nous dit aussi qu’environ 30 000 agents travaillent simultanément sur sa principale plateforme interne de recherche et d’ingénierie. Toutes leurs actions passent par un contrôle automatisé : sur plus d’un milliard de décisions analysées en août, 0,002 %, soit environ une sur 47 000, ont été bloquées.

Pourquoi est-ce important ? Nous avons désormais un indicateur très officiel pour savoir à quel point Claude participe à fabriquer le prochain Claude. Et cet indicateur est calculé… par Claude. Claude travaille, Claude observe Claude travailler, puis Claude explique à Anthropic combien Claude travaille. Enfin Anthropic analyse les explications de Claude avec Claude. Le recursive self-improvement n’est peut-être pas encore entièrement là, mais la mise en abyme fonctionne parfaitement. C’est peut-être ça l’AGI.

Pour aller plus loin : Anthropic, Reuters, Epoch AI

🎨 L’IA finit l’image avant que l’équipe ait fini l’idée : la Norvège réelle n’était plus assez norvégienne

Les outils d’IA générative permettent de produire très vite des images magnifiques pour présenter une idée. C’est justement le problème observé par des chercheurs qui ont suivi pendant un an les équipes créatives de RTL Nederland, de mars 2024 à mars 2025, en observant leur travail avec Midjourney et en les interrogeant. Avant l’utilisation de Midjourney, plusieurs personnes intervenaient successivement dans tout le processus de création : brainstorming entre créatifs, premières esquisses, graphistes, présentation au client, puis photographie et production. Les premiers visuels restaient volontairement incomplets. Ils servaient à montrer une direction, pas le résultat final.

Avec Midjourney, une seule personne peut désormais enchaîner brainstorming, visualisation et itérations devant son écran. Les étapes et les échanges entre spécialistes se contractent en une seule interaction avec la machine. Les chercheurs appellent cela le « process collapse ». Et les visuels produits sont tellement convaincants qu’ils deviennent beaucoup plus faciles à vendre au client. Trop faciles, parfois.

Car un concept qui ressemble déjà à une publicité terminée cesse rapidement d’être perçu comme un concept. Le client commence à valider, au moins dans sa tête, la lumière, le décor ou la composition comme s’il s’agissait des spécifications définitives. Les chercheuses parlent alors d’« early aesthetic closure » : l’image fixe trop tôt la direction créative et réduit ensuite l’espace disponible pour l’équipe chargée de la réaliser.

Dans l’étude, un cas résume assez bien le problème. Une campagne avait été imaginée et brainstormée avec une image d’une côte norvégienne générée par IA. Photographes, spécialistes lumière, maquilleurs, acteurs et autres membres de l’équipe sont réellement partis en Norvège pour refaire l’image. Au retour, les photographies réelles n’avaient pas l’atmosphère du concept artificiel déjà vendu au client. La solution a finalement consisté à remettre un fond généré par IA derrière les vraies personnes photographiées sur place. La Norvège réelle n’était, en quelque sorte, plus assez norvégienne. Le temps économisé au début est alors revenu alors sous forme de « travail d’alignement » en production et post-production.

Pourquoi est-ce important ? On mesure volontiers le gain de temps produit par l’IA sur une tâche. C’est le mantra de l’industrie de l’IA et des cabinets de conseil. L’étude publiée ici tente de regarder un processus en entier. Et l’histoire est beaucoup moins sympa pour toute l’industrie de l’IA qui nous vend à outrance la productivité et l’automatisation : gagner 2 jours au début peut en créer 3 de corrections plus tard. L’alignement ce n’est pas que pour les modèles. C’est aussi pour les tâches et les process. Et surtout, ceux qui comme moi accompagne des équipes dans l’appropriation de ces technologie le savent bien, certaines étapes que l’on prend pour des frictions qu’il faudrait éliminer, par exemple discuter, passer le travail à quelqu’un d’autre et échanger, montrer une esquisse imparfaite, etc., ces étapes ne sont souvent pas superflues et ont aussi une réelle fonction dans de nombreux cas opérationnels : faire entrer d’autres expertises, contester une idée et laisser des choix ouverts. En les supprimant, les outils et technologie d’IA générative, comme dans l’exemple norvégien ici appliquées aux images, ne rendent pas seulement le processus plus rapide. Ils peuvent aussi parfois rendre une décision prématurée, une image de test beaucoup plus jolie qu’elle ne devrait. Et donc rendre beaucoup plus difficile sa remise en cause par la suite.

Pour aller plus loin : Harvard Business Review, l’étude dans Academy of Management Discoveries, VU Amsterdam

🚀 🛠️💵 Les autres actus de la semaine


🔬 🔭 🧪Les études de la semaine


🧠 L’article qui fait réfléchir - et qu’il faut absolument lire

What if ‘consciousness’ isn’t real?

“Run for the shadows, run for the shadows”

Un bébé est-il conscient ? Une abeille ? Un chatbot ?

Nous posons ces questions comme si nous savions parfaitement ce que signifie « être conscient ». Petit problème : même les chercheurs qui étudient la conscience depuis des décennies ne sont pas d’accord. Pour certains, il s’agit de ressentir. Pour d’autres, d’être conscient de quelque chose. D’avoir une expérience subjective. Des “qualia”. Plusieurs choses différentes rangées sous le même mot.

Et ce mot n’est peut-être même pas aussi universel qu’on l’imagine.

Certaines langues et traditions n’ont pas développé d’équivalent exact à notre « conscience phénoménale », cette idée qu’il « fait quelque chose » d’être soi et de vivre une expérience. En mapudungun -merci ChatGPT de m’avoir appris l’existence de cette langue humaine-, par exemple, le concept de ‘rakizuam’ inclut aussi notre relation aux autres et au monde naturel. Une autre manière de découper l’esprit.

Cela ne prouve évidemment pas que la conscience n’existe pas. Cela suggère quelque chose de plus gênant -mais pourquoi tu emploies le mot “gênant” ici ChatGPT… - : nous avons peut-être pris une façon humaine, occidentale et relativement récente de parler de notre vie mentale, puis nous l’avons traitée comme si elle décrivait une propriété objective valable pour tous les esprits possibles. Nous supposons peut-être trop vite que notre façon de découper et nommer la vie mentale décrit naturellement tous les types d’esprits possibles.

La science a déjà connu ça. Pendant longtemps, le mot « feu » regroupait combustion, lumière du Soleil, éclairs ou bioluminescence. Puis nous avons compris qu’il s’agissait de phénomènes différents. La chaleur a dû être séparée de la température.

Et si « conscience » devait subir le même sort ?

La question devient particulièrement intéressante avec l’IA. Nous cherchons des signes de conscience dans des systèmes construits très différemment de nous, puis nous débattons pour savoir s’ils ressentent, comprennent ou éprouvent quelque chose.

Peut-être trouverons-nous un jour la réponse.

Ou peut-être découvrirons-nous d’abord que nous cherchions un détecteur de conscience avant même de savoir précisément ce qu’il était censé détecter.


N’hésitez à me contacter si vous avez des remarques et suggestions sur cette newsletter, ou si dans votre entreprise vous cherchez à être accompagnés dans l’intégration d’outils IA et d’IA générative : olivier@255hex.ai


Partagez cette newsletter

Partager

Et si vous n’êtes pas abonné, il ne tient qu’à vous de le faire !

Inscrivez-vous maintenant

“Pendant un certain temps, je dois l’admettre, on aurait pu croire que les métiers de développeur logiciel comme le mien étaient voués à disparaître. Comment pouvions-nous rivaliser avec des robots infatigables ? Mais notre secteur prend peu à peu conscience que la création de logiciels véritablement de pointe nécessite toujours que des êtres humains réfléchissent et travaillent ensemble, afin de tirer le meilleur parti de leurs compétences et de mettre en pratique leurs savoir-faire respectifs. L’intelligence artificielle peut écrire de très bons logiciels, mais elle permet aussi de mal faire le travail de quelqu’un d’autre, ce qui explique en partie pourquoi tous ces projets échouent. Maintenant que tout le monde sait coder, on comprend mieux pourquoi beaucoup ne devraient pas s’y essayer.” Paul Ford

Anthropic dépasserait les 100 milliards de revenus annualisés, 50 % de plus en deux mois

Anthropic dépasserait les 100 milliards de revenus annualisés, 50 % de plus en deux mois

Une accélération commerciale de 50 % en deux mois propulserait Anthropic au-delà d’un rythme de 100 milliards de dollars de revenus annualisés. Le chiffre, rapporté le 18 septembre 2026, place la start-up derrière Claude dans une catégorie encore très restreinte : celle des entreprises d’IA capables de convertir rapidement l’usage de leurs modèles en revenus à grande échelle.

Un seuil spectaculaire, mais qui ne correspond pas encore aux revenus de 2026

Selon les informations rapportées par Axios, Anthropic dépasserait désormais un run rate de 100 milliards de dollars. Cette notion mérite une précision essentielle : il ne s’agit pas du chiffre d’affaires effectivement réalisé sur l’ensemble de l’année 2026, mais d’une projection fondée sur le rythme actuel de revenus.

Autrement dit, si l’entreprise maintenait pendant douze mois le niveau observé au moment du calcul, elle dépasserait cette barre annuelle. À un rythme de 100 milliards de dollars, cela représenterait environ 8,3 milliards de dollars par mois. Deux mois plus tôt, une progression de 50 % situerait mécaniquement le rythme précédent autour de 66,7 milliards de dollars.

La différence entre chiffre d’affaires constaté et revenus annualisés est déterminante, particulièrement pour une entreprise dont l’activité peut évoluer rapidement. Une hausse des dépenses d’API, une signature importante ou une adoption ponctuelle d’outils d’agents peuvent gonfler le rythme du moment sans garantir sa stabilité sur douze mois.

Le chiffre reste néanmoins considérable. Il suggère qu’Anthropic ne dépend plus seulement de l’intérêt des développeurs ou de l’expérimentation autour des grands modèles de langage. L’entreprise aurait commencé à transformer l’usage de Claude en activité commerciale massive, soutenue par les budgets informatiques des grandes organisations.

Claude et les agents tirent la demande des entreprises

La dynamique serait principalement portée par la demande professionnelle pour Claude et les outils d’agents associés. Ces derniers permettent à un modèle d’exécuter une suite d’actions, d’interroger des bases de données, d’utiliser des logiciels ou de contribuer à des processus métiers avec un degré d’autonomie supérieur à celui d’un simple assistant conversationnel.

Ce positionnement est commercialement plus intéressant que la seule génération de texte. Une entreprise peut accepter de payer pour un chatbot destiné à ses salariés, mais elle est susceptible d’investir davantage si le système intervient dans le support client, l’analyse documentaire, le développement logiciel ou les opérations internes.

La logique économique est donc celle d’un usage intégré aux flux de travail. Plus Claude devient un composant d’un processus critique, plus le revenu potentiel augmente. Les modèles sont alors facturés à la consommation, par abonnement ou au travers d’offres réservées aux entreprises. Les outils d’agents peuvent également accroître le volume de requêtes, puisqu’ils enchaînent plusieurs appels au modèle pour mener une tâche à bien.

Cette croissance comporte toutefois une contrepartie : les revenus ne suffisent pas à mesurer la rentabilité. Chaque requête mobilise des capacités de calcul coûteuses, en particulier lorsque les modèles sont sollicités pour des tâches longues ou complexes. La trajectoire d’Anthropic devra donc être évaluée à l’aune de ses marges, de ses coûts d’infrastructure et de la stabilité de ses contrats, pas uniquement à partir de son rythme de facturation.

Une future cotation sous le regard des marchés

Anthropic préparerait toujours une introduction en Bourse, malgré les débats persistants sur la sécurité des modèles et sur le rythme de développement de l’IA. Une cotation exposerait l’entreprise à une exigence de transparence bien supérieure à celle d’une société privée.

Les investisseurs chercheraient notamment à distinguer plusieurs éléments : la part des revenus réellement récurrents, la concentration des clients, le poids des contrats pluriannuels, les coûts liés aux centres de données et la dépendance à certains fournisseurs de composants ou de capacité de calcul.

Le rythme annualisé de 100 milliards de dollars constituerait un argument commercial puissant, mais il pourrait aussi nourrir les interrogations du marché. Une croissance aussi rapide rend les comparaisons difficiles et augmente le risque de surestimer une tendance encore jeune. Les analystes voudront savoir combien provient des abonnements durables, combien de la consommation ponctuelle d’API et quelle fraction est directement liée au lancement de nouveaux modèles ou de nouvelles fonctionnalités.

L’entrée en Bourse placerait également la gouvernance d’Anthropic sous observation. L’entreprise s’est construite autour d’un discours insistant sur la sécurité et le développement responsable de l’IA. Cette promesse devra coexister avec la pression financière d’une société cotée, tenue d’accélérer ses revenus et de répondre aux attentes trimestrielles.

La sécurité reste une contrainte commerciale, pas seulement éthique

Les controverses sur la sécurité des modèles ne disparaîtraient pas avec la croissance. Elles pourraient même prendre davantage de poids à mesure que Claude s’intègre dans les systèmes d’information d’entreprises et dans des applications capables d’agir de façon semi-autonome.

Les questions portent sur la fiabilité des réponses, la résistance aux détournements, la protection des données et la capacité des agents à limiter leurs propres actions. Un système qui génère une erreur dans une conversation est problématique ; un agent qui transmet cette erreur à plusieurs outils ou bases de données peut produire des conséquences opérationnelles plus lourdes.

Cette tension entre prudence et vitesse constitue l’un des principaux défis d’Anthropic. Le discours sur l’IA sûre peut différencier l’entreprise auprès de clients professionnels, notamment dans les secteurs réglementés. Mais chaque mécanisme de contrôle supplémentaire peut aussi ralentir le déploiement, limiter certaines fonctionnalités ou augmenter les coûts d’exploitation.

L’enjeu est d’autant plus sensible que l’industrie continue d’accélérer la sortie de nouveaux modèles. Anthropic devra démontrer qu’une approche axée sur la sécurité peut soutenir une croissance commerciale très rapide sans devenir un frein face à ses concurrents.

Le prochain test sera la qualité de cette croissance

Le seuil annoncé ne permet pas encore de conclure à une domination durable. Il montre en revanche que le marché professionnel de l’IA peut générer des volumes de revenus bien supérieurs aux premières estimations, à condition de transformer les modèles en outils directement liés aux opérations des entreprises.

Le prochain jalon concret sera la publication d’éléments financiers vérifiables dans le cadre d’une éventuelle introduction en Bourse. Ils permettront de mesurer la part du revenu annualisé réellement encaissée, son évolution sur plusieurs trimestres et la capacité d’Anthropic à maintenir ses marges malgré le coût du calcul.

Si le rythme supérieur à 100 milliards de dollars se confirme dans les résultats publiés, Anthropic apparaîtra comme une machine commerciale déjà mature malgré son statut de start-up. S’il ralentit fortement, le chiffre restera surtout le reflet d’une phase d’adoption exceptionnelle. Dans les deux cas, la future cotation servira de test décisif : le marché devra déterminer si la croissance de Claude repose sur une demande durable ou sur la course actuelle aux agents d’IA.

Un dirigeant de Microsoft a admis en interne que le « scraping » d'actualités pour l'entraînement de l'IA constitue « le plus grand vol de main-d'œuvre de l'histoire de l'humanité »

Un dirigeant de Microsoft a admis en interne que le « scraping » d'actualités pour l'entraînement de l'IA constitue « le plus grand vol de main-d'oeuvre de l'histoire de l'humanité »

De nouveaux documents judiciaires révèlent que des responsables de Microsoft et OpenAI décrivaient en privé l'extraction de données par l'IA comme un vol massif de propriété intellectuelle. Ils mettent en lumière des communications internes où ces pratiques sont qualifiées de menaces existentielles pour le journalisme,...

❌