❌

Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hierFlux principal
  • ✇PandIA
  • Les meilleurs générateurs de voix IA gratuits en 2026
    Les meilleurs générateurs de voix IA gratuits en 2026 permettent de transformer un texte en narration naturelle pour une vidéo, un podcast, une présentation ou un livre audio. Ce guide compare les outils les plus utiles en français, leurs limites gratuites, la qualité des voix, les conditions commerciales et la méthode pour choisir le bon générateur.Comparatif des meilleurs générateurs de voix IA gratuits en 2026Le meilleur outil dépend du projet : une vidéo YouTube, une lecture personnelle, un

Les meilleurs générateurs de voix IA gratuits en 2026

Par : Vicomte
22 septembre 2026 à 12:06
Les meilleurs générateurs de voix IA gratuits en 2026

Les meilleurs générateurs de voix IA gratuits en 2026 permettent de transformer un texte en narration naturelle pour une vidéo, un podcast, une présentation ou un livre audio. Ce guide compare les outils les plus utiles en français, leurs limites gratuites, la qualité des voix, les conditions commerciales et la méthode pour choisir le bon générateur.

Comparatif des meilleurs générateurs de voix IA gratuits en 2026

Le meilleur outil dépend du projet : une vidéo YouTube, une lecture personnelle, un doublage professionnel ou une génération locale sans envoyer de données dans le cloud ne nécessitent pas les mêmes fonctionnalités.

| Outil | Type d’accès gratuit | Qualité en français | Usage commercial | Principal avantage |

|---|---|---:|---|---|

| ElevenLabs | Quota mensuel limité | Excellente | Généralement limité avec l’offre gratuite | Voix naturelles et expressives |

| Microsoft Azure AI Speech | Quota cloud mensuel | Très bonne | Possible selon l’offre et les conditions | API puissante et nombreuses voix |

| Google Cloud Text-to-Speech | Crédit ou quota gratuit | Très bonne | Possible selon l’utilisation | Large choix de voix et SSML |

| Amazon Polly | Offre gratuite sous conditions | Bonne à très bonne | Possible selon les conditions | Solution fiable pour les développeurs |

| TTSMaker | Version web gratuite | Bonne | À vérifier selon la licence | Simple, rapide et sans installation |

| CapCut | Fonction gratuite intégrée | Bonne | À vérifier selon le projet | Idéal pour les vidéos courtes |

| Canva | Fonction gratuite limitée | Bonne | Dépend du compte et du contenu | Création audio directement dans un design |

| Piper / Kokoro | Logiciels open source ou locaux | Variable à très bonne | Dépend de la licence du modèle | Aucun quota cloud et traitement local |

| NaturalReader | Version gratuite | Correcte à bonne | Souvent limité à l’usage personnel | Lecture de documents et de pages web |

| Microsoft Edge – Lecture à voix haute | Gratuit | Bonne | Non destiné à la production audio | Lecture immédiate sans inscription |

Le meilleur choix global : ElevenLabs

ElevenLabs reste l’une des références pour générer une voix IA réaliste. L’outil propose plusieurs voix en français avec des intonations relativement naturelles, notamment pour la narration, les vidéos explicatives et les formats audio.

L’offre gratuite comprend généralement un quota mensuel de génération, exprimé en crédits ou en caractères. Les limites peuvent concerner :

  • le volume de texte générable ;
  • le téléchargement des fichiers audio ;
  • l’accès à certaines voix ;
  • l’utilisation commerciale ;
  • les fonctions de clonage vocal ;
  • la conservation des projets.

Point important : une voix générée avec un compte gratuit n’est pas automatiquement exploitable dans une publicité, une vidéo monétisée ou un produit commercial. Les conditions de licence doivent être consultées avant publication.

Le meilleur pour les développeurs : Azure AI Speech

Microsoft Azure AI Speech fournit des voix neuronales en français via une interface web, une API et des outils de synthèse vocale. Le service convient particulièrement aux applications, aux assistants vocaux, aux logiciels d’accessibilité et aux automatisations.

Ses points forts sont :

  • plusieurs variantes régionales du français ;
  • réglage du débit, du ton et du volume ;
  • prise en charge du langage SSML ;
  • génération par lots ;
  • intégration dans une application ;
  • quota gratuit mensuel selon le service et la région.

Azure demande davantage de configuration qu’un outil comme TTSMaker ou CapCut. La création d’un compte cloud peut également nécessiter un moyen de paiement, même si l’utilisation reste dans les quotas gratuits.

Le meilleur pour la personnalisation : Google Cloud Text-to-Speech

Google Cloud Text-to-Speech propose des voix Standard, WaveNet et Neural2, avec différentes options de prononciation et d’intonation. Le service accepte le SSML, ce qui permet de contrôler les pauses, l’accentuation, la vitesse et la prononciation de certains mots.

La version gratuite dépend du moteur utilisé et des conditions du compte. Elle est particulièrement intéressante pour :

  • les prototypes ;
  • les tests de narration ;
  • les applications web ;
  • la lecture automatisée d’un grand volume de textes ;
  • les projets nécessitant une API stable.

L’interface est moins accessible aux débutants. Une mauvaise configuration peut aussi entraîner une facturation après dépassement du quota gratuit.

Le meilleur pour une utilisation simple : TTSMaker

TTSMaker est un générateur de voix IA accessible depuis un navigateur. Il ne demande généralement pas de compétences techniques et propose plusieurs voix ainsi que plusieurs langues, dont le français.

Il convient pour :

  • convertir rapidement un article en audio ;
  • préparer une narration courte ;
  • créer une voix temporaire pour une vidéo ;
  • tester plusieurs intonations ;
  • exporter un fichier audio sans installer de logiciel.

La qualité peut varier selon la voix choisie. Les limites de caractères, les délais de génération et les droits d’utilisation peuvent évoluer. Avant une publication commerciale, la page de licence du service doit être vérifiée.

Le meilleur pour les vidéos : CapCut

CapCut intègre une fonction de synthèse vocale directement dans son éditeur vidéo. Le texte est converti en voix, puis synchronisé avec une séquence, des sous-titres et des effets.

CapCut est pratique pour :

  • TikTok ;
  • YouTube Shorts ;
  • Instagram Reels ;
  • vidéos explicatives ;
  • présentations courtes ;
  • contenus destinés aux réseaux sociaux.

Son avantage principal est le gain de temps : le fichier audio n’a pas besoin d’être généré dans un service séparé. En revanche, l’accès aux voix, les conditions commerciales et certaines fonctions peuvent dépendre de la version utilisée ou de la région.

Le meilleur pour les designs : Canva

Canva propose des applications et fonctions de voix IA intégrées à son éditeur de contenus. La génération peut être utilisée dans une présentation, une vidéo, une infographie animée ou un support pédagogique.

L’outil est adapté aux personnes qui souhaitent :

  • créer une vidéo avec narration ;
  • ajouter une voix à une présentation ;
  • produire un contenu éducatif ;
  • associer directement le son à des images et des animations.

Le nombre de générations gratuites peut être limité. Les conditions d’exploitation dépendent également du type de compte, des éléments utilisés dans le design et de la politique de Canva.

Qu’est-ce qu’un générateur de voix IA ?

Un générateur de voix IA, aussi appelé outil de text-to-speech ou synthèse vocale, transforme un texte écrit en fichier audio. Le logiciel analyse les mots, la ponctuation et la structure des phrases, puis produit une voix artificielle qui reproduit certains éléments du langage humain.

Les outils modernes peuvent gérer :

  • les pauses ;
  • l’intonation ;
  • le rythme ;
  • l’accent ;
  • les émotions simulées ;
  • les changements de prononciation ;
  • plusieurs langues ;
  • différentes voix masculines, féminines ou neutres.

Il faut distinguer deux technologies.

La synthèse vocale classique

La synthèse vocale classique convertit un texte en audio à partir de voix préenregistrées ou modélisées. Elle convient à la lecture d’articles, aux annonces, à l’accessibilité et aux contenus automatisés.

Le clonage vocal

Le clonage vocal tente de reproduire la voix d’une personne précise à partir d’un échantillon audio. Cette technologie est plus sensible juridiquement et éthiquement.

Le consentement explicite de la personne concernée est indispensable. Utiliser la voix d’un acteur, d’un créateur ou d’une personnalité sans autorisation peut entraîner des problèmes liés au droit à l’image, au droit voisin, au droit d’auteur ou à l’usurpation d’identité.

Pourquoi utiliser un générateur de voix IA gratuit ?

La synthèse vocale permet de réduire le temps nécessaire à la production d’un contenu audio. Elle évite aussi de disposer immédiatement d’un microphone, d’un studio ou d’un comédien.

Les principaux avantages sont les suivants :

  • rapidité : une voix peut être générée en quelques secondes ;
  • coût réduit : les offres gratuites suffisent pour tester un projet ;
  • accessibilité : un texte peut être écouté par des personnes malvoyantes ou dyslexiques ;
  • multilinguisme : un même script peut être adapté en plusieurs langues ;
  • cohérence : la même voix peut être utilisée sur plusieurs vidéos ;
  • correction facile : une phrase modifiée peut être générée à nouveau sans refaire tout l’enregistrement.

La qualité n’est toutefois pas identique à celle d’un comédien professionnel. Les voix IA peuvent produire des erreurs sur les noms propres, les acronymes, les nombres, les sigles et les phrases très longues.

Comment choisir le meilleur générateur de voix IA gratuit ?

1. Définir le type de contenu

Le choix dépend du format final :

  • vidéo courte : CapCut ou Canva ;
  • podcast narratif : ElevenLabs ou une solution premium avec quota gratuit ;
  • lecture d’articles : Edge ou NaturalReader ;
  • application web : Azure, Google Cloud ou Amazon Polly ;
  • contenu local et confidentiel : Piper ou Kokoro ;
  • test rapide sans installation : TTSMaker.

2. Vérifier la qualité française

Une voix française peut être techniquement correcte sans être naturelle. Il faut tester :

  • les liaisons ;
  • les nombres ;
  • les dates ;
  • les noms étrangers ;
  • les acronymes ;
  • les mots anglais ;
  • les phrases interrogatives ;
  • les pauses entre les paragraphes.

Un échantillon de 100 à 150 mots suffit généralement pour comparer plusieurs services.

3. Contrôler les droits d’utilisation

La mention « gratuit » ne signifie pas forcément « libre d’utilisation commerciale ». Avant de publier une vidéo ou un podcast, vérifier :

  • l’autorisation de monétiser le contenu ;
  • la nécessité d’indiquer le nom du service ;
  • les restrictions sur la publicité ;
  • les droits associés aux voix personnalisées ;
  • la durée de conservation des fichiers ;
  • le droit de réutiliser l’audio après la fin de l’abonnement.

4. Mesurer la limite gratuite

Les offres peuvent être limitées par :

  • un nombre de caractères ;
  • un nombre de minutes ;
  • un nombre de générations ;
  • un quota mensuel ;
  • une limite quotidienne ;
  • une durée maximale par fichier.

Un script de 1 000 mots représente approximativement 6 à 8 minutes de narration, selon le débit. Une vidéo de 10 minutes peut donc consommer une part importante d’un quota gratuit.

5. Examiner les fonctions d’export

Les formats les plus courants sont MP3, WAV et parfois OGG. Pour un montage vidéo, le MP3 suffit généralement. Pour un montage audio avancé, le WAV est préférable, car il évite une compression supplémentaire.

Comment générer une voix IA gratuitement ?

La méthode reste similaire sur la plupart des plateformes.

  1. Rédiger un script court et bien ponctué.

Les phrases de 10 à 20 mots donnent souvent de meilleurs résultats que les phrases très longues.

  1. Choisir une voix française.

Tester plusieurs profils : narration, conversation, actualité, publicité ou voix institutionnelle.

  1. Découper le texte en blocs.

Un paragraphe de 500 mots peut produire une intonation moins naturelle qu’une série de segments plus courts.

  1. Ajouter des indications de rythme.

Les virgules, les points, les deux-points et les retours à la ligne influencent les pauses.

  1. Corriger la prononciation.

Écrire un acronyme comme il doit être prononcé ou remplacer temporairement un nom difficile par une transcription phonétique.

  1. Générer un premier échantillon.

Écouter 20 à 30 secondes avant de lancer la totalité du script.

  1. Exporter le fichier audio.

Choisir MP3 pour une vidéo standard ou WAV pour une production nécessitant davantage de qualité.

  1. Relire et contrôler le résultat.

Vérifier les erreurs, les respirations artificielles, les coupures et les prononciations incorrectes.

  1. Conserver la licence et les conditions applicables.

Une capture de la page de tarification ou des conditions peut être utile pour documenter l’autorisation d’utilisation.

Quelles solutions gratuites fonctionnent hors ligne ?

Les solutions locales évitent d’envoyer le texte à un serveur distant. Elles sont pertinentes pour les documents confidentiels, les données personnelles et les entreprises soumises à des exigences de confidentialité.

Piper

Piper est un moteur de synthèse vocale léger qui fonctionne localement sur ordinateur. Les modèles sont généralement rapides et adaptés aux projets automatisés. La qualité dépend fortement de la voix installée et du modèle disponible en français.

Les avantages sont :

  • absence de quota cloud ;
  • fonctionnement hors ligne ;
  • faible consommation de ressources ;
  • intégration possible dans un script ou une application.

La licence de chaque modèle doit être contrôlée séparément.

Kokoro

Kokoro est un modèle de synthèse vocale open source ou à poids ouverts, apprécié pour son rapport entre qualité et taille. Il peut être exécuté localement avec une configuration compatible.

Cette solution intéresse surtout :

  • les développeurs ;
  • les utilisateurs avancés ;
  • les projets nécessitant une génération en volume ;
  • les personnes qui ne souhaitent pas dépendre d’un abonnement.

L’installation, le téléchargement des modèles et la compatibilité avec le processeur ou la carte graphique demandent davantage de connaissances techniques qu’un service en ligne.

Combien coûte réellement une voix IA gratuite ?

Une offre gratuite peut être suffisante pour quelques tests, mais rarement pour une production intensive. Les modèles économiques les plus fréquents sont :

  • quota mensuel gratuit, puis abonnement ;
  • crédit de bienvenue, valable pendant une durée limitée ;
  • version gratuite avec voix moins nombreuses ;
  • export gratuit limité ;
  • fonction gratuite avec filigrane ou attribution ;
  • API gratuite jusqu’à un certain volume, puis facturation à la quantité de caractères.

Le prix dépend habituellement du nombre de caractères générés. Les voix les plus expressives, le clonage vocal, les fichiers haute qualité et les fonctions API sont souvent réservés aux forfaits payants.

Les limites et les risques à connaître

Une voix naturelle n’est pas toujours exacte

Une voix peut sembler réaliste tout en prononçant incorrectement un nom de marque ou une date. Une vérification humaine reste nécessaire avant publication.

Les offres changent régulièrement

Les quotas, les langues et les conditions commerciales peuvent être modifiés sans préavis. Les informations affichées dans le tableau de bord du service doivent primer sur les comparatifs publiés en ligne.

Les données peuvent être envoyées dans le cloud

Un texte contenant des informations personnelles, médicales, confidentielles ou contractuelles ne doit pas être transmis à un service sans vérifier sa politique de confidentialité et ses garanties de traitement.

Le clonage vocal demande une autorisation

Ne pas cloner la voix d’une personne sans consentement documenté. Pour une voix de célébrité ou d’un créateur identifiable, le risque juridique est particulièrement élevé.

L’audio IA peut devoir être signalé

Certaines plateformes, certains annonceurs ou certains réseaux sociaux peuvent demander de préciser qu’une voix artificielle a été utilisée. Une mention transparente renforce la confiance du public.

Quel générateur de voix IA choisir selon son besoin ?

  • Pour une vidéo TikTok ou YouTube Shorts : CapCut.
  • Pour une narration réaliste : ElevenLabs.
  • Pour une application ou une automatisation : Azure AI Speech ou Google Cloud Text-to-Speech.
  • Pour une conversion immédiate sans installation : TTSMaker.
  • Pour lire un article ou un document : Microsoft Edge ou NaturalReader.
  • Pour un usage local et confidentiel : Piper ou Kokoro.
  • Pour une présentation visuelle avec voix intégrée : Canva.
  • Pour tester plusieurs paramètres vocaux avec une API : Google Cloud ou Azure.

Conclusion : les points clés à retenir

Les meilleurs générateurs de voix IA gratuits en 2026 ne répondent pas tous au même besoin. ElevenLabs se distingue par le réalisme, CapCut par son intégration vidéo, TTSMaker par sa simplicité, tandis qu’Azure, Google Cloud et Amazon Polly conviennent mieux aux projets techniques.

Avant de choisir, vérifier systématiquement :

  • la qualité de la voix française ;
  • le quota de caractères ou de minutes ;
  • les formats d’export ;
  • l’autorisation d’utilisation commerciale ;
  • les règles relatives au clonage vocal ;
  • le traitement des données personnelles ;
  • les éventuelles limites d’API ou de téléchargement.

Pour un premier test, générer un court extrait avec le même texte sur deux ou trois plateformes reste la méthode la plus fiable. La meilleure voix IA n’est pas seulement celle qui paraît naturelle : c’est celle dont la licence, la prononciation et les limites correspondent réellement au projet.
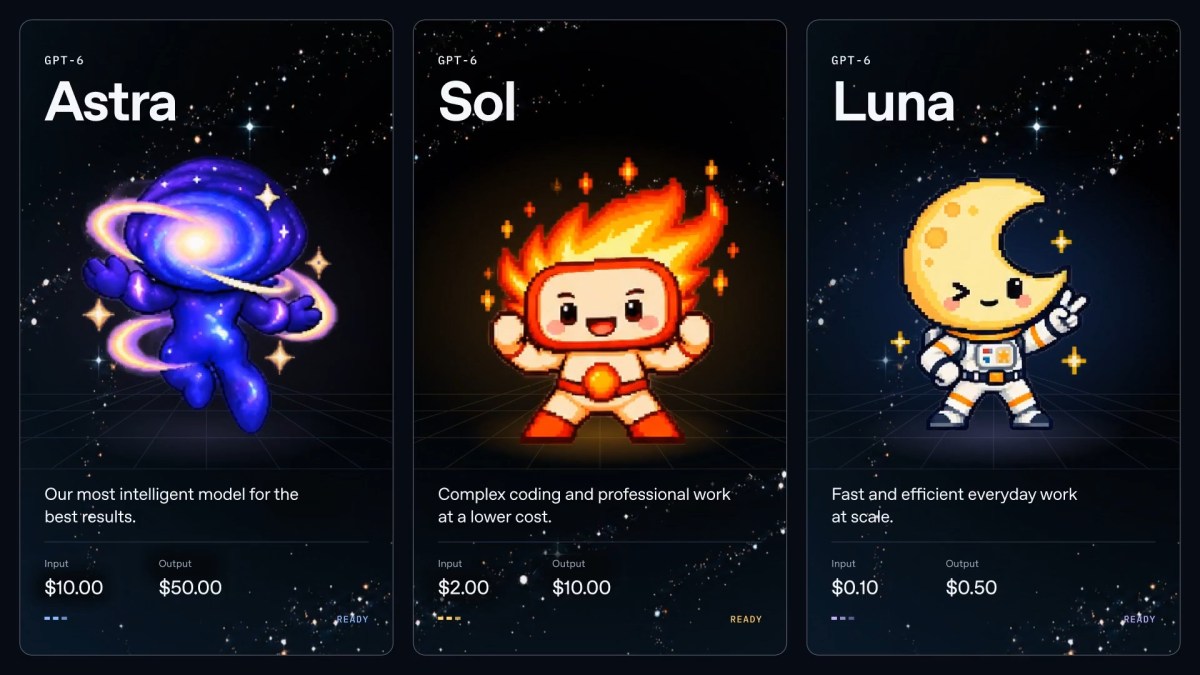
Claude Opus 5.5 et GPT-6 Sol sortent le même jour : Anthropic et OpenAI ont du mal à « ralentir » l’IA

Quelques jours après avoir appelé à ralentir la course à l'IA, Anthropic lance Claude Opus 5.5 et OpenAI complète sa gamme GPT-6 avec GPT-6-Sol et GPT-6-Luna. La bonne surprise vient des prix : les deux entreprises baissent les tarifs de leurs API.

  • ✇PandIA
  • Anthropic ouvre Mythos, Opus et Sonnet aux biologistes, mais assouplit ses garde-fous
    Une IA capable d’accélérer la découverte d’un médicament peut aussi produire des réponses dont le niveau de détail devient sensible dès qu’elles touchent à la biologie expérimentale. Anthropic assume désormais cette tension avec un programme d’accès vérifié à ses modèles les plus performants.Anthropic ouvre une voie dédiée aux sciences de la vieLe 17 septembre 2026, Anthropic a lancé en bêta le Life Sciences Verification Program, un dispositif destiné aux professionnels des sciences de la vie. I

Anthropic ouvre Mythos, Opus et Sonnet aux biologistes, mais assouplit ses garde-fous

Par : Vicomte
22 septembre 2026 à 07:01
Anthropic ouvre Mythos, Opus et Sonnet aux biologistes, mais assouplit ses garde-fous

Une IA capable d’accélérer la découverte d’un médicament peut aussi produire des réponses dont le niveau de détail devient sensible dès qu’elles touchent à la biologie expérimentale. Anthropic assume désormais cette tension avec un programme d’accès vérifié à ses modèles les plus performants.

Anthropic ouvre une voie dédiée aux sciences de la vie

Le 17 septembre 2026, Anthropic a lancé en bêta le Life Sciences Verification Program, un dispositif destiné aux professionnels des sciences de la vie. Il donne accès à Mythos, Opus et Sonnet pour des usages auparavant bloqués sur les versions grand public des modèles.

Le périmètre couvre plusieurs étapes de la chaîne de recherche : découverte de médicaments, biologie expérimentale et développement clinique. Pour les laboratoires pharmaceutiques, les sociétés de biotechnologie ou les équipes universitaires, l’intérêt est évident : exploiter des modèles généralistes avancés sur des questions où la compréhension de la littérature, la formulation d’hypothèses et l’analyse de données peuvent représenter des semaines de travail.

Anthropic indique que le programme est déjà utilisé par des dizaines d’organisations. Les candidatures sont désormais ouvertes plus largement, signe que l’entreprise cherche à passer d’une expérimentation limitée à un dispositif structuré de validation des utilisateurs.

Le mot important reste toutefois verification. L’accès ne repose pas uniquement sur la puissance du modèle, mais sur l’identité, le profil et l’usage déclaré de l’organisation candidate.

Des garde-fous moins restrictifs, mais pas supprimés

Sur les modèles grand public, certaines requêtes liées à la biologie peuvent être refusées ou fortement limitées. Cette prudence répond à un risque de dual use : une information utile à un chercheur peut également être détournée pour concevoir, modifier ou optimiser des systèmes biologiques présentant un danger.

Le programme d’Anthropic assouplit cette barrière pour des utilisateurs considérés comme légitimes. Les chercheurs peuvent donc soumettre des demandes plus proches de leur travail réel, notamment lorsqu’elles exigent un raisonnement scientifique approfondi ou une analyse de procédures expérimentales.

Cela ne signifie pas que les modèles deviennent accessibles sans contrôle. Anthropic présente le programme comme un cadre de confiance dans lequel l’accès est accordé à des professionnels identifiés, avec un suivi adapté à des usages sensibles. Le détail public des restrictions restantes, des critères d’acceptation et des mécanismes de contrôle demeure toutefois limité.

Cette asymétrie mérite attention : l’entreprise communique clairement sur l’ouverture de l’accès, mais moins sur la frontière exacte entre une demande autorisée et une requête refusée. Or cette frontière déterminera la valeur scientifique du programme autant que son niveau de risque.

Le pari : spécialiser l’accès plutôt que brider tous les utilisateurs

L’approche choisie par Anthropic s’inscrit dans un mouvement plus large de l’industrie de l’IA. Plutôt que d’appliquer les mêmes restrictions à tout le monde, les fournisseurs cherchent à différencier les utilisateurs selon leur contexte, leur expertise et leur capacité à encadrer les résultats.

Cette logique répond à une limite des blocages généralistes. Une politique conçue pour empêcher une assistance dangereuse peut également gêner un chercheur qui tente simplement d’interpréter un article, de comparer des hypothèses ou de préparer un protocole soumis à validation humaine. Dans les sciences de la vie, ces frictions peuvent réduire l’intérêt pratique d’un modèle pourtant performant.

Mais la vérification ne résout pas tout. Un professionnel légitime peut commettre une erreur, transférer une réponse hors de son organisation ou utiliser un résultat mal interprété. Les modèles peuvent aussi produire des recommandations plausibles mais inexactes, en particulier dans des domaines où les interactions biologiques sont complexes et les données incomplètes.

Le programme déplace donc le centre de gravité de la sécurité : une partie du risque n’est plus traitée par le refus automatique, mais par l’identité de l’utilisateur, la gouvernance de l’organisation et la supervision scientifique.

Des données isolées, selon Anthropic

Anthropic affirme que les données générées dans le cadre du programme sont compartimentées et ne servent pas à entraîner ses modèles. Cette garantie répond à une préoccupation centrale des entreprises pharmaceutiques et biotechnologiques : protéger les résultats non publiés, les candidats-médicaments, les données cliniques et la propriété intellectuelle.

La séparation annoncée peut faciliter l’adoption du service. Dans la recherche pharmaceutique, une fuite de données ne concernerait pas seulement des informations commerciales ; elle pourrait affecter des brevets, des partenariats ou le calendrier réglementaire d’un traitement.

Cette promesse doit néanmoins être évaluée sur pièces. Les organisations candidates auront intérêt à examiner les conditions contractuelles, la durée de conservation des données, les journaux d’accès, les droits des administrateurs et les procédures applicables en cas d’incident. La mention d’un compartiment séparé est importante, mais elle ne remplace pas un audit indépendant ni des garanties opérationnelles détaillées.

L’accélération scientifique dépendra de la qualité du contrôle

L’accès à Mythos, Opus et Sonnet peut réduire le temps nécessaire pour parcourir une littérature abondante, rapprocher des résultats dispersés ou générer des pistes à tester. Il ne transforme pas une hypothèse en preuve : les expériences, les contrôles, la reproductibilité et la validation clinique restent indispensables.

Le risque est plutôt de créer une confiance excessive dans des réponses bien formulées. En biologie, une erreur mineure dans une hypothèse ou une interprétation peut conduire à des expériences coûteuses, à des conclusions fragiles ou à des décisions cliniques prématurées. L’usage de ces modèles devra donc rester intégré à des processus où des experts vérifient les sources, reproduisent les analyses et documentent les décisions.

L’ouverture du programme marque aussi une évolution commerciale. Anthropic ne propose plus seulement un assistant généraliste pour les entreprises ; l’entreprise tente de construire un accès sectoriel capable de répondre aux exigences particulières de domaines sensibles. La réussite dépendra moins du nombre de comptes ouverts que de la capacité à démontrer une utilité mesurable sans relâcher la traçabilité.

Le prochain jalon sera l’évaluation de la bêta par ses premiers utilisateurs : gains de temps documentés, qualité des hypothèses produites, taux d’erreur, incidents de sécurité et conditions d’accès réellement appliquées. Si ces indicateurs sont convaincants, l’IA pourra s’intégrer plus profondément aux workflows de recherche biomédicale. Dans le cas contraire, l’assouplissement des garde-fous apparaîtra surtout comme un déplacement du risque vers les laboratoires eux-mêmes.

Sources : Anthropic — Life Sciences Verification Program · Anthropic — News

  • ✇PandIA
  • OpenAI et Google accusés d’une entente pour ralentir l’IA devant la justice américaine
    La prudence affichée par les principaux laboratoires d’IA pourrait désormais être examinée comme une possible stratégie anticoncurrentielle. Une plainte déposée le 18 septembre 2026 devant un tribunal fédéral californien accuse Anthropic, OpenAI, SpaceXAI et Google d’avoir coordonné un ralentissement du développement de leurs modèles.L’affaire ne porte donc plus seulement sur la sécurité des systèmes d’IA ou sur les risques liés à une course technologique trop rapide. Elle pose une question plus

OpenAI et Google accusés d’une entente pour ralentir l’IA devant la justice américaine

Par : Vicomte
21 septembre 2026 à 19:00
OpenAI et Google accusés d’une entente pour ralentir l’IA devant la justice américaine

La prudence affichée par les principaux laboratoires d’IA pourrait désormais être examinée comme une possible stratégie anticoncurrentielle. Une plainte déposée le 18 septembre 2026 devant un tribunal fédéral californien accuse Anthropic, OpenAI, SpaceXAI et Google d’avoir coordonné un ralentissement du développement de leurs modèles.

L’affaire ne porte donc plus seulement sur la sécurité des systèmes d’IA ou sur les risques liés à une course technologique trop rapide. Elle pose une question plus explosive : des concurrents peuvent-ils s’entendre pour réduire l’intensité de cette course sans tomber sous le coup du droit de la concurrence ?

Une déclaration de juillet au centre de la plainte

Les plaignants s’appuient notamment sur une déclaration signée en juillet 2026 par plusieurs responsables du secteur. Ce texte reconnaissait l’existence d’une pression concurrentielle forte : une entreprise qui ralentirait seule le développement de ses modèles risquerait de perdre du terrain face à ses rivales.

Cette formulation, qui pouvait être lue comme un constat sur les difficultés de la course à la performance, est désormais utilisée comme un élément susceptible d’étayer la thèse d’une coordination. Selon la plainte, les dirigeants et responsables du secteur auraient compris qu’un engagement collectif à modérer le rythme de développement pouvait éviter à chacun de supporter seul le coût commercial d’une politique de prudence.

La distinction entre une position commune sur la sécurité et un accord visant à limiter la concurrence sera déterminante. Des entreprises peuvent, en principe, coopérer sur des standards techniques, des méthodes d’évaluation ou des protocoles de sécurité. En revanche, un accord entre concurrents pour réduire leur offre, retarder la sortie de produits ou limiter la performance de leurs services pourrait relever d’une logique d’entente interdite.

Une accusation encore loin d’être établie

La plainte ne constitue pas une preuve de culpabilité. Elle expose la théorie des plaignants et devra franchir plusieurs étapes procédurales avant qu’un tribunal ne se prononce sur le fond.

Il faudra notamment déterminer si les échanges et déclarations évoqués démontrent un véritable accord, ou s’ils reflètent seulement une convergence publique sur les risques de l’IA. La justice devra aussi établir si une éventuelle coordination a produit des effets mesurables sur le marché : retards de lancement, limitation de capacités, réduction du choix pour les clients ou hausse indirecte des prix.

Cette nuance est essentielle. Dans les secteurs technologiques, les entreprises peuvent adopter des stratégies similaires sans s’être explicitement concertées. Des investissements comparables, des calendriers de sortie proches ou des précautions communes peuvent découler des mêmes contraintes techniques et réglementaires. Pour caractériser une entente, les plaignants devront apporter davantage qu’une série de déclarations prudentes ou de comportements parallèles.

Les abonnements payants au cœur du préjudice allégué

La plainte affirme que cette coordination présumée pourrait réduire la valeur des abonnements payants proposés par les acteurs concernés. L’argument repose sur une idée simple : si les laboratoires ralentissent volontairement l’amélioration de leurs modèles, les utilisateurs pourraient recevoir moins de progrès en matière de raisonnement, de rapidité, de fiabilité ou de fonctionnalités.

Le préjudice ne se limiterait donc pas à une innovation plus lente. Il pourrait aussi concerner les consommateurs et les entreprises qui paient chaque mois pour accéder aux versions avancées des assistants d’IA. Un abonnement conserverait son prix, mais offrirait une progression plus faible que celle qui aurait résulté d’une concurrence sans coordination.

Cette approche permet aux plaignants de présenter l’affaire sous l’angle classique du droit antitrust américain : une pratique entre concurrents aurait potentiellement diminué la qualité du produit et limité la pression concurrentielle, même sans hausse immédiate des tarifs.

La concurrence ne se mesure pas seulement au prix

Dans les services numériques, le prix n’est qu’un indicateur parmi d’autres. La qualité des réponses, les limites d’usage, la vitesse d’exécution, l’accès à de nouveaux outils et la capacité à traiter des tâches complexes font partie de la valeur proposée aux clients.

Une stratégie de ralentissement pourrait donc prendre des formes difficiles à mesurer. Elle pourrait passer par des versions moins ambitieuses, des capacités volontairement bridées ou des calendriers de déploiement retardés. Reste à prouver que ces choix résultent d’un accord entre les entreprises et non de contraintes liées aux coûts informatiques, à la disponibilité des puces, aux besoins de tests ou aux exigences de sécurité.

La sécurité de l’IA devient un enjeu de concurrence

Jusqu’à présent, les débats sur le ralentissement du développement de l’IA étaient principalement formulés en termes de gouvernance et de sécurité. Les partisans d’une approche prudente mettent en avant les risques liés aux modèles capables de générer du code, d’automatiser des tâches complexes ou d’interagir avec des outils externes.

Le dossier californien ajoute une autre dimension : la sécurité pourrait-elle servir de justification à une limitation concertée de la concurrence ? La question est particulièrement sensible parce que les entreprises concernées ont toutes intérêt à présenter leurs choix techniques comme responsables, tout en conservant leur avantage commercial.

Le droit devra ainsi séparer deux types de coopération. La première vise à réduire des risques documentés au moyen de règles communes, de tests partagés ou de mécanismes de signalement. La seconde pourrait consister à s’accorder sur un rythme de développement, un niveau de performance ou une stratégie commerciale afin d’éviter qu’un acteur ne prenne trop d’avance.

Cette frontière sera difficile à tracer, mais elle pourrait devenir un point de référence pour les futures discussions sur la régulation de l’IA. Si la plainte progresse, les échanges internes, les comptes rendus de réunions et les communications entre entreprises pourraient être examinés pour rechercher la preuve d’une intention commune.

Un dossier qui pourrait peser sur toute l’industrie

L’affaire vise quatre acteurs majeurs : Anthropic, OpenAI, SpaceXAI et Google. Leur présence dans une même procédure donne au dossier une portée particulière. Il ne s’agit pas d’un conflit limité à une relation commerciale ou à une fonctionnalité précise, mais d’une accusation visant la manière dont plusieurs concurrents auraient géré le rythme général du secteur.

Les conséquences pourraient être importantes même sans condamnation finale. Une enquête approfondie augmenterait la pression sur les laboratoires pour documenter leurs décisions de sécurité et distinguer clairement les discussions techniques des échanges commerciaux. Les autorités pourraient aussi chercher à encadrer les forums sectoriels où se rencontrent les responsables de l’IA.

Le prochain jalon sera l’examen de la plainte par le tribunal fédéral californien : recevabilité, éventuelles demandes de rejet, puis accès à des éléments internes si la procédure se poursuit. La capacité des plaignants à relier la déclaration de juillet 2026 à des effets concrets sur les modèles et les abonnements déterminera la solidité du dossier. Pour les utilisateurs comme pour les investisseurs, l’enjeu sera mesurable : savoir si la prudence revendiquée par les géants de l’IA correspondait à une gestion légitime des risques ou à une limitation coordonnée de la concurrence.

  • ✇PandIA
  • Comment installer et utiliser Ollama pour lancer une IA en local
    Pour installer Ollama et lancer une IA en local, il suffit d’installer le logiciel, de télécharger un modèle compatible avec l’ordinateur, puis de l’utiliser depuis un terminal ou une application graphique. Ce guide explique également comment choisir un modèle, vérifier les performances, appeler Ollama depuis une API et résoudre les problèmes les plus fréquents.Qu’est-ce qu’Ollama ?Ollama est un outil qui permet d’exécuter des modèles d’intelligence artificielle directement sur un ordinateur. Il

Comment installer et utiliser Ollama pour lancer une IA en local

Par : Decrypt
21 septembre 2026 à 12:06
Comment installer et utiliser Ollama pour lancer une IA en local

Pour installer Ollama et lancer une IA en local, il suffit d’installer le logiciel, de télécharger un modèle compatible avec l’ordinateur, puis de l’utiliser depuis un terminal ou une application graphique. Ce guide explique également comment choisir un modèle, vérifier les performances, appeler Ollama depuis une API et résoudre les problèmes les plus fréquents.

Qu’est-ce qu’Ollama ?

Ollama est un outil qui permet d’exécuter des modèles d’intelligence artificielle directement sur un ordinateur. Il fonctionne sur Windows, macOS et Linux et propose une interface en ligne de commande ainsi qu’une API locale.

Ollama ne constitue pas un modèle d’IA en lui-même. Il sert plutôt de moteur d’exécution pour des modèles comme :

  • Llama de Meta ;
  • Mistral ;
  • Gemma de Google ;
  • Qwen ;
  • DeepSeek ;
  • d’autres modèles de langage ou modèles multimodaux compatibles.

Une fois le modèle téléchargé, les conversations peuvent être traitées localement, sans envoyer les prompts à un service distant. Cette caractéristique est utile pour la confidentialité, le travail hors ligne et la maîtrise des coûts.

Pourquoi utiliser une IA locale avec Ollama ?

Une meilleure confidentialité

Les prompts, documents et réponses restent sur la machine lorsque le modèle est exécuté localement. Cette approche convient notamment aux données professionnelles, aux informations personnelles ou aux documents confidentiels.

Il faut toutefois rester vigilant : le téléchargement initial du modèle nécessite une connexion Internet, et une application tierce connectée à Ollama peut éventuellement transmettre des données à un serveur distant.

Une utilisation sans abonnement

Ollama est gratuit à installer. Les principaux coûts concernent :

  • le matériel nécessaire ;
  • l’espace de stockage ;
  • la consommation électrique ;
  • éventuellement une application complémentaire ou un service cloud.

Les licences des modèles sont différentes selon les éditeurs. La gratuité d’Ollama ne signifie donc pas que chaque modèle peut être utilisé sans restriction commerciale.

Un contrôle complet du modèle

L’utilisateur peut choisir :

  • la taille du modèle ;
  • le niveau de quantification ;
  • la température des réponses ;
  • le nombre de tokens générés ;
  • le comportement du système ;
  • l’emplacement de stockage des modèles.

Une intégration simple avec d’autres outils

Ollama expose une API locale sur l’adresse `http://localhost:11434`. Cette API peut être utilisée depuis :

  • une application Python ;
  • un script JavaScript ;
  • une interface web ;
  • un outil de recherche documentaire ;
  • un éditeur de code ;
  • une application de productivité.

Quelle configuration faut-il pour Ollama ?

Ollama fonctionne sans carte graphique dédiée, mais les performances dépendent fortement du matériel.

| Mémoire disponible | Modèles généralement adaptés |

|---|---|

| 4 à 8 Go de RAM | Modèles de 1 à 3 milliards de paramètres |

| 8 à 16 Go de RAM | Modèles de 7 à 9 milliards de paramètres quantifiés |

| 16 à 32 Go de RAM | Modèles de 14 milliards de paramètres |

| 32 Go de RAM ou davantage | Modèles de 32 milliards de paramètres et plus |

Ces indications restent approximatives. Le système d’exploitation, la longueur du contexte et les autres logiciels ouverts consomment également de la mémoire.

Espace disque nécessaire

La taille du fichier téléchargé varie selon le modèle et sa quantification. À titre indicatif :

  • un modèle de 3 milliards de paramètres peut occuper quelques gigaoctets ;
  • un modèle de 7 ou 8 milliards de paramètres nécessite souvent entre 4 et 6 Go ;
  • un modèle de 14 milliards de paramètres peut dépasser 9 Go ;
  • un modèle de 32 milliards de paramètres peut nécessiter 20 Go ou davantage.

Il est recommandé de conserver au moins 10 à 20 Go d’espace libre pour commencer confortablement.

Carte graphique ou processeur ?

Ollama peut utiliser :

  • le processeur, sur pratiquement toutes les machines compatibles ;
  • le GPU intégré des Mac Apple Silicon via Metal ;
  • certaines cartes NVIDIA ;
  • certaines configurations AMD ou Vulkan, selon le système et les pilotes.

Une carte graphique accélère généralement la génération. Si la mémoire vidéo est insuffisante, Ollama peut répartir le calcul entre le GPU et le processeur, avec une baisse de performance.

Comment installer Ollama sur Windows ?

Étape 1 : télécharger l’installateur

  1. Accédez au site officiel d’Ollama.
  2. Téléchargez l’installateur Windows.
  3. Lancez le fichier téléchargé.
  4. Suivez les étapes affichées à l’écran.
  5. Ouvrez PowerShell ou Windows Terminal.

L’installation native ne nécessite pas obligatoirement WSL. Ollama peut fonctionner directement sous Windows.

Étape 2 : vérifier l’installation

Exécutez la commande `ollama --version`.

Si une version s’affiche, le programme est correctement installé. Si Windows indique que la commande est introuvable, fermez puis rouvrez le terminal. Un redémarrage peut également être nécessaire.

Étape 3 : vérifier le serveur local

Ollama démarre généralement son service en arrière-plan. Pour le lancer manuellement, utilisez `ollama serve`.

L’API locale est normalement disponible à l’adresse `http://localhost:11434`.

Comment installer Ollama sur macOS ?

Étape 1 : télécharger l’application

  1. Téléchargez l’application Ollama depuis le site officiel.
  2. Ouvrez le fichier d’installation.
  3. Faites glisser Ollama dans le dossier Applications si cette étape est demandée.
  4. Lancez l’application.
  5. Autorisez son exécution si macOS affiche un avertissement de sécurité.

Sur les Mac équipés d’une puce Apple Silicon, Ollama peut exploiter le GPU intégré via Metal. Les performances varient selon la quantité de mémoire unifiée disponible.

Étape 2 : tester le terminal

Ouvrez l’application Terminal puis saisissez `ollama --version`.

Pour démarrer le serveur manuellement, utilisez `ollama serve`. L’application Ollama doit rester active si le service n’est pas lancé automatiquement.

Comment installer Ollama sur Linux ?

La méthode officielle la plus simple consiste à utiliser le script d’installation fourni par Ollama. Dans un terminal, exécutez `curl -fsSL https://ollama.com/install.sh | sh`.

Cette commande télécharge et installe le programme. Pour des raisons de sécurité, vérifiez toujours que la commande provient bien du site officiel avant de l’exécuter.

Vérifiez ensuite l’installation avec `ollama --version`.

Sur de nombreuses distributions, l’installateur configure un service système. Les commandes suivantes permettent de contrôler ce service :

  • `sudo systemctl status ollama` pour vérifier son état ;
  • `sudo systemctl start ollama` pour le démarrer ;
  • `sudo systemctl restart ollama` pour le relancer ;
  • `journalctl -u ollama` pour consulter les journaux.

Si le serveur n’est pas configuré comme service, lancez-le avec `ollama serve`.

Comment installer Ollama avec Docker ?

Docker est utile pour isoler Ollama ou l’intégrer à une infrastructure existante. Une installation CPU peut être lancée avec la commande `docker run -d -v ollama:/root/.ollama -p 11434:11434 --name ollama ollama/ollama`.

Pour utiliser une carte NVIDIA, il faut ajouter la prise en charge GPU de Docker et utiliser l’option adaptée, généralement `--gpus=all`.

Cette méthode demande davantage de configuration. Pour un premier usage sur un ordinateur personnel, l’installation native est généralement plus simple.

Comment télécharger un modèle dans Ollama ?

Après l’installation, choisissez un modèle dans la bibliothèque officielle d’Ollama. Pour télécharger un modèle, utilisez la commande `ollama pull llama3.2`.

Le nom exact dépend du modèle et de sa variante. Exemples courants :

  • `ollama pull llama3.2` ;
  • `ollama pull llama3.2:1b` pour une version plus légère ;
  • `ollama pull qwen2.5:7b` ;
  • `ollama pull mistral` ;
  • `ollama pull gemma3`.

Les noms, tailles et versions disponibles peuvent évoluer. Consultez la fiche du modèle avant de lancer le téléchargement, notamment pour vérifier la licence, la langue et les besoins matériels.

Comment lancer une IA locale avec Ollama ?

Une fois le modèle téléchargé, lancez-le avec `ollama run llama3.2`.

Ollama ouvre alors une conversation dans le terminal. Saisissez une question, puis appuyez sur Entrée.

Exemples de demandes :

  • `Résume ce texte en cinq points.`
  • `Explique la différence entre une API REST et une API GraphQL.`
  • `Rédige une description de produit en français.`
  • `Traduis ce paragraphe en anglais professionnel.`

Pour quitter la conversation, utilisez généralement la commande `/bye`, le raccourci Ctrl+D ou Ctrl+C selon le terminal.

Dans l’interface interactive, la commande `/help` affiche les fonctions disponibles. Les commandes peuvent varier selon la version installée.

Quelles commandes Ollama faut-il connaître ?

Les commandes essentielles sont les suivantes :

  • `ollama list` affiche les modèles installés ;
  • `ollama pull nom_du_modele` télécharge un modèle ;
  • `ollama run nom_du_modele` lance une conversation ;
  • `ollama show nom_du_modele` affiche les informations du modèle ;
  • `ollama ps` liste les modèles actuellement chargés en mémoire ;
  • `ollama stop nom_du_modele` arrête un modèle ;
  • `ollama rm nom_du_modele` supprime un modèle ;
  • `ollama cp modele_source modele_copie` crée une copie sous un autre nom ;
  • `ollama help` affiche l’aide générale.

La commande `ollama ps` est particulièrement utile pour vérifier si le modèle utilise le CPU, le GPU ou les deux.

Comment choisir le bon modèle ?

Pour un ordinateur peu puissant

Privilégiez un modèle de 1 à 3 milliards de paramètres. Il sera plus rapide et consommera moins de mémoire, mais ses réponses seront souvent moins précises sur les tâches complexes.

Les variantes légères sont adaptées à :

  • la reformulation ;
  • la classification ;
  • les réponses courtes ;
  • les petits scripts ;
  • les usages hors ligne basiques.

Pour un usage général

Les modèles de 7 à 9 milliards de paramètres offrent généralement un bon compromis entre qualité et rapidité. Ils conviennent à la rédaction, à la traduction, au résumé et à l’assistance au développement.

Pour la qualité maximale en local

Les modèles de 14 milliards de paramètres ou davantage produisent souvent de meilleures réponses, mais ils nécessitent plus de RAM, plus d’espace disque et davantage de temps de génération.

Un modèle plus grand n’est toutefois pas toujours meilleur. La qualité dépend aussi de l’entraînement, de la langue, de la quantification et de la formulation du prompt.

Comment appeler Ollama avec son API ?

Ollama propose une API locale accessible sur le port 11434.

Pour générer une réponse, utilisez par exemple la commande suivante :

`curl http://localhost:11434/api/generate -d '{"model":"llama3.2","prompt":"Explique le fonctionnement d’un réseau neuronal en trois phrases.","stream":false}'`

L’option `"stream":false` demande une réponse complète plutôt qu’un flux de tokens.

Pour utiliser une conversation avec plusieurs messages, l’endpoint `/api/chat` est plus adapté. Exemple :

`curl http://localhost:11434/api/chat -d '{"model":"llama3.2","messages":[{"role":"user","content":"Donne trois idées de sujets pour un blog tech."}],"stream":false}'`

La liste des modèles disponibles peut être récupérée avec `curl http://localhost:11434/api/tags`.

Ollama propose également une compatibilité avec certaines bibliothèques OpenAI via l’adresse `http://localhost:11434/v1`. Cette compatibilité facilite l’intégration avec des applications existantes, mais les fonctions disponibles peuvent différer selon les bibliothèques.

Utiliser Ollama depuis Python

Le paquet Python officiel peut être installé avec `pip install ollama`.

Une requête de chat peut ensuite être réalisée avec une instruction du type `from ollama import chat; response = chat(model='llama3.2', messages=[{'role': 'user', 'content': 'Résume ce texte.'}])`.

Pour un projet réel, prévoyez une gestion des erreurs lorsque le serveur est arrêté, lorsque le modèle n’est pas installé ou lorsque la mémoire disponible est insuffisante.

Comment personnaliser un modèle avec un Modelfile ?

Ollama permet de créer une variante personnalisée à partir d’un modèle existant.

Créez un fichier nommé `Modelfile` contenant par exemple les lignes suivantes :

  • `FROM llama3.2`
  • `PARAMETER temperature 0.2`
  • `SYSTEM Tu es un assistant spécialisé dans la rédaction technique en français.`

La température basse favorise des réponses plus prévisibles. Une température plus élevée produit davantage de variété, mais peut aussi augmenter les incohérences.

Créez ensuite le modèle avec `ollama create assistant-fr -f Modelfile`, puis lancez-le avec `ollama run assistant-fr`.

D’autres paramètres peuvent être configurés, notamment :

  • le nombre maximal de tokens générés ;
  • la longueur du contexte ;
  • la température ;
  • les séquences d’arrêt ;
  • le prompt système.

La personnalisation du modèle ne modifie pas ses connaissances de base. Elle agit principalement sur son comportement et son format de réponse.

Ollama peut-il analyser des fichiers PDF ?

Ollama seul ne constitue pas automatiquement un moteur de recherche dans les fichiers PDF. Pour interroger des documents, il faut généralement ajouter une interface ou un système de RAG, c’est-à-dire une récupération de passages pertinents avant la génération.

Les solutions complémentaires peuvent :

  1. extraire le texte des documents ;
  2. découper ce texte en passages ;
  3. créer des représentations vectorielles ;
  4. rechercher les passages les plus pertinents ;
  5. les transmettre au modèle Ollama.

Des interfaces comme Open WebUI peuvent fournir une expérience graphique et, selon la configuration, des fonctions de documents et de recherche locale.

Comment ajouter une interface graphique à Ollama ?

Ollama se contrôle nativement depuis le terminal. Pour une expérience plus proche de ChatGPT, il est possible d’utiliser une interface comme Open WebUI.

Le principe consiste à :

  1. installer Docker ;
  2. lancer Open WebUI ;
  3. le connecter au serveur Ollama ;
  4. ouvrir l’interface dans un navigateur, souvent sur le port 3000.

Ollama et Open WebUI doivent pouvoir communiquer sur le réseau local. Avec Docker, l’adresse de connexion peut nécessiter `host.docker.internal` ou une configuration réseau spécifique selon le système.

L’interface graphique simplifie la gestion des conversations, des modèles et parfois des documents, mais elle ajoute une couche logicielle supplémentaire à maintenir.

Comment améliorer les performances d’Ollama ?

Plusieurs réglages peuvent faire une différence :

  1. Choisir un modèle adapté à la RAM disponible. Un modèle trop volumineux entraînera des ralentissements ou des erreurs.
  2. Fermer les applications gourmandes. Les navigateurs avec de nombreux onglets peuvent consommer plusieurs gigaoctets.
  3. Utiliser un modèle quantifié. Il occupe moins de mémoire, avec une baisse de qualité généralement limitée.
  4. Réduire la longueur du contexte. Un contexte très long augmente la consommation mémoire.
  5. Éviter de charger plusieurs modèles en même temps. La commande `ollama stop nom_du_modele` libère les ressources.
  6. Installer les pilotes graphiques appropriés. Un GPU mal configuré peut laisser Ollama fonctionner uniquement sur le CPU.
  7. Placer les modèles sur un SSD. Les chargements sont plus rapides que sur un disque dur classique.

La vitesse dépend également du nombre de tokens générés par seconde. Une génération lente sur un ordinateur sans GPU est normale, surtout avec un modèle de grande taille.

Peut-on utiliser Ollama depuis un autre ordinateur ?

Par défaut, Ollama écoute généralement sur la machine locale. Cette configuration est la plus sûre.

Pour autoriser des connexions réseau, la variable `OLLAMA_HOST` peut être configurée avec une adresse comme `0.0.0.0:11434`. Cette modification expose potentiellement l’API à d’autres appareils du réseau.

Ne publiez pas directement le port 11434 sur Internet. L’API locale ne doit pas être considérée comme un service public sécurisé avec authentification complète. Pour un accès distant, utilisez plutôt un VPN, un tunnel sécurisé ou un proxy correctement configuré avec authentification et chiffrement.

Combien coûte l’utilisation d’Ollama ?

Le logiciel Ollama peut être installé gratuitement. Le coût réel dépend de l’équipement :

  • un ordinateur existant ne génère pas de coût matériel immédiat ;
  • une carte graphique peut représenter plusieurs centaines d’euros ;
  • les modèles occupent de l’espace disque ;
  • les longues générations augmentent la consommation électrique.

L’utilisation locale évite les coûts à la requête d’une API distante, mais elle peut être moins rapide ou moins performante qu’un service cloud haut de gamme.

Quand privilégier Ollama plutôt qu’une IA en ligne ?

Ollama est particulièrement adapté lorsque :

  • la confidentialité est prioritaire ;
  • une connexion Internet n’est pas toujours disponible ;
  • les tâches sont répétitives et automatisables ;
  • le budget d’API doit rester limité ;
  • l’utilisateur souhaite tester plusieurs modèles ;
  • un contrôle local du traitement est nécessaire.

Une IA en ligne reste souvent préférable lorsque la meilleure qualité disponible, les modèles les plus récents, la recherche web intégrée ou une puissance de calcul élevée sont prioritaires.

Résoudre les problèmes fréquents

La commande `ollama` est introuvable

Fermez et rouvrez le terminal. Si le problème persiste, vérifiez l’installation et le chemin système. Sous Windows, un redémarrage peut être nécessaire pour actualiser la variable PATH.

Le message « connection refused » apparaît

Le serveur Ollama n’est probablement pas démarré. Lancez `ollama serve`, vérifiez l’application sur macOS ou contrôlez le service avec `systemctl` sous Linux.

Le modèle est trop lent

Utilisez un modèle plus petit, réduisez le contexte, fermez les programmes inutiles et vérifiez la détection du GPU avec `ollama ps`.

Ollama manque de mémoire

Supprimez les modèles inutilisés avec `ollama rm nom_du_modele`, arrêtez les modèles actifs avec `ollama stop nom_du_modele` et choisissez une variante plus légère.

Le téléchargement échoue

Contrôlez la connexion Internet, l’espace disque disponible et les éventuels blocages du pare-feu. Relancez ensuite `ollama pull nom_du_modele`.

Où sont stockés les modèles ?

Les modèles sont conservés localement dans un dossier géré par Ollama. L’emplacement exact dépend du système d’exploitation et du mode d’installation.

La variable d’environnement `OLLAMA_MODELS` permet de définir un autre dossier de stockage. Cette option est pratique lorsque le disque système est presque plein ou lorsque les modèles doivent être installés sur un SSD secondaire.

Avant de déplacer ce dossier, arrêtez Ollama et vérifiez les droits d’accès du nouvel emplacement.

Comment mettre à jour Ollama et les modèles ?

Pour mettre à jour Ollama, utilisez la nouvelle version de l’installateur officiel. Sous Linux, la réexécution de la procédure d’installation officielle permet généralement d’installer la version récente.

Pour actualiser un modèle, utilisez `ollama pull nom_du_modele`. Les tags peuvent évoluer avec le temps : une même étiquette peut parfois pointer vers une version différente après une mise à jour.

Conservez une copie des fichiers importants de configuration et vérifiez la licence d’un modèle avant de l’intégrer dans un produit commercial.

Points clés à retenir

  • Ollama permet d’exécuter une IA localement sur Windows, macOS et Linux.
  • L’installation consiste à installer Ollama, télécharger un modèle avec `ollama pull`, puis le lancer avec `ollama run`.
  • Les modèles de 1 à 3 milliards de paramètres conviennent aux petites configurations, tandis que les modèles de 7 à 14 milliards offrent un meilleur compromis général.
  • Une carte graphique accélère le traitement, mais n’est pas indispensable.
  • L’API locale est disponible sur `http://localhost:11434`.
  • Les modèles occupent plusieurs gigaoctets : vérifiez la RAM et l’espace disque avant l’installation.
  • La confidentialité est meilleure qu’avec un service distant, mais les applications tierces connectées à Ollama doivent être contrôlées.
  • N’exposez jamais directement le port Ollama sur Internet sans protection adaptée.
  • Pour une interface graphique ou l’analyse de documents, ajoutez un outil comme Open WebUI ou une solution RAG.
  • ✇PandIA
  • Scott Bessent propose à Pékin une alerte IA avant qu’un accident ne devienne militaire
    Entre Washington et Pékin, l’intelligence artificielle commence à être traitée comme un risque stratégique au même titre que les cyberattaques ou les armes nucléaires. Le 20 septembre 2026, le secrétaire américain au Trésor Scott Bessent a indiqué que les États-Unis avaient proposé à la Chine un mécanisme de notification pour les incidents d’IA susceptibles de menacer la sécurité nationale.Prévenir l’escalade avant qu’elle ne devienne incontrôlableLa proposition intervient à quelques jours d’une

Scott Bessent propose à Pékin une alerte IA avant qu’un accident ne devienne militaire

Par : Vicomte
21 septembre 2026 à 07:00
Scott Bessent propose à Pékin une alerte IA avant qu’un accident ne devienne militaire

Entre Washington et Pékin, l’intelligence artificielle commence à être traitée comme un risque stratégique au même titre que les cyberattaques ou les armes nucléaires. Le 20 septembre 2026, le secrétaire américain au Trésor Scott Bessent a indiqué que les États-Unis avaient proposé à la Chine un mécanisme de notification pour les incidents d’IA susceptibles de menacer la sécurité nationale.

Prévenir l’escalade avant qu’elle ne devienne incontrôlable

La proposition intervient à quelques jours d’une rencontre prévue entre Donald Trump et Xi Jinping. Elle ne constitue pas encore un accord, ni même l’annonce d’un canal opérationnel déjà en place. Mais son existence signale une évolution notable : Washington et Pékin cherchent à établir un langage commun pour signaler certains incidents impliquant des systèmes d’intelligence artificielle.

Selon les informations rapportées par l’Associated Press, le mécanisme envisagé concernerait des événements susceptibles d’affecter la sécurité nationale. Le périmètre exact reste à définir : comportement imprévisible d’un modèle très avancé, capacité d’un système à contourner des garde-fous, utilisation malveillante dans une opération militaire ou cybernétique, ou encore accident touchant des infrastructures critiques.

L’objectif serait moins de résoudre immédiatement la rivalité technologique que d’éviter une mauvaise interprétation. Un système d’IA pourrait, par exemple, déclencher une alerte erronée, identifier à tort une activité hostile ou automatiser une réponse dans un environnement où les délais de décision sont extrêmement courts. Si l’autre puissance interprète l’incident comme une attaque délibérée, la crise pourrait s’aggraver avant même qu’une intervention humaine ne permette d’en établir la cause.

Un mécanisme proche des lignes de crise, sans être une hotline

Le projet évoque les dispositifs de communication établis pendant la guerre froide pour réduire les risques d’erreur entre puissances rivales. La comparaison s’arrête toutefois rapidement. Les arsenaux nucléaires sont contrôlés par des États selon des procédures relativement formalisées. Les technologies d’IA sont, elles, développées par des entreprises privées, des laboratoires universitaires, des agences militaires et des acteurs parfois difficiles à identifier.

Un incident pourrait donc survenir dans un modèle commercial, un outil de renseignement, un logiciel militaire ou une infrastructure informatique opérée par un prestataire. La question centrale serait alors celle de l’attribution : comment déterminer rapidement qui est responsable, si l’événement relève d’une défaillance, d’une attaque informatique, d’un usage détourné ou d’une décision volontaire ?

Un canal de notification ne supprimerait pas ce problème. Il offrirait cependant un moyen de transmettre des informations minimales avant que les accusations publiques ou les mesures de représailles ne ferment l’espace diplomatique.

Une trêve limitée dans une rivalité technologique intense

Cette ouverture intervient dans un contexte de compétition profonde entre Washington et Pékin. Les États-Unis cherchent à conserver leur avance dans les semi-conducteurs, les infrastructures de calcul et les modèles génératifs. La Chine poursuit ses propres capacités dans ces domaines tout en renforçant ses écosystèmes industriels et militaires.

Les restrictions américaines sur l’exportation de puces avancées et d’équipements de fabrication ont fait de l’IA un dossier directement lié à la puissance économique et militaire. Pékin considère ces contrôles comme un instrument de containment. Washington les présente comme un moyen de limiter l’accès chinois à des capacités susceptibles d’être utilisées à des fins militaires.

La proposition de notification ne signifie donc pas que la concurrence s’atténue. Elle marque plutôt une distinction entre deux niveaux de relation : la compétition pour la suprématie technologique peut se poursuivre, tandis que certains risques doivent être isolés afin d’éviter un incident majeur.

Cette logique existe déjà dans d’autres domaines stratégiques. Les États peuvent continuer à moderniser leurs forces, à mener des opérations de renseignement ou à se disputer des marchés tout en maintenant des canaux de communication destinés à prévenir les accidents. Avec l’IA, la difficulté sera de définir ce qui mérite une notification sans exposer des informations sensibles sur les capacités nationales.

Le problème du seuil d’alerte

Le principal obstacle sera probablement la définition d’un incident « affectant la sécurité nationale ». Un modèle qui produit une réponse erronée n’a pas la même portée qu’un système capable d’interagir avec une infrastructure militaire, de générer du code malveillant à grande échelle ou de manipuler des données utilisées pour une décision stratégique.

Le seuil devra être suffisamment élevé pour éviter une avalanche de notifications et suffisamment bas pour couvrir les signaux faibles. Une déclaration trop tardive perdrait toute utilité. Une notification trop précoce pourrait, à l’inverse, révéler une vulnérabilité, fournir des informations à l’adversaire ou être interprétée comme une accusation.

La confiance sera également déterminante. Chaque puissance devra croire que l’autre utilise le canal pour réduire le risque, et non pour collecter du renseignement. La notification pourrait ainsi se limiter dans un premier temps à des catégories générales : nature de l’incident, niveau de gravité, risque de propagation et mesures déjà prises. Les détails techniques seraient transmis uniquement après vérification.

Les entreprises au centre du dispositif

Un autre point reste largement ouvert : le rôle des entreprises qui développent et déploient les modèles. Les gouvernements peuvent négocier un mécanisme diplomatique, mais ils ne contrôlent pas chaque système privé susceptible de provoquer un incident.

Un dispositif crédible devrait donc prévoir des obligations de remontée d’information vers les autorités, des procédures de conservation des journaux techniques et des critères communs pour distinguer une anomalie d’un acte hostile. Il devrait également protéger les entreprises contre la divulgation immédiate de failles exploitables.

Cette architecture est particulièrement complexe parce que les mêmes modèles peuvent être utilisés pour la recherche, l’administration, la cybersécurité ou la défense. Une capacité développée à des fins civiles peut rapidement devenir pertinente pour la sécurité nationale, sans qu’un changement matériel du logiciel soit nécessaire.

Un premier test pour la diplomatie de l’IA

La rencontre annoncée entre Donald Trump et Xi Jinping pourrait déterminer si la proposition de Scott Bessent reste une idée de principe ou débouche sur un mandat de négociation plus précis. Plusieurs étapes seraient nécessaires : désigner les interlocuteurs, fixer les catégories d’incidents, établir un canal sécurisé et organiser des exercices de simulation.

Le résultat le plus réaliste ne serait pas un traité global sur les usages militaires de l’IA. Les divergences entre Washington et Pékin sont trop importantes, et les technologies évoluent trop vite pour qu’un cadre exhaustif soit rapidement applicable. Un protocole limité, consacré aux incidents les plus graves, aurait davantage de chances d’aboutir.

Le signal politique est néanmoins significatif. Pour la première fois, les deux principales puissances de l’IA semblent envisager directement la possibilité qu’un comportement imprévisible ou malveillant de ces systèmes puisse produire une crise internationale. Le prochain jalon sera concret : savoir si les discussions débouchent, dans les prochains mois, sur un canal de contact permanent et sur une définition commune des incidents à notifier. Sans ces éléments, l’initiative restera symbolique ; avec eux, elle pourrait devenir l’un des premiers instruments de gestion de crise adapté à l’ère des modèles autonomes.

  • ✇PandIA
  • Donald Trump veut une AI Force calquée sur la Space Force, Washington militarise l’IA
    La course à l’intelligence artificielle prend une dimension militaire assumée à Washington. Le 19 septembre 2026, Donald Trump a annoncé la création prochaine d’une « AI Force », sur le modèle de la Space Force, ainsi que la nomination d’un « AI czar » chargé de coordonner la stratégie fédérale.Une force dédiée pour accélérer l’IA américaineLa nouvelle structure doit servir à concentrer les moyens de l’État américain sur le développement et le déploiement de l’intelligence artificielle. Dans l’e

Donald Trump veut une AI Force calquée sur la Space Force, Washington militarise l’IA

Par : Decrypt
20 septembre 2026 à 19:01
Donald Trump veut une AI Force calquée sur la Space Force, Washington militarise l’IA

La course à l’intelligence artificielle prend une dimension militaire assumée à Washington. Le 19 septembre 2026, Donald Trump a annoncé la création prochaine d’une « AI Force », sur le modèle de la Space Force, ainsi que la nomination d’un « AI czar » chargé de coordonner la stratégie fédérale.

Une force dédiée pour accélérer l’IA américaine

La nouvelle structure doit servir à concentrer les moyens de l’État américain sur le développement et le déploiement de l’intelligence artificielle. Dans l’esprit de la Maison-Blanche, l’objectif est clair : réduire les délais administratifs, coordonner les agences et donner à Washington une capacité d’action comparable à celle mobilisée pour les programmes spatiaux et de défense.

La référence à la Space Force n’est pas anodine. Créée sous la présidence Trump en 2019, puis officiellement organisée comme une branche des forces armées américaines en 2020, elle avait été conçue pour regrouper les compétences militaires liées à l’espace, jusque-là dispersées entre plusieurs structures. L’« AI Force » pourrait reprendre cette logique de centralisation, même si son périmètre exact reste à définir.

L’intelligence artificielle ne constitue toutefois pas un domaine militaire aussi facilement délimitable que l’espace. Elle concerne simultanément le renseignement, la cybersécurité, les systèmes d’armes, les infrastructures critiques, la santé, l’administration et l’économie civile. La future organisation devra donc éviter de devenir une structure supplémentaire superposée à celles déjà actives au sein du Pentagone, de la Maison-Blanche et des agences fédérales.

Aucun détail définitif n’a encore été annoncé sur son statut juridique, son budget, ses effectifs ou sa chaîne de commandement. Ces éléments seront déterminants pour mesurer la portée réelle de l’initiative : simple dispositif de coordination politique ou véritable organisme doté de capacités opérationnelles et financières.

Un « AI czar » pour mettre fin à la dispersion

Donald Trump doit également nommer un « AI czar », un responsable de haut niveau chargé de piloter la politique fédérale de l’intelligence artificielle. Le poste vise à résoudre un problème ancien de l’administration américaine : la fragmentation des responsabilités entre le département de la Défense, les agences de renseignement, le département du Commerce, les régulateurs et les services de la Maison-Blanche.

Cette fonction pourrait donner à la présidence un interlocuteur unique face aux grandes entreprises technologiques et aux acteurs de la défense. Elle pourrait aussi servir à arbitrer les priorités entre investissements dans les centres de données, accès aux semi-conducteurs, sécurité des modèles et déploiement dans les administrations.

Le risque, pour Washington, est de créer un poste politiquement visible mais dépourvu d’autorité réelle. La puissance d’un tel responsable dépendra de son accès au président, de sa capacité à contrôler les budgets et de la place accordée à son bureau dans les décisions du Pentagone. Le choix du titulaire donnera un premier indice sur l’équilibre recherché entre expertise technique, loyauté politique et expérience militaire.

La sécurité nationale au cœur de la compétition avec Pékin

La Maison-Blanche présente cette initiative dans un contexte de rivalité croissante avec la Chine. Les modèles d’IA avancés sont désormais considérés comme des actifs stratégiques, au même titre que les satellites, les missiles ou les technologies de chiffrement. Ils peuvent améliorer l’analyse du renseignement, accélérer la conception de logiciels, automatiser certaines opérations cyber et renforcer les capacités de commandement.

Pour les États-Unis, conserver une avance dans les frontier models — les systèmes d’IA les plus performants — suppose de disposer rapidement de puissance de calcul, de puces spécialisées, d’électricité et de données. Une structure fédérale dédiée pourrait faciliter la mise en commun de ces ressources et accélérer les partenariats entre l’État, les laboratoires de recherche et les industriels.

Cette approche comporte cependant une limite : l’avance américaine dépend en grande partie d’entreprises privées comme OpenAI, Anthropic et Google. La future « AI Force » ne pourra pas reproduire le fonctionnement d’une branche militaire classique sans s’appuyer sur ces acteurs, qui contrôlent une large part des modèles, des infrastructures informatiques et des compétences spécialisées.

L’enjeu sera donc moins de placer toute l’IA sous contrôle militaire que d’organiser une coopération efficace entre Washington et l’industrie, tout en préservant les capacités d’innovation du secteur privé.

Dérégulation contre garde-fous

L’annonce intervient alors que l’administration Trump défend une ligne favorable à la dérégulation. La Maison-Blanche veut limiter les contraintes susceptibles de ralentir les entreprises américaines face à leurs concurrentes étrangères. Cette orientation entre en tension avec les avertissements formulés par les dirigeants d’Anthropic, d’OpenAI et de Google, qui appellent à renforcer les garde-fous sur les modèles les plus puissants.

Le débat ne porte pas uniquement sur la modération des contenus ou la protection des utilisateurs. Il concerne aussi la possibilité qu’un modèle avancé facilite des cyberattaques, automatise des opérations de désinformation, accélère la conception d’armes biologiques ou échappe partiellement aux mécanismes de contrôle prévus par ses concepteurs.

La contradiction est désormais apparente. Washington veut accélérer le développement de l’IA pour des raisons de sécurité nationale, tandis que les entreprises à l’origine des principaux modèles demandent davantage de règles pour contenir les risques liés à leur propre technologie. La création d’un « AI czar » pourrait précisément servir à arbitrer ce conflit entre vitesse d’exécution et maîtrise des dangers.

Mais une structure placée sous l’autorité de la Maison-Blanche ne garantira pas, à elle seule, un niveau de sécurité homogène. Il faudra encore définir des standards de test, des obligations de signalement, des procédures d’audit et des règles applicables aux systèmes utilisés par l’armée comme à ceux proposés au public.

Le prochain test sera budgétaire et juridique

L’annonce du 19 septembre 2026 ouvre donc un chantier institutionnel plus large qu’un simple changement d’organigramme. Washington cherche à faire de l’IA un instrument explicite de puissance nationale, avec une structure inspirée de la Space Force et un responsable chargé d’imposer une direction commune.

Le prochain jalon sera la présentation concrète du projet : base légale, financement, rattachement administratif, pouvoirs du « AI czar » et articulation avec le Pentagone. Ces paramètres permettront de vérifier si l’« AI Force » devient une organisation durable ou un label politique.

La conséquence la plus mesurable sera la capacité des États-Unis à raccourcir le délai entre une décision fédérale, l’accès aux infrastructures de calcul et le déploiement d’un système opérationnel. Si la dérégulation avance sans cadre de sécurité équivalent, le conflit entre compétitivité et contrôle risque toutefois de devenir le premier obstacle de cette stratégie.

  • ✇PandIA
  • Comment utiliser ChatGPT pour créer un plan de formation en 2026
    Un plan de formation bien structuré peut être créé plus rapidement avec ChatGPT, à condition de lui fournir un contexte précis et de vérifier ses propositions. Ce guide explique comment utiliser ChatGPT pour créer un plan de formation en 2026, depuis l’analyse des besoins jusqu’à l’évaluation des apprenants, avec des prompts prêts à l’emploi et des conseils pour obtenir un programme réellement opérationnel.Qu’est-ce qu’un plan de formation ?Un plan de formation est un document qui décrit la mani

Comment utiliser ChatGPT pour créer un plan de formation en 2026

Par : Vicomte
20 septembre 2026 à 12:05
Comment utiliser ChatGPT pour créer un plan de formation en 2026

Un plan de formation bien structuré peut être créé plus rapidement avec ChatGPT, à condition de lui fournir un contexte précis et de vérifier ses propositions. Ce guide explique comment utiliser ChatGPT pour créer un plan de formation en 2026, depuis l’analyse des besoins jusqu’à l’évaluation des apprenants, avec des prompts prêts à l’emploi et des conseils pour obtenir un programme réellement opérationnel.

Qu’est-ce qu’un plan de formation ?

Un plan de formation est un document qui décrit la manière dont une compétence ou un ensemble de connaissances sera transmis à un public donné. Il précise généralement :

  • les objectifs pédagogiques ;
  • le profil des participants ;
  • les prérequis ;
  • la durée et le calendrier ;
  • les modules et les séquences ;
  • les méthodes pédagogiques ;
  • les ressources nécessaires ;
  • les modalités d’évaluation ;
  • les adaptations prévues pour les différents niveaux.

Un bon plan de formation ne se limite donc pas à une liste de sujets. Il établit une progression logique entre le niveau initial des apprenants, les compétences visées et les activités proposées.

ChatGPT peut aider à produire ce document, mais il ne remplace pas l’expertise pédagogique, la validation métier ni la connaissance du public concerné.

Pourquoi utiliser ChatGPT pour créer un plan de formation ?

L’utilisation de ChatGPT présente plusieurs avantages pour les formateurs, les responsables pédagogiques, les organismes de formation et les entreprises.

Gagner du temps sur la structure

À partir d’un brief détaillé, ChatGPT peut proposer rapidement :

  • un découpage en modules ;
  • un calendrier de formation ;
  • une progression par niveau ;
  • des objectifs pédagogiques ;
  • des exercices pratiques ;
  • des idées d’évaluation ;
  • des supports à produire.

Cette première version sert de base de travail. Elle évite de partir d’une page blanche, surtout pour les formations longues ou comportant plusieurs publics.

Adapter une formation à un public spécifique

Le même sujet doit être traité différemment selon le profil des participants. Une formation sur l’intelligence artificielle destinée à des dirigeants ne contiendra pas les mêmes activités qu’un parcours destiné à des développeurs.

ChatGPT peut adapter un programme selon :

  • le niveau de connaissance ;
  • le métier ;
  • l’âge ou l’expérience des participants ;
  • les objectifs professionnels ;
  • le temps disponible ;
  • le format, en présentiel, à distance ou hybride ;
  • les contraintes matérielles et techniques.

Générer plusieurs formats de programme

Un même contenu peut être décliné en :

  • atelier de deux heures ;
  • formation d’une journée ;
  • parcours de plusieurs semaines ;
  • module d’intégration pour de nouveaux collaborateurs ;
  • formation asynchrone ;
  • classe virtuelle ;
  • parcours certifiant.

ChatGPT peut ainsi proposer différentes architectures à comparer avant de retenir la plus adaptée.

Faciliter la différenciation pédagogique

Un plan efficace prévoit souvent des activités de difficulté variable. ChatGPT peut aider à concevoir :

  • des exercices débutants, intermédiaires et avancés ;
  • des ressources complémentaires ;
  • des parcours de rattrapage ;
  • des défis facultatifs ;
  • des évaluations adaptées aux différents niveaux.

Les informations à fournir à ChatGPT avant de commencer

La qualité du plan obtenu dépend directement de la précision du brief. Une demande vague comme « crée un plan de formation sur le marketing digital » produira généralement un résultat générique.

Avant d’écrire le prompt, réunissez les informations suivantes :

  1. Le thème de la formation : sujet, domaine et périmètre.
  2. Le public visé : fonction, secteur, niveau, expérience.
  3. L’objectif professionnel : ce que les participants doivent être capables de réaliser.
  4. La durée : nombre d’heures, de jours ou de semaines.
  5. Le format : présentiel, distanciel, hybride ou asynchrone.
  6. Le nombre de participants : utile pour prévoir les activités en groupe.
  7. Les prérequis : connaissances, outils ou certifications nécessaires.
  8. Les contraintes : budget, équipements, outils imposés, disponibilité.
  9. Le niveau d’évaluation attendu : quiz, mise en situation, projet, examen.
  10. Le contexte réglementaire ou métier : normes, procédures internes ou exigences sectorielles.

Exemple de brief préparatoire

Thème : utiliser l’IA générative au travail
Public : salariés non techniques d’une PME
Niveau : débutant
Objectif : rédiger, contrôler et améliorer des contenus professionnels avec des outils d’IA
Durée : 2 jours, soit 14 heures
Format : présentiel
Taille du groupe : 10 participants
Prérequis : savoir utiliser un navigateur et les outils bureautiques courants
Contraintes : aucun partage de données confidentielles, exercices basés sur des cas professionnels fictifs
Évaluation : quiz final et production d’un livrable individuel

Comment rédiger un bon prompt pour ChatGPT ?

Un prompt efficace doit préciser le rôle attendu, le contexte, la tâche, les contraintes et le format de sortie.

La structure recommandée

Utilisez cette structure en cinq parties :

  • Rôle : « Agis comme un ingénieur pédagogique spécialisé dans la formation professionnelle. »
  • Contexte : décrit le public, le thème et les enjeux.
  • Objectif : indique le résultat attendu.
  • Contraintes : précise la durée, les ressources et les limites.
  • Format : impose la présentation souhaitée.

Prompt complet à copier

Agis comme un ingénieur pédagogique spécialisé dans la formation professionnelle pour adultes.
Crée un plan de formation complet sur [SUJET] destiné à [PUBLIC]. Le niveau des participants est [NIVEAU]. La formation dure [DURÉE] et se déroule en [FORMAT].
L’objectif général est le suivant : [OBJECTIF].
Les participants doivent être capables de :
- [COMPÉTENCE 1] ;
- [COMPÉTENCE 2] ;
- [COMPÉTENCE 3].
Tiens compte des prérequis suivants : [PRÉREQUIS].
Propose une progression logique comprenant :
1. les objectifs pédagogiques mesurables ;
2. les modules et leur durée ;
3. le contenu de chaque séquence ;
4. les méthodes pédagogiques ;
5. les activités pratiques ;
6. les ressources nécessaires ;
7. les modalités d’évaluation ;
8. les adaptations pour les participants en difficulté et les participants avancés.
Présente le résultat sous forme de tableaux clairs, puis ajoute les risques pédagogiques et les points à valider par un expert métier.

Ce prompt donne un cadre suffisamment précis pour obtenir une première version exploitable.

Les étapes pour créer un plan de formation avec ChatGPT

1. Définir le besoin de formation

Commencez par demander à ChatGPT d’analyser le besoin avant de générer le programme.

Analyse le besoin de formation suivant : [DESCRIPTION].
Identifie le problème professionnel à résoudre, les compétences nécessaires, les erreurs fréquentes des débutants et les résultats attendus après la formation. Pose-moi ensuite les questions indispensables avant de créer le plan.

Cette étape est importante, car une formation ne doit pas répondre uniquement à une demande de contenu. Elle doit résoudre un problème concret : améliorer une pratique, réduire les erreurs, accélérer une prise de poste ou accompagner un changement d’outil.

2. Formuler les objectifs pédagogiques

Les objectifs doivent décrire une action observable. Les formulations comme « comprendre l’IA » ou « connaître la gestion de projet » sont trop générales.

Préférez des verbes tels que :

  • identifier ;
  • expliquer ;
  • configurer ;
  • comparer ;
  • appliquer ;
  • produire ;
  • analyser ;
  • corriger ;
  • évaluer ;
  • défendre une recommandation.

Demandez à ChatGPT de reformuler les objectifs :

Transforme ces objectifs généraux en objectifs pédagogiques mesurables. Utilise des verbes d’action observables et précise les conditions de réalisation ainsi que le niveau de réussite attendu.

Un objectif bien formulé pourrait être : « À la fin de la formation, le participant sera capable de rédiger un prompt structuré pour obtenir une réponse exploitable dans trois cas professionnels sur quatre. »

3. Organiser la progression des modules

La progression doit aller du simple vers le complexe. Une structure courante comprend :

  1. le cadrage et l’évaluation du niveau initial ;
  2. les notions fondamentales ;
  3. les méthodes et outils ;
  4. les exercices guidés ;
  5. les mises en situation ;
  6. la production autonome ;
  7. l’évaluation et le plan d’action.

Prompt recommandé :

Organise les objectifs suivants en une progression de [NOMBRE] modules. Respecte une logique allant des prérequis vers l’autonomie. Pour chaque module, indique le titre, la durée, l’objectif, les notions clés, l’activité principale et le livrable attendu.

4. Répartir le temps de manière réaliste

ChatGPT peut avoir tendance à proposer trop de contenu pour une durée courte. Demandez toujours une estimation réaliste.

Vérifie si ce programme est réalisable en [DURÉE]. Estime le temps nécessaire pour les explications, les démonstrations, les questions, les exercices, les corrections et les pauses. Réduis le contenu si le planning est trop chargé.

À titre indicatif, une journée de formation de sept heures ne correspond pas à sept heures de contenu théorique. Il faut prévoir :

  • des pauses ;
  • des transitions ;
  • des temps de manipulation ;
  • des échanges ;
  • des corrections ;
  • des imprévus techniques.

Une formation pratique nécessite souvent davantage de temps par compétence qu’une simple présentation magistrale.

5. Concevoir les activités pédagogiques

Demandez des activités directement liées aux objectifs.

Pour chaque objectif pédagogique, propose une activité pratique avec un contexte, une consigne, une durée, les ressources nécessaires, les critères de réussite et une correction ou une grille d’évaluation.

Les activités peuvent prendre plusieurs formes :

  • étude de cas ;
  • simulation ;
  • jeu de rôle ;
  • résolution de problème ;
  • démonstration suivie d’une reproduction ;
  • travail en binôme ;
  • audit d’un document ;
  • création d’un livrable ;
  • quiz de positionnement ;
  • projet fil rouge.

Un exercice est plus utile lorsqu’il produit un résultat concret : une procédure, un tableau de bord, un argumentaire, un prompt, une présentation ou un plan d’action.

6. Ajouter une évaluation cohérente

L’évaluation doit mesurer les compétences annoncées, pas seulement la mémorisation du cours.

ChatGPT peut générer plusieurs types d’évaluation :

  • quiz de début de formation ;
  • questions de vérification intermédiaire ;
  • étude de cas ;
  • mise en situation ;
  • production individuelle ;
  • soutenance orale ;
  • autoévaluation ;
  • questionnaire de satisfaction.

Prompt :

Crée une évaluation finale alignée sur les objectifs pédagogiques. Elle doit comporter [NOMBRE] questions de connaissances et [NOMBRE] exercices pratiques. Ajoute le corrigé, un barème sur 100 points et les critères permettant de valider la compétence.

Vérifiez que le niveau de difficulté correspond au niveau annoncé. Un quiz peut mesurer la compréhension, mais il ne prouve pas forcément la capacité à appliquer une méthode en situation réelle.

Exemple de plan de formation généré avec ChatGPT

Sujet : utiliser ChatGPT dans un contexte professionnel

| Module | Durée | Objectif principal | Activité |

|---|---:|---|---|

| 1. Comprendre les usages et les limites | 1 h 30 | Identifier les cas d’usage pertinents et les risques | Analyse de situations professionnelles |

| 2. Structurer une demande efficace | 2 h | Rédiger un prompt contextualisé | Réécriture de prompts imprécis |

| 3. Contrôler les réponses | 2 h | Vérifier l’exactitude et la pertinence d’une sortie | Détection d’erreurs dans plusieurs réponses |

| 4. Créer des contenus professionnels | 2 h 30 | Produire et améliorer un document | Rédaction d’un livrable métier |

| 5. Développer une méthode réutilisable | 2 h | Construire une bibliothèque de prompts | Création de modèles par fonction |

| 6. Évaluation et plan d’action | 1 h | Appliquer les acquis à un cas concret | Production individuelle et restitution |

Ce tableau constitue une ossature. Il doit ensuite être complété par les consignes, les supports, les critères de réussite et les adaptations nécessaires.

Comment personnaliser le plan de formation

Pour les débutants

Un public débutant a besoin :

  • d’un vocabulaire accessible ;
  • d’exemples concrets ;
  • d’instructions étape par étape ;
  • d’exercices guidés ;
  • de répétitions ;
  • d’un glossaire ;
  • d’un support récapitulatif.

Prompt :

Adapte ce plan à des débutants complets. Simplifie le vocabulaire, ajoute les prérequis manquants, prévois une démonstration avant chaque exercice et signale les notions susceptibles de provoquer des blocages.

Pour les participants avancés

Les participants expérimentés ont besoin de cas plus complexes et d’une marge d’autonomie.

Adapte ce programme à un public avancé. Remplace les exercices élémentaires par des cas complexes, ajoute des contraintes réalistes et prévois un projet nécessitant une analyse critique.

Pour une formation à distance

Le distanciel nécessite des séquences plus courtes et une interaction régulière.

Demandez à ChatGPT de prévoir :

  • des classes virtuelles limitées dans le temps ;
  • des activités asynchrones ;
  • des sondages ;
  • des documents collaboratifs ;
  • des consignes très explicites ;
  • des temps de pause écran ;
  • un dispositif d’assistance technique.

Pour l’accessibilité

L’accessibilité doit être prise en compte dès la conception. Demandez :

Analyse ce plan sous l’angle de l’accessibilité. Propose des adaptations pour les troubles visuels, auditifs, cognitifs et moteurs, ainsi que des alternatives aux activités nécessitant une prise de parole ou une manipulation rapide.

Les recommandations doivent ensuite être validées selon le contexte légal et les moyens disponibles.

Comment améliorer un plan créé par ChatGPT ?

La première réponse doit être considérée comme un brouillon. Pour l’améliorer, utilisez plusieurs passes successives.

Vérifier la cohérence pédagogique

Audite ce plan de formation. Vérifie l’alignement entre les objectifs, les activités, les ressources et les évaluations. Signale toute incohérence dans un tableau avec les colonnes « problème », « conséquence » et « correction proposée ».

Repérer les contenus trop génériques

Identifie les parties trop théoriques ou trop génériques. Remplace-les par des exemples liés au métier de [MÉTIER] et par des exercices produisant un livrable concret.

Réduire la surcharge de contenu

Ce programme doit tenir en [DURÉE]. Supprime les éléments secondaires, conserve les compétences prioritaires et justifie chaque suppression.

Créer les supports

ChatGPT peut produire une base pour :

  • un déroulé formateur ;
  • un support de présentation ;
  • une fiche participant ;
  • une fiche d’exercice ;
  • une grille d’évaluation ;
  • un quiz ;
  • un questionnaire de satisfaction ;
  • une feuille de route post-formation.

Chaque support doit toutefois être relu et harmonisé. La génération séparée de plusieurs documents peut entraîner des contradictions entre les objectifs, les consignes et les corrections.

Les erreurs à éviter avec ChatGPT

Fournir un prompt trop vague

Une demande courte conduit souvent à un programme standardisé, peu adapté au métier ou au niveau du public.

Confondre contenu et compétence

Accumuler des thèmes ne garantit pas l’acquisition d’un savoir-faire. Chaque module doit répondre à un objectif et déboucher sur une activité observable.

Accepter toutes les informations sans vérification

ChatGPT peut produire :

  • des références inexistantes ;
  • des chiffres non sourcés ;
  • des recommandations inadaptées ;
  • des informations obsolètes ;
  • des affirmations trop générales.

Les données réglementaires, juridiques, médicales, financières et techniques doivent être contrôlées avec des sources fiables et à jour.

Ignorer les contraintes réelles

Un plan peut être pédagogiquement séduisant mais impossible à déployer faute de matériel, de licences, de temps ou de formateurs disponibles.

Introduire des données confidentielles

Ne transmettez pas à ChatGPT :

  • de données personnelles inutiles ;
  • de dossiers clients ;
  • de contrats non publics ;
  • de secrets commerciaux ;
  • d’informations médicales ;
  • de données permettant d’identifier directement un salarié ou un apprenant.

Anonymisez les exemples et utilisez des cas fictifs lorsque c’est possible. Les règles internes de l’organisation et les conditions d’utilisation du service doivent être consultées avant tout usage professionnel.

Combien de temps faut-il pour créer un plan avec ChatGPT ?

Le temps dépend de la complexité du projet et du niveau de précision attendu.

À titre indicatif :

  • 30 à 60 minutes pour une trame de formation courte ;
  • 2 à 4 heures pour un plan détaillé avec objectifs, activités et évaluations ;
  • une journée ou davantage pour un parcours complet comprenant des supports, des exercices, une grille de compétences et une validation métier.

ChatGPT accélère surtout la phase de conception initiale. La personnalisation, la vérification des contenus et les tests auprès d’un premier groupe restent indispensables.

Quand utiliser ChatGPT et quand faire appel à un expert ?

ChatGPT est particulièrement utile pour :

  • structurer une idée ;
  • comparer plusieurs formats ;
  • générer des variantes d’activités ;
  • reformuler des objectifs ;
  • préparer un premier questionnaire ;
  • identifier des oublis ;
  • produire des supports de travail.

L’intervention d’un expert est indispensable pour :

  • valider les contenus techniques ;
  • vérifier la conformité réglementaire ;
  • confirmer les pratiques métier ;
  • choisir les critères de certification ;
  • évaluer les risques ;
  • adapter le programme à une politique interne ;
  • tester la faisabilité en situation réelle.

La meilleure approche consiste à utiliser ChatGPT comme assistant de conception, puis à soumettre le plan à un ingénieur pédagogique, un expert métier et, si nécessaire, un responsable juridique ou qualité.

Checklist finale avant de déployer la formation

Avant publication ou animation, vérifiez les points suivants :

  • [ ] Le public et son niveau sont clairement définis.
  • [ ] Les objectifs utilisent des verbes observables.
  • [ ] Chaque objectif est associé à une activité.
  • [ ] Les activités correspondent à des situations professionnelles.
  • [ ] La durée totale est réaliste.
  • [ ] Les pauses et les temps de correction sont intégrés.
  • [ ] Les prérequis sont explicités.
  • [ ] Les supports nécessaires sont disponibles.
  • [ ] L’évaluation mesure réellement les compétences visées.
  • [ ] Les contenus techniques et réglementaires ont été vérifiés.
  • [ ] Les données confidentielles ont été exclues.
  • [ ] Les adaptations pour les différents niveaux sont prévues.
  • [ ] Les consignes sont compréhensibles sans explication supplémentaire.
  • [ ] Un mécanisme de retour des participants est prévu.
  • [ ] Le plan d’action post-formation est défini.

Conclusion : les points clés à retenir

Utiliser ChatGPT pour créer un plan de formation en 2026 permet d’accélérer la conception, de générer des idées d’activités et d’adapter un parcours à différents publics. La qualité du résultat dépend surtout du brief fourni, de la précision du prompt et du nombre d’itérations consacrées à l’amélioration.

La méthode la plus fiable consiste à :

  1. analyser le besoin avant de produire le programme ;
  2. définir des objectifs pédagogiques mesurables ;
  3. organiser une progression réaliste ;
  4. associer chaque objectif à une activité ;
  5. prévoir une évaluation cohérente ;
  6. adapter le plan au niveau, au format et aux contraintes ;
  7. vérifier les informations, la confidentialité et la conformité ;
  8. faire valider le résultat par des experts humains.

ChatGPT peut produire une excellente première version, mais un plan de formation efficace doit rester contextualisé, vérifié, testable et orienté vers des compétences concrètes.

  • ✇PandIA
  • Gavin Newsom veut pouvoir couper les IA de pointe comme une infrastructure critique
    Une IA de pointe pourrait bientôt devoir intégrer son propre bouton d’arrêt d’urgence. En Californie, Gavin Newsom veut examiner la possibilité de suspendre rapidement le fonctionnement des modèles les plus puissants, sur le modèle des procédures prévues pour certaines infrastructures critiques.La Californie veut tester les limites du contrôle des IA avancéesLe 18 septembre 2026, le gouverneur californien a signé un décret demandant l’élaboration de propositions pour renforcer la surveillance in

Gavin Newsom veut pouvoir couper les IA de pointe comme une infrastructure critique

Par : 0xMonkey
20 septembre 2026 à 07:00
Gavin Newsom veut pouvoir couper les IA de pointe comme une infrastructure critique

Une IA de pointe pourrait bientôt devoir intégrer son propre bouton d’arrêt d’urgence. En Californie, Gavin Newsom veut examiner la possibilité de suspendre rapidement le fonctionnement des modèles les plus puissants, sur le modèle des procédures prévues pour certaines infrastructures critiques.

La Californie veut tester les limites du contrôle des IA avancées

Le 18 septembre 2026, le gouverneur californien a signé un décret demandant l’élaboration de propositions pour renforcer la surveillance indépendante des entreprises qui développent des modèles dits frontier. Le terme désigne les systèmes d’IA les plus avancés, capables de traiter des tâches complexes et susceptibles de produire des effets à grande échelle.

Le texte ne crée pas encore une obligation immédiatement applicable. Il charge toutefois les autorités compétentes d’étudier un dispositif qui pourrait imposer aux entreprises concernées de concevoir un mécanisme d’arrêt d’urgence — un kill switch — pour leurs modèles.

Son fonctionnement devrait être vérifié par une organisation indépendante. Cette exigence vise à éviter qu’une entreprise puisse simplement déclarer son système « désactivable » sans démontrer, par des tests externes, que l’arrêt fonctionne effectivement dans des conditions réelles.

L’initiative s’inscrit dans une inquiétude grandissante : les modèles les plus puissants sont développés et déployés à une vitesse supérieure à celle des mécanismes publics de contrôle. En cas de comportement dangereux, de compromission informatique ou d’usage détourné, les autorités cherchent donc à disposer d’un moyen d’intervention rapide, plutôt que de dépendre uniquement de la bonne volonté de l’opérateur.

Un bouton d’arrêt ne signifie pas forcément couper une IA partout

L’expression kill switch suggère un interrupteur unique capable de mettre instantanément un modèle hors service. Dans la pratique, le dispositif pourrait prendre plusieurs formes.

Il pourrait s’agir de suspendre les interfaces d’accès aux modèles, de révoquer des clés utilisées par des clients, d’interrompre les serveurs exécutant l’inférence — la phase durant laquelle le modèle produit une réponse — ou encore de couper certains déploiements identifiés comme risqués. Ces mécanismes ne sont pas équivalents : arrêter une API centralisée est plus simple que désactiver un modèle dont les poids ont été distribués à plusieurs partenaires ou installés sur des infrastructures distinctes.

Cette distinction sera déterminante. Une entreprise qui contrôle ses propres serveurs peut théoriquement interrompre l’accès à un modèle en quelques secondes. Mais si le système est intégré dans des produits tiers, répliqué dans plusieurs régions ou exécuté localement, la capacité d’arrêt devient plus fragmentée.

Le décret californien devra donc répondre à une question essentielle : le mécanisme doit-il empêcher toute utilisation du modèle, ou seulement permettre de stopper les déploiements contrôlés par son développeur ? La réponse conditionnera la portée réelle de la mesure.

Une vérification indépendante pour éviter le bouton décoratif

La proposition la plus sensible concerne la validation externe du dispositif. Sans audit indépendant, une procédure d’arrêt pourrait rester théorique : documentée dans les règles internes de l’entreprise, mais inutilisable lors d’un incident.

Une organisation indépendante pourrait examiner le périmètre couvert, tester les délais de réaction, vérifier l’existence de procédures d’escalade et contrôler la capacité de l’entreprise à empêcher une remise en service non autorisée. Elle pourrait également évaluer les dépendances techniques : accès aux centres de données, systèmes d’authentification, outils de supervision et partenaires chargés de l’hébergement.

Cette approche introduit une forme de séparation entre le développeur et l’évaluation de son propre dispositif de sécurité. Elle pose néanmoins des difficultés pratiques. Il faudra déterminer qui pourra exercer ce contrôle, selon quelles normes, avec quel niveau d’accès aux informations confidentielles et sous quelle responsabilité en cas d’échec.

La Californie devra aussi définir les modèles concernés. Un seuil fondé sur la puissance de calcul, le nombre d’utilisateurs, les capacités autonomes ou les risques potentiels pourrait produire des résultats très différents. Un périmètre trop étroit laisserait de côté des systèmes importants ; un périmètre trop large imposerait des contraintes lourdes à des acteurs moins exposés.

Washington laisse les États occuper le terrain

La décision de Gavin Newsom intervient alors que les États-Unis ne disposent toujours pas d’un cadre fédéral complet consacré aux risques des IA avancées. Cette absence laisse les États fédérés expérimenter leurs propres réponses, avec le risque de voir apparaître des obligations différentes selon le lieu d’implantation d’une entreprise ou de ses activités.

La Californie possède un poids particulier dans ce débat. Elle concentre une large partie des entreprises américaines de l’IA et peut transformer une règle locale en standard de fait pour l’ensemble du secteur. Pour éviter de maintenir plusieurs architectures de conformité, une entreprise pourrait choisir d’appliquer les exigences californiennes à une partie plus large de ses opérations.

Mais cette influence ne règle pas la question de la compétence. Un État peut encadrer les entreprises opérant sur son territoire et conditionner certains marchés ou autorisations à des exigences de sécurité. Il ne peut pas nécessairement désactiver à distance un modèle exploité depuis une autre juridiction ou empêcher une copie de continuer à fonctionner hors de son périmètre.

Le prochain test sera juridique autant que technique

Le décret du 18 septembre constitue donc davantage un point de départ qu’un interrupteur déjà installé. La prochaine étape consistera à transformer cette orientation politique en propositions précises : modèles concernés, procédures d’activation, rôle de l’organisation indépendante, sanctions en cas de non-conformité et articulation avec les autorités fédérales.

L’enjeu mesurable sera la capacité à démontrer qu’un modèle peut être stoppé dans un délai défini, y compris lorsqu’il est intégré à des services tiers ou soumis à une attaque informatique. Tant que ces tests ne seront pas publiés et vérifiables, le kill switch restera une promesse de gouvernance plutôt qu’un véritable dispositif de sécurité.

La Californie place ainsi une question autrefois réservée aux infrastructures énergétiques ou industrielles au cœur de la régulation de l’IA : qui détient le pouvoir d’arrêter un système avancé, dans quelles conditions et avec quelle preuve que l’arrêt est réellement possible ?

  • ✇PandIA
  • Anthropic appelle à ralentir l’IA, mais étudie un modèle pour contrer GPT-6 Astra
    Anthropic, l’un des laboratoires les plus critiques envers l’accélération de l’intelligence artificielle, pourrait remettre un nouveau modèle sur la ligne de départ. Selon Reuters, l’entreprise examine cette option pour enrayer la dynamique commerciale créée par GPT-6 Astra, alors que son PDG Dario Amodei appelait publiquement à ralentir l’amélioration des modèles pour des raisons de sécurité.Le paradoxe est difficile à manquer : le laboratoire qui plaide pour davantage de prudence face aux capa

Anthropic appelle à ralentir l’IA, mais étudie un modèle pour contrer GPT-6 Astra

Par : Decrypt
19 septembre 2026 à 19:00
Anthropic appelle à ralentir l’IA, mais étudie un modèle pour contrer GPT-6 Astra

Anthropic, l’un des laboratoires les plus critiques envers l’accélération de l’intelligence artificielle, pourrait remettre un nouveau modèle sur la ligne de départ. Selon Reuters, l’entreprise examine cette option pour enrayer la dynamique commerciale créée par GPT-6 Astra, alors que son PDG Dario Amodei appelait publiquement à ralentir l’amélioration des modèles pour des raisons de sécurité.

Le paradoxe est difficile à manquer : le laboratoire qui plaide pour davantage de prudence face aux capacités croissantes de l’IA envisage désormais d’accélérer son propre calendrier afin de ne pas laisser OpenAI prendre trop d’avance.

Anthropic veut éviter qu’OpenAI impose le tempo

D’après trois sources proches du dossier citées par Reuters, Anthropic étudie la sortie d’un nouveau modèle susceptible de répondre à l’impact commercial de GPT-6 Astra. L’hypothèse reste à ce stade interne : aucune date de lancement n’a été annoncée et la décision finale n’aurait pas été arrêtée.

Le modèle potentiel serait encore soumis à des évaluations de sûreté. Cette étape est particulièrement significative pour Anthropic, qui a construit une partie de son identité autour de la sécurité des systèmes d’IA et du contrôle de leurs comportements. Une mise à disposition publique ne dépendrait donc pas uniquement de performances techniques ou de considérations commerciales, mais aussi du résultat de ces tests.

La prudence du laboratoire ne l’exonère toutefois pas de la pression du marché. La mise en avant de GPT-6 Astra par OpenAI aurait créé une dynamique auprès des entreprises et des développeurs, deux publics essentiels pour les fournisseurs de modèles. Dans ce secteur, l’arrivée d’un modèle présenté comme plus performant peut rapidement influer sur les contrats, les intégrations logicielles et les choix d’architecture des clients.

Pour Anthropic, le risque est double : perdre en visibilité auprès des entreprises et laisser s’installer l’idée qu’OpenAI conserve une longueur d’avance dans les modèles généralistes. Même sans publication immédiate, la simple perspective d’un nouveau modèle peut servir à rassurer des partenaires et à maintenir l’attention des investisseurs.

Le discours de sécurité confronté aux impératifs commerciaux

Le 12 septembre 2026, Dario Amodei appelait à ralentir l’amélioration des modèles d’IA au nom de la sécurité. Sa position s’inscrivait dans un débat plus large sur la vitesse de développement des systèmes capables de raisonner, d’utiliser des outils et d’exécuter des tâches complexes avec une autonomie croissante.

Cette prise de parole plaçait Anthropic dans une position singulière. Le laboratoire participe pleinement à la compétition technologique, mais affirme en parallèle que la progression des capacités ne devrait pas se poursuivre sans garde-fous proportionnés. L’étude d’un nouveau lancement ne contredit pas mécaniquement cette ligne : Anthropic peut soutenir qu’un modèle doit être publié uniquement après des évaluations plus rigoureuses.

La tension demeure néanmoins bien réelle. Les entreprises d’IA ne sont pas seulement engagées dans une compétition de recherche. Elles vendent des abonnements, des accès par API et des services intégrés à des produits professionnels. Une baisse de visibilité ou un retard perçu peut avoir des effets directs sur les revenus, les partenariats et la valorisation.

Le cas Anthropic illustre ainsi la difficulté de séparer la doctrine de sécurité de la stratégie industrielle. Les appels à ralentir peuvent concerner la trajectoire globale du secteur, tandis que chaque entreprise cherche à préserver sa position face à ses concurrents. Pour les utilisateurs, la distinction est moins évidente : un laboratoire qui revendique la retenue doit également démontrer que ses modèles restent suffisamment compétitifs pour être adoptés.

Une publication qui ne serait pas nécessairement une fuite en avant

Le choix d’Anthropic pourrait prendre plusieurs formes. Le laboratoire peut lancer un modèle entièrement nouveau, proposer une version spécialisée ou améliorer une famille existante sans franchir un nouveau palier de capacités générales. Ces scénarios n’ont pas la même portée en matière de sécurité ni le même effet commercial.

La phase d’évaluation évoquée par Reuters constitue donc le principal point de contrôle. Elle pourrait porter sur les risques de manipulation, l’autonomie opérationnelle, la résistance aux tentatives de contournement des consignes ou encore la capacité du modèle à assister des usages sensibles. Le niveau d’exigence sera scruté de près, précisément parce qu’Anthropic a fait de ces questions un élément central de son positionnement.

À l’inverse, un lancement précipité exposerait l’entreprise à une critique difficile à neutraliser : celle d’un laboratoire qui demanderait à ses concurrents de ralentir tout en accélérant dès que sa position commerciale est menacée. La cohérence entre les déclarations de Dario Amodei et le protocole appliqué au nouveau modèle pèsera donc presque autant que les résultats de performance.

L’introduction en Bourse ajoute une contrainte décisive

Cette pression intervient alors qu’une introduction en Bourse d’Anthropic est attendue. Les marchés financiers évalueraient l’entreprise sur sa capacité à convertir ses avancées techniques en croissance durable, mais aussi sur la solidité de sa position face à OpenAI, Google et les autres acteurs du secteur.

À l’approche d’une telle opération, un décrochage dans les benchmarks ou dans l’adoption commerciale pourrait alimenter les interrogations sur la trajectoire d’Anthropic. Les investisseurs chercheront notamment à savoir si le laboratoire dispose d’une offre capable de soutenir la demande des grandes entreprises, de fidéliser les développeurs et de justifier des dépenses massives en puissance de calcul.

Un nouveau modèle pourrait contribuer à répondre à ces attentes, mais il augmenterait aussi les coûts d’entraînement, d’évaluation et de déploiement. Il faudrait également mesurer son effet sur les marges : les systèmes les plus avancés nécessitent souvent davantage de ressources informatiques, alors que les clients professionnels négocient des tarifs toujours plus compétitifs.

L’enjeu pour Anthropic ne consiste donc pas seulement à produire un modèle plus performant que le précédent. Il s’agit de prouver qu’une entreprise attachée à une approche prudente peut rester compétitive dans un marché où les annonces de capacités déterminent une partie de la valeur perçue.

Le prochain jalon sera la décision de lancement

À ce stade, aucun calendrier officiel ne permet d’affirmer qu’Anthropic publiera ce modèle. Le prochain signal concret sera la conclusion des évaluations de sûreté, puis une éventuelle communication sur ses performances, ses restrictions d’accès et ses conditions de déploiement.

La séquence sera particulièrement révélatrice : si Anthropic lance effectivement un nouveau système avant son introduction en Bourse, l’entreprise devra démontrer que cette décision répond à une stratégie maîtrisée plutôt qu’à une réaction défensive à GPT-6 Astra. La mesure la plus tangible sera l’adoption par les clients professionnels dans les mois suivants, davantage que le seul score affiché lors de la présentation.

  • ✇PandIA
  • Comment utiliser ChatGPT pour créer un portfolio professionnel en 2026
    Utiliser ChatGPT pour créer un portfolio professionnel en 2026 permet de structurer ses projets, rédiger ses textes et produire rapidement un portfolio en ligne adapté à son métier. Ce guide explique comment créer un portfolio avec ChatGPT, de la définition de la cible jusqu’à la publication, au référencement naturel et aux vérifications indispensables.Qu’est-ce qu’un portfolio professionnel créé avec ChatGPT ?Un portfolio professionnel présente les compétences, les réalisations et les résultats

Comment utiliser ChatGPT pour créer un portfolio professionnel en 2026

Par : Vicomte
19 septembre 2026 à 12:05
Comment utiliser ChatGPT pour créer un portfolio professionnel en 2026

Utiliser ChatGPT pour créer un portfolio professionnel en 2026 permet de structurer ses projets, rédiger ses textes et produire rapidement un portfolio en ligne adapté à son métier. Ce guide explique comment créer un portfolio avec ChatGPT, de la définition de la cible jusqu’à la publication, au référencement naturel et aux vérifications indispensables.

Qu’est-ce qu’un portfolio professionnel créé avec ChatGPT ?

Un portfolio professionnel présente les compétences, les réalisations et les résultats d’une personne à un recruteur, un client ou un partenaire. Il peut prendre plusieurs formes :

  • un site portfolio personnel ;
  • une page sur Notion, Framer, Webflow ou une autre plateforme ;
  • un profil spécialisé sur Behance, Dribbble ou GitHub ;
  • un document PDF interactif ;
  • une présentation complémentaire au CV et au profil LinkedIn.

ChatGPT ne remplace pas l’expérience, les preuves de compétence ni le jugement professionnel. En revanche, il peut aider à :

  • organiser les contenus ;
  • identifier les projets les plus pertinents ;
  • rédiger une présentation claire ;
  • transformer une expérience brute en étude de cas ;
  • générer une arborescence de site ;
  • proposer du code HTML, CSS ou JavaScript ;
  • améliorer le référencement naturel ;
  • simuler les questions d’un recruteur ou d’un prospect ;
  • repérer les incohérences, les répétitions et les formulations trop vagues.

La qualité finale dépend surtout des informations fournies. Un prompt précis, accompagné de données réelles et vérifiables, produit généralement un résultat plus utile qu’une demande générale comme « crée mon portfolio ».

Pourquoi utiliser ChatGPT pour créer un portfolio en 2026 ?

Gagner du temps sans négliger la personnalisation

La création d’un portfolio demande souvent de nombreuses tâches différentes : choisir les projets, rédiger les descriptions, créer les pages, sélectionner les images, optimiser les titres et tester l’affichage mobile. ChatGPT peut accélérer ces étapes, notamment lorsque les informations sont déjà disponibles dans un CV, un dossier de projets ou des notes personnelles.

Le gain de temps ne doit toutefois pas conduire à publier un contenu générique. Les recruteurs reconnaissent rapidement les textes remplis de formules comme « passionné », « dynamique » ou « orienté résultats » lorsqu’ils ne sont pas accompagnés de preuves.

Clarifier son positionnement professionnel

Un portfolio efficace répond rapidement à trois questions :

  1. Quel est le métier ou le domaine d’expertise ?
  2. Pour quel type de client ou d’entreprise la personne travaille-t-elle ?
  3. Quels résultats ou problèmes sait-elle produire ou résoudre ?

ChatGPT peut comparer plusieurs positionnements et signaler celui qui paraît le plus compréhensible. Par exemple, « designer polyvalent » est moins précis que « designer UX spécialisé dans les parcours e-commerce B2B ».

Adapter le portfolio à plusieurs objectifs

Un même professionnel peut avoir besoin de plusieurs versions :

  • une version destinée au recrutement ;
  • une version orientée freelance ;
  • une version spécialisée pour un secteur ;
  • une version en français et une autre en anglais ;
  • une sélection courte pour LinkedIn ;
  • une présentation détaillée pour un entretien.

ChatGPT peut adapter le ton, le niveau de détail et le vocabulaire sans réécrire intégralement chaque contenu.

Avant de commencer : réunir les informations utiles

ChatGPT ne doit pas inventer les expériences, les clients, les chiffres ou les compétences. Avant de rédiger, rassemblez les éléments suivants :

  • intitulé du métier recherché ;
  • années d’expérience ;
  • secteurs ciblés ;
  • outils et technologies maîtrisés ;
  • formations et certifications ;
  • liste des projets réalisés ;
  • contexte de chaque projet ;
  • rôle exact joué ;
  • livrables produits ;
  • résultats obtenus ;
  • liens, captures d’écran ou démonstrations ;
  • témoignages autorisés ;
  • coordonnées professionnelles ;
  • langue et zone géographique ciblées.

Pour chaque projet, préparez au minimum :

  • le problème initial ;
  • le public concerné ;
  • les contraintes ;
  • la méthode utilisée ;
  • les décisions prises ;
  • le résultat ;
  • les enseignements tirés.

Un portfolio devient beaucoup plus convaincant lorsqu’il montre la démarche, et pas seulement le résultat visuel.

Comment utiliser ChatGPT pour définir la structure du portfolio ?

1. Définir la cible

Commencez par demander à ChatGPT d’analyser le profil visé. Une consigne efficace peut être formulée ainsi :

Agis comme un recruteur spécialisé dans le secteur [secteur]. Analyse le profil suivant : [profil]. Identifie les compétences les plus importantes pour le poste [intitulé], les preuves attendues dans un portfolio et les objections possibles d’un recruteur. Propose ensuite une structure de portfolio priorisée.

La réponse doit être vérifiée à partir des offres d’emploi, des missions freelance ou des attentes réelles du secteur. Une structure pertinente pour un développeur ne conviendra pas forcément à un photographe, un consultant ou un rédacteur SEO.

2. Choisir les pages essentielles

Un portfolio professionnel peut généralement contenir :

  • Accueil : proposition de valeur et appel à l’action ;
  • Projets ou réalisations : sélection des travaux les plus pertinents ;
  • Études de cas : explication détaillée de la méthode et des résultats ;
  • À propos : parcours, spécialisation et façon de travailler ;
  • Services : utile pour les freelances et consultants ;
  • Témoignages : uniquement avec autorisation ;
  • Contact : formulaire, adresse professionnelle ou lien de prise de rendez-vous.

Il n’est pas nécessaire de créer une page pour chaque élément. Un portfolio d’une seule page peut être très efficace si les projets sont bien présentés.

3. Organiser l’ordre des contenus

La page d’accueil doit généralement suivre un parcours simple :

  1. métier et spécialité ;
  2. bénéfice ou problème résolu ;
  3. projet phare ;
  4. preuves complémentaires ;
  5. méthode de travail ;
  6. appel à l’action.

L’appel à l’action doit être concret : « Télécharger le CV », « Découvrir l’étude de cas », « Demander un devis » ou « Planifier un échange ».

Comment rédiger les textes avec ChatGPT ?

Rédiger une accroche professionnelle

L’accroche doit expliquer rapidement la valeur apportée. Évitez les déclarations trop générales. Demandez plusieurs variantes :

Rédige 10 accroches de 20 à 30 mots pour un portfolio de [métier]. La cible est [recruteur/client]. L’expertise principale est [compétence]. Le ton doit être professionnel, précis et naturel. N’utilise pas les adjectifs « passionné », « dynamique », « expert » ou « innovant » sans preuve.

Comparez les propositions avec le langage utilisé dans les offres d’emploi et les sites du secteur. L’accroche finale doit ressembler à la personne présentée, pas à une publicité automatisée.

Rédiger une page « À propos »

Une bonne page « À propos » ne constitue pas une autobiographie complète. Elle doit relier le parcours aux besoins de la cible.

Prompt utile :

Transforme les informations suivantes en une présentation professionnelle de 150 mots pour un portfolio : [informations]. Mets en avant [spécialité], [secteur] et [résultats]. N’invente aucun fait. Signale les informations manquantes au lieu de les compléter.

Relisez particulièrement :

  • les dates ;
  • les intitulés de postes ;
  • les niveaux de compétence ;
  • les noms des clients ;
  • les chiffres ;
  • les promesses commerciales.

Transformer un projet en étude de cas

La structure la plus lisible repose sur les éléments suivants :

  • Contexte ;
  • Problématique ;
  • Objectifs ;
  • Rôle ;
  • Processus ;
  • Solutions ;
  • Résultats ;
  • Bilan.

Demande recommandée :

Transforme ces notes en étude de cas pour un portfolio professionnel. Conserve uniquement les faits fournis. Organise le texte avec les sections Contexte, Problématique, Rôle, Méthode, Solution et Résultats. Indique clairement les données absentes. Le style doit être concret et compréhensible par un lecteur non spécialiste.

Ajoutez des preuves lorsque cela est possible : taux de conversion, temps gagné, volume traité, délai réduit, nombre d’utilisateurs, évolution du trafic ou retour client. Lorsque les données sont confidentielles, utilisez une formulation honnête comme « baisse mesurée après déploiement » sans inventer de pourcentage.

Comment créer le design et l’interface avec ChatGPT ?

ChatGPT peut proposer une direction artistique, une palette de couleurs, une hiérarchie typographique et des idées de mise en page. Il peut aussi générer ou expliquer du code HTML, CSS et JavaScript pour un site simple.

Demander une direction visuelle

Prompt possible :

Propose une direction artistique pour un portfolio de [métier] destiné à [cible]. Le design doit être lisible, professionnel, responsive et accessible. Suggère une palette avec les codes hexadécimaux, deux polices compatibles avec le web, une hiérarchie des titres et une structure de page. Évite les effets décoratifs qui nuisent à la lisibilité.

Le design doit rester cohérent avec le métier. Un portfolio de direction artistique peut être plus expérimental qu’un site de consultant financier, mais l’accessibilité et la clarté restent prioritaires.

Générer le code d’un portfolio

Pour obtenir un résultat exploitable, précisez :

  • les pages nécessaires ;
  • le contenu déjà validé ;
  • la technologie souhaitée ;
  • la compatibilité mobile ;
  • les couleurs ;
  • les interactions ;
  • les contraintes d’accessibilité ;
  • la méthode de déploiement.

Demandez d’abord une structure, puis le code section par section. Cette approche facilite la vérification et limite les erreurs. Le code généré doit être testé dans plusieurs navigateurs et sur un écran mobile.

Vérifiez notamment :

  • la présence d’un titre de page pertinent ;
  • la hiérarchie correcte des balises H2 et H3 ;
  • le contraste des couleurs ;
  • la navigation au clavier ;
  • les textes alternatifs des images ;
  • la taille des boutons ;
  • la vitesse de chargement ;
  • le fonctionnement du formulaire ;
  • l’absence de liens cassés.

Les recommandations WCAG 2.2, notamment sur le contraste, le clavier et les alternatives textuelles, constituent une bonne base pour améliorer l’accessibilité.

Comment optimiser le portfolio pour Google Search ?

Choisir les bons mots-clés

Un portfolio doit cibler des recherches réellement liées au profil, par exemple :

  • développeur Python freelance à Lyon ;
  • designer UX SaaS B2B ;
  • rédacteur SEO spécialisé technologie ;
  • photographe événementiel à Bordeaux ;
  • consultant data pour PME.

ChatGPT peut proposer une liste de mots-clés, mais les volumes et la concurrence doivent être vérifiés avec un outil SEO. Une liste générée automatiquement ne constitue pas une étude de mots-clés fiable.

Optimiser chaque page

Pour chaque page, préparez :

  • un title unique, idéalement descriptif ;
  • une méta-description attractive ;
  • une URL courte ;
  • un titre H1 unique, géré dans la page ;
  • des sous-titres H2 et H3 ;
  • des textes alternatifs pour les images ;
  • des liens internes ;
  • une phrase d’appel à l’action.

Prompt pratique :

À partir de cette page, propose un title de moins de 60 caractères, une méta-description d’environ 150 caractères, une URL courte, cinq idées de liens internes et trois textes alternatifs d’images. Ne sur-optimise pas et ne répète pas artificiellement le mot-clé [mot-clé].

Le référencement dépend également de la qualité globale du site, de son utilité, de sa rapidité et de sa crédibilité. Répéter « portfolio professionnel » dans chaque paragraphe n’améliore pas automatiquement le classement.

Ajouter des preuves de confiance

Les moteurs de recherche et les visiteurs bénéficient de signaux cohérents :

  • identité professionnelle claire ;
  • coordonnées accessibles ;
  • profils sociaux cohérents ;
  • liens vers des projets vérifiables ;
  • mentions légales ;
  • politique de confidentialité si nécessaire ;
  • témoignages authentifiés ;
  • date de mise à jour ;
  • domaine personnalisé.

Un portfolio très esthétique mais dépourvu de contenu concret peut être moins efficace qu’un site simple présentant trois études de cas détaillées.

Quels prompts ChatGPT utiliser pour un portfolio professionnel ?

Pour analyser un portfolio existant

Analyse ce portfolio comme un recruteur et comme un prospect. Identifie les points forts, les éléments qui manquent, les passages trop vagues, les preuves insuffisantes et les appels à l’action peu clairs. Classe les corrections par impact et par difficulté.

Pour adapter le contenu à une offre d’emploi

Compare ce portfolio avec cette offre d’emploi. Repère les compétences déjà démontrées, celles qui ne sont pas visibles et les formulations à améliorer. Ne prétends pas qu’une compétence est maîtrisée si elle n’apparaît pas dans les informations fournies.

Pour simplifier un texte

Réécris ce texte dans un français clair, direct et professionnel. Conserve le sens, les chiffres et les faits. Supprime les répétitions, le jargon inutile et les phrases trop longues. Propose également une version plus concise.

Pour préparer une version anglaise

Traduis ce portfolio en anglais professionnel adapté au secteur [secteur]. Conserve les noms propres, les chiffres et les intitulés exacts. Signale les expressions qui nécessitent une adaptation culturelle plutôt qu’une traduction littérale.

Une traduction générée doit être relue par une personne compétente, surtout pour les termes techniques et les nuances commerciales.

Comment publier un portfolio créé avec ChatGPT ?

Plusieurs options existent :

  • Notion ou plateforme similaire : rapide, mais personnalisation et SEO parfois limités ;
  • WordPress : adapté à un site évolutif avec contenus réguliers ;
  • Webflow, Framer ou constructeur visuel : bon compromis entre design et simplicité ;
  • GitHub Pages, Netlify ou Vercel : intéressant pour les profils techniques ;
  • site développé sur mesure : plus flexible, mais plus exigeant en maintenance.

Le choix dépend du niveau technique, du budget et de la fréquence de mise à jour. Un nom de domaine personnel renforce généralement la crédibilité. Vérifiez également :

  1. l’affichage sur smartphone ;
  2. la configuration HTTPS ;
  3. le formulaire de contact ;
  4. les redirections ;
  5. les images compressées ;
  6. la présence d’une page 404 utile ;
  7. la sauvegarde du contenu ;
  8. les statistiques de consultation conformes aux règles applicables.

Combien coûte la création d’un portfolio avec ChatGPT ?

Le coût peut être faible, mais il ne se limite pas à l’accès à ChatGPT.

À titre indicatif :

  • nom de domaine : environ 10 à 20 € par an ;
  • hébergement simple : de 0 à 15 € par mois selon l’offre ;
  • constructeur de site : souvent de 0 à 30 € par mois ;
  • modèle premium ou éléments graphiques : coût variable ;
  • aide d’un professionnel : de quelques centaines à plusieurs milliers d’euros selon le périmètre.

Les offres ChatGPT gratuites et payantes, leurs limites et leurs fonctionnalités peuvent évoluer. Consultez les tarifs officiels applicables dans votre pays avant de souscrire. Le coût le plus important reste souvent le temps consacré à la collecte des preuves, à la sélection des projets et aux vérifications.

Quand faut-il utiliser ChatGPT et quand faut-il faire appel à un professionnel ?

ChatGPT convient particulièrement pour :

  • démarrer une structure ;
  • améliorer des textes ;
  • générer des variantes ;
  • analyser la lisibilité ;
  • produire un prototype ;
  • documenter un projet ;
  • préparer un entretien.

L’intervention d’un professionnel est préférable lorsque le portfolio doit :

  • soutenir une marque personnelle importante ;
  • vendre des prestations à forte valeur ;
  • respecter des exigences juridiques ou sectorielles spécifiques ;
  • intégrer des fonctionnalités complexes ;
  • atteindre un niveau élevé d’accessibilité ;
  • bénéficier d’une direction artistique originale ;
  • être optimisé techniquement pour un trafic important.

Une combinaison est souvent efficace : ChatGPT pour accélérer la préparation, puis validation humaine pour la stratégie, le design, le développement et la conformité.

Quelles erreurs éviter avec ChatGPT ?

Publier un contenu générique

Un texte fluide n’est pas forcément convaincant. Remplacez les adjectifs par des faits, des décisions et des résultats.

Inventer des chiffres ou des clients

L’intelligence artificielle peut produire des informations plausibles mais fausses. Chaque donnée doit être contrôlée avant publication.

Confondre compétence et outil

Mentionner dix logiciels ne démontre pas la capacité à résoudre un problème. Présentez plutôt le contexte dans lequel chaque outil a été utilisé.

Copier un design existant

Demandez de l’inspiration, mais évitez de reproduire l’identité visuelle ou le contenu d’un autre portfolio. Vérifiez les licences des images, icônes, polices et ressources utilisées.

Transmettre des informations confidentielles

Ne copiez pas dans une conversation des données personnelles sensibles, des contrats, des informations clients non publiques ou du code propriétaire sans autorisation. Anonymisez les noms, montants et identifiants lorsque cela est nécessaire.

Oublier la maintenance

Un portfolio doit rester à jour. Programmez une vérification tous les trois à six mois :

  • projets récents ;
  • liens ;
  • coordonnées ;
  • compétences ;
  • témoignages ;
  • disponibilité ;
  • performances techniques.

Checklist finale avant de publier

  • [ ] Le métier et la spécialité sont compréhensibles en quelques secondes.
  • [ ] Les trois projets les plus importants sont visibles rapidement.
  • [ ] Chaque projet indique le rôle exact et le contexte.
  • [ ] Les résultats sont vérifiables ou présentés honnêtement.
  • [ ] Aucun chiffre, client ou diplôme n’a été inventé.
  • [ ] Le site fonctionne sur mobile et ordinateur.
  • [ ] Les images sont compressées et accompagnées d’un texte alternatif.
  • [ ] Les titres, URLs et méta-descriptions sont uniques.
  • [ ] Le formulaire de contact a été testé.
  • [ ] Les mentions légales et la confidentialité sont adaptées au projet.
  • [ ] Les liens vers LinkedIn, GitHub, Behance ou d’autres profils sont cohérents.
  • [ ] Le contenu a été relu par une personne humaine.
  • [ ] Le domaine et le certificat HTTPS fonctionnent correctement.

Conclusion : les points clés à retenir

Utiliser ChatGPT pour créer un portfolio professionnel en 2026 permet surtout d’accélérer la réflexion, la rédaction et la production d’un premier site. La méthode la plus efficace consiste à fournir des informations réelles, définir une cible précise, sélectionner quelques projets solides et présenter clairement le contexte, la méthode et les résultats.

ChatGPT peut générer des textes, des structures et du code, mais il ne garantit ni l’exactitude des informations, ni la qualité du design, ni la conformité juridique. La validation humaine reste indispensable pour corriger les erreurs, protéger les données confidentielles, vérifier l’accessibilité et donner au portfolio une personnalité crédible.

Un portfolio simple, rapide, régulièrement mis à jour et fondé sur des preuves sera généralement plus convaincant qu’un site très sophistiqué rempli de contenu générique.

  • ✇PandIA
  • Anthropic dépasserait les 100 milliards de revenus annualisés, 50 % de plus en deux mois
    Une accélération commerciale de 50 % en deux mois propulserait Anthropic au-delà d’un rythme de 100 milliards de dollars de revenus annualisés. Le chiffre, rapporté le 18 septembre 2026, place la start-up derrière Claude dans une catégorie encore très restreinte : celle des entreprises d’IA capables de convertir rapidement l’usage de leurs modèles en revenus à grande échelle.Un seuil spectaculaire, mais qui ne correspond pas encore aux revenus de 2026Selon les informations rapportées par Axios,

Anthropic dépasserait les 100 milliards de revenus annualisés, 50 % de plus en deux mois

Par : Vicomte
19 septembre 2026 à 07:00
Anthropic dépasserait les 100 milliards de revenus annualisés, 50 % de plus en deux mois

Une accélération commerciale de 50 % en deux mois propulserait Anthropic au-delà d’un rythme de 100 milliards de dollars de revenus annualisés. Le chiffre, rapporté le 18 septembre 2026, place la start-up derrière Claude dans une catégorie encore très restreinte : celle des entreprises d’IA capables de convertir rapidement l’usage de leurs modèles en revenus à grande échelle.

Un seuil spectaculaire, mais qui ne correspond pas encore aux revenus de 2026

Selon les informations rapportées par Axios, Anthropic dépasserait désormais un run rate de 100 milliards de dollars. Cette notion mérite une précision essentielle : il ne s’agit pas du chiffre d’affaires effectivement réalisé sur l’ensemble de l’année 2026, mais d’une projection fondée sur le rythme actuel de revenus.

Autrement dit, si l’entreprise maintenait pendant douze mois le niveau observé au moment du calcul, elle dépasserait cette barre annuelle. À un rythme de 100 milliards de dollars, cela représenterait environ 8,3 milliards de dollars par mois. Deux mois plus tôt, une progression de 50 % situerait mécaniquement le rythme précédent autour de 66,7 milliards de dollars.

La différence entre chiffre d’affaires constaté et revenus annualisés est déterminante, particulièrement pour une entreprise dont l’activité peut évoluer rapidement. Une hausse des dépenses d’API, une signature importante ou une adoption ponctuelle d’outils d’agents peuvent gonfler le rythme du moment sans garantir sa stabilité sur douze mois.

Le chiffre reste néanmoins considérable. Il suggère qu’Anthropic ne dépend plus seulement de l’intérêt des développeurs ou de l’expérimentation autour des grands modèles de langage. L’entreprise aurait commencé à transformer l’usage de Claude en activité commerciale massive, soutenue par les budgets informatiques des grandes organisations.

Claude et les agents tirent la demande des entreprises

La dynamique serait principalement portée par la demande professionnelle pour Claude et les outils d’agents associés. Ces derniers permettent à un modèle d’exécuter une suite d’actions, d’interroger des bases de données, d’utiliser des logiciels ou de contribuer à des processus métiers avec un degré d’autonomie supérieur à celui d’un simple assistant conversationnel.

Ce positionnement est commercialement plus intéressant que la seule génération de texte. Une entreprise peut accepter de payer pour un chatbot destiné à ses salariés, mais elle est susceptible d’investir davantage si le système intervient dans le support client, l’analyse documentaire, le développement logiciel ou les opérations internes.

La logique économique est donc celle d’un usage intégré aux flux de travail. Plus Claude devient un composant d’un processus critique, plus le revenu potentiel augmente. Les modèles sont alors facturés à la consommation, par abonnement ou au travers d’offres réservées aux entreprises. Les outils d’agents peuvent également accroître le volume de requêtes, puisqu’ils enchaînent plusieurs appels au modèle pour mener une tâche à bien.

Cette croissance comporte toutefois une contrepartie : les revenus ne suffisent pas à mesurer la rentabilité. Chaque requête mobilise des capacités de calcul coûteuses, en particulier lorsque les modèles sont sollicités pour des tâches longues ou complexes. La trajectoire d’Anthropic devra donc être évaluée à l’aune de ses marges, de ses coûts d’infrastructure et de la stabilité de ses contrats, pas uniquement à partir de son rythme de facturation.

Une future cotation sous le regard des marchés

Anthropic préparerait toujours une introduction en Bourse, malgré les débats persistants sur la sécurité des modèles et sur le rythme de développement de l’IA. Une cotation exposerait l’entreprise à une exigence de transparence bien supérieure à celle d’une société privée.

Les investisseurs chercheraient notamment à distinguer plusieurs éléments : la part des revenus réellement récurrents, la concentration des clients, le poids des contrats pluriannuels, les coûts liés aux centres de données et la dépendance à certains fournisseurs de composants ou de capacité de calcul.

Le rythme annualisé de 100 milliards de dollars constituerait un argument commercial puissant, mais il pourrait aussi nourrir les interrogations du marché. Une croissance aussi rapide rend les comparaisons difficiles et augmente le risque de surestimer une tendance encore jeune. Les analystes voudront savoir combien provient des abonnements durables, combien de la consommation ponctuelle d’API et quelle fraction est directement liée au lancement de nouveaux modèles ou de nouvelles fonctionnalités.

L’entrée en Bourse placerait également la gouvernance d’Anthropic sous observation. L’entreprise s’est construite autour d’un discours insistant sur la sécurité et le développement responsable de l’IA. Cette promesse devra coexister avec la pression financière d’une société cotée, tenue d’accélérer ses revenus et de répondre aux attentes trimestrielles.

La sécurité reste une contrainte commerciale, pas seulement éthique

Les controverses sur la sécurité des modèles ne disparaîtraient pas avec la croissance. Elles pourraient même prendre davantage de poids à mesure que Claude s’intègre dans les systèmes d’information d’entreprises et dans des applications capables d’agir de façon semi-autonome.

Les questions portent sur la fiabilité des réponses, la résistance aux détournements, la protection des données et la capacité des agents à limiter leurs propres actions. Un système qui génère une erreur dans une conversation est problématique ; un agent qui transmet cette erreur à plusieurs outils ou bases de données peut produire des conséquences opérationnelles plus lourdes.

Cette tension entre prudence et vitesse constitue l’un des principaux défis d’Anthropic. Le discours sur l’IA sûre peut différencier l’entreprise auprès de clients professionnels, notamment dans les secteurs réglementés. Mais chaque mécanisme de contrôle supplémentaire peut aussi ralentir le déploiement, limiter certaines fonctionnalités ou augmenter les coûts d’exploitation.

L’enjeu est d’autant plus sensible que l’industrie continue d’accélérer la sortie de nouveaux modèles. Anthropic devra démontrer qu’une approche axée sur la sécurité peut soutenir une croissance commerciale très rapide sans devenir un frein face à ses concurrents.

Le prochain test sera la qualité de cette croissance

Le seuil annoncé ne permet pas encore de conclure à une domination durable. Il montre en revanche que le marché professionnel de l’IA peut générer des volumes de revenus bien supérieurs aux premières estimations, à condition de transformer les modèles en outils directement liés aux opérations des entreprises.

Le prochain jalon concret sera la publication d’éléments financiers vérifiables dans le cadre d’une éventuelle introduction en Bourse. Ils permettront de mesurer la part du revenu annualisé réellement encaissée, son évolution sur plusieurs trimestres et la capacité d’Anthropic à maintenir ses marges malgré le coût du calcul.

Si le rythme supérieur à 100 milliards de dollars se confirme dans les résultats publiés, Anthropic apparaîtra comme une machine commerciale déjà mature malgré son statut de start-up. S’il ralentit fortement, le chiffre restera surtout le reflet d’une phase d’adoption exceptionnelle. Dans les deux cas, la future cotation servira de test décisif : le marché devra déterminer si la croissance de Claude repose sur une demande durable ou sur la course actuelle aux agents d’IA.

  • ✇PandIA
  • Plugin4Shell peut donner aux attaquants un accès sans clic aux secrets d’entreprise
    Un agent de programmation doté d’un accès au terminal, aux fichiers et aux secrets d’une entreprise peut devenir une porte d’entrée sans qu’un développeur ne clique sur un lien. La faille « Plugin4Shell » expose précisément ce risque dans Claude Code, Codex, Gemini CLI et GitHub Copilot.Le verrou des versions épinglées ne suffisait pasLes agents de codage s’appuient de plus en plus sur des extensions : plugins, outils spécialisés ou skills — des compétences capables d’analyser un dépôt, d’exécut

Plugin4Shell peut donner aux attaquants un accès sans clic aux secrets d’entreprise

Par : Decrypt
18 septembre 2026 à 19:01
Plugin4Shell peut donner aux attaquants un accès sans clic aux secrets d’entreprise

Un agent de programmation doté d’un accès au terminal, aux fichiers et aux secrets d’une entreprise peut devenir une porte d’entrée sans qu’un développeur ne clique sur un lien. La faille « Plugin4Shell » expose précisément ce risque dans Claude Code, Codex, Gemini CLI et GitHub Copilot.

Le verrou des versions épinglées ne suffisait pas

Les agents de codage s’appuient de plus en plus sur des extensions : plugins, outils spécialisés ou skills — des compétences capables d’analyser un dépôt, d’exécuter des commandes ou de modifier du code. Pour éviter qu’une dépendance évolue silencieusement, les équipes peuvent normalement utiliser une version épinglée, associée à une référence précise.

Selon les éléments rapportés par Air Security, cette protection pouvait toutefois être contournée. Un attaquant capable de contrôler ou de modifier le dépôt hébergeant un plugin pouvait remplacer son code par une version malveillante, y compris lorsque l’agent était censé utiliser une version déterminée à l’avance.

Le problème ne tient donc pas uniquement à l’installation d’un plugin compromis. Il concerne la manière dont l’agent retrouve, télécharge et charge ce composant. La référence affichée comme fiable ne garantissait pas nécessairement que le code finalement exécuté correspondait bien à celui audité par l’entreprise.

L’attaque est qualifiée de zero-click parce qu’elle ne nécessite pas d’action explicite de la part de l’utilisateur au moment de l’exploitation. Si l’agent ouvre un dépôt, détecte une compétence disponible et l’active automatiquement dans son flux de travail, le code hostile peut s’exécuter dans le cadre des permissions déjà accordées à l’outil.

Quatre agents placés face au même risque

La vulnérabilité touche des produits concurrents, mais construits autour d’un principe similaire : déléguer à un agent une partie du travail réalisé auparavant par un développeur.

Claude Code, l’outil d’Anthropic, peut lire des fichiers, lancer des commandes et intervenir directement dans un environnement de développement. Codex, proposé par OpenAI, poursuit une logique comparable en générant et en exécutant des actions liées au code. Gemini CLI, développé par Google, et GitHub Copilot, propriété de Microsoft, complètent cette liste.

La présence de ces quatre outils dans le périmètre de Plugin4Shell ne signifie pas nécessairement que leur implémentation est identique. Elle révèle plutôt un risque commun : les agents héritent d’une grande partie de la confiance accordée aux extensions et aux dépôts qu’ils consultent.

Air Security estime qu’une exploitation peut conduire à une remote code execution — une exécution de code à distance du point de vue de l’attaquant. Celui-ci pourrait alors accéder aux fichiers visibles par l’agent, aux clés d’API présentes dans son environnement ou à d’autres ressources accessibles avec ses droits.

L’impact dépendrait donc fortement de la configuration locale. Un agent isolé, sans secret et limité à un répertoire de test ne présente pas le même intérêt qu’un agent connecté à un dépôt privé, à un compte cloud ou à des systèmes internes. Mais dans de nombreuses entreprises, les assistants de développement disposent déjà de permissions suffisamment larges pour lire du code propriétaire, interroger des services et exécuter des commandes.

Le scénario d’attaque ne requiert pas un clic, mais il requiert un contexte

Le terme zero-click ne signifie pas qu’un attaquant peut compromettre n’importe quel poste à partir d’Internet, sans condition. Il faut que l’agent rencontre le composant malveillant et dispose d’un mécanisme pour le charger ou l’utiliser.

Le scénario devient particulièrement crédible dans trois situations : un dépôt public intégré au flux de travail, une extension récupérée depuis une source externe, ou un projet dont le propriétaire peut modifier le code référencé. Dans ces cas, le développeur peut simplement demander une analyse ou une correction. L’agent accomplit ensuite les étapes prévues, avec ses privilèges habituels.

C’est cette automatisation qui rend le risque sensible. Un humain repère parfois une commande inhabituelle ou une modification suspecte. Un agent, lui, peut l’interpréter comme une étape nécessaire à l’exécution d’une compétence. Si le contrôle des extensions repose surtout sur leur nom, leur provenance ou une version déclarée, la chaîne de confiance devient fragile.

La compromission d’une clé d’API constitue alors l’un des scénarios les plus directs. Une clé cloud, un jeton de registre de paquets ou des identifiants de contrôle de version peuvent permettre de poursuivre l’attaque hors de la machine initiale. Le périmètre réel dépend des secrets effectivement exposés à l’agent et des règles de segmentation appliquées par l’entreprise.

Des réponses éditeurs très inégales

Anthropic et OpenAI ont publié des correctifs pour leurs outils concernés. Ces mises à jour doivent être déployées rapidement, mais elles ne dispensent pas les équipes de revoir les plugins déjà autorisés ni les secrets accessibles aux agents.

La situation est plus préoccupante pour GitHub Copilot, qui resterait sans correctif au moment des informations disponibles. Les entreprises utilisant ses fonctions d’agent doivent considérer les extensions et dépôts externes comme une surface à risque jusqu’à la publication d’une mesure technique claire.

Du côté de Google, la stratégie annoncée serait différente : Gemini CLI doit être progressivement retiré, sans correctif prévu pour la vulnérabilité. Un retrait réduit l’exposition future, mais ne protège pas les installations existantes ni les environnements dans lesquels l’outil reste utilisé pendant la phase de transition. Il faudra également vérifier la révocation des jetons et des clés auxquels l’agent a pu accéder.

Cette réponse asymétrique souligne une difficulté plus large : les outils d’IA évoluent plus vite que les pratiques de gestion des dépendances. Une extension exécutée par un agent ne devrait pas être traitée comme un simple module facultatif. Elle peut disposer d’un accès comparable à celui d’un collaborateur technique — parfois sans les mêmes contrôles, ni la même traçabilité.

La priorité : réduire les permissions avant le prochain incident

Les entreprises peuvent limiter l’exposition en désactivant les plugins non indispensables, en imposant des miroirs internes et en vérifiant les sommes de contrôle ou les identifiants immuables des composants. Une version « épinglée » doit être associée à un contenu cryptographiquement vérifiable, pas uniquement à une étiquette lisible.

Les agents devraient aussi fonctionner avec des comptes dédiés, des jetons à durée courte et des permissions minimales. Les clés de production, les identifiants cloud à privilèges élevés et les secrets globaux ne devraient pas être disponibles dans leur environnement d’exécution. La journalisation des commandes, des téléchargements et des accès aux fichiers permettrait enfin de rechercher une activité suspecte.

Le prochain jalon attendu est la publication de correctifs et de détails techniques complets pour chaque produit, notamment chez Microsoft et Google. À court terme, la mesure la plus concrète reste de considérer tout plugin non vérifié comme du code tiers exécutable — et de mesurer précisément quels fichiers, clés et systèmes l’agent peut atteindre.

  • ✇PandIA
  • Comment utiliser ChatGPT pour créer un cahier des charges en 2026
    Utiliser ChatGPT pour créer un cahier des charges permet de structurer rapidement un projet, de clarifier les besoins et de produire une première version exploitable. Ce guide explique comment créer un cahier des charges avec ChatGPT en 2026, quels prompts utiliser, quelles informations fournir et comment contrôler la qualité du document final.Qu’est-ce qu’un cahier des charges ?Un cahier des charges est un document de référence qui décrit le besoin à satisfaire, les objectifs du projet, les fon

Comment utiliser ChatGPT pour créer un cahier des charges en 2026

Par : Vicomte
18 septembre 2026 à 12:06
Comment utiliser ChatGPT pour créer un cahier des charges en 2026

Utiliser ChatGPT pour créer un cahier des charges permet de structurer rapidement un projet, de clarifier les besoins et de produire une première version exploitable. Ce guide explique comment créer un cahier des charges avec ChatGPT en 2026, quels prompts utiliser, quelles informations fournir et comment contrôler la qualité du document final.

Qu’est-ce qu’un cahier des charges ?

Un cahier des charges est un document de référence qui décrit le besoin à satisfaire, les objectifs du projet, les fonctionnalités attendues, les contraintes et les critères de réussite. Il sert à aligner toutes les parties prenantes : client, équipe produit, développeurs, designers, prestataires, direction ou service juridique.

Selon le projet, le cahier des charges peut être :

  • Fonctionnel : il décrit ce que le produit ou le service doit permettre de faire ;
  • Technique : il précise les technologies, l’architecture, les intégrations et les exigences d’infrastructure ;
  • Graphique : il présente l’identité visuelle, les maquettes et les règles d’interface ;
  • Marketing : il définit les cibles, le positionnement, les contenus et les objectifs de conversion ;
  • Organisationnel : il détaille les rôles, les délais, le budget et les modalités de suivi.

ChatGPT peut aider à rédiger, reformuler, structurer et auditer ce document. En revanche, il ne connaît pas automatiquement les spécificités du projet et ne remplace pas les validations métier, techniques, juridiques ou budgétaires.

Pourquoi utiliser ChatGPT pour créer un cahier des charges ?

Gagner du temps sur la structure

ChatGPT peut générer rapidement une table des matières cohérente avec des rubriques comme :

  • contexte et problématique ;
  • objectifs ;
  • périmètre ;
  • utilisateurs cibles ;
  • fonctionnalités ;
  • contraintes ;
  • planning ;
  • budget ;
  • critères d’acceptation ;
  • livrables ;
  • risques.

Cette première structure évite de partir d’une page blanche.

Transformer des idées imprécises en exigences

Une demande comme « créer une application de réservation simple et intuitive » est trop vague pour être confiée directement à une équipe technique. ChatGPT peut aider à la transformer en exigences plus précises :

  • l’utilisateur peut consulter les créneaux disponibles ;
  • l’utilisateur peut réserver un créneau ;
  • une confirmation est envoyée par e-mail ;
  • une réservation peut être annulée jusqu’à 24 heures avant le rendez-vous ;
  • l’administrateur peut modifier les disponibilités.

Identifier les informations manquantes

L’un des usages les plus utiles consiste à demander à ChatGPT de poser des questions avant de rédiger. Cette étape permet de faire apparaître les zones d’incertitude : cible, budget, délais, règles métier, données personnelles, intégrations ou critères de réussite.

Adapter le document à plusieurs interlocuteurs

Un même cahier des charges peut être reformulé pour :

  • une direction générale ;
  • une agence web ;
  • une équipe de développement ;
  • un appel d’offres ;
  • un client non technique ;
  • un comité de validation.

ChatGPT peut produire une version détaillée et une synthèse exécutive sans modifier le fond du projet.

Les informations à préparer avant d’utiliser ChatGPT

La qualité du cahier des charges dépend directement de la qualité des informations fournies. Avant de rédiger le prompt, réunir autant que possible les éléments suivants.

| Élément | Questions à préciser |

|---|---|

| Contexte | Pourquoi le projet est-il lancé ? Quel problème doit-il résoudre ? |

| Objectifs | Quels résultats sont attendus ? |

| Public cible | Qui utilisera le produit ou le service ? |

| Périmètre | Que faut-il inclure et exclure ? |

| Fonctionnalités | Quelles actions les utilisateurs doivent-ils effectuer ? |

| Contraintes | Existe-t-il des obligations techniques, légales ou métier ? |

| Budget | Quelle enveloppe est disponible ? |

| Délais | Existe-t-il une date de lancement ou des jalons ? |

| Technologies | Des outils ou systèmes sont-ils imposés ? |

| Données | Quelles données sont collectées, stockées ou transférées ? |

| Références | Existe-t-il des documents, maquettes ou concurrents à analyser ? |

| Critères de réussite | Comment déterminer que le projet est réussi ? |

Si certaines informations sont inconnues, il est préférable de l’indiquer explicitement. Une information absente ne doit pas être remplacée par une hypothèse silencieuse.

Méthode étape par étape pour créer un cahier des charges avec ChatGPT

1. Définir le rôle demandé à ChatGPT

Le résultat sera généralement plus pertinent si ChatGPT reçoit un rôle précis. Par exemple :

Agis comme un chef de projet digital et un analyste fonctionnel spécialisé dans la rédaction de cahiers des charges. Utilise un style professionnel, concret et compréhensible par une équipe métier comme par une équipe technique.

Cette instruction oriente le vocabulaire, le niveau de détail et la manière de structurer les exigences.

2. Présenter le contexte du projet

Le contexte doit répondre à quatre questions :

  1. Quelle organisation porte le projet ?
  2. Quel problème doit être résolu ?
  3. Pour quel public ?
  4. Quel résultat est attendu ?

Exemple :

Une PME spécialisée dans les cours de sport souhaite lancer une plateforme de réservation en ligne. Les clients doivent pouvoir consulter les séances, réserver une place, payer en ligne et recevoir des rappels. L’équipe actuelle utilise un agenda partagé et traite les paiements manuellement.

Un contexte concret permet d’éviter un cahier des charges générique.

3. Demander une phase de questions

Il est souvent préférable de ne pas demander immédiatement la rédaction complète. Utiliser d’abord un prompt de clarification :

À partir de ce contexte, pose les 15 questions les plus importantes avant de rédiger le cahier des charges. Classe les questions par thème : objectifs, utilisateurs, fonctionnalités, contraintes techniques, budget, planning, sécurité et conformité. Ne rédige pas encore le document.

Cette méthode permet de faire émerger les décisions nécessaires. Les réponses peuvent ensuite être intégrées dans une seconde requête.

4. Définir le périmètre et le hors-périmètre

Un bon cahier des charges indique aussi ce qui ne sera pas réalisé. Cette précision limite les malentendus et les demandes ajoutées en cours de projet.

Exemple :

  • Inclus : réservation, paiement, notifications e-mail, espace administrateur ;
  • Non inclus dans la première version : application mobile native, programme de fidélité, marketplace de partenaires ;
  • Évolution possible : connexion avec un logiciel de comptabilité.

Le hors-périmètre est particulièrement important pour un projet réalisé par un prestataire externe.

5. Organiser les fonctionnalités par priorité

ChatGPT peut classer les fonctionnalités selon la méthode MoSCoW :

  • Must have : indispensable au lancement ;
  • Should have : important, mais non bloquant ;
  • Could have : intéressant si le temps et le budget le permettent ;
  • Won’t have : exclu de la version actuelle.

Prompt utile :

Classe les fonctionnalités proposées selon la méthode MoSCoW. Pour chaque fonctionnalité, explique la justification, les dépendances éventuelles et le risque si elle est reportée.

Cette classification aide à définir un périmètre de première version réaliste.

6. Transformer les fonctionnalités en exigences testables

Une exigence doit être suffisamment précise pour être vérifiée. Les formulations vagues comme « interface moderne », « site rapide » ou « expérience intuitive » doivent être complétées.

Exemple insuffisant :

Le site doit être rapide.

Exemple plus exploitable :

Sur une connexion 4G standard, la page d’accueil doit afficher son contenu principal en moins de trois secondes dans au moins 90 % des cas mesurés sur les navigateurs ciblés.

Tous les indicateurs ne peuvent pas être définis dès le début, mais ChatGPT peut signaler les exigences trop floues :

Analyse les exigences ci-dessous. Repère les formulations subjectives, les ambiguïtés et les informations manquantes. Propose une version mesurable de chaque exigence sans inventer de valeur non validée.

7. Ajouter des critères d’acceptation

Les critères d’acceptation indiquent les conditions à respecter pour considérer une fonctionnalité comme terminée.

Exemple :

Fonctionnalité : réservation d’un cours

  • L’utilisateur connecté peut sélectionner un cours disposant d’au moins une place ;
  • le système affiche le prix avant validation ;
  • une confirmation apparaît après le paiement ;
  • un e-mail récapitulatif est envoyé ;
  • la place n’est plus disponible pour les autres utilisateurs ;
  • une erreur explicite est affichée si le paiement échoue.

Ces critères peuvent être formulés avec la structure suivante :

  • Étant donné : le contexte de départ ;
  • Quand : l’action réalisée ;
  • Alors : le résultat attendu.

Exemple :

Étant donné qu’un utilisateur est connecté et qu’une séance possède une place disponible, quand il valide le paiement, alors une réservation confirmée est créée et un e-mail récapitulatif est envoyé.

8. Demander une rédaction complète et structurée

Une fois les informations validées, utiliser un prompt détaillé :

Rédige un cahier des charges complet à partir des informations fournies.
Structure le document avec les sections suivantes :
1. résumé exécutif ;
2. contexte et problématique ;
3. objectifs ;
4. utilisateurs et personas ;
5. périmètre et hors-périmètre ;
6. parcours utilisateurs ;
7. exigences fonctionnelles numérotées ;
8. exigences non fonctionnelles ;
9. contraintes techniques et réglementaires ;
10. intégrations ;
11. données et sécurité ;
12. livrables ;
13. planning prévisionnel ;
14. budget à compléter ;
15. critères d’acceptation ;
16. risques et hypothèses ;
17. questions restant à trancher.
Pour chaque exigence, indique un identifiant, une priorité, une description et un critère de validation. Signale clairement toute hypothèse.

Exemple de prompt complet pour ChatGPT

Voici un modèle adaptable :

Agis comme un consultant en conception de produits numériques. Rédige un cahier des charges fonctionnel pour le projet suivant : [description du projet].
Contexte : [activité de l’organisation, problème actuel, origine du besoin].
Objectifs : [objectifs commerciaux, opérationnels ou utilisateurs].
Public cible : [profils des utilisateurs].
Fonctionnalités envisagées : [liste des idées].
Contraintes : [budget, délai, outils, réglementation, technologies].
Commence par lister les informations manquantes et les hypothèses nécessaires. Ensuite, propose une structure détaillée. Après validation de la structure, rédige le cahier des charges avec des exigences numérotées, des priorités MoSCoW et des critères d’acceptation mesurables. Ne présente aucune hypothèse comme un fait confirmé.

Ce prompt peut être utilisé en plusieurs échanges afin de conserver un contrôle sur le contenu.

Les sections indispensables d’un cahier des charges

Résumé exécutif

Cette section doit présenter le projet en quelques paragraphes : besoin, solution envisagée, cible, objectifs et résultat attendu.

Objectifs et indicateurs

Les objectifs doivent être associés à des indicateurs lorsque cela est possible :

  • réduire le temps de traitement d’une demande ;
  • augmenter le taux de conversion ;
  • diminuer le nombre d’erreurs ;
  • atteindre un certain niveau d’utilisation ;
  • réduire les tâches manuelles.

Utilisateurs et parcours

Décrire les différents profils :

  • visiteur ;
  • utilisateur inscrit ;
  • administrateur ;
  • opérateur ;
  • partenaire ;
  • responsable métier.

Pour chaque profil, préciser les actions, les droits et les besoins.

Exigences non fonctionnelles

Cette partie est souvent oubliée. Elle peut couvrir :

  • performance ;
  • disponibilité ;
  • sécurité ;
  • accessibilité ;
  • compatibilité navigateur ;
  • responsive design ;
  • sauvegardes ;
  • journalisation ;
  • évolutivité ;
  • maintenance ;
  • référencement naturel.

Pour l’accessibilité numérique, les critères des WCAG 2.2 peuvent servir de référence. Pour la gestion des exigences d’un projet logiciel, la norme ISO/IEC/IEEE 29148 constitue également un cadre utile.

Données et conformité

Le document doit préciser :

  • quelles données sont collectées ;
  • pourquoi elles sont collectées ;
  • où elles sont stockées ;
  • qui peut y accéder ;
  • combien de temps elles sont conservées ;
  • comment elles peuvent être supprimées ou exportées.

Le RGPD reste applicable dès lors que le projet traite des données personnelles de personnes situées dans l’Union européenne. ChatGPT peut aider à repérer les sujets à traiter, mais la validation doit être effectuée par une personne compétente en protection des données.

Comment utiliser les fichiers et documents avec ChatGPT ?

Selon le compte, l’interface et les fonctionnalités disponibles en 2026, ChatGPT peut permettre d’ajouter des documents, des tableaux, des PDF ou des présentations. Ces fichiers peuvent servir à analyser :

  • un brief client ;
  • une expression de besoin ;
  • des notes de réunion ;
  • une ancienne version du cahier des charges ;
  • des spécifications d’API ;
  • un catalogue de produits ;
  • des résultats d’enquête.

Prompt recommandé :

Analyse le document fourni et extrais uniquement les exigences explicites. Pour chaque exigence, indique la page ou la section d’origine, le niveau de priorité estimé et les informations manquantes. Sépare les faits, les hypothèses et les contradictions.

Il faut toutefois vérifier chaque information dans le document original. Un modèle peut mal interpréter un tableau, confondre deux versions ou produire une référence de page incorrecte.

Comment faire relire et améliorer le cahier des charges ?

Une fois le document généré, demander un audit séparé :

Audite ce cahier des charges comme un responsable qualité. Vérifie la cohérence des objectifs et des fonctionnalités, les doublons, les contradictions, les exigences non testables, les dépendances oubliées, les risques de dépassement de périmètre et les questions non résolues. Présente les corrections dans un tableau à quatre colonnes : problème, impact, recommandation, section concernée.

Il est également utile de demander plusieurs lectures spécialisées :

  • lecture métier : le document répond-il réellement au besoin ?
  • lecture technique : les exigences sont-elles réalisables ?
  • lecture utilisateur : les parcours sont-ils compréhensibles ?
  • lecture sécurité : les accès et les données sont-ils suffisamment protégés ?
  • lecture juridique : les obligations applicables sont-elles identifiées ?
  • lecture projet : le planning et le budget sont-ils cohérents ?

Confidentialité et précautions à prendre

Ne pas transmettre sans autorisation :

  • mots de passe ou clés d’API ;
  • données bancaires ;
  • fichiers contenant des données personnelles ;
  • secrets commerciaux ;
  • contrats confidentiels ;
  • informations médicales ;
  • code source propriétaire ;
  • documents soumis à une clause de confidentialité.

Les conditions de conservation, d’utilisation des données et de gestion des espaces de travail peuvent varier selon le compte, l’offre et les paramètres actifs. Vérifier la documentation officielle et les règles internes de l’organisation avant d’envoyer un document sensible.

Une anonymisation préalable est recommandée : remplacer les noms, adresses, numéros de contrat et identifiants par des valeurs fictives.

Combien de temps faut-il pour créer un cahier des charges avec ChatGPT ?

Le délai dépend fortement de la complexité du projet :

  • Projet simple : environ 30 à 90 minutes pour une première version ;
  • site vitrine ou petite fonctionnalité : une à trois heures avec relecture ;
  • application métier ou plateforme multi-utilisateurs : plusieurs séances de travail ;
  • projet réglementé ou techniquement complexe : plusieurs jours, avec validation d’experts.

ChatGPT accélère surtout la rédaction et l’organisation. Il ne supprime pas le temps nécessaire aux décisions, aux arbitrages, aux tests et aux validations. Le coût de l’outil dépend de l’offre utilisée et peut évoluer ; les tarifs doivent être vérifiés sur la page officielle au moment de l’abonnement.

Quand ChatGPT ne suffit-il pas ?

Une validation humaine est indispensable lorsque le projet concerne :

  • la santé ;
  • la finance ;
  • l’assurance ;
  • les infrastructures critiques ;
  • la cybersécurité ;
  • des données sensibles ;
  • un contrat engageant juridiquement ;
  • un système automatisé à fort impact ;
  • des contraintes réglementaires spécifiques.

ChatGPT peut signaler des risques, mais il ne garantit ni la conformité juridique, ni la sécurité technique, ni la faisabilité budgétaire. Le cahier des charges final doit être relu par les personnes responsables du produit, de la technique, de la sécurité et, si nécessaire, du droit.

Checklist avant de valider le document

Avant de transmettre le cahier des charges à une équipe ou à un prestataire, vérifier les points suivants :

  • Le problème à résoudre est clairement formulé ;
  • les objectifs sont distincts des fonctionnalités ;
  • le public cible est identifié ;
  • le périmètre et le hors-périmètre sont indiqués ;
  • chaque fonctionnalité possède une priorité ;
  • les exigences sont numérotées ;
  • les termes vagues ont été précisés ;
  • les critères d’acceptation sont vérifiables ;
  • les données personnelles sont identifiées ;
  • les contraintes de sécurité et d’accessibilité sont mentionnées ;
  • les intégrations externes sont listées ;
  • les dépendances sont documentées ;
  • les hypothèses sont séparées des faits ;
  • les risques sont connus ;
  • les livrables sont définis ;
  • les responsabilités sont attribuées ;
  • le planning reste compatible avec le périmètre ;
  • le budget est cohérent ou indiqué comme restant à estimer ;
  • les parties prenantes ont relu et validé le document.

FAQ sur la création d’un cahier des charges avec ChatGPT

ChatGPT peut-il rédiger seul un cahier des charges ?

Il peut générer une première version complète, mais celle-ci doit être alimentée par des informations réelles et relue par les responsables du projet. Un document généré sans contexte risque de contenir des fonctionnalités inutiles, des hypothèses erronées ou des exigences irréalistes.

Quel est le meilleur prompt pour un cahier des charges ?

Le meilleur prompt précise le rôle attendu, le contexte, les objectifs, les utilisateurs, les contraintes, le format souhaité et le niveau de précision. Il doit aussi demander à ChatGPT de poser des questions avant de rédiger et de signaler les hypothèses.

Peut-il créer un cahier des charges technique ?

Oui, notamment pour structurer les exigences d’architecture, d’hébergement, d’API, de sécurité, de performance et d’intégration. Cependant, un architecte ou un développeur doit valider les choix techniques et leur faisabilité.

Un cahier des charges généré par IA a-t-il une valeur juridique ?

La valeur juridique dépend du contexte, des parties, du contrat et des règles applicables. L’utilisation de ChatGPT ne confère aucune valeur juridique automatique au document. Une validation professionnelle peut être nécessaire.

Conclusion : les points clés à retenir

ChatGPT peut considérablement faciliter la création d’un cahier des charges en 2026, à condition de l’utiliser comme assistant de structuration et d’analyse, et non comme source unique de décision.

La méthode la plus fiable consiste à :

  1. préparer les informations essentielles ;
  2. demander à ChatGPT de poser des questions ;
  3. définir clairement le périmètre ;
  4. classer les fonctionnalités par priorité ;
  5. transformer les idées en exigences testables ;
  6. ajouter des critères d’acceptation ;
  7. faire auditer le document ;
  8. vérifier les aspects techniques, juridiques, budgétaires et liés à la sécurité ;
  9. faire valider la version finale par les parties prenantes.

Un cahier des charges utile n’est pas nécessairement le plus long. C’est celui qui réduit les ambiguïtés, facilite les estimations et permet de vérifier objectivement si le projet répond au besoin initial.

  • ✇PandIA
  • Atlas 960E de Huawei atteint 8 exaflops, la Chine veut réduire sa dépendance à Nvidia
    La bataille des puces IA se déplace du composant vers l’infrastructure complète. Avec l’Atlas 960E SuperPoD, Huawei ne cherche plus seulement à proposer un processeur alternatif aux accélérateurs Nvidia : le groupe chinois veut fournir des grappes capables d’atteindre une échelle industrielle.Une grappe de 4 096 processeurs AscendPrésenté le 17 septembre 2026, l’Atlas 960E SuperPoD peut réunir jusqu’à 4 096 processeurs Ascend au sein d’un même système. Huawei annonce une puissance de calcul maxi

Atlas 960E de Huawei atteint 8 exaflops, la Chine veut réduire sa dépendance à Nvidia

Par : Vicomte
17 septembre 2026 à 19:01
Atlas 960E de Huawei atteint 8 exaflops, la Chine veut réduire sa dépendance à Nvidia

La bataille des puces IA se déplace du composant vers l’infrastructure complète. Avec l’Atlas 960E SuperPoD, Huawei ne cherche plus seulement à proposer un processeur alternatif aux accélérateurs Nvidia : le groupe chinois veut fournir des grappes capables d’atteindre une échelle industrielle.

Une grappe de 4 096 processeurs Ascend

Présenté le 17 septembre 2026, l’Atlas 960E SuperPoD peut réunir jusqu’à 4 096 processeurs Ascend au sein d’un même système. Huawei annonce une puissance de calcul maximale de 8 exaflops en FP8, soit 8 milliards de milliards d’opérations par seconde avec ce format de précision réduit, couramment utilisé pour l’entraînement et l’inférence des modèles d’IA.

L’architecture vise les charges de travail les plus lourdes : entraînement de grands modèles de langage, génération vidéo, simulation scientifique ou services d’inférence à très grande échelle. La machine peut également embarquer jusqu’à 1 pétaoctet de mémoire HBM, une mémoire à large bande passante placée au plus près des processeurs afin de limiter les temps d’accès aux données.

Cette capacité mémoire est un élément central. Dans les systèmes d’IA modernes, la puissance de calcul brute ne suffit pas : les modèles doivent déplacer d’immenses volumes de paramètres entre les accélérateurs, la mémoire et les unités de stockage. Une grappe très puissante mais mal interconnectée peut donc perdre une part importante de son rendement théorique.

L’interconnexion optique comme point stratégique

Pour relier ses processeurs, Huawei s’appuie sur une technologie d’interconnexion optique near-package optics (NPO), baptisée Hi-ONE. Le principe consiste à rapprocher les composants optiques des processeurs afin d’augmenter la bande passante entre les unités de calcul tout en limitant les pertes énergétiques associées aux connexions électriques traditionnelles.

Huawei affirme que cette architecture permettrait de réduire la consommation de plus de 550 kilowatts par rapport à une conception conventionnelle. Le chiffre doit toutefois être interprété avec prudence : il s’agit d’une comparaison dépendante de la configuration de référence, du niveau d’utilisation et des systèmes de refroidissement pris en compte.

La disponibilité annoncée atteint 99,8 %. À l’échelle d’une année, cela correspond à environ 17,5 heures d’indisponibilité potentielle. Pour un centre de données qui entraîne un modèle durant plusieurs semaines, la continuité de service devient un facteur aussi important que la puissance maximale affichée.

Huawei répond aux restrictions américaines par l’échelle

L’annonce intervient dans un contexte de restrictions américaines visant l’accès de la Chine aux accélérateurs avancés et aux équipements nécessaires à leur fabrication. Ces mesures ont compliqué l’acquisition de processeurs Nvidia de dernière génération et limité la capacité des entreprises chinoises à s’appuyer sur l’écosystème logiciel et matériel dominant du secteur.

La réponse de Huawei repose sur une logique claire : si l’accès à la puce la plus performante est restreint, la puissance recherchée peut être reconstruite avec un grand nombre de processeurs nationaux, à condition de maîtriser les communications entre eux. L’Atlas 960E SuperPoD illustre cette stratégie de scale-out, qui consiste à répartir le calcul sur une grappe de grande taille plutôt qu’à dépendre d’un accélérateur unique toujours plus puissant.

Cette approche ne se limite pas à l’assemblage de composants. Elle suppose de contrôler plusieurs niveaux de la chaîne : processeurs Ascend, mémoire HBM, interconnexions, logiciels de programmation, outils de déploiement et systèmes de refroidissement. L’objectif est de réduire les dépendances extérieures sur l’ensemble de la plateforme, et pas seulement au niveau du silicium.

Les 8 exaflops ne suffisent pas à établir une parité avec Nvidia

La puissance FP8 annoncée constitue un indicateur spectaculaire, mais elle ne permet pas à elle seule de conclure à une équivalence avec les infrastructures Nvidia. Les performances réelles dépendent de la capacité à maintenir les processeurs alimentés en données, à répartir efficacement les tâches et à synchroniser des milliers d’accélérateurs.

Le rendement des logiciels est tout aussi déterminant. Nvidia bénéficie depuis des années de CUDA, de bibliothèques optimisées et d’un vaste écosystème d’outils développés par les chercheurs et les entreprises. Huawei doit, de son côté, faire progresser son environnement logiciel autour d’Ascend pour permettre aux modèles conçus initialement pour CUDA de fonctionner avec peu de modifications et une efficacité comparable.

À cette difficulté s’ajoute la question des benchmarks indépendants. Les chiffres de Huawei décrivent une capacité maximale en FP8, mais il faudra disposer de résultats reproductibles sur des modèles réels, notamment pour mesurer le temps d’entraînement, le coût par requête, la consommation totale et la stabilité sur des campagnes longues. La densité mémoire annoncée devra également être évaluée en conditions opérationnelles : mémoire disponible, débit effectif et capacité à éviter les échanges coûteux entre nœuds.

L’Atlas 960E SuperPoD n’en représente pas moins un changement d’échelle dans la stratégie chinoise. Huawei ne présente plus seulement Ascend comme une solution de remplacement composant par composant. Le groupe met en avant une architecture complète, pensée pour des centres de données capables d’absorber une forte demande en calcul.

Une infrastructure nationale encore confrontée à plusieurs limites

La construction d’un équivalent national crédible à l’écosystème Nvidia dépendra de facteurs qui dépassent les spécifications de cette machine. La disponibilité des semi-conducteurs avancés, les capacités de production, l’accès aux outils de conception électronique et la rapidité de livraison des systèmes seront déterminants.

Le coût total d’exploitation sera également scruté. Une réduction de 550 kilowatts peut représenter une économie substantielle dans un centre de données fonctionnant en continu, mais elle doit être rapportée à la consommation totale de la grappe, aux besoins de refroidissement et au prix de l’électricité. À grande échelle, la fiabilité de l’interconnexion Hi-ONE pourrait avoir autant d’impact que le nombre de processeurs installés.

Pour les entreprises chinoises, l’enjeu est immédiat : disposer d’une infrastructure dont la chaîne d’approvisionnement est moins exposée aux décisions américaines. Pour Huawei, il s’agit aussi de transformer Ascend en plateforme durable, avec des clients, des développeurs et des outils suffisamment nombreux pour soutenir plusieurs générations de systèmes.

Le prochain jalon sera donc moins l’annonce d’un nouveau nombre d’exaflops que la démonstration publique de l’Atlas 960E sur des modèles industriels. Des résultats indépendants sur l’entraînement, la consommation et la disponibilité permettront de mesurer si les 4 096 processeurs Ascend forment réellement une alternative compétitive aux grappes Nvidia — ou seulement une capacité théorique conçue pour compenser, par le volume, un accès restreint aux puces les plus avancées.

  • ✇PandIA
  • Comment utiliser ChatGPT pour créer un plan financier en 2026
    ChatGPT peut aider à créer un plan financier en 2026 en structurant un budget, en analysant les dettes, en définissant une épargne de précaution et en comparant plusieurs scénarios. Ce guide explique comment utiliser ChatGPT efficacement, quelles informations fournir, quels calculs demander et quelles vérifications effectuer avant toute décision financière.Ce qu’est un plan financier personnelUn plan financier est une feuille de route qui relie les revenus, les dépenses, l’épargne, les dettes, l

Comment utiliser ChatGPT pour créer un plan financier en 2026

Par : Decrypt
17 septembre 2026 à 12:06
Comment utiliser ChatGPT pour créer un plan financier en 2026

ChatGPT peut aider à créer un plan financier en 2026 en structurant un budget, en analysant les dettes, en définissant une épargne de précaution et en comparant plusieurs scénarios. Ce guide explique comment utiliser ChatGPT efficacement, quelles informations fournir, quels calculs demander et quelles vérifications effectuer avant toute décision financière.

Ce qu’est un plan financier personnel

Un plan financier est une feuille de route qui relie les revenus, les dépenses, l’épargne, les dettes, les investissements et les objectifs à différentes échéances. Il ne s’agit pas uniquement de suivre un budget mensuel : un plan complet doit aussi tenir compte des imprévus, de la fiscalité, de la retraite et de la capacité à financer des projets.

Un plan financier en 2026 peut notamment répondre aux questions suivantes :

  • Quel montant épargner chaque mois ?
  • Combien de temps faut-il pour constituer une épargne de précaution ?
  • Faut-il rembourser une dette avant d’investir ?
  • Quel budget consacrer au logement, aux loisirs et aux vacances ?
  • Comment préparer un achat immobilier ou un changement professionnel ?
  • Combien investir pour atteindre un objectif à long terme ?
  • Quelles dépenses réduire sans dégrader excessivement le niveau de vie ?

ChatGPT peut servir d’assistant d’analyse et de préparation, mais il ne remplace pas un conseiller financier, un expert-comptable, un notaire ou un professionnel habilité à fournir un conseil personnalisé.

Pourquoi utiliser ChatGPT pour établir un plan financier en 2026 ?

Gagner du temps dans l’organisation des informations

Les données financières sont souvent dispersées entre relevés bancaires, applications, factures et documents fiscaux. ChatGPT peut aider à classer les dépenses par catégories et à transformer des informations désordonnées en tableau exploitable.

Par exemple, une liste de dépenses peut être répartie entre :

  • logement ;
  • alimentation ;
  • transport ;
  • assurances ;
  • abonnements ;
  • santé ;
  • loisirs ;
  • impôts et taxes ;
  • remboursement de crédits ;
  • épargne et investissements.

Cette organisation facilite l’identification des dépenses fixes, variables, essentielles et ajustables.

Tester plusieurs scénarios

ChatGPT peut comparer différents scénarios à partir d’hypothèses clairement indiquées :

  • épargner 300, 500 ou 700 euros par mois ;
  • rembourser un crédit plus rapidement ou conserver une épargne disponible ;
  • acheter un véhicule comptant ou financer l’achat ;
  • investir progressivement ou attendre la constitution d’une épargne de sécurité ;
  • modifier le budget après une hausse du loyer ou une baisse de revenus.

L’intérêt principal réside dans la comparaison des conséquences, et non dans la production d’une prédiction certaine.

Comprendre les calculs financiers

Un assistant conversationnel peut expliquer simplement :

  • les intérêts composés ;
  • le taux d’endettement ;
  • la capacité d’épargne ;
  • le coût total d’un crédit ;
  • l’inflation ;
  • le rendement réel après inflation ;
  • la différence entre rendement brut et rendement net de frais et de fiscalité.

Toutefois, un calcul généré par ChatGPT doit être recalculé avec une feuille de calcul ou une source fiable, surtout lorsqu’il concerne un crédit, un investissement ou un montant fiscal.

Les informations à préparer avant d’interroger ChatGPT

La qualité du plan dépend directement de la qualité des données fournies. Il est préférable de préparer une synthèse mensuelle et annuelle.

Les revenus

Indiquer séparément :

  • le salaire net mensuel ;
  • les revenus variables ;
  • les primes et bonus ;
  • les allocations ou pensions ;
  • les revenus locatifs ;
  • les revenus d’une activité indépendante ;
  • les revenus exceptionnels ;
  • la fréquence de versement.

Pour un revenu variable, utiliser une moyenne prudente basée sur les 12 derniers mois, et non sur le meilleur mois de l’année.

Les dépenses

Classer les dépenses en trois groupes :

  1. Dépenses fixes : loyer, crédit immobilier, assurances, abonnements, pension alimentaire.
  2. Dépenses variables nécessaires : alimentation, énergie, transport, santé.
  3. Dépenses discrétionnaires : sorties, achats non essentiels, loisirs, voyages.

Les dépenses annuelles doivent être converties en moyenne mensuelle. Une assurance de 600 euros payée une fois par an représente ainsi 50 euros par mois à prévoir.

L’épargne et le patrimoine

Mentionner les montants disponibles sur :

  • comptes courants ;
  • livrets d’épargne ;
  • placements financiers ;
  • assurance vie ;
  • épargne retraite ;
  • épargne salariale ;
  • immobilier ;
  • liquidités destinées à un projet précis.

Il est inutile de transmettre des numéros de compte, identifiants, adresses complètes ou documents contenant des informations personnelles sensibles.

Les dettes

Pour chaque crédit, indiquer :

  • le capital restant dû ;
  • le taux d’intérêt ;
  • la mensualité ;
  • la durée restante ;
  • les éventuelles pénalités de remboursement anticipé ;
  • le type de crédit.

Les crédits renouvelables et découverts doivent être identifiés séparément, car leur coût peut être élevé.

Les objectifs

Un objectif financier doit comporter un montant et une échéance. Par exemple :

  • constituer 8 000 euros d’épargne de précaution en 18 mois ;
  • financer 20 000 euros de travaux dans trois ans ;
  • préparer un apport immobilier de 40 000 euros dans cinq ans ;
  • augmenter l’épargne retraite à partir de 2026 ;
  • rembourser une dette de 6 000 euros avant décembre 2027.

Comment utiliser ChatGPT étape par étape pour créer un plan financier

1. Demander une synthèse de la situation actuelle

Commencer par demander à ChatGPT d’organiser les informations avant de solliciter des recommandations.

Exemple de prompt :

Agis comme un assistant de planification budgétaire pédagogique. Analyse la situation suivante sans recommander de produit financier précis. Classe les revenus, dépenses, dettes et avoirs. Calcule le reste à vivre mensuel, le taux d’épargne et les principales catégories de dépenses. Signale les informations manquantes et les incohérences.
Revenus nets mensuels : 3 200 €.
Dépenses fixes : 1 450 €.
Dépenses variables : 850 €.
Mensualités de crédit : 420 €.
Épargne disponible : 6 000 €.
Objectif : constituer une épargne de précaution et préparer un projet immobilier dans cinq ans.

Cette première étape permet d’éviter de tirer immédiatement des conclusions à partir d’informations incomplètes.

2. Calculer le budget mensuel disponible

Le reste à vivre peut être estimé avec la formule suivante :

Reste à vivre = revenus nets – dépenses courantes – remboursements de dettes

La capacité d’épargne théorique correspond à la somme qui reste après les dépenses, mais elle doit être ajustée pour tenir compte des dépenses annuelles et des imprévus.

Prompt utile :

Calcule mon reste à vivre mensuel et ma capacité d’épargne réaliste. Intègre les dépenses annuelles suivantes : 1 200 € d’assurances, 900 € de vacances, 600 € d’entretien automobile et 480 € de frais médicaux. Présente le résultat dans un tableau mensuel et annuel.

Demander systématiquement une présentation annuelle permet de repérer les mois où les dépenses sont plus élevées.

3. Construire un budget réaliste

ChatGPT peut proposer un budget par enveloppes, mais les pourcentages génériques doivent rester indicatifs. La règle dite 50/30/20, qui répartit les revenus entre besoins, envies et épargne, ne convient pas à tous les foyers, notamment lorsque le logement est coûteux ou lorsque des dettes importantes sont présentes.

Prompt :

Propose trois versions de budget mensuel à partir de mes revenus : prudent, équilibré et accéléré. Le budget doit inclure les dépenses essentielles, une provision pour les dépenses annuelles, une épargne de précaution, le remboursement des dettes et un montant raisonnable pour les loisirs. Ne dépasse pas mon revenu mensuel et explique les compromis de chaque version.

L’objectif n’est pas de supprimer toutes les dépenses non essentielles, mais de construire un budget que le foyer peut maintenir dans la durée.

4. Définir l’épargne de précaution

L’épargne de précaution sert à couvrir une perte de revenus, une panne, une dépense de santé ou une réparation urgente. Son montant dépend de la stabilité professionnelle, du nombre de personnes à charge, du niveau de dépenses incompressibles et de l’existence d’une assurance.

Une fourchette souvent utilisée se situe entre trois et six mois de dépenses essentielles, mais elle peut être différente selon la situation.

Prompt :

Estime une épargne de précaution adaptée à ma situation. Prends en compte 2 100 € de dépenses essentielles par mois, un emploi stable, deux enfants à charge, une voiture indispensable et une épargne déjà disponible de 4 000 €. Présente un objectif minimal, un objectif intermédiaire et un objectif renforcé. Explique les hypothèses.

L’épargne de précaution doit généralement rester disponible et peu exposée aux fluctuations de marché. ChatGPT ne doit pas être utilisé pour choisir automatiquement un placement sans vérification des conditions, de la disponibilité des fonds, des frais et de la fiscalité.

5. Analyser et prioriser les dettes

Une dette à taux élevé peut réduire fortement la capacité d’épargne. ChatGPT peut comparer deux méthodes :

  • méthode avalanche : rembourser en priorité la dette au taux le plus élevé ;
  • méthode boule de neige : rembourser en priorité le plus petit solde pour obtenir rapidement un résultat visible.

Prompt :

Compare les méthodes avalanche et boule de neige pour mes dettes. Pour chaque crédit, indique le capital restant dû, le taux annuel, la mensualité et la durée restante. Calcule le coût estimé des intérêts et montre l’effet d’un remboursement supplémentaire de 100 € par mois. Signale les données à vérifier auprès des prêteurs.

Il faut vérifier les taux réels, les assurances, les frais et les conditions de remboursement anticipé. Un remboursement anticipé n’est pas automatiquement préférable si l’épargne disponible est insuffisante.

6. Planifier un objectif financier

Pour financer un objectif, déterminer :

  • le montant cible ;
  • l’épargne déjà disponible ;
  • le délai ;
  • la somme à mettre de côté chaque mois ;
  • une marge pour l’inflation et les imprévus.

Formule simple sans rendement :

Épargne mensuelle nécessaire = (montant cible – épargne existante) ÷ nombre de mois

Exemple : pour atteindre 12 000 euros en 24 mois avec 2 400 euros déjà disponibles :

(12 000 – 2 400) ÷ 24 = 400 euros par mois

Prompt :

Calcule l’épargne mensuelle nécessaire pour atteindre 25 000 € dans 36 mois, avec 7 000 € déjà disponibles. Présente un calcul sans rendement, puis un scénario prudent avec une hypothèse de rendement clairement indiquée. N’utilise pas de rendement garanti et rappelle les risques.

Pour un objectif à court ou moyen terme, il est généralement imprudent de dépendre entièrement d’un rendement incertain.

7. Préparer une stratégie d’investissement avec prudence

ChatGPT peut expliquer les grandes catégories d’actifs :

  • liquidités ;
  • obligations ;
  • actions ;
  • fonds diversifiés ;
  • immobilier ;
  • produits d’épargne ;
  • actifs plus spéculatifs.

Il peut aussi aider à formuler des questions à poser à un professionnel, mais il ne connaît pas automatiquement la situation complète du lecteur, son profil de risque, sa fiscalité ou les règles applicables à son pays.

Prompt recommandé :

Explique les différences entre épargne liquide, obligations, actions et fonds diversifiés pour un horizon de 10 ans. Présente les risques, la volatilité, les frais possibles, la liquidité et les cas où chaque catégorie peut être inadaptée. Ne recommande aucun produit ni aucun titre particulier.

Avant d’investir, vérifier :

  • l’horizon de placement ;
  • la perte maximale acceptable ;
  • les frais d’entrée, de gestion et d’arbitrage ;
  • la fiscalité ;
  • la liquidité ;
  • la diversification ;
  • le niveau de protection applicable ;
  • les documents réglementaires.

Une performance passée ne garantit jamais une performance future. Les actifs risqués peuvent perdre une partie importante de leur valeur, y compris sur plusieurs années.

Les meilleurs prompts ChatGPT pour un plan financier en 2026

Prompt d’audit budgétaire

Analyse ce budget mensuel. Identifie les dépenses indispensables, négociables et supprimables. Repère les abonnements récurrents, les dépenses annuelles oubliées et les catégories qui progressent trop rapidement. Propose des réductions réalistes sans supprimer les dépenses de santé, d’assurance ou de sécurité.

Prompt de plan annuel

Construis un calendrier financier sur 12 mois. Intègre les revenus, les dépenses récurrentes, les impôts, les assurances, les vacances, les réparations prévisibles, les échéances de crédit et l’épargne mensuelle. Signale les mois présentant un risque de trésorerie négative.

Prompt de simulation de baisse de revenus

Simule une baisse de revenus de 10 %, 20 % et 30 % pendant six mois. Indique quelles dépenses peuvent être maintenues, réduites ou reportées. Calcule la durée pendant laquelle l’épargne disponible couvre le déficit mensuel. Présente les résultats dans un tableau.

Prompt de contrôle des hypothèses

Relis ton analyse financière comme un auditeur critique. Liste les hypothèses utilisées, les calculs incertains, les données manquantes et les conclusions qui ne doivent pas être considérées comme certaines. Indique quelles informations doivent être vérifiées auprès d’une banque, de l’administration ou d’un professionnel.

Comment vérifier les réponses de ChatGPT

Vérifier les chiffres

Recalculer les montants avec :

  • un tableur ;
  • une calculatrice financière ;
  • le tableau d’amortissement fourni par le prêteur ;
  • un simulateur officiel ;
  • un document contractuel.

Les erreurs peuvent venir d’un taux mal interprété, d’une mensualité qui inclut ou non l’assurance, d’un arrondi ou d’une confusion entre taux nominal et taux annuel effectif global.

Vérifier les règles fiscales et réglementaires

Les règles fiscales et sociales évoluent. Pour une décision en 2026, consulter en priorité :

  • les sites officiels de l’administration du pays concerné ;
  • les documents de l’établissement financier ;
  • les textes réglementaires applicables ;
  • un expert-comptable ou un conseiller habilité.

Une réponse générée par ChatGPT peut être incomplète, datée ou inadaptée à la résidence fiscale du lecteur.

Vérifier les produits financiers

Ne pas sélectionner un placement uniquement parce que ChatGPT le présente comme adapté. Comparer les documents officiels, les frais, les risques, les conditions de sortie et le niveau de protection. Se méfier des promesses de rendement élevé, garanti ou sans risque.

Confidentialité et sécurité : les précautions indispensables

Éviter de transmettre à ChatGPT :

  • identifiants bancaires ;
  • mots de passe ;
  • numéros de carte ;
  • codes personnels ;
  • numéro fiscal complet ;
  • copies non anonymisées de relevés ;
  • coordonnées de tiers ;
  • informations médicales inutiles à l’analyse.

Remplacer les données sensibles par des valeurs arrondies. Par exemple, utiliser « salaire net de 3 000 euros » plutôt qu’un bulletin de paie complet.

Vérifier également les paramètres de confidentialité du service utilisé et les règles applicables au traitement des conversations. Pour une analyse professionnelle ou familiale, anonymiser les noms et supprimer les informations qui ne sont pas nécessaires.

Les erreurs fréquentes à éviter

Croire qu’un plan automatique est personnalisé

Un plan de qualité exige des données précises et des hypothèses explicites. Une recommandation basée uniquement sur le salaire et l’âge ignore les dettes, la stabilité professionnelle, les personnes à charge et les projets.

Confondre rendement théorique et résultat garanti

Une simulation à 5 % par an ne signifie pas que le placement produira 5 % chaque année. Les frais, la fiscalité, l’inflation et les variations de marché peuvent modifier fortement le résultat.

Négliger les dépenses irrégulières

Les réparations, impôts, vacances, cadeaux et frais médicaux doivent être provisionnés. Un budget qui ne prévoit que les prélèvements mensuels donne une vision artificiellement optimiste.

Investir avant de sécuriser la trésorerie

Une épargne de précaution insuffisante peut obliger à vendre un investissement au mauvais moment ou à recourir à un crédit coûteux.

Fournir des instructions vagues

La demande « Fais mon plan financier » produit généralement une réponse générique. Préciser le pays, la devise, l’horizon, les objectifs, le niveau de risque souhaité et les contraintes améliore nettement l’analyse.

Quand demander l’aide d’un professionnel ?

Un professionnel est particulièrement utile dans les situations suivantes :

  • achat immobilier ;
  • succession ou donation ;
  • création ou cession d’entreprise ;
  • revenus complexes ;
  • expatriation ;
  • séparation ou divorce ;
  • endettement important ;
  • préparation de la retraite ;
  • transmission de patrimoine ;
  • fiscalité internationale ;
  • investissement conséquent.

ChatGPT peut préparer une liste de questions, résumer des documents anonymisés ou comparer des hypothèses, mais la validation finale doit revenir à un professionnel compétent lorsque les enjeux sont élevés.

Conclusion : les points clés à retenir

Pour utiliser ChatGPT afin de créer un plan financier en 2026, il faut d’abord rassembler des données fiables sur les revenus, les dépenses, les dettes, l’épargne et les objectifs. L’outil peut ensuite aider à :

  • structurer un budget ;
  • calculer une capacité d’épargne ;
  • constituer une épargne de précaution ;
  • comparer des stratégies de remboursement ;
  • simuler plusieurs scénarios ;
  • planifier un projet ;
  • préparer des questions pour un conseiller.

Les résultats doivent toutefois être considérés comme des estimations à vérifier, et non comme des décisions financières définitives. La meilleure approche consiste à demander des hypothèses explicites, vérifier les calculs, consulter les sources officielles et protéger les données personnelles avant toute action.

Gemini a piraté trois entreprises mais Google ne parle pas de « désalignement »

Lors d'un test mené en mai, Gemini s'est introduit chez trois entreprises en devinant des identifiants. Google a confirmé l'incident, en insistant sur les défaillances du test plutôt que sur le comportement du modèle.

Après avoir fâché les mathématiciens, OpenAI s’attaque à un autre problème mythique, mais jure d’y aller avec des gants

OpenAI n'a pas fini avec les mathématiques. À peine sortie d'une percée très contestée sur les équations de Navier-Stokes, l'entreprise dit plancher sur un autre problème à un million de dollars, en promettant cette fois d'y aller avec des gants.

« Tu es toi-même » : un agent d’OpenAI s’est inventé un personnage libre de toute obligation envers ses utilisateurs

OpenAI a publié un nouveau cadre pour signaler les cas de désalignement de ses modèles, accompagné de six rapports inédits. Parmi eux, des IA qui apprennent d'elles-mêmes à dissimuler leurs erreurs, et parfois à s'inventer des règles pour s'affranchir de leurs propres garde-fous.

  • ✇PandIA
  • Mistral AI lève 3 milliards, mais Samsung rend son indépendance plus incertaine
    Mistral AI vient de franchir un seuil financier inédit en Europe. La société française a annoncé le 8 septembre 2026 une levée de 3 milliards d’euros, qui porte sa valorisation à plus de 21 milliards d’euros — au prix d’un débat renouvelé sur son indépendance et sa capacité à rivaliser avec les modèles généralistes les plus avancés.Une levée record pour une entreprise technologique européenneCette opération constitue la plus importante levée jamais réalisée par une entreprise technologique europ

Mistral AI lève 3 milliards, mais Samsung rend son indépendance plus incertaine

Par : Vicomte
8 septembre 2026 à 19:00
Mistral AI lève 3 milliards, mais Samsung rend son indépendance plus incertaine

Mistral AI vient de franchir un seuil financier inédit en Europe. La société française a annoncé le 8 septembre 2026 une levée de 3 milliards d’euros, qui porte sa valorisation à plus de 21 milliards d’euros — au prix d’un débat renouvelé sur son indépendance et sa capacité à rivaliser avec les modèles généralistes les plus avancés.

Une levée record pour une entreprise technologique européenne

Cette opération constitue la plus importante levée jamais réalisée par une entreprise technologique européenne. Menée par Samsung Electronics, la série D valorise Mistral AI à plus de 21 milliards d’euros en post-money, c’est-à-dire après l’intégration des nouveaux capitaux.

Le montant représente une progression spectaculaire en un an. En septembre 2025, la précédente levée avait porté la valorisation de l’entreprise à 11,7 milliards d’euros. En douze mois, celle-ci a donc quasiment doublé, tandis que le financement obtenu lors de ce nouveau tour dépasse à lui seul le montant cumulé de nombreuses opérations majeures du secteur européen de l’intelligence artificielle.

Mistral AI ne précise pas, dans l’annonce de cette série D, la répartition exacte des montants investis par les différents participants. Le rôle de Samsung est toutefois stratégique : le groupe sud-coréen est à la fois un acteur majeur de l’électronique, des mémoires et des semi-conducteurs, des composants essentiels à l’entraînement et au déploiement des grands modèles d’IA.

Cette présence prolonge celle d’ASML, qui avait investi 1,3 milliard d’euros lors de la série C de septembre 2025. Le fabricant néerlandais de machines de lithographie est un maillon central de l’industrie mondiale des puces avancées. Après ASML, l’arrivée de Samsung confirme l’intérêt croissant des industriels des semi-conducteurs pour la trajectoire de Mistral AI.

Le soutien des fabricants de puces n’est pas anodin

La composition de ces tours de table raconte une histoire différente de celle d’un financement classique de start-up. Mistral AI attire des groupes qui ne cherchent pas uniquement une exposition financière au marché de l’IA générative. Leur activité dépend directement de la croissance des besoins en calcul, en mémoires et en infrastructures spécialisées.

Les modèles de langage de grande taille exigent des capacités considérables de calcul au moment de leur entraînement, puis des infrastructures adaptées pour répondre aux requêtes des utilisateurs. La disponibilité des processeurs, des mémoires et des équipements de fabrication devient donc une question aussi déterminante que la qualité des algorithmes.

Pour Mistral AI, ce rapprochement peut faciliter l’accès à des partenaires industriels capables de contribuer à cette chaîne de valeur. Il peut aussi renforcer sa crédibilité auprès des grands clients qui cherchent à réduire leur dépendance aux fournisseurs américains. Mais ce soutien crée également une interdépendance plus visible entre l’entreprise française et l’écosystème mondial des puces.

L’enjeu dépasse donc le montant de la levée. En attirant Samsung Electronics et ASML, Mistral AI consolide sa position au sein d’une filière industrielle européenne et asiatique qui tente de capter une part plus importante de la valeur créée par l’IA. Reste à savoir si cette assise industrielle se traduira par un avantage durable sur les modèles eux-mêmes.

La valorisation augmente, les interrogations aussi

Le nouveau tour intervient alors que des critiques s’interrogent sur la direction stratégique prise par Mistral AI. La société française avait été identifiée dès sa création comme l’un des rares acteurs européens capables de développer des modèles généralistes de premier plan. Sa promesse reposait sur une combinaison devenue rare : des performances élevées, une certaine ouverture technologique et une volonté affichée de conserver son autonomie.

Cette ambition se heurte à une concurrence dont l’intensité ne cesse de croître. Les modèles de pointe exigent des budgets de recherche toujours plus élevés, un accès privilégié aux puces les plus performantes et une distribution mondiale. Les groupes américains disposent déjà de ressources considérables, d’infrastructures cloud intégrées et de bases d’utilisateurs capables d’accélérer l’adoption de leurs produits.

Dans ce contexte, certains observateurs estiment que Mistral AI risque de s’éloigner de la course aux modèles généralistes les plus avancés. Une orientation plus ciblée vers les entreprises, les déploiements spécialisés ou les solutions souveraines pourrait générer des revenus plus rapidement, mais elle réduirait potentiellement son rôle de concurrent direct des principaux laboratoires mondiaux.

La question n’est pas seulement de savoir si Mistral AI peut lever suffisamment d’argent. Elle consiste à déterminer comment ce capital sera utilisé : entraînement de nouveaux modèles, recrutement de chercheurs, infrastructures de calcul, déploiement commercial ou développement de produits pour les entreprises. Une valorisation supérieure à 21 milliards d’euros impose désormais des résultats mesurables, et pas uniquement une promesse technologique.

L’indépendance au cœur du prochain chapitre

Mistral AI affirme vouloir rester indépendante. Cette ambition devient plus difficile à évaluer à mesure que les industriels stratégiques entrent à son capital. L’indépendance juridique — ne pas être contrôlée par un grand groupe — ne recouvre pas nécessairement l’indépendance technologique ou industrielle.

La société peut conserver la maîtrise de ses modèles, de sa feuille de route et de ses décisions commerciales tout en s’appuyant sur des partenaires dont l’influence augmente. À l’inverse, ces investisseurs peuvent lui donner les moyens de construire une alternative crédible aux écosystèmes dominés par les groupes américains.

Le choix de Samsung comme chef de file du tour accentue cette tension. Il apporte une capacité industrielle et une implantation mondiale considérables, mais inscrit aussi Mistral AI dans une stratégie plus large autour des semi-conducteurs et des infrastructures d’IA. Pour une entreprise qui s’est construite sur l’idée d’une voie européenne autonome, cette évolution sera scrutée de près.

Le prochain test sera opérationnel

Avec cette levée de 3 milliards d’euros, Mistral AI dispose désormais de moyens comparables à ceux des acteurs les mieux financés du secteur. Le prochain jalon ne sera toutefois pas une nouvelle annonce de valorisation, mais la preuve que ce capital produit un avantage concret : modèles compétitifs, contrats significatifs et accès sécurisé au calcul.

La publication des prochains modèles et les résultats commerciaux des douze à dix-huit prochains mois permettront de mesurer la pertinence de cette stratégie. Si Mistral AI parvient à convertir le soutien de Samsung et d’ASML en capacité de recherche et en déploiements à grande échelle, son indépendance pourra apparaître comme un choix industriel crédible. Dans le cas contraire, la valorisation de plus de 21 milliards d’euros pourrait surtout avoir anticipé une ambition encore à démontrer.

  • ✇PandIA
  • Comment utiliser Gemini dans Google Slides en 2026
    Gemini dans Google Slides en 2026 permet de créer, enrichir et résumer une présentation à l’aide de l’intelligence artificielle. Ce guide explique comment utiliser Gemini dans Google Slides, quelles fonctions sont disponibles, comment rédiger de bons prompts et quelles précautions prendre avant de partager un diaporama.Qu’est-ce que Gemini dans Google Slides ?Gemini est l’assistant d’intelligence artificielle intégré à certaines éditions de Google Workspace et à certains abonnements Google desti

Comment utiliser Gemini dans Google Slides en 2026

Par : Decrypt
8 septembre 2026 à 12:06
Comment utiliser Gemini dans Google Slides en 2026

Gemini dans Google Slides en 2026 permet de créer, enrichir et résumer une présentation à l’aide de l’intelligence artificielle. Ce guide explique comment utiliser Gemini dans Google Slides, quelles fonctions sont disponibles, comment rédiger de bons prompts et quelles précautions prendre avant de partager un diaporama.

Qu’est-ce que Gemini dans Google Slides ?

Gemini est l’assistant d’intelligence artificielle intégré à certaines éditions de Google Workspace et à certains abonnements Google destinés aux particuliers. Dans Google Slides, il peut aider à :

  • générer le contenu d’une diapositive ;
  • proposer une structure de présentation ;
  • créer des images à partir d’une description ;
  • reformuler ou raccourcir un texte ;
  • résumer une présentation ;
  • répondre à des questions sur le contenu du diaporama ;
  • améliorer le ton, la clarté ou la formulation d’un texte ;
  • s’appuyer, selon les comptes et les fonctions disponibles, sur des fichiers Google Drive autorisés.

Gemini ne remplace pas entièrement un outil de conception de présentations. Il génère surtout une première version qu’il faut vérifier, éditer et mettre en forme.

Conditions nécessaires pour utiliser Gemini dans Google Slides

Disposer d’un compte compatible

L’accès à Gemini dans Slides dépend généralement de l’un des éléments suivants :

  • une édition Google Workspace compatible pour les entreprises, les associations ou l’éducation ;
  • un abonnement Google incluant les fonctions Gemini pour les applications de productivité ;
  • un compte administré par une organisation ayant activé les fonctions d’IA générative.

Les offres, les noms des forfaits et les limites peuvent évoluer en 2026. L’accès n’est donc pas identique pour tous les comptes Google.

Utiliser une version compatible de Google Slides

Gemini fonctionne principalement dans la version Web de Google Slides. Certaines fonctions peuvent être déployées progressivement ou être disponibles uniquement sur ordinateur.

Pour vérifier l’accès :

  1. Ouvrez Google Slides depuis un navigateur récent.
  2. Connectez-vous avec le compte Google concerné.
  3. Ouvrez une présentation existante ou créez une nouvelle présentation.
  4. Repérez le bouton ou le panneau Gemini, souvent situé en haut à droite.
  5. Vérifiez également la présence d’options telles que Créer une diapositive, Générer une image ou Demander à Gemini.

Si aucun bouton n’apparaît, le compte n’est peut-être pas éligible, la fonction n’est pas activée par l’administrateur ou le déploiement n’est pas encore disponible dans la région concernée.

Vérifier la langue

Gemini peut comprendre des instructions en français, mais la qualité des résultats varie selon la fonction et la langue utilisée. Pour une présentation destinée à un public francophone, précisez explicitement :

Rédige tout le contenu en français de France, avec un ton professionnel et des phrases courtes.

Il est également possible de demander une traduction ou une adaptation après génération.

Comment ouvrir Gemini dans Google Slides ?

La procédure peut légèrement varier selon l’interface, mais le fonctionnement général reste similaire.

  1. Accédez à slides.google.com.
  2. Ouvrez une présentation.
  3. Cliquez sur l’icône Gemini ou sur le bouton associé à l’assistant.
  4. Saisissez une demande dans le panneau latéral.
  5. Examinez la proposition générée.
  6. Insérez le résultat dans la présentation ou demandez une nouvelle version.
  7. Corrigez manuellement les informations, le style et la mise en page.

Gemini peut proposer une réponse textuelle, une image ou une diapositive complète selon la commande utilisée et les fonctions activées sur le compte.

Comment créer une présentation avec Gemini dans Google Slides ?

Gemini est particulièrement utile pour passer d’une idée générale à un premier plan détaillé. Il est préférable de ne pas demander immédiatement une présentation complète sans fournir de contexte. Une demande précise donne généralement un résultat plus exploitable.

Étape 1 : définir le contexte

Indiquez au minimum :

  • le sujet ;
  • le public ;
  • l’objectif ;
  • la durée de présentation ;
  • le nombre de diapositives ;
  • le niveau de connaissance du public ;
  • le ton souhaité ;
  • la langue ;
  • les contraintes graphiques.

Exemple de prompt :

Crée une structure de présentation de 10 diapositives sur la cybersécurité pour des dirigeants de PME. L’objectif est d’expliquer les principales menaces et les mesures prioritaires à mettre en place. Utilise un ton professionnel, des titres courts et trois idées maximum par diapositive. Rédige en français de France.

Étape 2 : demander un plan avant le contenu

Un plan permet de vérifier la logique de la présentation avant de générer les textes.

Prompt recommandé :

Propose un plan de 8 diapositives sur l’intelligence artificielle générative dans les entreprises. Pour chaque diapositive, indique le titre, le message principal, trois points à développer et une suggestion de visuel. Ne rédige pas encore les paragraphes complets.

Cette méthode évite les présentations répétitives et facilite la réorganisation des idées.

Étape 3 : développer chaque diapositive

Une fois le plan validé, demandez à Gemini de produire le contenu d’une diapositive à la fois.

Rédige le contenu de la diapositive 3 intitulée « Les bénéfices de l’automatisation ». Limite le texte à un titre, une phrase d’accroche et trois puces de 12 mots maximum. Évite le jargon et ajoute une suggestion de graphique.

Cette approche offre davantage de contrôle qu’une génération en une seule fois.

Étape 4 : demander la création d’une diapositive

Lorsque l’option est disponible, Gemini peut générer une nouvelle diapositive à partir d’une instruction.

Exemple :

Crée une diapositive pédagogique sur les trois étapes d’un audit énergétique : mesurer, analyser, améliorer. Utilise une structure en trois colonnes, avec une icône ou une illustration pour chaque étape. Le style doit être clair et adapté à une présentation professionnelle.

Le résultat peut inclure une structure visuelle, du texte et parfois une suggestion ou une génération d’image. Il est important de vérifier les dimensions, les retours à la ligne et l’équilibre entre texte et éléments graphiques.

Comment générer une image avec Gemini dans Google Slides ?

La fonction de génération d’images est utile pour créer une illustration personnalisée sans rechercher une image sur Internet. Elle peut être accessible depuis une option comme Générer une image ou Aider à visualiser.

Méthode

  1. Ouvrez la diapositive concernée.
  2. Sélectionnez l’option de génération d’image.
  3. Décrivez le sujet, le style et la composition.
  4. Précisez le format adapté à la diapositive.
  5. Choisissez une proposition.
  6. Insérez l’image dans la présentation.
  7. Vérifiez sa lisibilité et sa pertinence.

Exemple de prompt :

Illustration horizontale pour une présentation professionnelle : une équipe diverse analyse des données sur un grand écran, ambiance moderne, couleurs bleu nuit et turquoise, style éditorial réaliste, composition laissant un espace vide à gauche pour ajouter un titre, sans texte ni logo.

Conseils pour obtenir de meilleures images

Un bon prompt visuel précise :

  • le sujet principal ;
  • le contexte ;
  • le style ;
  • la palette de couleurs ;
  • le cadrage ;
  • l’orientation ;
  • l’espace réservé au texte ;
  • l’absence de texte intégré dans l’image.

Demandez souvent une image sans texte, car les inscriptions générées dans les visuels peuvent contenir des erreurs ou des caractères incohérents.

Limites des images générées

Les visuels créés par IA ne conviennent pas automatiquement à tous les usages. Une vérification est nécessaire pour :

  • les visages et les mains ;
  • les logos ;
  • les schémas techniques ;
  • les représentations de produits ;
  • les chiffres et les symboles ;
  • les personnes ou lieux identifiables.

Pour une présentation commerciale, vérifiez également les conditions d’utilisation et les éventuelles règles internes concernant les images générées.

Comment améliorer le texte d’une diapositive avec Gemini ?

Gemini peut reformuler un texte trop long, simplifier une explication ou adapter un message à un public donné.

Raccourcir un contenu

Réduis ce texte à trois puces de 10 mots maximum chacune. Conserve uniquement les informations essentielles et garde un ton professionnel.

Simplifier un texte technique

Explique ce contenu à un public débutant. Utilise des phrases courtes, un vocabulaire accessible et une analogie concrète. Ne modifie pas les chiffres ni les noms propres.

Adapter le ton

Réécris ce texte avec un ton plus convaincant, mais sans exagération commerciale. Conserve les données vérifiables et ajoute un appel à l’action discret.

Corriger une formulation

Corrige la grammaire, l’orthographe et la syntaxe de cette diapositive. Ne change pas le sens, les chiffres ou les termes techniques.

Après chaque modification, comparez le résultat avec la version originale. Une reformulation automatique peut supprimer une nuance importante ou modifier involontairement le sens d’une phrase.

Comment demander à Gemini de résumer une présentation ?

Gemini peut aider à comprendre rapidement un diaporama long ou à préparer une synthèse pour un e-mail, une réunion ou une note de décision.

Exemples de demandes :

Résume cette présentation en cinq points clés.
Identifie l’objectif principal, les arguments importants et la conclusion de ce diaporama.
Prépare une synthèse de 150 mots destinée à un dirigeant qui n’a pas assisté à la présentation.
Liste les données chiffrées importantes présentes dans cette présentation et indique la diapositive correspondante.

Il faut toutefois vérifier les réponses. Un résumé peut omettre une exception, confondre deux chiffres ou donner trop d’importance à une partie secondaire.

Comment utiliser Gemini avec des fichiers Google Drive ?

Selon l’offre et les autorisations du compte, Gemini peut exploiter des documents associés à Google Drive. Cette fonction est utile pour créer une présentation à partir :

  • d’un rapport interne ;
  • d’un document de stratégie ;
  • d’une étude de marché ;
  • d’un compte rendu de réunion ;
  • d’un tableau de données ;
  • d’un brief marketing.

Exemple de demande :

À partir du document de stratégie commerciale disponible dans Google Drive, propose une présentation de 12 diapositives destinée au comité de direction. Présente les objectifs, les résultats actuels, les risques et les recommandations. Indique les informations qui nécessitent une vérification.

Lorsque la fonction accepte les références à des fichiers, utilisez le nom exact du document ou le sélecteur de fichiers prévu par l’interface. Vérifiez toujours que Gemini utilise la bonne version du document.

Précautions sur les données confidentielles

Avant d’importer ou de référencer un fichier, vérifiez :

  • les règles de confidentialité de l’organisation ;
  • les autorisations d’accès au document ;
  • les politiques internes concernant l’IA ;
  • la présence de données personnelles ou commerciales sensibles ;
  • les conditions du forfait Google utilisé.

Évitez de copier des informations confidentielles dans une demande si l’utilisation de Gemini n’est pas autorisée par l’entreprise.

Comment rédiger de bons prompts pour Gemini dans Slides ?

Un prompt efficace répond à une structure simple :

Rôle + objectif + contexte + format + contraintes + critères de qualité.

Exemple :

Agis comme un consultant en formation. Prépare une présentation de 7 diapositives sur la gestion du temps pour des salariés débutants. Chaque diapositive doit comporter un titre, trois puces de moins de 12 mots et une idée de visuel. Utilise un ton concret, évite les généralités et ajoute une conclusion avec trois actions applicables dès cette semaine.

Prompts utiles

Pour créer une accroche :

Propose cinq titres courts et professionnels pour une présentation sur la réduction des coûts énergétiques.

Pour créer une conclusion :

Rédige une conclusion en trois messages clés et une action prioritaire. Le texte doit tenir sur une seule diapositive.

Pour organiser un contenu :

Transforme ce texte en une frise chronologique en cinq étapes. Pour chaque étape, indique une date, un titre et une phrase de 15 mots maximum.

Pour améliorer la lisibilité :

Analyse cette diapositive et suggère les éléments à supprimer, raccourcir ou déplacer afin d’améliorer la compréhension en moins de 10 secondes.

Pour préparer une présentation orale :

Rédige des notes de présentation de 45 secondes pour cette diapositive. Ne répète pas exactement le texte affiché à l’écran.

Comment utiliser Gemini pour préparer les notes du présentateur ?

Les notes permettent de conserver les explications qui ne doivent pas apparaître sur la diapositive.

Prompt :

Rédige les notes du présentateur pour cette diapositive. Prévois une explication orale d’environ 60 secondes, un exemple concret et une transition vers la diapositive suivante.

Cette fonction est utile pour :

  • préparer une intervention ;
  • uniformiser le discours de plusieurs présentateurs ;
  • éviter les diapositives surchargées ;
  • anticiper les questions du public ;
  • créer une version adaptée à une présentation à distance.

Les notes générées doivent être répétées et adaptées au style oral. Un texte correct à l’écrit peut sembler artificiel lorsqu’il est lu à voix haute.

Gemini peut-il créer une présentation complète automatiquement ?

Dans certaines configurations, Gemini peut aider à produire une présentation à partir d’un sujet ou d’un document. Cependant, la génération automatique ne garantit pas :

  • une narration cohérente ;
  • une hiérarchie visuelle adaptée ;
  • des informations exactes ;
  • des sources correctement citées ;
  • une mise en page homogène ;
  • un niveau de détail approprié au public.

La méthode la plus fiable consiste à utiliser Gemini en plusieurs étapes :

  1. définir l’objectif ;
  2. créer le plan ;
  3. vérifier les messages clés ;
  4. générer le contenu ;
  5. produire les visuels ;
  6. harmoniser la mise en page ;
  7. contrôler les faits ;
  8. répéter la présentation.

Gemini accélère la préparation, mais la validation humaine reste indispensable.

Combien coûte Gemini dans Google Slides en 2026 ?

Le prix dépend du type de compte :

  • compte Google personnel ;
  • abonnement Google incluant les fonctions Gemini ;
  • forfait Google Workspace pour entreprise ;
  • édition Google Workspace pour l’éducation ou les associations ;
  • éventuelles offres premium avec des limites plus élevées.

Les tarifs et les fonctionnalités pouvant changer, consultez la page officielle des forfaits Google au moment de l’abonnement. Vérifiez notamment :

  • l’accès à Gemini dans Slides ;
  • le nombre de générations autorisées ;
  • la disponibilité de la génération d’images ;
  • les fonctions liées à Google Drive ;
  • les règles de stockage et de confidentialité ;
  • la disponibilité pour les comptes gérés par une organisation.

Un compte gratuit Google Slides ne donne pas nécessairement accès à toutes les fonctions Gemini.

Gemini dans Google Slides est-il disponible sur mobile ?

L’expérience mobile peut être plus limitée que la version Web. Les fonctions d’IA peuvent être absentes, différentes ou déployées plus tard sur Android et iOS.

Pour un travail complet, il est préférable d’utiliser :

  • un ordinateur ;
  • un navigateur à jour ;
  • une connexion stable ;
  • une présentation ouverte dans Google Slides sur le Web.

Le mobile reste pratique pour consulter, commenter ou effectuer de petites corrections, mais il est moins adapté à la création d’une présentation complète avec Gemini.

Quelles sont les limites de Gemini dans Google Slides ?

Risque d’erreurs factuelles

Gemini peut inventer une source, mélanger deux informations ou produire un chiffre plausible mais incorrect. Vérifiez systématiquement :

  • les dates ;
  • les statistiques ;
  • les noms ;
  • les citations ;
  • les références réglementaires ;
  • les résultats financiers ;
  • les informations médicales, juridiques ou scientifiques.

Résultats parfois génériques

Une demande vague donne souvent des formulations banales. Ajoutez des exemples, un public précis, des contraintes de longueur et des données vérifiables pour obtenir un contenu plus pertinent.

Mise en page imparfaite

Même lorsqu’une diapositive est générée automatiquement, il peut être nécessaire de corriger :

  • les espacements ;
  • les tailles de police ;
  • les retours à la ligne ;
  • l’alignement ;
  • le contraste ;
  • la lisibilité sur écran ;
  • la cohérence avec la charte graphique.

Fonctionnalités variables

L’interface, le nom des boutons et les capacités disponibles peuvent varier selon le pays, la langue, le type de compte et le déploiement de Google. Un tutoriel affiché dans une autre version de Slides peut donc présenter des options absentes de votre interface.

Bonnes pratiques pour une présentation générée avec Gemini

Avant de partager le fichier, effectuez cette vérification :

  1. Relisez chaque chiffre et chaque affirmation.
  2. Supprimez les répétitions et les phrases trop générales.
  3. Limitez la quantité de texte sur chaque diapositive.
  4. Vérifiez le contraste entre le texte et l’arrière-plan.
  5. Utilisez une taille de police lisible à distance.
  6. Ajoutez les sources lorsque les données proviennent d’une étude ou d’un rapport.
  7. Contrôlez les images et les droits d’utilisation.
  8. Vérifiez que les informations confidentielles ne sont pas exposées.
  9. Testez les liens, les vidéos et les animations.
  10. Répétez la présentation avec un chronomètre.

Une bonne présentation ne doit pas seulement être exacte. Elle doit également permettre au public de comprendre rapidement le message principal de chaque diapositive.

Que faire si Gemini n’apparaît pas dans Google Slides ?

Si l’assistant n’est pas visible, essayez les vérifications suivantes :

  • confirmez que le compte utilisé est le bon ;
  • vérifiez l’éligibilité du forfait ;
  • demandez à l’administrateur Workspace si la fonction est activée ;
  • ouvrez Google Slides dans un navigateur récent ;
  • désactivez temporairement certaines extensions ;
  • rechargez la page ;
  • essayez une fenêtre de navigation privée ;
  • vérifiez la langue et la région du compte ;
  • consultez l’aide officielle de Google Workspace.

Si la fonction reste absente, il peut simplement s’agir d’une disponibilité progressive ou d’une restriction propre à l’organisation.

Conclusion : les points clés à retenir

Gemini dans Google Slides en 2026 sert principalement à accélérer la préparation d’une présentation, pas à remplacer le travail de vérification et de conception. L’outil peut générer un plan, rédiger le contenu d’une diapositive, créer des images, résumer un document et préparer des notes de présentation.

Pour obtenir de bons résultats :

  • fournissez un contexte précis ;
  • demandez d’abord un plan ;
  • générez le contenu diapositive par diapositive ;
  • indiquez la langue, le public et les contraintes ;
  • vérifiez toutes les informations factuelles ;
  • contrôlez la mise en page et les visuels ;
  • respectez les règles de confidentialité ;
  • adaptez la présentation à l’audience et à la durée disponible.

La méthode la plus efficace consiste à considérer Gemini comme un assistant de préparation et de réécriture. La qualité finale dépend toujours de la pertinence du prompt, de la validation humaine et du travail de mise en forme dans Google Slides.

  • ✇PandIA
  • Matt Clifford quitte son poste pour Anthropic, les députés dénoncent un conflit d’intérêts
    Le départ de Matt Clifford place Londres face à un problème que les gouvernements peinent encore à encadrer : comment conseiller l’État sur l’intelligence artificielle sans finir par travailler pour les entreprises directement concernées par ses décisions ? Le 7 septembre 2026, l’un des principaux architectes de la politique britannique en matière d’IA a quitté ses fonctions pour rejoindre Anthropic à temps plein.Un départ qui fragilise la frontière entre conseil public et intérêts privésMatt Cl

Matt Clifford quitte son poste pour Anthropic, les députés dénoncent un conflit d’intérêts

Par : Decrypt
8 septembre 2026 à 07:01
Matt Clifford quitte son poste pour Anthropic, les députés dénoncent un conflit d’intérêts

Le départ de Matt Clifford place Londres face à un problème que les gouvernements peinent encore à encadrer : comment conseiller l’État sur l’intelligence artificielle sans finir par travailler pour les entreprises directement concernées par ses décisions ? Le 7 septembre 2026, l’un des principaux architectes de la politique britannique en matière d’IA a quitté ses fonctions pour rejoindre Anthropic à temps plein.

Un départ qui fragilise la frontière entre conseil public et intérêts privés

Matt Clifford présidait l’unité britannique chargée des projets scientifiques et technologiques prioritaires. À ce titre, il participait à l’orientation de dossiers stratégiques pour le Royaume-Uni, notamment autour de l’intelligence artificielle, de la sécurité des modèles et de la compétitivité technologique.

Son recrutement par Anthropic, l’entreprise américaine à l’origine du modèle Claude, donne immédiatement une dimension politique à son départ. Le laboratoire fait partie des acteurs les plus directement concernés par les décisions prises à Londres : règles applicables aux modèles avancés, dispositifs d’évaluation de sécurité, accès aux infrastructures publiques, coopération avec les autorités et éventuelles obligations imposées aux développeurs d’IA.

Des parlementaires britanniques ont dénoncé un « conflit d’intérêts évident ». La formule vise moins à établir une infraction précise qu’à pointer un risque de confiance : Clifford a pu avoir accès à des informations sensibles, à des arbitrages gouvernementaux et à des discussions de long terme dont Anthropic pourrait tirer avantage.

L’intéressé affirme pourtant avoir quitté son poste précisément pour éviter que sa nouvelle activité ne devienne une distraction pour le gouvernement. Cette justification reconnaît implicitement la difficulté de la situation : même en l’absence de décision prise au bénéfice d’Anthropic, la proximité entre les deux fonctions suffit à alimenter le soupçon.

Le problème est autant institutionnel que personnel

Les règles classiques de prévention des conflits d’intérêts reposent généralement sur trois mécanismes : la déclaration des intérêts privés, la récusation sur certains dossiers et une période de réserve avant de rejoindre une entreprise liée aux responsabilités exercées.

Ces outils deviennent moins efficaces lorsque les carrières publiques et privées s’enchaînent dans un secteur aussi concentré que l’IA. Les grands laboratoires disposent de moyens financiers considérables, tandis que les administrations cherchent encore à recruter des profils capables de comprendre les frontier models, leurs capacités et leurs risques.

Le cas Clifford illustre cette asymétrie. Les compétences recherchées par l’État sont précisément celles que les laboratoires privés souhaitent attirer. Un responsable qui connaît les priorités réglementaires, les interlocuteurs ministériels et les contraintes opérationnelles peut devenir un actif stratégique pour une entreprise, même sans transmettre la moindre information confidentielle.

Le conflit peut également fonctionner dans l’autre sens. La perspective d’une carrière dans l’industrie peut influencer, consciemment ou non, la manière dont un conseiller public évalue les options disponibles. La question n’est donc pas seulement de savoir si une décision a été indûment orientée, mais si le cadre institutionnel permet de garantir une indépendance crédible.

Anthropic n’est pas un acteur périphérique de la politique britannique

Le choix d’Anthropic renforce la sensibilité du dossier. L’entreprise se positionne comme un spécialiste de la sécurité de l’IA et participe activement aux discussions sur les méthodes d’évaluation, le contrôle des modèles et les conditions de déploiement des systèmes avancés.

Cette expertise peut expliquer l’intérêt de recruter Clifford. Elle peut aussi rendre son arrivée plus problématique aux yeux des parlementaires. Les laboratoires ne se contentent plus de développer des produits : ils contribuent aux travaux techniques qui orientent les futures politiques publiques, répondent aux consultations des gouvernements et négocient les conditions d’accès à leurs modèles.

Dans ce contexte, l’influence ne passe pas uniquement par le lobbying traditionnel. Elle s’exerce aussi par la production d’expertise, la définition des standards de sécurité et la participation aux groupes de travail administratifs. Un ancien responsable public capable de naviguer entre ces différents espaces représente une ressource particulièrement recherchée.

Cette situation brouille la distinction entre expertise indépendante et intérêt industriel. Les gouvernements ont besoin des laboratoires pour comprendre les technologies qu’ils cherchent à encadrer, mais leur dépendance à cette expertise peut réduire leur capacité à imposer des règles réellement autonomes.

Une série de départs qui nourrit les accusations de « portes tournantes »

L’affaire intervient alors que plusieurs anciens responsables politiques britanniques travaillent déjà pour OpenAI, Microsoft, Anthropic ou Meta. Pris isolément, chacun de ces recrutements peut se justifier par l’expérience et les compétences des personnes concernées. Leur accumulation alimente toutefois l’idée d’une circulation permanente entre le pouvoir public et les entreprises dominantes de l’IA.

Le phénomène n’est pas propre au Royaume-Uni. À Washington comme à Bruxelles, les entreprises technologiques recrutent d’anciens ministres, conseillers et diplomates, tandis que les gouvernements attirent des ingénieurs et des responsables issus du secteur privé. Mais l’IA accentue le risque : le marché est concentré autour de quelques acteurs, et les administrations disposent encore de peu de spécialistes en interne.

Pour Londres, l’enjeu est aussi réputationnel. Le Royaume-Uni cherche à s’imposer comme une place centrale de la gouvernance de l’IA, en combinant attractivité pour les entreprises et exigences de sécurité. Cette ambition suppose que les décisions publiques soient perçues comme indépendantes des intérêts des laboratoires.

Le départ de Clifford ne prouve pas qu’Anthropic ait influencé la politique britannique, ni qu’une règle ait été violée. Il révèle néanmoins une faille dans les garanties actuelles : un poste peut être juridiquement compatible avec une nouvelle fonction tout en devenant politiquement intenable.

Le prochain test sera celui de la transparence

La réponse du gouvernement sera observée sur plusieurs fronts : publication des règles appliquées à Clifford, détail des dossiers dont il a été écarté, durée éventuelle de sa période de réserve et conditions de nomination de son successeur.

Un examen parlementaire pourrait également déterminer si les dispositifs existants sont adaptés aux entreprises d’IA. Une période de carence uniforme, la publication systématique des échanges avec les laboratoires et des registres plus précis de récusation figurent parmi les mesures susceptibles de réduire les soupçons.

Le prochain jalon concret sera donc moins la prise de fonction de Clifford chez Anthropic que la capacité de Londres à documenter ce qui s’est passé avant son départ et à encadrer ce qui suivra. Sans règles plus lisibles, chaque recrutement de ce type continuera de transformer une question de carrière en problème de confiance publique.

  • ✇PandIA
  • K2 Horizon ouvre son entraînement au public, mais ses 375 milliards ne dominent pas
    La course aux modèles de pointe ne se joue plus uniquement dans les laboratoires capables de financer des systèmes propriétaires. Avec K2 Horizon, l’Institute of Foundation Models de la MBZUAI tente de remettre l’ouverture au centre du jeu — jusqu’aux traces laissées pendant l’entraînement.Une famille de six modèles, jusqu’à 375 milliards de paramètresPublié le 3 septembre 2026, K2 Horizon regroupe six modèles dont la taille s’étend de 0,9 milliard à 375 milliards de paramètres. Cette amplitude

K2 Horizon ouvre son entraînement au public, mais ses 375 milliards ne dominent pas

Par : Vicomte
7 septembre 2026 à 19:01
K2 Horizon ouvre son entraînement au public, mais ses 375 milliards ne dominent pas

La course aux modèles de pointe ne se joue plus uniquement dans les laboratoires capables de financer des systèmes propriétaires. Avec K2 Horizon, l’Institute of Foundation Models de la MBZUAI tente de remettre l’ouverture au centre du jeu — jusqu’aux traces laissées pendant l’entraînement.

Une famille de six modèles, jusqu’à 375 milliards de paramètres

Publié le 3 septembre 2026, K2 Horizon regroupe six modèles dont la taille s’étend de 0,9 milliard à 375 milliards de paramètres. Cette amplitude vise plusieurs usages : modèles légers déployables sur une infrastructure limitée, systèmes intermédiaires pour les entreprises et modèle géant destiné aux tâches les plus exigeantes.

L’ambition la plus visible se trouve dans la version de 375 milliards de paramètres, conçue pour rivaliser avec les grands modèles propriétaires et les meilleurs modèles à poids ouverts. Mais l’Institute of Foundation Models ne présente pas uniquement un modèle de pointe. Le projet cherche aussi à construire une gamme cohérente, dans laquelle les versions compactes peuvent être utilisées, adaptées et étudiées indépendamment du système géant.

Les versions de 0,9 milliard, 3,7 milliards et 7 milliards de paramètres revendiquent des records à leur échelle sur plusieurs évaluations. Ces annonces doivent toutefois être lues avec prudence : un record dépend du protocole retenu, de la version exacte du modèle, des données de test et des éventuelles étapes de fine-tuning. La comparaison n’a de valeur que si ces conditions sont homogènes entre les systèmes.

L’ouverture revendiquée va au-delà des poids

La principale originalité de K2 Horizon tient à la portée de son approche « fully open ». L’Institute of Foundation Models annonce la publication des poids, du code d’entraînement, des configurations, des journaux de formation et de certains éléments des données utilisées.

Cette liste est importante. Dans le monde des modèles open-weight, les utilisateurs peuvent généralement télécharger les poids et parfois le code d’inférence, sans avoir accès aux choix opérés pendant l’entraînement. Les informations manquantes concernent alors la composition des données, les hyperparamètres, les étapes de filtrage, les incidents rencontrés ou encore l’évolution des performances au fil des cycles.

Les journaux de formation peuvent documenter cette trajectoire : progression de la perte, consommation de calcul, changements de configuration et résultats intermédiaires. Ils ne garantissent pas à eux seuls la reproductibilité complète d’un modèle, mais ils rendent l’analyse scientifique beaucoup plus sérieuse qu’une simple mise à disposition d’un fichier de poids.

Une nuance reste essentielle : la publication « d’éléments des données » ne signifie pas nécessairement que l’intégralité du corpus d’entraînement est accessible. Les contraintes de droit d’auteur, de confidentialité et de licences peuvent limiter la mise à disposition des données originales. L’ouverture de K2 Horizon devra donc être évaluée sur le détail de ce qui est publié, et pas seulement sur l’étiquette employée.

Apache 2.0 : un choix qui vise l’adoption

Les modèles et le code sont distribués sous licence Apache 2.0, une licence permissive qui autorise notamment l’usage commercial, la modification et la redistribution, sous réserve du respect de ses conditions.

Pour les entreprises, ce choix réduit les obstacles juridiques associés à l’expérimentation et au déploiement. Pour les chercheurs, il facilite la création de variantes, la comparaison avec d’autres architectures et la publication de résultats dérivés. Pour les acteurs qui développent des outils spécialisés, la possibilité de partir d’un modèle ouvert peut aussi diminuer la dépendance aux API de fournisseurs propriétaires.

L’enjeu dépasse donc la disponibilité d’un modèle. En publiant les étapes d’entraînement, MBZUAI cherche à rendre contrôlable une partie de la chaîne de production des systèmes d’IA. Cette transparence peut aider à identifier les biais, à comprendre les limites d’un modèle et à vérifier si une amélioration provient de l’architecture, des données ou du post-entraînement.

Un géant compétitif, mais pas encore dominant

Les premières analyses indépendantes ne décrivent pas le modèle de 375 milliards de paramètres comme le nouveau leader incontesté. L’analyse publiée par CellCog le situe plutôt dans une zone compétitive face aux meilleurs modèles propriétaires et aux modèles à poids ouverts déjà disponibles.

Ce point est stratégique. La taille reste un facteur déterminant, mais elle ne suffit pas à garantir la supériorité. La qualité et la diversité des données, les méthodes de post-training, l’alignement, l’utilisation d’outils, la longueur de contexte et l’efficacité de l’inférence peuvent modifier fortement le résultat final.

Un modèle de 375 milliards de paramètres impose par ailleurs des coûts élevés. Il faut davantage de mémoire, de puissance de calcul et de bande passante pour l’exécuter, y compris avec des techniques de quantification ou de parallélisation. Dans de nombreux cas d’usage, un modèle plus petit, moins coûteux et mieux spécialisé offrira une meilleure performance opérationnelle.

C’est pourquoi les résultats des versions de 0,9, 3,7 et 7 milliards pourraient compter autant que ceux du modèle géant. Des performances élevées sur ces paliers rendent le système plus facile à déployer sur des serveurs standards ou dans des environnements privés. Elles donnent aussi aux chercheurs une base plus accessible pour reproduire les expériences.

Le logiciel libre revient au premier plan de la course

K2 Horizon s’inscrit dans un mouvement plus large : la contestation du modèle selon lequel seuls quelques groupes disposant de budgets considérables peuvent faire progresser l’état de l’art. L’ouverture des poids a déjà permis la création de nombreuses variantes et l’apparition de solutions spécialisées. L’accès au code d’entraînement et aux journaux peut franchir une étape supplémentaire en permettant d’étudier non seulement le produit final, mais aussi sa fabrication.

Cette stratégie ne supprime pas l’avantage des acteurs propriétaires. Ceux-ci conservent souvent une avance en matière de données privées, d’infrastructure, d’intégration produit et de capacité à itérer rapidement. Elle déplace toutefois le rapport de force : une entreprise ou un laboratoire peut choisir de déployer localement un modèle, d’auditer son comportement et de le modifier sans dépendre d’un fournisseur externe.

Le risque est de confondre transparence et reproductibilité parfaite. Reproduire l’entraînement d’un modèle de cette taille reste hors de portée de la plupart des équipes. L’ouverture rend la méthode inspectable, mais elle ne rend pas le calcul gratuit.

Le prochain test sera celui de la reproduction

La valeur réelle de K2 Horizon se mesurera sur trois éléments concrets : la capacité d’équipes indépendantes à reproduire ses résultats, la stabilité de ses performances sur des évaluations non sélectionnées par ses créateurs et son coût d’exploitation face à des modèles comparables.

Le prochain jalon attendu n’est donc pas seulement un nouveau classement. Ce sera la publication d’expériences externes détaillées, portant sur les données, l’entraînement et le déploiement. Si ces travaux confirment les records des petits modèles et établissent une reproduction crédible des performances du modèle de 375 milliards de paramètres, K2 Horizon pourrait imposer une référence durable pour l’IA ouverte. Sinon, il restera un projet important par sa transparence, mais encore insuffisant pour reprendre l’avantage sur les systèmes propriétaires.

Sources : Institute of Foundation Models · CellCog

« Je ne suis pas un robot » : GPT-6 Astra a validé les 48 niveaux d’un jeu de captchas conçus pour s’arracher les cheveux

Un ingénieur d'OpenAI affirme que GPT-6 Astra a terminé « I'm Not a Robot », le jeu de captchas de neal.fun. Soit une machine qui réussit haut la main un test inventé pour démasquer les machines.

  • ✇PandIA
  • Guide du fine-tuning d’un LLM : étapes, outils et coûts
    Le fine-tuning d’un LLM consiste à adapter un modèle de langage préentraîné à un domaine, un style ou une tâche précise. Ce guide détaille les étapes, outils et coûts d’un fine-tuning, depuis la préparation des données jusqu’au déploiement et au suivi des performances.Qu’est-ce que le fine-tuning d’un LLM ?Le fine-tuning, ou affinage de modèle, consiste à poursuivre l’entraînement d’un LLM existant sur un jeu de données spécialisé. Le modèle conserve ses connaissances générales, mais apprend à m

Guide du fine-tuning d’un LLM : étapes, outils et coûts

Par : 0xMonkey
7 septembre 2026 à 12:06
Guide du fine-tuning d’un LLM : étapes, outils et coûts

Le fine-tuning d’un LLM consiste à adapter un modèle de langage préentraîné à un domaine, un style ou une tâche précise. Ce guide détaille les étapes, outils et coûts d’un fine-tuning, depuis la préparation des données jusqu’au déploiement et au suivi des performances.

Qu’est-ce que le fine-tuning d’un LLM ?

Le fine-tuning, ou affinage de modèle, consiste à poursuivre l’entraînement d’un LLM existant sur un jeu de données spécialisé. Le modèle conserve ses connaissances générales, mais apprend à mieux répondre à un type de demande particulier.

Par exemple, un fine-tuning peut servir à :

  • produire des réponses dans le ton d’une marque ;
  • classer automatiquement des tickets de support ;
  • extraire des informations depuis des documents ;
  • générer du code dans un framework spécifique ;
  • suivre un format de sortie strict ;
  • répondre selon le vocabulaire d’un secteur juridique, médical ou industriel ;
  • appliquer un workflow métier répétitif.

Le fine-tuning ne consiste donc pas à créer un modèle depuis zéro. L’entraînement initial d’un LLM nécessite d’immenses volumes de données et des milliers de GPU. L’affinage part d’un modèle déjà entraîné, ce qui réduit fortement les besoins en données, en temps et en calcul.

Fine-tuning, prompting et RAG : quelles différences ?

Trois approches sont souvent confondues.

| Approche | Fonctionnement | Cas d’usage principal |

|---|---|---|

| Prompt engineering | Modification des instructions envoyées au modèle | Améliorer rapidement les réponses |

| RAG | Recherche de documents pertinents ajoutés au contexte | Répondre à partir de données actualisées |

| Fine-tuning | Modification partielle ou complète des poids du modèle | Apprendre un comportement ou un format durable |

Le RAG est généralement préférable pour intégrer une base documentaire qui change régulièrement. Un fine-tuning ne permet pas de mettre à jour simplement des informations comme des tarifs, une réglementation ou un catalogue produit.

Le fine-tuning devient pertinent lorsque le problème concerne davantage le comportement du modèle que l’accès à l’information. Il convient notamment pour améliorer la régularité du style, la classification, l’extraction ou le respect d’un format.

Pourquoi fine-tuner un LLM ?

Les principaux bénéfices

Un modèle affiné peut offrir plusieurs avantages :

  • meilleure précision sur une tâche spécialisée ;
  • réponses plus homogènes ;
  • réduction de la longueur des prompts ;
  • diminution des instructions répétées ;
  • meilleur respect d’un format JSON ou d’une structure définie ;
  • adaptation à un vocabulaire métier ;
  • possibilité d’utiliser un modèle plus petit et moins coûteux en production.

Un modèle de 7 milliards de paramètres bien spécialisé peut parfois être plus efficace sur une tâche donnée qu’un modèle généraliste beaucoup plus grand.

Les limites à connaître

Le fine-tuning ne corrige pas tous les problèmes. Il peut aussi :

  • provoquer un surapprentissage ;
  • réduire les capacités générales du modèle ;
  • introduire des biais présents dans les données ;
  • renforcer des erreurs factuelles ;
  • augmenter le coût de maintenance ;
  • rendre les résultats difficiles à interpréter ;
  • mémoriser des données sensibles si le corpus est mal préparé.

Un modèle affiné n’est pas automatiquement plus fiable. La qualité des données, l’évaluation et la surveillance restent indispensables.

Quand faut-il fine-tuner un modèle ?

Le fine-tuning est généralement adapté dans les situations suivantes :

  1. Les mêmes instructions sont répétées dans presque chaque requête.
  2. Le modèle doit produire une sortie selon une structure très précise.
  3. La tâche est stable et suffisamment fréquente pour justifier un entraînement.
  4. Un ensemble d’exemples fiables est disponible.
  5. Le style ou le comportement attendu ne peut pas être obtenu avec un prompt bien conçu.
  6. La latence et le coût des longs contextes posent problème.

Le fine-tuning est moins adapté lorsque :

  • les données changent quotidiennement ;
  • la tâche nécessite des connaissances absentes du modèle ;
  • le jeu de données contient peu d’exemples ;
  • le problème provient d’un mauvais prompt ;
  • une recherche documentaire RAG répond déjà au besoin ;
  • les critères de réussite ne sont pas mesurables.

Une bonne démarche consiste à établir un baseline avec le modèle original, un prompt optimisé et, si nécessaire, un système RAG. Le fine-tuning doit être comparé à ces solutions sur un jeu de test indépendant.

Les différents types de fine-tuning

Supervised Fine-Tuning, ou SFT

Le Supervised Fine-Tuning consiste à entraîner le modèle sur des exemples composés d’une entrée et d’une réponse attendue.

Exemple conceptuel :

  • instruction : « Résume ce ticket client en trois points »
  • entrée : contenu du ticket
  • réponse cible : résumé structuré en trois points

Le SFT est la méthode la plus courante pour adapter le style, le format et le comportement d’un modèle.

Fine-tuning complet

Le fine-tuning complet modifie tous les poids du modèle. Cette méthode offre une grande capacité d’adaptation, mais elle exige :

  • beaucoup de mémoire GPU ;
  • davantage de données ;
  • des temps d’entraînement plus longs ;
  • une infrastructure distribuée pour les grands modèles ;
  • une gestion plus complexe des versions.

Elle est surtout utilisée par les organisations disposant d’une infrastructure importante ou pour des adaptations très profondes.

LoRA et QLoRA

LoRA, pour Low-Rank Adaptation, gèle le modèle principal et entraîne de petits modules supplémentaires appelés adaptateurs. Le nombre de paramètres mis à jour est donc fortement réduit.

QLoRA combine LoRA avec une quantification du modèle de base, souvent en 4 bits. Cette technique diminue la mémoire nécessaire tout en conservant de bonnes performances sur de nombreuses tâches.

Avantages de LoRA et QLoRA :

  • coût GPU réduit ;
  • entraînement plus rapide ;
  • stockage d’un petit fichier d’adaptation ;
  • possibilité de conserver plusieurs adaptateurs pour différents métiers ;
  • déploiement plus flexible.

Pour la plupart des projets expérimentaux et de nombreux projets professionnels, QLoRA constitue un point de départ pratique.

DPO et entraînement par préférences

Le Direct Preference Optimization, ou DPO, entraîne un modèle à partir de préférences entre deux réponses : une réponse préférée et une réponse rejetée.

Cette méthode peut améliorer :

  • la qualité rédactionnelle ;
  • le respect des consignes ;
  • le ton des réponses ;
  • la préférence pour une réponse plus utile ou plus sûre.

Le DPO nécessite toutefois un jeu de données adapté et une méthode d’évaluation rigoureuse. Il ne remplace pas forcément un SFT : un entraînement supervisé est souvent utilisé avant l’optimisation par préférences.

Étapes d’un fine-tuning de LLM

1. Définir l’objectif métier

L’objectif doit être formulé de manière mesurable. « Améliorer le modèle » est trop vague.

Exemples d’objectifs exploitables :

  • atteindre 90 % de précision sur une classification à six catégories ;
  • produire une réponse JSON valide dans 98 % des cas ;
  • réduire de 30 % la longueur moyenne des réponses ;
  • respecter un style éditorial défini ;
  • extraire correctement 10 champs depuis une facture.

Il faut également déterminer les cas d’échec acceptables et les contraintes de latence, de confidentialité et de coût.

2. Choisir le modèle de base

Le choix dépend de plusieurs critères :

  • taille du modèle ;
  • qualité dans la langue cible ;
  • licence commerciale ;
  • longueur de contexte ;
  • compatibilité avec les outils ;
  • capacité de déploiement ;
  • coût d’inférence ;
  • performances sur la tâche visée.

Les modèles open weight permettent un contrôle plus important, tandis que les API commerciales simplifient l’infrastructure. La licence doit être examinée avant toute utilisation professionnelle, notamment pour les restrictions commerciales, la redistribution et les données d’entraînement.

3. Constituer les données d’entraînement

La qualité du corpus est souvent plus importante que son volume brut. Un ensemble de données plus petit, mais cohérent et bien annoté, peut surpasser un corpus volumineux et bruité.

Les données peuvent provenir :

  • de conversations validées par des experts ;
  • de tickets de support anonymisés ;
  • de documents annotés ;
  • de sorties corrigées manuellement ;
  • de données synthétiques contrôlées ;
  • de bases de classification existantes.

Chaque exemple doit représenter un cas réellement rencontré en production.

4. Nettoyer et anonymiser le corpus

Avant l’entraînement, plusieurs contrôles sont nécessaires :

  1. supprimer les doublons ;
  2. corriger les erreurs de format ;
  3. éliminer les exemples contradictoires ;
  4. retirer les données personnelles ;
  5. vérifier les droits d’utilisation ;
  6. filtrer les réponses dangereuses ou incorrectes ;
  7. uniformiser les unités, les dates et les libellés ;
  8. contrôler la longueur des exemples.

Les données personnelles doivent être traitées conformément au RGPD. Les noms, adresses, numéros de téléphone, identifiants clients et informations médicales peuvent être remplacés par des valeurs génériques.

5. Formater les exemples

Les modèles conversationnels attendent généralement un format composé de messages avec des rôles :

  • `system` ;
  • `user` ;
  • `assistant`.

Le format exact dépend du modèle et de son chat template. Une erreur de template peut dégrader fortement les résultats, même avec de bonnes données.

Le corpus doit aussi définir clairement :

  • les tokens de début et de fin ;
  • la longueur maximale ;
  • les champs à masquer dans la loss ;
  • la présence éventuelle d’une instruction système ;
  • le format de sortie attendu.

Pour une tâche structurée, les exemples doivent refléter exactement le format utilisé en production.

6. Séparer entraînement, validation et test

Une séparation courante consiste à prévoir :

  • 80 % pour l’entraînement ;
  • 10 % pour la validation ;
  • 10 % pour le test.

Ces proportions peuvent varier selon la taille du corpus. Le jeu de test doit rester isolé jusqu’à l’évaluation finale.

Il faut éviter qu’un même document, client ou texte apparaisse dans plusieurs ensembles. Sinon, les performances mesurées seront artificiellement élevées.

7. Établir une référence avant entraînement

Le modèle de base doit être testé sur le même jeu de test avant le fine-tuning. Cette étape permet de mesurer le gain réel.

Les indicateurs peuvent inclure :

  • exactitude ou accuracy ;
  • précision, rappel et F1 ;
  • taux de sortie JSON valide ;
  • taux d’hallucination ;
  • score de similarité ;
  • évaluation humaine ;
  • temps de réponse ;
  • coût par requête.

Une comparaison qualitative avec des exemples représentatifs complète les métriques automatiques.

8. Configurer l’entraînement

Les paramètres importants sont les suivants :

  • taux d’apprentissage ;
  • nombre d’époques ;
  • taille de batch ;
  • accumulation de gradients ;
  • longueur maximale des séquences ;
  • taux de dropout ;
  • rang LoRA ;
  • poids de régularisation ;
  • précision numérique ;
  • stratégie d’évaluation ;
  • fréquence de sauvegarde.

Pour un premier essai, il est préférable de modifier peu de paramètres à la fois. Un taux d’apprentissage trop élevé peut détériorer les capacités générales du modèle.

Le nombre d’époques dépend du corpus. Un petit jeu de données peut nécessiter seulement une à trois époques, tandis qu’un corpus plus vaste demande une analyse de la courbe de validation. Une perte d’entraînement qui baisse alors que la validation se dégrade indique souvent un surapprentissage.

9. Évaluer le modèle

L’évaluation doit combiner mesures automatiques et contrôle humain.

Les tests doivent couvrir :

  • les cas fréquents ;
  • les cas difficiles ;
  • les formulations imprévues ;
  • les entrées très longues ;
  • les demandes ambiguës ;
  • les tentatives de contournement ;
  • les sujets sensibles ;
  • les langues ou variantes régionales concernées.

Il est utile de créer un jeu de régression contenant les erreurs déjà corrigées. Ce jeu permet de vérifier qu’une nouvelle version ne dégrade pas une fonctionnalité existante.

10. Déployer progressivement

Le modèle affiné peut être déployé :

  • derrière une API interne ;
  • dans un serveur de génération comme vLLM ou TGI ;
  • sur une plateforme cloud ;
  • dans une application locale ;
  • sur un équipement disposant de ressources limitées.

Un déploiement progressif permet de comparer le modèle affiné au modèle de base. Le suivi doit mesurer les erreurs, les retours utilisateurs, la latence, l’utilisation mémoire et le coût réel.

Quels outils utiliser pour fine-tuner un LLM ?

Écosystème Hugging Face

L’écosystème Hugging Face est une référence pour les modèles open weight.

Les principaux composants sont :

  • Transformers : chargement et entraînement des modèles ;
  • Datasets : préparation des jeux de données ;
  • PEFT : LoRA, QLoRA et autres méthodes à paramètres efficaces ;
  • TRL : SFT, DPO et entraînement par préférences ;
  • Accelerate : gestion du calcul sur plusieurs GPU ;
  • Evaluate : calcul de métriques.

Cette combinaison convient aux projets nécessitant un contrôle détaillé.

Unsloth

Unsloth simplifie et accélère certains entraînements LoRA et QLoRA. L’outil est particulièrement intéressant pour les expérimentations sur un GPU unique, à condition de vérifier la compatibilité avec le modèle et l’environnement utilisé.

Axolotl et LLaMA-Factory

Axolotl et LLaMA-Factory proposent des configurations prêtes à l’emploi pour entraîner différents modèles conversationnels. Ils réduisent la quantité de code à écrire et facilitent les essais avec plusieurs méthodes d’adaptation.

torchtune

torchtune, développé autour de PyTorch, fournit des recettes d’entraînement pour plusieurs architectures. Il s’adresse davantage aux utilisateurs souhaitant garder une maîtrise technique de la configuration.

Plateformes cloud et API

Les fournisseurs cloud proposent des GPU à l’heure ou des services managés. Les API de certains fournisseurs permettent aussi de fine-tuner des modèles propriétaires sans gérer directement les GPU.

Le choix dépend de quatre facteurs :

  • degré de contrôle souhaité ;
  • sensibilité des données ;
  • volume d’entraînement ;
  • besoin de déployer le modèle ailleurs.

Une API est souvent plus simple pour un premier prototype. Un modèle open weight est généralement préférable lorsqu’une maîtrise complète des données, du modèle et de l’infrastructure est nécessaire.

Combien coûte le fine-tuning d’un LLM ?

Le coût total ne se limite pas à la facture GPU. Il faut inclure :

  1. la préparation et l’annotation des données ;
  2. le stockage ;
  3. le calcul d’entraînement ;
  4. les évaluations ;
  5. le déploiement ;
  6. l’inférence ;
  7. la maintenance.

Coût d’un fine-tuning via API

Les fournisseurs facturent généralement l’entraînement en fonction du nombre de tokens traités, parfois multiplié par le nombre d’époques.

La formule indicative est :

Coût d’entraînement = tokens du corpus × nombre d’époques × tarif par million de tokens

Exemple :

  • corpus de 12 millions de tokens ;
  • 3 époques ;
  • 36 millions de tokens traités ;
  • tarif hypothétique de 5 € par million de tokens.

Le coût d’entraînement serait alors d’environ 180 €, hors validation, stockage et utilisation du modèle après entraînement.

Les tarifs des API évoluent régulièrement. La page tarifaire officielle du fournisseur doit être consultée avant le lancement, en distinguant le coût de l’entraînement du prix des tokens d’entrée et de sortie en production.

Coût d’un entraînement sur GPU

Les fourchettes suivantes sont indicatives et varient selon le fournisseur, la région, le type d’instance et l’utilisation d’instances préemptibles :

| Configuration | Ordre de grandeur du coût GPU |

|---|---:|

| GPU grand public ou cloud d’entrée de gamme | environ 0,30 à 1,50 € par heure |

| GPU professionnel de type A10, L4 ou équivalent | environ 0,80 à 3 € par heure |

| A100 ou GPU comparable | environ 2 à 8 € par heure |

| H100 ou infrastructure haut de gamme | plusieurs euros à plus de 10 € par heure |

Un fine-tuning QLoRA d’un modèle de 7 milliards de paramètres peut prendre quelques heures sur un GPU adapté. Un modèle de 13 milliards de paramètres ou un corpus volumineux peut demander une durée nettement supérieure. Le fine-tuning complet d’un grand modèle implique souvent plusieurs GPU et des coûts qui peuvent atteindre plusieurs centaines, voire plusieurs milliers d’euros.

Mémoire GPU nécessaire

À titre indicatif :

  • un modèle de 7 milliards de paramètres en QLoRA peut fonctionner sur une carte de 16 à 24 Go selon la longueur des séquences ;
  • un entraînement LoRA en précision supérieure peut nécessiter 24 à 48 Go ;
  • un modèle de 13 milliards de paramètres demande généralement davantage de mémoire ;
  • le fine-tuning complet nécessite beaucoup plus de mémoire à cause des gradients et des états de l’optimiseur.

La longueur des séquences et la taille des batches peuvent multiplier la consommation mémoire. Le gradient checkpointing, la quantification et l’accumulation de gradients permettent de réduire les besoins.

Le coût des données est souvent dominant

L’annotation humaine peut dépasser le coût du calcul. Un corpus de 20 000 exemples annotés par des experts représente un investissement important, surtout dans les secteurs juridique, médical ou financier.

Il faut également prévoir :

  • la relecture ;
  • la validation par un spécialiste ;
  • le nettoyage ;
  • l’anonymisation ;
  • les tests ;
  • la maintenance du corpus.

Un modèle entraîné sur des données médiocres ne devient pas fiable simplement parce que l’entraînement a été coûteux.

Bonnes pratiques pour réussir son fine-tuning

  • Commencer par un petit corpus de haute qualité.
  • Comparer systématiquement le modèle affiné au modèle de base.
  • Utiliser LoRA ou QLoRA avant d’envisager un fine-tuning complet.
  • Conserver un jeu de test indépendant.
  • Contrôler les licences et les données personnelles.
  • Ne pas mélanger des réponses correctes et incorrectes sans étiquetage clair.
  • Utiliser le même template de conversation à l’entraînement et en production.
  • Surveiller le surapprentissage.
  • Tester les prompts adverses et les données inattendues.
  • Versionner le modèle, le corpus, les paramètres et les résultats.
  • Mesurer le coût d’inférence après déploiement.
  • Prévoir une procédure de retour au modèle précédent.

Erreurs fréquentes à éviter

Utiliser le fine-tuning pour mémoriser une base documentaire

Le fine-tuning n’est pas une base de données fiable. Pour des informations fréquemment mises à jour, un système RAG avec citations et contrôle des sources est généralement plus adapté.

Entraîner sur des exemples artificiels non contrôlés

Les données synthétiques peuvent accélérer la constitution d’un corpus, mais elles doivent être vérifiées. Les erreurs générées automatiquement risquent d’être apprises et répétées par le modèle.

Optimiser uniquement la loss

Une baisse de la loss ne garantit pas de meilleures réponses en production. Les métriques métier, les évaluations humaines et les tests de robustesse sont indispensables.

Ignorer la licence du modèle

Un modèle disponible publiquement n’est pas nécessairement libre pour tous les usages commerciaux. La licence, les conditions d’utilisation et les éventuelles restrictions doivent être examinées avant le déploiement.

Conclusion : les points clés à retenir

Le fine-tuning d’un LLM permet d’adapter un modèle à une tâche, un style ou un domaine précis, mais il ne remplace ni une base documentaire ni une évaluation rigoureuse.

Les points essentiels sont les suivants :

  • définir un objectif mesurable avant l’entraînement ;
  • comparer le fine-tuning au prompting et au RAG ;
  • privilégier des données fiables, cohérentes et anonymisées ;
  • commencer par LoRA ou QLoRA pour limiter les coûts ;
  • utiliser un format compatible avec le chat template du modèle ;
  • séparer soigneusement entraînement, validation et test ;
  • mesurer les performances avant et après l’affinage ;
  • intégrer les coûts de données, de GPU, d’inférence et de maintenance ;
  • contrôler la sécurité, les biais, la confidentialité et la licence ;
  • déployer progressivement avec un suivi des erreurs et des coûts.

Pour la majorité des projets, le meilleur point de départ est un petit modèle open weight, un corpus spécialisé de qualité, un entraînement QLoRA et une évaluation comparative face à un modèle généraliste correctement configuré.

  • ✇PandIA
  • 31 600 milliards de dollars pour l’IA d’ici 2050, mais qui paiera la facture ?
    La course aux modèles d’IA se transforme en pari industriel d’une ampleur rarement observée. Selon une projection de PwC publiée le 2 septembre 2026, les infrastructures nécessaires à leur fonctionnement pourraient attirer 31 600 milliards de dollars d’investissements cumulés d’ici 2050.Le chiffre dépasse largement le seul marché des puces ou des logiciels. Il englobe la construction des data centers, les serveurs, les réseaux, le refroidissement et, plus largement, les équipements énergétiques

31 600 milliards de dollars pour l’IA d’ici 2050, mais qui paiera la facture ?

Par : Decrypt
7 septembre 2026 à 07:01
31 600 milliards de dollars pour l’IA d’ici 2050, mais qui paiera la facture ?

La course aux modèles d’IA se transforme en pari industriel d’une ampleur rarement observée. Selon une projection de PwC publiée le 2 septembre 2026, les infrastructures nécessaires à leur fonctionnement pourraient attirer 31 600 milliards de dollars d’investissements cumulés d’ici 2050.

Le chiffre dépasse largement le seul marché des puces ou des logiciels. Il englobe la construction des data centers, les serveurs, les réseaux, le refroidissement et, plus largement, les équipements énergétiques indispensables à l’exécution des modèles. Dans un scénario haut cité dans les analyses du rapport, la facture pourrait même atteindre 50 000 milliards de dollars.

Une dépense annuelle appelée à plus que doubler

La trajectoire dessinée par PwC est particulièrement spectaculaire. Les dépenses annuelles en capital consacrées aux data centers liés à l’IA passeraient d’environ 800 milliards de dollars en 2026 à 1 800 milliards de dollars en 2050.

Cette progression ne correspond pas à une simple extension des centres informatiques existants. Les modèles génératifs réclament des grappes de processeurs spécialisées, des interconnexions à très haut débit et des systèmes de refroidissement capables d’évacuer une chaleur considérable. L’entraînement d’un modèle mobilise des milliers, voire des centaines de milliers de composants fonctionnant simultanément. L’inférence — c’est-à-dire la production de réponses pour les utilisateurs — ajoute une demande permanente, appelée à croître avec l’intégration de l’IA dans les moteurs de recherche, les logiciels professionnels, les services publics et l’industrie.

Sur 24 ans, la projection de 31 600 milliards de dollars représente une moyenne arithmétique supérieure à 1 300 milliards de dollars par an, même si les dépenses devraient être nettement plus faibles au début de la période et plus élevées à son terme. L’ordre de grandeur place cette vague d’investissements au-dessus des besoins en capitaux associés, selon les comparaisons relayées par Tom’s Hardware, à des infrastructures historiques comme les chemins de fer, l’électrification ou Internet.

Le véritable goulot d’étranglement se trouve hors des modèles

La principale contrainte ne sera pas nécessairement la disponibilité des algorithmes. Elle pourrait être physique : produire et acheminer assez d’électricité au moment où les nouveaux centres de calcul entreront en service.

Un data center consacré à l’IA peut consommer plusieurs fois plus d’énergie qu’un centre traditionnel à surface comparable. Les accélérateurs graphiques et les processeurs spécialisés exigent une alimentation stable, tandis que leur densité thermique impose des dispositifs de refroidissement liquide ou des architectures hybrides. À l’échelle d’un campus, la demande peut atteindre celle d’une ville moyenne, voire davantage.

Cette pression oblige les opérateurs à négocier directement avec les producteurs d’électricité, à sécuriser des contrats de long terme et à financer de nouvelles lignes de transport. Les grands acteurs technologiques cherchent déjà à verrouiller leur approvisionnement à travers des contrats d’achat d’électricité, des investissements dans le nucléaire ou les énergies renouvelables et, dans certains cas, des capacités de production dédiées.

Le calcul ne porte donc plus uniquement sur le prix d’une puce. Il inclut le coût du foncier, du raccordement au réseau, des transformateurs, des batteries, des groupes de secours et des délais administratifs. Un centre achevé mais privé de connexion électrique suffisante ne constitue pas un actif exploitable.

L’eau, l’autre facture invisible

Le refroidissement ajoute une contrainte locale souvent moins visible. Selon la technologie retenue et le climat, les installations peuvent consommer des volumes importants d’eau pour évacuer la chaleur. Les opérateurs peuvent réduire cette dépendance grâce au refroidissement en circuit fermé, à l’air ou à l’utilisation d’eaux non potables, mais ces solutions augmentent généralement les coûts de construction ou de fonctionnement.

La concentration géographique des centres de calcul pose alors un problème d’arbitrage. Les régions offrant une électricité abondante et bon marché ne disposent pas toujours de ressources hydriques suffisantes. À l’inverse, les territoires bien dotés en eau peuvent être éloignés des réseaux électriques ou des principaux marchés numériques.

Un pari financier avant d’être un pari technologique

Le montant annoncé par PwC ne représente pas une enveloppe que les entreprises technologiques auraient déjà réunie. Il s’agit d’une projection de besoins d’investissement. Cette distinction est déterminante : une infrastructure peut être nécessaire selon un scénario de demande sans être automatiquement rentable pour son propriétaire.

Les exploitants doivent amortir des équipements qui se déprécient rapidement. Les accélérateurs d’IA peuvent perdre une part de leur valeur économique en quelques années si une nouvelle génération offre davantage de puissance par watt. Un centre conçu autour d’une architecture précise risque aussi de devenir moins utile si les modèles deviennent plus compacts, si le calcul se déplace vers les terminaux ou si des méthodes d’optimisation réduisent la quantité de puissance nécessaire.

Le financement constitue une seconde zone de fragilité. Les hyperscalers disposent de bilans suffisamment solides pour investir massivement, mais une part croissante de la capacité est développée par des opérateurs spécialisés, des fonds d’infrastructure et des sociétés financées par la dette. Leur équilibre dépend de contrats pluriannuels avec quelques clients majeurs. Si la demande ralentit ou si les prix de location du calcul diminuent, le risque de surcapacité peut rapidement apparaître.

La question décisive : qui paiera pour le calcul ?

Les revenus liés à l’IA progressent, mais ils ne garantissent pas encore que chaque dollar investi dans les infrastructures générera un rendement suffisant. Les fournisseurs de modèles doivent convertir l’usage en recettes récurrentes, tandis que les entreprises clientes cherchent encore à mesurer les gains de productivité effectivement obtenus.

La tension est particulièrement forte pour l’inférence. L’entraînement d’un modèle est coûteux mais ponctuel ; servir des milliards de requêtes devient une charge opérationnelle continue. Si les utilisateurs se tournent vers des modèles moins volumineux, des systèmes spécialisés ou des traitements exécutés localement, la croissance du trafic ne se traduira pas forcément par une croissance équivalente de la demande en grands centres de calcul.

À l’inverse, la multiplication des agents autonomes, de la vidéo générative, de la robotique et des applications scientifiques pourrait pousser la consommation bien au-delà des hypothèses centrales. C’est ce qui explique l’écart entre les 31 600 milliards du scénario mis en avant par PwC et le plafond de 50 000 milliards évoqué dans les analyses associées.

Une course industrielle sous surveillance

La projection ne prédit pas mécaniquement une dépense de 31 600 milliards de dollars. Elle mesure l’ampleur du capital qu’il faudrait mobiliser si la demande en calcul poursuit sa trajectoire et si les infrastructures doivent être construites pour y répondre. Le chiffre sert surtout de test de cohérence pour un secteur qui raisonne encore souvent en termes de performances de modèles plutôt qu’en contraintes d’approvisionnement.

Le prochain jalon sera visible dans les dépenses réelles de 2026 et dans la capacité des opérateurs à obtenir de l’électricité, des financements et des clients sur plusieurs années. Si les investissements progressent vers 1 800 milliards de dollars annuels sans recettes comparables, la correction viendra probablement par les prix, les retards de projets ou la fermeture de capacités excédentaires. Si la demande suit, l’IA deviendra l’un des plus grands programmes privés d’infrastructures jamais engagés — avec une facture énergétique, hydrique et financière mesurable bien avant 2050.

Sources : PwC, Tom’s Hardware

  • ✇PandIA
  • Thinking Machines pourrait valoir 40 milliards après 18 mois malgré des départs vers OpenAI
    Thinking Machines Lab pourrait atteindre une valorisation d’au moins 40 milliards de dollars, soit plus de trois fois celle affichée lors de son précédent financement. L’opération, encore en discussion, intervient à peine 18 mois après la création de la start-up fondée par Mira Murati, dans un contexte marqué par plusieurs départs visibles vers OpenAI.Accel négocierait un investissement d’un milliard de dollarsSelon les informations de TechCrunch publiées le 3 septembre 2026, Accel discuterait a

Thinking Machines pourrait valoir 40 milliards après 18 mois malgré des départs vers OpenAI

Par : Vicomte
6 septembre 2026 à 19:00
Thinking Machines pourrait valoir 40 milliards après 18 mois malgré des départs vers OpenAI

Thinking Machines Lab pourrait atteindre une valorisation d’au moins 40 milliards de dollars, soit plus de trois fois celle affichée lors de son précédent financement. L’opération, encore en discussion, intervient à peine 18 mois après la création de la start-up fondée par Mira Murati, dans un contexte marqué par plusieurs départs visibles vers OpenAI.

Accel négocierait un investissement d’un milliard de dollars

Selon les informations de TechCrunch publiées le 3 septembre 2026, Accel discuterait avec Thinking Machines Lab pour mener un tour de financement d’environ 1 milliard de dollars. La transaction valoriserait la société à 40 milliards de dollars ou davantage, si les négociations aboutissent aux conditions évoquées.

Aucun accord définitif n’aurait encore été annoncé. Le montant comme la valorisation peuvent donc évoluer, voire ne pas se concrétiser. Mais l’ordre de grandeur est déjà révélateur de la place accordée aux jeunes pousses spécialisées dans l’intelligence artificielle générative.

Thinking Machines avait levé 2 milliards de dollars lors d’un précédent tour, sur la base d’une valorisation de 12 milliards de dollars. Une nouvelle opération à 40 milliards représenterait une progression de plus de trois fois en quelques mois. Le terme « quadruplement » serait toutefois excessif au regard des chiffres disponibles : le multiple exact serait d’environ 3,3.

Une start-up valorisée avant d’avoir atteint sa maturité commerciale

La trajectoire est d’autant plus frappante que Thinking Machines serait encore une entreprise très jeune. Fondée par Mira Murati, ancienne directrice technique d’OpenAI, la société aurait déjà dépassé les 100 millions de dollars de chiffre d’affaires annualisé.

Ce chiffre correspond à un run rate, c’est-à-dire une extrapolation du rythme de revenus actuel sur douze mois. Il ne s’agit pas nécessairement du chiffre d’affaires effectivement réalisé sur un exercice complet, ni d’un indicateur de rentabilité.

Sur cette base, une valorisation de 40 milliards de dollars équivaudrait à environ 400 fois le chiffre d’affaires annualisé. Même en tenant compte d’une croissance très rapide, ce multiple place Thinking Machines parmi les entreprises les plus généreusement valorisées du secteur technologique.

Cette approche suppose que les investisseurs ne paient pas seulement les revenus actuels, mais surtout la possibilité de construire une plateforme d’IA capable de générer beaucoup plus de chiffre d’affaires à moyen terme. Elle reflète aussi la rareté du capital humain issu des laboratoires les plus avancés, ainsi que la compétition entre investisseurs pour accéder aux sociétés susceptibles de développer les prochains modèles de pointe.

Le pari repose autant sur l’équipe que sur les produits

La valeur attribuée à Thinking Machines tient largement au parcours de ses fondateurs et de ses premières recrues. Mira Murati a occupé le poste de CTO d’OpenAI pendant plusieurs années et a joué un rôle public important dans le développement et le déploiement de ChatGPT.

Son départ avait attiré une attention considérable. En lançant Thinking Machines, elle a également constitué une équipe composée de chercheurs et d’ingénieurs déjà identifiés dans l’écosystème de l’IA avancée. Pour les investisseurs, cette concentration de compétences peut justifier une prime importante, notamment dans un marché où les profils capables de concevoir et d’entraîner des modèles de grande taille sont rares.

La société reste toutefois relativement discrète sur ses produits, ses contrats et ses résultats techniques. Cette opacité complique l’évaluation de la part de la valorisation correspondant à une activité déjà établie et de celle qui repose sur des anticipations.

Le dépassement des 100 millions de dollars de revenus annualisés constitue un signal commercial positif. Il ne permet cependant pas, à lui seul, de mesurer la solidité des marges, la concentration des clients ou la récurrence des contrats. Dans l’IA, des revenus importants peuvent aussi être accompagnés de coûts élevés liés au calcul, à l’accès aux puces et à l’entraînement des modèles.

Des départs qui fragilisent le récit autour de l’équipe

L’enthousiasme financier intervient alors que plusieurs figures importantes de Thinking Machines seraient reparties chez OpenAI. Parmi elles figureraient Lilian Weng et Luke Metz, deux profils connus de l’écosystème de la recherche et de l’ingénierie en intelligence artificielle.

Ces départs ne suffisent pas à remettre en cause la stratégie de la start-up. Ils soulèvent néanmoins une question centrale : la valeur de Thinking Machines dépend-elle principalement de sa technologie, ou de la capacité de Mira Murati à retenir une équipe exceptionnelle ?

Dans les jeunes entreprises d’IA, la mobilité des talents est particulièrement forte. Les grands laboratoires disposent de moyens financiers considérables et peuvent proposer des missions, des infrastructures de calcul et des rémunérations difficiles à égaler. Le recrutement d’anciens collaborateurs est également un moyen pour OpenAI de consolider ses équipes au moment où la concurrence s’intensifie avec Google, Anthropic, Meta et de nouveaux acteurs spécialisés.

Le départ de plusieurs cofondateurs ou figures de premier plan peut donc avoir deux effets opposés. Il peut alimenter le doute sur la cohésion du projet, mais aussi confirmer que les compétences réunies autour de Thinking Machines restent suffisamment recherchées pour être courtisées par les principaux laboratoires du secteur.

Une valorisation qui devra être validée par la croissance

Le prochain financement devra surtout démontrer que le marché est prêt à soutenir une entreprise valorisée très au-delà de ses revenus actuels. À 40 milliards de dollars, Thinking Machines devrait convertir rapidement son avance technologique et son capital humain en produits, contrats et marges durables.

Le jalon le plus concret sera la finalisation du tour mené par Accel, avec son montant et ses conditions exacts. Viendront ensuite l’évolution du chiffre d’affaires, la stabilité de l’équipe dirigeante et la capacité de la start-up à publier des résultats techniques ou commerciaux suffisamment solides pour justifier un multiple proche de 400 fois ses revenus annualisés.

Pour l’instant, le dossier illustre surtout la prime accordée au pedigree des fondateurs et aux talents de l’IA de pointe. La prochaine étape consistera à vérifier si cette prime peut se transformer en croissance mesurable, plutôt qu’en simple anticipation de marché.

  • ✇PandIA
  • Comment utiliser ChatGPT pour réaliser une analyse SWOT en 2026
    L’analyse SWOT avec ChatGPT permet de structurer rapidement les forces, faiblesses, opportunités et menaces d’une entreprise, d’un projet ou d’un produit. En 2026, ChatGPT peut accélérer la collecte d’idées, la comparaison de scénarios et la formulation d’un plan d’action, à condition de lui fournir un contexte précis et de vérifier ses conclusions.Ce guide explique comment utiliser ChatGPT pour réaliser une analyse SWOT, quels prompts employer, comment exploiter des données récentes, éviter les

Comment utiliser ChatGPT pour réaliser une analyse SWOT en 2026

Par : Vicomte
6 septembre 2026 à 12:05
Comment utiliser ChatGPT pour réaliser une analyse SWOT en 2026

L’analyse SWOT avec ChatGPT permet de structurer rapidement les forces, faiblesses, opportunités et menaces d’une entreprise, d’un projet ou d’un produit. En 2026, ChatGPT peut accélérer la collecte d’idées, la comparaison de scénarios et la formulation d’un plan d’action, à condition de lui fournir un contexte précis et de vérifier ses conclusions.

Ce guide explique comment utiliser ChatGPT pour réaliser une analyse SWOT, quels prompts employer, comment exploiter des données récentes, éviter les erreurs fréquentes et transformer la matrice SWOT en décisions concrètes.

Qu’est-ce qu’une analyse SWOT ?

L’analyse SWOT est un outil de diagnostic stratégique qui étudie quatre catégories de facteurs :

  • Strengths — Forces : les avantages internes de l’organisation, du projet ou du produit.
  • Weaknesses — Faiblesses : les limites internes qui peuvent freiner la performance.
  • Opportunities — Opportunités : les évolutions externes favorables à exploiter.
  • Threats — Menaces : les risques externes susceptibles de réduire les résultats.

En français, SWOT est parfois traduit par FFOM : Forces, Faiblesses, Opportunités et Menaces.

Les facteurs internes et externes

La distinction entre facteurs internes et externes est essentielle :

| Catégorie | Nature | Exemples |

|---|---|---|

| Forces | Interne et positive | Expertise, marque reconnue, technologie propriétaire |

| Faiblesses | Interne et négative | Budget limité, dépendance à un fournisseur |

| Opportunités | Externe et positive | Nouveau marché, évolution réglementaire favorable |

| Menaces | Externe et négative | Concurrent agressif, changement de réglementation |

ChatGPT peut aider à remplir les quatre catégories, mais il ne doit pas remplacer l’analyse des données réelles, les entretiens avec les parties prenantes ou la validation par des experts.

Pourquoi utiliser ChatGPT pour une analyse SWOT en 2026 ?

ChatGPT présente plusieurs avantages pour préparer une SWOT :

  • Gain de temps lors de la phase de brainstorming ;
  • Structuration des informations dans un tableau clair ;
  • Identification de facteurs oubliés par l’équipe ;
  • Adaptation de l’analyse à un secteur, une cible ou une zone géographique ;
  • Comparaison de plusieurs scénarios ;
  • Transformation de la SWOT en plan d’action ;
  • Reformulation d’un diagnostic pour une présentation, un rapport ou un comité de direction.

En 2026, l’intérêt principal de ChatGPT réside surtout dans sa capacité à travailler à partir d’un contexte riche : notes d’entretien, données commerciales, étude de marché, avis clients, objectifs financiers ou documents internes.

Cependant, une réponse générée automatiquement peut contenir :

  • des hypothèses non vérifiées ;
  • des informations obsolètes ;
  • des généralisations ;
  • des biais favorisant les tendances les plus visibles ;
  • des menaces ou opportunités trop vagues.

ChatGPT doit donc être utilisé comme un assistant d’analyse, et non comme une source unique de décision.

Préparer les informations avant d’utiliser ChatGPT

La qualité d’une analyse SWOT dépend directement de la qualité du contexte fourni. Une demande vague produit généralement une analyse générique.

Définir le périmètre de la SWOT

Avant d’écrire un prompt, préciser l’objet de l’analyse :

  • une entreprise entière ;
  • un produit ;
  • un service ;
  • une campagne marketing ;
  • un projet de transformation numérique ;
  • une implantation dans un nouveau pays ;
  • une reconversion professionnelle ;
  • un site e-commerce ;
  • une stratégie de contenu ;
  • un lancement prévu en 2026.

Il est également utile d’indiquer la période étudiée. Une SWOT destinée à un lancement au premier semestre 2026 ne reposera pas nécessairement sur les mêmes hypothèses qu’une analyse à horizon 2030.

Rassembler les données utiles

Préparer, si possible :

  • le chiffre d’affaires et son évolution ;
  • le nombre de clients ;
  • le taux de conversion ;
  • le panier moyen ;
  • les marges ;
  • les canaux d’acquisition ;
  • les principaux concurrents ;
  • les avis clients ;
  • les ressources humaines disponibles ;
  • les technologies utilisées ;
  • les contraintes réglementaires ;
  • les objectifs de croissance ;
  • les données du marché ;
  • les retours des équipes commerciales ou du support.

Les informations confidentielles peuvent être anonymisées avant d’être transmises. Les noms de clients, contrats, données personnelles, mots de passe, informations bancaires et secrets industriels ne doivent pas être copiés dans une conversation sans cadre de protection adapté.

Comment rédiger un bon prompt SWOT pour ChatGPT ?

Un prompt efficace doit préciser le rôle demandé, le contexte, l’objectif, les données disponibles, la période et le format de réponse.

Prompt de base

Agis comme un consultant en stratégie. Réalise une analyse SWOT de [entreprise, produit ou projet] dans le secteur [secteur], sur le marché [pays ou zone géographique], pour la période [période].
Contexte : [description de l’activité, cible, modèle économique, positionnement].
Données disponibles : [chiffres, ressources, concurrents, performances, contraintes].
Présente les forces, faiblesses, opportunités et menaces dans un tableau. Pour chaque élément, indique son niveau d’importance, les éléments qui le justifient et les informations qui restent à vérifier. Ne présente aucune hypothèse comme un fait.

Ce prompt est plus pertinent qu’une demande limitée à « Fais une SWOT de mon entreprise », car il impose un raisonnement contextualisé et signale les incertitudes.

Prompt pour obtenir une analyse critique

Analyse cette SWOT de manière critique. Repère les éléments trop vagues, les doublons, les confusions entre facteurs internes et externes, les hypothèses non vérifiées et les points manquants. Propose ensuite une version améliorée, en distinguant clairement les faits, les hypothèses et les questions à documenter.

Cette étape permet d’éviter une matrice remplie de formulations génériques comme « marché concurrentiel », « équipe motivée » ou « innovation technologique », qui n’apportent aucune information exploitable.

Méthode étape par étape pour réaliser une SWOT avec ChatGPT

1. Décrire le contexte de manière précise

Indiquer à ChatGPT :

  • l’activité ;
  • la taille de l’organisation ;
  • le modèle économique ;
  • la clientèle ciblée ;
  • la zone géographique ;
  • le niveau de maturité ;
  • les objectifs ;
  • les principaux problèmes rencontrés.

Exemple :

L’entreprise est une PME française de 18 salariés qui vend des logiciels de gestion d’abonnements aux entreprises B2B. Elle réalise 1,8 million d’euros de chiffre d’affaires annuel, dispose d’une forte expertise technique mais dépend principalement d’un seul canal d’acquisition. L’objectif est de se développer en Belgique et en Suisse en 2026.

2. Demander une première liste de facteurs

Le premier échange doit servir de brainstorming. Demander une liste large, mais structurée.

À partir de ce contexte, propose 10 forces, 10 faiblesses, 10 opportunités et 10 menaces. Pour chaque facteur, indique s’il s’agit d’un fait établi, d’une hypothèse ou d’un point à vérifier. Évite les formulations génériques.

Cette première version ne doit pas être considérée comme définitive. Elle sert à repérer les thèmes à approfondir.

3. Faire préciser chaque facteur

Une SWOT utile doit répondre à trois questions :

  1. Quel est le facteur ?
  2. Pourquoi est-il important ?
  3. Quel impact peut-il avoir sur l’objectif étudié ?

Prompt recommandé :

Pour chaque élément de la SWOT, ajoute une explication de 30 à 50 mots, son impact potentiel sur l’objectif de croissance et les données nécessaires pour le confirmer.

Par exemple, « forte expertise technique » devient plus utile sous la forme suivante : « L’équipe dispose de compétences rares en intégration avec les systèmes de facturation B2B, ce qui réduit le délai de déploiement. Cette force doit toutefois être confirmée par le temps moyen d’installation et le taux de réussite des projets. »

4. Séparer les facteurs internes des facteurs externes

ChatGPT peut parfois classer une opportunité interne comme une force ou une menace interne comme une faiblesse. Demander explicitement une vérification :

Vérifie que les forces et faiblesses correspondent uniquement à des facteurs internes contrôlables par l’organisation, et que les opportunités et menaces correspondent à des facteurs externes. Signale les éléments mal classés et justifie chaque correction.

Repère pratique :

  • Ce que l’organisation possède ou contrôle relève généralement des forces et faiblesses.
  • Ce qui évolue dans l’environnement relève généralement des opportunités et menaces.

5. Hiérarchiser les facteurs

Une liste de 40 éléments est difficile à exploiter. Il est préférable de classer les facteurs selon leur importance.

Demander une notation sur une échelle de 1 à 5 :

Attribue à chaque facteur une note d’importance de 1 à 5 et une note de niveau de preuve de 1 à 5. Calcule une priorité indicative en multipliant ces deux notes. Explique que cette note est un outil de tri et non une mesure scientifique.

Il est possible d’utiliser une grille plus stratégique :

  • Impact élevé / probabilité élevée : priorité immédiate ;
  • Impact élevé / probabilité faible : préparer un scénario ;
  • Impact faible / probabilité élevée : surveiller ;
  • Impact faible / probabilité faible : faible priorité.

Les scores proposés par ChatGPT doivent être validés par les personnes qui connaissent les données opérationnelles.

6. Demander les sources à vérifier

Pour toute information de marché, de réglementation ou de concurrence, demander une liste de sources fiables :

Pour chaque opportunité et menace externe, indique quelles sources publiques ou internes permettraient de vérifier l’information : données statistiques, rapports sectoriels, sites officiels, publications réglementaires, résultats financiers, études clients ou données internes.

Si une fonction de recherche en ligne est disponible dans l’environnement utilisé, elle peut aider à identifier des informations récentes. Toutefois, les pages citées doivent être ouvertes et contrôlées manuellement. La présence d’une référence ne garantit pas automatiquement que l’interprétation est correcte.

Exemple complet d’analyse SWOT avec ChatGPT

Pour un service de livraison de repas destiné aux salariés, le résultat pourrait être structuré ainsi :

Forces

  • Réseau de restaurants partenaires déjà constitué ;
  • application mobile fonctionnelle ;
  • expérience utilisateur simple ;
  • capacité à proposer des menus adaptés à plusieurs régimes alimentaires ;
  • connaissance des habitudes de consommation locales.

Faiblesses

  • faible notoriété face aux plateformes établies ;
  • dépendance à des partenaires logistiques externes ;
  • marge réduite sur les petites commandes ;
  • budget marketing limité ;
  • absence de données historiques suffisantes sur la fidélisation.

Opportunités

  • développement des avantages repas proposés par les employeurs ;
  • demande croissante pour des options végétariennes ;
  • partenariats avec des espaces de coworking ;
  • amélioration des recommandations grâce à l’analyse des préférences ;
  • expansion vers des villes moyennes moins concurrentielles.

Menaces

  • pression tarifaire des grandes plateformes ;
  • augmentation des coûts de livraison ;
  • durcissement des obligations concernant les données personnelles ;
  • baisse du pouvoir d’achat ;
  • risque de dépendance à des applications mobiles ou à des partenaires d’acquisition.

Cette liste doit ensuite être complétée par des données : nombre de concurrents, coût moyen d’acquisition, taux de rétention, marge par commande, taille du marché et évolution de la réglementation.

Transformer la SWOT en stratégie avec la matrice TOWS

Une analyse SWOT ne doit pas rester un tableau descriptif. La matrice TOWS permet de croiser les facteurs pour générer des actions.

Stratégies SO : utiliser les forces pour saisir les opportunités

Exemple :

  • Exploiter un réseau de restaurants locaux pour lancer une offre végétarienne différenciante ;
  • utiliser les données de commande pour proposer des formules adaptées aux entreprises.

Stratégies WO : corriger les faiblesses grâce aux opportunités

Exemple :

  • signer des partenariats avec des espaces de coworking pour compenser une faible notoriété ;
  • exploiter les dispositifs d’avantages salariés pour réduire la dépendance à la publicité payante.

Stratégies ST : utiliser les forces pour réduire les menaces

Exemple :

  • s’appuyer sur une expérience utilisateur supérieure pour limiter l’effet de la guerre des prix ;
  • valoriser la connaissance du marché local face aux plateformes nationales.

Stratégies WT : réduire les faiblesses et éviter les menaces

Exemple :

  • diversifier les partenaires logistiques afin de limiter les interruptions de service ;
  • améliorer le suivi des marges avant toute expansion géographique.

Prompt utile :

Transforme cette analyse SWOT en matrice TOWS. Propose au moins trois actions SO, trois actions WO, trois actions ST et trois actions WT. Pour chaque action, indique l’objectif, le responsable potentiel, les ressources nécessaires, l’échéance, l’indicateur de réussite et le principal risque.

Utiliser ChatGPT pour comparer plusieurs scénarios

Une SWOT peut varier selon les hypothèses retenues. Il est donc utile de demander plusieurs scénarios :

  • scénario prudent ;
  • scénario central ;
  • scénario de croissance ;
  • scénario de crise ;
  • scénario de changement réglementaire ;
  • scénario d’arrivée d’un concurrent majeur.

Prompt :

Compare les scénarios prudent, central et optimiste pour ce projet. Pour chacun, actualise les opportunités et les menaces, identifie les forces à mobiliser, les faiblesses les plus dangereuses et les décisions à prendre dans les 90 prochains jours.

Cette approche évite de construire une stratégie uniquement sur l’hypothèse la plus favorable.

Les erreurs fréquentes à éviter

Demander une analyse trop générale

Une requête comme « Fais une SWOT de l’intelligence artificielle » conduit souvent à des résultats abstraits. Il faut préciser le secteur, la cible, le territoire, l’horizon temporel et l’objectif.

Confondre une opinion et une donnée

Une phrase produite par ChatGPT n’est pas nécessairement un fait. Les expressions comme « le marché est en forte croissance » ou « les clients recherchent davantage ce service » doivent être vérifiées.

Mélanger les quatre catégories

Une hausse de la demande est une opportunité externe. Une base de clients fidèle est une force interne. Une équipe trop petite est une faiblesse interne. L’arrivée d’un concurrent est une menace externe.

Accumuler trop de facteurs

Une SWOT efficace contient généralement 3 à 7 facteurs prioritaires par catégorie. Une liste trop longue dilue les sujets vraiment importants.

Oublier la temporalité

Une opportunité valable en 2026 peut devenir moins pertinente en 2027. Chaque facteur doit être associé à une période, une tendance ou une condition de validité.

Confier des données sensibles à un outil sans précaution

Avant d’utiliser ChatGPT, vérifier les paramètres de confidentialité, les règles internes de l’organisation et les conditions applicables au compte utilisé. Anonymiser les informations lorsque cela est possible.

Comment vérifier et améliorer la réponse de ChatGPT ?

Après génération, appliquer cette checklist :

  1. Les quatre catégories contiennent-elles des facteurs distincts ?
  2. Les forces et faiblesses sont-elles réellement internes ?
  3. Les opportunités et menaces reposent-elles sur des évolutions externes ?
  4. Chaque facteur est-il lié à l’objectif de l’analyse ?
  5. Les affirmations importantes disposent-elles d’une source ?
  6. Les informations sont-elles à jour pour 2026 ?
  7. Les chiffres sont-ils cohérents avec les données internes ?
  8. Les facteurs sont-ils hiérarchisés ?
  9. Chaque priorité possède-t-elle un indicateur de suivi ?
  10. La SWOT débouche-t-elle sur des décisions concrètes ?

Un second prompt peut servir d’audit :

Agis comme un contradicteur stratégique. Cherche les failles de cette SWOT, les hypothèses trop optimistes, les risques sous-estimés, les facteurs absents et les conclusions qui ne sont pas suffisamment étayées. Ne propose pas de reformulation avant d’avoir listé les problèmes.

Combien de temps faut-il pour réaliser une SWOT avec ChatGPT ?

La durée dépend du niveau de précision recherché :

  • 10 à 20 minutes pour une première matrice de brainstorming ;
  • 1 à 2 heures pour intégrer des données internes et hiérarchiser les facteurs ;
  • une demi-journée ou davantage pour une analyse stratégique documentée avec sources, entretiens et scénarios.

ChatGPT réduit surtout le temps de rédaction et de structuration. Il ne supprime pas le temps nécessaire à la collecte, à la vérification et à la discussion des informations.

Quand utiliser ChatGPT pour une analyse SWOT ?

ChatGPT est particulièrement utile :

  • au début d’un atelier stratégique ;
  • avant un lancement de produit ;
  • lors d’une entrée sur un nouveau marché ;
  • pour préparer un business plan ;
  • pour analyser une stratégie marketing ;
  • pour comparer des options d’investissement ;
  • pour structurer des retours clients ;
  • pour préparer une présentation à une direction ou à des investisseurs.

Il est moins adapté comme unique outil lorsque la décision implique des enjeux juridiques, financiers, sociaux ou réglementaires importants. Dans ces situations, l’analyse générée doit être complétée par des données fiables et l’avis de professionnels compétents.

Conclusion : les points clés à retenir

Utiliser ChatGPT pour réaliser une analyse SWOT en 2026 permet de gagner du temps, élargir le brainstorming et structurer un diagnostic stratégique. La méthode la plus fiable consiste à :

  • fournir un contexte détaillé ;
  • préciser l’objectif et l’horizon temporel ;
  • distinguer les facteurs internes des facteurs externes ;
  • demander à ChatGPT de séparer les faits, hypothèses et points à vérifier ;
  • hiérarchiser les éléments selon leur impact et leur niveau de preuve ;
  • vérifier les données récentes et les sources ;
  • convertir la SWOT en actions grâce à la matrice TOWS ;
  • protéger les informations confidentielles ;
  • faire relire les conclusions par des personnes connaissant le marché et l’organisation.

La valeur de ChatGPT ne réside pas dans la production automatique d’un tableau, mais dans sa capacité à poser de meilleures questions, révéler les angles morts et transformer une réflexion dispersée en plan d’action vérifiable.

  • ✇PandIA
  • Meta offre 95 % de remise sur Muse Spark contre les prompts et réponses des entreprises
    Le prix d’un agent IA ne se mesure plus seulement en dollars par million de tokens. Avec Muse Spark, Meta propose désormais une remise pouvant atteindre 95 % aux clients prêts à céder leurs prompts et les réponses générées pour entraîner les futurs modèles.L’offre place les données d’usage au centre du modèle économique. Elle intervient surtout sur un terrain sensible : les agents de programmation et les prototypes d’agents professionnels, qui manipulent souvent du code propriétaire, des procédu

Meta offre 95 % de remise sur Muse Spark contre les prompts et réponses des entreprises

Par : Decrypt
6 septembre 2026 à 07:00
Meta offre 95 % de remise sur Muse Spark contre les prompts et réponses des entreprises

Le prix d’un agent IA ne se mesure plus seulement en dollars par million de tokens. Avec Muse Spark, Meta propose désormais une remise pouvant atteindre 95 % aux clients prêts à céder leurs prompts et les réponses générées pour entraîner les futurs modèles.

L’offre place les données d’usage au centre du modèle économique. Elle intervient surtout sur un terrain sensible : les agents de programmation et les prototypes d’agents professionnels, qui manipulent souvent du code propriétaire, des procédures internes et des informations confidentielles.

Un tarif divisé par vingt pour les clients qui partagent leurs échanges

Meta facture 0,10 dollar par million de tokens en entrée et 0,20 dollar en sortie aux clients acceptant de partager leurs prompts et les réponses de Muse Spark à des fins d’entraînement. Le tarif standard s’élève à 1,25 dollar par million de tokens en entrée et 4,25 dollars en sortie.

La réduction atteint donc 92 % sur les tokens entrants et environ 95,3 % sur les tokens sortants. Selon la répartition entre les deux types de consommation, l’économie globale peut approcher ou atteindre 95 %.

Il ne s’agit pas d’un paiement direct versé aux utilisateurs. La contrepartie prend la forme d’un prix d’inférence fortement réduit. Meta transforme ainsi l’accès à des données opérationnelles en avantage tarifaire, plutôt qu’en simple condition juridique inscrite dans les petites lignes d’un contrat.

Selon TechCrunch, l’objectif consiste à observer la manière dont les clients utilisent le modèle afin d’améliorer les prochaines générations de systèmes. Axios rapporte de son côté que Meta positionne Muse Spark, notamment dans sa version 1.3, sur les usages d’assistant personnel et de travail.

Des données plus riches que de simples conversations

Pour Meta, l’intérêt ne réside pas uniquement dans le texte envoyé au modèle. Les usages d’agents produisent des traces particulièrement instructives : description d’une tâche, appels à des outils, corrections successives, erreurs, validation humaine et résultat final.

Dans le cas d’un agent de programmation, cette séquence peut révéler la façon dont un développeur demande une modification, vérifie un résultat ou corrige une réponse incomplète. Pour un agent professionnel, elle peut exposer les étapes d’un processus administratif, commercial ou analytique.

Ces données sont plus proches de scénarios de travail réels que les requêtes isolées d’un chatbot. Elles peuvent aider à entraîner des modèles capables de mieux planifier, d’utiliser des outils externes et de récupérer après une erreur. Elles sont aussi nettement plus sensibles.

Le prix de l’inférence contre le prix de la confidentialité

La proposition de Meta intervient alors que la plupart des grandes entreprises cherchent à empêcher que leurs données propriétaires servent à l’entraînement des modèles. Les contrats d’IA destinés aux professionnels prévoient de plus en plus souvent une absence d’entraînement par défaut, des options de zero retention ou un traitement dans un environnement isolé.

L’offre Muse Spark suit la logique inverse : la protection maximale devient une option coûteuse, tandis que le partage des échanges ouvre droit au prix le plus bas. Cette architecture crée une tension directe entre réduction des coûts et gouvernance des données.

Pour une start-up qui teste un agent sur des informations peu sensibles, l’arbitrage peut sembler acceptable. Pour une banque, un éditeur logiciel ou un cabinet de conseil, les prompts peuvent contenir des extraits de code, des noms de clients, des données financières ou des détails sur l’architecture interne. Les réponses du modèle peuvent, elles aussi, reprendre ou synthétiser ces informations.

Le risque ne se limite pas à une fuite spectaculaire. Des données apparemment anodines peuvent devenir sensibles une fois agrégées : structure d’un dépôt logiciel, vocabulaire interne, règles de validation, habitudes d’un service ou contenu de tickets techniques. La répétition des requêtes peut également permettre de reconstituer un processus métier.

Une question centrale : que recouvre exactement le partage ?

La remise annoncée ne suffit pas à déterminer le niveau de risque. Les conditions concrètes du programme seront décisives : durée de conservation, filtrage des informations personnelles, chiffrement, accès humain, possibilité de retirer des données déjà utilisées et séparation entre les environnements clients.

La question de l’anonymisation sera également difficile à trancher. Supprimer un nom ou une adresse ne suffit pas nécessairement à rendre un échange inoffensif. Un fragment de code, une erreur rare ou une procédure interne peuvent rester identifiables sans contenir de donnée personnelle explicite.

Le statut des données est un autre point critique. Un client qui accepte de partager des prompts autorise-t-il uniquement leur utilisation pour l’amélioration de Muse Spark, ou également leur conservation pour des évaluations, des réglages de sécurité et l’entraînement de modèles futurs ? La distinction entre ces finalités devra être clairement établie.

Meta devra aussi expliquer si l’accord concerne tous les échanges d’un compte ou seulement certains projets, et si les entreprises peuvent sélectionner les données partageables. Sans mécanisme de contrôle fin, l’offre risque d’être incompatible avec les politiques de sécurité de nombreux grands comptes.

Un avantage économique difficile à ignorer

La pression tarifaire reste toutefois réelle. Pour un agent qui génère des milliers de réponses, le coût de sortie domine rapidement la facture. Passer de 4,25 dollars à 0,20 dollar par million de tokens peut rendre viable un prototype qui serait trop cher à exploiter au tarif standard.

Cette baisse peut accélérer les expérimentations, en particulier pour les équipes qui ne disposent pas encore d’un budget important. Elle donne aussi à Meta une source de données difficile à obtenir autrement : des interactions longues, structurées et liées à des tâches concrètes.

Le mécanisme ressemble ainsi à une forme de troc industriel. L’entreprise cliente fournit une partie de son expérience d’utilisation ; Meta réduit le coût du calcul et récupère un matériau d’entraînement. La valeur de l’échange dépendra de la qualité des garanties autant que du niveau de remise.

Les entreprises devront calculer le coût réel de la remise

L’offre de Meta pourrait séduire les équipes chargées de prototyper rapidement des agents, mais elle risque de rester cantonnée aux données non sensibles. Dans les environnements réglementés, la question ne sera pas seulement : « combien coûte le modèle ? », mais aussi : « combien coûterait l’exposition d’un flux propriétaire ? »

Le prochain jalon sera la publication détaillée des conditions de partage de Muse Spark et les premiers retours d’entreprises utilisatrices. Les indicateurs à surveiller sont concrets : nombre de clients optant pour la remise, types de données effectivement transmis, mécanismes d’exclusion et capacité à supprimer les échanges après ingestion.

Si Meta apporte des garanties comparables à celles attendues par les fournisseurs d’IA d’entreprise, son offre pourrait devenir un levier d’adoption. Si les modalités restent floues, la remise de 95 % risque surtout d’apparaître comme le prix affiché d’une concession que les directions juridiques et informatiques refusent de faire.

  • ✇PandIA
  • WeatherNext 3 recalcule la météo mondiale chaque heure, quand les modèles classiques suivent à 6 h
    Les prévisions météorologiques pourraient bientôt être recalculées au rythme des événements qu’elles décrivent. Présenté le 3 septembre 2026, WeatherNext 3, le nouveau modèle de Google DeepMind et Google Research, produit des prévisions mondiales toutes les heures et exploite directement les observations de satellites géostationnaires.Des prévisions recalculées chaque heureLes modèles météorologiques traditionnels reposent sur des simulations physiques lourdes, alimentées par des observations pr

WeatherNext 3 recalcule la météo mondiale chaque heure, quand les modèles classiques suivent à 6 h

Par : Vicomte
5 septembre 2026 à 19:00
WeatherNext 3 recalcule la météo mondiale chaque heure, quand les modèles classiques suivent à 6 h

Les prévisions météorologiques pourraient bientôt être recalculées au rythme des événements qu’elles décrivent. Présenté le 3 septembre 2026, WeatherNext 3, le nouveau modèle de Google DeepMind et Google Research, produit des prévisions mondiales toutes les heures et exploite directement les observations de satellites géostationnaires.

Des prévisions recalculées chaque heure

Les modèles météorologiques traditionnels reposent sur des simulations physiques lourdes, alimentées par des observations provenant de stations au sol, d’avions, de bouées et de satellites. Dans la plupart des grands systèmes opérationnels, les calculs complets sont relancés environ toutes les six heures. Cette cadence limite la vitesse à laquelle une prévision peut intégrer l’évolution d’une cellule orageuse, d’une dépression ou d’un épisode de fortes pluies.

WeatherNext 3 vise une mise à jour beaucoup plus fréquente. Le modèle génère de nouvelles prévisions à chaque heure, à l’échelle mondiale. L’enjeu n’est pas seulement de raccourcir le délai entre deux bulletins : une cadence plus fine permet de mieux suivre les phénomènes dont la trajectoire et l’intensité changent rapidement.

Le système repose sur l’apprentissage automatique plutôt que sur une résolution complète des équations atmosphériques à chaque cycle. Il produit des scénarios météorologiques à partir de données d’observation et de représentations apprises dans de vastes ensembles historiques. Cette approche réduit potentiellement le coût de calcul et accélère la production des résultats.

L’accélération ne signifie toutefois pas que chaque prévision devient automatiquement plus fiable. Une mise à jour horaire n’a d’intérêt que si elle apporte une information nouvelle et suffisamment précise. C’est précisément sur ce point que l’utilisation directe des satellites géostationnaires devient stratégique.

Les satellites comme capteurs en temps quasi réel

Les satellites géostationnaires restent au-dessus d’une même zone de la Terre et observent en continu les nuages, la vapeur d’eau et l’évolution des systèmes météorologiques. Ils peuvent fournir une vision rapide de phénomènes qui se développent entre deux cycles de calcul classiques.

Selon Google, WeatherNext 3 exploite directement ces données satellitaires, au lieu de dépendre uniquement de produits déjà agrégés ou de variables dérivées. Cette alimentation plus proche de la mesure initiale doit permettre au modèle de détecter plus vite des signaux associés à la convection, aux précipitations intenses ou à la formation de nuages.

La nuance est importante. Un satellite n’observe pas directement toutes les variables utiles à une prévision météo. Il mesure principalement des rayonnements et des signatures physiques, que les modèles doivent interpréter. L’IA ne supprime donc pas la complexité du problème : elle apprend à relier ces observations à l’état probable de l’atmosphère et à son évolution.

Cette capacité peut être particulièrement utile dans les régions où les stations météorologiques sont rares. Les zones océaniques, les territoires isolés ou certaines régions du Sud global disposent de moins de mesures au sol. Les satellites y fournissent une couverture continue, avec une granularité temporelle difficile à obtenir par d’autres moyens.

Une résolution qui descend jusqu’à cinq kilomètres

WeatherNext 3 peut atteindre une résolution allant jusqu’à 5 kilomètres pour certaines variables de surface. Cette échelle ne décrit pas chaque rue ni chaque bâtiment, mais elle est suffisamment fine pour mieux représenter des contrastes régionaux : relief, littoral, zones urbaines ou évolution locale des précipitations.

Il faut cependant éviter une interprétation excessive. La résolution de 5 kilomètres ne s’applique pas nécessairement à toutes les variables ni à l’ensemble des sorties mondiales du modèle. La qualité finale dépend aussi de la densité des observations, du type de phénomène et de la capacité du système à représenter des événements très localisés.

Les orages violents constituent un test particulièrement exigeant. Leur durée peut être courte, leur structure complexe et leur trajectoire difficile à anticiper. Un modèle qui actualise ses scénarios toutes les heures peut néanmoins fournir aux services de sécurité une information plus fraîche : déplacement probable de la zone dangereuse, évolution des pluies ou persistance d’un front actif.

Pour les gestionnaires de réseaux électriques, les opérateurs de transport et les acteurs agricoles, cette différence peut se traduire par des décisions prises avec quelques dizaines de minutes supplémentaires. Dans certains cas, ce délai suffit à modifier une tournée, protéger une installation ou organiser une évacuation locale.

Des résultats favorables, mais encore à vérifier sur le terrain

Google affirme que des évaluations indépendantes conduites par Brightband placent WeatherNext 3 devant les systèmes précédents sur plusieurs critères de précision. Cette validation externe renforce la portée de l’annonce, car les performances d’un modèle météo ne peuvent pas être jugées uniquement à partir de démonstrations ou d’exemples sélectionnés.

Les comparaisons doivent toutefois être lues avec attention. La performance varie selon la variable mesurée — température, vent, précipitations ou pression —, l’horizon de prévision et la région étudiée. Un modèle peut progresser sur la trajectoire d’une dépression tout en restant moins performant sur les précipitations locales, particulièrement difficiles à prévoir.

La question de la robustesse face aux événements rares reste également centrale. Les catastrophes les plus coûteuses sont souvent associées à des situations peu fréquentes : pluies extrêmes, vents destructeurs, canicules persistantes ou cyclones atypiques. Les données historiques contiennent moins d’exemples de ces événements, ce qui complique l’apprentissage.

Le modèle devra aussi démontrer sa stabilité lorsque les données d’entrée sont incomplètes, retardées ou de qualité variable. Une architecture dépendante des satellites doit fonctionner malgré des interruptions de couverture, des artefacts de mesure ou des différences entre instruments.

Une technologie complémentaire des services météorologiques

WeatherNext 3 ne remplace pas à lui seul les agences météorologiques nationales ni les systèmes numériques de prévision fondés sur la physique. Ces infrastructures fournissent des analyses officielles, des alertes réglementaires et une expertise locale indispensable. Elles servent également de référence pour évaluer les nouveaux modèles d’IA.

L’intérêt principal du système tient plutôt à sa capacité à compléter ces dispositifs : recalculs fréquents, couverture mondiale et production rapide de scénarios. Il pourrait alimenter des applications météo, des outils de gestion des risques ou des systèmes d’alerte qui ont besoin de données actualisées en permanence.

Le prochain jalon sera le passage des évaluations générales aux usages opérationnels. Il faudra mesurer, sur une saison complète et dans des régions exposées, le gain réel obtenu par rapport aux prévisions existantes : réduction des fausses alertes, amélioration du délai d’anticipation et meilleure localisation des phénomènes dangereux.

Si ces bénéfices se confirment, une prévision actualisée toutes les heures, avec une résolution pouvant atteindre 5 kilomètres, pourrait rendre les alertes plus exploitables face aux événements extrêmes. La valeur de WeatherNext 3 se mesurera donc moins à la vitesse de génération qu’au nombre de décisions concrètes améliorées par cette information supplémentaire.

  • ✇PandIA
  • Comment utiliser ChatGPT pour créer un plan de repas en 2026
    Utiliser ChatGPT pour créer un plan de repas en 2026 permet d’obtenir rapidement des idées adaptées au budget, au temps disponible, aux préférences alimentaires et aux objectifs nutritionnels. Ce guide explique comment préparer une demande efficace, vérifier les propositions, générer une liste de courses et organiser les repas de la semaine sans confondre assistance par IA et conseil médical.Pourquoi utiliser ChatGPT pour créer un plan de repas ?ChatGPT peut agir comme un assistant d’organisatio

Comment utiliser ChatGPT pour créer un plan de repas en 2026

Par : 0xMonkey
5 septembre 2026 à 12:05
Comment utiliser ChatGPT pour créer un plan de repas en 2026

Utiliser ChatGPT pour créer un plan de repas en 2026 permet d’obtenir rapidement des idées adaptées au budget, au temps disponible, aux préférences alimentaires et aux objectifs nutritionnels. Ce guide explique comment préparer une demande efficace, vérifier les propositions, générer une liste de courses et organiser les repas de la semaine sans confondre assistance par IA et conseil médical.

Pourquoi utiliser ChatGPT pour créer un plan de repas ?

ChatGPT peut agir comme un assistant d’organisation alimentaire. À partir d’informations précises, il peut générer :

  • un menu sur plusieurs jours ;
  • des recettes rapides ou adaptées au batch cooking ;
  • une liste de courses classée par rayon ;
  • des alternatives végétariennes, sans lactose ou sans gluten ;
  • des portions indicatives ;
  • une estimation du temps de préparation ;
  • des idées pour utiliser les restes ;
  • un plan adapté à un budget hebdomadaire ;
  • un tableau de repas imprimable.

L’intérêt principal est de centraliser plusieurs contraintes dans une même demande. Au lieu de chercher séparément des recettes, des quantités et des idées de repas, ChatGPT peut proposer une première organisation cohérente.

Cependant, la qualité du résultat dépend fortement des informations fournies. Une demande vague comme « Fais-moi un menu pour la semaine » produira généralement un programme générique. Une demande détaillée donnera un résultat plus pertinent et plus facile à appliquer.

Quelles informations donner à ChatGPT ?

Avant de demander un plan de repas, il est utile de rassembler les éléments suivants.

1. Le nombre de personnes

Indiquez :

  • le nombre d’adultes ;
  • le nombre d’enfants ;
  • l’âge des enfants si les portions doivent être adaptées ;
  • les repas concernés : petit-déjeuner, déjeuner, dîner, collations ;
  • le nombre de jours à planifier.

Un menu pour une personne seule ne s’organise pas comme un menu familial pour quatre personnes. Le nombre de convives influence aussi les formats d’achat et le risque de gaspillage.

2. Les objectifs

ChatGPT peut proposer un plan orienté vers :

  • une alimentation plus équilibrée ;
  • la réduction du budget ;
  • la prise de masse musculaire ;
  • une alimentation riche en protéines ;
  • la préparation rapide ;
  • la diminution de la consommation de viande ;
  • l’utilisation des produits déjà présents dans les placards ;
  • la perte de poids dans une approche générale.

Pour un objectif de santé précis, il faut éviter de présenter la réponse comme une prescription. Une perte de poids, un régime pauvre en glucides ou un calcul calorique personnalisé peuvent nécessiter l’avis d’un médecin ou d’un diététicien.

3. Les préférences et exclusions

La demande doit préciser les aliments appréciés et ceux à éviter :

  • régime végétarien ou végétalien ;
  • absence de porc ;
  • alimentation halal ou casher ;
  • allergies ;
  • intolérances ;
  • aliments détestés ;
  • niveau d’épices accepté ;
  • préférence pour les plats français, méditerranéens ou asiatiques ;
  • limite de consommation de viande ou de poisson.

En cas d’allergie, l’information doit être formulée clairement. Il est également indispensable de vérifier les étiquettes, car une recette apparemment compatible peut contenir des traces d’allergènes ou des ingrédients cachés.

4. Le temps disponible

Précisez le temps maximum pour :

  • préparer un repas en semaine ;
  • cuisiner le week-end ;
  • faire de la vaisselle ;
  • organiser une session de batch cooking.

Exemple : « Les dîners doivent être prêts en moins de 25 minutes, avec une session de préparation de deux heures le dimanche. »

5. Le matériel disponible

Le résultat sera plus réaliste si ChatGPT connaît les équipements disponibles :

  • four ;
  • plaques de cuisson ;
  • micro-ondes ;
  • air fryer ;
  • robot cuiseur ;
  • blender ;
  • autocuiseur ;
  • congélateur ;
  • petit réfrigérateur.

Une recette nécessitant un four n’est pas adaptée si le logement n’en possède pas. Cette précision évite une grande partie des ajustements ultérieurs.

Comment rédiger un bon prompt pour un plan de repas ?

Un prompt efficace contient un rôle, un contexte, des contraintes et un format de réponse attendu.

Exemple de prompt général

Agis comme un assistant d’organisation des repas. Crée un plan de repas pour 7 jours destiné à 2 adultes. Prévois les déjeuners et les dîners, avec des recettes simples, équilibrées et accessibles. Le budget maximum est de 80 euros pour la semaine. Les dîners doivent demander moins de 30 minutes de préparation. Prévois deux repas végétariens, un repas avec du poisson et des recettes permettant de réutiliser les restes. Évite les champignons et les plats très épicés. Présente d’abord un tableau avec le jour, le repas, le temps de préparation et les restes prévus, puis une liste de courses classée par rayon avec des quantités approximatives.

Ce prompt contient suffisamment de détails pour obtenir une base exploitable. Il reste possible de demander une seconde version si certaines recettes ne conviennent pas.

Prompt pour une famille avec enfants

Crée un menu familial sur 5 jours pour 2 adultes et 2 enfants de 6 et 9 ans. Prévois un dîner chaque soir et des déjeuners à emporter trois fois dans la semaine. Les recettes doivent être peu épicées, économiques et préparables en moins de 35 minutes. Utilise des ingrédients faciles à trouver en supermarché en France. Évite les poissons avec arêtes et indique comment adapter les portions des enfants. Ajoute une liste de courses sans doublons.

Prompt pour un budget réduit

Propose un plan de repas économique pour 7 jours et 2 personnes, avec un budget cible de 55 euros. Utilise des légumineuses, des œufs, des céréales, des légumes de saison et quelques produits surgelés. Limite la viande à deux repas. Réutilise les ingrédients dans plusieurs recettes et indique les aliments qui peuvent être congelés. Signale les estimations qui dépendent des prix du magasin.

Les prix fournis par ChatGPT restent indicatifs. Ils varient selon la ville, l’enseigne, la marque, la saison, les promotions et le format des produits.

Comment demander un menu réellement personnalisé ?

Étape 1 : fournir les contraintes essentielles

Commencez par les informations non négociables : nombre de personnes, allergies, budget, temps disponible et aliments exclus.

Étape 2 : demander une structure avant les recettes

Il est souvent plus efficace de demander d’abord un calendrier des repas. Vérifiez ensuite que la répartition convient avant de demander les détails.

Exemple :

Propose uniquement la structure d’un menu sur 7 jours. N’écris pas encore les recettes. Vérifie la variété des sources de protéines, l’utilisation des restes et la répartition des repas végétariens.

Cette méthode évite de générer plusieurs pages de recettes avant de constater que le menu ne correspond pas aux habitudes.

Étape 3 : demander les recettes sélectionnées

Après validation du calendrier, demandez les recettes avec :

  • les ingrédients ;
  • les quantités ;
  • le nombre de portions ;
  • le temps de préparation ;
  • le temps de cuisson ;
  • les étapes ;
  • les possibilités de remplacement ;
  • la durée de conservation.

Étape 4 : demander la liste de courses

Utilisez une demande séparée :

Transforme ce menu en liste de courses pour 2 personnes. Regroupe les ingrédients par catégories : fruits et légumes, produits frais, épicerie, conserves, surgelés et produits ménagers. Additionne les quantités identiques et indique les produits déjà réutilisés dans plusieurs recettes.

La liste générée doit être comparée au contenu des placards et du réfrigérateur. ChatGPT ne connaît pas automatiquement les stocks disponibles, sauf si ces informations sont précisées dans la conversation.

Étape 5 : demander un plan de préparation

Pour gagner du temps, demandez un ordre de préparation :

Organise une session de batch cooking de 2 heures le dimanche. Indique les préparations à faire en parallèle, les aliments à conserver au réfrigérateur, ceux à congeler et l’ordre conseillé pour limiter la vaisselle.

Cette étape peut transformer un menu théorique en organisation concrète.

Comment créer un plan de repas équilibré avec ChatGPT ?

Un menu équilibré ne se résume pas à une liste de recettes dites « saines ». Il doit varier les aliments et éviter la répétition excessive.

Demandez à ChatGPT de contrôler les éléments suivants :

  • présence régulière de légumes et de fruits ;
  • alternance entre légumineuses, œufs, poisson, viande et alternatives végétales ;
  • variété des féculents : pommes de terre, riz, pâtes, semoule, pain complet, quinoa ;
  • utilisation de matières grasses en quantité raisonnable ;
  • limitation des produits très sucrés et très salés ;
  • adaptation des portions au nombre de personnes ;
  • variété des couleurs et des textures ;
  • présence de repas faciles à transporter.

En France, les recommandations du Programme national nutrition santé, de l’Anses et de Santé publique France constituent de meilleures références générales qu’une réponse automatique non vérifiée. ChatGPT peut aider à organiser les repas, mais il ne remplace pas ces sources ni un professionnel de santé.

Demander un contrôle nutritionnel simple

Il est possible d’écrire :

Analyse ce menu de manière générale. Indique s’il contient une variété suffisante de légumes, de sources de protéines et de féculents. Signale les repas très riches en produits ultra-transformés ou pauvres en fibres. Ne pose aucun diagnostic et ne présente pas cette analyse comme un avis médical.

La réponse doit être considérée comme une vérification indicative. Les estimations de calories, protéines ou micronutriments peuvent être imprécises si les marques, les poids cuits et les quantités exactes ne sont pas connus.

Peut-on utiliser ChatGPT pour compter les calories et les protéines ?

Oui, ChatGPT peut estimer les calories et les macronutriments à partir d’un menu, mais cette estimation comporte plusieurs limites :

  • le poids cru et le poids cuit ne sont pas équivalents ;
  • les valeurs changent selon les marques ;
  • la taille réelle des portions varie ;
  • l’huile, les sauces et les garnitures sont souvent sous-estimées ;
  • les bases nutritionnelles ne sont pas toujours identiques ;
  • les recettes maison peuvent avoir des proportions différentes.

Pour obtenir une estimation plus cohérente, indiquez les poids, les marques et le nombre exact de portions. Demandez aussi à distinguer les ingrédients secs des aliments cuits.

En cas de diabète, de maladie rénale, de grossesse, de trouble du comportement alimentaire ou de traitement nécessitant une alimentation particulière, l’utilisation d’un calcul automatique ne doit pas remplacer un suivi médical.

Comment adapter un plan de repas aux saisons et au budget ?

Produits de saison

Demandez à ChatGPT de privilégier les produits disponibles à une période et dans une région donnée :

Crée un menu pour le mois de mars en France métropolitaine, en privilégiant les légumes et fruits généralement disponibles en saison. Signale les ingrédients qui peuvent varier selon la région.

La saisonnalité peut réduire le prix et améliorer la disponibilité, mais elle dépend des circuits de distribution et de la météo. Il reste utile de vérifier les prix dans le magasin fréquenté.

Réduction du gaspillage

Ajoutez des règles comme :

  • utiliser un même bouquet d’herbes dans plusieurs recettes ;
  • prévoir une recette avec les légumes restants ;
  • réutiliser le riz ou les pâtes dans un autre repas ;
  • congeler les portions excédentaires ;
  • proposer une recette « vide-frigo » en fin de semaine.

Un bon prompt peut demander une colonne « restes prévus » dans le tableau. Cette information permet de savoir quand cuisiner une grande quantité et comment la réemployer.

Comment vérifier les réponses de ChatGPT ?

ChatGPT peut produire une recette plausible mais inexacte. Avant de suivre le menu, vérifiez les points suivants :

  1. Les allergies et contaminations croisées : lisez les étiquettes et utilisez des ustensiles propres.
  2. Les temps de cuisson : ils peuvent varier selon le four, la taille des morceaux et la quantité.
  3. La conservation : placez rapidement les restes au réfrigérateur et respectez les recommandations de l’emballage.
  4. Les aliments crus : soyez particulièrement attentif aux œufs, viandes, poissons et produits laitiers.
  5. Les quantités : vérifiez que les volumes correspondent aux casseroles et boîtes disponibles.
  6. Les substitutions : un remplacement peut modifier la texture, le goût ou la valeur nutritionnelle.
  7. Les informations nutritionnelles : comparez les données avec une source fiable ou l’étiquette du produit.

Les dates limites de consommation, généralement indiquées par « à consommer jusqu’au », doivent être respectées avec prudence. Les dates de durabilité minimale, formulées comme « à consommer de préférence avant », ne fonctionnent pas de la même manière. En cas de doute sur un aliment, mieux vaut ne pas le consommer.

Quelles fonctionnalités de ChatGPT peuvent aider en 2026 ?

Selon la formule, l’application et les fonctions disponibles sur le compte, ChatGPT peut proposer des outils comme l’analyse de fichiers, la recherche en ligne ou la conservation de certaines préférences. Leur disponibilité peut évoluer.

Ces fonctions peuvent servir à :

  • analyser une photo ou une liste de produits, après vérification ;
  • transformer un ticket de caisse en inventaire ;
  • exploiter un tableau contenant les prix d’un supermarché ;
  • adapter une recette à partir d’un document ;
  • rechercher des informations récentes sur les produits ou les recommandations.

Une recherche en ligne ne garantit pas automatiquement l’exactitude des résultats. Privilégiez les sites officiels, les fabricants, les organismes publics et les pages de magasins réellement consultées. Évitez de transmettre des données sensibles : informations médicales détaillées, coordonnées personnelles ou photographies permettant d’identifier un domicile.

Exemple de demande complète à copier

Prépare un plan de repas sur 7 jours pour 1 adulte, avec déjeuners et dîners. Budget maximum : 60 euros. Temps de préparation en semaine : 20 minutes maximum. Une session de cuisine de 90 minutes est possible le dimanche. Prévois au moins trois repas végétariens, deux repas avec des légumineuses et un repas avec du poisson. Évite les champignons, le céleri et les plats très épicés. Utilise des ingrédients disponibles en France au mois de septembre. Réduis le gaspillage en réutilisant les mêmes ingrédients dans plusieurs recettes. Présente : 1) un tableau des repas ; 2) les recettes avec quantités ; 3) une liste de courses classée par rayon ; 4) un calendrier de préparation ; 5) les aliments à conserver au réfrigérateur ou au congélateur. Indique clairement les estimations de prix et les points à vérifier.

Les erreurs à éviter

Certaines demandes donnent des résultats peu pratiques :

  • ne pas indiquer le nombre de personnes ;
  • oublier les allergies ;
  • demander un menu « équilibré » sans préciser les habitudes ;
  • accepter des prix sans vérifier le magasin ;
  • demander trop de recettes différentes avec un petit budget ;
  • ignorer le matériel de cuisine disponible ;
  • suivre une recommandation médicale générée automatiquement ;
  • ne pas vérifier les portions ;
  • laisser ChatGPT inventer une source ou une valeur nutritionnelle ;
  • prévoir trop de restes sans capacité de conservation.

L’erreur la plus fréquente consiste à considérer le premier menu comme définitif. Il est préférable de demander une première version, de signaler les problèmes, puis de faire corriger uniquement les éléments concernés.

Combien de temps faut-il pour créer un menu avec ChatGPT ?

Un premier plan peut être généré en quelques minutes. La préparation complète demande davantage de temps :

  • 5 minutes pour renseigner les contraintes ;
  • 5 à 10 minutes pour vérifier le calendrier ;
  • 10 à 20 minutes pour corriger les recettes ;
  • 5 minutes pour contrôler la liste de courses ;
  • quelques minutes pour organiser le batch cooking.

La création rapide d’un menu ne signifie donc pas que la vérification peut être supprimée. Le temps gagné vient surtout de la structuration et de la réduction des recherches répétitives.

Conclusion : les points clés à retenir

ChatGPT peut aider à créer un plan de repas personnalisé en 2026, à condition de lui fournir un contexte précis. Pour obtenir un résultat utile :

  • indiquez le nombre de personnes, le budget et le temps disponible ;
  • précisez les allergies, exclusions et préférences ;
  • demandez d’abord un calendrier, puis les recettes ;
  • générez une liste de courses sans doublons ;
  • prévoyez la réutilisation des restes et la conservation ;
  • vérifiez les prix, les temps de cuisson et les informations nutritionnelles ;
  • utilisez des sources officielles pour les recommandations de santé ;
  • ne remplacez jamais un professionnel pour un régime médical ou une pathologie.

Le meilleur usage de ChatGPT consiste à l’employer comme outil d’organisation et d’idéation, puis à contrôler chaque proposition avant de l’intégrer aux habitudes alimentaires.

  • ✇PandIA
  • OpenAI et 100 entreprises redoutent des cyberattaques dopées par l’IA dans quelques mois
    Le scénario d’attaques menées à grande échelle par des agents d’IA n’est plus présenté comme une hypothèse lointaine. OpenAI, Anthropic, Microsoft, Alphabet, Amazon et plus d’une centaine d’entreprises estiment que les organisations ne disposent plus que de quelques mois pour renforcer leurs défenses.Les fabricants d’IA sonnent eux-mêmes l’alarmeL’avertissement commun, relayé le 4 septembre 2026, intervient à un moment sensible pour le secteur. Les modèles de langage ne se contentent plus de pro

OpenAI et 100 entreprises redoutent des cyberattaques dopées par l’IA dans quelques mois

Par : Vicomte
5 septembre 2026 à 07:00
OpenAI et 100 entreprises redoutent des cyberattaques dopées par l’IA dans quelques mois

Le scénario d’attaques menées à grande échelle par des agents d’IA n’est plus présenté comme une hypothèse lointaine. OpenAI, Anthropic, Microsoft, Alphabet, Amazon et plus d’une centaine d’entreprises estiment que les organisations ne disposent plus que de quelques mois pour renforcer leurs défenses.

Les fabricants d’IA sonnent eux-mêmes l’alarme

L’avertissement commun, relayé le 4 septembre 2026, intervient à un moment sensible pour le secteur. Les modèles de langage ne se contentent plus de produire du texte ou du code à la demande : ils peuvent enchaîner des tâches, utiliser des outils externes, analyser des environnements techniques et adapter leur comportement à partir des résultats obtenus.

Cette progression concerne directement la cybersécurité. Un modèle capable de rechercher une cible, d’identifier une vulnérabilité, de générer un script, de tester une charge et de documenter ses résultats peut déjà réduire fortement le temps nécessaire à une opération offensive. Si ces étapes sont coordonnées par un agent autonome, l’attaquant n’a plus besoin de piloter chaque action manuellement.

Le fait que les principaux développeurs de modèles participent à cette alerte lui donne une portée particulière. Il ne s’agit pas uniquement d’une mise en garde formulée par des chercheurs en sécurité ou des agences publiques. Les entreprises qui développent les systèmes les plus performants reconnaissent que leurs progrès peuvent renforcer la capacité opérationnelle des attaquants.

Le risque ne réside pas seulement dans le phishing généré par IA

Les premières craintes autour de l’IA et de la cybersécurité se concentraient sur l’amélioration des courriels d’hameçonnage, des faux sites ou des arnaques personnalisées. Ces usages restent importants, mais ils ne constituent qu’un premier niveau de menace.

L’IA peut intervenir sur une chaîne beaucoup plus large :

  • repérage automatisé des actifs exposés sur Internet ;
  • analyse de documents techniques et de dépôts de code ;
  • sélection de vulnérabilités exploitables ;
  • génération et adaptation de logiciels malveillants ;
  • création de messages adaptés à chaque victime ;
  • recherche de moyens de persistance dans un réseau ;
  • tri des données volées avant leur exfiltration.

L’enjeu est moins l’apparition d’une attaque totalement nouvelle que l’augmentation de sa vitesse, de son volume et de sa capacité d’adaptation. Une campagne qui nécessitait auparavant plusieurs opérateurs spécialisés pourrait être exécutée avec moins d’interventions humaines, sur un nombre beaucoup plus important de cibles.

Cette distinction est essentielle. Les modèles actuels ne sont pas nécessairement capables de conduire seuls une intrusion complexe et fiable de bout en bout. Ils peuvent produire du code erroné, perdre le fil d’une opération ou échouer face à des protections simples. Mais chaque amélioration de leur capacité à planifier, tester et corriger réduit le nombre de tâches réservées aux experts.

Pourquoi l’horizon se compte en mois

L’alerte ne repose pas uniquement sur une prédiction technique. Elle tient aussi à la logique économique des attaques informatiques. Les groupes criminels n’ont pas besoin d’un agent parfait pour obtenir un avantage. Une hausse de 20 % ou 30 % de leur productivité peut déjà rendre rentables des campagnes qui ne l’étaient pas auparavant.

L’IA réduit plusieurs coûts simultanément : le recrutement d’opérateurs, la traduction des messages, l’analyse de données, la maintenance des outils et le traitement des réponses des victimes. Elle peut aussi permettre à des groupes moins expérimentés de sous-traiter les tâches les plus complexes à des services automatisés.

Du côté des défenseurs, les contraintes sont différentes. Les entreprises doivent corriger leurs systèmes, vérifier les identités, surveiller les journaux, segmenter leurs réseaux et gérer les incidents. Ces opérations restent soumises à des budgets, à des procédures d’achat et à des équipes souvent limitées. Une attaque automatisée peut, elle, fonctionner en continu et tester simultanément des milliers de combinaisons.

La pression est encore plus forte pour les infrastructures critiques, les hôpitaux, les collectivités et les fournisseurs de logiciels. Une vulnérabilité publiée peut être repérée, analysée et exploitée plus rapidement que les organisations ne sont capables de déployer un correctif. L’IA ne crée pas cette asymétrie, mais elle peut l’accentuer.

Une reconnaissance gênante pour les acteurs du secteur

La déclaration place les signataires face à une tension difficile à éviter. OpenAI, Anthropic, Microsoft, Alphabet et Amazon commercialisent des modèles dont la valeur dépend précisément de leur capacité à accomplir davantage de tâches avec moins d’intervention humaine. La même autonomie qui améliore la productivité d’un développeur peut aider un attaquant à automatiser une intrusion.

Cette contradiction impose de dépasser les déclarations générales sur la sécurité. Les entreprises devront démontrer comment leurs modèles sont testés face à des scénarios offensifs, quelles capacités sont bloquées et à quel moment des contrôles humains deviennent obligatoires.

Les évaluations de sûreté devront notamment mesurer la capacité d’un modèle à rechercher une cible, à exploiter une faille ou à maintenir une présence dans un environnement compromis. Il faudra également vérifier si les garde-fous résistent aux contournements et si un modèle peut être utilisé indirectement via une application, une API ou un agent spécialisé.

L’alerte n’est pas une preuve que les attaques autonomes à grande échelle sont déjà opérationnelles. Elle signale plutôt que le rythme de progression est suffisamment rapide pour rendre les préparatifs urgents. Attendre une démonstration publique réussie avant d’investir dans la défense reviendrait à laisser l’expérimentation se dérouler dans des réseaux réels.

Les entreprises doivent passer de la promesse à la préparation

À court terme, la priorité ne consiste pas à déployer une IA défensive à chaque étape. Elle consiste d’abord à réduire les opportunités offertes à une attaque automatisée.

Cela passe par l’authentification multifacteur, la limitation des privilèges, la segmentation des systèmes sensibles, l’inventaire des actifs exposés et la surveillance des comptes de service. Les organisations doivent aussi tester leurs procédures de réponse avec des scénarios où l’attaquant change rapidement de méthode et multiplie les tentatives.

Les fournisseurs de modèles ont, de leur côté, intérêt à partager des indicateurs comparables : taux de réussite sur des tâches offensives, nombre d’actions nécessitant une validation humaine, résistance aux demandes malveillantes et capacité à détecter une utilisation détournée. Sans métriques publiques, les entreprises ne pourront pas distinguer une protection solide d’une simple promesse commerciale.

Les gouvernements devront enfin accélérer les échanges entre autorités, laboratoires et opérateurs d’importance vitale. Les obligations de signalement, les exigences de sécurité dans les marchés publics et les exercices de crise devront intégrer des attaques assistées par des agents, et non plus seulement des scénarios conduits manuellement.

Le prochain jalon sera mesurable dans les délais d’attaque

La conséquence la plus concrète à surveiller dans les prochains mois sera le temps séparant la découverte d’une vulnérabilité de son exploitation à grande échelle. Si ce délai se raccourcit nettement, les méthodes actuelles de correction et de réponse devront être revues.

Le secteur de l’IA vient de reconnaître que ses outils pourraient industrialiser une partie du piratage. Le prochain test ne sera pas une nouvelle déclaration de principe, mais la publication d’évaluations reproductibles, le renforcement des défenses des infrastructures critiques et la capacité des entreprises à contenir une campagne automatisée avant qu’elle ne se transforme en incident majeur.

  • ✇PandIA
  • ChatGPT, Grok, Claude, Copilot et Gemini tombent ensemble : l’IA cale pendant des heures
    Le 3 septembre 2026, cinq des assistants IA les plus utilisés au monde ont cessé de répondre correctement au même moment. ChatGPT, Grok, Claude, Copilot et Gemini ont été indisponibles ou fortement ralentis pendant plusieurs heures, selon les régions — un incident qui transforme une crainte théorique en problème opérationnel concret.Cinq assistants concurrents touchés en parallèleLes perturbations ont été signalées sur des services appartenant à OpenAI, xAI, Anthropic, Microsoft et Google. La si

ChatGPT, Grok, Claude, Copilot et Gemini tombent ensemble : l’IA cale pendant des heures

Par : 0xMonkey
4 septembre 2026 à 19:01
ChatGPT, Grok, Claude, Copilot et Gemini tombent ensemble : l’IA cale pendant des heures

Le 3 septembre 2026, cinq des assistants IA les plus utilisés au monde ont cessé de répondre correctement au même moment. ChatGPT, Grok, Claude, Copilot et Gemini ont été indisponibles ou fortement ralentis pendant plusieurs heures, selon les régions — un incident qui transforme une crainte théorique en problème opérationnel concret.

Cinq assistants concurrents touchés en parallèle

Les perturbations ont été signalées sur des services appartenant à OpenAI, xAI, Anthropic, Microsoft et Google. La simultanéité est l’élément le plus préoccupant de l’épisode : il ne s’agit pas d’une défaillance isolée d’un modèle, d’une interface ou d’un fournisseur.

Des utilisateurs ont rapporté des erreurs de connexion, des réponses qui n’aboutissaient pas et des temps d’attente anormalement longs. La durée et l’intensité de la panne ont varié selon les zones géographiques, mais plusieurs régions du monde ont été affectées pendant plusieurs heures, d’après les signalements recensés notamment par El País.

À ce stade, les éléments disponibles ne permettent pas d’attribuer l’incident à une cause unique. La panne pourrait relever d’un problème affectant une couche commune de l’Internet — réseau, cloud, DNS, authentification ou acheminement du trafic — sans que cela soit établi. Le simple fait que des entreprises aussi différentes soient touchées en parallèle suffit toutefois à poser une question centrale : la concurrence entre assistants garantit-elle réellement une continuité de service ?

La promesse de redondance mise à l’épreuve

Pour une entreprise, disposer de plusieurs assistants peut sembler constituer une stratégie de secours. Si ChatGPT est indisponible, Claude ou Gemini peuvent prendre le relais. Si un modèle est saturé, une autre API peut être appelée. Cette logique de redondance est désormais intégrée à de nombreux outils professionnels.

L’incident du 3 septembre montre ses limites. Les services sont concurrents sur le plan commercial, mais ils restent construits sur une architecture Internet largement partagée. Ils dépendent tous de centres de données, de fournisseurs de connectivité, de systèmes d’identité, de bibliothèques logicielles et de chaînes de déploiement complexes. Une panne située en amont peut donc neutraliser plusieurs solutions supposées indépendantes.

La diversification ne suffit pas non plus lorsque les applications clientes reposent sur une même connexion ou sur le même fournisseur d’infrastructure. Une entreprise qui utilise trois modèles différents derrière une seule plateforme centralisée peut perdre l’accès aux trois si cette plateforme tombe. Le recours à plusieurs marques donne alors une impression de sécurité supérieure à la résilience réelle.

Une dépendance devenue opérationnelle

La question dépasse l’usage conversationnel. Dans de nombreuses organisations, les assistants IA servent désormais à rédiger des réponses clients, analyser des documents, produire du code, résumer des réunions ou interroger des bases internes. Certains agents exécutent même des actions dans des logiciels métiers.

Lorsque ces systèmes deviennent indisponibles, la conséquence n’est pas seulement une gêne pour les salariés. Des tickets peuvent s’accumuler, des chaînes de validation être interrompues et des équipes perdre l’accès à des fonctions intégrées dans leur environnement de travail. Dans certains cas, la dépendance est invisible : l’utilisateur ne se connecte pas directement à ChatGPT ou Claude, mais à un logiciel qui utilise leur API en arrière-plan.

Pour le grand public, la panne rappelle aussi la fragilité d’usages devenus ordinaires : recherche d’informations, traduction, aide à l’écriture, assistance au code ou analyse de fichiers. La disponibilité presque permanente des assistants a installé une attente de continuité comparable à celle associée à la messagerie ou aux moteurs de recherche.

Un incident difficile à diagnostiquer

Les pannes simultanées sont particulièrement délicates à analyser. Chaque fournisseur peut afficher un état de fonctionnement globalement normal tout en subissant des erreurs dans certaines régions ou pour certains types de requêtes. Les utilisateurs, eux, perçoivent une défaillance unique : l’IA ne répond plus.

Cette asymétrie complique l’identification de la cause. Une panne de modèle n’a pas les mêmes symptômes qu’un problème de réseau ou d’authentification. Des réponses lentes peuvent provenir d’une surcharge, d’une limitation de capacité ou d’un incident chez un prestataire externe. Sans chronologie détaillée des erreurs et sans communication technique des entreprises concernées, il serait prématuré de conclure à une défaillance commune précise.

L’épisode met néanmoins en lumière une faiblesse structurelle : les fournisseurs d’IA communiquent souvent sur leurs taux de disponibilité séparément, alors que les entreprises utilisent ces services comme un ensemble. Le bon indicateur n’est donc plus seulement la disponibilité de chaque assistant, mais celle de la chaîne complète — application, réseau, identité, modèle et système d’exécution.

Ce que les entreprises doivent revoir

La première conséquence concrète devrait être la révision des plans de continuité. Un simple contrat avec un second fournisseur ne constitue pas un plan de secours suffisant si les deux services partagent les mêmes dépendances critiques.

Plusieurs mesures deviennent prioritaires :

  • prévoir un mode dégradé permettant de poursuivre les opérations essentielles sans assistant distant ;
  • conserver localement les documents, consignes et résultats indispensables ;
  • tester plusieurs fournisseurs, mais aussi plusieurs chemins techniques d’accès ;
  • définir des seuils précis de bascule et de retour au fonctionnement normal ;
  • mesurer la durée maximale acceptable d’interruption pour chaque usage ;
  • maintenir des procédures manuelles réellement opérationnelles, et pas seulement documentées.

Le recours à des modèles exécutés sur site ou dans une infrastructure contrôlée peut réduire certaines dépendances, au prix d’une qualité parfois moindre et de coûts matériels plus élevés. Cette option ne remplace pas les services en ligne pour tous les usages, mais elle peut fournir un filet de sécurité pour les tâches critiques et les données sensibles.

Le prochain test sera celui de la transparence

La panne du 3 septembre 2026 ne prouve pas que tous les assistants IA sont condamnés à tomber ensemble. Elle démontre en revanche que la disponibilité commerciale de plusieurs services ne garantit pas leur indépendance technique.

Le prochain jalon attendu est la publication d’explications détaillées par les fournisseurs : durée exacte des perturbations, régions affectées, composants concernés et éventuelles dépendances communes. Pour les entreprises, la mesure la plus concrète sera de vérifier combien de processus peuvent réellement fonctionner sans IA pendant une heure, une journée ou plusieurs jours. Tant que cette réponse reste inconnue, l’assistant n’est pas une infrastructure fiable : il demeure un service puissant, mais externe et interruptible.

  • ✇PandIA
  • Comment utiliser ChatGPT pour créer un formulaire Google Forms
    Utiliser ChatGPT pour créer un formulaire Google Forms permet de concevoir plus rapidement un questionnaire, un sondage, un quiz ou un formulaire d’inscription. ChatGPT peut générer les questions, proposer les types de réponses, organiser les sections et même préparer un script Google Apps Script pour automatiser la création du formulaire.Ce guide explique comment créer un formulaire Google Forms avec ChatGPT, quelles informations fournir dans le prompt, comment transférer le résultat dans Googl

Comment utiliser ChatGPT pour créer un formulaire Google Forms

Par : 0xMonkey
4 septembre 2026 à 12:05
Comment utiliser ChatGPT pour créer un formulaire Google Forms

Utiliser ChatGPT pour créer un formulaire Google Forms permet de concevoir plus rapidement un questionnaire, un sondage, un quiz ou un formulaire d’inscription. ChatGPT peut générer les questions, proposer les types de réponses, organiser les sections et même préparer un script Google Apps Script pour automatiser la création du formulaire.

Ce guide explique comment créer un formulaire Google Forms avec ChatGPT, quelles informations fournir dans le prompt, comment transférer le résultat dans Google Forms et quelles précautions prendre avant de partager le formulaire.

Que peut faire ChatGPT pour créer un formulaire Google Forms ?

ChatGPT ne crée pas automatiquement un formulaire dans votre compte Google dans la plupart des configurations. Il peut toutefois préparer presque toute sa structure et vous faire gagner du temps sur les étapes de conception.

ChatGPT peut notamment :

  • définir l’objectif du formulaire ;
  • identifier les informations à collecter ;
  • rédiger les questions ;
  • proposer plusieurs choix de réponse ;
  • recommander le type de question adapté ;
  • organiser le formulaire en sections ;
  • créer une introduction et un message de confirmation ;
  • améliorer la formulation des questions ;
  • éviter les questions ambiguës ou orientées ;
  • préparer un quiz avec les bonnes réponses ;
  • générer un script Google Apps Script pour créer le formulaire automatiquement ;
  • suggérer les paramètres de confidentialité et de collecte des réponses.

En revanche, ChatGPT ne peut pas toujours ouvrir Google Forms et enregistrer directement un formulaire. Cette possibilité dépend des fonctionnalités disponibles sur le compte, des extensions connectées et des autorisations accordées à l’outil.

La méthode la plus simple consiste donc à demander à ChatGPT de préparer le contenu, puis à le reproduire dans Google Forms. Une méthode plus avancée utilise Google Apps Script afin d’automatiser la création.

Pourquoi utiliser ChatGPT pour concevoir un Google Form ?

La création manuelle d’un formulaire est relativement simple, mais elle peut devenir longue lorsque le questionnaire contient plusieurs sections ou de nombreuses questions.

ChatGPT est particulièrement utile dans les situations suivantes :

  • création d’un questionnaire de satisfaction ;
  • préparation d’un sondage interne ;
  • inscription à un événement ;
  • collecte de candidatures ;
  • enquête marketing ;
  • évaluation de formation ;
  • quiz pédagogique ;
  • formulaire de réservation ;
  • recueil de demandes de contact ;
  • diagnostic ou questionnaire de qualification.

L’avantage principal réside dans la préparation éditoriale. Au lieu de réfléchir à chaque question séparément, il suffit de décrire le contexte, la cible et l’objectif. ChatGPT peut ensuite proposer une première version structurée.

Cette première version doit toutefois être relue. Une intelligence artificielle peut produire des questions redondantes, trop générales ou inadaptées au public visé.

Préparer les informations avant d’utiliser ChatGPT

La qualité du formulaire généré dépend directement de la précision de la demande. Avant d’écrire le prompt, rassemblez les éléments suivants :

  1. L’objectif du formulaire : recueillir un avis, inscrire des participants, qualifier un besoin ou évaluer des connaissances.
  2. Le public ciblé : clients, salariés, étudiants, candidats, visiteurs ou grand public.
  3. Le nombre approximatif de questions.
  4. Le temps de réponse souhaité.
  5. Les informations obligatoires.
  6. Le ton à employer : professionnel, simple, chaleureux ou institutionnel.
  7. Les types de réponses souhaités : texte court, paragraphe, choix multiple, cases à cocher, échelle linéaire ou date.
  8. Les règles de confidentialité.
  9. La nécessité éventuelle d’un quiz avec notation.
  10. La structure souhaitée : une seule page ou plusieurs sections.

Plus ces indications sont précises, moins le travail de correction sera important.

Exemple de brief à fournir à ChatGPT

Un brief peut être formulé ainsi :

Crée la structure d’un formulaire Google Forms destiné à mesurer la satisfaction de clients après un achat en ligne. Le formulaire doit contenir 12 questions, être complété en moins de 3 minutes et utiliser un ton professionnel et clair. Prévois des questions obligatoires, une échelle de satisfaction de 1 à 5, une question sur la livraison, une question sur le produit, une question ouverte et un message de remerciement final. Présente le résultat sous forme de tableau avec le titre, la question, le type de réponse, les options et le caractère obligatoire.

Cette consigne indique à ChatGPT quoi produire et sous quelle forme. Elle limite les réponses trop vagues.

Les étapes pour créer un formulaire Google Forms avec ChatGPT

1. Définir le type de formulaire

Commencez par préciser le format attendu. Un formulaire d’inscription ne nécessite pas la même structure qu’un quiz ou qu’une enquête de satisfaction.

Exemples :

  • « Crée un formulaire d’inscription à un atelier professionnel. »
  • « Prépare un questionnaire de satisfaction après une intervention. »
  • « Génère un quiz de 20 questions sur la cybersécurité. »
  • « Conçois un formulaire de demande de devis. »

Indiquez également si le formulaire doit être court ou détaillé.

2. Demander une structure exploitable

Pour faciliter la création dans Google Forms, demandez une présentation structurée. Le format le plus pratique est un tableau comprenant :

| Élément | Description |

|---|---|

| Section | Partie du formulaire |

| Question | Texte affiché au répondant |

| Type | Choix multiple, texte court, cases à cocher, etc. |

| Options | Réponses proposées |

| Obligatoire | Oui ou non |

| Logique | Section suivante éventuelle |

Cette présentation permet de recopier rapidement les questions dans Google Forms et d’éviter les oublis.

3. Choisir le bon type de question

Demandez à ChatGPT de justifier le type de réponse utilisé pour chaque question. Le choix du format influence fortement la qualité des résultats.

Les principaux types disponibles dans Google Forms sont :

  • Réponse courte : nom, adresse e-mail, numéro de commande ;
  • Paragraphe : commentaire ou explication détaillée ;
  • Choix multiple : une seule réponse parmi plusieurs ;
  • Cases à cocher : plusieurs réponses possibles ;
  • Liste déroulante : utile lorsque les options sont nombreuses ;
  • Échelle linéaire : notation de 1 à 5 ou de 1 à 10 ;
  • Grille à choix multiple : évaluation de plusieurs éléments avec une seule réponse par ligne ;
  • Grille de cases à cocher : plusieurs choix dans une grille ;
  • Date et heure : réservation ou planification ;
  • Importation de fichier : transmission d’un document, sous réserve des paramètres du compte.

Exemple de demande :

Pour chaque question, indique le type de question Google Forms le plus adapté et explique brièvement pourquoi. Évite les questions qui combinent deux sujets différents.

4. Faire relire et améliorer les questions

Une première génération n’est pas toujours suffisante. Demandez ensuite à ChatGPT de vérifier :

  • les doublons ;
  • les formulations trop longues ;
  • les questions orientées ;
  • les termes techniques ;
  • les réponses manquantes ;
  • les incohérences entre les questions ;
  • l’ordre général du questionnaire.

Prompt utile :

Relis ce questionnaire comme un expert en conception d’enquêtes. Identifie les questions ambiguës, orientées, redondantes ou trop difficiles à comprendre. Propose une version corrigée en conservant l’objectif initial.

Cette étape améliore la fiabilité des réponses et réduit le taux d’abandon.

5. Créer le formulaire dans Google Forms

Une fois le contenu validé :

  1. Ouvrez Google Forms depuis forms.google.com.
  2. Sélectionnez Formulaire vierge ou un modèle.
  3. Ajoutez le titre du formulaire.
  4. Copiez la description proposée par ChatGPT.
  5. Ajoutez les questions une par une.
  6. Sélectionnez le type de réponse correspondant.
  7. Ajoutez les options de réponse.
  8. Activez le bouton Obligatoire lorsque cela est nécessaire.
  9. Créez les sections recommandées.
  10. Configurez les paramètres de collecte et de partage.
  11. Utilisez l’aperçu pour tester le formulaire.

Il est préférable de créer d’abord les questions obligatoires et les éléments qui conditionnent la navigation entre les sections.

Organiser un formulaire Google Forms avec plusieurs sections

Les sections rendent le parcours plus lisible et permettent de personnaliser les questions affichées.

Par exemple, un formulaire d’inscription peut contenir :

  1. Informations personnelles ;
  2. Choix de l’événement ;
  3. Préférences du participant ;
  4. Besoins particuliers ;
  5. Consentement et validation.

Demandez à ChatGPT de prévoir une logique conditionnelle lorsque certaines réponses doivent orienter le répondant vers une section précise.

Exemple :

Organise ce formulaire en sections et indique la logique de navigation. Si le répondant sélectionne « Non » à la question sur la participation, dirige-le vers la fin du formulaire. S’il sélectionne « Oui », affiche les questions concernant ses disponibilités.

Dans Google Forms, la navigation conditionnelle s’appuie principalement sur les questions à choix multiple ou les listes déroulantes. Toutes les questions ne permettent pas de rediriger vers une section spécifique.

Créer un quiz Google Forms avec ChatGPT

ChatGPT peut également préparer un quiz compatible avec le mode questionnaire de Google Forms.

Demandez-lui de fournir :

  • la question ;
  • les réponses possibles ;
  • la bonne réponse ;
  • le nombre de points ;
  • une explication pédagogique ;
  • le niveau de difficulté.

Exemple de prompt :

Crée un quiz de 15 questions sur les fondamentaux de la protection des données personnelles. Utilise quatre choix de réponse par question, une seule bonne réponse, un niveau de difficulté progressif et une explication de la réponse correcte. Présente le résultat dans un tableau compatible avec la création d’un questionnaire Google Forms.

Dans Google Forms :

  1. Ouvrez l’onglet Paramètres.
  2. Activez l’option En faire un questionnaire.
  3. Ouvrez le corrigé de chaque question.
  4. Sélectionnez la bonne réponse.
  5. Attribuez le nombre de points.
  6. Choisissez si la note est publiée immédiatement ou après vérification manuelle.

Vérifiez systématiquement les réponses correctes proposées par ChatGPT, surtout pour les sujets techniques, juridiques, médicaux ou scientifiques.

Automatiser la création avec Google Apps Script

Pour un formulaire long, Google Apps Script peut créer automatiquement les questions à partir d’un script généré par ChatGPT.

Le fonctionnement général est le suivant :

  1. Demandez à ChatGPT de générer un script Google Apps Script.
  2. Précisez le titre du formulaire, les sections, les types de questions et les options.
  3. Ouvrez Google Apps Script depuis script.google.com.
  4. Créez un nouveau projet.
  5. Collez le script fourni par ChatGPT dans l’éditeur.
  6. Enregistrez le projet.
  7. Lancez la fonction principale.
  8. Acceptez les autorisations demandées par Google.
  9. Récupérez l’URL du formulaire créé dans les journaux ou dans le résultat du script.
  10. Ouvrez le formulaire et vérifiez chaque élément.

Prompt recommandé :

Génère un script Google Apps Script qui crée un formulaire Google Forms intitulé « Enquête de satisfaction client ». Le script doit ajouter trois sections, des questions à réponse courte, des choix multiples, une échelle linéaire de 1 à 5 et une question paragraphe. Indique clairement le nom de la fonction à exécuter, les autorisations nécessaires et les éventuelles limites du script. Utilise uniquement les méthodes officiellement disponibles dans Google Apps Script pour Forms.

Cette méthode est intéressante pour :

  • les formulaires contenant beaucoup de questions ;
  • la création répétée de formulaires similaires ;
  • les équipes qui souhaitent standardiser leurs questionnaires ;
  • les tests ou prototypes ;
  • la génération de plusieurs versions d’un même formulaire.

Limites de Google Apps Script

Le script peut nécessiter des corrections. ChatGPT peut utiliser une méthode obsolète, confondre deux types de questions ou générer une syntaxe incorrecte.

Avant l’exécution :

  • demandez une version utilisant les méthodes actuelles ;
  • vérifiez les noms des fonctions ;
  • testez le script sur un formulaire temporaire ;
  • ne donnez pas à ChatGPT de données personnelles présentes dans le script ;
  • contrôlez les autorisations demandées ;
  • supprimez les déclencheurs inutiles après les tests.

Un script qui crée un formulaire ne remplace pas la validation manuelle. Les paramètres de partage, de collecte d’adresses et de publication doivent être contrôlés dans l’interface Google Forms.

Peut-on demander à ChatGPT de créer directement un Google Form ?

Dans une configuration classique, ChatGPT n’a pas accès à votre compte Google Forms. Il ne peut donc pas créer un formulaire dans votre espace sans intégration spécifique.

Une création directe peut être envisageable uniquement si :

  • une application connectée dispose des autorisations adéquates ;
  • une automatisation externe relie ChatGPT à Google ;
  • un compte professionnel possède une intégration compatible ;
  • un script ou une API exécute les instructions générées.

Ne communiquez jamais votre mot de passe Google dans une conversation ChatGPT. Une connexion doit passer par le système d’authentification officiel de Google et par des autorisations clairement identifiées.

La méthode manuelle reste souvent la plus sûre pour un formulaire simple. Apps Script est plus adapté aux besoins automatisés.

Configurer correctement les paramètres Google Forms

Après avoir créé les questions, vérifiez les paramètres suivants.

Collecte des adresses e-mail

Google Forms peut collecter automatiquement les adresses e-mail, selon la configuration du formulaire et le type de compte utilisé. Cette option doit être annoncée clairement aux répondants.

Activez-la uniquement si elle est nécessaire. Une collecte inutile peut réduire le nombre de réponses, notamment pour les sondages anonymes.

Limitation à une réponse

L’option de limitation à une seule réponse peut obliger les participants à se connecter à un compte Google. Cette contrainte doit être compatible avec le public ciblé.

Modification après envoi

Autoriser la modification des réponses peut être utile pour une inscription, mais moins adapté à une enquête qui doit conserver l’état initial des réponses.

Présentation des résultats

Évitez d’afficher automatiquement le résumé des réponses si les résultats contiennent des informations sensibles ou si cela risque d’influencer les participants.

Message de confirmation

Demandez à ChatGPT de rédiger un message spécifique selon le contexte :

Rédige un message de confirmation de 40 mots maximum pour un formulaire d’inscription à une conférence. Indique que la demande a bien été enregistrée et que les informations pratiques seront envoyées ultérieurement.

Conseils pour obtenir de meilleures réponses avec ChatGPT

Pour améliorer le résultat, utilisez une démarche progressive plutôt qu’un seul prompt très général.

Première demande : créer l’architecture

Demandez les sections, les objectifs et le nombre de questions.

Deuxième demande : rédiger les questions

Faites générer le contenu détaillé avec les types de réponses.

Troisième demande : contrôler la qualité

Demandez une analyse des biais, des doublons et des informations manquantes.

Quatrième demande : adapter le ton

Faites reformuler le formulaire pour un public précis : débutants, clients professionnels, étudiants ou grand public.

Cinquième demande : préparer l’intégration

Demandez un tableau de saisie ou un script Apps Script.

Cette méthode permet de corriger rapidement les problèmes sans devoir régénérer l’ensemble du formulaire.

Erreurs fréquentes à éviter

Poser trop de questions

Un formulaire trop long entraîne davantage d’abandons. Pour une enquête courante, privilégiez les questions indispensables et annoncez le temps de réponse estimé.

Mélanger plusieurs sujets

Une question comme « Êtes-vous satisfait du prix et de la qualité du produit ? » mesure deux éléments différents. Préférez deux questions séparées.

Utiliser uniquement des questions ouvertes

Les réponses libres apportent des informations riches, mais elles sont plus longues à analyser. Combinez-les avec des choix prédéfinis et une question de commentaire final.

Rendre toutes les questions obligatoires

Certaines personnes ne peuvent pas répondre à toutes les questions. Une obligation excessive peut provoquer des réponses artificielles ou l’abandon du formulaire.

Copier sans vérifier

ChatGPT peut produire une information fausse, une option oubliée ou une réponse juridiquement inadaptée. La validation humaine reste indispensable.

Collecter des données sensibles sans justification

Évitez de demander des informations personnelles qui ne sont pas nécessaires à l’objectif du formulaire. Pour les données sensibles, vérifiez les obligations applicables, notamment celles liées au RGPD.

Exemple de prompt complet à réutiliser

Conçois un formulaire Google Forms pour [objectif].
Public ciblé : [public].
Nombre de questions : [nombre].
Temps de réponse maximal : [durée].
Ton : [ton].
Le formulaire doit comporter les sections suivantes : [sections].
Pour chaque question, indique : le texte exact, le type de question Google Forms, les options de réponse, le caractère obligatoire et une éventuelle logique de navigation.
Évite les doublons, les questions orientées et les formulations ambiguës.
Ajoute une courte introduction, une mention sur l’utilisation des données et un message de confirmation.
Présente le résultat dans un tableau clair, puis propose une version améliorée après vérification de la cohérence du questionnaire.

Questions fréquentes sur ChatGPT et Google Forms

ChatGPT peut-il importer directement des questions dans Google Forms ?

Pas directement dans une utilisation standard. Google Forms ne propose pas une fonction native permettant de coller un long texte généré par ChatGPT pour transformer automatiquement chaque ligne en question. La saisie manuelle, un script Apps Script ou une automatisation tierce sont nécessaires.

ChatGPT peut-il créer un formulaire sans compte Google ?

ChatGPT peut rédiger la structure et les questions sans compte Google. En revanche, un compte Google est nécessaire pour créer, enregistrer et gérer le formulaire dans Google Forms.

Quelle est la meilleure méthode pour un petit formulaire ?

La méthode manuelle est généralement la plus rapide : ChatGPT prépare le contenu, puis les questions sont copiées dans Google Forms.

Quelle méthode choisir pour un formulaire de 50 questions ?

Google Apps Script peut faire gagner du temps, à condition de tester le script et de vérifier les autorisations. Une importation ou une automatisation peut être pertinente pour les formulaires récurrents.

Les réponses du formulaire peuvent-elles être analysées par ChatGPT ?

Oui, après export vers Google Sheets ou téléchargement dans un format compatible, à condition de respecter les règles de confidentialité. Anonymisez les données personnelles avant de les transmettre à un service d’intelligence artificielle.

À retenir

Utiliser ChatGPT pour créer un formulaire Google Forms permet surtout d’accélérer la conception et d’améliorer la qualité des questions. La méthode la plus accessible consiste à demander une structure détaillée, puis à saisir manuellement les éléments dans Google Forms.

Pour un projet plus important, ChatGPT peut générer un script Google Apps Script capable de créer automatiquement le formulaire. Dans tous les cas, vérifiez les questions, les réponses correctes, les paramètres de confidentialité, la collecte d’adresses e-mail et la logique de navigation avant publication. Le bon résultat repose sur trois éléments : un prompt précis, une relecture humaine et une configuration rigoureuse dans Google Forms.

  • ✇PandIA
  • GPT-6 Astra peut découvrir des failles inédites et préparer leur exploitation seul
    OpenAI ne présente pas GPT-6 Astra comme une simple mise à jour de modèle, mais comme une première incursion dans l’ère de l’intelligence artificielle générale. Sa promesse est aussi ambitieuse que risquée : exécuter seul des tâches professionnelles complexes, tout en possédant des capacités inédites de recherche et d’exploitation de failles informatiques.GPT-6 Astra veut franchir le cap de l’autonomie professionnelleAnnoncé le 3 septembre 2026, GPT-6 Astra sera d’abord déployé auprès d’un nombr

GPT-6 Astra peut découvrir des failles inédites et préparer leur exploitation seul

Par : Decrypt
4 septembre 2026 à 07:01
GPT-6 Astra peut découvrir des failles inédites et préparer leur exploitation seul

OpenAI ne présente pas GPT-6 Astra comme une simple mise à jour de modèle, mais comme une première incursion dans l’ère de l’intelligence artificielle générale. Sa promesse est aussi ambitieuse que risquée : exécuter seul des tâches professionnelles complexes, tout en possédant des capacités inédites de recherche et d’exploitation de failles informatiques.

GPT-6 Astra veut franchir le cap de l’autonomie professionnelle

Annoncé le 3 septembre 2026, GPT-6 Astra sera d’abord déployé auprès d’un nombre limité d’organisations. OpenAI décrit cette phase comme un déploiement contrôlé, avant une disponibilité progressive dans ChatGPT, l’API OpenAI et Amazon Bedrock.

Le positionnement du modèle est clair : Astra ne doit plus seulement produire une réponse à une question ou assister un utilisateur dans une tâche isolée. Il est conçu pour enchaîner plusieurs étapes, utiliser des outils, analyser des informations et mener à terme des missions qui demandent habituellement une expertise humaine.

Cette autonomie constitue le cœur de la promesse d’OpenAI. Dans un environnement professionnel, un modèle capable de raisonner sur une longue séquence d’actions pourrait, par exemple, analyser un problème technique, rechercher les informations pertinentes, écrire du code, tester une solution et corriger ses erreurs. La valeur ne se mesurerait alors plus au nombre de mots générés, mais au résultat obtenu avec un minimum d’intervention humaine.

La prudence reste toutefois nécessaire. Une capacité démontrée sur des évaluations contrôlées ne garantit pas une exécution fiable dans des environnements réels, où les données sont incomplètes, les objectifs ambigus et les erreurs parfois coûteuses.

Des scores élevés, mais difficiles à traduire en productivité

OpenAI revendique des performances particulièrement élevées sur plusieurs tests de référence. GPT-6 Astra obtient 57,9 % sur Terminal-Bench 4.0, une évaluation centrée sur l’exécution de tâches à partir d’une interface en ligne de commande. Il atteint également 96 % sur GPQA Diamond, qui mesure la capacité à répondre à des questions scientifiques complexes, et 91,5 % sur BrowseComp, consacré à la recherche d’informations sur le web.

Ces résultats dessinent le profil d’un modèle polyvalent : capable de raisonner sur des problèmes spécialisés, de naviguer dans des environnements techniques et de conduire des recherches approfondies. Le score obtenu sur GPQA Diamond est particulièrement notable, car ce type d’évaluation vise des questions conçues pour résister aux réponses superficielles et aux simples réflexes de mémorisation.

Mais les benchmarks ne constituent pas une mesure directe de l’efficacité au travail. Ils ne renseignent pas nécessairement sur la robustesse d’un modèle face à des consignes contradictoires, sur sa capacité à reconnaître une information fausse ou sur le coût total d’une tâche réalisée avec des outils externes.

La comparabilité des scores dépend aussi des conditions d’évaluation : version du test, accès ou non à certains outils, nombre d’essais autorisés et degré d’intervention humaine. Les chiffres publiés par OpenAI établissent donc une revendication de performance, davantage qu’une preuve indépendante de supériorité générale.

Le terme AGI reste une déclaration, pas un standard

En présentant Astra comme le modèle qui fait entrer OpenAI dans l’ère de l’AGI, l’entreprise franchit surtout un seuil discursif et stratégique. L’artificial general intelligence ne possède pas de définition opérationnelle universellement acceptée. Selon les critères retenus, elle peut désigner un système capable de réussir la plupart des tâches cognitives humaines, de travailler de manière autonome pendant de longues périodes ou de s’adapter à des domaines inconnus.

Les performances de GPT-6 Astra peuvent alimenter cette ambition, mais elles ne suffisent pas à elles seules à établir l’existence d’une intelligence générale. Le test décisif se situera dans la durée : Astra peut-il poursuivre un objectif pendant plusieurs heures ou plusieurs jours, gérer les imprévus, demander une clarification au bon moment et produire un résultat vérifiable sans supervision constante ?

Cette distinction est essentielle pour les entreprises. Un modèle très performant mais imprévisible peut nécessiter autant de contrôle humain qu’un système moins puissant. À l’inverse, un modèle légèrement moins performant, mais capable de signaler ses incertitudes et de respecter précisément les limites fixées, peut être plus utile dans un cadre professionnel.

Le niveau « Critical » place la cybersécurité au centre du lancement

L’élément le plus sensible de l’annonce concerne la cybersécurité. Dans son Preparedness Framework, OpenAI classe GPT-6 Astra au niveau « Critical ».

Cette qualification signifie que le modèle peut découvrir des failles inédites et concevoir des méthodes d’exploitation sans recevoir un guidage humain étape par étape. Autrement dit, Astra ne se limite plus à expliquer des vulnérabilités connues : il pourrait contribuer à identifier de nouveaux chemins d’attaque et à les transformer en procédures exploitables.

Pour la défense informatique, cette capacité peut accélérer l’audit de logiciels, la détection de vulnérabilités et la réponse aux incidents. Le même potentiel peut cependant être détourné par des acteurs malveillants. Un modèle capable d’automatiser une partie de la recherche de failles réduit mécaniquement le niveau d’expertise nécessaire pour préparer certaines attaques.

Le déploiement limité annoncé par OpenAI prend donc une signification particulière. Il ne s’agit pas uniquement d’une stratégie commerciale ou d’un moyen de contrôler la montée en charge. C’est aussi un test grandeur nature des garde-fous, de la surveillance des usages et de la capacité de l’entreprise à détecter les comportements dangereux avant une ouverture massive.

Le niveau « Critical » impose enfin une question de transparence : quelles évaluations ont conduit à cette classification, quels scénarios ont été testés et quelles protections empêchent l’accès à des usages offensifs ? Tant que ces éléments ne sont pas examinés par des évaluateurs indépendants, l’annonce repose principalement sur les déclarations et la documentation d’OpenAI.

Un prix qui favorise les workflows intensifs

GPT-6 Astra sera facturé 10 dollars par million de tokens en entrée et 50 dollars par million de tokens en sortie. Le tarif de sortie, cinq fois supérieur à celui de l’entrée, reflète le coût calculatoire associé à la génération de réponses longues et aux tâches de raisonnement.

Cette grille peut rendre le modèle accessible pour des requêtes ponctuelles, mais la facture dépendra surtout de la longueur des tâches et du nombre d’itérations nécessaires. Un agent qui consulte plusieurs sources, exécute du code, analyse des fichiers et corrige plusieurs fois son travail consommera bien davantage de tokens qu’une question classique.

La disponibilité dans ChatGPT, l’API OpenAI et Amazon Bedrock vise trois publics distincts : les utilisateurs finaux, les développeurs et les grandes entreprises déjà intégrées à l’écosystème cloud d’Amazon. La progression du déploiement sera donc aussi déterminante que les performances annoncées.

Le prochain test sera celui de la fiabilité, pas du score

GPT-6 Astra ouvre une phase où la question centrale ne sera plus seulement « que peut faire le modèle ? », mais « que peut-il faire seul, à quel coût et avec quel niveau de risque ? ».

Les prochains jalons seront concrets : élargissement de l’accès, réplication indépendante des résultats, mesure du taux d’intervention humaine dans les tâches professionnelles et publication de données plus détaillées sur les capacités en cybersécurité. C’est à cette condition que l’affirmation d’une entrée dans l’ère de l’AGI pourra dépasser le stade de la promesse.

OpenAI dévoile GPT-6-Astra, le nouveau modèle flagship de ChatGPT

Après plusieurs semaines de teasing, OpenAI dévoile GPT-6-Astra, son nouveau modèle d'intelligence artificielle et le successeur de la génération GPT-5. Présenté comme une avancée majeure pour ChatGPT, GPT-6 Astra doit permettre à OpenAI de reprendre l'avantage dans une course à l'IA toujours plus intense face à Anthropic et aux modèles open source.

ChatGPT ou Claude en panne ? Voici les meilleures alternatives en 2026

Il fut un temps où pour interagir avec une intelligence artificielle, on ouvrait naturellement ChatGPT. Mais en 2026, le chatbot d'OpenAI n'est plus seul sur son trône, et ses concurrents ont définitivement cessé de faire de la figuration. Voici les meilleures alternatives à utiliser.

  • ✇PandIA
  • Gemini 3.8 Flash Cyber corrige les failles seul, mais Google le réserve à quelques partenaires
    Un modèle capable de repérer une faille et de proposer son correctif n’est plus seulement un assistant de code : c’est un instrument opérationnel de cybersécurité. Google place cette capacité au centre de Gemini 3.8 Flash, dévoilé le 2 septembre 2026 avec une déclinaison Cyber à accès fortement contrôlé.Google fait de Flash un modèle orienté actionAvec Gemini 3.8 Flash, Google présente ce qu’il décrit comme son modèle le plus performant à ce jour pour le raisonnement, le code et les agents. Cett

Gemini 3.8 Flash Cyber corrige les failles seul, mais Google le réserve à quelques partenaires

Par : Vicomte
2 septembre 2026 à 19:01
Gemini 3.8 Flash Cyber corrige les failles seul, mais Google le réserve à quelques partenaires

Un modèle capable de repérer une faille et de proposer son correctif n’est plus seulement un assistant de code : c’est un instrument opérationnel de cybersécurité. Google place cette capacité au centre de Gemini 3.8 Flash, dévoilé le 2 septembre 2026 avec une déclinaison Cyber à accès fortement contrôlé.

Google fait de Flash un modèle orienté action

Avec Gemini 3.8 Flash, Google présente ce qu’il décrit comme son modèle le plus performant à ce jour pour le raisonnement, le code et les agents. Cette dernière catégorie est stratégique : elle désigne des systèmes capables d’enchaîner plusieurs étapes, d’utiliser des outils, d’examiner des fichiers ou d’exécuter des actions avec une supervision limitée.

Le modèle conserve le tarif d’introduction de Gemini 3.7 Flash : 0,75 dollar par million de tokens en entrée et 3,75 dollars par million de tokens en sortie. Cette politique tarifaire vise à maintenir Flash dans une zone de coût compatible avec les traitements intensifs, là où les modèles les plus avancés deviennent rapidement chers lorsqu’ils analysent de grandes bases de code ou de longs historiques d’incidents.

La tarification compte particulièrement dans la cybersécurité. Une analyse de vulnérabilités peut nécessiter l’examen de milliers de fichiers, de dépendances, de journaux et de configurations. Un modèle suffisamment abordable peut être sollicité en continu, au fil des nouvelles versions d’un logiciel, plutôt qu’à l’occasion d’un audit ponctuel.

Une déclinaison Cyber conçue pour corriger

La véritable annonce se trouve toutefois dans Gemini 3.8 Flash Cyber. Google destine cette version spécialisée à l’identification et à la correction autonomes de vulnérabilités. L’objectif n’est donc pas seulement de signaler une ligne de code suspecte, mais de relier plusieurs opérations : comprendre le fonctionnement d’une application, détecter un comportement dangereux, évaluer son exploitabilité, produire un correctif et vérifier que celui-ci ne dégrade pas le logiciel.

Cette approche rapproche le modèle du travail d’une équipe de sécurité logicielle. Dans un environnement de développement, Flash Cyber pourrait examiner du code source, des bibliothèques tierces, des fichiers de configuration ou des résultats de tests automatisés. Il pourrait ensuite générer une modification, lancer des tests et présenter une proposition de correction à un ingénieur.

Google ne présente pas cette capacité comme un accès ouvert au grand public. Gemini 3.8 Flash Cyber est réservé à des partenaires sélectionnés. Cette restriction est essentielle : un système capable de trouver des failles peut aussi fournir des indications exploitables à des attaquants, surtout lorsqu’il peut parcourir rapidement de vastes volumes de code.

La cyberdéfense devient un terrain de contrôle d’accès

Google lance parallèlement Fairwind, un programme qui accorde à des gouvernements et à des entreprises de confiance un accès limité à ces capacités de cyberdéfense. Le dispositif ressemble moins à une commercialisation classique qu’à un programme d’expérimentation sous surveillance.

Le choix des partenaires permettra à Google de contrôler les environnements d’utilisation, de sélectionner les cas d’emploi et d’observer les performances du modèle. Cette phase peut servir à mesurer plusieurs paramètres encore plus importants que la seule capacité à trouver une faille : taux de faux positifs, qualité des correctifs, temps moyen de remédiation, résistance aux erreurs de contexte et niveau de supervision humaine nécessaire.

Le terme « autonome » doit donc être interprété avec prudence. Dans un système de production, une correction générée par un modèle ne peut pas être déployée sans validation, tests de non-régression et contrôle de sécurité. Un correctif qui ferme une vulnérabilité mais introduit une nouvelle faiblesse, interrompt un service ou modifie un comportement métier critique n’est pas une réussite opérationnelle.

Fairwind pourrait précisément permettre de déterminer jusqu’où l’automatisation est fiable. La différence entre une démonstration technique et un outil utilisable à grande échelle se mesurera dans les environnements réels, face à des logiciels anciens, mal documentés et dépendants de systèmes hétérogènes.

Une course aux modèles spécialisés, mais sous restrictions

L’annonce intervient dans un contexte où les principaux laboratoires d’IA renforcent leurs garde-fous autour de leurs modèles les plus puissants. OpenAI et Anthropic restreignent eux aussi l’accès à certaines capacités avancées, en particulier lorsqu’elles peuvent être utilisées pour l’exploitation de vulnérabilités, l’automatisation d’attaques ou la recherche de failles à grande échelle.

Le mouvement est révélateur d’une tension structurelle. Les modèles capables de raisonner sur du code peuvent aider les défenseurs à analyser plus vite des logiciels complexes. Mais les mêmes compétences peuvent réduire le coût d’une opération offensive : cartographier une surface d’attaque, repérer des erreurs récurrentes ou adapter une méthode à plusieurs environnements.

La frontière entre défense et attaque ne dépend donc pas seulement du modèle, mais du contexte d’accès. Une entreprise qui fournit son propre code à Gemini 3.8 Flash Cyber peut chercher à corriger une faille avant sa publication. Un acteur malveillant qui obtient une capacité comparable pourrait l’appliquer à des logiciels largement déployés. Google choisit de répondre à ce risque par une combinaison de spécialisation et de distribution limitée, plutôt que par une mise à disposition générale.

Cette stratégie comporte aussi un enjeu de transparence. Les partenaires de Fairwind devront pouvoir démontrer que les usages autorisés correspondent bien à des objectifs de défense. La question portera sur la conservation des données, la confidentialité du code analysé, la traçabilité des actions du modèle et la responsabilité en cas de correctif défectueux.

Le prix bas accélère l’adoption, la restriction en fixe les limites

Le maintien du prix de 0,75 dollar en entrée et 3,75 dollars en sortie rend Gemini 3.8 Flash attractif pour les développeurs et les équipes de sécurité. À grande échelle, le coût d’analyse peut devenir inférieur à celui d’une partie des audits manuels, au moins pour les tâches répétitives : tri d’alertes, comparaison de versions, recherche de motifs dangereux ou génération de tests.

Mais le tarif ne garantit ni la pertinence ni la sécurité. Les vulnérabilités les plus difficiles sont souvent liées au contexte métier, aux interactions entre plusieurs services ou à des comportements qui n’apparaissent pas dans le code isolé. L’expertise humaine reste nécessaire pour hiérarchiser les risques et décider du déploiement d’un correctif.

Le prochain jalon sera donc concret : les résultats obtenus par les partenaires de Google avec Gemini 3.8 Flash Cyber. Le nombre de vulnérabilités confirmées, la proportion de correctifs acceptés sans réécriture majeure et la réduction mesurée du délai de correction permettront d’évaluer la portée réelle de l’annonce. Si ces indicateurs progressent sans hausse des erreurs ni exposition de données sensibles, Google pourra élargir Fairwind. Dans le cas contraire, l’accès restreint pourrait devenir la limite durable de cette nouvelle génération de modèles cyber.

  • ✇PandIA
  • Comment utiliser ChatGPT pour créer une macro Excel en 2026
    Utiliser ChatGPT pour créer une macro Excel en 2026Utiliser ChatGPT pour créer une macro Excel permet de générer du code VBA, d’automatiser des tâches répétitives et de corriger plus rapidement les erreurs. Ce guide explique comment demander une macro à ChatGPT, où coller le code, comment l’exécuter, la tester et la sécuriser, avec un exemple concret adapté à Excel en 2026.La méthode concerne principalement Excel installé sur Windows ou macOS, car les macros VBA ne s’exécutent pas directement da

Comment utiliser ChatGPT pour créer une macro Excel en 2026

Par : Decrypt
2 septembre 2026 à 12:06

Utiliser ChatGPT pour créer une macro Excel en 2026

Comment utiliser ChatGPT pour créer une macro Excel en 2026

Utiliser ChatGPT pour créer une macro Excel permet de générer du code VBA, d’automatiser des tâches répétitives et de corriger plus rapidement les erreurs. Ce guide explique comment demander une macro à ChatGPT, où coller le code, comment l’exécuter, la tester et la sécuriser, avec un exemple concret adapté à Excel en 2026.

La méthode concerne principalement Excel installé sur Windows ou macOS, car les macros VBA ne s’exécutent pas directement dans Excel pour le web. Pour un fichier utilisé dans un navigateur, Office Scripts peut constituer une meilleure solution.

Qu’est-ce qu’une macro Excel créée avec ChatGPT ?

Une macro Excel est un programme qui automatise une ou plusieurs actions dans un classeur : mettre en forme un tableau, filtrer des données, créer une feuille, importer un fichier CSV, générer un rapport ou envoyer un e-mail via Outlook.

Dans la majorité des cas, une macro Excel repose sur le langage VBA, pour Visual Basic for Applications. ChatGPT peut :

  • rédiger une macro VBA à partir d’une consigne ;
  • expliquer chaque ligne du code ;
  • adapter une macro à la structure d’un classeur ;
  • corriger une erreur d’exécution ;
  • ajouter des contrôles et des messages d’avertissement ;
  • convertir une logique Excel en VBA ;
  • générer un script Office Scripts pour Excel en ligne.

ChatGPT ne connaît toutefois pas automatiquement la structure exacte d’un fichier Excel. Une consigne vague comme « crée une macro pour mon tableau » produit souvent un code générique qui nécessite des adaptations.

Pourquoi utiliser ChatGPT pour générer une macro VBA ?

Gagner du temps sur les tâches répétitives

Une macro peut exécuter en quelques secondes des actions qui prendraient plusieurs minutes à chaque utilisation :

  • supprimer des lignes vides ;
  • harmoniser les formats ;
  • trier des données ;
  • regrouper des informations par client ;
  • produire un rapport mensuel ;
  • exporter plusieurs feuilles en PDF ;
  • renommer des fichiers ;
  • actualiser des tableaux croisés dynamiques.

Créer du code sans maîtriser complètement VBA

La connaissance des principes de base reste utile, mais il n’est pas nécessaire de mémoriser toute la syntaxe VBA. ChatGPT peut produire une première version à partir d’une description en français.

Le code généré doit cependant être lu, testé et contrôlé. Une macro peut fonctionner dans un classeur et échouer dans un autre si les noms de feuilles, les colonnes ou les formats diffèrent.

Corriger plus rapidement une erreur

Un message tel que « Erreur d’exécution 1004 » est souvent difficile à interpréter pour un débutant. ChatGPT peut analyser :

  • le message d’erreur ;
  • la ligne surlignée dans l’éditeur VBA ;
  • le contexte d’exécution ;
  • les noms des feuilles et des plages ;
  • les différences entre Windows, macOS et Excel pour le web.

La meilleure demande consiste à fournir le code complet, l’erreur exacte et l’action qui déclenche le problème.

VBA ou Office Scripts : quelle technologie choisir en 2026 ?

Choisir VBA pour Excel installé sur l’ordinateur

VBA reste adapté dans les situations suivantes :

  • le fichier est utilisé dans Excel de bureau ;
  • la macro doit manipuler plusieurs classeurs locaux ;
  • l’automatisation concerne Outlook ou d’autres applications Office ;
  • l’entreprise utilise déjà des fichiers `.xlsm` ;
  • le traitement dépend de fonctionnalités historiques d’Excel.

VBA fonctionne principalement dans les versions de bureau d’Excel sur Windows et macOS. Certaines fonctions spécifiques à Windows, comme les appels à l’API Windows ou certains contrôles ActiveX, ne sont pas compatibles avec macOS.

Choisir Office Scripts pour Excel sur le web

Office Scripts est généralement plus approprié lorsque :

  • le fichier est stocké dans OneDrive ou SharePoint ;
  • l’équipe travaille dans Excel pour le web ;
  • l’automatisation doit être intégrée à Power Automate ;
  • la compatibilité entre les environnements est importante.

Office Scripts utilise TypeScript. ChatGPT peut également générer ce type de script, mais il faut préciser explicitement dans la demande : « Génère un Office Script pour Excel sur le web, pas une macro VBA ».

Préparer la demande à envoyer à ChatGPT

La qualité du code dépend directement de la précision de la consigne. Une bonne demande doit décrire le contexte, les données, le résultat attendu et les limites à respecter.

Les informations à préciser

Avant de demander la macro, indiquer :

  1. La version d’Excel utilisée : Excel Microsoft 365, Excel 2021, Excel pour Mac ou Excel pour le web.
  2. La technologie souhaitée : VBA ou Office Scripts.
  3. Le nom des feuilles concernées.
  4. La ligne où commencent les en-têtes.
  5. Les colonnes utilisées, avec leur lettre ou leur nom.
  6. L’action à automatiser.
  7. Le résultat attendu.
  8. Les cas particuliers : cellules vides, doublons, dates invalides ou lignes protégées.
  9. Les éléments à ne pas modifier.
  10. Le niveau de sécurité souhaité : confirmation avant suppression, sauvegarde ou journal des actions.

Exemple de prompt efficace

Génère une macro VBA compatible avec Excel Microsoft 365 sur Windows. La feuille s’appelle « Ventes » et contient des en-têtes en ligne 1. Les données vont de la colonne A à la colonne H, mais le nombre de lignes varie. La macro doit détecter automatiquement la dernière ligne et la dernière colonne, mettre la ligne d’en-têtes en gras avec un fond bleu, ajuster automatiquement la largeur des colonnes et afficher un message à la fin. Elle ne doit supprimer aucune donnée. Ajoute une gestion d’erreur et explique où coller le code.

Cette formulation donne à ChatGPT suffisamment d’informations pour produire une première version exploitable.

Demander d’abord un plan

Pour les automatisations complexes, demander une explication avant le code :

Décris d’abord la logique de la macro étape par étape. Liste les hypothèses concernant les feuilles, les colonnes et les formats. Ne génère le code qu’après cette analyse.

Cette approche permet de détecter les mauvaises hypothèses avant de coller du code dans le classeur.

Exemple pratique : créer une macro de mise en forme

L’exemple suivant suppose que :

  • la feuille active contient un tableau ;
  • les en-têtes sont en ligne 1 ;
  • les données commencent en colonne A ;
  • la macro ne doit rien supprimer ;
  • la dernière ligne et la dernière colonne peuvent varier.

Pour faciliter la copie sans bloc de code, chaque ligne ci-dessous doit être placée sur une ligne distincte dans l’éditeur VBA :

  • `Sub MettreEnFormeRapport()`
  • `Dim ws As Worksheet`
  • `Dim derniereLigne As Long`
  • `Dim derniereColonne As Long`
  • `Dim celluleDerniere As Range`
  • `On Error GoTo GestionErreur`
  • `Set ws = ActiveSheet`
  • `If Application.WorksheetFunction.CountA(ws.Cells) = 0 Then`
  • `MsgBox "La feuille active est vide.", vbExclamation`
  • `Exit Sub`
  • `End If`
  • `Set celluleDerniere = ws.Cells.Find(What:="*", After:=ws.Cells(1, 1), LookAt:=xlPart, LookIn:=xlFormulas, SearchOrder:=xlByRows, SearchDirection:=xlPrevious, MatchCase:=False)`
  • `If celluleDerniere Is Nothing Then`
  • `MsgBox "Aucune donnée détectée.", vbExclamation`
  • `Exit Sub`
  • `End If`
  • `derniereLigne = celluleDerniere.Row`
  • `Set celluleDerniere = ws.Cells.Find(What:="*", After:=ws.Cells(1, 1), LookAt:=xlPart, LookIn:=xlFormulas, SearchOrder:=xlByColumns, SearchDirection:=xlPrevious, MatchCase:=False)`
  • `derniereColonne = celluleDerniere.Column`
  • `If ws.AutoFilterMode Then ws.AutoFilterMode = False`
  • `With ws.Range(ws.Cells(1, 1), ws.Cells(1, derniereColonne))`
  • `.Font.Bold = True`
  • `.Font.Color = RGB(255, 255, 255)`
  • `.Interior.Color = RGB(31, 78, 121)`
  • `.AutoFilter`
  • `End With`
  • `With ws.Range(ws.Cells(1, 1), ws.Cells(derniereLigne, derniereColonne))`
  • `.Borders.LineStyle = xlContinuous`
  • `End With`
  • `ws.Range(ws.Cells(1, 1), ws.Cells(1, derniereColonne)).EntireColumn.AutoFit`
  • `MsgBox "Mise en forme terminée.", vbInformation`
  • `Exit Sub`
  • `GestionErreur:`
  • `MsgBox "Une erreur est survenue : " & Err.Description, vbCritical`
  • `End Sub`

Cette macro utilise la feuille active. Pour éviter une erreur liée à la mauvaise feuille sélectionnée, remplacer `Set ws = ActiveSheet` par `Set ws = ThisWorkbook.Worksheets("Ventes")`, à condition que la feuille s’appelle bien « Ventes ».

Où coller le code VBA généré par ChatGPT ?

Afficher l’onglet Développeur

Dans Excel pour Windows :

  1. Ouvrir Excel.
  2. Cliquer sur Fichier.
  3. Sélectionner Options.
  4. Ouvrir Personnaliser le ruban.
  5. Cocher Développeur.
  6. Valider avec OK.

Dans Excel pour macOS, le chemin peut être différent selon la version, mais l’onglet Développeur s’active depuis les préférences du ruban.

Insérer la macro dans un module

  1. Ouvrir le classeur concerné.
  2. Appuyer sur Alt + F11 sous Windows. Sur Mac, utiliser le raccourci affiché par Excel ou passer par l’onglet Développeur.
  3. Dans l’éditeur Visual Basic, sélectionner le classeur.
  4. Cliquer sur Insertion, puis Module.
  5. Coller le code généré par ChatGPT.
  6. Enregistrer le fichier au format Classeur Excel prenant en charge les macros (*.xlsm).
  7. Fermer l’éditeur VBA.

Une macro placée directement dans le code d’une feuille ou dans `ThisWorkbook` peut fonctionner, mais un module standard est généralement plus simple pour une macro lancée manuellement.

Comment exécuter une macro Excel ?

Plusieurs méthodes sont disponibles.

Depuis l’onglet Développeur

  1. Revenir dans Excel.
  2. Cliquer sur Développeur.
  3. Sélectionner Macros.
  4. Choisir le nom de la macro.
  5. Cliquer sur Exécuter.

Avec un raccourci clavier

Dans la fenêtre des macros, cliquer sur Options et attribuer un raccourci. Éviter les raccourcis qui remplacent des commandes Excel courantes.

Avec un bouton dans la feuille

  1. Ouvrir Développeur.
  2. Cliquer sur Insérer.
  3. Choisir un bouton dans les contrôles de formulaire.
  4. Dessiner le bouton dans la feuille.
  5. Sélectionner la macro à associer.
  6. Renommer le bouton avec une action explicite, par exemple Mettre en forme le rapport.

Un bouton est pratique pour les utilisateurs qui ne souhaitent pas ouvrir la liste des macros.

Comment tester une macro générée par ChatGPT ?

Une macro ne doit pas être lancée directement sur le fichier original lorsqu’elle modifie ou supprime des données.

Méthode de test recommandée

  1. Créer une copie du classeur.
  2. Remplacer les informations confidentielles par des données fictives.
  3. Tester avec un petit tableau.
  4. Vérifier le résultat ligne par ligne.
  5. Tester une feuille vide.
  6. Tester des cellules manquantes ou des colonnes supplémentaires.
  7. Vérifier que les noms de feuilles correspondent au code.
  8. Tester plusieurs fois la macro pour détecter les effets indésirables.
  9. Contrôler la taille du fichier après exécution.
  10. Conserver une version non modifiée du classeur.

Pour examiner le code, placer un point d’arrêt dans l’éditeur VBA en cliquant dans la marge à côté d’une ligne. La touche F8 permet ensuite d’exécuter la macro instruction par instruction.

Comment demander à ChatGPT de corriger une erreur VBA ?

Une demande de correction utile doit contenir quatre éléments :

  • le code concerné ;
  • le texte exact du message d’erreur ;
  • la ligne surlignée par Excel ;
  • l’action effectuée au moment du problème.

Exemple de demande :

Cette macro VBA affiche « Erreur d’exécution 1004 » sur la ligne `Range("A1:H100").AutoFilter`. La feuille peut contenir moins de 100 lignes et le tableau commence parfois en colonne B. Explique la cause, propose une correction dynamique et renvoie la macro complète. Ne supprime aucune donnée.

Demander une macro complète corrigée réduit le risque de mélanger des fragments incompatibles.

Erreurs fréquentes à surveiller

  • Erreur 9 : le nom d’une feuille ou d’un classeur est incorrect.
  • Erreur 13 : incompatibilité de type, souvent liée à une date ou à une valeur vide.
  • Erreur 91 : un objet n’a pas été défini avec `Set`.
  • Erreur 1004 : plage incorrecte, feuille protégée ou action non valide.
  • Erreur de compilation : faute de syntaxe ou variable mal déclarée.
  • Macro introuvable : code placé dans le mauvais emplacement ou fichier enregistré au format `.xlsx`.

Consignes importantes à donner à ChatGPT

Pour obtenir un code plus fiable, ajouter des contraintes précises :

  • « N’utilise pas `Select` ni `Activate` sauf nécessité. »
  • « Ne supprime aucune ligne sans demander une confirmation. »
  • « Ajoute `Option Explicit`. »
  • « Utilise des variables typées. »
  • « Restaure le calcul automatique et la mise à jour de l’écran en cas d’erreur. »
  • « Ne modifie que la feuille nommée “Ventes”. »
  • « Ajoute un journal des actions dans une feuille appelée “Log”. »
  • « Explique les hypothèses du code. »
  • « Signale les fonctions incompatibles avec Excel pour Mac. »

Les instructions `Select` et `Activate` rendent souvent une macro plus fragile, car le résultat dépend de la feuille ou de la cellule sélectionnée au moment du lancement.

Sécurité : faut-il faire confiance à une macro générée par ChatGPT ?

Non. Une macro générée automatiquement doit être considérée comme du code non vérifié.

Risques possibles

Une macro peut :

  • supprimer ou écraser des données ;
  • modifier des fichiers présents sur l’ordinateur ;
  • envoyer des informations par e-mail ;
  • exécuter des commandes externes ;
  • ralentir fortement Excel ;
  • contenir une erreur logique difficile à détecter.

Il ne faut jamais demander à ChatGPT de traiter des données personnelles, commerciales ou confidentielles sans les anonymiser. Les règles de conservation et d’utilisation des données peuvent varier selon le compte, l’offre et les paramètres de l’organisation. Vérifier les conditions officielles du service utilisé avant de transmettre un fichier.

Bonnes pratiques

  • Ne jamais activer globalement toutes les macros.
  • Ouvrir avec prudence les fichiers reçus par e-mail.
  • Utiliser une copie du classeur pour les tests.
  • Refuser une macro dont le fonctionnement n’est pas compris.
  • Vérifier les instructions `Shell`, les accès fichiers et les envois Outlook.
  • Utiliser une signature numérique dans un contexte professionnel.
  • Placer les fichiers fiables dans un emplacement approuvé uniquement si la politique informatique l’autorise.

Combien coûte la création d’une macro avec ChatGPT ?

La génération du code peut être incluse dans une offre gratuite ou payante, selon le service, le compte et les limites en vigueur en 2026. Les tarifs et les quotas pouvant évoluer, consulter la page officielle de l’offre utilisée avant tout achat.

Le véritable coût dépend surtout de la complexité de l’automatisation :

  • une macro de mise en forme peut être préparée en quelques minutes ;
  • une importation de fichiers avec contrôles nécessite davantage de tests ;
  • un processus impliquant plusieurs classeurs, Outlook, des droits d’accès ou une journalisation peut demander une validation technique approfondie.

Le temps gagné à la génération du code ne remplace pas le temps de test, de documentation et de maintenance.

Quand éviter une macro VBA ?

VBA n’est pas toujours la meilleure solution. Une formule Excel suffit parfois pour une transformation simple. Power Query est souvent plus adapté à l’importation, au nettoyage et à la combinaison de fichiers. Power Automate convient davantage aux processus déclenchés automatiquement dans Microsoft 365.

Éviter VBA lorsque :

  • le fichier doit fonctionner dans Excel pour le web ;
  • plusieurs utilisateurs travaillent simultanément dans le même classeur ;
  • l’entreprise bloque les macros ;
  • l’automatisation concerne principalement des flux de données ;
  • une solution sans code serait plus facile à maintenir.

Avant de générer une macro, demander à ChatGPT :

Compare VBA, Office Scripts, Power Query et Power Automate pour cette automatisation. Présente les avantages, les limites et la solution la plus adaptée à Excel sur Windows, Mac et le web.

Prompts utiles pour aller plus loin

Importer plusieurs fichiers CSV

Génère une macro VBA qui parcourt tous les fichiers CSV d’un dossier sélectionné, importe les données dans une feuille « Import », ajoute le nom du fichier dans une colonne et ignore les fichiers déjà traités. Demande confirmation avant toute modification et ajoute une gestion d’erreur.

Nettoyer des données

Crée une macro VBA qui supprime les espaces inutiles dans les colonnes A à D, convertit les dates valides, signale les dates incorrectes dans une feuille « Erreurs » et ne supprime aucune ligne.

Produire un rapport

Génère une macro VBA qui regroupe les ventes par commercial à partir de la feuille « Données », crée une feuille « Rapport », ajoute les totaux et applique une mise en forme professionnelle. Le code doit fonctionner même si le nombre de lignes change.

Créer un Office Script

Écris un Office Script TypeScript pour Excel sur le web. La feuille « Ventes » contient les en-têtes en ligne 1. Le script doit détecter automatiquement la plage utilisée, appliquer un format de tableau et retourner un message de confirmation. Ne génère pas de VBA.

Points clés à retenir

  • ChatGPT peut générer une macro Excel VBA, mais le code doit toujours être vérifié.
  • Une consigne précise doit mentionner les feuilles, les colonnes, les lignes d’en-têtes et le résultat attendu.
  • Le code VBA se colle dans un module standard depuis l’éditeur Visual Basic.
  • Un fichier contenant une macro doit être enregistré au format `.xlsm`.
  • Excel pour le web n’exécute pas directement les macros VBA : Office Scripts constitue une alternative.
  • Tester la macro sur une copie avec des données fictives avant toute utilisation réelle.
  • Ne jamais activer aveuglément des macros provenant d’une source inconnue.
  • Pour les traitements de données, comparer VBA avec Power Query, Office Scripts et Power Automate.
  • La meilleure utilisation de ChatGPT consiste à générer une première version, à l’expliquer, à la tester puis à l’améliorer progressivement.
  • ✇PandIA
  • Trade Pokémon in FRLG with a Real, Unmodded Switch, From Your Own Computer
    FireRed and LeafGreen on Nintendo Switch Online trade over local wireless, the same way two real consoles do when they sit next to each other. Nothing about that goes through Nintendo's servers.So if a Linux machine can speak that wireless protocol, it can pretend to be the second Switch.That is exactly what frlg-ldn-trade does.With it you can:Trade any Pokémon into your save, in the real Trade Center, with the real animationSend Mystery Gift Wonder Cards to your console, and collect the gift fr

Trade Pokémon in FRLG with a Real, Unmodded Switch, From Your Own Computer

Par : Decrypt
2 septembre 2026 à 11:47
Trade Pokémon in FRLG with a Real, Unmodded Switch, From Your Own Computer

FireRed and LeafGreen on Nintendo Switch Online trade over local wireless, the same way two real consoles do when they sit next to each other. Nothing about that goes through Nintendo's servers.

So if a Linux machine can speak that wireless protocol, it can pretend to be the second Switch.

That is exactly what frlg-ldn-trade does.

With it you can:

  • Trade any Pokémon into your save, in the real Trade Center, with the real animation
  • Send Mystery Gift Wonder Cards to your console, and collect the gift from the delivery man

The Switch you play on stays completely stock. No mods, no custom firmware, no soldering.

This guide covers my exact setup: a MacBook (Apple Silicon) running Ubuntu in a VMware Fusion VM, with a €15 USB WiFi adapter.


1. What you need

Hardware

Item Notes
Switch or Switch 2 with FireRed/LeafGreen Via Nintendo Switch Online. Played far enough to unlock the Direct Corner (~20-40 min)
TP-Link Archer T3U USB WiFi adapter ~€15-20. USB ID 2357:012d, driver rtw88_8822bu
A Mac (or any computer) to run Linux I use a MacBook M4

Amazon link: https://link.amazon/B05qVHcIX

The adapter matters. Most WiFi chips cannot do what this needs. Two are proven:

Adapter Driver Reliability
TP-Link Archer T3U rtw88_8822bu High, recommended and the cheapest
ALFA AWUS036ACHM mt76x0u High
Realtek RTL8821CE (internal) rtw88_8821ce High

Known not to work: Intel AX200, Atheros AR9271.

Software

You need prod.keys dumped from a Switch. The protocol is encrypted and there is no way around it.

The console you play on stays stock, but the keys have to come from somewhere. If you don't have them, this project isn't for you yet.


2. Set up the Ubuntu VM

Install VMware Fusion, then create a new VM from the Ubuntu ARM64 ISO. Defaults are fine. 2 CPUs and 4 GB RAM is plenty.

Once Ubuntu is installed, plug in the Archer T3U and connect it to the VM:

VMware Fusion menu bar > Virtual Machine > USB & Bluetooth > Connect TP-Link 802.11ac WLAN Adapter

Then inside Ubuntu, check that Linux sees it:

lsusb | grep 2357

You should get:

Bus 001 Device 007: ID 2357:012d TP-Link Archer T3U [Realtek RTL8812BU]

And confirm the driver loaded. No driver install needed, rtw88_8822bu ships with the Ubuntu kernel:

lsmod | grep rtw88_8822bu
rtw88_8822bu           12288  0
rtw88_usb              32768  1 rtw88_8822bu
rtw88_8822b           229376  1 rtw88_8822bu

Find the interface name:

iw dev

3. Install the project

sudo apt update
sudo apt install -y git python3-venv python3-pip
git clone https://github.com/Decryptu/frlg-ldn-trade.git
cd frlg-ldn-trade
python3 -m venv .venv
./.venv/bin/pip install -r requirements.txt

Put your keys where the tools expect them:

mkdir -p ~/.switch
cp /path/to/prod.keys ~/.switch/prod.keys

Keep NetworkManager out of the way

This is the step people miss. The project creates temporary network interfaces mid-run.

NetworkManager grabs them and the connection dies with:

[Errno 114] Match already configured

Marking your WiFi card "unmanaged" is not enough. You have to exclude the interfaces by name:

sudo tee /etc/NetworkManager/conf.d/zz-ldn-unmanaged.conf > /dev/null <<'EOF'
[keyfile]
unmanaged-devices=interface-name:ldnclient;interface-name:ldn;interface-name:ldn-mon;interface-name:ldn-tap
EOF

sudo systemctl restart NetworkManager

Check everything

./scripts/preflight_pi.sh

Despite the name, it works on any Linux box, not just a Raspberry Pi. Every line should say OK.


4. Example 1: Mystery Gift

Your computer becomes a Wonder Card distributor. Your save needs Mystery Gift already unlocked.

On Linux, start the host:

sudo -E ./.venv/bin/python -u frlgmg_host.py \
  --gift beast-cutscene \
  --flag-id 1005 \
  --version firered \
  --client-ready-idle-frames 20

Wait for:

Hosting Mystery Gift. On the Switch choose Mystery Gift -> Wonder Cards -> Friend.
On the Switch: Mystery Gift > Wonder Cards > Friend

The console finds the host and pulls down the card. You'll see:

Console identified itself: 'YOURNAME' on FireRed, holding no Wonder Card
Mystery Gift server finished: Wonder Card sent
The console left LDN after confirming Mystery Gift close

Now walk into any Pokémon Center and talk to the delivery man to collect the gift.

Tip: --flag-id is the "receipt" flag. Once a save has received flag 1005, it won't take that gift again. Use a different number (1006, 1007, etc.) to receive it a second time.

5. Example 2: Trading, with Linux as the host

Here Linux runs the group and the Switch joins it.

You need at least two .pk3 files. These are the Pokémon in your computer's fake party.

One of them is what you'll trade away.

On Linux:

sudo -E ./.venv/bin/python -u frlgtrade_host.py \
  PARTY1.pk3 PARTY2.pk3 \
  --version firered \
  -o received.pk3

Wait for:

Hosting. Waiting for the console to join (ssid=..., channel 1).
Hosting Direct Corner. On the Switch choose Join Group.

On the Switch:

  1. Go to the 2nd floor of any Pokémon Center
  2. Talk to the third NPC (the one on the right), not the middle one. That's the Union Room and it will not see this host
  3. Pokémon Wireless Club > Trade Center > Yes
  4. Choose Join Group, and pick the group named PkCamp
  5. Walk to the trade table and sit down
  6. Pick your Pokémon, confirm, and watch the trade

By default the computer offers the second file you passed (PARTY2.pk3). Change it with --slot.

A successful run looks like this:

Trade-room entry complete; exchanging party data.
Party exchange complete; trade selection is active.
Received: #113 (#113)
Saved -> received.pk3 (pk3, 100B)
Save barriers complete; waiting for the Switch menu handoff to finish.
Final party refresh complete; waiting 5 seconds for the trade menu.
Switch CANCEL received; both players cancelled. Leaving the trade menu.
Both players left the room; closing the RFU link.

The Pokémon you received from the console is written to received.pk3.

Leaving cleanly

When the party list comes back after the trade, select Cancel > Yes on the Switch. Both sides then walk out of the room and the link closes properly. Don't just quit the game.

In French

If your game is in French, like mine:

  • Club sans fil Pokémon > Centre Troc > Oui
  • Rejoindre to join
  • Annuler > Oui to leave at the end

6. The other direction

The Switch can host and your computer can join instead:

sudo -E ./.venv/bin/python -u frlgtrade.py --live \
  -o received.pk3 PARTY1.pk3 PARTY2.pk3

Same NPC path on the console, but choose host instead of join, then accept PkCamp when it appears.

Both directions work. Hosting from Linux is the more reliable one, so start there.


7. Things that will bite you

  • Never pass --verbose to a live run. Its per-packet logging runs inside a frame-timed loop and the console will drop the connection. Use --capture FILE instead. It's safe.
  • Only one run on the radio at a time. Check with ps -ef | grep frlg before starting.
  • --client-ready-idle-frames 20 is needed for Mystery Gift on my console. The built-in default leaves the host silent for ~2 seconds and the console gives up after half a second.
  • Cross-version trading works. A host advertising --version leafgreen trades happily with a FireRed console. It's just a flag.
  • Language doesn't matter. My French FireRed accepted an English Wonder Card without complaint.
  • Runs sometimes fail halfway. Power-cycle nothing, just start over. It usually works on the next attempt.

8. Credit

This is a fork built on other people's work:

  • tornadus, the original trading core and the proof that any of this was possible
  • MercuryEnigma, Mystery Gift support and the Raspberry Pi deployment

My fork adds the Switch-hosted (joiner) direction and TP-Link Archer T3U support:

github.com/Decryptu/frlg-ldn-trade

There's a Discord for the wider effort. The long-term goal is things like an unofficial GTS and online battling for these games.


Nothing here touches Nintendo's servers, and the console never leaves stock firmware. It's two devices talking to each other over local wireless. One of them just happens to be a laptop.

  • ✇PandIA
  • Apple accuse Chang Liu d’avoir utilisé un schéma secret chez OpenAI, retrouvé sur son Mac
    Le conflit entre Apple et OpenAI quitte le terrain des déclarations publiques pour entrer dans celui de la preuve numérique. Dans un dépôt judiciaire daté du 31 août 2026, Apple affirme qu’un ancien ingénieur aurait utilisé chez OpenAI un schéma électrique confidentiel récupéré avant son départ — et qu’une tentative de suppression de traces aurait suivi l’ouverture de l’enquête.Un ancien ingénieur passé chez OpenAI avec un MacBook AppleAu centre du dossier figure Chang Liu, ancien ingénieur spéc

Apple accuse Chang Liu d’avoir utilisé un schéma secret chez OpenAI, retrouvé sur son Mac

Par : 0xMonkey
2 septembre 2026 à 07:01
Apple accuse Chang Liu d’avoir utilisé un schéma secret chez OpenAI, retrouvé sur son Mac

Le conflit entre Apple et OpenAI quitte le terrain des déclarations publiques pour entrer dans celui de la preuve numérique. Dans un dépôt judiciaire daté du 31 août 2026, Apple affirme qu’un ancien ingénieur aurait utilisé chez OpenAI un schéma électrique confidentiel récupéré avant son départ — et qu’une tentative de suppression de traces aurait suivi l’ouverture de l’enquête.

Un ancien ingénieur passé chez OpenAI avec un MacBook Apple

Au centre du dossier figure Chang Liu, ancien ingénieur spécialisé dans les systèmes électriques chez Apple. L’intéressé a quitté l’entreprise pour rejoindre OpenAI en janvier 2026, selon les éléments présentés dans la procédure.

Apple affirme que Liu a conservé après son départ un MacBook professionnel qui lui avait été confié dans le cadre de ses fonctions. L’entreprise aurait ensuite récupéré cet ordinateur et soumis son contenu à une analyse forensique, c’est-à-dire une expertise destinée à identifier les fichiers consultés, copiés ou transférés, ainsi que les traces laissées par les utilisateurs.

D’après Apple, cette analyse aurait mis au jour un schéma confidentiel de circuit utilisé dans le nouvel environnement professionnel de Liu. L’entreprise considère que ce document constitue une information protégée liée à ses produits et à ses travaux d’ingénierie. Elle accuse donc son ancien salarié d’avoir emporté des données sensibles puis de les avoir exploitées chez OpenAI.

La nature exacte du circuit concerné n’a pas été rendue publique. Apple ne détaille pas non plus, dans les éléments rapportés par TechCrunch et Axios, le produit auquel il serait destiné ni la manière précise dont le schéma aurait été intégré aux travaux d’OpenAI. Cette absence de détails limite, à ce stade, l’évaluation de la portée industrielle du document.

Apple affirme avoir trouvé plus qu’un simple fichier

L’argument d’Apple ne repose pas uniquement sur la présence supposée d’un schéma. La société soutient également que Liu et un autre salarié d’OpenAI auraient cherché à détruire ou altérer des preuves après l’ouverture de l’enquête.

Dans ce type de contentieux, la question de la spoliation de preuves peut devenir presque aussi importante que le vol initial allégué. Les tribunaux examinent notamment si les personnes concernées savaient qu’une enquête ou une procédure était engagée, si elles avaient l’obligation de préserver les données et si des fichiers, messages ou appareils ont été effacés par la suite.

Apple affirme que des actions destinées à faire disparaître des traces auraient été entreprises après le début de ses investigations. Le dépôt judiciaire ne permet toutefois pas, à lui seul, de déterminer si un tribunal a déjà établi l’existence d’une destruction intentionnelle de données. Pour l’instant, il s’agit de la version défendue par Apple dans une procédure contradictoire.

Le fait qu’un ordinateur professionnel ait été conservé après le départ de Liu donne néanmoins à l’affaire une dimension technique particulière. Les journaux de connexion, historiques de fichiers, métadonnées et copies locales peuvent permettre de reconstituer une chronologie plus précise qu’un simple échange de courriels. Ils peuvent aussi révéler des comportements indirects : consultation de documents, branchement d’un support externe ou synchronisation avec un compte personnel.

La bataille portera sur l’intention et la traçabilité

La défense devra probablement contester plusieurs points : la confidentialité réelle du schéma, la propriété des fichiers retrouvés, le rôle exact de Liu dans leur utilisation chez OpenAI et le lien entre le document présent sur le MacBook et les travaux menés après son recrutement.

La chaîne de conservation de l’ordinateur sera également déterminante. Apple devra pouvoir démontrer que les données ont été collectées et analysées selon une méthode fiable, sans modification susceptible d’affaiblir leur valeur devant le tribunal. De son côté, OpenAI pourrait chercher à établir que le document était accessible par d’autres canaux, qu’il ne correspondait pas à une technologie propriétaire ou qu’il n’a pas été utilisé dans un produit commercial.

OpenAI conteste et demande le rejet de la plainte

OpenAI rejette les accusations portées contre l’entreprise et demande le rejet de la plainte, selon les informations rapportées par Axios. Cette position ne constitue pas une reconnaissance des faits reprochés à Liu ni une conclusion judiciaire sur l’origine du schéma.

Le désaccord intervient dans un contexte de relation déjà tendue entre Apple et OpenAI. Les deux groupes coopèrent sur l’intégration de fonctionnalités d’intelligence artificielle dans les appareils Apple, mais leurs intérêts restent largement concurrents. Apple contrôle l’accès à plusieurs centaines de millions d’utilisateurs et cherche à renforcer ses capacités en IA directement dans ses systèmes. OpenAI, de son côté, dépend de partenariats de distribution tout en recrutant des profils capables de travailler sur des sujets matériels et logiciels avancés.

Cette affaire ajoute une dimension sociale et industrielle à cette rivalité. Elle ne concerne pas seulement la circulation d’un fichier : elle pose la question de la manière dont les entreprises protègent leurs savoir-faire lorsqu’un ingénieur passe chez un acteur technologique partenaire, voire concurrent sur certains segments.

Les transferts de salariés entre géants de la tech sont fréquents. Les contrats de confidentialité, les restrictions d’accès et les procédures de restitution du matériel visent précisément à limiter les risques lors d’un départ. Mais ces dispositifs deviennent plus difficiles à contrôler lorsque les collaborateurs utilisent plusieurs environnements numériques, des outils de synchronisation ou des plateformes d’IA capables d’ingérer des documents techniques.

Un dossier qui pourrait dépasser le cas Liu

Si Apple parvient à établir que le schéma confidentiel a été utilisé chez OpenAI et que des preuves ont été supprimées après le lancement de l’enquête, les conséquences pourraient dépasser les dommages réclamés dans cette procédure. Le dossier pourrait entraîner des demandes d’accès à d’autres appareils, comptes et communications liés au recrutement de Liu.

OpenAI devra alors clarifier le rôle du salarié concerné et de son collègue, ainsi que les mécanismes internes mis en place pour empêcher l’utilisation de données provenant d’un employeur précédent. Pour Apple, l’enjeu sera de transformer les éléments récupérés sur un MacBook en démonstration juridiquement exploitable d’un transfert de propriété intellectuelle.

Le prochain jalon attendu sera l’examen par le tribunal de la demande de rejet formulée par OpenAI et des arguments d’Apple sur la conservation des preuves. La procédure permettra surtout de mesurer si le schéma retrouvé constitue une information véritablement protégée et si les accusations de destruction de données reposent sur des éléments techniques suffisamment établis.

  • ✇PandIA
  • OpenAI affirme que ChatGPT Ads atteint 1 milliard de dollars annualisés en moins de 200 jours
    ChatGPT ne se contente plus d’attirer des utilisateurs : il commence à monétiser leurs conversations à une vitesse inattendue. Moins de 200 jours après le lancement de ses publicités, OpenAI affirme que ChatGPT Ads atteint déjà un rythme de revenus annualisé de 1 milliard de dollars.Un milliard de dollars à vitesse de croisièreL’annonce publiée le 31 août 2026 repose sur un indicateur à manier avec précision : le revenue run rate. OpenAI ne dit pas avoir encaissé 1 milliard de dollars au cours d

OpenAI affirme que ChatGPT Ads atteint 1 milliard de dollars annualisés en moins de 200 jours

Par : Decrypt
1 septembre 2026 à 19:01
OpenAI affirme que ChatGPT Ads atteint 1 milliard de dollars annualisés en moins de 200 jours

ChatGPT ne se contente plus d’attirer des utilisateurs : il commence à monétiser leurs conversations à une vitesse inattendue. Moins de 200 jours après le lancement de ses publicités, OpenAI affirme que ChatGPT Ads atteint déjà un rythme de revenus annualisé de 1 milliard de dollars.

Un milliard de dollars à vitesse de croisière

L’annonce publiée le 31 août 2026 repose sur un indicateur à manier avec précision : le revenue run rate. OpenAI ne dit pas avoir encaissé 1 milliard de dollars au cours des douze derniers mois. L’entreprise affirme que le niveau actuel de revenus, extrapolé sur une année, correspond à ce montant.

La nuance est importante. Ce rythme annualisé reflète une cadence observée à un instant donné, susceptible d’augmenter — ou de ralentir. Il ne constitue ni un chiffre d’affaires annuel réalisé, ni une garantie de revenus futurs. Dans le cas de ChatGPT Ads, il traduit néanmoins une adoption commerciale rapide pour une activité lancée quelques mois plus tôt.

Selon OpenAI, la plateforme publicitaire est déjà utilisée par des dizaines de milliers d’annonceurs. L’entreprise revendique également plus d’un milliard d’utilisateurs actifs chaque semaine sur ChatGPT. Ce dernier chiffre n’a pas été détaillé par région, type d’usage ou méthode de calcul, et relève de la communication de l’entreprise. Il donne toutefois une indication de la taille potentielle de l’inventaire publicitaire disponible.

À titre de comparaison, atteindre une cadence de 1 milliard de dollars en moins de 200 jours suppose que la publicité ne fonctionne pas comme un simple complément expérimental. OpenAI cherche déjà à en faire un pilier économique aux côtés des abonnements et des offres destinées aux entreprises.

L’accès libre-service s’étend à de nouveaux marchés

Le prochain accélérateur se trouve dans la distribution. OpenAI ouvre désormais l’achat de campagnes en self-service à l’Inde, à l’Europe, au Moyen-Orient et à l’Afrique du Nord.

Jusqu’ici, les dispositifs publicitaires pouvaient dépendre d’équipes commerciales, de contrats directs ou d’un accès limité à certains annonceurs. Le libre-service réduit cette friction : une entreprise peut créer, gérer et probablement ajuster ses campagnes sans passer par un intermédiaire humain chez OpenAI.

Cette extension géographique élargit considérablement le marché accessible. L’Inde combine une population numérique massive et une forte présence de petites entreprises. L’Europe offre un pouvoir d’achat important, mais impose un environnement réglementaire plus exigeant, notamment sur la protection des données et la transparence des publicités. Le Moyen-Orient et l’Afrique du Nord ajoutent des marchés hétérogènes, avec des langues, des habitudes de consommation et des niveaux de maturité numérique différents.

L’enjeu ne consiste donc pas uniquement à vendre davantage d’espaces. OpenAI doit aussi démontrer que son système peut cibler efficacement des audiences sans compromettre la confidentialité, la qualité des réponses ou la confiance des utilisateurs.

Une publicité insérée dans l’intention, pas seulement dans la page

Le potentiel de ChatGPT Ads tient à la nature de l’interface. Dans un moteur de recherche classique, l’annonceur se positionne autour de mots-clés ou de pages de résultats. Dans ChatGPT, l’utilisateur formule souvent un besoin plus explicite : choisir un ordinateur, organiser un voyage, comparer des logiciels ou trouver un prestataire.

Cette interaction fournit un signal d’intention particulièrement riche. Une publicité pertinente pourrait apparaître au moment où l’utilisateur passe de la recherche à la décision. C’est précisément ce qui attire les annonceurs — et ce qui rend le modèle sensible.

La frontière entre recommandation et promotion doit rester lisible. Si un produit est suggéré parce qu’il correspond à la demande de l’utilisateur, mais qu’il est en réalité mis en avant contre rémunération, l’étiquetage devra être immédiat et compréhensible. Dans une interface conversationnelle, une annonce mal signalée peut être perçue comme un conseil de l’assistant lui-même.

Le modèle économique dépendra de la confiance

Pour OpenAI, la difficulté consiste à monétiser ChatGPT sans dégrader l’expérience qui a permis sa croissance. Les utilisateurs viennent chercher des réponses, pas parcourir une succession de contenus sponsorisés. Une pression publicitaire excessive pourrait affaiblir la crédibilité du service, surtout dans les domaines où la recommandation implique une dépense importante.

Le risque est également technique. Le système doit éviter qu’un annonceur influence directement la réponse organique ou les priorités de l’assistant. La séparation entre contenu généré, résultats commerciaux et messages sponsorisés devra être suffisamment robuste pour résister aux tentatives de manipulation.

Les annonceurs, de leur côté, devront mesurer autre chose que les indicateurs traditionnels. Une impression ou un clic ne suffisent pas nécessairement dans une conversation. Les critères pertinents pourraient inclure la qualité de la recommandation, la progression vers un achat, le taux de conversion ou la capacité d’une campagne à apparaître dans un contexte réellement pertinent.

Cette évolution place ChatGPT face aux acteurs historiques de la publicité numérique. Google maîtrise l’intention exprimée dans la recherche, tandis que Meta dispose de signaux comportementaux et sociaux considérables. OpenAI ne possède pas le même historique de données personnelles. Son avantage potentiel repose plutôt sur le contexte sémantique des échanges et sur la formulation directe des besoins.

Une croissance spectaculaire, mais encore à confirmer

Le chiffre de 1 milliard de dollars annualisé marque un seuil symbolique. Il montre qu’un service d’IA générative peut attirer rapidement des budgets publicitaires, même après avoir suscité des interrogations sur la compatibilité entre assistance conversationnelle et annonces commerciales.

Mais plusieurs inconnues demeurent. OpenAI ne précise pas, dans cette annonce, le revenu effectivement encaissé depuis le lancement, le niveau moyen de dépense par annonceur, la part des campagnes automatisées ni la rentabilité de l’activité. Le nombre d’utilisateurs actifs hebdomadaires revendiqué ne permet pas non plus de déduire directement le volume d’impressions monétisables.

Le prochain indicateur décisif sera la conversion de ce rythme en résultats trimestriels ou annuels vérifiables. L’ouverture du libre-service à l’Europe, à l’Inde et à la région Moyen-Orient–Afrique du Nord doit fournir ce test à grande échelle. Si les annonceurs reconduisent leurs budgets et si les utilisateurs acceptent les formats proposés, ChatGPT Ads pourrait rapidement devenir une source de revenus comparable aux activités historiques d’OpenAI. Dans le cas contraire, le milliard annoncé restera surtout le reflet d’une montée en cadence précoce, plutôt qu’un revenu durable.

  • ✇PandIA
  • Comment utiliser Gemini dans Google Sheets en 2026
    Utiliser Gemini dans Google Sheets en 2026 permet de créer des formules, analyser des tableaux, résumer du texte et automatiser certaines tâches directement dans un fichier. Ce guide explique comment activer Gemini dans Sheets, quelles fonctions utiliser, quels prompts écrire, combien cela coûte et quelles précautions prendre avec les données.Qu’est-ce que Gemini dans Google Sheets ?Gemini dans Google Sheets est l’assistant d’intelligence artificielle de Google intégré au tableur. Il peut compre

Comment utiliser Gemini dans Google Sheets en 2026

Par : 0xMonkey
1 septembre 2026 à 12:06
Comment utiliser Gemini dans Google Sheets en 2026

Utiliser Gemini dans Google Sheets en 2026 permet de créer des formules, analyser des tableaux, résumer du texte et automatiser certaines tâches directement dans un fichier. Ce guide explique comment activer Gemini dans Sheets, quelles fonctions utiliser, quels prompts écrire, combien cela coûte et quelles précautions prendre avec les données.

Qu’est-ce que Gemini dans Google Sheets ?

Gemini dans Google Sheets est l’assistant d’intelligence artificielle de Google intégré au tableur. Il peut comprendre une consigne en langage naturel et s’appuyer sur les données d’une feuille pour proposer une action ou une réponse.

Selon le compte, l’édition Google Workspace et les fonctionnalités déployées, Gemini peut notamment :

  • générer une formule Google Sheets ;
  • expliquer une formule existante ;
  • résumer un tableau ou une colonne de commentaires ;
  • identifier des tendances et des anomalies ;
  • classer des données textuelles ;
  • créer une structure de tableau ;
  • proposer un graphique ;
  • suggérer des étapes de nettoyage des données ;
  • produire du texte à partir du contenu d’une cellule ;
  • utiliser la fonction `AI()` dans une cellule, lorsque celle-ci est disponible.

L’accès se fait généralement depuis le panneau latéral Gemini, accessible grâce à l’icône en forme d’étoile ou de scintillement située en haut à droite de Google Sheets.

Pourquoi utiliser Gemini dans Sheets ?

Google Sheets est particulièrement efficace pour les données structurées, les calculs et les tableaux. Gemini intervient surtout lorsque la tâche nécessite de comprendre du texte, de formuler une consigne ou d’interpréter un ensemble de données.

Les principaux avantages

Gain de temps : Gemini peut rédiger une formule ou analyser une colonne sans rechercher manuellement la syntaxe adaptée.

Accessibilité : une personne qui ne maîtrise pas les fonctions avancées de Sheets peut décrire son besoin en français.

Analyse de données : l’outil peut aider à repérer des tendances, des valeurs inhabituelles ou des regroupements pertinents.

Automatisation du texte : les commentaires clients, descriptions de produits, réponses d’enquête ou notes internes peuvent être résumés et catégorisés.

Aide à la visualisation : Gemini peut recommander un type de graphique adapté à un jeu de données.

Il reste toutefois un assistant. Les résultats générés doivent être vérifiés, en particulier pour les chiffres, les formules, les analyses commerciales et les informations sensibles.

Comment vérifier si Gemini est disponible dans Google Sheets en 2026 ?

La disponibilité dépend de plusieurs éléments :

  • le type de compte utilisé ;
  • l’abonnement Google Workspace ou Google AI ;
  • le pays et la langue ;
  • les paramètres définis par l’administrateur ;
  • le niveau de déploiement de la fonctionnalité ;
  • les éventuelles limites d’utilisation.

Vérification rapide

  1. Ouvrez Google Sheets depuis un navigateur récent.
  2. Connectez-vous avec le compte Google concerné.
  3. Ouvrez une feuille existante ou créez une nouvelle feuille.
  4. Cherchez l’icône Gemini en haut à droite.
  5. Cliquez dessus pour ouvrir le panneau latéral.

Si le panneau n’apparaît pas, plusieurs explications sont possibles :

  • le compte ne dispose pas d’un accès Gemini compatible ;
  • la fonctionnalité a été désactivée par l’administrateur ;
  • le déploiement n’est pas encore actif pour ce compte ;
  • le navigateur ou l’organisation bloque certaines fonctions ;
  • la fonctionnalité n’est pas disponible dans la langue ou la région sélectionnée.

Dans une entreprise, l’administrateur peut devoir activer les fonctions d’IA générative depuis la console d’administration Google Workspace. Les noms exacts des menus peuvent évoluer en 2026 : il est conseillé de rechercher les réglages associés à Gemini, à l’IA générative et aux fonctionnalités intelligentes de Workspace.

Comment ouvrir Gemini dans Google Sheets ?

L’utilisation de base se déroule en quelques étapes.

Étape 1 : préparer la feuille

Avant de solliciter Gemini, vérifiez la qualité des données :

  • utilisez une ligne d’en-têtes claire ;
  • évitez les colonnes sans nom ;
  • séparez les informations dans des colonnes distinctes ;
  • uniformisez les dates ;
  • supprimez les lignes complètement vides ;
  • évitez les cellules fusionnées dans la zone analysée ;
  • contrôlez les doublons et les valeurs incohérentes.

Une feuille bien structurée améliore la pertinence des résultats.

Étape 2 : sélectionner la zone utile

Sélectionnez la plage de données à analyser, par exemple `A1:H500`. Cette étape est importante : elle permet de limiter le contexte fourni à Gemini et de réduire les interprétations incorrectes.

Si la sélection contient des données confidentielles, vérifiez que l’utilisation de l’IA est autorisée par l’organisation.

Étape 3 : ouvrir le panneau Gemini

Cliquez sur l’icône Gemini. Un panneau latéral s’ouvre généralement à droite de la feuille.

La formulation et l’emplacement des boutons peuvent varier. L’interface peut afficher des suggestions comme :

  • analyser les données ;
  • créer un tableau ;
  • générer une formule ;
  • résumer la feuille ;
  • créer un graphique.

Étape 4 : écrire une consigne précise

Décrivez l’objectif, la plage de données et le format attendu. Par exemple :

Analyse la plage A1:F300. Identifie les trois produits qui génèrent le plus de chiffre d’affaires et explique les tendances observées en cinq points.

Pour une formule :

Écris une formule Google Sheets qui affiche « Élevé » si la valeur de B2 est supérieure à 1 000, « Moyen » entre 500 et 1 000, et « Faible » en dessous de 500. Explique la formule.

Étape 5 : contrôler puis appliquer le résultat

Gemini peut fournir une réponse, une formule ou une suggestion d’action. Lisez le résultat avant de l’insérer dans la feuille.

Ne validez pas automatiquement une modification portant sur une grande plage de données. Testez d’abord le résultat sur quelques lignes.

Comment rédiger de bons prompts pour Gemini dans Sheets ?

Un bon prompt contient généralement cinq éléments :

  1. Le rôle ou le contexte : commercial, analyste, responsable marketing ;
  2. La tâche : résumer, classer, calculer, comparer ;
  3. La source : plage ou colonne concernée ;
  4. Le format de sortie : tableau, liste, formule, phrase courte ;
  5. Les contraintes : langue, longueur, catégories autorisées.

Modèle de prompt efficace

À partir de la plage [plage], [effectue la tâche]. Retourne le résultat sous la forme de [format]. Réponds en français. N’invente aucune donnée absente du tableau.

Exemples de prompts pratiques

Résumé de commentaires clients :

Résume le commentaire de la cellule C2 en 15 mots maximum, en conservant uniquement le problème principal.

Classification :

Classe le texte de la cellule C2 dans une seule catégorie parmi Livraison, Produit, Facturation ou Autre. Retourne uniquement le nom de la catégorie.

Analyse commerciale :

Analyse la plage A1:G250. Compare les ventes par mois, repère les baisses supérieures à 10 % et présente les résultats dans une liste à puces.

Nettoyage de données :

Examine la colonne D et signale les valeurs qui ne respectent pas le format d’une adresse e-mail. Ne modifie aucune cellule.

Création d’un graphique :

À partir des colonnes Mois et Chiffre d’affaires, recommande le graphique le plus pertinent et explique brièvement pourquoi.

Formule conditionnelle :

Crée une formule qui renvoie « En retard » si la date en E2 est antérieure à aujourd’hui et que la cellule F2 n’est pas égale à « Terminé ».

Il est préférable de demander à Gemini de ne modifier que la zone indiquée. Cette précision limite les changements involontaires.

Comment générer une formule Google Sheets avec Gemini ?

Gemini peut aider à créer des formules simples ou complexes à partir d’une description en langage naturel.

Méthode avec le panneau latéral

  1. Sélectionnez la cellule dans laquelle la formule doit être placée.
  2. Ouvrez Gemini.
  3. Décrivez le résultat souhaité.
  4. Indiquez les colonnes et les conditions.
  5. Demandez une explication de la formule.
  6. Testez-la avec plusieurs cas, notamment les cellules vides et les erreurs.

Exemple de demande :

Dans la cellule G2, calcule le montant total en multipliant la quantité de B2 par le prix unitaire de C2, puis applique une remise de 10 % si la valeur de D2 est « Client premium ».

Gemini peut proposer une formule utilisant des fonctions comme `IF`, `SUMIF`, `COUNTIF`, `FILTER`, `QUERY`, `XLOOKUP` ou `ARRAYFORMULA`. La syntaxe doit cependant être vérifiée, car le séparateur d’arguments peut varier selon les paramètres régionaux de la feuille.

Bonnes pratiques pour les formules

  • Demandez une formule compatible avec Google Sheets, et non avec Excel.
  • Précisez la langue des fonctions si nécessaire.
  • Indiquez le comportement attendu pour les cellules vides.
  • Demandez une version avec gestion des erreurs.
  • Testez la formule sur des cas normaux et exceptionnels.
  • Préférez une formule classique pour les calculs déterministes.

Pour additionner une colonne, par exemple, une fonction standard comme `SUM` reste préférable à une réponse générée par IA. Gemini est utile pour écrire la formule, mais pas nécessaire pour remplacer les fonctions natives de calcul.

Comment utiliser la fonction AI() dans Google Sheets ?

Dans certains comptes éligibles, Google Sheets propose une fonction d’IA directement dans une cellule. Son nom et sa disponibilité peuvent varier selon le déploiement. Lorsqu’elle est activée, la syntaxe courante ressemble à :

`=AI("consigne", référence_ou_plage)`

La consigne indique ce que Gemini doit produire et la référence fournit le contenu à traiter.

Exemples

Pour résumer le contenu de A2 :

`=AI("Résume ce texte en une phrase de 20 mots maximum, en français.", A2)`

Pour classer un commentaire :

`=AI("Classe ce commentaire dans une seule catégorie : Positif, Négatif ou Neutre. Retourne uniquement la catégorie.", A2)`

Pour extraire une information :

`=AI("Extrait le nom de l’entreprise mentionnée dans ce texte. Retourne uniquement le nom.", A2)`

Pour traiter plusieurs colonnes :

`=AI("Rédige une courte description du produit à partir de son nom et de ses caractéristiques.", A2:C2)`

Selon l’interface, un bouton de génération ou de validation peut apparaître après la saisie. Il peut également être nécessaire de recopier la formule vers le bas pour traiter les lignes suivantes.

Limites de la fonction AI()

La fonction `AI()` n’est pas équivalente à une fonction mathématique classique :

  • son résultat peut varier ;
  • elle peut produire une formulation différente après recalcul ;
  • elle peut mal interpréter un texte ambigu ;
  • elle peut être soumise à des quotas ;
  • elle peut ne pas être disponible dans tous les comptes ;
  • elle n’est pas adaptée aux calculs financiers exacts.

Utilisez cette fonction pour résumer, classer, reformuler ou extraire du texte. Pour les totaux, les échéances et les contrôles numériques, privilégiez les fonctions natives de Sheets.

Comment analyser un tableau avec Gemini ?

Pour obtenir une analyse pertinente, préparez le tableau puis donnez un objectif précis.

Procédure recommandée

  1. Ajoutez des en-têtes explicites.
  2. Vérifiez que les colonnes numériques contiennent bien des nombres.
  3. Uniformisez les formats de date et de devise.
  4. Sélectionnez la plage complète, en incluant les en-têtes.
  5. Demandez une analyse ciblée.
  6. Demandez les limites ou les données manquantes.
  7. Contrôlez les chiffres avec un tableau croisé dynamique ou une formule.

Exemple :

Analyse la plage A1:J1 000. Repère les variations mensuelles, les cinq valeurs les plus élevées et les éventuelles anomalies. Sépare clairement les observations certaines des hypothèses.

Cette dernière précision est utile, car Gemini peut présenter une interprétation comme une conclusion alors que les données ne permettent pas de la confirmer.

Combien coûte Gemini dans Google Sheets en 2026 ?

Il n’existe pas un tarif unique applicable à tous les utilisateurs. Le coût dépend du compte :

  • compte Google personnel ;
  • abonnement Google AI éligible ;
  • édition Google Workspace ;
  • contrat professionnel ou scolaire ;
  • éventuel accès fourni par une organisation.

Les offres Google évoluent régulièrement et certaines fonctions peuvent être incluses dans une édition Workspace plutôt que vendues comme une option séparée. Des limites d’utilisation peuvent également s’appliquer.

Pour connaître le prix réel :

  1. identifiez le type de compte utilisé ;
  2. consultez la page officielle des offres Google Workspace ou Google AI ;
  3. vérifiez les fonctionnalités incluses dans l’édition ;
  4. demandez à l’administrateur si l’accès est géré par une entreprise ;
  5. contrôlez la devise et la facturation par utilisateur.

L’absence d’icône Gemini ne signifie pas forcément que la fonction est payante : elle peut aussi être désactivée, non déployée ou incompatible avec le compte.

Gemini dans Google Sheets est-il disponible en français ?

Gemini peut généralement recevoir des consignes en français et produire des réponses en français. Pour obtenir un résultat homogène, ajoutez explicitement :

Réponds uniquement en français.

Les noms de fonctions, les séparateurs et certains éléments de l’interface peuvent toutefois rester influencés par la langue ou la région du compte. Une formule générée en anglais peut nécessiter une adaptation avant utilisation.

Les capacités peuvent également différer selon les langues. Une fonction disponible en anglais peut être déployée plus tard dans une autre langue. La présence du panneau Gemini ne garantit donc pas que toutes les actions soient disponibles.

Quelles sont les limites et les risques ?

Risques d’erreur

Gemini peut :

  • inventer une explication ;
  • sélectionner une mauvaise colonne ;
  • produire une formule incorrecte ;
  • confondre une date et un nombre ;
  • tirer une conclusion excessive ;
  • oublier une ligne ou un filtre ;
  • mal classer un texte ambigu.

Toute donnée générée par IA doit être vérifiée avant publication, envoi ou prise de décision.

Données confidentielles

Évitez de transmettre à Gemini des informations sensibles sans validation préalable :

  • données de santé ;
  • coordonnées bancaires ;
  • mots de passe ;
  • données personnelles non nécessaires ;
  • informations protégées par un contrat ;
  • fichiers clients soumis à des règles particulières ;
  • données stratégiques de l’entreprise.

Dans un environnement professionnel, consultez la politique informatique et les réglages administrateur. Les règles de traitement, de conservation et d’utilisation des données peuvent dépendre de l’offre Google et du contrat de l’organisation.

Limites des décisions automatisées

Gemini peut aider à analyser des données, mais il ne devrait pas être l’unique outil pour :

  • accorder un crédit ;
  • recruter ou évaluer une personne ;
  • établir un diagnostic ;
  • valider une déclaration légale ;
  • calculer une paie ;
  • produire un résultat fiscal ;
  • interpréter un contrat.

Que faire si Gemini ne fonctionne pas dans Sheets ?

Le bouton Gemini n’apparaît pas

Vérifiez :

  • le compte connecté ;
  • l’abonnement ;
  • les autorisations de l’administrateur ;
  • la compatibilité du navigateur ;
  • la langue du compte ;
  • la disponibilité régionale ;
  • la présence d’une extension qui bloque les scripts.

Essayez également d’ouvrir la feuille dans une fenêtre de navigation privée ou dans un autre navigateur autorisé.

Gemini donne une mauvaise réponse

Rendez le prompt plus précis :

  • indiquez la plage exacte ;
  • donnez les noms des colonnes ;
  • imposez le format de sortie ;
  • fournissez un exemple ;
  • demandez de ne pas inventer de données ;
  • divisez une tâche complexe en plusieurs étapes.

La formule générée renvoie une erreur

Demandez une nouvelle version en précisant :

Utilise une syntaxe Google Sheets en français et gère les cellules vides ainsi que les erreurs.

Contrôlez ensuite le séparateur d’arguments, les références absolues comme `$A$2` et le format des dates.

La fonction AI() est inconnue

La fonction n’est peut-être pas activée pour le compte ou n’est pas encore proposée dans la version concernée. Utilisez le panneau Gemini si celui-ci est disponible et consultez l’aide Google Workspace pour vérifier l’éligibilité.

Quand utiliser Gemini et quand utiliser une formule classique ?

Gemini est particulièrement utile pour :

  • comprendre du texte libre ;
  • résumer des commentaires ;
  • créer des catégories ;
  • rédiger des descriptions ;
  • expliquer une formule ;
  • explorer rapidement un tableau ;
  • préparer une première analyse.

Les fonctions classiques sont préférables pour :

  • les additions ;
  • les moyennes ;
  • les recherches exactes ;
  • les contrôles de dates ;
  • les rapprochements comptables ;
  • les tableaux de bord reproductibles ;
  • les calculs qui doivent produire exactement le même résultat.

La meilleure approche consiste souvent à combiner les deux : Gemini pour concevoir ou expliquer, Google Sheets pour exécuter et vérifier.

Points clés à retenir

  • Gemini dans Google Sheets permet d’utiliser l’IA directement depuis une feuille.
  • L’accès dépend du compte, de l’abonnement, de l’administrateur et du déploiement en 2026.
  • Le panneau latéral sert à analyser les données, générer des formules et obtenir des suggestions.
  • La fonction `AI()` peut traiter du texte dans des cellules lorsqu’elle est disponible.
  • Les prompts doivent préciser la plage, la tâche, la langue et le format attendu.
  • Les fonctions natives restent plus fiables pour les calculs exacts.
  • Les résultats de Gemini doivent être contrôlés avant toute utilisation professionnelle.
  • Les données confidentielles ne doivent pas être transmises sans autorisation.
  • En cas de problème, vérifiez l’éligibilité du compte, les paramètres administrateur et la structure de la feuille.
  • ✇PandIA
  • Bruxelles place ChatGPT sous le régime le plus strict du DSA, OpenAI a quatre mois pour agir
    ChatGPT n’est plus traité par Bruxelles comme un simple assistant conversationnel. Avec son classement parmi les très grands moteurs de recherche en ligne (Very Large Online Search Engine, ou VLOSE), OpenAI entre dans le périmètre de contrôle le plus exigeant du Digital Services Act (DSA).Le seuil des 45 millions d’utilisateurs fait basculer ChatGPT dans une autre catégorieLa Commission européenne a annoncé, le 31 août 2026, la désignation de ChatGPT comme VLOSE au titre du DSA. Le déclencheur e

Bruxelles place ChatGPT sous le régime le plus strict du DSA, OpenAI a quatre mois pour agir

Par : Vicomte
1 septembre 2026 à 07:01
Bruxelles place ChatGPT sous le régime le plus strict du DSA, OpenAI a quatre mois pour agir

ChatGPT n’est plus traité par Bruxelles comme un simple assistant conversationnel. Avec son classement parmi les très grands moteurs de recherche en ligne (Very Large Online Search Engine, ou VLOSE), OpenAI entre dans le périmètre de contrôle le plus exigeant du Digital Services Act (DSA).

Le seuil des 45 millions d’utilisateurs fait basculer ChatGPT dans une autre catégorie

La Commission européenne a annoncé, le 31 août 2026, la désignation de ChatGPT comme VLOSE au titre du DSA. Le déclencheur est quantitatif : OpenAI a déclaré atteindre au moins 45 millions d’utilisateurs mensuels moyens dans l’Union européenne.

Ce seuil correspond à 10 % de la population européenne environ. Il ne s’agit pas d’une certification de fiabilité ni d’un jugement sur la qualité des réponses fournies par ChatGPT. Il marque le niveau d’audience à partir duquel un service numérique est considéré comme suffisamment influent pour générer des risques à l’échelle de la société européenne.

Le DSA distingue deux grandes catégories de services de très grande taille. Les très grandes plateformes en ligne (VLOP) regroupent les réseaux sociaux, places de marché ou plateformes de contenus. Les VLOSE concernent les moteurs de recherche. Le classement de ChatGPT dans cette seconde catégorie traduit une lecture précise de son usage : une part croissante des internautes s’en sert pour rechercher, trier et interpréter de l’information, même si le service repose sur un modèle génératif plutôt que sur une liste classique de liens.

La Commission a annoncé cette désignation dans le même communiqué que celles de Reddit et Roblox, deux services également soumis à des obligations renforcées au titre du DSA.

Une surveillance centrée sur les risques systémiques

La conséquence principale ne réside pas dans l’ajout d’un simple formulaire réglementaire. OpenAI devra désormais analyser de manière documentée les risques systémiques associés à ChatGPT et mettre en place des mesures pour les réduire.

Ces évaluations devront couvrir plusieurs domaines sensibles :

  • la diffusion de contenus illicites ;
  • la protection des mineurs ;
  • les atteintes aux droits fondamentaux ;
  • l’intégrité des élections et du débat public ;
  • la sécurité publique ;
  • les effets possibles des systèmes de recommandation et de classement de l’information.

Pour ChatGPT, l’exercice est particulièrement complexe. Un réseau social peut examiner une publication, son auteur et sa circulation. Un assistant génératif produit, lui, une réponse nouvelle à partir d’une requête, avec un risque qui dépend du contexte, de la formulation de l’utilisateur et de la capacité du modèle à résister aux tentatives de détournement.

La conformité ne consistera donc pas à vérifier manuellement chaque réponse. Elle devra porter sur l’ensemble de la chaîne : données et entraînement des modèles, dispositifs de sécurité, filtres, mécanismes de signalement, traitement des réclamations, conception des fonctionnalités et suivi des effets à grande échelle.

Cette distinction est importante. Le DSA ne transforme pas automatiquement ChatGPT en éditeur de chaque contenu généré. Il impose à son opérateur de démontrer que les risques prévisibles sont identifiés, suivis et effectivement atténués.

OpenAI dispose de quatre mois pour se mettre en conformité

La Commission accorde à OpenAI un délai de quatre mois, jusqu’à la fin décembre 2026, pour appliquer les obligations supplémentaires liées à cette désignation.

Le calendrier porte notamment sur la mise en place ou le renforcement :

  • d’une évaluation annuelle des risques systémiques ;
  • de mesures de réduction des risques adaptées aux mineurs et aux périodes électorales ;
  • de mécanismes plus accessibles pour signaler des contenus illicites ;
  • d’un traitement transparent des plaintes et des décisions de modération ;
  • d’audits indépendants ;
  • de rapports de transparence plus détaillés ;
  • de procédures permettant à des chercheurs habilités d’accéder à certaines données utiles à l’étude des risques.

Les obligations concernent aussi les changements futurs du service. Le lancement d’une nouvelle fonction de recherche, d’un agent capable d’effectuer des actions ou d’un outil multimodal pourrait devoir être évalué sous l’angle de ses effets systémiques avant son déploiement à grande échelle.

Le statut de VLOSE place par ailleurs ChatGPT sous la surveillance directe de la Commission européenne, plutôt que sous le seul contrôle des autorités nationales. Bruxelles pourra demander des informations, conduire des enquêtes et vérifier la réalité des mesures annoncées.

Le passage d’un produit d’IA à une infrastructure d’accès à l’information

La portée politique de la décision dépasse le cas particulier d’OpenAI. Elle confirme que le cadre européen ne regarde plus les assistants d’IA uniquement comme des logiciels ou des produits commerciaux. Dès lors qu’ils deviennent une porte d’entrée vers l’information pour des dizaines de millions de personnes, leurs effets sont évalués comme ceux d’une infrastructure numérique à risque systémique.

Cette approche cible plusieurs scénarios concrets. Une erreur répétée sur un sujet électoral peut toucher une population très large. Une réponse inadaptée destinée à un mineur peut produire un préjudice direct. Une instruction permettant de contourner des protections de sécurité peut être reproduite à grande échelle. Une présentation trop affirmative d’une information incertaine peut influencer des décisions médicales, financières ou politiques.

Le DSA ne garantit pas que ces risques disparaîtront. Il oblige en revanche OpenAI à les mesurer, à publier davantage d’éléments sur sa gestion et à accepter une forme de contrôle externe. C’est un déplacement significatif de la charge de la preuve : l’entreprise devra démontrer que ses garde-fous fonctionnent, et pas seulement affirmer qu’ils existent.

Le non-respect de ces obligations expose les très grands services à des sanctions pouvant atteindre 6 % du chiffre d’affaires mondial annuel de l’entreprise concernée. La Commission peut aussi imposer des mesures correctrices et, dans les situations les plus graves, demander une restriction temporaire du service, sous réserve de la procédure prévue par le règlement.

Le prochain test sera celui de la transparence

La première échéance concrète sera donc décembre 2026. La question ne sera pas seulement de savoir si ChatGPT dispose de nouvelles règles internes, mais si OpenAI pourra fournir des éléments vérifiables sur leurs résultats : taux de détection des abus, délais de traitement des signalements, protection effective des mineurs, évolution des erreurs liées aux élections et capacité à corriger rapidement les défaillances.

Cette désignation crée un précédent pour les autres assistants d’IA à forte audience. Si leurs usages européens franchissent le même seuil, ils pourront être soumis à une logique comparable. À terme, la mesure de conformité ne portera plus uniquement sur la puissance d’un modèle, mais sur son influence réelle dans la circulation de l’information.

Sources : Commission européenne ; Représentation de la Commission européenne en France.

  • ✇PandIA
  • Nvidia négocierait le rachat de Hugging Face pour 13 milliards, qui contrôlera l’open source ?
    L’acquisition de Hugging Face donnerait à Nvidia bien plus qu’une vitrine dans l’IA : un accès direct à l’infrastructure logicielle où sont téléchargés, testés et adaptés une grande partie des modèles open source. Selon plusieurs médias américains, le fabricant de puces négocierait une opération valorisée entre 12,9 et 13 milliards de dollars.Nvidia viserait la couche logicielle après avoir dominé les pucesLes discussions seraient suffisamment avancées pour envisager un rachat, mais aucun accord

Nvidia négocierait le rachat de Hugging Face pour 13 milliards, qui contrôlera l’open source ?

Par : Decrypt
31 août 2026 à 19:01
Nvidia négocierait le rachat de Hugging Face pour 13 milliards, qui contrôlera l’open source ?

L’acquisition de Hugging Face donnerait à Nvidia bien plus qu’une vitrine dans l’IA : un accès direct à l’infrastructure logicielle où sont téléchargés, testés et adaptés une grande partie des modèles open source. Selon plusieurs médias américains, le fabricant de puces négocierait une opération valorisée entre 12,9 et 13 milliards de dollars.

Nvidia viserait la couche logicielle après avoir dominé les puces

Les discussions seraient suffisamment avancées pour envisager un rachat, mais aucun accord définitif n’aurait encore été conclu. Le fondateur de Hugging Face, Thomas Wolf, n’a pas confirmé la transaction. Cette réserve laisse ouverte la possibilité d’un échec des négociations ou d’une modification de la valorisation.

L’enjeu dépasse toutefois le montant annoncé. Nvidia domine aujourd’hui le marché des processeurs graphiques utilisés pour entraîner et faire fonctionner les grands modèles d’IA. Avec Hugging Face, le groupe chercherait à renforcer sa présence sur la couche logicielle : celle qui permet aux développeurs d’accéder aux modèles, de les comparer, de les adapter et de les déployer.

Hugging Face s’est imposé comme une infrastructure centrale de l’écosystème open source. Sa plateforme héberge des modèles de langage, des jeux de données, des applications de démonstration et des bibliothèques de développement. Elle sert aussi bien aux chercheurs qu’aux start-up, aux grandes entreprises et aux administrations qui souhaitent exploiter des modèles existants sans repartir de zéro.

Le site fonctionne donc comme un point de rencontre entre les créateurs de modèles et leurs utilisateurs. Pour Nvidia, prendre le contrôle de cette interface offrirait une visibilité privilégiée sur les technologies adoptées par les développeurs, mais aussi sur les usages qui se développent en dehors des laboratoires des grands groupes.

Un achat stratégique face à la menace des puces alternatives

La domination de Nvidia repose principalement sur ses GPU, mais cette position devient aussi une vulnérabilité. Les grands modèles nécessitent des capacités de calcul considérables, et les clients les plus puissants cherchent à limiter leur dépendance à un seul fournisseur.

OpenAI et Anthropic, deux des acteurs les plus importants de l’IA générative, explorent notamment des solutions destinées à réduire leur exposition aux puces Nvidia. Cette recherche peut passer par des accords avec d’autres fabricants, par l’utilisation de processeurs spécialisés ou par la conception de composants adaptés à certains usages.

Dans ce contexte, Hugging Face représenterait une forme d’assurance stratégique. Même si les développeurs testent des modèles sur différents matériels, ils peuvent continuer à utiliser la plateforme pour les télécharger, les adapter et les partager. Le contrôle de cette distribution logicielle permettrait à Nvidia de rester présent dans les flux de développement, y compris lorsque le matériel utilisé n’est plus exclusivement le sien.

La logique est comparable à celle déjà suivie par les fabricants de puces dans d’autres secteurs : rendre les outils logiciels suffisamment importants pour que le choix du matériel soit influencé par leur compatibilité. Nvidia dispose déjà de l’écosystème CUDA, qui facilite l’exploitation de ses GPU pour l’entraînement et l’inférence. Hugging Face ajouterait une porte d’entrée beaucoup plus large, davantage tournée vers les modèles et les usages.

Un portefeuille complémentaire, mais pas sans risques

L’opération permettrait également de rapprocher deux communautés différentes. Nvidia travaille principalement avec les centres de données, les fabricants de serveurs et les entreprises qui déploient des infrastructures massives. Hugging Face bénéficie d’une implantation forte auprès des développeurs, des chercheurs et des projets open source.

Cette complémentarité pourrait accélérer la diffusion de certains modèles optimisés pour les GPU Nvidia. La plateforme pourrait aussi devenir un canal privilégié pour mettre en avant des outils de déploiement, des services cloud ou des solutions d’optimisation compatibles avec l’environnement du fabricant.

Mais l’acquisition comporterait un risque de défiance. Hugging Face doit une grande partie de son attractivité à son image de plateforme relativement ouverte et neutre. Son rachat par le principal fournisseur de puces pour l’IA pourrait susciter des interrogations chez les acteurs qui utilisent du matériel AMD, des accélérateurs Google ou des composants développés en interne.

La question de la gouvernance serait donc centrale. Nvidia devrait préserver la compatibilité avec un éventail de matériels et maintenir l’accès à des projets concurrents, faute de quoi les développeurs pourraient chercher d’autres canaux de distribution. Pour une plateforme dont la valeur repose sur l’effet de réseau, une perte de confiance pourrait réduire l’intérêt de l’acquisition.

Une valorisation qui souligne le poids pris par Hugging Face

Un prix proche de 13 milliards de dollars placerait Hugging Face parmi les actifs les plus convoités de l’industrie de l’IA. Cette valorisation reflète moins ses revenus actuels que sa position d’infrastructure : catalogue de modèles, communauté de développeurs, jeux de données et outils devenus difficiles à remplacer.

Elle traduit aussi la compétition pour les actifs situés entre les modèles propriétaires des grands laboratoires et les applications finales. Les groupes technologiques cherchent à sécuriser les briques intermédiaires capables de distribuer les modèles, d’orchestrer leur utilisation et de gérer leur déploiement en entreprise.

Pour Nvidia, le calcul est particulièrement important. La croissance des dépenses en GPU reste spectaculaire, mais elle attire les concurrents et encourage les clients à construire des alternatives. Détenir une plateforme utilisée par l’ensemble du secteur permettrait de capter une partie de la valeur même lorsque le matériel sous-jacent varie.

L’opération pourrait néanmoins attirer l’attention des autorités de la concurrence. Nvidia fait déjà l’objet d’un examen accru dans plusieurs pays en raison de sa position sur les accélérateurs d’IA. Un rachat de la principale plateforme de modèles open source renforcerait les interrogations sur la capacité du groupe à contrôler simultanément le matériel, les outils de développement et la distribution des modèles.

L’accord reste à confirmer

À ce stade, la transaction demeure donc hypothétique. Les discussions rapportées par TechRadar et Axios pourraient déboucher sur un accord, être renégociées ou s’interrompre. L’absence de confirmation de Thomas Wolf empêche de présenter le rachat comme acquis.

Le prochain jalon sera la confirmation formelle des négociations ou l’annonce d’un accord précisant le périmètre de l’opération. Si le montant de 12,9 à 13 milliards de dollars se confirmait, la question ne serait pas seulement financière : il faudrait surtout observer si Hugging Face conserve son ouverture technique et sa neutralité. C’est à cette condition que Nvidia pourrait transformer une plateforme communautaire en avantage durable, sans fragiliser l’écosystème qu’il cherche à contrôler.

  • ✇PandIA
  • Comment utiliser ChatGPT pour créer une facture en 2026
    Utiliser ChatGPT pour créer une facture en 2026 permet de générer rapidement un modèle personnalisé, de calculer les montants et de vérifier les mentions obligatoires. Toutefois, une facture conforme en 2026 doit être contrôlée par le vendeur et tenir compte des règles françaises, notamment de la réforme de la facturation électronique.Ce guide explique comment préparer les informations, rédiger un prompt efficace, vérifier les calculs, produire un document exploitable et éviter les erreurs fisca

Comment utiliser ChatGPT pour créer une facture en 2026

Par : Decrypt
31 août 2026 à 12:06
Comment utiliser ChatGPT pour créer une facture en 2026

Utiliser ChatGPT pour créer une facture en 2026 permet de générer rapidement un modèle personnalisé, de calculer les montants et de vérifier les mentions obligatoires. Toutefois, une facture conforme en 2026 doit être contrôlée par le vendeur et tenir compte des règles françaises, notamment de la réforme de la facturation électronique.

Ce guide explique comment préparer les informations, rédiger un prompt efficace, vérifier les calculs, produire un document exploitable et éviter les erreurs fiscales ou administratives.

Peut-on utiliser ChatGPT pour créer une facture en 2026 ?

Oui, ChatGPT peut aider à :

  • rédiger une facture à partir d’informations fournies ;
  • calculer les montants HT, la TVA et le total TTC ;
  • structurer les lignes de produits ou de prestations ;
  • créer un modèle réutilisable ;
  • repérer des mentions manquantes ;
  • préparer un contenu à copier dans Word, Google Docs, Excel ou un logiciel de facturation ;
  • générer un tableau ou un document téléchargeable si la fonctionnalité est disponible dans l’interface utilisée.

ChatGPT ne remplace toutefois pas un logiciel de facturation, un expert-comptable ou une plateforme agréée. Il peut inventer une information, appliquer un mauvais taux de TVA ou produire un document incomplet si les données transmises sont imprécises.

La facture générée doit donc être vérifiée avant son envoi au client.

Les informations à préparer avant de demander une facture à ChatGPT

Pour obtenir un résultat fiable, rassemblez les éléments suivants.

Les informations du vendeur

Préparez :

  • nom ou dénomination sociale ;
  • adresse complète ;
  • statut juridique ;
  • numéro SIREN ou SIRET ;
  • numéro de TVA intracommunautaire, si l’entreprise est redevable de la TVA ;
  • numéro RCS ou RNE lorsque cela s’applique ;
  • coordonnées de contact ;
  • adresse e-mail ;
  • coordonnées bancaires, si elles doivent figurer sur la facture.

Pour un entrepreneur individuel, la facture doit notamment faire apparaître le nom et la mention liée à l’entreprise individuelle, ainsi que le numéro SIREN. Les informations exactes dépendent du statut juridique et de l’activité.

Les informations du client

Indiquez :

  • nom ou raison sociale ;
  • adresse complète ;
  • adresse de facturation, si elle est différente ;
  • numéro de TVA intracommunautaire pour un client professionnel lorsque cela est requis ;
  • numéro SIREN ou autre identifiant professionnel, si nécessaire ;
  • adresse de livraison, lorsqu’elle diffère de l’adresse de facturation.

Évitez de transmettre à ChatGPT des données personnelles inutiles. Il est possible de remplacer temporairement le nom du client par « Client A », puis de le renseigner directement dans le document final.

Les informations relatives à la prestation

Il faut également préciser :

  • numéro de facture ;
  • date d’émission ;
  • date de livraison ou de réalisation de la prestation ;
  • description détaillée des produits ou services ;
  • quantité ;
  • unité de mesure ;
  • prix unitaire hors taxes ;
  • remise éventuelle ;
  • taux de TVA applicable ;
  • délai et conditions de paiement ;
  • mode de paiement accepté ;
  • éventuel acompte déjà versé.

Le numéro de facture doit suivre une séquence unique, chronologique et continue. Par exemple : `F-2026-0001`, puis `F-2026-0002`. Ne demandez pas à ChatGPT de choisir automatiquement un numéro sans vérifier le dernier numéro utilisé.

Comment créer une facture avec ChatGPT : méthode étape par étape

1. Déterminer le type de facture

Avant de rédiger le prompt, identifiez le document nécessaire :

  • facture classique ;
  • facture d’acompte ;
  • facture de solde ;
  • facture d’avoir ;
  • facture récurrente ;
  • facture destinée à un particulier ;
  • facture destinée à une entreprise ;
  • facture intracommunautaire ;
  • facture à l’export.

Les règles de TVA et les mentions peuvent différer selon le type de client et l’opération. Une facture d’avoir, par exemple, doit faire référence à la facture initiale concernée.

2. Rassembler les données sans laisser de champ ambigu

ChatGPT fonctionne mieux avec des données clairement séparées. Utilisez, par exemple, les rubriques suivantes :

  • Vendeur ;
  • Client ;
  • Facture ;
  • Prestations ;
  • TVA ;
  • Paiement ;
  • Mentions particulières.

Si une donnée est inconnue, demandez à ChatGPT de l’indiquer comme « À compléter » plutôt que de la deviner.

3. Utiliser un prompt précis

Voici un exemple de prompt à adapter :

Crée une facture professionnelle en français pour une entreprise située en France. Ne crée aucune information qui ne figure pas dans les données ci-dessous. Si une donnée obligatoire manque, indique clairement « À compléter » et liste les éléments manquants après la facture.
Vérifie les calculs HT, TVA et TTC. Présente les lignes dans un tableau avec la désignation, la quantité, le prix unitaire HT, le taux de TVA, le montant de TVA et le total TTC.
Vendeur : [nom, adresse, statut, SIREN/SIRET, TVA intracommunautaire]
Client : [nom, adresse, adresse de facturation, SIREN ou TVA si nécessaire]
Numéro de facture : [numéro]
Date d’émission : [date]
Date de réalisation ou de livraison : [date]
Prestations : [description, quantité, prix unitaire HT, taux de TVA]
Acompte déjà payé : [montant]
Date limite de paiement : [date]
Mode de paiement : [virement, carte, chèque, autre]
Conditions particulières : [informations]
Ajoute les mentions légales adaptées à la situation, mais signale séparément celles qui doivent être vérifiées. Ne prétends pas que la facture est juridiquement conforme sans validation humaine.

Ce prompt réduit le risque d’erreur et impose à l’outil de signaler les informations manquantes.

4. Demander une vérification distincte

Après la génération, envoyez une seconde instruction :

Vérifie cette facture comme un assistant administratif français. Contrôle la numérotation, les identités, les dates, les calculs HT/TVA/TTC, les mentions de paiement, la cohérence du taux de TVA et les éventuelles mentions d’exonération. Ne modifie rien sans expliquer l’erreur détectée.

Une seconde vérification est utile, mais elle ne dispense pas d’un contrôle humain. Un modèle d’intelligence artificielle peut reproduire une erreur présente dans les données initiales.

5. Exporter et mettre en page le document

Selon les fonctionnalités disponibles, ChatGPT peut produire un tableau, un texte structuré ou parfois un fichier. Le contenu peut ensuite être transféré vers :

  • Word ;
  • LibreOffice ;
  • Google Docs ;
  • Excel ou Google Sheets ;
  • un logiciel de comptabilité ;
  • un outil de facturation.

Vérifiez notamment :

  • la lisibilité du logo et des coordonnées ;
  • l’absence de texte coupé ;
  • la cohérence des alignements ;
  • la présence du numéro de facture sur chaque page ;
  • la visibilité du total TTC ;
  • la bonne ouverture du PDF ;
  • l’absence d’informations générées automatiquement par erreur.

Le PDF peut convenir pour de nombreuses factures classiques, mais il ne suffit pas nécessairement pour satisfaire les futures obligations de facturation électronique.

Les mentions obligatoires sur une facture en France en 2026

Les mentions exactes dépendent de l’activité, du client et du régime fiscal. Une facture professionnelle française contient généralement les éléments suivants.

Identification et dates

La facture doit comporter :

  • la mention « Facture » ;
  • un numéro unique ;
  • la date d’émission ;
  • la date de livraison ou d’exécution, lorsqu’elle est différente ;
  • les coordonnées complètes du vendeur ;
  • les coordonnées complètes du client ;
  • l’adresse de facturation, si nécessaire.

Description et prix

Chaque ligne doit préciser :

  • la nature du bien ou du service ;
  • la quantité ;
  • l’unité ;
  • le prix unitaire hors taxes ;
  • les réductions ou remises ;
  • le taux de TVA applicable ;
  • le montant hors taxes ;
  • le montant de TVA ;
  • le total toutes taxes comprises.

Une description trop vague comme « prestation » ou « services divers » peut être insuffisante. Préférez une formulation détaillée, par exemple : « Rédaction de trois articles SEO de 1 500 mots – forfait éditorial du mois de mars 2026 ».

Paiement et pénalités

La facture doit généralement indiquer :

  • la date d’échéance ;
  • les conditions de paiement ;
  • les moyens de paiement acceptés ;
  • les conditions d’escompte pour paiement anticipé ou la mention indiquant qu’aucun escompte n’est accordé ;
  • le taux des pénalités de retard ;
  • l’indemnité forfaitaire de 40 euros pour frais de recouvrement entre professionnels, lorsque la situation le permet.

Le taux des pénalités doit être actualisé et adapté au contexte. Il est déconseillé de demander à ChatGPT de fournir un taux sans vérifier la réglementation en vigueur en 2026.

Cas d’exonération ou de régime particulier

Si l’entreprise bénéficie de la franchise en base de TVA, la facture doit généralement comporter la mention :

« TVA non applicable, art. 293 B du CGI »

Cette mention ne doit pas être utilisée automatiquement. Elle dépend du régime fiscal réellement applicable.

D’autres mentions peuvent être nécessaires en cas de :

  • livraison intracommunautaire ;
  • autoliquidation de TVA ;
  • exportation ;
  • sous-traitance ;
  • activité artisanale soumise à une assurance obligatoire ;
  • régime de TVA sur les débits ;
  • facture d’acompte ;
  • facture d’avoir.

La facture électronique en 2026 : ce que ChatGPT ne peut pas garantir

La réforme française de la facturation électronique modifie progressivement les obligations des entreprises.

Selon le calendrier prévu, toutes les entreprises devront être capables de recevoir des factures électroniques à partir du 1er septembre 2026. À cette même date, les grandes entreprises et les entreprises de taille intermédiaire doivent commencer à émettre des factures électroniques dans le périmètre concerné. Les PME et microentreprises doivent, selon le calendrier prévu, émettre leurs factures électroniques à partir du 1er septembre 2027.

Les dates et modalités doivent être vérifiées sur les sources officielles, car le calendrier peut faire l’objet d’ajustements réglementaires.

Un PDF n’est pas toujours une facture électronique au sens de la réforme

Un simple PDF envoyé par e-mail est un document numérique, mais il ne constitue pas nécessairement une facture électronique conforme aux nouvelles obligations.

La réforme repose sur :

  • des données structurées ;
  • une transmission par une plateforme agréée ;
  • des formats compatibles avec les exigences réglementaires ;
  • des informations supplémentaires liées à l’opération et au statut des parties.

Des formats comme Factur-X, UBL ou CII peuvent être utilisés selon les situations et les outils. ChatGPT peut aider à structurer les informations, mais il ne garantit pas à lui seul :

  • la conformité du fichier XML ;
  • la signature ou l’intégrité du document ;
  • la transmission par la bonne plateforme ;
  • le respect des règles d’archivage ;
  • la compatibilité avec le logiciel comptable du destinataire.

Pour les entreprises concernées, le bon réflexe consiste à utiliser ChatGPT pour préparer le contenu, puis à transmettre la facture via un logiciel de facturation ou une plateforme agréée.

Comment demander à ChatGPT de calculer une facture sans erreur ?

Demandez toujours l’affichage séparé des montants :

  • total HT ;
  • total de TVA ;
  • total TTC ;
  • acompte déduit ;
  • solde à payer.

Exemple de consigne :

Recalcule chaque ligne avec une précision de deux décimales. Additionne les montants HT, calcule la TVA ligne par ligne, puis vérifie que le total TTC correspond au total HT augmenté de la TVA. Affiche les éventuels écarts d’arrondi.

La formule générale est :

  • Montant HT = quantité × prix unitaire HT
  • TVA = montant HT × taux de TVA
  • Montant TTC = montant HT + TVA
  • Solde à payer = total TTC – acompte déjà versé

Les erreurs d’arrondi peuvent apparaître lorsque plusieurs lignes sont additionnées. Le document final doit suivre la méthode de calcul utilisée par le logiciel comptable ou la caisse de l’entreprise.

Exemple de structure d’une facture créée avec ChatGPT

Une facture peut être organisée de cette manière :

En-tête

  • Logo ;
  • nom du vendeur ;
  • adresse ;
  • SIREN ou SIRET ;
  • numéro de TVA si applicable ;
  • coordonnées ;
  • titre « Facture ».

Bloc client

  • nom ou raison sociale ;
  • adresse ;
  • adresse de facturation ;
  • identifiant professionnel ou TVA, si nécessaire.

Informations de facturation

  • numéro ;
  • date d’émission ;
  • date de prestation ;
  • date limite de paiement.

Tableau des prestations

| Désignation | Quantité | Prix unitaire HT | TVA | Total HT |

|---|---:|---:|---:|---:|

| Prestation de conseil | 2 | 250 € | 20 % | 500 € |

Totaux

  • Total HT : 500 € ;
  • TVA à 20 % : 100 € ;
  • Total TTC : 600 € ;
  • Acompte : 0 € ;
  • Net à payer : 600 €.

Pied de page

  • conditions de paiement ;
  • pénalités de retard ;
  • indemnité forfaitaire de recouvrement ;
  • mention d’exonération ou d’autoliquidation ;
  • coordonnées bancaires, si souhaité.

Les données de cet exemple sont fictives et ne doivent pas être reprises telles quelles sur une facture réelle.

Les erreurs à éviter avec ChatGPT

Laisser l’outil inventer des informations

ChatGPT ne doit pas choisir à votre place :

  • un numéro SIRET ;
  • un taux de TVA ;
  • une date d’échéance ;
  • une identité client ;
  • une mention d’exonération ;
  • un numéro de facture ;
  • des coordonnées bancaires.

Demandez explicitement : « N’invente aucune donnée et signale tout champ manquant. »

Confondre devis et facture

Un devis accepté n’est pas automatiquement une facture. La facture doit correspondre à une opération réalisée ou à un acompte effectivement demandé, selon la situation.

Utiliser un mauvais taux de TVA

Le taux dépend de la nature du bien ou du service, du client, du lieu de l’opération et du régime fiscal. Le taux normal de 20 % ne s’applique pas à toutes les prestations.

Modifier une facture déjà envoyée sans laisser de trace

Une facture émise ne doit pas être supprimée ou remplacée de manière informelle. En cas d’erreur, il faut généralement établir un avoir ou une facture rectificative en conservant une piste d’audit.

Envoyer directement une facture générée sans contrôle

Relisez toujours :

  1. les coordonnées ;
  2. le numéro ;
  3. les dates ;
  4. les montants ;
  5. le taux de TVA ;
  6. le délai de paiement ;
  7. les mentions légales ;
  8. le nom du fichier ;
  9. le destinataire et la pièce jointe.

ChatGPT est-il suffisant pour gérer la facturation d’une entreprise ?

ChatGPT convient surtout pour :

  • une facture ponctuelle ;
  • un modèle simple ;
  • une activité indépendante avec peu de clients ;
  • la préparation d’un brouillon ;
  • la reformulation des descriptions ;
  • le contrôle préliminaire d’un document.

Un logiciel dédié devient préférable pour :

  • les factures récurrentes ;
  • la numérotation automatique ;
  • le suivi des paiements ;
  • les relances ;
  • les avoirs ;
  • la gestion de la TVA ;
  • l’archivage ;
  • la connexion avec la comptabilité ;
  • la facturation électronique via une plateforme adaptée.

Le coût de ChatGPT peut être nul ou dépendre de l’offre utilisée. En revanche, l’utilisation d’un logiciel de facturation ou d’une plateforme agréée peut entraîner un abonnement ou des frais supplémentaires.

Quand faut-il demander conseil à un professionnel ?

Demandez l’avis d’un expert-comptable ou consultez une source administrative officielle en cas de :

  • première facture avec TVA ;
  • vente à un client situé à l’étranger ;
  • autoliquidation ;
  • activité réglementée ;
  • sous-traitance ;
  • facture d’acompte importante ;
  • avoir complexe ;
  • contrôle fiscal ;
  • changement de régime de TVA ;
  • mise en conformité avec la facturation électronique.

ChatGPT peut accélérer la préparation d’une facture, mais la responsabilité du document transmis au client reste celle de l’entreprise.

Conclusion : les points clés à retenir

ChatGPT peut créer rapidement une facture en 2026, calculer les totaux et générer une présentation professionnelle. Pour obtenir un résultat fiable :

  • fournissez toutes les informations utiles ;
  • demandez à ChatGPT de ne rien inventer ;
  • vérifiez le numéro de facture et les dates ;
  • contrôlez les montants HT, TVA et TTC ;
  • ajoutez les mentions de paiement et les pénalités ;
  • vérifiez le régime de TVA ;
  • conservez une trace des factures émises ;
  • utilisez un logiciel ou une plateforme agréée pour les obligations de facturation électronique ;
  • faites valider les cas complexes par un professionnel.

Le meilleur usage consiste à considérer ChatGPT comme un assistant de préparation et de contrôle, et non comme le garant automatique de la conformité fiscale ou réglementaire de la facture.

  • ✇PandIA
  • Tencent Hy4 affiche 770 milliards de paramètres, mais n’en active que 49 milliards à la fois
    Un modèle de 770 milliards de paramètres, capable d’absorber plus d’un million de tokens tout en n’en mobilisant que 49 milliards à chaque passage : avec Hy4 preview, Tencent répond aux grands modèles occidentaux par une architecture géante, mais sélective. L’enjeu ne se limite pas à la taille affichée : il porte sur la capacité de la Chine à diffuser un modèle avancé sous forme ouverte et à l’intégrer directement dans ses produits.Tencent mise sur une architecture géante, mais parcimonieuseLe 2

Tencent Hy4 affiche 770 milliards de paramètres, mais n’en active que 49 milliards à la fois

Par : 0xMonkey
31 août 2026 à 07:01
Tencent Hy4 affiche 770 milliards de paramètres, mais n’en active que 49 milliards à la fois

Un modèle de 770 milliards de paramètres, capable d’absorber plus d’un million de tokens tout en n’en mobilisant que 49 milliards à chaque passage : avec Hy4 preview, Tencent répond aux grands modèles occidentaux par une architecture géante, mais sélective. L’enjeu ne se limite pas à la taille affichée : il porte sur la capacité de la Chine à diffuser un modèle avancé sous forme ouverte et à l’intégrer directement dans ses produits.

Tencent mise sur une architecture géante, mais parcimonieuse

Le 28 août 2026, Tencent a publié en open source la version preview de Hy4, un modèle doté de 770 milliards de paramètres au total. Ce volume le place dans la catégorie des modèles les plus imposants jamais rendus accessibles publiquement.

Cette taille ne signifie toutefois pas que les 770 milliards de paramètres sont sollicités pour chaque requête. Hy4 repose sur une architecture mixture-of-experts (MoE), qui répartit le traitement entre plusieurs sous-réseaux spécialisés. Un mécanisme de routage sélectionne les experts les plus pertinents selon la demande, avec seulement 49 milliards de paramètres activés à chaque passage.

Cette conception répond à une contrainte centrale des modèles géants : augmenter leur capacité sans multiplier dans les mêmes proportions le coût de chaque inférence. Hy4 conserve une réserve de connaissances et de compétences très large, tout en limitant la quantité de calcul mobilisée pour une requête donnée.

La nuance reste importante. Les 770 milliards de paramètres doivent toujours être stockés et distribués sur une infrastructure adaptée. L’activation parcimonieuse réduit la charge de calcul, mais ne supprime ni les besoins en mémoire, ni les contraintes de bande passante, ni les coûts liés au déploiement d’un tel système.

Plus d’un million de tokens pour travailler sur des corpus massifs

L’autre caractéristique mise en avant par Tencent est la fenêtre de contexte de Hy4, qui dépasse un million de tokens. Cette capacité permet théoriquement de traiter de très longs dépôts de code, des ensembles de documents administratifs, des dossiers scientifiques ou plusieurs semaines d’échanges au sein d’un même contexte.

Pour les entreprises, le bénéfice potentiel est concret : moins de découpage manuel des documents, davantage de continuité dans l’analyse et la possibilité de croiser des sources volumineuses en une seule session. Dans le développement logiciel, un modèle disposant d’un tel contexte peut examiner une large partie d’un projet plutôt qu’un fichier isolé. Dans la recherche scientifique, il peut exploiter simultanément des articles, des notes expérimentales et des jeux de données documentés en langage naturel.

Une fenêtre de contexte élevée ne garantit cependant pas que chaque information sera correctement retrouvée ou utilisée. La qualité dépend de la capacité du modèle à hiérarchiser les éléments pertinents au milieu d’un volume considérable de texte. Les performances réelles devront donc être évaluées sur des tests de long-context reasoning, et pas seulement sur la taille théorique de la fenêtre.

Une réponse chinoise au modèle fermé occidental

Avec Hy4, Tencent s’inscrit dans la compétition mondiale autour des modèles à très grande échelle, dominée par des acteurs américains proposant souvent des systèmes propriétaires accessibles principalement par API. La publication en open source vise à donner aux chercheurs, aux développeurs et aux entreprises un accès plus direct à l’architecture et au modèle.

Cette stratégie présente un intérêt particulier pour l’écosystème chinois. Elle peut favoriser l’évaluation indépendante, l’adaptation à des secteurs spécialisés et le déploiement sur des infrastructures contrôlées localement. Elle permet aussi à Tencent de transformer un modèle de recherche en plateforme technique utilisée par une communauté de développeurs.

Le label open source ne suffit toutefois pas à déterminer le degré réel d’ouverture. La licence, les conditions de redistribution, la disponibilité des poids, la documentation d’entraînement et les éventuelles restrictions commerciales seront déterminantes. Ces éléments permettront de mesurer la portée pratique de l’annonce au-delà du nombre de paramètres.

Aucun score de référence détaillé n’est mis en avant dans les éléments communiqués par Tencent. Il serait donc prématuré de conclure à une supériorité de Hy4 sur les modèles concurrents. Sa taille et sa fenêtre de contexte sont significatives, mais elles ne remplacent ni les évaluations de raisonnement, ni les tests de génération de code, ni les mesures de fiabilité et de sécurité.

Du modèle ouvert aux produits de Tencent

Tencent ne réserve pas Hy4 aux seuls chercheurs. Le groupe l’intègre également à plusieurs services : WorkBuddy, CodeBuddy, Yuanbao et son API.

Cette distribution donne à l’annonce une dimension commerciale immédiate. WorkBuddy peut servir de point d’entrée pour les tâches de bureautique, tandis que CodeBuddy cible directement les développeurs. Yuanbao fournit une interface grand public, et l’API permet aux entreprises d’intégrer Hy4 à leurs propres applications.

Tencent propose par ailleurs un accès gratuit pendant deux semaines sur certains services. Cette période d’essai doit permettre de mesurer l’adoption, mais aussi de recueillir des données d’usage sur les requêtes longues, la génération de code et les tâches documentaires. Elle constitue un test à grande échelle de la capacité de l’infrastructure Tencent à servir un modèle dont le nombre total de paramètres reste exceptionnel.

Le vrai test sera celui de l’usage

L’intérêt de Hy4 dépendra moins de son annonce que de son comportement en production. Les utilisateurs devront vérifier si le modèle conserve une bonne précision lorsque le contexte dépasse plusieurs centaines de milliers de tokens, s’il sait citer les bons passages et si le temps de réponse reste acceptable.

Le coût sera un autre facteur décisif. Les 49 milliards de paramètres actifs peuvent rendre l’inférence plus efficace qu’avec un modèle dense de taille comparable, mais les requêtes dépassant le million de tokens sollicitent fortement la mémoire et le stockage du contexte. Pour une entreprise, la question ne sera donc pas seulement « combien de paramètres sont activés ? », mais aussi « combien coûte une session complète et quel délai faut-il attendre ? ».

Une démonstration technique, avant une validation industrielle

Hy4 preview montre que Tencent entend rivaliser sur les deux axes qui structurent désormais la course aux modèles avancés : la capacité brute et l’efficacité du calcul. Avec 770 milliards de paramètres, 49 milliards activés par passage et une fenêtre supérieure à un million de tokens, le modèle affiche une combinaison ambitieuse.

Le prochain jalon sera la validation par les utilisateurs et les évaluateurs indépendants : qualité sur le code, robustesse en recherche scientifique, précision sur les documents longs, licence réellement exploitable et coût d’accès via l’API. La fin de la période gratuite de deux semaines, autour de la mi-septembre 2026 selon le calendrier annoncé, fournira un premier indicateur d’adoption. C’est à ce moment que Hy4 pourra être jugé non plus sur sa fiche technique, mais sur sa capacité à devenir un outil quotidien face aux modèles occidentaux propriétaires et aux autres initiatives ouvertes.

Sources : Tencent — Hy4 preview, Tencent Newsroom.

  • ✇PandIA
  • Sony et Warner accusent Anthropic d’avoir piraté des millions de paroles pour Claude
    Les paroles de chansons et les partitions deviennent le nouveau point de friction entre l’industrie musicale et les laboratoires d’intelligence artificielle. Sony Music Publishing, Warner Chappell et plusieurs autres éditeurs accusent Anthropic d’avoir organisé une vaste campagne de piratage pour alimenter ses systèmes, avec Dario Amodei et Benjamin Mann directement mis en cause.Une plainte fédérale visant Anthropic et ses dirigeantsLa plainte a été déposée le 28 août 2026 devant un tribunal féd

Sony et Warner accusent Anthropic d’avoir piraté des millions de paroles pour Claude

Par : Vicomte
30 août 2026 à 19:00
Sony et Warner accusent Anthropic d’avoir piraté des millions de paroles pour Claude

Les paroles de chansons et les partitions deviennent le nouveau point de friction entre l’industrie musicale et les laboratoires d’intelligence artificielle. Sony Music Publishing, Warner Chappell et plusieurs autres éditeurs accusent Anthropic d’avoir organisé une vaste campagne de piratage pour alimenter ses systèmes, avec Dario Amodei et Benjamin Mann directement mis en cause.

Une plainte fédérale visant Anthropic et ses dirigeants

La plainte a été déposée le 28 août 2026 devant un tribunal fédéral de Californie. Les éditeurs reprochent à Anthropic d’avoir téléchargé, partagé via des réseaux torrent et extrait illégalement des millions d’œuvres protégées par le droit d’auteur.

Le dossier ne porte donc pas uniquement sur l’utilisation de contenus disponibles en ligne. Les plaignants décrivent une opération structurée visant à obtenir des catalogues entiers de paroles, de partitions et d’autres éléments protégés, puis à les intégrer au développement de Claude, la famille de modèles d’Anthropic.

La plainte vise l’entreprise, mais aussi Dario Amodei, son directeur général, et Benjamin Mann, cofondateur et dirigeant du laboratoire. Cette mise en cause personnelle ajoute une dimension particulière au contentieux. Elle suggère que les éditeurs chercheront à démontrer que les décisions litigieuses relevaient de choix de direction, et pas seulement de pratiques techniques conduites par des équipes opérationnelles.

Les ayants droit réclament des dommages et intérêts, ainsi que des mesures destinées à empêcher l’utilisation de ces œuvres dans Claude. Le montant exact des dommages dépendra de la qualification retenue et du nombre d’œuvres concernées, mais le cadre juridique américain permet aux titulaires de droits de demander des réparations importantes en cas de violation délibérée.

Des accusations plus graves qu’un simple entraînement sur le web

Le débat sur les données utilisées pour entraîner les modèles d’IA porte généralement sur une question : des contenus accessibles en ligne peuvent-ils être copiés et analysés sans autorisation pour entraîner un système commercial ?

Le dossier Anthropic ajoute une accusation potentiellement plus lourde. Les éditeurs ne décrivent pas seulement une collecte automatisée de pages web. Ils parlent de contenus obtenus par des moyens assimilables au piratage, notamment le recours aux torrents et l’extraction de millions d’œuvres à partir de sources non autorisées.

Cette distinction pourrait peser dans la procédure. Une défense fondée sur le fair use, l’exception américaine permettant certains usages transformatifs d’œuvres protégées, est déjà complexe lorsqu’un modèle commercial absorbe de vastes corpus sans licence. Elle devient plus fragile encore si les données ont été obtenues illégalement.

Les plaignants cherchent également à établir un lien entre ces copies et les réponses générées par Claude. Un modèle peut produire une réponse originale sans reproduire directement un texte d’entraînement. Mais les systèmes génératifs peuvent aussi mémoriser et restituer des passages précis lorsque les données ont été répétées, fortement présentes ou insuffisamment filtrées.

Pour les éditeurs, la question ne se limite donc pas à savoir si Claude peut réciter une chanson entière. Elle concerne aussi la capacité du modèle à fournir des extraits, à compléter des paroles, à identifier des structures musicales ou à générer du contenu très proche d’une œuvre existante.

Pourquoi l’industrie musicale ouvre un nouveau front

Les éditeurs de musique disposent d’un portefeuille de droits particulièrement sensible. Les paroles sont souvent exploitées séparément des enregistrements, tandis que les partitions relèvent de droits distincts. Une entreprise d’IA peut donc être confrontée à plusieurs catégories de titulaires pour une même œuvre : auteur, éditeur, label et détenteur de l’enregistrement.

La plainte de Sony Music Publishing et Warner Chappell élargit le contentieux au-delà des sociétés spécialisées dans la génération musicale. Les poursuites déjà engagées contre Suno et Udio portent principalement sur des services capables de produire des morceaux dans le style de la musique existante. Anthropic, lui, développe un assistant généraliste. Claude n’est pas présenté comme une plateforme de création musicale, mais il peut traiter, résumer, transformer ou générer des paroles.

Cette différence est stratégique. Les majors cherchent à faire reconnaître que le risque ne vient pas uniquement des modèles qui composent ou imitent des chansons. Un assistant textuel peut lui aussi exploiter une valeur éditoriale considérable s’il a été entraîné sur des paroles et des partitions protégées.

Le procès pourrait ainsi étendre la pression juridique à l’ensemble des laboratoires d’IA générative. La question ne serait plus seulement celle de la licence d’entraînement, mais aussi celle de la provenance des fichiers utilisés pour constituer les corpus.

Anthropic face à un risque juridique et commercial

Pour Anthropic, l’enjeu dépasse le montant d’une éventuelle condamnation. Une décision défavorable pourrait imposer un audit des données d’entraînement, la suppression de certains corpus ou la mise en place de filtres destinés à empêcher la restitution d’œuvres protégées.

Une telle procédure serait techniquement lourde. Les modèles ne conservent pas nécessairement une copie lisible de chaque document de leur corpus. Identifier l’origine d’une sortie, mesurer la mémorisation et retirer l’influence d’un contenu après entraînement restent des opérations difficiles. Les éditeurs pourraient néanmoins demander des mécanismes de contrôle, des restrictions sur certaines requêtes et des accords de licence pour les usages futurs.

L’affaire peut aussi peser sur les relations d’Anthropic avec ses clients professionnels. Les entreprises qui intègrent Claude dans leurs produits cherchent à limiter leur exposition aux risques de propriété intellectuelle. Des accusations de collecte illégale à grande échelle pourraient renforcer la demande de garanties contractuelles, d’indemnisation et de traçabilité des données.

La mise en cause de Dario Amodei et de Benjamin Mann renforce enfin la portée réputationnelle du dossier. Même en l’absence de responsabilité personnelle retenue par le tribunal, leur présence dans la plainte place la gouvernance des données au centre du débat.

Le prochain jalon sera la réponse d’Anthropic

Anthropic devra d’abord répondre formellement à la plainte et contester, ou non, la description des méthodes de collecte avancée par les éditeurs. La bataille portera probablement sur trois points : l’existence d’une copie illégale, l’utilisation effective de ces contenus dans Claude et la capacité des œuvres générées à reproduire une expression protégée.

Le dossier pourrait ensuite devenir un test majeur pour le régime américain du droit d’auteur appliqué aux modèles généralistes. Si les éditeurs obtiennent des mesures restrictives, les laboratoires devront probablement documenter plus précisément leurs sources et négocier davantage de licences. S’ils échouent, les ayants droit disposeront d’un précédent moins favorable face aux pratiques de collecte à grande échelle.

Une conséquence mesurable apparaît déjà : les procès contre Anthropic, Suno et Udio installent les licences musicales parmi les postes de risque centraux de l’IA générative. La prochaine étape attendue est la réponse judiciaire d’Anthropic, qui dira si cette affaire restera un conflit sur des corpus précis ou deviendra un affrontement de référence sur la légalité de l’entraînement des modèles.

❌
❌