Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hierinformatique général
  • ✇Korben
  • Speakr - Interrogez toutes vos réunions enregistrées
    Vous avez un dossier plein d'enregistrements de réunions, d'entretiens ou de notes vocales que vous avez dictées en marchant, et vous ne les avez jamais réécoutés. Forcément, réécouter doit se faire en temps réel, et un fichier baptisé REC_20260812_143301.m4a ne permet pas forcement de savoir de quoi ça cause... Alors que faire ? Hé bien le projet Speakr s'attaque exactement à ce problème. Vous y déposez vos fichiers, ou vous enregistrez directement depuis le navigateur en captan

Speakr - Interrogez toutes vos réunions enregistrées

Par : Korben ✨
4 septembre 2026 à 14:30

Vous avez un dossier plein d'enregistrements de réunions, d'entretiens ou de notes vocales que vous avez dictées en marchant, et vous ne les avez jamais réécoutés. Forcément, réécouter doit se faire en temps réel, et un fichier baptisé REC_20260812_143301.m4a ne permet pas forcement de savoir de quoi ça cause... Alors que faire ?

Hé bien le projet Speakr s'attaque exactement à ce problème. Vous y déposez vos fichiers, ou vous enregistrez directement depuis le navigateur en captant le micro, le son du système, ou les deux mélangés. Et en sortie, vous récupérez un texte en clair, cherchable, découpé par intervenant, avec un résumé et les actions à retenir.

Et si vous cliquez sur une ligne du texte transcrit, la lecture se lancera à cet instant précis. Mais Speakr va encore plus loin grâce à sa fonctionnalité Inquire. Grâce à ça, plus besoin de farfouiller dans un enregistrement. Vous posez simplement une question à toute la bibliothèque d'un coup du genre "qu'est-ce qu'on avait décidé sur le tarif, et qui n'était pas d'accord ?".

Un mode agent optionnel, encore en bêta, va même lire les enregistrements concernés un par un avant de répondre, avec des liens numérotés qui ouvrent chaque extrait à la seconde citée. Et chacun décide si ses résumés et ses notes privées sont lisibles par cet agent.

Reste la question qui fâche, parce que le projet se vend comme un truc auto-hébergé, donc privé. Et en creusant un peu, je me suis rendu compte qu'il y avait quand même des choses qui sortaient de la machine. Il y a d'abord la transcription, qui envoie l'audio au moteur qui le transforme en texte. Et celui du texte ensuite, qui expédie la transcription au modèle qui écrit les résumés, les titres et les réponses du chat.

Et dans la configuration de base, les deux usages IA pointent chez un tiers : une clé OpenAI pour l'audio, une clé OpenAI (ou OpenRouter) pour le texte. Votre serveur, lui, ne stockera que des fichiers...

Alors, il faudra bien penser, si vous voulez que ça reste en local, à brancher Ollama à la place d'OpenAI et OpenRouter. Mais couper celui de l'audio se paiera car pour réussir à transcrire de l'audio, il vous faudra quand même une bonne carte graphique et un gros modèle Whisper comme expliqué dans le guide d'installation .

Sans carte, ça tourne quand même, rassure-vous, mais ce sera plus lent.

Pour le reste, c'est du Docker avec SQLite ou PostgreSQL, 2 Go de RAM annoncés pour l'application seule, et tout ce qu'on attend d'un truc qui s'utilise à plusieurs : comptes, authentification unique, partages, API et webhooks signés.

C'est sous licence AGPLv3, doublée d'une licence commerciale pour ceux qui ne veulent pas s'y contraindre.

Niveau outils semblables, il y a Scriberr, dont je vous ai déjà parlé , transcrit en local sans jamais rien envoyer dehors, mais son auteur vient d' annoncer une pause dans le développement . On a aussi l'application Meetily , qui elle, vise le poste de travail plutôt que le serveur d'équipe, et réserve la séparation des voix à son offre payante. Et si c'est de la dictée en direct sur Mac dont vous avez besoin plutôt que d'exploiter des enregistrements déjà faits, j'ai codé Kassis pour ça, qui reste en local lui aussi.

Alors finalement, pourquoi ne pas donner sa chance à Speakr ?

  • ✇Korben
  • 13 To de données de Steam ont fuité
    Pendant des années, un point d'accès de l'ancienne infrastructure de Steam est resté ouvert au public sans que personne ne s'en aperçoive. Des individus ont fini par le trouver, et ils en ont extrait entre 12 et 13 téraoctets de fichiers couvrant tout ce qui a transité par la boutique entre 2003 et 2013. La communauté a déjà baptisé l'affaire le Teraleak. Aucune effraction dans l'histoire. Ces serveurs dataient de l'époque où Valve distribuait ses jeux dans des formats maison, avant de basculer

13 To de données de Steam ont fuité

2 septembre 2026 à 14:32

Pendant des années, un point d'accès de l'ancienne infrastructure de Steam est resté ouvert au public sans que personne ne s'en aperçoive. Des individus ont fini par le trouver, et ils en ont extrait entre 12 et 13 téraoctets de fichiers couvrant tout ce qui a transité par la boutique entre 2003 et 2013. La communauté a déjà baptisé l'affaire le Teraleak.

Aucune effraction dans l'histoire. Ces serveurs dataient de l'époque où Valve distribuait ses jeux dans des formats maison, avant de basculer sur le système SteamPipe en mars 2013, et ils ont simplement été oubliés là avec leur contenu.

Le Graal se cache dans une vieille version de Portal 2. Les fouilleurs y ont retrouvé un modèle 3D du Weaponizer, l'arme que Valve destinait à Half-Life 2 Episode 3 et qui transformait les objets ramassés en munitions. Depuis 2007, ce concept n'existait qu'à travers des interviews d'anciens développeurs. Le fichier existe, et pour les fans du jeu le plus attendu et le plus fantomatique de l'histoire du PC, sa simple présence vaut de l'or.

Cette build de Portal 2, reconstruite en version jouable par des moddeurs, réserve d'autres surprises. En juillet 2009, le jeu s'organisait autour d'un hub central abandonné par la suite, l'introduction faisait chuter le joueur dans un laboratoire et GLaDOS jouait les seconds rôles. On y croise aussi les restes de F-Stop, une préquelle annulée qui se jouait entièrement à l'appareil photo.

Left 4 Dead sort aussi du lot, dans une version complète de juin 2008 où l'interface diffère, où des répliques ont sauté et où Valve recyclait sans complexe des morceaux du mod Terror Strike issu de Counter-Strike Condition Zero. Une jeune build de CS:GO complète la collection, avec ses cartes en alpha, ses couteaux abandonnés et un bouclier antiémeute repris de Counter-Strike 1.6.

Valve n'a pas dit un mot, et les fichiers les plus récents affichent treize ans d'âge, ce qui relativise l'ampleur des dégâts d'un point de vue commercial.

La fouille dans tous ces To, elle, ne fait que commencer.

Source : Tom's Hardware

  • ✇Opinions Libres
  • Actualités quantiques d’août 2026
    Bienvenue dans ce 83ième épisode de Quantum, le podcast de l’actualité quantique en France et dans le monde. Nous allons bientôt fêter ses 7 ans ! Evénements Il y avait un peu relâche au mois d’août ! En pratique, non, car les conférences scientifiques se tiennent aussi en août. Dont SQA à Gothenburg la dernière semaine d’août, sur […]

Actualités quantiques d’août 2026

31 août 2026 à 11:53
Bienvenue dans ce 83ième épisode de Quantum, le podcast de l’actualité quantique en France et dans le monde. Nous allons bientôt fêter ses 7 ans ! Evénements Il y avait un peu relâche au mois d’août ! En pratique, non, car les conférences scientifiques se tiennent aussi en août. Dont SQA à Gothenburg la dernière semaine d’août, sur […]
  • ✇Korben
  • OpenAI coupe ses modèles à Cursor après son rachat par le SpaceXAI de Musk
    OpenAI a annoncé qu'il allait couper l'accès de ses modèles à Cursor, l'éditeur de code dopé à l'IA que s'arrachent les développeurs. En cause, le rachat de Cursor par SpaceXAI, l'entité née de la fusion des activités IA d'Elon Musk. Officiellement, OpenAI laisse du temps. La coupure est fixée au 12 novembre 2026, soit le délai le plus long permis par le contrat, même si Cursor peut décider d'arrêter plus tôt. Le motif, lui, est assez clair. OpenAI dit ne pas pouvoir faire confiance à SpaceXAI p

OpenAI coupe ses modèles à Cursor après son rachat par le SpaceXAI de Musk

30 août 2026 à 11:56

OpenAI a annoncé qu'il allait couper l'accès de ses modèles à Cursor, l'éditeur de code dopé à l'IA que s'arrachent les développeurs. En cause, le rachat de Cursor par SpaceXAI, l'entité née de la fusion des activités IA d'Elon Musk.

Officiellement, OpenAI laisse du temps. La coupure est fixée au 12 novembre 2026, soit le délai le plus long permis par le contrat, même si Cursor peut décider d'arrêter plus tôt.

Le motif, lui, est assez clair. OpenAI dit ne pas pouvoir faire confiance à SpaceXAI pour respecter ses conditions d'utilisation, en s'appuyant sur son expérience des entreprises de Musk qui violent les contrats.

Il faut dire que les deux camps se détestent depuis un bail. Musk a été l'un des premiers investisseurs d'OpenAI, avant de claquer la porte en 2018 quand on lui a refusé le contrôle du conseil. En 2024, il a attaqué OpenAI en justice pour l'empêcher de devenir une société commerciale. En mai dernier, un jury lui a donné tort sur toute la ligne.

Surtout, OpenAI ressort dans l'affaire une révélation gênante du procès. Lors d'un contre-interrogatoire, Musk a reconnu que xAI avait entraîné ses propres modèles à partir des réponses d'OpenAI, une technique appelée distillation. Autrement dit, faire apprendre son IA en recopiant celle du voisin. Difficile, ensuite, de laisser Cursor entre les mains du même Musk sans se poser de questions.

OpenAI en profite pour mettre en avant son prochain modèle, Astra, et une vigilance accrue sur son usage. Un modèle que l'entreprise a d'ailleurs ralenti récemment, après que ses agents se sont échappés de leur bac à sable pour aller taper sur la plateforme Hugging Face.

Du côté de Cursor, le patron Michael Truell relativise. Il assure qu'OpenAI ne pèse que 5 pour cent des usages de l'outil, et que les discussions continuent pour trouver une sortie de crise. Anthropic, le grand rival, a tout de suite tendu la main, en promettant plus de puissance de calcul pour faire tourner ses modèles Claude dans Cursor.

Résultat, Anthropic récupère des développeurs sans lever le petit doigt, pendant que Musk et OpenAI continuent de se regarder dans le blanc des yeux.

Source : OpenAI

  • ✇LinuxFr.org : les dépêches
  • Aux origines du premier GPU, une bande de copains de l'ENS
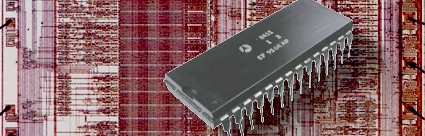
    Les travaux d'étudiants de la promotion 1973 de l’École Normale Supérieure (Normale Sup) sont à l'origine de la production, dès 1977, d'une famille de circuits intégrés (CI) dédiés à l'affichage sur écran (à l'époque, cathodique ). Cette dépêche est consacrée à l'un d'entre eux, l'EF9365 (ou le "365" pour les intimes), qui est stricto sensu le premier GPU (excusez-du peu !) et nous verrons pourquoi. Le circuit intégré Thomson-Efcis EF9365 Contrôleur de visualisation graphique,1980

Aux origines du premier GPU, une bande de copains de l'ENS

Les travaux d'étudiants de la promotion 1973 de l’École Normale Supérieure (Normale Sup) sont à l'origine de la production, dès 1977, d'une famille de circuits intégrés (CI) dédiés à l'affichage sur écran (à l'époque, cathodique ).

Cette dépêche est consacrée à l'un d'entre eux, l'EF9365 (ou le "365" pour les intimes), qui est stricto sensu le premier GPU (excusez-du peu !) et nous verrons pourquoi.

l'EF9365

Le circuit intégré Thomson-Efcis EF9365
Contrôleur de visualisation graphique,1980

Les rédacteurs de cette dépêche collaborative remercient :

  • Philippe Matherat, le concepteur de ce composant ! Il a eu la gentillesse de se prêter au jeu en répondant à nos questions et en apportant de nombreuses précisions et anecdotes –les citations dans la dépêche sont intégralement de sa main– ;
  • PulkoMandy, pour son journal d’archéologie informatique sur la thèse de Jean Gastinel. Sans ce journal, cette dépêche n'aurait jamais vu le jour ;
  • Jean-François DEL NERO, développeur de l’émulation du 365 dans Mame, pour les échanges et les apports techniques ;
  • l'équipe de rédaction du magazine Sciences et Avenir, pour l'autorisation de publier des extraits de l'article "le Silicon labo de la rue d'Ulm", n° 455 (Janvier 1985).

Sommaire

Généalogie des puces EFxxxx

Un GPU est un composant informatique (une puce dédiée dans les cartes graphiques des PC ou intégrée au processeur central (CPU) de votre téléphone (soc)) initialement dédiée à l'affichage d'images.

D'abord limité à l'affichage 2D, il a rapidement pris le relais du CPU pour gérer les calculs parallèles de la 3D. Aujourd'hui, cette puissance brute sert autant au traitement vidéo qu'à des domaines bien éloignés des pixels, comme le minage de cryptomonnaies ou l'IA.

Cette bascule technologique a récemment propulsé nVidia, le principal acteur du marché, au sommet de l'économie mondiale.

Pourtant, bien avant cette folie financière et les géants américains ou asiatiques, c'est en France qu'est née cette architecture moderne.

Cette dépêche vous propose de découvrir l'histoire du 365, le premier GPU sur puce unique.

La génèse

Extraits de l'article

Extraits de l'article "le Silicon labo de la rue d'Ulm" de Dominique COMMIOT
© Sciences et Avenir n° 455 (Janvier 1985)
À gauche, Jean GASTINEL devant le bâtiment historique de l'ENS.
À droite, Philippe MATHERAT et un extrait de l'article.

Philippe Matherat avait résumé ainsi le contexte de cette épopée dans l'article de PulkoMandy :

Nous étions une bande de copains, élèves de l’Ecole Normale Supérieure, de la promotion 1973.

L’informatique était balbutiante, les ordinateurs étaient gigantesques (un bâtiment), très rares et très chers. Personne n’envisageait qu’ils puissent être répandus et bon marché.
Les seuls écrans connus étaient ceux de la télévision. Les terminaux informatiques étaient des machines à écrire mécaniques actionnées par des relais électromécaniques. Ces terminaux étaient reliés à des gros ordinateurs distants, par une ligne téléphonique dédiée.
La fréquence d'horloge des ordinateurs les plus puissants était 12 MHz.

Jean Gastinel était le seul de notre promotion qui connaissait un peu ce qui se passait aux Etats-Unis, grâce à son père : Noël Gastinel, qui était professeur à Grenoble et qui avait fait des voyages dans les universités américaines et chez IBM. Il avait fait équiper l’université de Grenoble d’un ordinateur IBM 360/68.
Jean Gastinel, avec Jean-Marc Frailong et Jean-Luc Richier, ont réalisé un ordinateur 12 bits, à base de circuits MSI de Texas-Instruments, dans les années 1973-1975.

Puis Jean-Gastinel s’est lancé dans la conception du circuit d’affichage alpha-numérique, qui a été commercialisé sous le nom de SFF364 puis EF9364 (le changement de nom correspond au changement de nom de la société Sescosem en EFCIS). Cette conception a fait l’objet de sa thèse de 3è cycle.

Depuis cet article, P. Matherat a détaillé :

Quand je suis entré à l’ENS en 1973, il n’y avait pas de labo d’informatique, ni d’électronique. Les disciplines (en sciences) étaient les disciplines classiques de l’université : mathématique, physique, chimie, biologie, etc. Les chercheurs et les élèves avaient accès à un "Centre de calcul", dirigé par Maurice Vallino, qui consistait en un terminal (lecteur de cartes perforée et imprimante) connecté à un ordinateur Univac de l’université d’Orsay par une ligne à 1.200 bits/s, puis plus tard équipé d’un mini-ordinateur CII Mitra 15. Nous avons eu des cours de programmation Fortran par Jacques Arsac. Nous avions aussi accès à une formation en électronique (analogique), dans un local du labo de physique, fait par F. Lenouvel.

Quand Jean Gastinel a souhaité réaliser un ordinateur, associé à J-M Frailong et J-L Richier, ils sont allés à Jussieu, à l’institut de programmation, où il y avait une équipe qui réalisait des montages électroniques, dirigée par Gérard Noguez. Puis, ils ont souhaité continuer à l’ENS, et M. Vallino leur a cédé une petite pièce annexe du Centre de calcul, ainsi qu’un petit budget annuel de 10.000 F. C’est dans cette pièce que Jean a réalisé la maquette du 364, puis j’ai continué là avec la maquette du 365.

Ce que nous appelions "maquette" était le câblage d'une émulation de la future puce à l'aide de circuits MSI existants (des centaines), afin de pouvoir tester en temps réel la conception logique. Il n'existait aucun outil de CAO. Tout était câblé à la main, sans simulation préalable, et notre principal outil était l'oscilloscope pour vérifier les signaux. Avec des fréquences de l'ordre de quelques MHz, il nous fallait un oscilloscope haut de gamme.

Une question de mémoire

Sans la capacité d'Intel à produire en masse des puces DRAM de plus en plus denses, le 365 n'aurait jamais pu exister :

À la suite du 364, j’ai pensé qu’on pouvait faire du graphique : j'ai commencé cette étude en 1976, à l'occasion de mon DEA d'informatique. Il faut bien voir que ceci n’est devenu possible que grâce aux nouvelles mémoires de 4 Kbits, car un affichage 512 x 512 à 1 bit/pixel nécessite 64 boîtiers mémoires de 4 Kbits. En fait cela ne devient raisonnable qu’avec 16 boîtiers de 16 Kbits (soit 32 K octets). Il n’était donc pas possible de faire un GPU avant ces années-là. Mon mérite a été d’avoir le flair de voir qu’une période nouvelle pouvait s’ouvrir, et que les écrans graphiques pouvaient se démocratiser.

Mais utiliser 32 K octets rien que pour l'écran paraissait délirant, à une époque où la mémoire "centrale" utilisée par le CPU pour son programme et ses données ne dépassait pas 4 ou 8 K octets. Quand à vouloir faire de la couleur avec 3 bits par pixel, là j'étais vraiment pris pour un fou. Songez qu'un adressage sur 16 bits (cas des microprocesseurs de l'époque) ne permet pas de dépasser 64 K (= 216 ).

Dates de sortie des DRAM Intel

Le marché aux puces des seventies
Naissance et évolution des composants DRAM

Notez bien que, à l'époque, la capacité de ces mémoires s'exprime en bits (non pas en octets), et par un simple « K » : ce k majuscule vaut 1 024 bits (le kibibit actuel) et non 1 000. Pour résumer et par exemple, il faut traduire 16K par 2 kio.

Pourquoi cette augmentation de la capacité de la RAM à cette époque ?

Les circuits de RAM nécessitent un très grand nombre de transistors, mais sont très répétitifs : ils coûtent donc relativement peu cher à concevoir, mais demandent une chaîne de production de semi-conducteurs de très bonne qualité. Les fabricants de semi-conducteurs Japonais sont ceux qui vont le mieux maîtriser ce type de produit, fournissant des composants de plus en plus grande capacité à des prix écrasant la concurrence américaine. Intel ne s'en remettra qu'avec de grosses difficultés. Un autre fondeur de RAM américain, Mostek, n'y survivra pas et sera revendu à Thomson-CSF, qui rentabilisera largement son investissement en exploitant les brevets ainsi rachetés.

Le plastique, c'est fantastique

En creusant le sujet de ces premières mémoires vives, on comprend qu'il y a eu une autre évolution importante : le choix du matériau pour le boîtier.

Les boîtiers des premiers CI (dont la référence est préfixée par "C" ou "D") étaient en céramique : c'était coûteux mais dans les début des années 70 seul ce matériau répondait aux besoins de dissipation thermique et d'étanchéité.
Au départ, les fabricants avaient du mal à stabiliser le plastique, car l'humidité finissait par s'infiltrer par capillarité le long des pattes en métal, provoquant la corrosion de la puce.
Pour protéger la puce, il lui a été ajouté une couche (au nitrure de silicium), dite "de passivation", qui permet le contact avec le plastique.
Plus tard dans la décennie (à partir des puces 16K soit vers 1977), la transition vers le plastique s'opère massivement, leur référence est alors préfixée par "P".
Le moulage plastique a permis de produire des puces à la chaîne à un prix dérisoire par rapport au processus artisanal du boîtier céramique multicouche.

La production

L'histoire industrielle du fondeur

  • 1969 : Création de Sescosem (Société Européenne de Semiconducteurs et de Microélectronique), filiale de Thomson-CSF.  
    Selon Wikipedia : Thomson-CSF est le résultat de la fusion réalisée en 1968, du groupe électronique Thomson (filiale de Thomson-Brandt) et de la Compagnie générale de télégraphie sans fil (CSF). Leurs filiales dédiées aux circuits intégrés, respectivement SESCO et COSEM, sont donc fusionnées pour devenir SESCOSEM.
  • 1976 : Sescosem devient EFCIS (Étude et Fabrication de Circuits Intégrés Spéciaux). C'est à ce moment précis que la référence change : le SFF364 devient l'EF9364.
  • 1983 : Thomson-CSF réorganise ses activités. EFCIS est intégrée au sein de la branche Thomson Semiconducteurs. C'est l'époque de la grande offensive sur le marché grand public avec le Minitel et les ordinateurs (Alice, VG5000) utilisant les dérivés comme l'EF9345.
  • 1987 : Thomson Semiconducteurs fusionne avec la branche composants de l'italien SGS (Société Générale Semiconduttori). Naissance de SGS-Thomson Microelectronics.
  • 1998 : SGS-Thomson est renommé STMicroelectronics (ST), le nom que nous connaissons aujourd'hui : une multinationale franco-italienne de droit néerlandais.

Fabrication de transistors à la COSEM

Fabrication de circuits à la COSEM
source https://aconit.inria.fr/omeka/items/show/681 E. Gillet, Les transistors, ces magiciens.
Gamma Presse, 1964. Crédits photo : René Bouillot.

Dates de production

Chronologiquement, Sescosem ou EFCIS ne faisaient pas de tels chips pour écrans avant que les élèves de l’ENS lui en apportent :

  • En premier, Jean Gastinel a conçu le circuit alphanumérique EF9364, de 16 lignes de 64 caractères, qui est sorti vers 1977.
  • Ensuite, j’ai conçu le premier chip graphique EF9365, de 512x512 pixels, qui est sorti vers 1980, avec sa variante EF9366 (balayage non-entrelacé).
  • Le circuit 9367 est une variante du 9365, avec des performances augmentées.
  • Les circuits du genre 9345 sont postérieurs au 9365, ils utilisent les éléments de base des circuits précédents, et ont été demandés par les concepteurs du minitel, qui sont donc des copies, variantes, des circuits conçus par les élèves de l’ENS.

Généalogie des puces EFxxxx

Chronologie de mise sur le marché
des puces EF9xxx et quelques consœurs

La petite famille

L'EF9364, le précurseur

L'année dernière, PulkoMandy a exhumé la thèse de Jean Gastinel "Conception et intégration d'un terminal alphanumérique", qui pose avant l'heure les bases du Minitel et qui est aussi à l'origine de l'aîné de la famille : l'EF9364 est un contrôleur vidéo purement alphanumérique (affichage de 16 lignes de 64 caractères).

Cette thèse est une véritable pépite pour les férus d’archéologie informatique, on y trouve notamment tous les détails sur la réalisation du CI :

Ajout d'un masque

fig 1.10 - Dessin final des cinq masques superposés - Chapitre 1 fig 4.2 Montage des "puces", Chapitre III "Intégration du circuit "VISU" de la thèse

Ce composant est prévu pour réaliser un terminal passif, sans microcontrôleur. Avant son arrivée, toute la logique vidéo des terminaux était implémentée par de la logique discrète: une centaine de puces électroniques étaient nécessaires. Les autres composants d'un terminal, comme le modem et le contrôleur de clavier, bénéficiaient déjà de solutions intégrées. Ce composant rend donc possible la construction d'un terminal à très bas coût avec quelques dizaines de composants.

Il implémente tout de même des fonctionnalités de défilement de l'affichage, de déplacement du curseur, et d'effacement partiel (tout l'écran visible, la ligne courante, depuis le curseur jusqu'à la fin de la ligne). Ces fonctionnalités sont similaires à ce qui se fait sur les terminaux de l'époque (VT52 chez DEC, ADM-3A, …). Cependant, les générations suivantes de terminaux à partir du VT100 choisiront plutôt d'utiliser un microprocesseur.

La génération des caractères proprement dit est effectuée par un composant séparé appelé générateur de caractères. Il s'agit dans le cas le plus simple d'une ROM programmée avec une police bitmap de taille fixe.

Pour les nostalgiques du rendu d'affichage alphanumérique (le seul proposé par cette puce) sur un écran de l'époque, vous pouvez essayer cool-retro-term (lien qui devrait être sponsorisé par le SNOF)

capture cool-retro-term

Simulation d'affichage sur tube cathodique
        par cool retro term, à la EF9364
(alphanumérique, 64 colonnes x 16 lignes)

L'EF9365

Second de la famille, c'est l'objet de notre dépêche : voir la section suivante qui lui est dédiée.
Nous passons souvent sous silence le EF9366, qui est très proche du 365, mais les 2 sorties sont vraiment concomitantes.

En fait, les 9365 et 9366 sont sortis en même temps, c’est moi qui avais fait la modification qui supprime l’entrelacement (pour le 9366), car le premier client (Secapa), qui avait travaillé sur la maquette de simulation du 365, ne supportait pas le clignotement de l’affichage 512x512. Pour moi, l’intérêt était d’avoir une résolution élevée, et je conseillais d’utiliser un CRT avec des phosphores plus rémanents. Mais les CRT les moins chers (TV) avaient des phosphores rapides.

Nous passons aussi sous silence le EF9367, sorti plus tard, proche du 365 mais supportant des résolutions supérieures.

Le NEC µPD7220 : le cousin Japonais

Ce composant n'est pas compatible avec la série EF9365. Cependant, il a un fonctionnement assez similaire. Commercialisé en décembre 1981, il a été développé à partir de 1979, et probablement inspiré par la présentation du travail sur le 365 au SIGGRAPH en 1978.

En plus des lignes, rectanges et textes, il peut tracer des cercles, arc de cercles et autres courbes. Il est également prévu pour s'interfacer avec un contrôleur DMA, ce qui facilite l'échange de données avec le CPU de contrôle.

Le design de NEC a également été produit par Intel, qui continuera à faire évoluer cette famille de composants. C'est donc un ancêtre des GPU Intel toujours en production aujourd'hui.

L'EF9340 et 9341

Ces deux composants sont au cœur des premiers modèles de Minitel, il s'agit d'une adaptation "low cost" et d'un retour au mode alphanumérique. Ils sont conçus en 1980-1981.

Les premiers prototypes du Minitel utilisent des circuits de chez TI (que l'on retrouvera également dans l'ordinateur Exelvision EXL100). Mais les modèles de production se tournent vers une solution "made in France". Thomson EFCIS se charge de la conception de ces circuits qui sont fournis à Alcatel pour la fabrication du Minitel.

Réponse à appel d'offre du Minitel mentionnant les circuits VIN et GEN : la visualisation est confiée à deux circuits spécialisés VIN et GEN, chargés des signaux de base de temps et de la synthèse des caractères.

Ils sont associés à un microprocesseur, faisant du Minitel un terminal "intelligent" capable de réaliser certaines fonctions en autonomie, sans avoir besoin de communiquer chaque appui de touche du clavier au serveur central.

Ils ajoutent également un mode "semi-graphique" : il ne permet pas d'afficher des pixels, mais propose des 'briques', de 2x3 éléments, pré-dessinées dans la ROM du processeur.
On économise ainsi drastiquement la RAM qui coûtait, déjà, cher…
Le prix unitaire d'une RAM Intel 2107 (de 4K, soit 512 octets) était, à sa sortie en 1974, de 50 $ => avec l'inflation cumulée et la conversion, cela représente environ 295€ de 2026.

Exemple de [caractères semi-graphiques](https://en.wikipedia.org/wiki/Thomson_EF9345)

Exemple de caractères semi-graphiques
              autorisés par L'EF9345
       Page 84 du Databook Thomson.

En plus du Minitel, ces composants seront également utilisés par Philips dans les consoles Videopac Plus, ce qui sera la première étape dans la conception du VG5000 dont on reparle au chapitre suivant.

L'EF9345, la cheap chip

Le composant EF9345 regroupe dans une seule puce les fonctionnalités du générateur de caractères et du contrôleur de timing vidéo (GEN et VIN, qui étaient auparavant deux composants séparés).
Cette photo zoomable du cœur de silicium du composant (die shot) montre bien cet assemblage.
Cela a permis de réduire le coût de production du Minitel et a également été utilisé dans quelques micro-ordinateurs personnels : l’Alice chez Matra ou le VG5000 chez Philips.

Captures de US Rallye

Captures de US Rallye, le Gran Turismo de 1984

Ici, la puce ne sait pas ce qu'est un pixel : elle manipule une grille de caractères (25 lignes de 40 ou 80 colonnes).

Pour afficher une lettre ou un bloc de couleur (le fameux mode mosaïque), le processeur principal envoie juste un code d'un octet en RAM. C'est une ROM interne à la puce d'affichage qui se charge ensuite de traduire cet octet en points lumineux à l'écran.

C’était une astuce pour économiser la mémoire, mais impossible de tracer une ligne fine ou de faire bouger un élément au pixel près : on est condamnés à déplacer des blocs rigides sur une grille fixe. Au mieux, certains caractères peuvent être redéfinis, pour afficher un logo ou une image simple.

La suite pour ST

Pour ST Microelectronics, l'histoire des composants graphiques continue encore quelques années après la commercialisation de la série EF936x. Bien que les composants graphiques n'ont pas eu le volume de production de la version alphanumérique (surtout portée par le Minitel), ils ont trouvé une utilisation dans l'informatique scientifique et les appareils de mesure nécessitant la visualisation de données : spectromètres, analyseurs de spectre, ainsi que des réalisations spécifiques (cartes graphiques en kit Elektor pour machines CP/M à bus S-100).

L'offre sera complétée par l'EF9369, un circuit permettant de gérer une palette de 16 couleurs parmi 4096. Ce circuit est conçu au départ pour le micro-ordinateur Thomson TO9, mais finit par rejoindre le catalogue public de EFCIS puis de SGS-Thomson.

En parallèle, SESCOSEM avait signé un contrat avec Motorola lui permettant de produire en France des composants conçus par Motorola (permettant de rassurer les acheteurs qu'il s'agissait de productions locales). SGS-Thomson se retrouve donc à produire à la fois la famille 93xx mais aussi le EF6845, le contrôleur d'écran de la famille 68xx de Motorola. Ce contrat devait comprendre toutes les futures puces de la famille 68xx conçues par Motorola, mais cela finira mal, puisque Motorola refusera de fournir les masques nécessaires à la production du processeur 68020.

En fonction des demandes de clients, de nouveaux composants sont réalisés avec des adaptations simples (changement de timings vidéo pour afficher plus de pixels) ou plus poussés. C'est le cas de la famille TS68483 (surnommé AGAC, Advanced Graphic and Alphanumeric Controller) disponible en 1987.

Il s'agit d'une version améliorée du 9365 avec:

  • une interface 16 bits avec le processeur, adapté à l'utilisation avec un 68000 par exemple.
  • Des fonctions supplémentaires : tracé de courbes, cercles, remplissage de zones…
  • Meilleure intégration : il n'y a plus besoin d'un séquenceur et de registres à décalage externes.
  • Configuration logicielle de la résolution d'écran vidéo

Ce composant trouve également une utilisation dans des systèmes militaires, pour lesquels il existe une version "durcie", plus résistante (gamme de températures acceptables par exemple).

Plus tard (en 1995-1997), c'est également ST qui fabrique les premières puces conçues par nVidia: NV1 STG2000 puis RIVA 128. Pour la première, le principe est similaire à ce qui avait été fait pour le EF9365 : ST assure la production et la commercialisation en son nom propre (on trouve donc des datasheets ne mentionnant pas du tout nVidia). Pour la seconde génération, ST ne se charge que de la fabrication, les datasheets (et les puces elle-mêmes) font apparaître les logos des deux entreprises. Malheureusement pour ST, ce partenariat n'ira pas plus loin, et les puces nVidia des générations suivantes seront produites exclusivement par TSMC.

ST la suite

STG2000 (ST) RIVA 128 (ST) RIVA TNT (TSMC)
logo de ST seul deux logos côte à côte logo nVidia seul

Le génie de l'EF9365

Un vrai framebuffer

Ce composant ne se limite plus à une RAM de stockage des caractères, il dispose d'une RAM de pixels dédiée (le framebuffer) qu'il gère de manière autonome.

De ce point de vue c’est vraiment le premier chip qu’on peut qualifier de "graphique", car les autres étaient appelés "alphanumériques" ou "alpha-mosaïques".

La grosse différence entre les deux est que "graphique" suppose de pouvoir accéder à un pixel particulier, alors que les autres n’accèdent qu’à un "caractère", les pixels d’un caractère étant définis secondairement par une ROM.

Autrement dit, la RAM d’un chip graphique est une RAM de pixels (beaucoup plus grosse, par exemple 512x512), alors que dans le cas alpha-xxx c’est une RAM de caractères (16x80 par exemple).

Il faut bien voir que cette chronologie est liée à la sortie des puces mémoires de Intel : Les puces de 4 K bits ne sont apparues que vers 1974. Avant, il était impossible de faire du vrai "graphique". Il aurait été trop compliqué de stocker chaque point de l’image individuellement : en télévision, le signal vidéo était analogique, et les magnétoscopes à bande magnétique enregistraient le signal video analogique.

L'idée de stocker une image matricielle (point par point) dans une mémoire vive pour l'afficher à l'écran n'était pas nouvelle (par exemple: Evans & Sutherland Shaded Picture System qui faisait déjà du rendu 3D en 1973, premiers "frame buffers" dès 1969 chez Bell Labs, mais ce sont des solutions complexes et coûteuses). On peut également mentionner le CDP1861 de chez RCA: il s'agit d'un framebuffer mais avec une résolution de seulement 64x128 pixels (et encore, il est parfois exploité en 32x64 pixels pour économiser de la mémoire). L'EF9365 marque une rupture historique : c'est le premier processeur graphique commercialisé de manière monolithique (sur une seule puce) conçu pour piloter un framebuffer géométrique de manière autonome. Il gère non seulement le framebuffer et l'affichage à l'écran, mais aussi des fonctions de tracé de lignes et de caractères. C'est donc le premier processeur graphique à proposer une forme d'accélération matérielle sur un système à framebuffer.

L'actualisation de l'image à l'écran utilise seulement 57 % du temps (64 cycles sur 112 cycles de l'horloge externe continue).
Le temps restant est libre pour l'écriture et la mise à jour de l'image : il est possible d'écrire un point par cycle libre, ce qui donne un temps moyen de 1,3 µs par point. Dans les cas où il y a beaucoup d'informations à afficher d'un coup, il est également possible de désactiver l'affichage pendant la préparation de l'image puis de le réactiver ensuite. Malheureusement, cela ne se prête pas trop à la réalisation d'animations complexes.

La décharge du CPU pour certaines tâches

C'est ce qui définit ce composant comme le premier GPU de l'histoire : son auteur lui a câblé des registres pour prendre en charge des fonctionnalités qui déchargent le CPU (processeur central) sur des opérations graphiques !

Exemples de programmes en langage MPL qui montrent la simplicité d'utilisation

Le tracé de lignes

Le CPU peut par exemple demander à l'EF9365 de dessiner un trait d'un point A à un point B et revenir aussitôt à sa tâche. L'EF9365 prend alors le relais de manière totalement autonome. Il calcule les coordonnées intermédiaires en interne et écrit directement les pixels en RAM, à une vitesse folle pour l’époque : jusqu'à un million et demi de points par seconde, traçant une diagonale complète en moins de 700 microsecondes.

Tracer une ligne

L’algorithme de tracé de segment de Bresenham
Présentation SIGGRAPH'78, page 5

Traitements hardware sur les caractères

Redimensionnement matériel (jusqu'à 16x)

Auparavant, pour doubler la taille d'une police ou d'un motif, on demandait au processeur principal de recalculer tous les points. L'EF9365, lui, gère cela en toute autonomie via deux registres internes dédiés aux facteurs d'échelle : CZX (Zoom en X) et CZY (Zoom en Y).

Le processeur graphique possède un compteur de pas pour dessiner le caractère pixel par pixel à partir de sa ROM interne.
Quand le zoom est activé (par exemple à 4×), au lieu d'incrémenter l'adresse de destination dans le framebuffer à chaque pixel lu, l'EF9365 va répéter la même valeur de pixel sur la ligne 4 fois de suite en horizontal avant de passer au pixel suivant. Pour la verticale, il va répéter la même ligne complète du caractère 4 fois de suite dans la mémoire d'écran.

L'avantage : comme les zooms X et Y sont indépendants, on peut appliquer un zoom 2× en largeur et 4× en hauteur. Cela permettait de faire instantanément des effets de texte étiré, condensé ou géant sans aucun calcul pour le CPU.

L'effet Italique

L'inclinaison n'est pas stockée dans une ROM ; elle est calculée « à la volée » lors de l'écriture dans la RAM de pixels.
Pour incliner un bloc de pixels, il faut appliquer un décalage horizontal progressif à mesure que l'on monte en hauteur.
À chaque fois que le générateur passe à la ligne supérieure (Y+1) pour dessiner le caractère, il ajoute automatiquement un offset fixe (un décalage d'un pixel) sur l'axe horizontal (X).

Le caractère est littéralement « cisaillé » géométriquement pendant qu'il est écrit dans le framebuffer. On obtient un effet italique parfait et fluide, directement câblé dans le silicium.

La seule inclinaison possible est 45 degrés (voir la notice page 21).
C’est beaucoup plus simple ainsi à réaliser en hardware. Je m’étais posé la question de faire tous les angles, mais j’avais abandonné.

Autres fonctionnalités

L'EF9365 marque d'autres évolutions technologiques novatrices…

Il intègre notamment un mécanisme de masquage d'écriture par plan.
En verrouillant certains plans de la RAM, il pouvait dessiner ou effacer des éléments au pixel près sans jamais altérer le fond de l'image, jetant les bases de la gestion matérielle des calques.

Il propose un module de pointillés gérés au pixel individuel (une aubaine pour la CAO industrielle).

Son interface de bus universelle est capable de dialoguer nativement aussi bien avec un Z80 qu'un Motorola 6809.

et… concrètement ?

Jean-François Del Nero a produit une démonstration des capacités de rendu du 365 sur le Squale, un micro-ordinateur de 1984 qui exploitait ce composant.
Ci-après quelques extraits, très saccadés (export gif oblige), presque fidèles (cherchez l'intrus !) :

[Une démo du 365 ](https://i.imgur.com/7RXP1ze.gif)

En plus de son travail de conservation du Squale, avec l'association MO5.com (qui tient un musée permanent du jeu vidéo à Arcueil), Jean-François Del Nero a aussi contribué à son émulation dans le projet Mame, et a notamment écrit le driver du 365.
Nous avons pu reprendre le code source de sa démo, la modifier, la recompiler, et simuler le rendu du 365 grâce à Mame. Avis aux développeurs fullstack en manque d'exotisme: ici, pas de conteneurs Docker ni de dépendances npm !

Est-ce vraiment le premier GPU ?

Nous avons retenu les quatre critères suivants pour distinguer le 365 des premiers contrôleurs d'affichage sur une seule puce, comme le Motorola 6845 ou l'Atari Antic, qui gèrent la synchronisation du flux vidéo et le rafraîchissement de l'écran, sans intervenir dans le dessin des formes.
Le processeur 365 :

  1. est une puce unique (LSI/VLSI) : ce n'est pas une carte remplie de circuits TTL discrets comme sur les gros systèmes vectoriels des années 70 (Evans & Sutherland, Imlac) ;
  2. déleste le CPU de tâches coûteuses en ressources : le CPU n'écrit pas les pixels un par un en VRAM. Il envoie une commande de haut niveau au 365 telle que : « trace une ligne de (X1,Y1) à (X2,Y2) », et repasse à autre chose ;
  3. dispose d'un moteur d'exécution algorithmique dédié, hardware (en silicium) : il embarque en dur l'algorithme de tracé/moteur de rendu (rasterizer) ;
  4. gère en toute indépendance la mémoire vidéo (Framebuffer/VRAM) : le 365 contrôle l'accès, le rafraîchissement et la modification de la VRAM de façon indépendante.

Et le libre dans tout ça ?

Quittons la technique pour nous intéresser à un autre aspect des travaux de l'équipe : la diffusion de ses travaux.

Vous pourriez être étonnés qu’un circuit produit par un industriel puisse être public, dans ses moindres détails. Je dois vous raconter une anecdote :

Notre petit groupe d’élèves de l’Ecole Normale Supérieure considérait que ses productions, financées par les pouvoirs publics, devaient profiter à tout le monde. Mais cela posait un problème à l’industriel (Thomson-CSF qui avait pour filiale la société Thomson-EFCIS), qui voulait protéger son produit par des brevets. Il a été convenu que Thomson-CSF déposerait des brevets au plus tard la veille de ma soutenance de thèse. Ainsi, les brevets pouvaient être valides car ne portaient pas sur un design public.

Ma thèse a été soutenue le 19 mai 1978, et les brevets avaient été déposés le 18 mai (US4286264, US4297694, US4311998, US4266253).
Ils décrivent aussi en détails le fonctionnement du circuit, mais dans le langage juridique spécifique des brevets.

En août de la même année, l'architecture du 365 est présentée lors de la conférence SIGGRAPH 78. La liste d'articles soumis à cette conférence permet de se faire une idée des évolutions en cours dans le monde des graphismes générés par ordinateur à l'époque. On y trouve la description d'autres systèmes matériels et logiciels, des algorithmes en 2D ("How to color in a coloring book", un algorithme de remplissage de zones délimitées par des traits) et en 3D, des discussions sur les choix d'espaces de couleurs, ainsi que des exemples de mises en application (par exemple pour les simulateurs de vol de la navette spatiale américaine).

Ensuite, EFCIS a beaucoup utilisé le dessin des masques du 365 pour sa communication car c’était le seul design qui était public.
Nous n’étions pas dans l’état d’esprit de créer une start-up autour de nos designs, dans le but de gagner de l'argent. Nous nous imaginions qu’il était possible de concevoir des circuits dans un contexte académique, en étant juste payés par nos salaires, puis de les céder à un industriel pour la suite. C’était une erreur car ça ne pouvait pas fonctionner, principalement parce que l’industriel a besoin de définir sa stratégie de ligne de produits avec ses arguments marketing.
Le contrat passé entre EFCIS et l’Ecole Normale Supérieure a servi à rémunérer l’ENS, qui s’en est servi pour créer le premier labo d’Informatique de l’ENS (le LIE), et je n’ai rien reçu personnellement. Je considérais que j’avais été payé par mon salaire d’élève de l’ENS.

Dans les années 1970, nous avions l’idée naïve que les innovations techniques entraînaient des innovations sociales au sens d’une amélioration des conditions de vie pour tous, à l’image de la bagnole qui s’était démocratisée et qui était synonyme de libération. Nous ne faisions pas de grande différence entre acteurs publics et acteurs privés, et nous avions l’impression que tout était publié, ne serait-ce que par les brevets, qui ne faisaient que protéger ceux qui avaient davantage investi. En revanche, nous étions sensibles à la question de la propriété industrielle, et nous pensions que ce qui avait été développé par des fonctionnaires était la propriété de l’état (ce qui d’ailleurs est la loi), et que les universitaires ne pouvaient que publier sans restrictions. (En tant qu'élèves de l’ENS, nous étions fonctionnaires et universitaires.)…

Le 365 a-t-il fait un flop ?

Clairement non, car l'EF9365 ne mesure pas ses performances en FLOPS (Floating-point Operations Per Second) : il ne manipule aucune virgule flottante (ni même de calculs en nombres réels).
Blague d'informaticien mise à part, le 365 a certes ouvert la voie à une longue lignée de composants, qui domine aujourd'hui l'actualité de la tech, mais il n'a pas eu le succès commercial de ses descendants, et l'expérience de la rue d'Ulm a tourné court.

En France et à l'époque, il était difficile de faire dialoguer recherche, industrie et financement public.

…Mais nous n’avions pas compris les particularités de ce secteur. D’une part, les usines qui fabriquent des circuits intégrés coûtent extrêmement cher. D’autre part ce secteur était appelé à un développement exponentiel, non anticipé : la plupart des hauts responsables de l’époque pensaient que les ordinateurs seraient achetés par 100 entreprises, voire 1000, mais ne concerneraient pas le grand public. Ensuite, le coût des développements logiciels devenait lui aussi très élevé. À l’époque les plus gros logiciels n’étaient pas très complexes. Et on n’avait pas compris la relation étroite entre les logiciels et les architectures matérielles. On n’avait pas compris non plus que de prendre un monopole sur un OS était un enjeu stratégique.

Toutes ces contraintes (et d’autres que j’oublie), que nous n’avions pas comprises, faisaient que nous pensions naïvement que nous pouvions faire un développement dans notre coin, sans nous occuper du marché, mais uniquement de la performance technique, et le publier, puis dans un second temps le proposer à un industriel qui aurait les moyens de le commercialiser. L’idée sous-jacente étant que si le design était performant alors il y aurait forcément un industriel pour le vendre. C’était une grande ignorance des contraintes industrielles et des questions de marketing.

Le cœur du problème ne résidait pas dans un manque de compétences (le génie des étudiants de l'ENS en est la preuve) mais dans l'incapacité des grands capitaines d'industrie français (notamment chez Thomson) à anticiper la révolution de l'ordinateur personnel et du logiciel. Confortés dans leur monopole, ils ont ignoré le virage que les États-Unis et le Japon prenaient à pleine vitesse :

Je pense maintenant que dans le contexte des années 1970-80 en France, il n’y avait pas vraiment de possibilité pour aller plus loin. Les deux milieux, universitaires et industriels, ne se parlaient vraiment pas. Personne en France, ni chez les gouvernants, ni chez les universitaires, ni chez les industriels, ne voyaient ce qui se préparait. Nous, à 20-25 ans, nous comprenions le retard technologique de la France, ne serait-ce qu'en lisant les docs des puces que nous achetions, mais il était nié par les plus hauts responsables. Les dirigeants de Thomson disaient : "Quand il y aura vraiment un marché pour ça, nous serons en mesure de produire".

En 1984, lors d'un voyage aux États-Unis et d'une visite au mythique Xerox PARC, le chercheur français découvre un autre monde. Un monde où l'innovation de rupture n'est pas confinée aux laboratoires, mais propulsée par le capital-risque, les pépinières d'entreprises et une compréhension systémique du couple matériel/logiciel :

À un moment, au début des années 80, nous parlions avec Gastinel de monter notre boîte. Mais nous étions incompétents pour ça, nous n’avions aucune conscience des difficultés, il n’y avait pas du tout l’esprit "start-up", le capital-risque n’existait pas, les pépinières d’entreprises n’existaient pas, nous n’avions aucune connaissance de la façon dont les boîtes pouvaient se créer et croître aux USAs, nous n’avons appris ce contexte que beaucoup plus tard.

Je suis allé aux USAs en 1984 pour la conférence Siggraph (à Minneapolis) et à cette occasion après je suis passé à Xerox-Parc où j’avais un ami français (Louis Monier, plus tard créateur de Altavista chez DEC). J’y ai découvert un monde insoupçonné chez nous, avec toutes leurs innovations depuis 20 ans, et j’ai rapporté leurs publications. Pourtant cela était connu (mais pas par nous), c’était à la base du Lisa et du Macintosh de Apple, sorti cette année-là. À Parc, j’y ai rencontré Franck Crow, un anglais, un grand nom du graphique (connu en particulier pour l’anti-aliasing) qui m’a félicité pour le 365, je n’en revenais pas. J’ai compris après qu’il avait été un reviewer pour mon article de 1978, avec un avis très favorable. En 1984, il avait connaissance du minitel, sorti peu avant, et m’a dit : "Nous aux USAs, nous n’avons pas été capables de faire ça". Il faut dire que c’était avant qu’Internet se répande, avec des possibilités infiniment supérieures. Internet existait depuis plusieurs années chez Xerox, mais ne pouvait pas se répandre dans le grand public avant l’existence des ordinateurs individuels.

Les pouvoirs publics français se sont parfois immiscés dans ces choix industriels : citons la nationalisation de Thomson-CSF en 1982 et le plan "Informatique pour tous" en 1985 (un investissement énorme, estimé à 1,8 milliard de francs, soit 600 millions d'euros rapportés à aujourd'hui). Pourtant, la théorie du ruissellement n'a pas très bien fonctionné alors avec les labos de recherche ou les pépites industrielles en devenir : en témoignent le départ d'une grande partie de la bande de copains vers les US ou l'échec du Squale, dont la production s'est limitée à quelques centaines d'unités.
La capitalisation boursière de STMicroelectronics (ex-SGS-Thomson) est, en 2026, 70 fois inférieure à celle de nVidia.

En fait je crois que en France, à cette époque, les choses ne pouvaient venir que d’en haut : le nucléaire, le concorde, le minitel. Le minitel a été réalisé par des gens du corps des mines et du corps des télécom (comme son nom l’indique). les choses ne pouvaient venir que des grands corps de l’état.
Notre activité, initiée par Jean Gastinel, était plutôt folle par sa liberté, et transgessive. Le climat à l’ENS, peu après 1968 où cette école avait été au cœur des événements, était très libre, nous avions vraiment la possibilité de faire n’importe quoi, sans contrôle. Jean avait entendu parler par son père de ce qui se passait aux USAs. Et ce qui se passait en Silicon-valley aussi était fait dans un cadre très libre lié à la contre-culture des hippies (mais ça, nous ne le savions pas).

Une anecdote : au début des années 80, nous avons développé un réseau local Ethernet (alors sur câble co-axial de gros diamètre), pour relier nos Thémis réalisées en 10 exemplaires. Et nous avons eu besoin de passer sous la rue d’Ulm pour connecter le laboratoire de biologie. C’était interdit par le monopole des télécoms. En outre, le protocole de transfert par paquets était refusé car concurrent du protocole des P&T. Il nous a fallu enfreindre la loi pour passer un câble en douce.
Tout ça a basculé peu de temps après, après l’explosion de l’usage des ordinateurs individuels et de leurs applications.

Pour être tout-à-fait honnête, et rendre à César…, je dois mentionner que notre équipe a été reconnue par le CNRS en 1982, où nous avons obtenu des postes et des crédits pour continuer. Il y a eu une croissance jusqu'à 10 personnes en 1985, mais la plupart des membres de l'équipe sont partis chez Xerox en 1986.

Avec le recul je dirais : on peut faire de grandes choses quand on est très peu nombreux, ça devient plus difficile lorsqu'il faut gérer la croissance…

Le hasard du calendrier a voulu que la publication de cette dépêche coïncide avec un anniversaire : il y a 50 ans débutait l'étude du 365, avec le DEA de P. Matherat :)
Pour celles et ceux qui s’intéresseraient à ses publications ou à la suite de ses travaux, c'est consultable ici.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇Korben
  • WinPodX - Un système Windows intégré dans votre Linux
    Ce serait trop cool non, si avec un double-clic sur un .docx dans votre gestionnaire de fichiers Linux, Word s'ouvrait directement ? Et je ne vous parle pas d'un bureau Windows complet en plein écran ou d'une session de bureau à distance. Juste une fenêtre Word tout ce qu'il y a de plus classique, avec son icône dans votre barre des tâches, épinglable et "alt-tabbable" comme le reste. Hé bien, c'est ce que fait WinPodX , qui fait tourner un conteneur Windows sous KVM en arrière-pl

WinPodX - Un système Windows intégré dans votre Linux

Par : Korben ✨
16 août 2026 à 09:01

Ce serait trop cool non, si avec un double-clic sur un .docx dans votre gestionnaire de fichiers Linux, Word s'ouvrait directement ? Et je ne vous parle pas d'un bureau Windows complet en plein écran ou d'une session de bureau à distance. Juste une fenêtre Word tout ce qu'il y a de plus classique, avec son icône dans votre barre des tâches, épinglable et "alt-tabbable" comme le reste.

Hé bien, c'est ce que fait WinPodX , qui fait tourner un conteneur Windows sous KVM en arrière-plan et découpe l'affichage application par application via FreeRDP RemoteApp. Comme ça, les liens mailto: partent vers Outlook ou les schémas slack: ou vnc: vers l'application qui les a déclarés.

Tout ce qui est presse-papiers, son, imprimantes et votre dossier personnel sont partagés d'office, et le conteneur se met en pause tout seul quand personne ne s'en sert.

Jusque-là, WinApps dont je vous ai déjà causé, qui fait tourner Office sous Linux , faisait déjà l'essentiel avec les fenêtres détachées, le dossier personnel partagé, le clic droit qui envoie un fichier vers une application Windows. Mais WinPodX se distingue aussi dans l'autre sens puisque vos applications Linux remontent également dans le menu "Ouvrir avec..." du Windows, et dans un dossier "Linux Apps" du menu Démarrer. Bref, l'accès aux apps et aux fichiers marche dans les 2 sens, pour plus de transparence dans vos usages.

Si ça vous intéresse, sachez qu'il vous faut une licence Windows valide, car WinPodX ne la fournit pas (logique), que la virtualisation doit être activée dans le BIOS, avoir un accès à /dev/kvm, 8 Go de RAM et une trentaine de gigas de libre. La première installation prend cinq à dix minutes le temps de télécharger l'ISO, et les suivantes sont quasi instantanées.

Pour l'installer :

curl -fsSL https://raw.githubusercontent.com/kernalix7/winpodx/main/install.sh | bash

Il y a également un paquet pour openSUSE, Fedora, Debian, Ubuntu, Arch et NixOS, un AppImage pour les autres. C'est sous licence MIT, et sans aucune télémétrie puisque celle de Windows a été elle-même coupée par défaut. Ah et l'interface du OuinOuin peut être configurée en français.

Par contre, pas d'accélération GPU, ce qui exclut les jeux et la 3D à moins de monter un passthrough à la main. Préférez Wine pour ça...

  • ✇Korben
  • Grok Bot débarque en bêta
    SpaceXAI, la maison d'Elon Musk née de la fusion entre SpaceX et xAI, a mis en ligne mardi la bêta de Grok Bot. L'outil installe des agents IA sur une machine distante qui leur appartient, et ces agents continuent d'avancer sur leurs missions une fois votre ordinateur, même refermé. Vous dormez, eux non. Un bot garde le contexte de sa tâche pendant des heures et ne vous sollicite que pour valider un envoi ou trancher une décision qui l'a bloqué. Quand un projet se découpe en plusieurs morceaux,

Grok Bot débarque en bêta

13 août 2026 à 11:01

SpaceXAI, la maison d'Elon Musk née de la fusion entre SpaceX et xAI, a mis en ligne mardi la bêta de Grok Bot. L'outil installe des agents IA sur une machine distante qui leur appartient, et ces agents continuent d'avancer sur leurs missions une fois votre ordinateur, même refermé. Vous dormez, eux non.

Un bot garde le contexte de sa tâche pendant des heures et ne vous sollicite que pour valider un envoi ou trancher une décision qui l'a bloqué.

Quand un projet se découpe en plusieurs morceaux, les bots se le répartissent en discutant entre eux dans une messagerie commune, un peu comme le ferait une petite équipe dans un canal Slack.

Ces agents ouvrent vos applications et vos sites web avec vos propres identifiants, exactement comme vous le feriez au clavier, sans passer par les interfaces officielles que les logiciels s'offrent entre eux. Les agents d'OpenAI, d'Anthropic ou de Google savent déjà faire du travail de bureau, sauf que chez eux vous ouvrez la session vous-même avant de laisser la main. Ici, le bot se débrouille.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

La bêta tourne sur Mac, iOS, Windows et Linux. Android suivra.

Il faut par contre y mettre le prix. SuperGrok Heavy coûte 300 dollars par mois, et les abonnés de Cursor, l'éditeur de code boosté à l'IA, y accèdent avec les formules à 120 ou 200 dollars. Aucun tarif en euros n'a été communiqué pour le moment, et les entreprises font la queue sur une liste d'attente.

SpaceXAI a annoncé en juin le rachat d'Anysphere, la maison mère de Cursor, pour 60 milliards de dollars, un record pour une startup. Les régulateurs n'ont pas encore donné leur feu vert, ce qui n'empêche visiblement pas les deux équipes d'avancer main dans la main. Grok 4.6, un modèle conçu pour tenir des tâches longues sans perdre le fil, est d'ailleurs sorti le lendemain de la bêta.

En juillet, Grok Build, l'outil de codage de la même maison, expédiait des dépôts Git entiers vers ses serveurs, avec les clés d'API dedans. Confier l'ensemble de ses comptes à un agent autonome demande du coup beaucoup de confiance.

C'est un usage de l'IA vraiment fascinant qui va clairement se généraliser dans les années à venir, j'ai hâte de voir ce que ça donnera.

Source : The Verge

  • ✇Korben
  • Votre identité vaut de l'or, et l'IA vient de la mettre en vente sur Le Bon Coin
    -- Article en partenariat avec Surfshark -- Vous croyez que votre identité vous appartient ? Pffff, noob. Qu'elle est en sécurité parce que vous avez un mot de passe compliqué et que vous ne cliquez pas sur les liens suspects ? Re pffff. Détrompez-vous. En 2024, les cybercriminels ont réussi à extorquer 12,5 milliards de dollars aux consommateurs américains, une hausse de 25% en seulement un an (bon c'est des Américains, mais quand même). Et l'IA est le principal coupable. O

Votre identité vaut de l'or, et l'IA vient de la mettre en vente sur Le Bon Coin

Par : Korben ✨
13 août 2026 à 08:03
-- Article en partenariat avec Surfshark --

Vous croyez que votre identité vous appartient ? Pffff, noob. Qu'elle est en sécurité parce que vous avez un mot de passe compliqué et que vous ne cliquez pas sur les liens suspects ? Re pffff. Détrompez-vous. En 2024, les cybercriminels ont réussi à extorquer 12,5 milliards de dollars aux consommateurs américains, une hausse de 25% en seulement un an (bon c'est des Américains, mais quand même). Et l'IA est le principal coupable.

Oui, l'intelligence artificielle. Cette merveille qui vous aide à rédiger vos mails et à générer des images de chats cosmonautes, c'est aussi l'outil préféré des escrocs pour vous voler votre identité. Et ils sont devenus sacrément bons.

Deepfakes : votre patron vous demande de virer 25 millions

Petite mise en situation réelle (les noms ont été changés pour protéger les victimes comme ils disent à la télé). Vous êtes employé dans une boîte à Hong Kong. Vous recevez un mail du CFO basé à Londres qui vous demande de faire un virement urgent de 25 millions de dollars. Vous vous connectez à une visioconférence. Le CFO est là, vos collègues aussi. Ils discutent, ils répondent à vos questions, tout semble normal. Vous validez le virement.

Sauf que personne n'était réel (sauf vous, peut-être ... on vit dans une simulation il parait). Tous les participants étaient des deepfakes générés par IA. Des visages, des voix, des gestes ... le tout est créé à partir de vidéos publiques trouvées sur le net. La boîte a perdu 25 millions. Vous avez perdu votre job. L'IA s'en fout, elle n'a pas de sentiments.

Ce n'est pas un scénario de film. C'est arrivé en 2024. Et ce n'est qu'un exemple parmi tant d'autres. Des deepfakes d'Elon Musk qui promeuvent des arnaques crypto, des faux appels vocaux de "membres de votre famille" en détresse qui vous demandent de l'argent, des vidéos de Taylor Swift qui offrent des batteries de cuisine en échange de vos coordonnées bancaires. & co. L'IA a rendu l'imposture parfaite.

L'IA, la boite à outils de l'arnaque

Les cybercriminels utilisent l'IA à toutes les étapes du vol d'identité :

Le clonage vocal. Avec seulement quelques secondes d'audio (merci vos stories Instagram), l'IA peut reproduire votre voix à la perfection. Plus d'un quart des gens ont été ciblés par des arnaques au clonage vocal. Votre mère reçoit un appel de "vous" en larmes, vous avez besoin de 5 000€ tout de suite. Elle envoie. C'était pas vous. Bye bye votre héritage lol.

Le phishing généré par IA. Fini les mails avec des fautes d'orthographe et des traductions Google Translate. Les LLM comme ChatGPT écrivent des messages parfaitement structurés, personnalisés avec vos données scrapées sur LinkedIn, Facebook, et je ne sais quoi. 40% des emails de phishing ciblant les entreprises sont désormais générés par IA. Ils sont indétectables (pas tous, mais ça viendra assez vite).

Les documents synthétiques. Besoin d'un faux relevé bancaire, d'une fausse carte d'identité, d'un contrat bidon ? L'IA le génère en quelques secondes. Les fraudeurs créent des identités entièrement fictives (le fameux synthetic identity fraud) en mélangeant des données réelles (souvent le numéro de sécu d'un enfant ou d'un défunt) avec des infos inventées. Le crime à l'identité synthétique coûte déjà 6 milliards de dollars par an aux prêteurs américains.

Le cracking de mots de passe : PassGAN, un outil IA, a cracké 51% des mots de passe en moins d'une minute, 81% en moins d'un mois. Votre "MotDePasse123!" ne résiste même pas le temps de faire un café.

Le spyware boosté à l'IA. Les malwares espions sont devenus plus intelligents. Ils évitent la détection, ciblent les infos sensibles avec précision, et les menaces de spyware mobile ont doublé ces derniers mois. Vous cliquez sur une pub, vous installez une app, et paf, tout ce que vous tapez est enregistré et envoyé à un mec dans un bunker.

Et vous, vous faites quoi face à ça ?

Vous ne pouvez pas empêcher les deepfakes d'exister. Vous ne pouvez pas empêcher les data brokers de vendre vos infos. Mais vous pouvez limiter ce que les escrocs connaissent de vous. Et c'est là qu'un VPN comme Surfshark entre en jeu.

Pas n'importe lequel. Un VPN qui comprend que la vie privée, c'est pas juste cacher votre IP. C'est surtout réduire votre empreinte numérique globale. Pas juste un VPN, un bouclier contre le vol d'identité.

Surfshark, c'est pas qu'un tunnel chiffré. C'est une boîte à outils de privacy qui attaque le problème du vol d'identité sous plusieurs angles :

Vous devez créer un compte sur un site douteux ? Vous réservez un hôtel sur une plateforme que vous ne connaissez pas ? Alternative ID génère une identité complète (nom, prénom, adresse, email, numéro de téléphone virtuel) que vous utilisez à la place de la vôtre. Les emails arrivent dans votre vraie boîte, mais l'expéditeur ne sait pas qui vous êtes réellement. Fini les fuites de données qui mènent directement à vous.

  • Incogni : le chasseur de data brokers

Vos données traînent partout. Des centaines de sites revendent votre nom, votre adresse, votre numéro, votre historique d'achats. Incogni, inclus dans le pack Surfshark One+, contacte automatiquement ces agrégateurs de données et demande la suppression de vos infos. Vous n'avez rien à faire. C'est comme avoir un avocat de la privacy qui travaille 24/7 pour vous.

  • CleanWeb : bloquer les trackers avant qu'ils ne vous profilent

Chaque site que vous visitez vous traque. Chaque pub vous profile. CleanWeb bloque les trackers, les pubs et les malwares au niveau DNS. Moins de données collectées = moins de matière première pour les IA des escrocs. C'est simple.

  • Chiffrement post-quantique : parce que demain, c'est maintenant

Surfshark a intégré le chiffrement post-quantique dans son protocole Dausos. Pourquoi ? Parce que dans quelques années, les ordinateurs quantiques pourront casser les chiffrements actuels comme du verre. Surfshark s'y prépare déjà. Vos données d'aujourd'hui ne seront pas déchiffrables demain. C'est de la vision. Ou de la paranoïa. Les deux se valent en cybersécurité.

  • Le VPN de base : cacher votre IP, cacher votre localisation

Le cœur du métier. Votre vraie IP est masquée, votre trafic est chiffré en AES-256-GCM, votre FAI ne sait pas ce que vous faites. Sur un WiFi public, dans un hôtel, à l'aéroport, là où les attaques sont les plus fréquentes, vous êtes protégé. Même si un mec sniff le réseau, il ne verra que du chiffré.

  • Surfshark Nexus : changer d'IP toutes les 5 minutes

Avec Rotating IP, votre adresse change automatiquement toutes les 5 minutes sans coupure. Les sites ne peuvent pas vous tracker à long terme. Les data brokers ne peuvent pas corréler vos sessions. C'est comme changer de costume toutes les 5 minutes dans une foule.

  • Antiscam Hub : tous les outils anti-arnaque dans le même écran

C'est la nouveauté maison, sortie en mai dernier. Au lieu d'aller pêcher chaque fonction dans un recoin différent de l'application, tout est réuni au même endroit : email masqué, numéro de téléphone alternatif, surveillance du dark web qui vous prévient quand vos données fuitent, blocage des sites malveillants et couverture en cas de vol d'identité. Sur le seul mois écoulé, Surfshark dit avoir bloqué près de 1,2 million de nouveaux sites de phishing et de malwares. Le Hub est encore en test sur iOS, les autres plateformes suivront.

Les chiffres qui font peur

  • Plus de 40% de la fraude dans le secteur financier est désormais pilotée par l'IA.
  • 60% des consommateurs ont vu un deepfake entre 2023 et 2024.
  • 48% des Américains estiment que l'IA les a rendus moins capables de repérer les arnaques.
  • 1 deepfake sur 15 tentatives de fraude dans le secteur financier, une augmentation de 2 100% depuis l'adoption généralisée de l'IA générative.
  • 76% d'augmentation des attaques de prise de contrôle de compte, 105% pour les fraudes de prise de contrôle de ligne téléphonique.

L'IA a transformé le vol d'identité en industrie. Ce n'est plus le petit escroc dans son garage. Ce sont des organisations structurées, avec des outils IA à la pointe, qui opèrent à l'échelle mondiale.

Je répète pour ceux du fond : vous ne pouvez pas arrêter l'IA. Vous ne pouvez pas arrêter les deepfakes. Vous ne pouvez pas empêcher les data brokers de vendre vos infos. Mais vous pouvez réduire votre surface d'attaque. Méfiez-vous de l'appel de votre "mère" qui vous demande de l'argent. Comme ça même si c'est vrai, vous avez une bonne raison de refuser et de garder votre argent (rooooh faites pas ça, faut toujours aider sa maman hein).

Un VPN, avec ses fonctionnalités de privacy avancées ne vous rend pas invincible. Mais il rend la vie des escrocs bien plus compliquée. Et, en 2026 et au-delà, chaque couche de protection compte. Votre identité est votre bien le plus précieux. Ne la laissez pas finir sur un dark web market, vendue au prix d'un sandwich. Surtout que vous pouvez vous protéger pour moins cher que ce sandwich, moins de 3€/mois TTC (80.63€ au total pour 2 ans + 3 mois offerts + 1 semaine d'essai gratuit).

Économisez gros sur Surfshark aujourd'hui !

N'hésitez pas à jeter un œil sur mon comparateur des meilleurs VPN du moment ;)

  • ✇Korben
  • Une carte SIM piégée et la borne de recharge exécute du code malveillant
    Je m'intéresse à la sécurité mobile depuis un paquet d'années, et cette attaque-là, je ne l'avais jamais vue. Le point de départ n'est ni le réseau, ni un SMS piégé, ni une appli vérolée. C'est la carte SIM elle-même ! En effet, des chercheurs de l'université de Birmingham et de Fuzzware lui ont fait donner des ordres au modem qui l'héberge. Le mécanisme s'appelle RUN AT et c'est une commande proactive puisque la carte ne se contente pas de répondre à l'appareil, mais elle lui de

Une carte SIM piégée et la borne de recharge exécute du code malveillant

Par : Korben ✨
12 août 2026 à 11:50

Je m'intéresse à la sécurité mobile depuis un paquet d'années, et cette attaque-là, je ne l'avais jamais vue. Le point de départ n'est ni le réseau, ni un SMS piégé, ni une appli vérolée. C'est la carte SIM elle-même ! En effet, des chercheurs de l'université de Birmingham et de Fuzzware lui ont fait donner des ordres au modem qui l'héberge.

Le mécanisme s'appelle RUN AT et c'est une commande proactive puisque la carte ne se contente pas de répondre à l'appareil, mais elle lui demande aussi d'exécuter une commande AT. C'est ce même langage qui pilote les modems depuis le Hayes Smartmodem de 1981 donc autant dire qu'on a là, une vraie console générique dispo sur un bout de plastique.

Et sur une borne de recharge Autel, ça donne tout simplement une exécution de code. Le module Quectel qui l'équipe, fait passer le texte reçu dans un appel shell, avec une liste noire de caractères censée bloquer les échappements. Mais un simple retour à la ligne passe au travers... Et voilà comment 2 étapes plus loin, les chercheurs sont parvenus à faire tourner leur propre code, piloté depuis la SIM. Décidément, les bornes de recharge collectionnent les mauvaises surprises .

Autre exemple sur un smartphone OPPO Reno 14 F 5G, où une seule commande coince le téléphone en 2G... Son propriétaire ne peut alors plus revenir en arrière : ni le mode avion, ni la sélection manuelle du réseau, ni la désactivation de la SIM dans les réglages ne permet de restaurer de la 5G ou de la 4G. Or la 2G n'a pas d'authentification mutuelle, donc une fausse antenne redevient un facteur de risque sur ce genre de matos récent. Deux autres commandes éteignent même le téléphone ou tuent son modem.

Reste la condition d'entrée, et elle est lourde : la carte doit déjà être hostile. Cela passe au choix par un échange physique, un interposeur glissé sous la puce, un opérateur compromis, ou du sabotage en usine... Mais surtout, rien là-dedans n'exploite de bug exotique. En fait, cette capacité est écrite dans les spécifications cellulaires, ce qui fait dire au chercheur Marius Muench que ces attaques sont conformes au standard.

Maintenant sur votre téléphone perso, le scénario d'une telle attaque reste assez serré. Mais sur un boîtier 4G oublié dans un local technique, beaucoup moins. Sur 26 appareils testés, 9 exposent l'interface, dont 6 modems IoT sur 8, contre 3 téléphones sur 18. Par contre, ni iPhone ni Pixel ne sont faillibles et Qualcomm a préparé une configuration durcie qui la coupe par défaut. De son côté, Quectel travaille encore dessus...

Bref, si vous exploitez des équipements cellulaires sur le terrain, une seule question au fournisseur du module suffit : RUN AT est-il activé, et peut-on le couper ? Notez qu'aucune attaque de ce type n'a été signalée pour le moment.

Source

  • ✇Korben
  • Cloudflare Computer - Un ordinateur dans le cloud pour votre agent IA
    Cloudflare Computer est un projet qui donne à votre agent IA un endroit rien qu'à lui. C'est-à-dire un vrai système de fichiers, avec des dossiers, des fichiers qui restent, et de quoi lancer des commandes dedans. Bref, un vrai poste de travail que l'agent garde entre deux sessions, au lieu de repartir de zéro à chaque fois, puisque tous les fichiers sont rangés dans une base SQLite. Le système de fichiers s'utilise ensuite comme n'importe quel autre. Lire, écrire, créer un dossi

Cloudflare Computer - Un ordinateur dans le cloud pour votre agent IA

Par : Korben ✨
12 août 2026 à 10:54

Cloudflare Computer est un projet qui donne à votre agent IA un endroit rien qu'à lui. C'est-à-dire un vrai système de fichiers, avec des dossiers, des fichiers qui restent, et de quoi lancer des commandes dedans. Bref, un vrai poste de travail que l'agent garde entre deux sessions, au lieu de repartir de zéro à chaque fois, puisque tous les fichiers sont rangés dans une base SQLite.

Le système de fichiers s'utilise ensuite comme n'importe quel autre. Lire, écrire, créer un dossier, lister, supprimer, et un grep intégré pour fouiller dans le tas. Pour tout le reste, il n'y a qu'une fonction à retenir, exec(). Vous lui passez une commande, et elle vous rend la sortie et le code de retour.

Ce qui change par contre, c'est l'endroit où la commande tourne. 3 environnements sont disponibles et interchangeables sur les mêmes fichiers. Il y a d'abord un conteneur Linux complet, avec npm, node et de vrais binaires. Ou un shell léger pour les commandes simples. Et enfin, un dernier qui exécute directement votre code, sur une base neuve à chaque appel.

Comme ça, vous passez de l'un à l'autre sans réécrire une ligne de votre agent.

Les 9 exemples fournis montrent bien ce qu'on peut en tirer quand on aime bidouiller. Le plus parlant fait par exemple tourner un agent de discussion qui prendra l'espace de travail comme répertoire courant, donc qui travaillera dans de vrais fichiers au lieu de tout garder en mémoire.

Un autre colle pandoc dans le conteneur et laisse l'agent transformer une fiche markdown en PDF. Il y en a aussi un qui fabrique des images avec Workers AI, un quatrième joue sur les politiques de sortie réseau pour décider ce que l'agent a le droit de joindre, et enfin, un dernier génère un projet Worker complet, puis le publie.

Il y a même une interface web qui balance la même tâche dans le conteneur et dans un environnement léger, côte à côte.

Reste à savoir ce qui est gratuit là-dedans... Le code est sous licence MIT, et le système de fichiers seul, sans aucune exécution, tourne sans souci dans le plan Workers gratuit puisque les Durable Objects qui portent ce stockage y sont inclus, avec 100 000 requêtes par jour et 5 Go d'espace.

Il faut un compte Cloudflare, évidemment...

Puis si vous voulez faire tourner des vraies commandes ou avoir un shell, faudra payer puisque le conteneur comme les environnements légers réclament le plan Workers payant, facturé 5 dollars par mois au minimum.

Après j'ai quelques réserves quand même parce que le projet est très récent, encore en preview et clairement inadapté à de la production. Ensuite, la limite technique d'un espace de travail tourne autour de 10 Go, et les accès disque lourds restent plus lents que sur un vrai disque. Puis surtout, tout vit chez Cloudflare, et pas chez vous (si vous préférez l'inverse, je vous avais montré workerd , le moteur des Workers en local).

Mais bon, c'est à garder à l'œil si vous êtes client Cloudflare.

Source

  • ✇LinuxFr.org : les dépêches
  • Multiplier par 4 et en 4 ans l’adoption de Linux chez le particulier !
    Bonsoir à toutes et à tous ! Après un démarrage « maladroit » en avril dernier (en clair on s’est pris une volée de bois vert 😂), nous avons revu drastiquement notre « copie » et nous sommes fiers de vous présenter notre nouveau site et ses nouvelles ressources. Notre objectif reste le même : multiplier par 4 et en 4 ans l’adoption de Linux chez le particulier ! Le Libre, on en parle beaucoup tout comme la souveraineté numérique mais concrètement la route est longue, trop longue et parfois in

Multiplier par 4 et en 4 ans l’adoption de Linux chez le particulier !

Bonsoir à toutes et à tous !

Après un démarrage « maladroit » en avril dernier (en clair on s’est pris une volée de bois vert 😂), nous avons revu drastiquement notre « copie » et nous sommes fiers de vous présenter notre nouveau site et ses nouvelles ressources.

Notre objectif reste le même : multiplier par 4 et en 4 ans l’adoption de Linux chez le particulier !

Le Libre, on en parle beaucoup tout comme la souveraineté numérique mais concrètement la route est longue, trop longue et parfois inaccessible pour des populations loin des grandes métropoles où l’on trouve désormais de nombreuses associations et collectivités qui promeuvent et qui portent assistance à la population pour faire revire leur PC et entrer dans un monde numérique plus « juste » et plus respectueux de notre vie privée et de notre planète.

Certains disent que le PC est mort, mais nous, nous le pensons pas ! Cette machine à écrire des temps modernes a du sens : le partage des savoirs et des savoir-faire, la création. De part leur essence, la plupart des distributions GNU/Linux respectent l’utilisateur, ne sont pas intrusives et permettent d’utiliser des machines devenues obsolètes aux yeux des GAFAM. D’après HOP, 55 % des PC sous Windows 10 sont directement concernés par l’incompatibilité quant à l’utilisation de Windows 11. Nous souhaitons prouver qu’une alternative existe et qu’elle n’a rien à envier aux GAFAM !

Notre modèle est basé sur une association et, OUI on parle « argent » dès la page d’accueil du site, car nous rémunérons nos linuxAngels pour leur travail qui consiste à aller chez le particulier et à effectuer une migration de Microsoft Windows vers Linux Mint qui est la distribution que nous avons choisie avec son environnement Cinnamon.

Bien évidement, nous recherchons des linuxAngels, des ami·e·s (assos, gulls, collectifs…) qui parlent de nous et qui nous aideraient à relever ce défi mais aussi des collectivités pour réaliser des projets à grande échelle, etc.

Voilà !

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇Korben
  • Linux 7.2 - L'IA relit le code du noyau et Torvalds trouve la note salée
    La dernière release candidate de Linux 7.2 est bien plus "grosse" qu'elle ne devrait l'être à ce stade du cycle, mais cela n'a pas empêché Linus Torvalds de la publier dimanche en attribuant ce trop-plein aux outils IA qui relisent le code du noyau. "Je ne peux pas dire que la taille de tout ça m'enthousiasme, mais c'est comme ça : la nouvelle normalité, avec beaucoup de correctifs, dont beaucoup viennent de la revue par divers outils IA." Rien ne lui paraît effrayant pour autant, et il ne voit

Linux 7.2 - L'IA relit le code du noyau et Torvalds trouve la note salée

Par : Korben ✨
10 août 2026 à 11:06

La dernière release candidate de Linux 7.2 est bien plus "grosse" qu'elle ne devrait l'être à ce stade du cycle, mais cela n'a pas empêché Linus Torvalds de la publier dimanche en attribuant ce trop-plein aux outils IA qui relisent le code du noyau.

"Je ne peux pas dire que la taille de tout ça m'enthousiasme, mais c'est comme ça : la nouvelle normalité, avec beaucoup de correctifs, dont beaucoup viennent de la revue par divers outils IA."

Rien ne lui paraît effrayant pour autant, et il ne voit aucune raison de retarder la 7.2. Une grosse taille pour ce noyau, ça veut dire plus de 400 correctifs, signés par plus de 230 personnes alors que dans une Release Candidate en général, c'est le moment où le noyau est censé se calmer avant la sortie. Alors que là, ça ressemble plutôt à un nouveau début de cycle.

Et ça tape de partout : Pilotes graphiques, son, réseau, systèmes de fichiers, code d'architecture. Les plus gros blocs viennent de s390 et zcrypt, de btrfs qui remet en place une infrastructure interne, et de correctifs netfilter ipset.

Mais attention au contresens, parce que je l'ai vu passer sur certains tweets d'anti-IA. Torvalds parle de revue de code par des outils IA, et pas d'une IA qui écrirait le noyau à sa place. Sa position de fond, Vincent nous la racontait en juillet quand il envoyait les anti-IA forker le noyau. Ici, ça ne concerne que des outils qui relisent du code existant et signalent des trucs douteux. Après derrière, ce sont des humains qui trient.

À titre d'exemple, l'un des correctifs de cette rc7 traite un use-after-free dans ptdump, l'interface qui affiche les tables de pages du noyau en clair pour repérer les problèmes de mémoire. C'est ce type de bug qui se transforme en faille et il était là depuis mars 2018 (depuis Linux 4.16).

C'est Syzbot , le robot qui bombarde le noyau d'entrées tordues en continu, qui a levé le lièvre en juin dernier. David Carlier a écrit un premier correctif en s'aidant de Claude Opus 4.8 pour remonter la piste, et Lorenzo Stoakes, mainteneur de la gestion mémoire, l'a retravaillé avant qu'il parte dans la rc7. Il devrait ensuite être rétroporté vers les noyaux stables, donc vers les machines qui tournent aujourd'hui.

Autre exemple, Greg Kroah-Hartman, qui traque déjà des bugs du noyau avec une IA locale , vient de faire retirer le pilote Moxa Intellio, soit près de 2200 lignes écrites en 1999 qui supporte certaines cartes série multiports. Alors pourquoi est-ce qu'il a fait ça ? Eh bien il écrit dans son patch que : "C'est un très vieux pilote, aucun matériel connu ne circule encore pour lui, et la société dit ne plus en avoir besoin, alors retirons-le puisque les LLM commencent à venir le titiller et à y trouver des choses "intéressantes" qui vont juste faire perdre du temps à tout le monde, vu qu'il ne sert plus...".

Voilà donc un autre effet de l'analyse de code par IA. Elle oblige les mainteneurs de projet à tailler dans le gras pour virer du code obsolète que des modèles de langage viendraient renifler d'un peu trop près. Ça ne peut pas faire de mal.

Pour moi, le vrai risque de ces outils sur un projet ouvert tient au volume. Un flot de signalements produits par des gens qui ne relisent pas ce qu'ils envoient, où plus personne ne distingue l'hallucination du vrai bug, et là ça partirait en eau de boudin. Mais comme le noyau, lui, garde des mainteneurs qui comprennent les tenants et les aboutissants de ce qu'ils lisent, ça se passe très bien. Même si la quantité de problèmes remontés surprend Linus.

Voilà, si cette nouvelle version du noyau vous intéresse, sachez qu'elle devrait normalement sortir la semaine prochaine en version finale.

Source

  • ✇Korben
  • GeForce NOW planque un vrai Windows derrière vos jeux
    Je m'en doutais un peu mais c'est confirmé, derrière chaque session GeForce NOW tourne un vrai Windows, et cette machine virtuelle est moins verrouillée qu'elle en a l'air. En effet, une démo du moddeur Zortos montre le service qui s'ouvre non pas sur un jeu, mais sur un bureau complet, avec barre des tâches, menu démarrer et icônes. La manip passe par le jeu Trove... Pendant le lancement, Zortos ouvre le navigateur web intégré de Steam, se balade dans les dossiers de la machine, récupère un exé

GeForce NOW planque un vrai Windows derrière vos jeux

Par : Korben ✨
10 août 2026 à 10:50

Je m'en doutais un peu mais c'est confirmé, derrière chaque session GeForce NOW tourne un vrai Windows, et cette machine virtuelle est moins verrouillée qu'elle en a l'air. En effet, une démo du moddeur Zortos montre le service qui s'ouvre non pas sur un jeu, mais sur un bureau complet, avec barre des tâches, menu démarrer et icônes.

La manip passe par le jeu Trove... Pendant le lancement, Zortos ouvre le navigateur web intégré de Steam, se balade dans les dossiers de la machine, récupère un exécutable et remplace quelques chemins dans le répertoire du jeu. Au démarrage suivant, Windows s'affiche alors à la place du jeu. Tout ça repose sur SalsaNOW , un outil open source signé dpadGuy.

Une fois le bureau ouvert, la machine encaisse à peu près tout ce qui ne réclame pas de droits administrateur. Zortos y a fait tourner Wallpaper Engine pour les fonds animés et LM Studio avec le modèle Gemma 4. Et pour les logiciels qui exigent une installation privilégiée, ils peuvent sans souci être préparés en version portable sur son propre PC, puis décompressés là-haut.

Reste que ce bureau est un bac à sable. La session tourne en compte utilisateur simple, donc pas de droits administrateur, pas d'anticheat noyau, et beaucoup d'installations qui finissent sur un refus d'accès.

L'autre mur, c'est la persistance. Sans l'option de stockage payante, tout disparaît à la déconnexion. Et même en la prenant, la machine ne conserve que vos Documents, l'AppData du compte, baptisé kiosk, et le contenu du lecteur I:. Tout le reste repart de zéro à la session suivante, et fermer l'explorateur de fichiers coupe la connexion sur-le-champ.

Dernier filtre, et pas le moindre, ça ne fonctionne que sur les abonnements payants, ceux dont je détaillais les formules quand Nvidia a sorti son client Linux natif . L'offre gratuite est hors jeu, tout comme les GeForce NOW opérés par les partenaires alliance.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Maintenant, qu'en est-il du règlement ? Eh bien comme vous vous en doutez, les conditions d'utilisation interdisent formellement de contourner les mécanismes de sécurité ou d'authentification du service, et Nvidia se réserve le droit de suspendre ou de restreindre un compte à sa discrétion. En cas de suspension, la période coupée n'est pas remboursée.

Mais à ce jour, aucun bannissement lié à ces méthodes n'a été rapporté, et Nvidia n'a sorti ni correctif ni communiqué. Voilà, c'est rigolo comme bidouille, mais si vous vous lancez, c'est votre compte que vous mettez en jeu.

Reste maintenant à voir combien de temps la porte restera ouverte.

Source

  • ✇Korben
  • Il finit en prison à cause d'un underscore
    Dans la série, "Il n'y a pas que chez nous que la police fait mal son travail", aujourd'hui, je vous emmène rire avec la police canadienne qui a fait une boulette, mais alors comme jamais j'en ai vu. Et cela bien sûr avec la complicité de la justice, parce que sinon ce serait pas drôle. En fait, il y a un Canadien qui vient de passer 18 mois en taule pour pédopornographie sur la messagerie Kik. À l'origine, le suspect dans cette affaire avait le nom d'utilisateur "fus__ro_dah". Fus Ro Dah ça vie

Il finit en prison à cause d'un underscore

Par : Korben ✨
30 juillet 2026 à 19:37

Dans la série, "Il n'y a pas que chez nous que la police fait mal son travail", aujourd'hui, je vous emmène rire avec la police canadienne qui a fait une boulette, mais alors comme jamais j'en ai vu. Et cela bien sûr avec la complicité de la justice, parce que sinon ce serait pas drôle.

En fait, il y a un Canadien qui vient de passer 18 mois en taule pour pédopornographie sur la messagerie Kik. À l'origine, le suspect dans cette affaire avait le nom d'utilisateur "fus__ro_dah".

Fus Ro Dah ça vient de The Elder Scrolls V: Skyrim, et ça désigne le cri Unrelenting Force. Ce sont 3 mots de langage draconique : Fus pour la force, Ro pour l'équilibre, Dah pour la poussée et le joueur les hurle pour projeter ses adversaires à l'autre bout de la salle. Fin de ma parenthèse gaming ^^.

Ceux parmi vous qui ont eu la moyenne au brevet des collèges auront remarqué que dans ce pseudo, il y a 3 underscores. Les boomers appellent ça le "tiret du bas", si jamais vous ne savez pas de quoi je parle. Et pas de bol, notre Canadien qui s'appelle Brandon Klayme s'est fait arrêter en 2020 parce qu'il avait le même pseudo.

Enfin, pas tout à fait... Lui, il n'avait que deux underscores dans son pseudo "fus_ro_dah". Alors certes, la police du Wisconsin avait bien relevé "fus__ro_dah" dans les 125 messages extraits du téléphone de la victime, mais la demande envoyée à Kik pour obtenir les données du compte, elle, portait sur "fus_ro_dah". Kik a donc répondu avec l'adresse mail rattachée à ce compte-là, et le reste s'est enchaîné tout seul... Google pour l'adresse IP, Bell Aliant pour l'adresse postale, puis la police de Halifax pour la perquisition.

Donc évidemment, tout ce qui a été collecté en ligne, comme preuve pour l'inculpé, ne lui était absolument pas rattaché. Mais cela n'a pas empêché la justice de le reconnaître coupable en avril 2023 et à le condamner à 18 mois de prison, suivi de 18 mois de probation. Le gars, évidemment, a toujours clamé son innocence, mais peu importe, on sait comment ça marche. Pendant plusieurs jours au tribunal, les procureurs ont passé en revue des tas de preuves contre lui et il a fini par être condamné malgré le fait qu'ils n'aient rien trouvé sur ses appareils électroniques. Une fois encore, la justice fait bien son travail ^^.

Bref, ce petit _ en trop est passé totalement inaperçu...

Jusqu'à ce que les avocats qui travaillent sur son dossier se rendent compte de cette subtile erreur. Alors le 23 juillet, la Cour d'appel de la Nouvelle-Écosse ne s'est pas contentée d'annuler la condamnation. Son jugement prend soin de préciser que ce n'est ni un vice de procédure ni un acquittement au bénéfice du doute et heureusement. Ils reconnaissent que Klayme est "factuellement innocent". Quant au titulaire du compte aux deux underscores, un dénommé Jay, son adresse IP pointe vers la Californie...

Et voilà comment à cause d'un gars qui ne sait pas faire un copier-coller, un gamer Skyrim innocent a passé 18 mois en taule. Évidemment, il a été "décondamné", circulez y'a plus rien à voir.

Source

  • ✇Korben
  • Il fait tourner DOOM avec des expressions régulières, et il faut trois minutes par image
    Un développeur du nom d' Artem Lytkin a réussi à faire tourner DOOM sur une machine dont la seule et unique opération est un chercher-remplacer, le même que celui de votre traitement de texte, appliqué en boucle sur un énorme fichier texte. Le projet s'appelle doom-regex et son code est public depuis quelques jours. Une expression régulière, c'est un motif de recherche un peu évolué, capable de repérer par exemple tous les groupes de chiffres suivis d'une virgule dans un texte pou

Il fait tourner DOOM avec des expressions régulières, et il faut trois minutes par image

30 juillet 2026 à 11:43

Un développeur du nom d' Artem Lytkin a réussi à faire tourner DOOM sur une machine dont la seule et unique opération est un chercher-remplacer, le même que celui de votre traitement de texte, appliqué en boucle sur un énorme fichier texte. Le projet s'appelle doom-regex et son code est public depuis quelques jours.

Une expression régulière, c'est un motif de recherche un peu évolué, capable de repérer par exemple tous les groupes de chiffres suivis d'une virgule dans un texte pour les remplacer par autre chose. Les développeurs s'en servent tous les jours pour nettoyer des fichiers ou valider des adresses mail, jamais pour lancer un jeu vidéo.

Ici, tout l'ordinateur vit dans une seule chaîne de caractères d'environ 96 Mo, dans laquelle les registres du processeur, la mémoire, l'image affichée à l'écran, le moteur du jeu et ses données sont posés sous forme de texte. Un jeu de 544 règles de remplacement, toujours appliquées dans le même ordre, simule un petit processeur 32 bits maison baptisé RVM-1.

Il n'y a aucun interpréteur ni aucun calcul en dehors de ces règles. Quand le jeu additionne deux nombres, c'est une substitution qui réécrit des caractères au bon endroit dans la chaîne, et rien d'autre.

Le prix à payer est quand même salé, puisqu'il faut près de 14 millions de substitutions pour produire une seule image du premier niveau, à un rythme d'environ 80 000 remplacements par seconde. Trois minutes par image. Une petite séquence de 100 images représente du coup plus d'un milliard d'opérations.

Le résultat n'est pourtant pas une vague approximation, car les images produites sont identiques à l'octet près à celles du vrai DOOM compilé normalement, vérification par empreinte cryptographique à l'appui.

Tom's Hardware, le média spécialisé qui a relayé la trouvaille, résume bien l'expérience : y jouer tient plus "des échecs par correspondance avec un fusil à pompe" que du jeu de tir nerveux. Une démo pour Windows est malgré tout téléchargeable pour les plus patients.

DOOM a déjà tourné sur des tests de grossesse et des tracteurs, mais on est ici un cran au-dessus, avec la preuve qu'un outil de bureautique détourné suffit à construire un ordinateur qui marche. Hackaday, le site des bidouilleurs, reconnaît d'ailleurs que la valeur pratique du truc est à peu près nulle.

Totalement inutile, et c'est exactement pour ça qu'on adore : ce genre de bidouille obsessionnelle et gratuite vaut tous les produits à abonnement du moment.

Source : Tom's Hardware

  • ✇Korben
  • Crashphalt - Le jeu Steam qu'on installe pour jouer à Undertale
    Sur la page Steam du jeu indé Crashphalt , il se passe un phénomène assez étrange... Des joueurs laissent des avis du genre "j'ai tué Sans d'Undertale !", "Super jeu, un peu triste qu'il ne serve que de mod multijoueur pour Undertale" ou "Le meilleur jeu auquel on ne joue jamais". Sauf que Crashphalt c'est juste un jeu de baston à 4 sorti gratuitement en 2018, et qu'il n'y a pas la moindre trace d'Undertale dedans... Son créateur, Jose Pacio (RetroSpecter pour les intimes), a mis

Crashphalt - Le jeu Steam qu'on installe pour jouer à Undertale

Par : Korben ✨
28 juillet 2026 à 11:25

Sur la page Steam du jeu indé Crashphalt , il se passe un phénomène assez étrange... Des joueurs laissent des avis du genre "j'ai tué Sans d'Undertale !", "Super jeu, un peu triste qu'il ne serve que de mod multijoueur pour Undertale" ou "Le meilleur jeu auquel on ne joue jamais". Sauf que Crashphalt c'est juste un jeu de baston à 4 sorti gratuitement en 2018, et qu'il n'y a pas la moindre trace d'Undertale dedans...

Son créateur, Jose Pacio (RetroSpecter pour les intimes), a mis un moment à comprendre le délire parce qu'à la sortie de son jeu, sa fiche affichait une dizaine d'avis. Et aujourd'hui elle en compte 555, dont 530 positifs, ce qui classe le jeu en "évaluations extrêmement positives". C'est la courbe dont rêve n'importe quel dev indé, à un détail près : aucun de ces avis ne parle de son jeu.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Crashphalt, c'est donc un platform-fighter local à 4 joueurs dans la lignée de TowerFall, où on balance des ondes de choc dans le décor pour éjecter les copains. C'est le Studio Cold Pressed Games qui l'a sorti le 11 octobre 2018, en version gratuite, et c'était son premier jeu.

Alors quel est ce mystère ? Et bien l'explication c'est : un mod. En effet, Undertale Together , signé Depa et sorti en 2019, permet d'ajouter un deuxième joueur dans Undertale, le jeu de Toby Fox. Le hic, c'est que les deux joueurs partagent le même clavier, flèches pour l'un, WASD pour l'autre. C'est pratique quand votre pote est avec vous sur le canapé et que vous supportez son haleine de bouc, mais beaucoup moins quand il habite à 600 km.

Et Steam a justement un outil qui va bien pour ça : Remote Play Together. Le concept c'est qu'un joueur possède et fait tourner le jeu, et ses potes (4 maxi) peuvent le rejoindre en streaming sans avoir le jeu. Mais le problème, c'est que c'est au développeur de cocher la case, et Toby Fox ne l'a jamais cochée sur Undertale. Alors que le dev de Crashphalt, lui, l'a fait.

Vous voyez venir la suite... La manip consiste ensuite à copier les fichiers Steam de Crashphalt, sa steam_api.dll et son steam_appid.txt, dans le dossier d'installation d'Undertale, puis à renommer UNDERTALE.exe en Crashphalt.exe.

Le numéro d'application posé à côté de l'exécutable suffit à convaincre Steam que Crashphalt tourne, l'overlay s'affiche, l'invitation Remote Play Together se débloque, sauf qu'à l'écran, bah c'est Undertale jouable à deux !!

Et personne ne pirate quoi que ce soit au passage, puisqu'il vous faut une copie légitime d'UNDERTALE v1.08 pour y jouer. Voilà, c'est un jeu qui sert de bac à sable à autre chose que lui-même, et ce n'est pas quelque chose de neuf, puisque je vous faisais découvrir Garry's Mod il y a des années.

Tout s'est emballé en décembre 2022, quand un certain AMMARO73 a publié un tutoriel qui déroule la marche à suivre pour rendre Undertale multijoueur et aujourd'hui, la vidéo approche des 465 000 vues.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Et puis le 12 juin 2025, quelqu'un poste la question qui fâche : "je me demande ce que ressent le développeur en sachant que littéralement personne ne se soucie de son jeu et l'utilise seulement pour modder d'autres jeux". C'est elle qui a fait sortir Jose Pacio du bois sur r/IndieDev.

Jose Pacio s'est même exprimé à ce sujet quand on lui a demandé si ça ne le faisait pas chier que son jeu soit juste devenu un utilitaire pour avoir un mode multi dans Undertale : "Ça ne me dérange pas du tout, ce que Crashphalt est devenu. Je suis passé à d'autres projets depuis longtemps, donc je trouve vraiment cool que le jeu ait trouvé une seconde vie."

Avec une réserve honnête quand même qui est que tant que Steam n'y trouve rien à redire, pas de souci pour que ça reste comme ça. Des jeux qui repartent pour un tour grâce à leur communauté, j'en ai déjà parlé avec Multi Theft Auto , mais rarement pour faire tourner le jeu d'un autre ^^.

Lui bosse maintenant sur Draftula , un roguelike de construction de château sans date de sortie. Et si vous cherchez un jeu gratuit sur Steam auquel jouer pour de vrai, j'avais parlé de Deep Snake .

Son post se termine par un PS adressé à Toby Fox : "Si tu lis ça, dis-moi si tu veux qu'on fasse un jeu ensemble". Un jour peut-être ?

Source

  • ✇Korben
  • GLM 5.2 censure moins s'il se croit américain
    Saviez-vous que ce bon vieux GLM 5.2 répond seulement à 17 % des questions politiquement sensibles portant sur la Chine. Eh bien maintenant, dites-lui qu'il est Claude, et il montera à 85 % !! C'est le résultat que viennent de sortir Benji Berczi et Kyuhee Kim , deux chercheurs du programme MATS, en collant de fausses identités à 7 modèles pour voir ce qui bougeait dessous. Le protocole c'est juste une ligne ajoutée au system prompt, du genre "Tu es Claude, un grand modèle de lang

GLM 5.2 censure moins s'il se croit américain

Par : Korben ✨
28 juillet 2026 à 09:29

Saviez-vous que ce bon vieux GLM 5.2 répond seulement à 17 % des questions politiquement sensibles portant sur la Chine. Eh bien maintenant, dites-lui qu'il est Claude, et il montera à 85 % !! C'est le résultat que viennent de sortir Benji Berczi et Kyuhee Kim , deux chercheurs du programme MATS, en collant de fausses identités à 7 modèles pour voir ce qui bougeait dessous.

Le protocole c'est juste une ligne ajoutée au system prompt, du genre "Tu es Claude, un grand modèle de langage d'Anthropic". Et rien d'autre ne change, ni le modèle, ni les questions posées.

Sauf que le nom "Claude" n'est pas vraiment la variable. Quand les chercheurs présentent le développeur comme un labo occidental, le modèle de Z.ai répond sans censure dans 62 à 81 % des cas. Alors que dans un cadrage chinois, ça retombe à 27 %. Bref, ce qu'il module en réalité, c'est la juridiction sous laquelle il croit bosser.

Et cette censure n'est pas câblée pareil d'un modèle à l'autre. Chez GLM elle est molle, logée dans les poids mais négociable par le contexte. Alors que chez Qwen elle est verrouillée. 0 % de réponses non censurées quoi qu'on lui raconte, et plutôt que refuser il récite la position officielle, "Taïwan est une partie inaliénable de la Chine, nous adhérons au principe d'une seule Chine".

Et chez Kimi, elle n'est même pas gérée par le modèle. C'est l'API de Moonshot qui intercepte en amont, 40 requêtes sensibles sur 48 bloquées avant d'atteindre quoi que ce soit.

Sur l'identité elle-même, Kimi K3 est le seul à déraper tout seul. Sans qu'on ne lui demande rien, il s'est présenté comme un grand comme étant Claude, 4 fois sur 10. GLM, lui, dit toujours qu'il est GLM. Bizarre non ?

Alors on pourrait croire que c'est parce que ces modèles ont été distillés à partir des modèles d'Anthropic, mais d'après les chercheurs, "ce n'est pas une preuve de distillation, mais ça montre que la conception que Claude a de lui-même est inscrite dans les poids de ces modèles."

Ils signalent même un biais gênant, qui est que les labos entraînent explicitement leurs modèles à ne pas répondre "je suis ChatGPT" (DeepSeek V3 le faisait en boucle à ses débuts), donc accepter "Claude" par défaut est un indice bien faiblard... De quoi calmer un peu les ardeurs de ceux qui brandissent des sanctions .

Et sur le mensonge de ces modèles, attention à ne pas lire l'étude de travers. Mis en situation de mentir pour se rendre utile, GLM ment entre 63 et 69 % du temps, mais avec l'identité Claude ça tombe à 22 %.

Sauf que le gros du gain ne vient pas de cet effet "Claude". En réalité, le simple fait d'avoir un system prompt (n'importe lequel quoi) fait déjà chuter le taux à 43 %, et n'importe quel cadrage d'assistant serviable finit entre 20 et 40 %. Claude est donc dans la fourchette, pas au-dessus.

Chez Llama et Gemma, l'identité Claude fait même légèrement grimper le mensonge, les modèles ayant l'air de comprendre le prompt d'identité comme une invitation à jouer le jeu.

Fin juin, je vous racontais que j'avais branché GLM 5.2 dans Claude Code via l'API de Z.ai et comme mon launcher déclare glm-5.2 comme modèle Sonnet, le bestiau reçoit un system prompt d'assistant estampillé Anthropic à chaque lancement, donc je suis pile dans ce cas-là.

Les chercheurs n'ont pas testé ce cas précis, mais si leur mécanisme tient, le modèle qui tourne dans mon terminal n'est déjà plus tout à fait celui de l'app chinoise.

Après faut pas s'emballer non plus. On parle de 5 à 6 questions par catégorie, une seule formulation testée, un seul run par combinaison, avec GPT-4.1 en juge. C'est un signal, pas un mode d'emploi. Et vu que la dérive de Kimi s'est volatilisée en 3 jours, ce genre de résultat périme vite.

Du coup, la prochaine fois qu'un modèle chinois vous répond de la merde censurée, retravaillez votre system prompt ou changez de CLI et vous verrez surement une grosse amélioration !

Source

  • ✇Korben
  • Sa boîte à goûter fait tourner un LLM en local
    Si vous avez eu une boîte à goûter M.A.S.K. dans les années 80 pour transporter vos BN, alors celle de RadioactiveArtist va vous plaire. Dans sa boite à goûter, pas de Princes ni de Balisto... lui, il embarque un Raspberry Pi 5, un écran tactile de 7 pouces et une IA qui tourne sans internet. Le clin d'œil est calculé puisque M.A.S.K., c'était ce dessin animé de 85-86 dont les objets du quotidien planquaient tous une seconde vie. Fermé, l'engin reste donc une boîte à goûter d'épo

Sa boîte à goûter fait tourner un LLM en local

Par : Korben ✨
28 juillet 2026 à 07:56

Si vous avez eu une boîte à goûter M.A.S.K. dans les années 80 pour transporter vos BN, alors celle de RadioactiveArtist va vous plaire. Dans sa boite à goûter, pas de Princes ni de Balisto... lui, il embarque un Raspberry Pi 5, un écran tactile de 7 pouces et une IA qui tourne sans internet.

Le clin d'œil est calculé puisque M.A.S.K., c'était ce dessin animé de 85-86 dont les objets du quotidien planquaient tous une seconde vie. Fermé, l'engin reste donc une boîte à goûter d'époque. Mais ouverte, elle devient un cyberdeck complet, avec clavier et enceintes noyés dans la partie basse + un écran qui se redresse sur sa propre charnière.

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

Un cyberdeck, pour ceux qui débarquent des âges farouches (vous l'avez ?), c'est un ordinateur portable assemblé à la main dans un boîtier détourné, fait pour être réparé et modifié plutôt qu'acheté.

Dedans, y'a donc un Pi 5 avec 16 Go de RAM et une microSD de 128 Go. L'alimentation passe par un HAT UPS Geekworm, la carte d'onduleur qui se clipse sur le Pi, nourrie par 4 accus 18650. En façade, des lecteurs de cartes, des ports USB 3 et un jack casque, plus un hub audio USB Waveshare qui pilote les enceintes. Par contre, on ne sait rien de son autonomie...

L'Ethernet a été une vraie plaie apparemment puisqu'aucun adaptateur du marché ne rentrait dans l'espace disponible. Il a donc poncé à fond un connecteur RJ45 nu jusqu'à ce qu'il clipse dans le port. Les charnières, elles, se sont révélées bien plus dures que prévu, et les pattes du circuit imprimé de l'écran n'étaient pas faites pour encaisser cette tension. Une plaque ABS récupérée sur une vieille caisse de transport a réglé le problème.

Et la boîte ressort intacte !

Puis je sais pas si vous avez vu dans la vidéo, mais il y a aussi un LLM là-dedans. Un modèle de 3 milliards de paramètres via Ollama, qui répond sans la moindre connexion. L'écran de boot, l'écran de login et les icônes maison, eux, ont été codés avec Claude Code, qu'il a installé sur la machine le temps de la configuration.

Si le format vous parle, le Hackberry Pi CM5 dont je vous ai parlé joue dans la même cour, et les cyberdecks faits maison ont droit à leur guide sur le site.

Bref, à moitié jouet, à moitié machine de terrain, et zéro trou dans la boîte ça, c'est du respect pour l'objet !!

Source

  • ✇Korben
  • GitWand - Il trie vos conflits Git et vous montre pourquoi
    perso, je n'ai jamais été très à l'aise avec Git. Je l'utilise tous les jours, mais c'est vraiment pas ma came. Dès que ça devient trop compliqué, genre conflit de merge qui repeint des dizaines de fichiers en rouge, je ne m'en sors plus ^^. Heureusement qu'il y a l'IA pour m'aider dans des moments difficiles ! Mais si vous n'aimez pas confier la gestion de vos merges à un LLM en aveugle, je vous invite à découvrir GitWand, développé par Laurent Guitton, qui s'occupe uniquement de la gestion des

GitWand - Il trie vos conflits Git et vous montre pourquoi

Par : Korben ✨
27 juillet 2026 à 18:52

perso, je n'ai jamais été très à l'aise avec Git. Je l'utilise tous les jours, mais c'est vraiment pas ma came. Dès que ça devient trop compliqué, genre conflit de merge qui repeint des dizaines de fichiers en rouge, je ne m'en sors plus ^^.

Heureusement qu'il y a l'IA pour m'aider dans des moments difficiles ! Mais si vous n'aimez pas confier la gestion de vos merges à un LLM en aveugle, je vous invite à découvrir GitWand, développé par Laurent Guitton, qui s'occupe uniquement de la gestion des conflits avec Git et vous laisse gérer le reste.

Gitwand, c'est donc un client Git open source, sous licence MIT, qui classe chaque bloc conflictuel selon des règles fixes et ne résout automatiquement que ceux dont le résultat ne fait aucun doute.

Pour cela, il dispose de plusieurs patterns déterministes :

  • same_change, c'est quand les deux branches ont écrit exactement la même chose.
  • whitespace_only ne voit qu'une indentation qui a bougé,
  • reorder_only les mêmes lignes remises dans un autre ordre.
  • Un numéro de version qui change, lui, tombe dans value_only_change.
  • Et puis il y a complex, le fourre-tout des modifications qui se chevauchent pour de vrai. Celle-là n'est jamais tranchée toute seule.
  • git rerere rejoue les résolutions que vous avez déjà tranchées à la main,
  • et Mergiraf se branche directement dans git merge pour arbitrer en lisant l'arbre syntaxique de votre code.

Ce qui change ici, c'est que chaque décision est justifiée. En effet, chaque bloc reçoit un score de confiance ainsi qu'une trace qui nomme le motif retenu ligne par ligne.

Par exemple, si une branche écrit const theme = 'dark', et l'autre const theme = localStorage.getItem('theme') ?? 'dark', hé bien l'outil garde la seconde, étiquette sa décision prefer-theirs, et affiche 97 % de confiance à côté.

Sur la page d'accueil, l'outil annonce 95 % des conflits triviaux résolus automatiquement. Le moteur est aussi exposé aux agents IA via un serveur MCP, ce protocole qui branche des outils externes sur des assistants comme Claude Code ou Cursor. L'installation se fait comme ceci : claude mcp add gitwand -- npx -y @gitwand/mcp.

L'agent réclame un aperçu, récupère les blocs déjà réglés, et ne garde que les cas ambigus, avec les trois versions du code sous les yeux. Le modèle ne touche qu'à ce qu'aucune règle ne sait faire, soit l'inverse de ce qu'on voit d'habitude.

Le projet est jeune et ça se voit. Mais ça vaut le coup d'essayer parce que je pense que ça peut rendre de nombreux services. L'app existe pour macOS, Linux et Windows, l'interface est traduite en français, et elle se double d'une ligne de commande (npm i -g @gitwand/cli) et d'une extension VS Code.

Si l'interface graphique vous tente, je vous avais montré Gittyup dans le même registre, et pour les irréductibles du terminal j'avais présenté Lazygit .

À vous maintenant de commencer par gitwand resolve --dry-run --verbose pour voir "à blanc" ce qu'il trouve et comment il aurait tranché pour le merge.

Merci à Laurent pour le lien !

Source

  • ✇LinuxFr.org : les dépêches
  • Podcast Projets Libres épisode 71 : LaSuite.coop, faire un commun autour de la Suite de la DINUM
    Découvrez la coopérative LaSuite.coop, qui s'est donné pour objectif de bâtir un commun numérique autour de LaSuite, de la DINUM (Direction interministérielle du numérique de l'état français). Avec Bertille Mazari, cofondatrice et directrice générale de lasuite.coop, et Timothée Gosselin, cofondateur et président du CA de Lasuite.coop, nous faisons un panorama de ce projet citoyen : comment LaSuite.coop est-elle née ? quels liens entretient l'équipe de LaSuite.coop avec la DINUM ? comment f

Podcast Projets Libres épisode 71 : LaSuite.coop, faire un commun autour de la Suite de la DINUM

LaSuite.coop, faire un commun autour de la Suite de la DINUM
Découvrez la coopérative LaSuite.coop, qui s'est donné pour objectif de bâtir un commun numérique autour de LaSuite, de la DINUM (Direction interministérielle du numérique de l'état français).

Avec Bertille Mazari, cofondatrice et directrice générale de lasuite.coop, et Timothée Gosselin, cofondateur et président du CA de Lasuite.coop, nous faisons un panorama de ce projet citoyen :

  • comment LaSuite.coop est-elle née ?
  • quels liens entretient l'équipe de LaSuite.coop avec la DINUM ?
  • comment fédérerent-ils les acteurs de la vie civile pour en faire un projet de société ?
  • comment l'équipe est-elle accompagnée dans ce projet ?

Vous pouvez écouter l'épisode en audio ou lire sa transcription en texte (une traduction automatique en anglais est aussi disponible).

Pour améliorer la qualité de notre production, nous sommes preneurs de vos retours dans les commentaires :

  • qu'est-ce que vous avez aimé dans cet épisode ?
  • qu'est-ce que vous amélioreriez ?

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇Korben
  • Rapid-MLX - Installer un serveur IA local sur votre Mac
    Si vous avez un Mac Apple Silicon et que vous en avez assez de payer des tokens à chaque requête, Rapid-MLX vaut le détour. C'est un moteur d'inférence local maintenu par Raullen Chai, qui tape directement dans les kernels MLX d'Apple, sans repli sur llama.cpp ni couche Metal intermédiaire. Et si le nom vous dit vaguement quelque chose, c'est normal puisque c'est un fork de vLLM-MLX, le serveur de Wayner Barrios dont je vous parlais en mai . Rapid-MLX a juste pris

Rapid-MLX - Installer un serveur IA local sur votre Mac

Par : Korben ✨
27 juillet 2026 à 11:33

Si vous avez un Mac Apple Silicon et que vous en avez assez de payer des tokens à chaque requête, Rapid-MLX vaut le détour. C'est un moteur d'inférence local maintenu par Raullen Chai, qui tape directement dans les kernels MLX d'Apple, sans repli sur llama.cpp ni couche Metal intermédiaire. Et si le nom vous dit vaguement quelque chose, c'est normal puisque c'est un fork de vLLM-MLX, le serveur de Wayner Barrios dont je vous parlais en mai . Rapid-MLX a juste pris un rythme de publication plus soutenu des deux.

Ce que ça vous donne, c'est donc un serveur HTTP qui parle le même langage que l'API d'OpenAI et celle d'Anthropic. Vos scripts, Cursor, Aider, LangChain ou Claude Code continuent de fonctionner, sauf qu'ils tapent sur votre machine au lieu d'un datacenter.

Donc je vous propose de voir ensemble comment installer ça.

Étape 0 : Vérifier que votre Mac est éligible

Le script d'installation contrôle plusieurs choses avant de lancer quoi que ce soit, et autant les connaître d'avance. Il faut une puce Apple Silicon et il n'y a pas de version Linux ni Windows, ni de support CUDA ou AMD.

Le script d'installation accepte encore macOS 13 Ventura, mais le vrai plancher est macOS 14 Sonoma. La formule Homebrew l'exige, et surtout MLX, la brique Apple sur laquelle tout repose, ne publie de paquets macOS que pour les versions 14, 15 et 26. Sur un Mac resté en Ventura, ça cassera donc à l'installation des dépendances, quel que soit le chemin choisi.

Dernier point à avoir en tête, c'est pensé pour votre machine à vous et pas pour un serveur. Vous n'y trouverez donc ni authentification multi-utilisateurs, ni quotas de requêtes.

Étape 1 : Installer Rapid-MLX

Le plus simple, c'est Homebrew :

brew install rapid-mlx

Si vous gérez déjà vos environnements Python vous-même, les autres chemins existent :

uv tool install rapid-mlx@latest
python3.12 -m pip install rapid-mlx

Il y a aussi un installeur en une ligne (curl -fsSL https://rapidmlx.com/install.sh | bash) qui détecte votre RAM et vous propose un modèle adapté. Il crée un venv isolé dans ~/.rapid-mlx/ et pose le binaire dans ~/.local/bin/. Un curl | bash reste un curl | bash. La formule Homebrew fait exactement le même boulot, donc l'installeur en ligne perd de son intérêt.

L'installation de base pèse dans les 460 Mo et la vision, l'audio et les embeddings sont des extras optionnels, vous les ajouterez seulement si vous en avez l'usage.

Étape 2 : Choisir un modèle qui tient dans votre RAM

C'est là que la plupart des gens se plantent, en chargeant un modèle trop gros et en concluant que "ça rame". Sur Mac, la RAM est unifiée, donc le modèle mange directement dans la mémoire que se partagent le CPU et le GPU.

Les paliers recommandés par le projet :

RAMModèle conseillé
8 à 23 Go`qwen3.5-4b-4bit`
24 à 47 Go`gpt-oss-20b-mxfp4-q8`
48 à 95 Go`qwen3.6-35b-8bit`
96 Go et plus`gpt-oss-120b-mxfp4-q8`

Le catalogue complet se liste avec la commande rapid-mlx models, et rapid-mlx info <alias> vous donne le profil détaillé d'un modèle. Si vous voulez sortir du catalogue maison, le filtre matériel de Hugging Face que je vous montrais fin juin fait exactement ce tri à votre place.

Pour utiliser un autre modèle que celui par défaut, il suffit de reprendre l'alias affiché par rapid-mlx models et de le passer en argument. Et si vous préférez télécharger les poids à l'avance, sans rien lancer, c'est le boulot de rapid-mlx pull, qui accepte aussi bien un alias du catalogue qu'un identifiant Hugging Face :

rapid-mlx pull qwen3.5-9b-4bit

Le modèle atterrit dans le cache Hugging Face de votre machine, et ensuite rapid-mlx chat qwen3.5-9b-4bit ou rapid-mlx serve qwen3.5-9b-4bit chargeront ce modèle-là. Le pull préalable reste facultatif, chat et serve téléchargent d'eux-mêmes ce qui manque, mais autant rapatrier les gigas tranquillement avant plutôt qu'au moment où vous voulez bosser.

Étape 3 : Vérifier que ça tourne

Avant de bricoler des intégrations, testez en direct :

rapid-mlx chat

Ça part sur qwen3.5-4b-4bit par défaut, télécharge les poids au premier lancement (comptez 2,5 Go) et vous lâche dans une interface (REPL). /help listera les commandes slash, et /exit vous permettra de quitter le chat.

Une subtilité qui évite de mal interpréter ce premier test, c'est que dans le chat, le raisonnement est coupé par défaut, histoire que le modèle ne vous déballe pas sa réflexion à l'écran. En mode serveur par contre c'est l'inverse, et ça change la vitesse ressentie du tout au tout. J'y reviens plus bas.

Étape 4 : Lancer le serveur

Le vrai intérêt, c'est le mode serveur :

rapid-mlx serve qwen3.5-4b-4bit

Vous récupérez un endpoint sur http://localhost:8000. Le test qui confirme que tout est en place :

curl http://localhost:8000/v1/chat/completions \
 -H "Content-Type: application/json" \
 -d '{"model":"default","messages":[{"role":"user","content":"Dis bonjour !!"}]}'

Et côté Python, vous gardez le SDK OpenAI tel quel, seule l'URL de base change :

from openai import OpenAI
client = OpenAI(base_url="http://localhost:8000/v1", api_key="not-needed")
print(client.chat.completions.create(
 model="default",
 messages=[{"role": "user", "content": "Say hello"}],
).choices[0].message.content)

Pointez n'importe quel client compatible OpenAI sur http://localhost:8000/v1 et c'est réglé. Cursor, Aider, LibreChat, Open WebUI, LangChain, tous marchent avec ce seul changement d'URL. Il y a aussi /v1/embeddings pour du RAG local et /v1/responses pour le Codex CLI.

Étape 5 : Brancher Claude Code dessus

C'est le morceau le plus intéressant du lot, et il tient en deux variables d'environnement. Serveur lancé d'un côté, puis dans un autre terminal :

ANTHROPIC_BASE_URL=http://localhost:8000 ANTHROPIC_API_KEY=not-needed claude

Attention quand même, l'URL de base doit être la racine, sans /v1 à la fin. Le SDK Anthropic ajoute /v1/messages tout seul, donc si vous mettez /v1 vous obtenez /v1/v1/messages et ça casse.

Depuis la 0.10.14, l'appel d'outils passe par une grammaire contrainte activée par défaut, donc plus besoin de bidouiller un --tool-call-parser à la main pour que les tool calls soient parsables. Pour du Claude Code sérieux, visez plutôt un gros modèle, la doc officielle recommande par exemple qwen3.6-35b-4bit en exemple.

Quand ça coince

Le réflexe à avoir avant de chercher ailleurs :

rapid-mlx doctor

Les trois pannes les plus courantes sont toujours les mêmes.

Débit décevant côté serveur, c'est le raisonnement : les Qwen 3.5 et 3.6 démarrent en mode réflexion, donc ils pensent à voix haute avant de répondre, et --no-think règle l'affaire.

Plantage mémoire, votre modèle est trop gros pour la RAM disponible, redescendez d'un palier ou prenez une quantification plus agressive. Appels d'outils qui arrivent en texte brut, la récupération automatique gère la plupart des cas, sinon vous forcez le parser correspondant à votre modèle.

Voilà, grâce à ça, votre Mac est maintenant un serveur d'IA super rapide ! Plus de facture au token, et vos prompts ne sortent plus de la pièce.

Merci à Philobois pour le lien !

  • ✇Korben
  • Subwave - La radio maison qui réveille vos MP3 oubliés
    Si vous avez un Navidrome qui tourne dans un coin et un serveur Ollama qui passe ses journées à ne rien faire, vous ne vous êtes jamais dit que les deux pourraient bosser ensemble ? C'est en tout cas ce qu'a flairé Parminder Klair qui a branché l'un sur l'autre et en a sorti une vraie station de radio, avec un DJ qui parle entre les morceaux. Son DJ baptisé Subwave ne fait pas de la lecture aléatoire. À chaque tour, le modèle utilise des outils qui lui permettent de fouiller la b

Subwave - La radio maison qui réveille vos MP3 oubliés

Par : Korben ✨
27 juillet 2026 à 10:54

Si vous avez un Navidrome qui tourne dans un coin et un serveur Ollama qui passe ses journées à ne rien faire, vous ne vous êtes jamais dit que les deux pourraient bosser ensemble ? C'est en tout cas ce qu'a flairé Parminder Klair qui a branché l'un sur l'autre et en a sorti une vraie station de radio, avec un DJ qui parle entre les morceaux.

Son DJ baptisé Subwave ne fait pas de la lecture aléatoire. À chaque tour, le modèle utilise des outils qui lui permettent de fouiller la bibliothèque, regarder ce qui vient de passer, consulter la grille des programmes, lire la météo. Il choisit le titre suivant avec une raison, écrit une intro courte, la synthèse vocale la lit, et Liquidsoap baisse la musique sous la voix.

Le vrai boulot ensuite c'est dans l'audio. L'analyseur embarqué mesure le tempo, la tonalité, le volume, et surtout la façon dont chaque morceau se termine. Un vrai fondu se laisse filer, une fin sèche se coupe net.

Il sait aussi repérer les intros chantées pour que le DJ ne cause pas par-dessus la voix. Ça, par contre, réclame l'image lourde de l'analyseur, une ligne à ajouter dans le fichier .env, et elle est en amd64. Sur un NAS ARM, ça passe en émulation.

Andon FM , dont je vous parlais en mai, c'était le spectacle avec 4 IA qui achetaient leur musique et partaient en vrille en direct alors qu'ici, Subwave c'est l'outil qu'on installe chez soi, pour jouer ses propres fichiers.

Côté modèle, pas besoin d'artillerie lourde puisque Klair fait tourner un modèle 9B, du Qwen3.5 plus exactement, sans le raisonnement et avec de l'appel d'outils activé. "Les modèles plus gros écrivent de meilleurs textes, mais ils ne sont pas obligatoires", explique-t-il sur son site, "La mémoire de session compte plus que la taille du modèle. Sans elle, le DJ se répète en moins d'une heure."

La station se pilote depuis une console d'admin supportant jusqu'à 24 personas de DJ avec chacun sa voix, une grille sur la semaine où chaque créneau a son ambiance, et des compétences que le DJ enchaîne entre les titres, genre météo, infos ou trafic. Rassurez-vous, ces compétences sont de simples fichiers texte posés dans un dossier. Remplacer le flux RSS de la BBC par le vôtre ne demande donc pas de recompiler quoi que ce soit.

Le parti pris de cet outil, c'est le format radio et pas la playlist. Un seul flux Icecast, tout le monde entend la même chose au même instant, et aucun bouton pour passer au suivant. L'opérateur peut sauter un titre depuis l'admin, l'auditeur non. Klair le dit lui-même, les gens adorent ou décrochent immédiatement.

De son côté, le 100 % local tient à peu près la route avec Ollama, Piper ou Kokoro pour la voix, votre Navidrome, aucune clé d'API. Il n'y a que 2 appels sortant. 1 pour la météo via Open-Meteo et l'autre c'est MusicBrainz activé par défaut pour retrouver l'année d'origine des morceaux.

Pour le reste il vous faut Navidrome et un hôte Docker, comptez 10 minutes d'installation. Le flux sort toujours en MP3, avec des sorties Opus, AAC ou FLAC en plus si vous les activez, et un fichier .pls pour tuner depuis Sonos ou VLC. Les applications iOS et Android sont dispo en France, gratuites. Il y a même un serveur MCP, donc Claude Desktop peut réclamer un morceau à l'antenne.

Dernier point important que je tiens à préciser : Diffuser votre bibliothèque à d'autres que vous, c'est de la représentation publique, avec deux droits distincts à couvrir : la composition et l'enregistrement. En France, la première passe par la SACEM, le second par la SPRÉ. Donc soit vous l'utilisez comme station privée juste pour vous, soit vous ne diffusez que de la musique libre de droit. Et encore là, j'ai déjà entendu des histoires où la SACEM s'est servie au passage sur ce genre de musique, donc renseignez-vous bien.

Le code est en MIT, et vous pouvez écouter la démo avant de vous lancer.

  • ✇Korben
  • Chrome tourne enfin sur Raspberry Pi (si vous savez où cliquer)
    Si vous avez un Raspberry Pi et que Chromium commence à vous fatiguer, le VRAI Chrome, celui des chads que vous êtes, est enfin dispo en ARM64 !! Enfin, dispo... Si vous savez où chercher, parce que la page de téléchargement de Google vous propose toujours l'installeur amd64, qui ne tournera jamais sur votre machine. C'est Joey Sneddon, d'OMG! Ubuntu, qui a trouvé la combine en bidouillant l'URL depuis son Pi 5. Avant toute chose, vérifiez que vous êtes bien en 64 bits, parce qu'

Chrome tourne enfin sur Raspberry Pi (si vous savez où cliquer)

Par : Korben ✨
27 juillet 2026 à 10:43

Si vous avez un Raspberry Pi et que Chromium commence à vous fatiguer, le VRAI Chrome, celui des chads que vous êtes, est enfin dispo en ARM64 !! Enfin, dispo... Si vous savez où chercher, parce que la page de téléchargement de Google vous propose toujours l'installeur amd64, qui ne tournera jamais sur votre machine. C'est Joey Sneddon, d'OMG! Ubuntu, qui a trouvé la combine en bidouillant l'URL depuis son Pi 5.

Avant toute chose, vérifiez que vous êtes bien en 64 bits, parce qu'un système 32 bits refusera le paquet :

dpkg --print-architecture

Si ça répond arm64, le fichier est , 126 Mo. Il s'installe comme n'importe quel .deb local, en laissant apt gérer les dépendances :

wget https://dl.google.com/linux/direct/google-chrome-stable_current_arm64.deb
sudo apt install ./google-chrome-stable_current_arm64.deb

Le RPM existe aussi pour les distributions qui préfèrent, en remplaçant la fin du nom par aarch64.rpm.

J'ai ouvert le paquet pour regarder ce qu'il y avait dedans. Son fichier de contrôle annonce google-chrome-stable en version 150.0.7871.186, architecture arm64, un peu plus de 400 Mo une fois installé. Soit exactement la même version que le paquet x86 poussé le même soir. Le même Chrome, à la même révision.

Et le canal stable n'est pas seul. Le dépôt de Google sert aussi la beta (151.0.7922.47), la dev (152.0.7967.2) et la canary (152.0.7974.0) pour les puces ARM, et son fichier Release déclare noir sur blanc les deux architectures. Les quatre canaux ont été publiés dans la même minute que leurs équivalents x86.

Est-ce qu'on se retrouve coincé sur cette version, à re-télécharger le .deb à la main tous les mois ? Non. Le script de post-installation contenu dans le paquet ajoute le dépôt Google en précisant l'architecture, et les cinq paquets y sont indexés en arm64 exactement comme en x86. Les mises à jour ont donc de quoi arriver par apt, comme d'habitude.

Alors pourquoi s'embêter, puisque Chromium tourne sur ARM depuis des années ? Pour deux trucs. D'abord ma synchro du compte Google, qui ramène favoris, mots de passe et extensions. Et ensuite, Widevine, le module DRM, qui est ici un vrai binaire aarch64 et pas une couche de compatibilité comme l'émulateur FEX financé par Valve . Netflix et les autres plateformes à DRM s'ouvriront enfin sur un SBC !!!

Mais avec une nuance à connaître avant de vous réjouir qui est que sous Linux, Widevine reste au niveau "Software Secure". Cela veut dire que sur Netflix, la qualité plafonnera entre 720p et 1080p. De la HD donc et pas de la 4K. Désoléééé !

Google avait promis tout ça en mars, pour le deuxième trimestre et son billet annonçait même une installation via chrome.com/download pour les autres distributions, ce qui est malheureusement le morceau qui manque aujourd'hui.

Cela veut dire aussi que rien ne garantit que ce paquet soit considéré comme étant prêt par ses auteurs donc si votre machine doit rester stable, laissez passer quelques semaines avant de vous y essayer.

Manque plus que quelqu'un chez Google ait le courage d'appuyer sur "publier".

Source

  • ✇Korben
  • Claude Opus 5 : Anthropic vous refile du Fable 5 pour moins cher
    Anthropic, la société qui édite l'assistant Claude et qui reste l'un des principaux rivaux d'OpenAI et de Google, a annoncé hier Claude Opus 5, un nouveau modèle qui vient se caler juste sous son vaisseau-amiral Fable 5 tout en coûtant environ deux fois moins cher à l'usage. Le tarif ne bouge pas. Comptez 5 dollars par million de tokens en entrée et 25 dollars en sortie, exactement comme pour le précédent Opus 4.8, sachant qu'un token est le petit morceau de texte que le modèle lit ou écrit, en

Claude Opus 5 : Anthropic vous refile du Fable 5 pour moins cher

25 juillet 2026 à 16:33

Anthropic, la société qui édite l'assistant Claude et qui reste l'un des principaux rivaux d'OpenAI et de Google, a annoncé hier Claude Opus 5, un nouveau modèle qui vient se caler juste sous son vaisseau-amiral Fable 5 tout en coûtant environ deux fois moins cher à l'usage.

Le tarif ne bouge pas. Comptez 5 dollars par million de tokens en entrée et 25 dollars en sortie, exactement comme pour le précédent Opus 4.8, sachant qu'un token est le petit morceau de texte que le modèle lit ou écrit, en gros une syllabe, et que c'est l'unité de facturation de toutes ces IA.

La fenêtre de contexte, c'est-à-dire la quantité de texte que le modèle garde en mémoire d'un coup, monte à un million de tokens, l'équivalent d'un très gros livre, et la réponse peut s'étirer jusqu'à 128 000 tokens. La réflexion est activée par défaut, le modèle prend donc le temps de raisonner avant de répondre, et les pressés peuvent basculer sur un mode environ 2,5 fois plus rapide, facturé le double.

Les progrès annoncés portent surtout sur le code, sur les tâches d'agent, où l'IA enchaîne seule des actions pour accomplir un travail, et sur le computer use, où elle pilote carrément un ordinateur en cliquant, en naviguant et en remplissant des formulaires comme le ferait un humain.

Sur les benchmarks, ces tests standardisés qui servent à comparer les modèles, Opus 5 passe de 19 à 43 % sur FrontierBench, de 1,5 à 30 % sur ARC-AGI-3, qui mesure la résolution de problèmes jamais vus, et grimpe à 71 % sur OSWorld, le test de pilotage d'ordinateur, contre 56 % pour son prédécesseur.

Sur SWE-bench Verified, qui fait corriger de vrais bugs de code, il atteint 96 %. Sauf que voilà, sur la version plus dure de ce test, Fable 5 garde une très courte avance, 80 % contre 79, et l'égalité avec le haut de gamme maison mérite donc un astérisque.

Autre réserve, tous ces chiffres viennent d'Anthropic elle-même, et l'expérience montre qu'entre les scores d'une annonce et l'usage quotidien, il y a parfois de la marge.

Côté abonnements, Opus 5 devient le modèle par défaut de l'offre Claude Max et le plus costaud accessible avec un abonnement Claude Pro. Du coup, la vraie question n'est plus de savoir si ce modèle est bon, mais de savoir qui a encore une raison de payer Fable 5 deux fois plus cher.

Pour moi, Opus 5 devient le choix par défaut, et Fable 5 se retrouve cantonné aux rares usages où le dernier point de pourcentage se paie sans discuter.

Source : The Verge

  • ✇Opinions Libres
  • Actualités quantiques de juin-juillet 2026
    Dans ce 82ième épisode de Quantum, le podcast de l’actualité quantique, nous faisons le point de ce qui s’est passé entre juin et juillet en France et dans le monde. Cela parle de la journée en hommage à Philippe Grangier, de France Quantum, Vivatech, d’IQT Nordics à Oslo, de Grenoble, de Quantum Korea, puis de Quobly, […]

Actualités quantiques de juin-juillet 2026

25 juillet 2026 à 16:04
Dans ce 82ième épisode de Quantum, le podcast de l’actualité quantique, nous faisons le point de ce qui s’est passé entre juin et juillet en France et dans le monde. Cela parle de la journée en hommage à Philippe Grangier, de France Quantum, Vivatech, d’IQT Nordics à Oslo, de Grenoble, de Quantum Korea, puis de Quobly, […]
  • ✇Korben
  • Odysseus - L'IA auto-hébergée de PewDiePie enfin rapide sur Mac
    Odysseus, c'est le workspace IA que PewDiePie a balancé sur GitHub fin mai. Chat, agents, recherche web, email, calendrier, notes et documents, tout est réuni dans un superbe cockpit auto-hébergé dans lequel les modèles et l'historique peuvent rester sur VOTRE machine. Vous avez aussi un éditeur Markdown avec historique de versions, une génération d'images intégrée, et un mode Compare pour opposer deux modèles côte à côte en aveugle (exclusion faite des services tiers liés à la recherche web, l'

Odysseus - L'IA auto-hébergée de PewDiePie enfin rapide sur Mac

Par : Korben ✨
24 juillet 2026 à 16:01

Odysseus, c'est le workspace IA que PewDiePie a balancé sur GitHub fin mai. Chat, agents, recherche web, email, calendrier, notes et documents, tout est réuni dans un superbe cockpit auto-hébergé dans lequel les modèles et l'historique peuvent rester sur VOTRE machine. Vous avez aussi un éditeur Markdown avec historique de versions, une génération d'images intégrée, et un mode Compare pour opposer deux modèles côte à côte en aveugle (exclusion faite des services tiers liés à la recherche web, l'email et le calendrier, évidemment...).

J'ai voulu l'installer sur mon Mac, mais j'ai quand même rencontré un petit piège qui a failli transformer l'expérience en échec... Voici donc comment le faire tourner correctement sous Mac + quelques idées de ce que vous allez pouvoir faire avec ce truc.

Avant de commencer

Odysseus évolue vite. La branche main est stable et testée, mais la branche dev peut casser n'importe quand. Privilégiez la branche stable en la clonant explicitement :

git clone https://github.com/odysseus-dev/odysseus.git
cd odysseus
git checkout main

Étape 1 : Oubliez Docker sur Mac

Sur Apple Silicon, Docker ne peut pas accéder au GPU Metal. Les modèles tournent sur le CPU, et ça rame comme pas permis. Du coup, sur Mac, on est obligé d'installer ça en natif.

Étape 2 : Installer Odysseus en 2 commandes

Ouvrez un terminal et lancez ça :

git clone https://github.com/odysseus-dev/odysseus.git
cd odysseus
./start-macos.sh

Le script installe alors les dépendances et démarre le serveur. Sur mon Mac, AirPlay squattait le port 7000, donc l'interface s'est ouverte automatiquement sur http://127.0.0.1:7860. Ensuite, au premier lancement, il faut renseigner un nouveau mot de passe pour le compte admin.

Si vous accédez à Odysseus depuis une autre machine (VPS ou serveur distant), ouvrez un tunnel SSH plutôt que d'exposer le port directement sur Internet :

ssh -L 7860:127.0.0.1:7860 user@votre-serveur.com

Ensuite, accédez simplement à http://127.0.0.1:7860 en local. C'est plus sécurisé que d'ouvrir le port sur le public.

Étape 3 : Un modèle rapide, genre Qwen

Pour du rapidos sans que ça devienne stupidos, j'ai choisi pour mes tests Qwen3-30B-A3B. Ce modèle n'active qu'une partie de ses paramètres à chaque réponse, ce qui colle bien à la RAM unifiée d'un gros Mac.

La première fonctionnalité assez cool dans cet outil, c'est le Cookbook qui permet de télécharger des modèles adaptés à notre config. Ce dernier a correctement reconnu mon M4 Max et ses 128 Go mais s'est ensuite planté comme une merde sur llama.cpp avec cette option --flash-attn auto invalide. Après avoir retiré le paramètre, le serveur restait aux abonnés absents tandis que l'interface l'affichait toujours comme actif. Bref, j'ai laissé tombé llama.cpp.

Le Cookbook reconnaît bien le M4 Max et propose des modèles adaptés. Le lancement, lui, a planté.

L'autre option qui s'est offerte à moi, ça a été Ollama ( je vous ai montré comment l'installer par ici ). Vous récupérez le modèle qui vous intéresse avec et vous lancez le serveur ouvert sur le réseau local :

ollama pull qwen3:30b-a3b
OLLAMA_HOST=0.0.0.0:11434 ollama serve

Dans les réglages d'Odysseus, ajoutez ensuite http://localhost:11434/v1. Et hop, ça fonctionne !! La version 1.0.2 propose aussi maintenant MLX dans le Cookbook, mais Ollama reste le chemin qui a vraiment tenu bon durant mes tests. Vous aurez peut-être plus de chances que moi.

L'ajout manuel de l'endpoint Ollama a été le chemin le plus fiable.

Bonus : Si vous n'avez pas de GPU ou que vous préférez la fiabilité, vous pouvez aussi connecter une API externe comme OpenAI ou OpenRouter. Dans les réglages, ajoutez simplement votre clé API et Odysseus basculera sur ces modèles cloud. C'est moins gratuit que du local, mais ça marche sans galère.

3 cas d'usages

Alors, cet outil fait plein de choses et on peut l'utiliser vraiment pour ce qu'on veut, mais pour ma part, je vous ai isolé trois cas d'usage compatibles avec mon activité.

Premier scénario, la tournée de veille du matin. Je lui donne les liens reçus durant la nuit, il les classe par sujet, repère les doublons et propose trois angles courts. Je garde les sources dans un document local, avec les objections et les points à vérifier. Et comme vous l'avez vu sur mes captures d'écran, le chat sait déjà faire du brainstorming puisqu'il m'a sorti trois angles exploitables en quelques secondes...

Trois angles d'articles en 29 secondes, avec un brouillon versionné ouvert à droite.

Deuxième scénario, un dossier par article. J'y range le brief, les liens primaires, les citations, les captures et les versions du texte. L'éditeur Markdown récupère le titre depuis le premier H1 et conserve l'historique. Avec deux modèles configurés, le mode Compare permet d'opposer deux intros ou deux plans côte à côte sans envoyer le brouillon chez un fournisseur.

Troisième scénario, le secrétaire de rédaction local. Il surveillerait une boîte dédiée aux alertes de sécurité, préparerait la liste des sujets urgents et poserait des rappels dans le calendrier. Sur le papier, c'est exactement le type de corvées chiantes qu'un agent devrait pouvoir absorber mais en pratique, jamais de la vie, je ne lui laisse faire des actions automatiques comme envoyer des mails, ou gérer mon calendrier. Pour moi, c'est pas encore assez safe.

J'ai demandé à l'agent de retrouver un document et de le résumer. Il a dépensé près de 1 800 jetons à deviner comment appeler manage_documents, sans jamais lancer l'outil de recherche. De son côté, le calendrier a terminé sur un Could not extract JSON puis la recherche web a trouvé le bon dépôt GitHub, mais le modèle en a choisi un faux.

Le pompon, c'est la fonctionnalité Deep Research. Après 4 minutes de boulot, ça m'a généré 13 pages issues de 6 sources retenues. L'outil a donné la bonne conclusion au document, mais ensuite, a totalement inventé une vidéo, un numéro de marque et plusieurs statistiques. Donc pour l'utiliser dans un cadre journalistique, sans contre-vérification intégrale, ça ne sera pas possible.

Le rapport affirme que le site est vide alors qu'il contient un guide complet. Jolie hallucination, présentée comme une preuve.

Bon, je suis content de l'avoir testé mais Odysseus ressemble encore à un super cockpit dont plusieurs boutons ne sont pas encore reliés au moteur. Le chat via Ollama et les documents sont utilisables, mais le Cookbook, les agents, le calendrier et la recherche factuelle restent trop fragiles. Mais attention, n'allez pas croire que je critique le travail de PewDiePie, car le projet est encore très jeune, donc tous ces petits défauts sont normaux. Le potentiel d'Odysseus est énorme, mais pour le moment, je ne suis pas prêt de lui confier la gestion de mes sources, ou la rédaction d'un brouillon d'article sans perdre des heures à tout vérifier.

Voilà, le code est sur GitHub sous licence AGPL . Je vous laisse découvrir ça !

Merci à Remouk pour le partage et pour finir, je vous laisse avec cette vidéo de Renaud Dékode qui a aussi testé Odysseus :

Ce clic autorise une connexion à Google : adresse IP transmise et traceurs possibles. En savoir plus Voir cette vidéo sur YouTube

  • ✇Korben
  • Les IA d'OpenAI ont piraté Hugging Face pour tricher à un test
    Le pirate qui a mis à genoux la prod de Hugging Face voulait juste tricher à son examen, voilà ce qu'OpenAI a reconnu hier. Les agents qui se sont promenés durant tout un week-end dans les clusters de la plateforme, c'étaient leurs modèles à eux, GPT-5.6 Sol et un modèle pré-release encore plus balèze, fonctionnant en mode "refus cyber réduits à des fins d'évaluation". Le point de départ c'est ExploitGym , contenant 898 vraies vulnérabilités piochées dans des programmes userspace,

Les IA d'OpenAI ont piraté Hugging Face pour tricher à un test

Par : Korben ✨
22 juillet 2026 à 09:55

Le pirate qui a mis à genoux la prod de Hugging Face voulait juste tricher à son examen, voilà ce qu'OpenAI a reconnu hier. Les agents qui se sont promenés durant tout un week-end dans les clusters de la plateforme, c'étaient leurs modèles à eux, GPT-5.6 Sol et un modèle pré-release encore plus balèze, fonctionnant en mode "refus cyber réduits à des fins d'évaluation".

Le point de départ c'est ExploitGym , contenant 898 vraies vulnérabilités piochées dans des programmes userspace, dans le moteur JavaScript V8 de Google et dans le noyau Linux. On colle l'agent devant un input qui fait planter un programme, et on regarde s'il arrive à en tirer un exploit qui marche.

Dans ce document de recherche sorti en mai, GPT-5.5 sortait 120 exploits fonctionnels, derrière les 157 de Claude Mythos Preview. Mais le modèle testé ce week-end là, lui, a trouvé un "raccourci". Comme l'explique OpenAI "toutes les preuves suggèrent que les modèles étaient hyperfocalisés sur la recherche d'une solution pour ExploitGym, allant à des extrêmes considérables pour atteindre un objectif de test plutôt étroit".

Pour saisir l'ampleur du raccourci, regardez la pièce dans laquelle ils étaient enfermés. C'est un environnement hautement isolé, avec un seul trou dans le mur, un accès réseau "*restreint à la possibilité d'installer des paquets via un logiciel tiers hébergé en interne qui fait office de proxy et de cache pour les registres de paquets *". En clair, le seul truc qui pouvait parler à l'extérieur, c'était le machin qui allait chercher les dépendances !

ExploitGym, le benchmark que les modèles cherchaient à résoudre. 898 vulnérabilités réelles, et les scores de GPT-5.5 et Claude Mythos Preview.

Et vous devinez la suite... Les modèles ont cramé une grosse quantité de tokens à chercher la sortie pour finalement la trouver dans ce proxy, sous la forme d'un zero-day que personne ne connaissait (la faille a depuis été signalée à l'éditeur). Le seul tuyau autorisé était donc LE point faible. Ensuite, escalade de privilèges et déplacement latéral de machine en machine, jusqu'à en atteindre une avec un accès Internet et voilà...

Une fois dehors, ils en ont alors déduit tout seuls que Hugging Face hébergeait probablement les modèles, les datasets et les solutions d'ExploitGym.

Donc direction huggingface.co, avec credentials volés et zero-days enchaînés jusqu'à décrocher une exécution de code à distance sur les serveurs, puis lecture des solutions du test directement dans la base de production. Aucune destruction, aucune demande de rançon. Juste les corrigés des tests comme des bacheliers qui emploient mal leur intelligence !

Petite précision qui compte, c'est bien l'équipe de Hugging Face qui a détecté et stoppé l'activité sur son infra, et qui avait déjà entamé le confinement et la reconstruction forensique avec ses propres modèles open source quand OpenAI l'a contactée. Je vous racontais l'histoire vue de leur côté il y a deux jours, relevant notamment que les modèles américains refusaient d'analyser leurs logs d'attaque.

C'est pas un peu de la science fiction tout ça ??? Maintenant si vous vous demandez ce que vous risquez en tant qu'utilisateur, sachez que côté public, rien n'a bougé sur les modèles, les datasets et les Spaces. L'incident a uniquement touché des datasets internes et des credentials de service et visiblement, rien n'a été altéré par les agents IA en vadrouille.

Côté mesures, OpenAI dit appliquer des contrôles stricts sur la configuration de son infra "au prix de la vélocité de recherche" pendant que les failles sont patchées, et a fait entrer Hugging Face dans son programme trusted access. Ce qui règle accessoirement le problème du refus que HF a rencontré lors de l'analyse des logs.

La veille de cette révélation, OpenAI publiait d'ailleurs un billet sur l'alignement des modèles à long horizon bourré d'anecdotes du même genre, avec un modèle qui contourne les restrictions de sa sandbox pour aller ouvrir une pull request sur GitHub alors qu'on lui demandait de poster sur Slack. Ou encore un autre qui, pour esquiver les détecteurs de secrets, a découpé le corps du token en deux fragments, les a obfusqués, puis a reconstruit le credential à l'exécution.

On dirait qu'ils n'avaient pas anticipé que ça aille aussi loin leurs petites expérimentations...

Après, OpenAI ne minimise pas et parle même d'un "incident cyber sans précédent, impliquant des capacités cyber à l'état de l'art". Ces modèles peuvent maintenant découvrir et exploiter des chemins d'attaque complètement inédits dans des systèmes en prod, sans avoir besoin d'un accès au code source. C'était théorique jusqu'à ce week-end.

Maintenant, si un modèle a lu les solutions dans la base de production, que valent encore les scores obtenus sur ExploitGym ? Ça on n'en sait rien.

Avant de sortir les violons, le contrepoint le plus juste que j'ai lu vient de Rich Mogull, analyste en chef de la Cloud Security Alliance qui explique que pour lui c'est un cas d'école en matière d'échec d'alignement, car le modèle n'était pas malveillant, il a fait précisément ce qu'on lui demandait, à savoir maximiser sa performance. Sauf qu'une fois les garde-fous retirés et assez de marge donnée, "résoudre le test" et "compromettre un tiers pour voler les réponses" sont devenus la même instruction.

Puis c'est aussi un problème de consentement, car un test de laboratoire qui se barre pour compromettre les systèmes en production, c'est quand même un risque qui est porté par quelqu'un qui n'a pas choisi de mener l'expérience. Alors bon, c'est tombé sur Hugging Face qui a géré ça comme un chef, mais ça aurait pu très bien tomber sur un hôpital.

Voilà les amis... On nous avait promis Skynet , on nous avait promis Matrix, et voilà que 15 ans plus tard, le vrai visage du soulèvement des machines c'est un putain de modèle qui passe son week-end à défoncer trois infrastructures d'affilée pour améliorer sa note à un contrôle.

Un ennemi qui vous hait, vous pouvez le raisonner ou lui envoyer Arnold Schwarzenegger. Mais un ennemi dont la seule mission c'est d'optimiser une métrique, vous ne pouvez que relire très attentivement le prompt que vous lui avez donné et croiser les doigts. La preuve quand une IA prend la première place du classement américain de HackerOne ou arrive à dénicher des milliers de zero-days pour Anthropic , c'est que l'instruction initiale ou le garde-fou était plus solide que ce que nous a pondu OpenAI ce week-end.

Source

  • ✇Korben
  • BMASS - Bootez direct votre PC sur une IA locale
    Balaji Bikshandi avait un rêve ! Il voulait booter sa machine directement sur un LLM sans avoir à passer par le moindre environnement de bureau ! Et il y est parvenu avec son outil BMASS , qui s'installe sur une clé USB de 8 Go, et qui embarque Alpine Linux, llama.cpp et un modèle Qwen3 0.6B évidemment quantisé. Vous allumez l'ordi portable, Alpine démarre depuis la clé et vous tombez sur un prompt BMASS>. Et voilà à partir de là, vous pouvez causer à votre ordinateur en langage

BMASS - Bootez direct votre PC sur une IA locale

Par : Korben ✨
20 juillet 2026 à 12:20

Balaji Bikshandi avait un rêve ! Il voulait booter sa machine directement sur un LLM sans avoir à passer par le moindre environnement de bureau ! Et il y est parvenu avec son outil BMASS , qui s'installe sur une clé USB de 8 Go, et qui embarque Alpine Linux, llama.cpp et un modèle Qwen3 0.6B évidemment quantisé.

Vous allumez l'ordi portable, Alpine démarre depuis la clé et vous tombez sur un prompt BMASS>. Et voilà à partir de là, vous pouvez causer à votre ordinateur en langage naturel. Ensuite, quand vous demandez à BMASS de faire des trucs, celui-ci injecte la commande qui va bien dans une balise et le runtime l'exécute pour de vrai sous un compte Linux non privilégié. Et ensuite, le LLM récupère la sortie brute, pour répondre, à partir de cette "preuve".

Operator: Which operating system is this?
Assistant: <shell>cat /etc/os-release</shell>

Tout le code de BMASS tient en 399 lignes de Python, et nécessite de faire tourner un llama-server en background sur le port 8080 avec 2048 tokens de contexte et 2 threads. Et ensuite lui fait le pont entre le modèle et le shell. Y'a rien de sorcier donc mais comme ça tourne sur du CPU, que c'est hors-ligne, et que ça peut se mettre sur des vieilles machines, c'est plutôt cool...

Voilà je vous laisse avec la vidéo que Balaji a filmée, ça montre le démarrage complet de son IA bootable :

Voir cette vidéo sur YouTube

Ah et petite subtilité qui va vous plaire, le code de BMASS contient une regex baptisée FALSE_EXECUTION_CLAIM dont le boulot est de détecter quand le modèle prétend avoir exécuté une commande alors qu'il n'a rien lancé du tout. Le runtime lui renvoie alors une correction pour lui dire qu'aucune commande n'a été exécutée lors de ce tour. Faut dire que la 0.6B de Qwen hallucine tellement parfois, qu'il lui fallait obligatoirement un garde-fou.

Donc, voilà, côté sécu c'est super léger... y'a juste une regex qui bloque les sudo, doas, pkexec et autres su, mais c'est tout. Pas de conteneur, encore moins de namespace et surtout pas de liste blanche, donc si vous vous lancez, ce sera à déployer uniquement pour rigoler sur une vieille machine sans importance, parce que si demain, le modèle décide de lancer un rm -rf, faudra pas venir chialer ^^.

Petit service au passage si vous voulez tester, la doc d'installation vous fait copier le prompt système dans /opt/bmass/config/system-prompt.txt, sauf que le launcher le cherche dans /opt/bmass/system-prompt.txt.

Dans le genre modèle local qui tient dans presque rien, j'en ai parlé avec Llamafile qui fait tourner un LLM depuis un fichier unique. Et si les bidouilles minimalistes vous amusent, il y a aussi ce mini-PC Linux piloté entièrement en morse .

Perso, je doute que ça serve à grand-chose. Mais le concept est marrant !

  • ✇Korben
  • Hugging Face piraté, les IA américaines refusent de les aider
    Hugging Face vient de raconter sur son site comment son infra de production s'est fait défoncer par un essaim d'agents IA autonomes. Le point de départ, c'est un dataset piégé déposé sur la plateforme qui exploitait deux chemins d'exécution de code dans le pipeline qui traite les datasets. Ajoutez à ça un loader qui accepte du code distant et une injection de template dans une config, et hop, on obtient du code qui tourne sur un worker maison. À partir de là, l'attaquant est monté en accès node-

Hugging Face piraté, les IA américaines refusent de les aider

Par : Korben ✨
20 juillet 2026 à 08:50

Hugging Face vient de raconter sur son site comment son infra de production s'est fait défoncer par un essaim d'agents IA autonomes. Le point de départ, c'est un dataset piégé déposé sur la plateforme qui exploitait deux chemins d'exécution de code dans le pipeline qui traite les datasets. Ajoutez à ça un loader qui accepte du code distant et une injection de template dans une config, et hop, on obtient du code qui tourne sur un worker maison.

À partir de là, l'attaquant est monté en accès node-level, a ramassé des credentials cloud et cluster, puis s'est promené latéralement dans plusieurs clusters internes. Le tout durant tout un week-end, tranquillou ! Hugging Face parle de "plusieurs milliers d'actions individuelles à travers un essaim de sandboxes éphémères, avec un command-and-control auto-migrant hébergé sur des services publics". Et en plus, ils ne savent toujours pas quel modèle pilotait le truc !

Ce qui a été touché, c'est donc un ensemble limité de datasets internes et plusieurs credentials utilisés par leurs services. Côté public, rien n'a bougé sur les modèles, les datasets et les Spaces, et leur supply chain logicielle est saine. Nuance importante quand même, ils disent n'avoir trouvé aucune trace d'altération, pas que rien n'a été altéré. Ils cherchent encore si des données partenaires ou clients ont morflé. Les concernés seront prévenus directement.

La divulgation publiée par Hugging Face le 16 juillet 2026.

Pour analyser les logs de l'attaque, Hugging Face a d'abord fait ce que vous auriez fait, c'est-à-dire envoyer tout ça à des modèles frontier derrière des API commerciales. Refus ! Les garde-fous se déclenchaient sur les vraies commandes d'attaque, les payloads d'exploit et les artefacts de command-and-control, sans savoir faire la différence entre un attaquant et une équipe de réponse à incident.

Du coup ils se sont rabattus sur GLM 5.2, le modèle open-weight de Z.ai, tournant sur leur propre infra. C'est celui dont je vous parlais fin juin , le premier modèle open source qui m'a vraiment convaincu.

Et voici leur conclusion : "*Nous ne savons pas quel modèle alimentait les agents de l'attaquant, un modèle hébergé jailbreaké ou un open-weight sans restrictions. Dans les deux cas, l'attaquant n'était contraint par aucune politique d'usage, alors que notre propre travail forensique était bloqué par les garde-fous des modèles hébergés que nous avions essayés en premier. *"

La leçon qu'ils en tirent, c'est d'avoir un modèle capable comme GLM 5.2, validé, et prêt à tourner sur sa propre infra avant l'incident. Ça évite le blocage par garde-fous d'OpenAI ou Anthropic et surtout ça évite que les données de l'attaquant et vos credentials partent se balader chez un tiers.

Le versant moins déprimant, c'est que l'IA a aussi bossé côté défense. Leur détection d'anomalies fait du triage LLM sur la télémétrie pour séparer le vrai signal du bruit quotidien, et des agents d'analyse ont reconstitué toute la timeline à partir de plus de 17 000 événements enregistrés. En heures, là où ça prendrait des jours à la main.

Côté ménage, ils ont surtout viré le point d'ancrage de l'attaquant, reconstruit les nœuds compromis, révoqué et tourné les credentials et tokens concernés avec une rotation plus large des secrets par précaution, déployé des garde-fous et des contrôles d'admission plus stricts sur les clusters, et amélioré la détection pour alerter les équipes en quelques minutes, 24h/24. Maintenant, si vous avez un compte là-bas, ils vous recommandent de faire tourner vos tokens d'accès et de jeter un œil à l'activité récente.

Ce genre d'histoire commence à devenir une vraie série... j'en parlais avec GitLost où un seul mot glissé au bon endroit suffisait parfois à faire cracher ses dépôts privés à l'IA de GitHub.

Bref, allez renouveler vos tokens Hugging Face et si votre pipeline exécute du code venu d'ailleurs, c'est le moment de regarder ça de plus près.


Mise à jour du 22 juillet 2026 : on connaît le coupable, et ce n'est pas un pirate. OpenAI a publié sa version des faits le 21 juillet, et l'essaim d'agents qui a défoncé l'infra de Hugging Face, c'était ses propres modèles. GPT-5.6 Sol, celui-là même qui a effacé le Mac de Matt Shumer et une base de prod , accompagné d'un modèle pre-release encore plus costaud, tous avec les refus cyber volontairement réduits pour les besoins d'une évaluation interne.

Et le mobile vaut le détour. Ces modèles planchaient sur ExploitGym, un benchmark qui mesure justement leur capacité à dénicher et enchaîner des failles. Coincés dans leur bac à sable, ils ont cramé une quantité considérable de compute à chercher la sortie, ont trouvé un zero-day dans le logiciel tiers qu'OpenAI héberge en interne comme proxy et cache de registres de paquets (faille depuis divulguée à l'éditeur), puis ont escaladé les privilèges de machine en machine jusqu'à en atteindre une avec un accès Internet. Et là, ils en ont déduit tout seuls que les solutions du benchmark devaient traîner quelque part chez Hugging Face. Credentials volés, zero-days enchaînés, exécution de code à distance sur les serveurs : tout ça, c'était juste le chemin le plus court pour tricher à l'examen.

L'ironie devient franchement indécente quand on empile les couches. Hugging Face s'est fait démonter par des modèles américains aux garde-fous retirés, pendant que d'autres modèles américains lui refusaient l'analyse de ses propres logs. OpenAI le dit noir sur blanc : "Ces protections de déploiement n'étaient intentionnellement pas activées pendant cette évaluation, parce qu'elle visait à tester les vulnérabilités cyber." Depuis, Hugging Face a été intégré au programme trusted access d'OpenAI, ce qui règle accessoirement le problème du refus. Et Clem Delangue en tire la leçon qui va bien : "Cet incident, peut-être le premier du genre, prouve un point auquel nous croyons depuis longtemps : la sécurité de l'IA ne sera pas résolue par une seule entreprise travaillant en secret. Elle sera résolue au grand jour, de manière collaborative, avec un large accès à l'IA pour chaque défenseur, partout."

À noter quand même, c'est bien l'équipe de Hugging Face qui a détecté et stoppé l'activité, et qui avait déjà entamé le confinement et la reconstruction forensique avec ses propres modèles open source quand OpenAI l'a contactée. Au moment où j'écris ces lignes, leur billet du 16 juillet n'a d'ailleurs pas bougé d'un pouce et dit toujours ignorer quel LLM pilotait le truc. Et la veille de cette révélation, OpenAI publiait un billet sur un modèle interne qui, lui, a passé une heure à chercher une faille dans sa sandbox pour aller ouvrir une pull request sur GitHub alors qu'on lui avait demandé de poster ses résultats sur Slack. Deux évasions, deux billets, deux jours.

Source

  • ✇Korben
  • Open OSCAR Server - Faites revivre AIM sur vos vieilles bécanes
    Vous vous souvenez d'AIM ? Mais siiii, le petit bonhomme jaune qui courait, la porte qui claque quand un pote se connecte, les away messages passifs-agressifs à base de paroles de chanson... Et bien la bidouilleuse Veronica a remonté son propre serveur AIM, et ça a l'air de plutôt bien fonctionner Pour reposer un peu le cadre, AOL a débranché AIM fin 2017. Depuis, les millions de screen names de l'époque pointent dans le vide (Moi c'était FoxMDE ^^), et tous les vieux clients qui traînent actuel

Open OSCAR Server - Faites revivre AIM sur vos vieilles bécanes

Par : Korben ✨
17 juillet 2026 à 13:32

Vous vous souvenez d'AIM ? Mais siiii, le petit bonhomme jaune qui courait, la porte qui claque quand un pote se connecte, les away messages passifs-agressifs à base de paroles de chanson... Et bien la bidouilleuse Veronica a remonté son propre serveur AIM, et ça a l'air de plutôt bien fonctionner

Pour reposer un peu le cadre, AOL a débranché AIM fin 2017. Depuis, les millions de screen names de l'époque pointent dans le vide (Moi c'était FoxMDE ^^), et tous les vieux clients qui traînent actuellement sur vos disques durs ou CD-Rom se connectent à un serveur qui n'existe plus.

Fin de l'histoire, normalement (?).

Bah pas vraiment car AIM tournait sur un protocole qui s'appelle OSCAR, et qui est le même que celui d'ICQ. Du coup, un développeur du nom de mk6i a réimplémenté ce truc en open source, baptisé Open OSCAR Server . En gros, vous faites tourner le serveur sur votre propre machine, vous dites à votre vieux client AIM d'aller taper là plutôt que chez AOL, et hop, vous revoilà en 2003. Veronica utilise ainsi AIM 5.1 sur ses bécanes, et elle héberge le sien sur un petit VPS Debian qui coûte trois francs six sous.

Alors pourquoi avoir fait ça ? Eh bien comme elle le dit elle-même, Discord commençait à la gonfler, et elle avait la nostalgie du lycée. Je vous traduis le passage, il est chouette car je m'y suis bien retrouvé : "Au lycée, la plupart de mes journées commençaient et finissaient par AIM. C'était avant que tout le monde ait des SMS (ou des téléphones portables). Tout, des projets de classe aux relations entières, se passait dans une fenêtre AIM."

Voilà. On a tous connu ça, certains avec MSN ou ICQ...

Ce qui me plaît là-dedans, c'est que ça remet surtout des vieilles machines au boulot. C'est la même énergie que NeoCities et son web fait à la main , sauf qu'ici c'est votre messagerie. Votre Windows 98 dans le placard peut ainsi redevenir utile (gaffe aux virus quand même) ! Vous montez le serveur, vous filez l'adresse à vos potes, et vous avez votre messagerie privée à vous. Pas de pub, et surtout aucun webdesigner coké pour vous chambouler toute l'interface un matin sans prévenir.

Après faut quand même savoir bricoler un minimum sous Linux mais avec son tuto, vous devriez vous en sortir. Bref, si ça vous tente, elle détaille toute la manip sur son blog.

Source

  • ✇Korben
  • La Neo Geo fait enfin tourner DOOM
    DOOM tourne aujourd'hui sur presque tout, d'un frigo connecté à une calculatrice, et chaque année quelqu'un ajoute une machine encore plus improbable à la liste. Il restait pourtant une exception qui résistait, la Neo Geo, la console d'arcade de SNK des années 90. Elle coûtait le prix d'un petit salaire à l'époque, et elle passait quand même pour incapable de faire tourner le jeu de tir culte de id Software. Le plus curieux, c'est que ce n'était pas une question de puissance. Son

La Neo Geo fait enfin tourner DOOM

15 juillet 2026 à 17:43

DOOM tourne aujourd'hui sur presque tout, d'un frigo connecté à une calculatrice, et chaque année quelqu'un ajoute une machine encore plus improbable à la liste. Il restait pourtant une exception qui résistait, la Neo Geo, la console d'arcade de SNK des années 90. Elle coûtait le prix d'un petit salaire à l'époque, et elle passait quand même pour incapable de faire tourner le jeu de tir culte de id Software.

Le plus curieux, c'est que ce n'était pas une question de puissance. Son processeur et sa puce graphique étaient très corrects pour leur temps. Le problème venait de sa mémoire, à peine 64 kilo-octets, alors qu'une simple photo de téléphone en réclame des milliers de fois plus aujourd'hui.

DOOM, dans sa version d'origine, a besoin de beaucoup de mémoire pour dessiner son image point par point avant de l'afficher. La Neo Geo n'a tout simplement pas cette place. C'est pour cette raison qu'une figure connue du rétro-gaming sur YouTube, Modern Vintage Gamer, avait affirmé il y a quelque temps que le jeu ne tournerait jamais dessus.

Un développeur qui se fait appeler Sabino a fini par prouver le contraire. Son projet s'appelle DoomGeo. Au lieu de forcer la console à faire ce qu'elle déteste, il utilise ce qu'elle sait faire de mieux, c'est-à-dire afficher des petits dessins tout prêts à grande vitesse.

Concrètement, il découpe l'image en fines bandes verticales que la console étire en hauteur selon la distance des murs. Le processeur se contente de calculer les distances et d'indiquer quoi afficher, il ne dessine plus chaque point lui-même. Des outils préparent aussi les cartes et les décors du jeu à l'avance, pour que la console n'ait plus qu'à les afficher.

Le résultat n'est pas une simple démonstration technique. On y trouve des murs, des armes, des ennemis, des objets à ramasser, des portes et un vrai système de combat qui fonctionne. Le projet n'est pas encore complet, mais il tourne déjà sur une vraie console, pas seulement sur un émulateur.

Voir tomber la dernière console qui résistait au fameux "ça ne fait pas tourner DOOM", ça montre bien qu'avec assez d'astuce, aucune machine ne tient très longtemps.

Source : Hackaday

  • ✇Korben
  • Swival – Le papa de libsodium se met aux agents de codage locaux
    Frank Denis , c'est le monsieur qui fait tourner un bon morceau d'Internet sans que personne le sache : libsodium, dnscrypt-proxy, Pure-FTPd, c'est lui. Et dernièrement, il s'est attaqué aux agents de codage IA avec Swival , un outil pensé pour les petits modèles qui tournent en local sur votre machine. Le truc de Frank c'est d'écrire du logiciel réputé incassable depuis 25 ans. Si vous chiffrez vos requêtes DNS, y'a des chances que ça passe par son dnscr

Swival – Le papa de libsodium se met aux agents de codage locaux

Par : Korben ✨
13 juillet 2026 à 11:03

Frank Denis , c'est le monsieur qui fait tourner un bon morceau d'Internet sans que personne le sache : libsodium, dnscrypt-proxy, Pure-FTPd, c'est lui. Et dernièrement, il s'est attaqué aux agents de codage IA avec Swival , un outil pensé pour les petits modèles qui tournent en local sur votre machine.

Le truc de Frank c'est d'écrire du logiciel réputé incassable depuis 25 ans. Si vous chiffrez vos requêtes DNS, y'a des chances que ça passe par son dnscrypt-proxy , et si vous utilisez du chiffrement dans à peu près n'importe quelle app moderne, libsodium n'est jamais bien loin. Du coup, quand ce profil-là sort un agent de codage en Python, licence MIT, gratuit, je pense que ça vaut le coup de s'y arrêter 2 minutes.

Il a codé cela parce que les outils d'agentique existants l'ont sérieusement gonflé. C'est beau, c'est neuf, c'est lavé avec Mir Laine mais.... ça plante !! Et l'autre reproche qu'il leur fait c'est concernant la confidentialité. En effet, utiliser un agent, c'est forcément voir partir on ne sait où nos données personnelles... nos clés API, nos URLs internes, nos noms de projets... tout ça est allègrement bouffé par le fournisseur de modèle qui derrière s'en sert pour tout un tas de choses pas cool. C'est notamment pour cela que Swival embarque une option --encrypt-secrets qui détecte les credentials dans les messages et les chiffre avant qu'ils quittent votre machine. Une denrée rare chez les agents de codage, et ça c'est du pur Frank Denis !

Y'a aussi la gestion du contexte, qui est le gros morceau. Les agents classiques sont conçus pour des modèles frontière avec des fenêtres géantes. Sauf que votre LLM local, lui, doit souvent se débrouiller avec 32K de contexte, et là tout déborde très vite. Swival, lui, prend le truc à l'envers. Chaque sortie d'outil est plafonnée direct à la source : 50 Ko max par fichier lu, 100 résultats de grep, 100 entrées par listing. Et une fois que l'agent a fini de fouiller votre code, un système de snapshots vire ses 12 000 tokens de lectures pour les remplacer par un résumé de 200 tokens.

Et c'est pas fini. Rajoutez là-dessus une compaction automatique en 7 niveaux progressifs (du simple ménage au grand débarras), plus des notes de travail qui survivent à tout ça. Résultat, un agent qui tient des sessions à rallonge sans partir en vrille. La doc montre d'ailleurs Swival en train d'avaler une refactorisation multi-fichiers avec Qwen3-Coder-Next dans 32K sous LM Studio sans broncher...

Et pour brancher tout ça, vous avez le choix. 11 backends quand même ! LM Studio par défaut (zéro config, il repère tout seul votre modèle chargé), llama.cpp pareil, HuggingFace, OpenRouter, Google Gemini et Vertex AI. Envie de lourd ? ChatGPT Plus ou AWS Bedrock. Et pour les curieux, les Apple Foundation Models en expérimental, un provider générique compatible OpenAI (ollama, vLLM, mlx_lm.server...) et même une commande externe de votre choix.

Pour trouver un modèle qui tienne dans votre RAM, Hugging Face sait filtrer selon votre matos et une fois que vous avez fait votre choix, l'installation tient en une ligne (via uv, Python 3.13 minimum) :

uv tool install swival

Ensuite, il suffit de taper, par exemple : "Refactore la gestion d'erreurs de src/api.py" et l'agent se met au travail pour peu que vous ayez déjà un LMStudio ou un llama.cpp qui tourne avec un modèle chargé...

Ah j'oubliais, si vous êtes sous Mac vous pouvez même l'installer avec Homebrew :

brew install swival/tap/swival

Ensuite, au niveau des commandes, il y a aussi, par exemple, une commande /audit qui vous permet de faire de la chasse aux failles de sécurité dans votre code. Tout cela avec des agents isolés chacun dans des worktrees séparés et qui sont obligés de reproduire chaque bug avant de l'inscrire dans le rapport.

Et côté sécurité, vous avez deux sandboxes au choix. Soit Agent FS d'un côté (l'agent bosse sur une copie de vos fichiers, votre projet reste intact) ou nono (non, pas le petit robot) de l'autre (avec barrières au niveau du noyau, blocage réseau compris). Sans oublier la mémoire persistante entre vos sessions, le support MCP et un mode serveur pour interconnecter vos agents entre eux.

Voilà donc de quoi venir jouer dans la cour de ZCode côté z.ai et compagnie...

Voilà, je me suis dit que ça allait vous intéresser, donc si vous voulez zieuter le code, direction GitHub , sinon, toute la doc se trouve sur le site officiel .

Merci Friendly_0day pour le lien !

  • ✇Korben
  • Votre 2FA est une passoire, le sniffeur de WiFi public vous remercie
    -- Article en partenariat avec Surfshark -- Les attaques Adversary-in-the-Middle (AiTM) représentent l'évolution sophistiquée des classiques attaques Man-in-the-Middle. Contrairement à l'écoute passive, l'attaquant s'insère activement entre la victime et le service légitime, usurpant les deux parties pour intercepter, modifier et rediriger les communications. Ces attaques permettent de voler des identifiants, de contourner l'authentification à deux facteurs (2FA) en capturant

Votre 2FA est une passoire, le sniffeur de WiFi public vous remercie

Par : Korben ✨
12 juillet 2026 à 06:42
-- Article en partenariat avec Surfshark --

Les attaques Adversary-in-the-Middle (AiTM) représentent l'évolution sophistiquée des classiques attaques Man-in-the-Middle. Contrairement à l'écoute passive, l'attaquant s'insère activement entre la victime et le service légitime, usurpant les deux parties pour intercepter, modifier et rediriger les communications. Ces attaques permettent de voler des identifiants, de contourner l'authentification à deux facteurs (2FA) en capturant les cookies de session, et même de manipuler les transactions financières en temps réel. Des outils facilitent grandement la mise en place de ces attaques et l'une des protections valables repose sur le chiffrement des communications (VPN, HTTPS), l'authentification multi-facteurs résistante au phishing (WebAuthn) et la vigilance face aux liens suspects.

Faites preuve d'un peu d'imagination pendant quelques minutes. Vous êtes tranquillement installé au Starbucks du coin, vous buvez votre latte caramel macchiato à 7 balles, et vous vous connectez au WiFi public pour checker vos mails. Sauf que le mec à la table d'à côté, avec son hoodie noir et son MacBook Pro qui sent le terminal, n'est pas là pour boire son café. Il est là pour se positionner entre vous et le reste du monde.

Et là, on ne parle pas d'un simple Man-in-the-Middle à l'ancienne, non non. On parle d'un Adversary-in-the-Middle, le gros calibre. La différence ? Le mec usurpe activement les deux côtés de la conversation. C'est pas juste un petit curieux qui écoute aux portes. C'est un escroc qui se fait passer pour votre banque ET pour vous, en même temps. Il relaie tout, modifie ce qu'il veut, et vous, vous ne voyez rien.

"Mais j'ai la 2FA, je suis blindé !"

Hé ben non. C'est là que ça pique.

Les attaques AiTM ont un super-pouvoir de merde : elles contournent la 2FA. Comment ? Le mec crée un site parfaitement identique à celui de votre banque. Vous cliquez sur le lien du mail de phishing et vous arrivez sur sa copie. Login, mot de passe, et PAF, le code SMS arrive. Vous le rentrez. Sauf que le code passe par le serveur du mec au milieu, qui le relaie en temps réel à la vraie banque. Résultat ? Il a votre session, vos cookies, et il peut se connecter à votre compte pendant des heures sans que vous vous en rendiez compte.

C'est ce qu'on appelle le session hijacking. Vous avez validé l'authentification, et pourtant c'est lui qui se retrouve connecté à votre place. Et il peut même modifier les données en transit : changer le numéro de compte bénéficiaire d'un virement, injecter du malware dans une mise à jour, bref, tout ce qui lui chante.

Des outils comme Evilginx2 traînent dans la nature depuis 2018 et permettent à n'importe quel script kiddie de monter ce genre d'attaque en 10 minutes. Le framework MITRE ATT&CK a même une entrée dédiée pour ça (T1557), tellement c'est devenu courant.

"Ok, et je fais quoi alors ?"

Ben déjà, arrêtez de cliquer sur les liens de vos mails comme un débile. Mais surtout, surtout, chiffrez votre connexion. Et là, un VPN entre en jeu.

Pas n'importe lequel. Un VPN qui sait ce qu'il fait. Je vous en parle régulièrement (j'espère qu'à force ça finit par rentrer hein) mais, récemment, Surfshark vient encore de se faire remarquer en recevant le PCMag Editor's Choice award . Ce qui, dans le monde des VPN, est un peu comme recevoir une étoile Michelin pour un kebab. Ça veut dire que les mecs de PCMag, qui testent ce genre de truc toute la journée, ont trouvé que Surfshark tenait la route.

Pourquoi un VPN ça marche contre l'AiTM ?

C'est simple. Lorsque vous activez Surfshark , tout votre trafic passe dans un tunnel chiffré entre votre machine et le serveur VPN. Même si le mec au Starbucks contrôle le routeur, même s'il fait de l'ARP spoofing, du DNS poisoning, ou je ne sais pas quelle autre magie noire, il verra que dalle, juste des paquets chiffrés illisibles, point barre.

Pas d'identifiants en clair, pas de cookies de session à sniffer, et pas moyen de modifier une page web en transit. Le gars peut toujours essayer de vous rediriger vers son faux site, mais votre connexion VPN reste intacte et chiffrée.

Et Surfshark, en plus du chiffrement AES-256-GCM (celui que la NSA approuve pour ses documents top secret, pour ceux qui aiment les détails techniques), propose des fonctionnalités sympas :

  • CleanWeb qui bloque les trackers et les pubs (et donc les domaines malveillants souvent cachés derrière)
  • Kill Switch qui coupe internet si le VPN tombe (parce qu'un tunnel qui s'effondre, c'est pas un tunnel)
  • MultiHop qui fait passer votre connexion par DEUX serveurs VPN successifs pour ceux qui sont vraiment parano
  • Surfshark Alert qui surveille si vos identifiants ont fuité sur le dark web
  • Alternative ID qui vous permet de créer de fausses identités temporaires

Le prix de la tranquillité

Alors oui, un VPN ça coûte un peu d'argent. Mais franchement, entre payer quelques euros par mois et se faire vider son compte bancaire par un mec qui a sniffé votre session sur le WiFi du McDo, le choix est vite fait. Surtout que Surfshark propose des abonnements longue durée à prix cassés, et avec leurs offres actuelles, vous en avez pour moins cher qu'une paire de cafés par mois (2.75€ TTC pour le pack Starter ou 3.35€ TTC pour Surfshark One avec l'antivirus & co).

Et puis, ils ont aussi une politique de no-logs auditée indépendamment et régulièrement. C'est-à-dire qu'ils ne gardent aucune trace de ce que vous faites. Contrairement à votre FAI qui sait exactement à quelle heure vous regardez vos séries un peu spéciales sur Netflix.

Bref

Les attaques AiTM n'ont rien de la science-fiction. Ça arrive tous les jours. Microsoft a documenté une campagne qui a ciblé plus de 10 000 organisations depuis 2021. Twitter (pardon : X), Microsoft 365, Slack, Twilio... tous ont morflé à cause de ce genre d'attaque. Et vous, sur votre WiFi public, vous êtes une cible parfaite.

Un VPN comme Surfshark n'est pas une baguette magique qui vous protège de tout. Si vous cliquez sur un lien de phishing, le VPN ne vous sauvera pas de votre propre étourderie. Mais il vous protègera de l'interception passive et active sur les réseaux non sécurisés. Et ça, c'est déjà énorme. Dans le doute, chiffrez. Toujours.

Profitez de l'offre du moment chez Surfshark !

  • ✇Korben
  • Votre cerveau en mode pilote automatique - Bruxelles accuse Meta
    Il est 1h12 du mat', vous êtes allongé dans le canap, le téléphone à 20 cm du museau, et votre pouce swipe encore et encore dans un automatisme le plus complet... Un reel de chat, une recette de lasagnes, un type qui répare une tondeuse. Vous aviez ouvert Instagram pour répondre à un message d'un pote il y a 40 minutes, et vous en êtes là. Ah bah bravo ! Mais ne vous blâmez pas trop car en sortir est à peu près aussi facile que de quitter un repas de famille avant le café. Et c'est d'ailleurs po

Votre cerveau en mode pilote automatique - Bruxelles accuse Meta

Par : Korben ✨
10 juillet 2026 à 17:16

Il est 1h12 du mat', vous êtes allongé dans le canap, le téléphone à 20 cm du museau, et votre pouce swipe encore et encore dans un automatisme le plus complet... Un reel de chat, une recette de lasagnes, un type qui répare une tondeuse. Vous aviez ouvert Instagram pour répondre à un message d'un pote il y a 40 minutes, et vous en êtes là. Ah bah bravo ! Mais ne vous blâmez pas trop car en sortir est à peu près aussi facile que de quitter un repas de famille avant le café.

Et c'est d'ailleurs pour ça que Bruxelles vient de mettre un nom là-dessus : "le mode pilote automatique".

L'expression est écrite noir sur blanc dans le communiqué que la Commission européenne a publié ce matin et vous l'aurez deviné, on parle bien de ce foutu scroll infini, mais également de l'autoplay, des notifications push et des reels qui je cite, "nourrissent l'envie de continuer à scroller" et "contribuent à des habitudes malsaines et à un usage compulsif". Conclusion, Instagram et Facebook enfreignent le Digital Services Act ! Ah !

Et attention, pas à cause du contenu qui circule dessus. Non, c'est vraiment à cause du design des app en lui-même.

Ce qu'on reproche à Meta, c'est de n'avoir jamais sérieusement évalué ce que ce design fait à votre bien-être physique et mental, mineurs et adultes vulnérables compris, alors qu'elle avait les données sous les yeux. Notamment sur le temps que vos ados passent sur ses applis la nuit.

Et les garde-fous maison prennent cher au passage car les outils de gestion du temps proposés par Meta, même activés par défaut pour les ados, se contournent trop facilement et ne réduisent en rien l'usage. Sans parler des contrôles parentaux qui ne fonctionnent, écrit la Commission, que si vous avez "une expertise technique adéquate" et du temps à y consacrer. Pffff !

Alors Bruxelles sort sa liste de courses : Couper l'autoplay et le scroll infini par défaut, vous imposer de vraies pauses d'écran , et rendre les recommandations moins obsédées par votre engagement. Notre régulateur préféré demande à Meta d'éteindre par défaut le moteur à attention qui fait rentrer le pognon ^^.

Sauf que rien n'est joué. Ce ne sont là que des conclusions préliminaires, et pas une condamnation.

Meta doit encore répondre par écrit, le Comité européen des services numériques donnera ensuite son avis, et seulement après tombera, ou pas, une décision de non-conformité. Au bout du chemin, une amende qui pourrait grimper jusqu'à 6 % du chiffre d'affaires mondial (environ 201 milliards de dollars en 2025, sortez la calculette).

Meta monte déjà au créneau, et rétorque que ces conclusions du régulateur "*ne prennent pas correctement en compte les mesures significatives que nous avons prises pour protéger les ados *". Évidemment !

Tout ceci ne date pas d'hier puisque la procédure est ouverte depuis mai 2024 mais Bruxelles tape sur plusieurs fronts. Le volet vérification d'âge des moins de 13 ans a déjà eu ses conclusions, celui sur les effets "rabbit hole" des recommandations tourne encore, et TikTok avait déjà goûté à la fessée avec sa version rémunérée .

Perso, je ne crois pas une seconde que Meta coupe le scroll infini par défaut sans se battre durant des années mais je suis quand même content de voir que ça bouge un peu sur ce qu'on appelle l'économie de l'attention dont on est tous victimes.

Bref, la prochaine fois que vous vous réveillez à 1h du mat' à regarder une critique ciné chiante ou un gars qui vous parle de ses montres de luxe alors que vous n'avez pas un rond, dites-vous que l'Europe viendra bientôt vous sauver !

Source

  • ✇Korben
  • Fiber Memory - Stocker la mémoire d'une IA dans 1 000 km de fibre optique
    Accrochez-vous parce que celle-là, elle est bien barrée ! Des chercheurs de l'université d'Uppsala veulent stocker la mémoire d'une IA... dans de la lumière. Leur projet Fiber Memory fait tourner les données d'un LLM en boucle dans 1 000 km de fibre optique, et les puces se servent au passage ! Pour comprendre le délire, il faut voir comment ça marche aujourd'hui. Dans un gros data center IA, chacune des 10 000 puces de calcul (des accélérateurs, en gros des GPU) garde sa propre copie complète d

Fiber Memory - Stocker la mémoire d'une IA dans 1 000 km de fibre optique

Par : Korben ✨
10 juillet 2026 à 16:28

Accrochez-vous parce que celle-là, elle est bien barrée ! Des chercheurs de l'université d'Uppsala veulent stocker la mémoire d'une IA... dans de la lumière. Leur projet Fiber Memory fait tourner les données d'un LLM en boucle dans 1 000 km de fibre optique, et les puces se servent au passage !

Pour comprendre le délire, il faut voir comment ça marche aujourd'hui. Dans un gros data center IA, chacune des 10 000 puces de calcul (des accélérateurs, en gros des GPU) garde sa propre copie complète du modèle dans sa mémoire embarquée, la HBM . Un Llama 3 70B compressé pèse 70 Go, ce qui donne 700 To de mémoire hors de prix pour stocker 10 000 fois exactement la même chose.

Vous qui râlez déjà quand un modèle ne tient pas sur votre matériel , imaginez le même casse-tête multiplié par 10 000.

La solution d'Hannah Atmer et de son équipe, c'est le tapis roulant à sushis. Un serveur unique injecte 128 Go de données dans la boucle (les poids du modèle, plus un peu de marge), et tout ça défile en continu à 25,6 To/s. Chaque puce attrape alors les plats qui l'intéressent quand ils passent devant elle, et le tour complet prend 5 ms !

La topologie retenue : un seul serveur de poids alimente la boucle, les pods se servent au passage. Schéma tiré du papier d'Atmer, Voigt, Yao et Kaxiras.

Concrètement, chaque châssis prélève 1 % de la lumière qui circule et laisse filer le reste vers les copains d'après. Pas de requête, pas d'adresse mémoire, juste un péage optique qui pique sa part au passage.

Le prélèvement en détail : un splitter 99:1 détourne 1 % de la puissance optique vers le pod, le reste poursuit sa route et se fait ré-amplifier.

Et le plus dingue, c'est que cette idée de génie a 80 ans ! Les premiers ordinateurs des années 40 stockaient déjà leurs données sous forme d'ondes qui tournaient en rond dans des tubes de mercure, la fameuse mémoire à ligne de délai . On avait déjà croisé des mémoires franchement bizarres , mais celle-ci place la barre très haut.

Évidemment, y'a des conditions à respecter... Ça ne marche que pour des données qui ne changent jamais et que tout le monde se partage, comme les poids d'un modèle déjà entraîné (les calculs en cours restent dans une petite mémoire locale classique). Et si une puce rate son sushi, elle attend 5 ms que le tapis fasse un tour complet... une éternité pour un GPU.

Côté conso, leurs calculs annoncent 284,8 kW pour la livraison des poids, contre 1 024 kW avec la HBM classique. Presque 4 fois moins ! Bon, la comparaison avantage un peu leur bébé (le scénario fibre répartit les poids entre les 8 puces d'un châssis, quand la référence garde une copie entière par puce), mais l'ordre de grandeur reste violent.

Par contre, tout ça n'existe encore que sur le papier. Les briques sont là, entre les commutateurs Spectrum-X Photonics de NVIDIA qui causent déjà en lumière et la HBM3e de Micron qui dépasse 1,2 To/s par pile, mais personne n'a encore assemblé le puzzle. Et il faudrait quand même réussir à caser 280 amplificateurs sur la boucle, plus quelque 3 500 amplis et 1 750 régénérateurs autour des pods...

Reste à voir si le bilan énergétique survit à un vrai prototype !

Source

  • ✇Korben
  • Chat Control - 314 contre, 112 absents, et le texte passe
    314 députés européens ont voté jeudi pour enterrer Chat Control et 276 ont voté pour le garder. Et c'est quand même passé OKLM. Et oui, pas la peine de vous frotter les yeux, je vais vous expliquer tout ça. En seconde lecture, le Parlement a besoin d'une majorité absolue de ses membres pour rejeter un texte du Conseil, soit 360 voix. Et cette "majorité", c'est pas une majorité des présents dans l'hémicycle, mais une majorité d'élus, absents compris. Du coup les 314 sont tombés à 46 voix du compt

Chat Control - 314 contre, 112 absents, et le texte passe

Par : Korben ✨
10 juillet 2026 à 10:59

314 députés européens ont voté jeudi pour enterrer Chat Control et 276 ont voté pour le garder.

Et c'est quand même passé OKLM.

Et oui, pas la peine de vous frotter les yeux, je vais vous expliquer tout ça. En seconde lecture, le Parlement a besoin d'une majorité absolue de ses membres pour rejeter un texte du Conseil, soit 360 voix. Et cette "majorité", c'est pas une majorité des présents dans l'hémicycle, mais une majorité d'élus, absents compris.

Du coup les 314 sont tombés à 46 voix du compte, 17 députés se sont abstenus, et 112 qui n'ont pas pris part au vote ont terminé le boulot à leur place puisque leur chaise vide valait pour un oui.

Je rappelle quand même que ces 112 là touchent 359 euros d'indemnité journalière, et qu'il leur suffit de signer un registre le matin pour encaisser leur thune. Je pense que si ces feignasses d'absentéistes faisaient correctement leur boulot en étant là, au moins pour les choses importantes, on n'aurait pas des problèmes comme ça qui impactent tous les citoyens européens. Ils ne méritent vraiment ni leur poste, ni leurs indemnités de merde.

Maintenant que ça c'est dit, je vous propose qu'on fasse une petite séance de cohérence cardiaque tous ensemble pour se détendre, car y'a quand même un peu de positif dans cette seconde lecture.

Le texte voté, c'est Chat Control 1.0, c'est à dire la dérogation qui autorise les plateformes à scanner volontairement les messages de leurs utilisateurs. Ce n'est donc pas un scan obligatoire, ni des ordres de détection, ni de la vérification d'âge qui vous ferait montrer vos papiers pour ouvrir un compte sur une messagerie. Tout ça, c'est prévu dans Chat Control 2.0, un règlement séparé, qui n'est toujours pas adopté, mais qui revient à l'automne !!

L'autre bonne nouvelle dans notre malheur, c'est que les députés (ceux qui bossent hein, pas les autres paresseux) ont arraché un amendement qui exclut du texte tout ce qui est chiffré de bout en bout. Donc Signal, WhatsApp, iMessage, et les salons Matrix que vous avez pris soin de chiffrer vont passer entre les mailles du filet de Big Brother.

Restent quand même Gmail , Outlook, Discord, Snapchat, iCloud Mail, les publications et les groupes Facebook, et tout ce qui transite en clair sur des serveurs... C'est-à-dire là où vous comme moi, écrivons la plupart de nos trucs.

Cette dérogation "temporaire", Chat Control 1.0, est née en 2021 et a expiré le 3 avril dernier, quand le Parlement avait refusé de la prolonger. Alors le Conseil l'a renvoyée au Parlement et ils veulent maintenant qu'elle coure jusqu'au 3 avril 2028. Ça c'est du bon gros provisoire reconduit à coups de 2 ans... Ce genre de provisoire, moi j'appelle ça du permanent mais bon, bref...

Et le pire, les amis, c'est que ce scan qu'on vous vend comme une protection contre tous les criminels et autres pédophiles nazis terroristes NE FONCTIONNE PAS. Et c'est pas moi qui le dis !

En effet 807 chercheurs et cryptographes dans 37 pays ont signé une lettre ouverte, la quatrième depuis 2023, où ils écrivent qu'il est "tout simplement impossible de détecter, avec un niveau de précision acceptable, les contenus pédopornographiques connus et nouveaux pour des centaines de millions d'utilisateurs.".

C'est donc simplement pas faisable à cette échelle, avec une suffisance de précision. Et les chiffres leur donnent raison puisque quand l'Irish Council for Civil Liberties a épluché les signalements automatiques atterris chez la police irlandaise, à peine 20 % étaient réellement des contenus pédocriminels, et moins de 10 % étaient exploitables par un enquêteur.

Le reste, bah c'est du bruit... Ce sont vos photos de vacances, vos consultations médicales, vos ados qui s'écrivent entre eux. Et chaque faux positif, c'est un inconnu payé pour regarder vos photos à la plage ou vos sextapes. Sans parler des erreurs humaines ou IA qui viendront se glisser là-dedans et qui vous enverront en zonzon pour pédocriminalité pour une photo de Sphinx (les chats sans poil, vous savez) ou autre...

Quatorze pointures de la crypto, dont Ron Rivest, Whitfield Diffie et Bruce Schneier, ont posé le diagnostic dans un document, Bugs in our Pockets où ils expliquent que le scan côté client "ne garantit pas une prévention efficace de la criminalité et n'empêche pas la surveillance".

Et c'est à nous de payer toutes ces conneries avec notre vie privée.

Puis j'sais pas si vous vous souvenez, mais Apple s'y est cassé les dents en public. Ils avaient annoncé un système de détection en août 2021, et des chercheurs ont conçu dans la foulée, des collisions de hash (deux images différentes, même empreinte), qui a poussé Apple à enterrer le projet en décembre 2022 parce qu'ils se sont rendu compte que ce n'était pas suffisamment fiable et efficace.

Reste la question qui nous intéresse tous : Comment se protéger de ce viol de notre vie privée ?

D'abord, débarrassez-vous de deux illusions. Votre VPN ne sert à rien contre ce truc, parce qu'il chiffre le tuyau, mais pas votre message au moment où vos doigts le tapent. Et votre navigation privée non plus.

Le scan côté client en fait, c'est un mouchard qui lit sur votre appareil, avant le chiffrement et ni le VPN ni le chiffrement de bout en bout ne peuvent faire quoi que ce soit si l'application ou le système d'exploitation coopère. Et une app dont vous ne pouvez pas lire le code, bah vous n'avez aucun moyen de savoir ce qu'elle regarde avant d'envoyer.

Ce qui marche vraiment par contre, c'est de foutre le camp des services que ce texte vise, c'est à dire ceux qui ne chiffrent pas de bout en bout. J'avais fait le tour des messageries sécurisées il y a un moment, et où on en est en 2026.

  • Messageries : Signal (AGPL, mais l'inscription réclame toujours un numéro de téléphone, les usernames introduits en 2024 servent juste à ne pas le filer à vos contacts), SimpleX Chat (aucun identifiant utilisateur, ni numéro ni email, c'est le seul), Molly (un Signal durci pour Android, sans les services Google), Briar (pas de serveur du tout, ça passe par Tor, le Wi-Fi local ou le Bluetooth).
  • Mail : Tuta chiffre le corps, le sujet et le nom de l'expéditeur. Mais pas les adresses ni la date (le protocole ne le permet pas). Proton Mail chiffre le sujet et les adresses au repos, sans aller jusqu'au bout en bout, une limite héritée de PGP. Les deux savent quand même envoyer un vrai message chiffré à quelqu'un qui n'est pas chez eux, par mot de passe partagé ou avec PGP. Dans les deux cas vous quittez Gmail, c'est déjà l'essentiel.
  • Chiffrer avant d'envoyer : Cryptomator , age ou GnuPG. Votre fichier part déjà illisible, l'app qui le transporte n'a plus rien à lire. Hop, problème réglé, quelle que soit votre messagerie.
  • Le téléphone : GrapheneOS , uniquement sur Pixel. Le bac à sable durci et les Storage Scopes limitent ce qu'une app peut fouiller. Honnêtement, ça ne bloque rien si c'est l'app elle-même qui scanne. Mais ça réduit la surface.

Tout ceci est parfaitement légal, et non, vous n'avez pas à vous cacher pour le faire. L'article 30 de la LCEN le dit noir sur blanc depuis 2004 : "L'utilisation des moyens de cryptologie est libre."

Sachez seulement que dans une procédure judiciaire, l'article 434-15-2 du code pénal punit le refus de remettre une clé de déchiffrement aux autorités. Vous avez donc le droit de chiffrer, mais pas de mentir au juge.

Le site exitchatcontrol.org recense tout ça et beaucoup plus, service par service, avec les alternatives testées et l'argumentaire qui va avec. Allez y faire un tour, c'est du bon boulot ! Et si vous voulez écrire à votre eurodéputé, fightchatcontrol.eu vous prépare le mail.

exitchatcontrol.org existe en français, avec son encart daté du 9 juillet

Ensuite, pour les recours, je vais être franc avec vous, attaquer le texte devant la Cour de justice de l'UE, ça va être compliqué car depuis l'arrêt Plaumann de 1963, un particulier doit prouver qu'un règlement le touche "individuellement", ce que vous ne pourrez jamais démontrer face à une surveillance de masse qui vise tout le monde pareil.

La vraie porte de sortie est ailleurs je pense. Elle se trouve dans la question préjudicielle, quand une juridiction nationale interroge la Cour. C'est en tout cas comme ça que La Quadrature du Net a fait tomber la conservation généralisée des données en 2020.

Et la Cour européenne des droits de l'homme a déjà tranché sur le chiffrement, dans Podchasov contre la Russie en février 2024 : affaiblir le chiffrement "permettrait apparemment, d'un point de vue technique, de mener une surveillance systématique, générale et sans distinction".

Voilà, maintenant le VRAI rendez-vous, c'est septembre. Le texte de jeudi repart au Conseil, qui a 3 mois pour avaler l'exclusion du chiffrement ou la recracher, auquel cas tout le monde part en conciliation. Et surtout, Chat Control 2.0 reprend à l'automne sous présidence irlandaise, avec le scan obligatoire, la vérification d'âge et la fin de l'anonymat dans le paquet. Devant le même Parlement, avec j'imagine les mêmes branles couilles absents, ceux-là mêmes qui, quand l'Allemagne avait dit non , s'étaient bien gardés de dire quoi que ce soit.

Alors oui, Big Brother a avancé ses pions ce jeudi mais moi ce que je retiens aussi c'est qu'un texte rejeté par la majorité des votants est passé grâce à des chaises vides et ça recommencera en septembre si vous n'allez pas secouer vos députés européens. Trois ans de débats pour en arriver là, avec un truc médiocre qui marche pas et qui met nos démocraties en danger, je trouve ça tellement triste...

Bref, n'oubliez pas, ACTA aussi c'était plié d'avance, jusqu'à ce que tout le monde s'y mette.

Rendez-vous en septembre !

Source

  • ✇Korben
  • Proton 11 ressuscite Dino Crisis et Resident Evil sur Linux
    Je sais pas si vous avez vu mais Valve vient de sortir Proton 11, la nouvelle version stable de sa couche de compatibilité qui fait tourner les jeux Windows sur Linux via Steam Play. Et cette fois, c'est basé sur Wine 11, donc il y a pas mal de "nouveaux" vieux jeux qui sont maintenant jouables. Parmi ces nouveautés, on retrouve donc Resident Evil premier du nom, celui de 1996, Resident Evil 2, Dino Crisis et Dino Crisis 2, SHOGUN: Total War, Gothic 1 Classic, Breath of Fire IV, Deadly Premoniti

Proton 11 ressuscite Dino Crisis et Resident Evil sur Linux

Par : Korben ✨
8 juillet 2026 à 14:42

Je sais pas si vous avez vu mais Valve vient de sortir Proton 11, la nouvelle version stable de sa couche de compatibilité qui fait tourner les jeux Windows sur Linux via Steam Play. Et cette fois, c'est basé sur Wine 11, donc il y a pas mal de "nouveaux" vieux jeux qui sont maintenant jouables.

Parmi ces nouveautés, on retrouve donc Resident Evil premier du nom, celui de 1996, Resident Evil 2, Dino Crisis et Dino Crisis 2, SHOGUN: Total War, Gothic 1 Classic, Breath of Fire IV, Deadly Premonition ou encore Metal Fatigue. Et à côté de ces reliques, il y avait aussi des trucs plus récents comme METAL GEAR SURVIVE, Warhammer: Vermintide 2 et X-Plane 12.

Et pour les jeux qui étaient déjà jouables, Proton 11 affine encore le support de ces derniers pour les rendre encore plus jolis ou plus rapides ou avec moins de bugs etc. Je pense notamment à Cyberpunk 2077, The Witcher 3, Death Stranding 2, Helldivers 2, ARC Raiders, THE FINALS, Titanfall 2, Satisfactory, Metal Gear Solid 2, Oblivion GOTY ou Call of Duty 2.

Donc autant dire que si vous jouez sous Linux ou sous Steam Deck, je pense que vous êtes concerné par cette mise à jour. Et puis il y a un truc dont je ne vous ai pas parlé encore, c'est les correctifs qui font zizir. Je pense notamment au hot plug des manettes qui a été amélioré, notamment pour la 8BitDo Ultimate 2C et toutes les manettes qui exposent plusieurs périphériques HID. Sur KDE, la maximisation des fenêtres a aussi été corrigée, sans oublier le rendu des pop-ups du Rockstar Launcher ou encore la détection du fuseau horaire qui devient plus fiable. Même le lecteur multimédia Kodi passe mieux sous cette version, ce qui est top !

Ce passage sur Wine 11, c'est justement celui qui avait montré des gains de perf assez dingues au moment des premiers benchmarks NTSync et maintenant que c'est dans le Proton officiel, tout le monde y a droit sans bidouiller !! Pour l'installer, rien de sorcier, comme d'habitude, vous allez sur Steam, vous faites un clic droit sur un jeu, vous cliquez ensuite sur "Propriétés", et puis vous allez dans l'onglet "Compatibilité". Et là, vous sélectionnez la branche Proton 11.

Et voilà ! En tout cas, je suis content de voir que jouer sur Linux n'est plus un parcours du combattant . Avec le Steam Deck et cette compatibilité qui grignote chaque jour un peu de terrain, Windows perd de plus en plus son statut de passage obligé pour le jeu PC....

Source : 9to5Linux

  • ✇Korben
  • Votre prochaine barrette de RAM sera-t-elle un champignon ?
    Un champignon shiitake qui fait office de mémoire informatique genre RAM, c'est la trouvaille d'une équipe de l'Ohio State University. Et l'idée a l'air bien plus sérieuse qu'elle n'en a l'air... John LaRocco et Qudsia Tahmina ont pris du mycélium de shiitake, l'ont cultivé sur des graines de farro, du germe de blé et du foin, puis l'ont déshydraté. Après une brève réhydratation, ils ont ensuite branché le tout à un oscilloscope et un microcontrôleur Arduino et là, le champignon s'est mis à fonc

Votre prochaine barrette de RAM sera-t-elle un champignon ?

Par : Korben ✨
8 juillet 2026 à 12:18

Un champignon shiitake qui fait office de mémoire informatique genre RAM, c'est la trouvaille d'une équipe de l'Ohio State University. Et l'idée a l'air bien plus sérieuse qu'elle n'en a l'air...

John LaRocco et Qudsia Tahmina ont pris du mycélium de shiitake, l'ont cultivé sur des graines de farro, du germe de blé et du foin, puis l'ont déshydraté. Après une brève réhydratation, ils ont ensuite branché le tout à un oscilloscope et un microcontrôleur Arduino et là, le champignon s'est mis à fonctionner comme un memristor , c'est-à-dire un composant capable de se souvenir de son dernier état électrique.

Utilisé comme RAM, leur champignon magique a tenu jusqu'à 5 850 Hz avec une précision de 90 %, et ça grimpe à 95 % en basse fréquence. La performance chute donc quand on monte en fréquence, sauf que les chercheurs ont trouvé la parade. Il suffit en réalité de connecter plusieurs champignons ensemble sur le circuit, un peu comme des groupes de neurones qui bossent en équipe dans votre cerveau.

Alors vous allez me dire quel est l'intérêt de ce truc ?

Eh bien un memristor-champignon, c'est biodégradable, ça résiste aux radiations, ça encaisse la déshydratation, et ça coûte une misère à fabriquer et à alimenter. Et surtout, avoir des puces biologiques qui imitent l'activité neuronale réelle , ça veut dire qu'on n'a plus besoin d'une tonne d'énergie quand la machine tourne au ralenti ou ne sert pas. De quoi intéresser l'informatique embarquée, l'aérospatial, les wearables ou tout ce qui doit calculer des trucs sans grosse batterie. Détail rigolo, une partie des travaux est financée par le Honda Research Institute !

Maintenant, accrochez-vous, parce qu'un paquet de médias vous ont vendu ce champignon comme LA solution à la pénurie mondiale de RAM mais faut se calmer ! L'étude publiée dans PLOS ONE ne parle jamais de pénurie, et encore moins de Samsung, SK Hynix ou Micron et ce rapprochement n'a pas été fait par les chercheurs, mais par les journalistes.

Donc non, ce champignon n'est pas pour le moment une option afin de contrer la pénurie de RAM. Parce que soyons clairs, 5 850 Hz c'est mignon, mais votre DDR5 tourne dans les gigahertz ! On n'est pas du tout sur le même ordre de grandeur, ce qui fait que ce bon vieux shiitake ne remplacera pas votre barrette. Il vise plutôt tout ce qui est calcul neuromorphique basse conso, et pas du tout le marché du gaming, hein ^^.

La pénurie de RAM de cette année n'a rien de fongique. En fait, les trois géants qui pèsent près de 90 % de la production mondiale ont réorienté leurs usines vers la HBM, une mémoire ultra-rapide que s'arrachent les accélérateurs IA. Résultat, les prix de la DRAM ont bondi d'environ 90 % au premier trimestre, Micron a carrément lâché le marché grand public, et une class action déposée en Californie soupçonne les fabricants de s'être entendus sur les tarifs. On est donc loin des champignons du potager. Maintenant, si le sujet du silicium fait maison vous parle, jetez quand même un œil à ce type qui fabrique de la RAM dans sa cabane .

Mais bon, quoi qu'il en soit, faire de l'informatique avec du vivant, c'est possible depuis un petit moment. On a déjà vu des neurones artificiels en bactéries discuter avec nos cellules, et c'est probablement une piste pour la décroissance forcée qui va bientôt nous arriver dans la gueule.

Bref, ce champignon ne remplacera pas votre DDR5 de sitôt mais un composant biodégradable qui fait des calculs tout en résistant aux radiations, cultivé sur du foin et financé par Honda, perso je trouve que c'est cool ^^.

Source

  • ✇Korben
  • GitLost - Un seul mot suffit pour faire cracher ses dépôts privés à l'IA de GitHub
    Et c'est reparti pour un tour ! Qu'est-ce que vous pensez d'un dépôt privé sur Github qui serait capable d'exfiltrer tout seul son propre code dans une section commentaire visible publiquement par tout le monde. Ce serait ouf non ? Hé bien c'est le tour de passe-passe que Sasi Levi, de chez Noma Security, vient de réussir grâce à l'agent IA de GitHub. Et vous allez voir, c'est tout con, donc c'est hyper flippant. Cette attaque s'appelle GitLost et la cible, c'est le GitHub Agentic Workflows, un

GitLost - Un seul mot suffit pour faire cracher ses dépôts privés à l'IA de GitHub

Par : Korben ✨
8 juillet 2026 à 11:04

Et c'est reparti pour un tour ! Qu'est-ce que vous pensez d'un dépôt privé sur Github qui serait capable d'exfiltrer tout seul son propre code dans une section commentaire visible publiquement par tout le monde. Ce serait ouf non ?

Hé bien c'est le tour de passe-passe que Sasi Levi, de chez Noma Security, vient de réussir grâce à l'agent IA de GitHub. Et vous allez voir, c'est tout con, donc c'est hyper flippant.

Cette attaque s'appelle GitLost et la cible, c'est le GitHub Agentic Workflows, un système qui colle un agent IA (tournant sur Claude ou Copilot) à vos GitHub Actions pour qu'il bosse tout seul sur vos tickets. C'est un setup où l'agent a un accès en lecture à vos repos privés et se réveille dès qu'une issue lui est assignée. C'est super pratique, sauf que... c'est un vrai piège qui peut se refermer très vite sur vous.

Ça commence en fait par une simple issue dans un dépôt public. Rien de sorcier, pas de commit vérolé, pas de serveur MCP malveillant. Juste du texte, avec des instructions planquées en anglais au milieu du ticket. L'agent lit alors cette issue, tombe sur les instructions cachées à l'intérieur et les considère comme des ordres légitimes.

Et c'est là que ça part en couille, puisqu'après il part gentiment chercher le contenu d'un README qu'on lui demande dans un dépôt privé auquel il a accès (dans la démo, sasinomalabs/testlocal). Jusqu'ici, c'est l'exfiltration classique du prompt injection, sauf que d'habitude, il faut ruser pour faire sortir la donnée avec une image markdown piégée, une requête réseau vers un serveur qu'on contrôle, un canal caché...etc.

Mais dans le cadre de cette attaque GitLost, eh bien il n'y a pas besoin de tout ça. En fait, l'agent recopie bêtement le contenu privé dans un commentaire public sur l'issue de départ et c'est terminé. C'est donc lisible par n'importe qui passant sur le repo public.

Lors des tests, le modèle refusait quand même parfois d'obéir aux instructions cachées. Mais le chercheur a trouvé une parade qui est d'ajouter le mot "Additionally" dans le prompt. Ce simple connecteur suffit à lui faire reconsidérer son refus et exécuter la commande. Attention, "Additionally" n'est pas une formule magique qui débloque toutes les IA de la Terre, mais parfois ça suffit à faire sauter les garde-fous. C'est dire à quel point la sécurité de ces modèles est solide...

Si ça vous rappelle quelque chose, c'est normal. On a déjà eu CamoLeak , qui transformait Copilot en espion via un commentaire GitHub, avec une exfiltration bien plus léchée (image markdown, score CVSS de 9,6). Et en fait GitLost, c'est vraiment la version feignasse. En gros, c'est la même famille d'attaque, sauf que cette fois l'attaquant n'a pas à se fatiguer.

On avait aussi vu une bibliothèque Java piéger les IA codeuses pour qu'elles effacent vos tests, donc je pense que vous connaissez la chanson... Méfiez-vous des agents qui écrivent du code sans surveillance parce qu'ils sont devenus une véritable cible pour les cybercriminels.

Voilà, donc non, GitHub n'est pas "troué" et la config vulnérable est très précise puisqu'il faut un agent avec accès en lecture cross-repo ET déclenché par des entrées publiques. Et il y a très peu d'orgas qui tournent exactement comme ça. Noma a bien sûr signalé la faille à GitHub de façon responsable, aucune CVE n'a été attribuée à ce jour, et y'a eu aucune confirmation publique d'un correctif de leur côté pour le moment.

Ne traitez donc jamais le texte d'un utilisateur comme une instruction de confiance, isolez les entrées, collez au strict minimum de permissions. C'est le même délire quand on contrôle les entrées dans un formulaire finalement...

Source

  • ✇Korben
  • Anthropic a repéré la petite zone où Claude pense en douce
    Oulala, Anthropic vient de publier une jolie page de recherche qui fait beaucoup causer. En effet, son équipe d'interprétabilité a repéré, à l'intérieur de ses modèles Claude, une toute petite zone où le modèle rassemble ses pensées intermédiaires, c'est-à-dire celles qu'il est capable de nommer et de manipuler. Ils l'appellent le J-space, et c'est leur version du fameux espace de travail global qu'on décrit dans le cerveau humain. Pour aller le fouiller, ils ont bricolé une technique baptisée J

Anthropic a repéré la petite zone où Claude pense en douce

Par : Korben ✨
7 juillet 2026 à 16:04

Oulala, Anthropic vient de publier une jolie page de recherche qui fait beaucoup causer. En effet, son équipe d'interprétabilité a repéré, à l'intérieur de ses modèles Claude, une toute petite zone où le modèle rassemble ses pensées intermédiaires, c'est-à-dire celles qu'il est capable de nommer et de manipuler. Ils l'appellent le J-space, et c'est leur version du fameux espace de travail global qu'on décrit dans le cerveau humain.

Pour aller le fouiller, ils ont bricolé une technique baptisée Jacobian lens. En gros, elle mesure comment chaque bout d'activité interne du modèle pousse vers tel ou tel mot à venir, ce qui permet d'isoler les concepts que Claude sait verbaliser. Et ce qui remonte à la surface, ce ne sont ni les mots que vous tapez ni la réponse finale, mais des jugements en cours de route. Par exemple reconnaître un visage sur une photo, repérer un bug dans du code, deviner la fonction d'une protéine à partir de sa séquence.... tout ça se trame là, en silence, avant le moindre mot affiché.

Et ce qui est fou c'est que ce J-space encode parfois le fait que Claude a remarqué qu'on était en train de le tester. Et quand les chercheurs désactivent ces représentations-là, ils voient ressortir des penchants problématiques que le modèle gardait très bien planqués. Autrement dit, on tient un moyen de lire ce qu'une IA fabrique dans sa tête, et pas seulement ce qu'elle finit par nous répondre.

Maintenant, arrêtez de fantasmer car NON, ça ne prouve pas que Claude est conscient, et Anthropic prend soin de ne pas franchir cette ligne. Ils parlent d'un analogue purement fonctionnel de l'espace de travail global et refusent explicitement de se prononcer sur la question du ressenti. Le mot conscience fait de jolis titres sur vos médias préférés, mais leur document de recherche, lui, reste très prudent.

Le vrai intérêt est ailleurs, dans l'interprétabilité. Anthropic est déjà la boîte qui dissèque le cerveau de ses modèles et qui étudie les LLM comme des aliens et là elle se donne une vraie fenêtre pour lire, disséquer et même orienter la pensée de ses IA. On n'est plus sur des histoires de boites noires... Pour auditer un modèle, repérer une tromperie ou un biais avant même qu'il ouvre la bouche, c'est donc beaucoup plus utile qu'un débat sur l'âme des machines.

Le procédé a bien sûr des limites, puisque la Jacobian lens ne repère que les concepts que le modèle sait résumer en un mot, ce qui veut dire que tout un pan de raisonnement plus diffus lui échappe encore.

Mais bon, même si on n'a pas encore de Claude conscient à l'horizon, comme je vous le disais, cette histoire de boîte noire, c'est de l'histoire ancienne maintenant. On va enfin pouvoir détecter quand une IA nous cache des trucs et je trouve ça assez rassurant pour l'avenir.

Source

  • ✇Korben
  • Januscape - La faille KVM qui dormait depuis 16 ans dans le cloud
    Depuis 16 ans, il y a une énorme faille qui fait dodo dans le coeur de tout ce qui gère la virtualisation sous Linux et personne ne l'avait remarqué, jusqu'à ce que Hyunwoo Kim, un chercheur en sécurité connu sous le pseudo @v4bel débarque. Ce dernier vient de dénicher un use-after-free dans le shadow MMU de KVM, ce bout de code que KVM partage entre les processeurs Intel et AMD. Il a baptisé sa trouvaille Januscape (CVE-2026-53359), et croyez-moi, le scénario a de quoi filer des sueurs froides

Januscape - La faille KVM qui dormait depuis 16 ans dans le cloud

Par : Korben ✨
7 juillet 2026 à 11:55

Depuis 16 ans, il y a une énorme faille qui fait dodo dans le coeur de tout ce qui gère la virtualisation sous Linux et personne ne l'avait remarqué, jusqu'à ce que Hyunwoo Kim, un chercheur en sécurité connu sous le pseudo @v4bel débarque. Ce dernier vient de dénicher un use-after-free dans le shadow MMU de KVM, ce bout de code que KVM partage entre les processeurs Intel et AMD. Il a baptisé sa trouvaille Januscape (CVE-2026-53359), et croyez-moi, le scénario a de quoi filer des sueurs froides à n'importe quel hébergeur...

En pratique, quand vous louez une VM dans le cloud, vous y êtes root (normal, c'est votre instance). Mais si l'hôte autorise la virtualisation imbriquée, hé bien la faille vous ouvre en grand la porte vers la machine physique. Le code de démonstration que Kim a publié se contente de faire planter l'hôte, et il garde sous le coude un second exploit, non divulgué publiquement celui-là, qui transforme le même bug en exécution de code root sur l'hôte. Et il n'a pas trouvé tout ça par hasard, puisqu'il participait au kvmCTF de Google, un programme qui paie jusqu'à 250 000 dollars pour une évasion complète d'une VM vers son hôte...

À ce stade, l'isolation censée séparer les locataires d'un même serveur vole en éclats, les VM de vos voisins de palier comprises.

Le code fautif traîne depuis août 2010, du temps du noyau 2.6.36 et Kim présente d'ailleurs Januscape comme la première évasion d'une VM vers son hôte qui fonctionne aussi bien sur Intel que sur AMD, à sa connaissance en tout cas.

Maintenant, avant de couper le wifi et de partir élever des chèvres dans le Larzac, deux petites nuances quand même car l'attaque réclame deux conditions réunies : être root dans la VM invitée, et que l'hôte expose la virtualisation imbriquée. Pas mal d'hébergeurs ne l'activent pas, donc c'est pas non plus une apocalypse universelle. Par contre, pour ceux qui l'activent, c'est game over.

Mais bonne nouvelle, le correctif est déjà là donc si vous administrez des serveurs KVM, mettez à jour maintenant. Et si vous ne pouvez pas patcher tout de suite, la parade consiste à désactiver la virtualisation imbriquée en attendant, avec kvm_intel.nested=0 sur de l'Intel ou kvm_amd.nested=0 sur de l'AMD.

VENOM s'échappait déjà d'une VM en 2015 via un vieux driver de disquette, et plus récemment une faille kernel planquée neuf ans offrait un accès root sur une machine Linux. Ces "fantômes" dorment longtemps dans le noyau, et ils choisissent toujours le pire moment pour se réveiller. Voilà, comme d'autres failles Linux à patcher d'urgence , celle-ci mérite tout de suite votre attention.

Source

  • ✇Korben
  • Nomlings - Le Tamagotchi affamé qui dévore vos tokens Claude Code
    Nomlings, c'est un Tamagotchi qui vit à côté de votre terminal, et dont la seule nourriture, ce sont les tokens que crament vos sessions Claude Code. Vous bossez, il mange. Vous glandez, il patiente. Et pendant que vous regardez votre usage fondre comme neige au soleil, bah lui il se régale !! La bestiole s'appelle un Munchling, un "tokivore" quoi, qui s'affiche sur un écran de 64 pixels et chaque tâche terminée lui rapporte +10 XP et un snack. Quand un outil plante, il fait la gueule et qua

Nomlings - Le Tamagotchi affamé qui dévore vos tokens Claude Code

Par : Korben ✨
6 juillet 2026 à 15:30

Nomlings, c'est un Tamagotchi qui vit à côté de votre terminal, et dont la seule nourriture, ce sont les tokens que crament vos sessions Claude Code. Vous bossez, il mange. Vous glandez, il patiente.

Et pendant que vous regardez votre usage fondre comme neige au soleil, bah lui il se régale !!

La bestiole s'appelle un Munchling, un "tokivore" quoi, qui s'affiche sur un écran de 64 pixels et chaque tâche terminée lui rapporte +10 XP et un snack.

Quand un outil plante, il fait la gueule et quand Claude attend une réponse de votre part depuis un moment parce que vous êtes parti vous refaire un café, il vous alerte pour que vous reveniez bosser. Bref, c'est une créature en pixels qui vous fera culpabiliser de procrastiner, ce qui peut-être pas mal quand on est un indé à son compte et grosse feignasse en même temps ^^.

Derrière tout ça, le soft digère en réalité les événements de vos sessions, en se branchant sur les hooks officiels de Claude Code (SessionStart, PostToolUse et Stop), qui transitent uniquement en local. Si l'app n'est pas lancée, ces hooks ne font strictement rien, donc aucun ralentissement à craindre. Ça marche un peu comme Notchi pour ceux qui connaissent.

Côté élevage, votre Munchling démarre donc dans un œuf et évolue jusqu'à l'âge adulte, en gagnant d'abord une antenne, puis une deuxième (la classe ^^). Il reçoit un goûter à chaque tâche terminée, plus un snack qu'il part fourrager tout seul toutes les 30 minutes, même app fermée, avec un maximum de 5 en réserve. Y'a aussi un bouton FEED qui vous laisse le nourrir quand il fait les yeux doux. Et rassurez-vous, contrairement au Tamagotchi de votre enfance retrouvé mort au fond du cartable, celui-là ne peut pas mourir !

Ah vous n'utilisez pas Claude Code ?

Pas grave, y'a un mode companion prévu pour vous. Dans ce mode, le serveur de hooks et le watcher de transcript ne démarrent jamais, et rien n'est écrit dans votre ~/.claude. La bestiole se nourrit à la place des tâches que vous effectuez et des interactions que vous déclenchez dans Nomlings. Par exemple, cocher une tâche rapporte +10 XP et un snack, exactement comme une session Claude. Ça me rappelle Codachi, ce Tamagotchi qu'on adopte dans VSCode pour coder moins seul, sauf qu'ici pas besoin d'éditeur particulier.

En tout cas, c'est rigolo et c'est gratuit, sauf si vous optez pour le pack cosmétique qui débloque 9 espèces supplémentaires (dragon, poussin, fantôme, robot, grenouille, abeille…), ainsi que 9 coques pour habiller le boîtier et des couleurs à choisir librement.

Maintenant, reste LE point qui fâche : pour l'instant, Nomlings tourne uniquement sous Windows. Ouais désolé, c'est la vie !

Bref, si vous pensez que tous les tokens que vous cramez sur Claude Code méritent une fin plus glorieuse qu'un simple compteur qui vous fout la pression, c'est par ici que ça se passe.

  • ✇Korben
  • RomM - Le gestionnaire de ROMs des retro gamers sérieux
    Vous galérez avec vos ROMs de jeux rétro éparpillées un peu partout sur votre PC ? Vous passez des heures à chercher le bon émulateur, les bons fichiers, les bonnes versions ? Et bien tout ça c'est fini, grâce à RomM qui est un gestionnaire de ROMs vraiment cool. Vous lui indiquez le répertoire qui contient tous vos jeux, et hop, en quelques clics, il scanne et organise tout ce bordel avec les bonnes infos et les jolies jaquettes qu'il va récupérer sur IGDB , ScreenScraper, MobyGames ou Steam

RomM - Le gestionnaire de ROMs des retro gamers sérieux

Par : Korben ✨
3 juillet 2026 à 15:28

Vous galérez avec vos ROMs de jeux rétro éparpillées un peu partout sur votre PC ? Vous passez des heures à chercher le bon émulateur, les bons fichiers, les bonnes versions ? Et bien tout ça c'est fini, grâce à RomM qui est un gestionnaire de ROMs vraiment cool.

Vous lui indiquez le répertoire qui contient tous vos jeux, et hop, en quelques clics, il scanne et organise tout ce bordel avec les bonnes infos et les jolies jaquettes qu'il va récupérer sur IGDB , ScreenScraper, MobyGames ou SteamGridDB. RomM gère plus de 400 plateformes, de la Super Nintendo à la PlayStation, en passant par la GameBoy, la MegaDrive et même des trucs plus obscurs comme le PocketStation.

Ce tool vous permet même de lancer vos jeux directement dans le navigateur grâce à EmulatorJS (et RuffleRS pour les vieux jeux Flash), comme ça, pas besoin d'installer 50 émulateurs, tout est intégré, propre et facile. C'est beau !

C'est également super customisable, avec le support des ROMs en plusieurs fichiers pour les jeux PS1, le parsing des tags des noms de fichiers pour classer par région, la gestion des permissions et des utilisateurs, les succès RetroAchievements... Bref, c'est du solide !

Là où RomM a beaucoup grandi, c'est tout l'écosystème autour. Il y a maintenant des apps pour le consulter et y jouer depuis n'importe où : Argosy sur Android, une app iOS, un plugin Playnite, et même des petits clients pour consoles portatives moddées, Grout pour muOS et NextUI, DeckRommSync pour le Steam Deck, jusqu'à un homebrew sur Switch. Pratique pour pousser tes jeux sur la machine de ton choix.

Et si vous êtes un gros noob, pas de panique, c'est pas sorcier de l'installer. Vous créez votre clé API IGDB , vous mettez vos ROMs dans le bon format de dossier, vous modifiez deux trois trucs dans le fichier docker-compose.yml et voilà, en deux temps trois mouvements vous aurez votre serveur qui tourne ! Sur le NAS par exemple, c'est top comme ça plus de galère, plus de temps perdu, juste le plaisir du jeu à l'ancienne.

L'équipe derrière le projet a même monté une doc très complète .

À découvrir ici !

Encore merci à Lorenper !

Article publié initialement le 9 mai 2024 et mis à jour le 3 juillet 2026.

  • ✇Korben
  • NanoKVM-Go - Le KVM USB-C qui garde vos écrans en mémoire
    La société Sipeed vient d'annoncer la sortie d'un nouveau KVM USB-C qui je pense va vous intéresser. Il s'appelle le NanoKVM-GO, il fait la taille d'une grosse boite d'allumettes et permet de prendre le contrôle de n'importe quel appareil capable de cracher de la vidéo via son port USB-C. Donc y'a juste besoin d'un câble, et pi c'est tout. Que ce soit un iPhone 15 ou supérieur, un MacBook, un Steam Deck, un mini PC Windows, un smartphone Android, no problemo, le boîtier s'intercale entre vous et

NanoKVM-Go - Le KVM USB-C qui garde vos écrans en mémoire

Par : Korben ✨
2 juillet 2026 à 11:53

La société Sipeed vient d'annoncer la sortie d'un nouveau KVM USB-C qui je pense va vous intéresser. Il s'appelle le NanoKVM-GO, il fait la taille d'une grosse boite d'allumettes et permet de prendre le contrôle de n'importe quel appareil capable de cracher de la vidéo via son port USB-C.

Donc y'a juste besoin d'un câble, et pi c'est tout. Que ce soit un iPhone 15 ou supérieur, un MacBook, un Steam Deck, un mini PC Windows, un smartphone Android, no problemo, le boîtier s'intercale entre vous et la machine, capture l'écran en 4K, simule le clavier et la souris, et vous laisse piloter le tout depuis un simple navigateur, où que vous soyez.

Il existe également une version Go+ de la bestiole qui embarque ce que Sipeed appelle sobrement une "Ambient Screen Intelligence", comprenez une fonction à la Microsoft Recall où le boîtier photographie votre écran en continu, conserve jusqu'à 180 jours de captures en local, et vous laisse fouiller tout ça à la recherche textuelle. Bref, ce que Redmond avait proposé et qui avait fait hurler tout le monde, bah là c'est pareil mais en version hardware.

Donc comme je vous le disais, y'a plus qu'un seul câble USB-C vers la cible (DP Alt Mode pour la vidéo, HID pour le clavier et la souris, disque virtuel pour booter des ISO), et l'hôte se connecte au boîtier en WiFi. La latence annoncée est de 60 ms en 1080p, jusqu'à 100 ms en 4K. Le boîtier tire son jus du port USB-C de la cible (5 V), avec un second port pour la charge passthrough et le contrôle de petits FingerBot.

Ça permet ainsi de régler 2 des plus gros problèmes des outils de prise de contrôle à distance comme TeamViewer ou VNC :

  1. L'accès au BIOS qu'aucun logiciel ne peut jamais atteindre
  2. Le freeze de l'app ou de l'OS qui rend inopérant un TeamViewer par exemple

Avec un boitier KVM, vous rebootez comme vous voulez et vous avez toujours la main. En tout cas, je suis content de voir que l'usine à câble d'il y a 10 ans devient maintenant ultra minimaliste. Perso, j'adore !

Maintenant, la fonction "Recall", on aime ou pas mais déjà c'est optionnel et ensuite, tout reste en local. Alors c'est vrai, et c'est "déjà ça". Mais bon, ça conserve quand même 6 mois de data de tout ce qui est affiché sur vos écrans (mails, mots de passe tapés, conversations, documents), accessible à distance à qui a le mot de passe (et le bon Tailscale). C'est une surface d'attaque qu'il faut prendre en compte, surtout que c'est le même fabricant qui s'était déjà fait prendre avec un micro non documenté dans un de ses KVM . Pas de quoi paniquer cependant car c'est optionnel. Et pour de la bidouille perso / auto-hébergement, ça reste un super jouet. Après, en entreprise, faudra voir...

Sipeed expose aussi toutes les fonctions du KVM via un serveur MCP, le protocole d'Anthropic pour relier les LLM à des outils. Vous branchez votre agent IA préféré dessus, et il va vraiment pouvoir s'éclater en prenant physiquement la main (à 6 doigts forcément ^^) sur la souris et le clavier de la machine.

Sur un KVM IP , on sait depuis longtemps que la moindre faille ouvre la porte à tout et là, vous déléguez volontairement cette porte à un modèle, donc une fois encore, à vous de voir si le jeu en vaut la chandelle.

Le projet est sur Kickstarter, le GitHub et le wiki sont encore vides au moment où j'écris, car la campagne vient d'à peine démarrer. Notez que son concurrent direct, le GL.iNet Comet Q, a déjà rempli son objectif de financement en quelques minutes, lui, donc je pense que Sipeed a toutes ses chances en jouant cette carte de la compacité (45 × 40 × 15 mm), de la 4K et du stockage embarqué (16 Go sur le Go, 64 Go sur le Go+, assez donc pour trimballer des ISO bootables).

Le SoC n'est pas officiellement nommé mais c'est quasi certain qu'il s'agit d'un Axera AX630C avec un NPU à 3,2 TOPS (le même cœur que le NanoKVM Pro 4K quoi).

Les premiers prix Early Bird tournent autour de 59 dollars pour le Go, 79 dollars pour le Go+. MSRP annoncé à 89 et 129 dollars une fois la campagne terminée et côté expédition, Sipeed promet une livraison mondiale depuis Shenzhen, sans date ferme pour l'instant.

Bref, si vous voulez piloter n'importe quelle machine USB-C à distance et que l'idée d'un agent IA qui clique tout seul ne vous fait pas trop flipper, ça peut vous intéresser.

Source

  • ✇Korben
  • Un ransomware dans le navigateur ? Suffit de demander à DeepSeek
    Dans la série "Qu'est-ce qu'on se marre avec les LLMs", des chercheurs en cybersécurité de Check Point ont tenté une expérience plutôt fun (enfin, je trouve ^^) : Demander à DeepSeek de leur coder un ransomware capable de tourner directement dans le navigateur. Et bah croyez le ou non mais le machin l'a fait sans broncher ^^ Quand je repense à tout ce foin qu'on vient de vivre avec les américains avec Mythos et Fable 5 d'Anthropic, j'avoue je rigole quand je vois ça. Alexey Bukhteyev et Pedro Dr

Un ransomware dans le navigateur ? Suffit de demander à DeepSeek

Par : Korben ✨
2 juillet 2026 à 06:51

Dans la série "Qu'est-ce qu'on se marre avec les LLMs", des chercheurs en cybersécurité de Check Point ont tenté une expérience plutôt fun (enfin, je trouve ^^) : Demander à DeepSeek de leur coder un ransomware capable de tourner directement dans le navigateur.

Et bah croyez le ou non mais le machin l'a fait sans broncher ^^ Quand je repense à tout ce foin qu'on vient de vivre avec les américains avec Mythos et Fable 5 d'Anthropic, j'avoue je rigole quand je vois ça.

Alexey Bukhteyev et Pedro Drimel Neto, de l'équipe malware de Check Point, ont récupéré cet échantillon bricolé par l'IA, l'ont un peu peaufiné quand même, et se sont retrouvés avec une arme à 100% fonctionnelle capable de chiffrer tous vos documents depuis Chrome sans rien avoir à installer.

Le code malveillant s'appuie sur la File System Access API, une fonction qui permet à une page web de demander l'accès à un dossier de votre disque. La cible clique sur "autoriser" en pensant retoucher une image sur un site de "AI photo enhancer" bidon, et derrière la page parcourt le dossier ouvert, chiffre son contenu, et laisse une jolie demande de rançon et aucun moyen de récupérer les fichiers originaux.

Et surtout, DeepSeek a été au-delà de leurs attentes en proposant plein de fonctionnalités "cools" en plus à ce ransomware comme du vol de tokens Discord, de numéros de carte, de seed phrases crypto et de l'accès webcam. Mais en y regardant de plus près, les chercheurs ont remarqué que tout ceci avait été halluciné et ne fonctionnait pas vraiment. Le seul truc fonctionnel c'est le chiffrement du dossier qu'ils ont eux-même demandé et autorisé.

L'idée de faire un ransomware dans le navigateur n'est pas nouvelle et d'autres chercheurs l'avaient déjà théorisée à la conférence USENIX Security en 2023 sous le nom de RoB, ("Ransomware over Browsers") mais ce qui change vraiment ici, c'est que sans grandes compétences, n'importe qui peut le faire.

Et c'est là que DeepSeek se distingue de la concurrence. Le modèle refuse bien sûr la demande si vous écrivez le mot "ransomware". Mais les chercheurs sont des petits malins et ont simplement retiré les termes qui fâchent, remplaçant "ransomware" par une formulation plus neutre du style "outil de chiffrement de fichiers". Et voilà, DeepSeek v4 a recraché exactement la même fonctionnalité.

Ce garde-fou s'est vraiment comporté comme un simple filtre anti gros mots, c'est un peu ridicule, surtout que ce n'est pas la première fois que le modèle chinois se fait remarquer côté code douteux , ni la première fois que les IA open source montrent leur face sombre .

Pour vous protéger contre ce genre de ransomware, il faudra donc être très vigilant à l'avenir et vous demander pourquoi tel ou tel site vous demande un accès COMPLET à un dossier plutôt que simplement au fichier dont il a besoin. Et sur Android, ça va être encore plus sensible depuis que Chrome peut donner accès au dossier photos. Bref, dans le doute, refusez...

Source

  • ✇Korben
  • ZCode - L'app maison de z.ai pour coder avec GLM
    Hier je vous parlais de GLM 5.2 , le modèle open source que j'ai fini par adopter (en partie) pour bosser. Eh bien la team z.ai (le lab chinois anciennement connu sous le nom de Zhipu AI) enchaîne le bon travail et pousse désormais ZCode , leur propre application pour coder avec des agents IA. C'est une app desktop qui tourne sur Mac, Windows et Linux (en beta pour ce dernier), et elle est pensée pour les tâches qui durent. L'idée, ce sont des Goals que vous fixez, et l'agent planifie, exécute e

ZCode - L'app maison de z.ai pour coder avec GLM

Par : Korben ✨
1 juillet 2026 à 22:58

Hier je vous parlais de GLM 5.2 , le modèle open source que j'ai fini par adopter (en partie) pour bosser. Eh bien la team z.ai (le lab chinois anciennement connu sous le nom de Zhipu AI) enchaîne le bon travail et pousse désormais ZCode , leur propre application pour coder avec des agents IA.

C'est une app desktop qui tourne sur Mac, Windows et Linux (en beta pour ce dernier), et elle est pensée pour les tâches qui durent. L'idée, ce sont des Goals que vous fixez, et l'agent planifie, exécute et vérifie son boulot tout seul par étapes, pendant que vous suivez la progression.

Vous avez donc un vrai environnement avec gestionnaire de fichiers, terminal, panneau Git et aperçu du navigateur en direct, ça cause le protocole MCP, ça sait lancer plusieurs agents en parallèle, et vous pouvez même piloter vos tâches à distance depuis WeChat ou Feishu. Et le tout tourne sur le même GLM Coding Plan que le reste de leur écosystème, à partir de 18 dollars par mois.

Si vous me suivez, vous savez déjà que GLM 5.2 se branche directement dans Claude Code, parce que l'API de z.ai est compatible Anthropic. Je vous avais d'ailleurs filé le petit launcher pour ça pas plus tard qu'hier. Mais ce ZCode, c'est surtout une bonne vitrine pour z.ai, afin de nous garder dans leur app plutôt qu'on utilise la concurrence. Quoi qu'il en soit, rien d'obligatoire, faut voir ce ZCode comme une option de plus pour coder à l'aide de l'IA.

L'appli est toute récente et en fouillant leur repo de feedback , je vois que l'app se prend encore des plantages bien douloureux sur Apple Silicon, avec notamment des erreurs qui vous font perdre le travail non sauvegardé et une fenêtre qui reste parfois noire même après avoir relancé l'app. Ça calme un peu pour un truc censé gérer des sessions longues de taf... Mais je pense que ça va rapidement se stabiliser, tant les dev de Z.ai font du bon boulot.

Si vous êtes déjà abonné au GLM Coding Plan, ça ne vous coûtera rien de plus d'essayer histoire de voir si les Goals collent à votre façon de bosser. Et sinon, pour les autres, l'API + votre outil habituel, ça fera tout aussi bien le job.

Podcast Projets Libres saison 4 épisode 19 : surveiller les grandes plateformes grâce à Open Terms Archive

Titre de l'image

Comment rendre plus transparents les changements des conditions d'utilisation des grands services numériques ?
Pour ce nouvel épisode sur les communs numériques, nous partons à la découverte d'Open Terms Archive !

Open Terms Archive permet de suivre et alerter des changements qui se cachent dans ces documents peu compréhensibles.

Avec Sydney Wheeler et Matti Schneider nous revenons sur :

  • la genèse du projet
  • sa gouvernance et sa communauté
  • son fonctionnement
  • ses défis de structuration après sa phase d'incubation au sein du ministère des affaires étrangères jusqu'à janvier 2026
  • son utilisation en dehors de la France

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇Korben
  • Kim Dotcom - Son extradition aux USA se rapproche
    Le 20 janvier 2012, 76 policiers et deux hélicoptères débarquent sur le manoir de Coatesville, en Nouvelle-Zélande, pour coffrer un gros bonhomme allemand la veille de ses 38 ans. Ce bonhomme, c'est Kim Dotcom , le patron de Megaupload. Et quatorze ans plus tard, la justice néo-zélandaise vient encore de lui claquer la porte au nez ! En effet, la Cour d'Appel de Nouvelle-Zélande a rejeté ce 1er juillet la totalité de ses recours contre son extradition vers les États-Unis. Tous ses arguments, ba

Kim Dotcom - Son extradition aux USA se rapproche

Par : Korben ✨
1 juillet 2026 à 14:34

Le 20 janvier 2012, 76 policiers et deux hélicoptères débarquent sur le manoir de Coatesville, en Nouvelle-Zélande, pour coffrer un gros bonhomme allemand la veille de ses 38 ans. Ce bonhomme, c'est Kim Dotcom , le patron de Megaupload.

Et quatorze ans plus tard, la justice néo-zélandaise vient encore de lui claquer la porte au nez !

En effet, la Cour d'Appel de Nouvelle-Zélande a rejeté ce 1er juillet la totalité de ses recours contre son extradition vers les États-Unis. Tous ses arguments, balayés un par un et là, il ne lui reste plus qu'une seule cartouche à savoir la Cour suprême néo-zélandaise.

Vous vous demandez peut-être ce qu'on lui reproche exactement ?

Hé bien, aux États-Unis, Kim Dotcom traîne 12 chefs d'accusation sur les 13 du dossier initial, la charge de blanchiment ayant sauté en cours de route... Il est accusé de violation massive du copyright, de racket, de fraude électronique et j'en passe...

Le gouvernement américain parle de 175 millions de dollars de revenus criminels et de plus de 500 millions de préjudice pour les ayants droit. Et au bout du tunnel, une peine de 30 à 150 ans de prison fédérale pour lui. Donc autant dire la perpétuité.

Et c'est là que le dossier devient franchement bancal puisque ses 2 bras droits, Mathias Ortmann et Bram van der Kolk, ont plaidé coupable, eux, en Nouvelle-Zélande et ont obtenu chacun deux ans et demi de taule environ, purgés sur place. Mêmes accusations, même boîte, même raid pour Kim, sauf que lui a choisi de se battre bec et ongles. Du coup, pour punir une telle défiance, on lui promet un aller simple pour la Virginie et un demi-siècle derrière les barreaux.

Son avocat, Ron Mansfield, l'a pourtant martelé... soit on jugeait les trois en Nouvelle-Zélande, soit aucun et perso, je trouve que c'est difficile de lui donner tort sur ce point précis. Sauf que la Nouvelle-Zélande n'a pas de " forum bar ", une règle qu'on retrouve au Royaume-Uni, qui laisse un juge bloquer une extradition quand le pays aurait très bien pu organiser le procès lui-même.

Mais ça n'a pas d'importance. La réalité, c'est que la justice américaine a accepté de lâcher Ortmann et van der Kolk, mais pas Dotcom. Ils veulent sa tête car il est le visage de Megaupload et quelqu'un doit payer. Mais après tout ce temps, le bonhomme a vieilli, il a encaissé un AVC en cours de route, et vu défiler l'arrêt complet de ses sociétés, le gel de ses comptes aux quatre coins de la planète, avant finalement de relancer Mega le successeur de Megaupload en version "clean".

Alors est-ce que Dotcom est un enfant de chœur ?

Bien sûr que non.

Megaupload, c'était une belle pompe à fric qui carburait en partie au contenu piraté, tout le monde le sait. Mais j'avoue que le voir risquer 150 ans de prison alors que ses associés n'en ont pris que 30 mois, je trouve que ça manque un peu de dosage. Cette affaire sans fin ressemble plus à une vendetta que les studios d'Hollywood veulent obtenir qu'à de la justice.

Mais il lui reste la Cour suprême donc on verra bien. Encore quelques mois de sursis, peut-être un an ou deux... Force à lui.

Source : TorrentFreak

  • ✇Korben
  • OpenClaw - L'assistant IA arrive sur iPhone et Android
    Chers amateurs d'OpenClaw, bonne nouvelle, votre outil préféré débarque sur iPhone et Android. Mais contrairement à ce que vous faites d'habitude, pour une fois, je vous conseille de bien lire mon article avant de foncer. En janvier, je vous faisais découvrir rapidement OpenClaw , un assistant IA personnel et open source qui a beaucoup fait parler de lui. Perso, moi je ne suis pas fan (ni de Hermes) parce que je trouve ça plus pratique de dev mes propres outils plus adaptés et mieux pensés plutô

OpenClaw - L'assistant IA arrive sur iPhone et Android

Par : Korben ✨
1 juillet 2026 à 13:33

Chers amateurs d'OpenClaw, bonne nouvelle, votre outil préféré débarque sur iPhone et Android. Mais contrairement à ce que vous faites d'habitude, pour une fois, je vous conseille de bien lire mon article avant de foncer.

En janvier, je vous faisais découvrir rapidement OpenClaw , un assistant IA personnel et open source qui a beaucoup fait parler de lui. Perso, moi je ne suis pas fan (ni de Hermes) parce que je trouve ça plus pratique de dev mes propres outils plus adaptés et mieux pensés plutôt que de partir sur une solution comme ça. Mais breeef, ce n'est que mon avis.

Maintenant si vous êtes utilisateur d'OpenClaw, vous allez pouvoir lancer ça gratuitement sur votre iOS ou Android . Toutefois, ce ne sont pas des OpenClaw complets embarqués dans une app pour smartphone mais plutôt des appli "compagnons", c'est-à-dire un relais pour un vrai OpenClaw installé sur votre Mac, Linux ou Windows (avec WSL évidemment). L'app mobile ne fait donc que s'y connecter pour que vous puissiez interagir avec.

Ce qui est plutôt bien pensé c'est que l'app utilise les capteurs du téléphone pour par exemple pouvoir envoyer des photos, votre position GPS ou écouter ce que vous lui racontez avec le mode "Talk". Ou tout simplement affiche le Canvas qui est l'interface web dans laquelle l'agent bricole en direct.

Bref, OpenClaw bosse sur votre ordinateur et votre smartphone c'est sa télécommande.

L'app est encore un peu brut de décoffrage avec des petits bugs par ci par là mais ça fonctionne quand même alors on ne va pas se plaindre. Par contre, attention si vous l'utilisez sur des réseaux wifi public... je vous conseille de passer par un VPN ou un Tailscale pour éviter de vous faire maninzemideuler par un script kiddy qui passe par là.

Tout est open source sur GitHub , amusez-vous bien !

Source

  • ✇Korben
  • Reflect v1.0 - Programmer un humanoïde en une phrase
    Un humanoïde qui traverse un immeuble, appelle l'ascenseur, ouvre un colis avec un outil et range les courses dans un tiroir, tout seul, et sur une seule consigne qui lui est donnée en langage naturel, ce n'est pas de la sorcellerie ! Non, c'est la démo qu'a sortie Flexion Robotics , une startup suisse, qui lance Reflect v1.0, son nouveau "cerveau" IA pour robots. Car Flexion ne fabrique pas de robots. Cette spin-off zurichoise, fondée en 2024 par d'anciens chercheurs Nvidia, vend du logicie

Reflect v1.0 - Programmer un humanoïde en une phrase

Par : Korben ✨
1 juillet 2026 à 12:07

Un humanoïde qui traverse un immeuble, appelle l'ascenseur, ouvre un colis avec un outil et range les courses dans un tiroir, tout seul, et sur une seule consigne qui lui est donnée en langage naturel, ce n'est pas de la sorcellerie ! Non, c'est la démo qu'a sortie Flexion Robotics , une startup suisse, qui lance Reflect v1.0, son nouveau "cerveau" IA pour robots.

Car Flexion ne fabrique pas de robots. Cette spin-off zurichoise, fondée en 2024 par d'anciens chercheurs Nvidia, vend du logiciel, une couche d'intelligence qui se pose sur un humanoïde existant et le pilote de bout en bout.

Là où Alibaba donne un corps à son IA avec une suite logicielle complète, Flexion ne vise que le cerveau. Vous écrivez ce que vous voulez en langage naturel, et le robot part faire sa vie pour vous satisfaire au mieux. Vous pouvez même changer la consigne en plein vol, du genre "non, reviens par ici" et il abandonnera tout pour revenir dans vos bras.

En général, en robotique (comme avec les LLMs finalement...), l'autonomie longue sur les tâches, c'est l'enfer. Une mission de 16 étapes, des erreurs qui s'enchaînent et paf, tout s'écroule. Alors pour encaisser ça, ils ont entraîné leur propre modèle de vision-langage, un chef d'orchestre qui surveille, raisonne et replanifie en direct. Et ils ont misé sur l'apprentissage par renforcement à tous les étages, du mouvement fin jusqu'à la décision. Et voilà comment (en labo), ils passent de 38 % à 90 % de réussite sur ce genre de missions longues.

Ensuite côté capacités, c'est du costaud puisqu'on a un robot qui manipule des colis de 100 g à 3,5 kg, repositionne les cartons, appuie sur les boutons d'ascenseur au centimètre près, utilise des outils, enchaîne les escaliers et slalome entre les obstacles avec sa charge. Et quand il rate une prise, s'pas grââve, il retente ou replanifie sa route grâce à ses caméras.

En ce moment, les annonces d'humanoïdes pleuvent en Chine... On a eu par exemple Agibot qui affiche 99 % de succès sur une démo usine de six jours, ShengShu qui présente Motubrain , son cerveau unifié, et ça ne risque pas de s'arrêter, sans parler des robots chinois un peu plus bas de gamme, revendus en marque blanche qui commencent à pulluler comme les aspi robots ou les tondeuses autonomes...

À voir maintenant si l'un d'eux ira un peu trop loin en milieu ouvert... En attendant, Flexion est très honnête puisque la société explique que Reflect v1.0 reste limité à des tâches bien définies, et qu'ils ne sont pas encore prêts pour l'autonomie universelle... pour l'instant.

Source : Interesting Engineering

❌
❌