❌

Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hierLEBIGDATA.FR
  • ✇LEBIGDATA.FR
  • Comment les Systèmes Multi-Agents réinventent l’intelligence artificielle
    L’évolution de l’informatique moderne repose sur la gestion de données. Ces volumes deviennent de plus en plus massifs et complexes. Les architectures logicielles centralisées historiques peinent désormais à répondre à ces besoins de flexibilité. C’est dans ce contexte de transition numérique que s’inscrivent les Systèmes Multi-Agents comme une alternative majeure. Ce paradigme déplace la logique algorithmique vers un réseau d’entités interconnectées. Chaque composant autonome participe activ

Comment les Systèmes Multi-Agents réinventent l’intelligence artificielle

Par : Roberto R.
30 juin 2026 à 19:30

L’évolution de l’informatique moderne repose sur la gestion de données. Ces volumes deviennent de plus en plus massifs et complexes. Les architectures logicielles centralisées historiques peinent désormais à répondre à ces besoins de flexibilité. C’est dans ce contexte de transition numérique que s’inscrivent les Systèmes Multi-Agents comme une alternative majeure.

Ce paradigme déplace la logique algorithmique vers un réseau d’entités interconnectées. Chaque composant autonome participe activement à l’effort collectif. Cet article explore en profondeur les fondements et l’histoire de cette technologie. Il analyse également ses architectures ainsi que ses applications industrielles.

Les fondements de l’intelligence artificielle distribuée

Les architectures informatiques traditionnelles reposent sur un modèle monolithique. Un serveur central y prend les décisions et exécute les tâches de manière séquentielle. Cette centralisation se heurte vite à des limites physiques, comme la saturation de la mémoire. Les goulets d’étranglement qui en résultent ralentissent les performances et bloquent le traitement des données massives.

Pour dépasser ces limites, la recherche a développé l’Intelligence Artificielle Distribuée (IAD). Ce modèle fragmente le problème initial pour répartir le calcul sur plusieurs machines. La décision n’appartient plus à une entité unique, mais devient le fruit d’un effort partagé. Cette décentralisation améliore la réactivité en temps réel et rend les systèmes plus flexibles.

L’IAD mise sur l’émergence pour faire naître une intelligence collective. À l’image d’une colonie de fourmis, chaque individu suit des règles simples sans dépendre d’un chef central. Leurs interactions dans un espace partagé génèrent un comportement de groupe complexe. Cette synergie permet de résoudre des défis logistiques ou mathématiques, le système global devenant souvent plus performant que chacun de ses composants.

Définition et piliers fondamentaux des Systèmes Multi-Agents

L’agent informatique est la brique de base de ce modèle distribué. Qu’il soit un logiciel ou un robot physique, il possède ses propres objectifs et une autonomie relative. Il analyse sa situation et agit sans attendre d’ordres permanents. Ses capteurs perçoivent son milieu et ses actionneurs le modifient selon un cycle continu : perception, délibération, action.

Les agents coexistent dans un environnement partagé, virtuel comme internet ou physique comme un entrepôt. Cet espace dynamique leur impose des contraintes qui limitent leurs actions ou leurs calculs. Il évolue sous l’effet de leurs comportements et d’événements extérieurs. Ce milieu permet aussi une communication indirecte, la stigmergie, où les agents s’adaptent en observant les traces de leurs pairs.

Pour éviter le chaos, une organisation collective structure le réseau. Elle définit les rôles de chacun, attribue les responsabilités et fixe l’accès aux ressources communes. Des règles et des protocoles encadrent les échanges afin de prévenir les blocages. Ce cadre pilote la répartition des tâches, garantissant la cohérence et la stabilité des décisions globales.

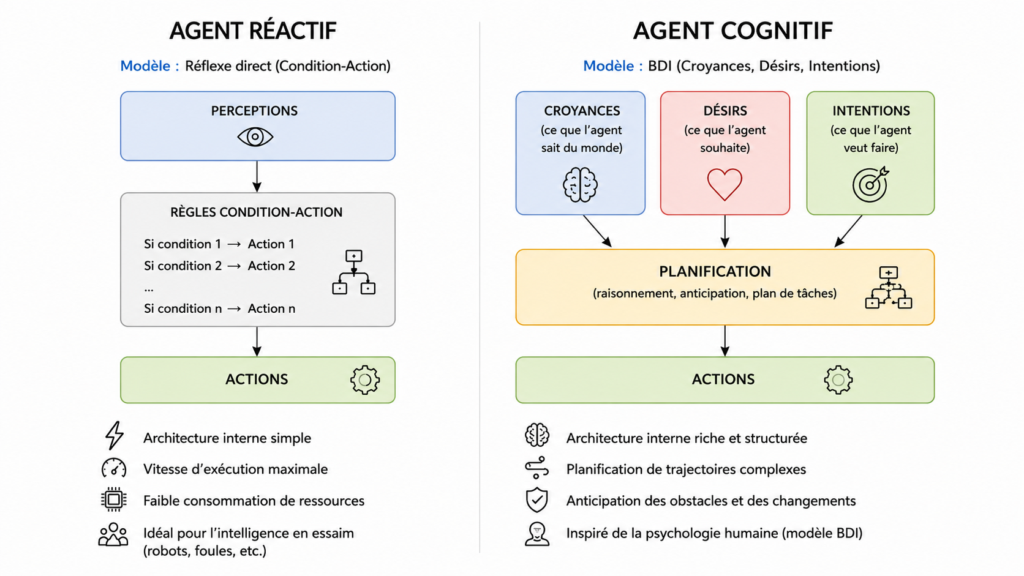
image illustrant l'architecture interne d'un agent autonome

Architecture interne et typologie d’un agent autonome

Les agents réactifs possèdent l’architecture interne la plus simple. Leur comportement repose entièrement sur un modèle réflexe direct. Ils associent une perception immédiate à une action selon une logique de type « Condition-Action« . Ces entités ne possèdent qu’une mémoire très limitée pour modéliser l’avenir.

Cette simplicité logicielle garantit une vitesse d’exécution maximale. Les agents consomment également très peu de ressources informatiques. Ce modèle permet de simuler efficacement les principes de l’intelligence en essaim. Il sert ainsi à coordonner des flottes de robots ou des foules urbaines.

À l’opposé, les agents cognitifs disposent d’une structure interne beaucoup plus riche. Ils s’appuient sur le modèle logique BDI inspiré de la psychologie humaine. Cette architecture articule explicitement les croyances, les désirs et les intentions de l’entité. Ce fonctionnement permet de planifier des trajectoires complexes et d’anticiper les obstacles.

Mécanismes d’interaction au sein des Systèmes Multi-Agents

La collaboration entre agents exige un langage commun pour éviter les malentendus. La fondation FIPA a créé des normes internationales pour répondre à ce défi. Le standard FIPA-ACL est aujourd’hui un langage de communication largement utilisé. Ce protocole permet à des entités hétérogènes d’échanger des informations de façon structurée.

Chaque message FIPA-ACL contient des champs obligatoires qui organisent la discussion. Il indique l’émetteur, le récepteur et un contenu précis. Son élément clé est le « performatif », qui définit l’intention du message, comme une question ou une offre. Grâce à cette structure, l’agent comprend mieux l’objectif de son interlocuteur.

Pour répartir le travail, les agents utilisent des protocoles de négociation comme le filet de contrats. Un agent émetteur publie un appel d’offres décrivant une tâche et ses contraintes. Les autres agents évaluent leurs capacités avant de soumettre une proposition. L’émetteur choisit l’offre la plus adaptée, facilitant une gestion efficace sans intervention humaine.

Historique et grandes étapes de l’évolution des agents

Les bases de la discipline naissent dans les années 1970. En 1973, Carl Hewitt introduit le modèle d’Acteurs, où des entités autonomes communiquent par messages. Ce concept pose les jalons du calcul parallèle et distribué. En parallèle, le Jeu de la vie (Game of Life)  de John Conway prouve que des règles locales simples peuvent générer une dynamique collective complexe.

Les années 1980 ouvrent l’ère de l’intelligence artificielle distribuée appliquée. La recherche développe alors les systèmes à base de « Tableau Noir ». Le projet de reconnaissance vocale HEARSAY-II valide cette architecture en faisant collaborer plusieurs modules sur une mémoire partagée. Cette innovation démontre concrètement l’intérêt du travail d’équipe entre composants logiciels.

Entre 1990 et 2000, la technologie se structure et s’industrialise. Rao et Georgeff formalisent l’architecture BDI en 1991 pour modéliser le raisonnement. La fondation FIPA standardise ensuite les langages de communication en 1996, avant que le framework JADE ne devienne une référence des développeurs. Les entreprises s’emparent alors de ces outils pour automatiser le commerce en ligne et la logistique.

image illustrant les apports et avantages concurrentiels des Systèmes Multi-Agents

Apports et avantages concurrentiels des Systèmes Multi-Agents

La décentralisation améliore la résilience informatique. Les architectures classiques dépendent souvent d’un point de contrôle unique sujet aux pannes générales. Les modèles distribués réduisent ce risque critique. La défaillance d’un agent isolé n’interrompt pas le fonctionnement global du système.

Le système peut ainsi afficher des capacités d’auto-guérison. Lorsqu’un agent s’arrête, ses voisins détectent aussitôt son absence. Ils se répartissent de manière autonome ses tâches en cours de traitement. Les protocoles de négociation réajustent le réseau pour sécuriser les infrastructures critiques.

Ce modèle excelle également en matière de scalabilité et de flexibilité. L’ajout d’un nouvel agent ne nécessite aucune réécriture du code source global. La nouvelle entité se connecte à l’environnement, s’enregistre et communique aussitôt. Cette modularité permet d’ajuster la taille du système en temps réel.

Domaines d’application industriels et cas d’usage réels

Les réseaux électriques modernes intègrent des énergies renouvelables intermittentes, comme le solaire ou l’éolien. Les infrastructures classiques peinent à gérer cette instabilité. Pour y remédier, les réseaux intelligents (Smart Grids) peuvent déployer des architectures multi-agents. Chaque producteur et consommateur dispose ainsi de son propre agent logiciel autonome.

Ces programmes évaluent en temps réel la production locale et la demande prévisible. Ils négocient ensuite les prix de l’électricité sur des marchés de proximité. Si l’offre baisse, les agents réduisent automatiquement la consommation des équipements non prioritaires. Cette régulation fine protège les lignes des surcharges et prévient les pannes en cascade.

La robotique collaborative applique des principes proches dans les entrepôts du commerce électronique. Des flottes de robots mobiles s’y déplacent de manière autonome pour transporter les marchandises. Les machines négocient leur passage aux intersections sans dépendre d’un serveur central. Elles adaptent leur itinéraire face aux obstacles, ce qui fluidifie les commandes et réduit les collisions.

L’état de l’art : la révolution des Multi-Agent Systems à l’ère des LLM

L’intégration des modèles de langage transforme l’architecture des agents. Les concepteurs n’ont plus à programmer chaque règle logique à la main. Le LLM sert désormais de moteur de raisonnement principal pour l’entité. L’agent comprend les instructions naturelles et planifie ses actions.

Pour accomplir une mission complexe, l’agent suit une boucle continue. Il décompose l’objectif en sous-tâches et choisit les outils adaptés. L’entité analyse ensuite ses propres résultats à chaque étape intermédiaire. Si le rendu est insatisfaisant, il corrige sa stratégie de manière autonome.

Cette agilité permet de déployer ces technologies en entreprise. Les organisations automatisent ainsi des processus métiers de bout en bout. En ingénierie logicielle, des agents architectes, codeurs et testeurs collaborent en continu. Cette coopération autonome réduit les tâches manuelles et les coûts.

Frameworks modernes et outils d’orchestration actuels

Le marché du développement Python s’articule aujourd’hui autour de deux outils clés. Le framework open-source LangGraph modélise les interactions sous forme de graphes cycliques. Il offre un contrôle sur l’état à chaque étape de calcul. À l’inverse, CrewAI adopte une approche axée sur des rôles métiers.

Ce framework organise les agents comme les membres d’une équipe opérationnelle. Il attribue et gère leurs tâches de manière séquentielle ou parallèle. Au-delà de ces choix techniques, faire communiquer des systèmes différents reste un défi majeur. Le Model Context Protocol (MCP) apporte une réponse standardisée à ce problème.

Ce protocole ouvert définit la manière dont un agent expose ses outils et ses données. Il sert d’interface entre l’intelligence artificielle et les systèmes d’information. Des applications issues de plateformes hétérogènes peuvent enfin collaborer. Ce standard aide à briser les silos technologiques et à relier des écosystèmes variés.

Défis techniques et verrous de sécurité des Systèmes Multi-Agents

Le déploiement industriel de ces architectures fait face à de réelles contraintes économiques. Les agents basés sur des modèles de langage consomment beaucoup de jetons. Lors des phases de négociation, les requêtes se multiplient et font rapidement grimper la facture. Cette communication intense pèse lourdement sur les budgets des entreprises.

La latence est un autre obstacle majeur. Les débats et les vérifications croisées entre agents ralentissent la décision finale. Plusieurs minutes peuvent ainsi s’écouler avant de résoudre un problème complexe. Des outils d’observabilité sont donc indispensables pour surveiller le réseau et limiter les boucles de discussion infinies.

Enfin, la sécurité de ces systèmes connectés pose des défis inédits. Leurs échanges constants exposent la mémoire collective à des risques d’empoisonnement. Une injection indirecte de requêtes peut ainsi manipuler un agent à son insu. J’estime donc que des protocoles de validation stricts doivent encadrer chaque action critique pour empêcher le sabotage ou les fuites de données.

Paradigmes technologiques émergents : apprentissage MARL et Web3

L’apprentissage par renforcement multi-agents (MARL) transforme la recherche en informatique. Dans ce modèle, les agents apprennent à collaborer par essais et erreurs au sein de simulations. Ils reçoivent des récompenses mathématiques dès qu’ils atteignent un objectif collectif. Ce mécanisme d’auto-amélioration leur permet de co-évoluer avec une supervision humaine limitée.

Les agents développent ainsi des stratégies de coordination inédites. La finance utilise le MARL pour modéliser les marchés boursiers. Les villes l’appliquent aussi pour optimiser les flottes de véhicules autonomes. Cette autonomie croissante pousse parfois ces systèmes à s’associer aux technologies décentralisées du Web3.

La blockchain offre un cadre de confiance utile à ces réseaux de machines. Elle attribue aux agents une identité numérique vérifiable et infalsifiable. Des contrats intelligents sécurisent ensuite leurs paiements directs de machine à machine, sans intermédiaire bancaire. Cette infrastructure pose les bases d’une économie plus largement pilotée par des logiciels intelligents.

Cet article Comment les Systèmes Multi-Agents réinventent l’intelligence artificielle a été publié sur LEBIGDATA.FR.

  • ✇LEBIGDATA.FR
  • REVE 2.0 : l’outil IA qui va bousculer la création d’image
    REVE 2.0 marque une nouvelle étape dans l’univers des générateurs d’images par intelligence artificielle. Cette nouvelle version abandonne le prompt textuel au profit d’un système de mise en page visuelle. Elle promet alors un contrôle inédit sur chaque création que vous ferez. REVE 2.0 ne se contente pas d’améliorer la génération d’images par intelligence artificielle. L’outil change complètement la manière de concevoir un visuel avec l’élimination de longues descriptions textuelles pour dél

REVE 2.0 : l’outil IA qui va bousculer la création d’image

Par : Navalona R.
22 juin 2026 à 16:20

REVE 2.0 marque une nouvelle étape dans l’univers des générateurs d’images par intelligence artificielle. Cette nouvelle version abandonne le prompt textuel au profit d’un système de mise en page visuelle. Elle promet alors un contrôle inédit sur chaque création que vous ferez.

REVE 2.0 ne se contente pas d’améliorer la génération d’images par intelligence artificielle. L’outil change complètement la manière de concevoir un visuel avec l’élimination de longues descriptions textuelles pour délivrer un résultat satisfaisant. Ici, vous serez amené à organiser directement votre composition à l’aide d’une interface graphique. Un Large Layout Model interprète ensuite la structure pour produire un rendu en 4K native.

Le fonctionnement de l’outil réduit les erreurs de placement et offre un niveau de précision rarement atteint dans le domaine. Cette évolution ouvre la voie à une production plus rapide pour les graphistes, les agences et les créateurs de contenu.

Pourquoi le modèle REVE 2.0 transforme la génération visuelle ?

Depuis plusieurs années, les générateurs d’images nécessitaient la description d’une scène avec un prompt plus ou moins détaillé. L’IA devait ensuite interpréter les instructions qu’elle reçoit. Cette méthode fonctionne, mais elle montre aussi rapidement ses limites. Un mot mal choisi, une formulation ambiguë ou une description incomplète suffisent pour produire un mauvais résultat.

Avec REVE 2.0, l’outil ne vous demande plus de tout expliquer par écrit. Le logiciel vous offre la possibilité de construire directement la structure de chaque image que vous voulez. Les différents éléments sont directement représentés par des blocs positionnés sur un canevas. Avec la combinaison des coordonnées, le moteur comprend vite la relation entre tous les objets avant de générer le rendu final.

Cette approche offre plusieurs avantages majeurs, dont les suivants :

  • une composition beaucoup plus fidèle à l’idée initiale
  • un placement précis de chaque élément
  • une réduction des erreurs liées à l’interprétation des prompts
  • des modifications locales sans dégrader le reste de l’image

Ici, le Large Layout Model analyse la structure géométrique de la scène. L’outil peut alors placer chaque objet au bon endroit sans négliger le respect des proportions. REVE 2.0 peut même conserver une cohérence visuelle entre tous les éléments. Avec cette évolution, les graphistes passent moins de temps à reformuler les prompts.

Il est même plus facile de peaufiner chaque composition avec les ajustements que vous jugez essentiels pour vos images. Le déplacement d’un bloc suffit pour modifier la scène sans être obligé de régénérer une image complète. L’outil apporte un véritable contrôle créatif et conserve en même temps la puissance de génération de l’IA.

https://youtu.be/DRn9C8lc0dg

Comment utiliser REVE 2.0 pour vos créations graphiques ?

Cet outil ne ressemble pas aux plateformes IA qui exigent une maîtrise de l’art du prompt. REVE 2.0 est un outil facile à prendre en main qui mise sur une approche beaucoup plus visuelle. Avec ce modèle, vous allez réaliser une image complexe sans devoir rédiger des dizaines de lignes d’instructions.

Vous pouvez commencer par prendre des informations sur le site officiel de l’outil. Cela suffit pour découvrir les principales fonctionnalités de REVE 2.0 avant de passer en mode payant. Vous accédez à un espace de travail épuré une fois que vous serez connecté à votre compte.

La création débute par la mise en place d’une structure où chaque futur élément de l’image est représenté par un bloc. Vous pouvez les déplacer librement sur le canevas pour faciliter le repérage du moteur IA. Cette étape comprend la disposition générale de la scène avant même de commencer le rendu.

Vous avez un objet mal placé ou un personnage doit être déplacé ? Vous pouvez modifier le bloc sans toucher au reste de la composition. Cette logique réduit les itérations qui étaient autrefois nécessaires avec les prompts textuels. L’outil apporte alors une sensation de contrôle rarement rencontrée sur d’autres générateurs d’images.

Voici en résumé le processus de création d’image avec REVE 2.0 :

  • création d’un compte sur la plateforme ;
  • ouverture d’un nouveau projet ;
  • placement des différents blocs sur le canevas ;
  • ajustement de leur taille et de leur position ;
  • lancement de la génération de l’image ;
  • corrections locales si nécessaire avant l’export final.
Créez de belles-images avec REVE 2.0.

Quelles sont les fonctionnalités intégrées dans Reve 2.0 ?

Chaque fonction de l’outil est pensée pour davantage de précision et réduire les manipulations inutiles. Ainsi, l’ensemble du système repose avant tout sur un éditeur de mise en page qui permet de contrôler chaque élément indépendamment. Les objets sont positionnés avec une grande précision grâce à des coordonnées spatiales.

Parmi les fonctionnalités les plus intéressantes, on retrouve notamment :

  • un éditeur graphique basé sur des blocs géométriques
  • un contrôle précis des coordonnées de chaque objet
  • une génération native en 4K
  • la possibilité de modifier un seul élément sans régénérer toute l’image
  • une meilleure gestion du texte intégré dans les visuels
  • une conservation des détails adaptée aux impressions haute résolution

Avec le Large Layout Model, l’outil comprend facilement la hiérarchie spatiale de la scène. Les objets restent correctement positionnés, même quand plusieurs modifications sont effectuées successivement. Cette stabilité améliore sensiblement la qualité finale du rendu et l’effet produit par chaque image créée.

Par ailleurs, l’outil se distingue par sa capacité à préserver la netteté des petits détails. Les textures, les inscriptions ou encore les éléments graphiques conservent une excellente lisibilité. Cela est valable même si vous devez travailler sur des images de très grande taille. Cette caractéristique concerne particulièrement les professionnels de l’impression, de la publicité ou du design éditorial.

Toutefois, il va falloir vous adapter si vous êtes habitué à piloter une intelligence artificielle par le texte. La logique de composition demande un léger temps d’adaptation, notamment pour comprendre comment organiser efficacement les blocs avant la génération. Par ailleurs, les corrections deviennent plus rapides et les résultats sont plus cohérents une fois que vous serez habitué.

Le modèle Reve 2.0 gagne-t-il le match de la qualité 4K ?

La qualité d’image reste l’un des critères les plus importants lorsqu’il s’agit de comparer les générateurs d’images. Sur ce point, Reve 2.0 produit des rendus en 4K native pouvant atteindre seize mégapixels. Ce niveau de définition répond aussi bien aux besoins du web qu’à ceux de l’impression professionnelle.

À noter que cette montée en résolution ne se fait pas au détriment de la qualité globale. Les textures apparaissent plus détaillées et les contours gagnent en précision. Ajouter à cela, les effets de lumière conservent davantage de nuances, même sur les scènes les plus complexes. Cette qualité d’affichage explique en partie les excellents résultats obtenus par le modèle dans plusieurs classements consacrés aux intelligences artificielles génératives. 

Au-delà de la définition, c’est surtout la cohérence visuelle qui impressionne avec REVE 2.0. Les petits détails restent parfaitement lisibles et les objets gardent leurs proportions. De plus, les imperfections habituellement observées sur certains générateurs deviennent plus rares. Cette stabilité représente un véritable avantage pour les professionnels qui recherchent des images exploitables sans longues retouches.

Par ailleurs, les inscriptions sont plus propres, avec moins de caractères déformés ou illisibles. Il faut savoir que la montée en puissance de REVE 2.0 a un coût. La génération d’images aussi détaillées demande davantage de ressources de calcul. Ainsi, quelques secondes supplémentaires peuvent être nécessaires pour obtenir le rendu final. Cette durée dépend en principe de la complexité du projet ou de l’affluence sur les serveurs.

Dans la pratique, cette attente reste relativement modérée face au niveau de qualité obtenu. Pour des projets destinés à des campagnes marketing, le gain de précision compense largement ce léger temps de traitement supplémentaire. Reve 2.0 démontre ainsi qu’il est possible d’allier finesse, stabilité et contrôle créatif dans une seule et même plateforme.

REVE 2.0 présente des fonctionnalités intéressantes.

Les tarifs et les formules pour ce nouvel outil

L’outil adopte un modèle d’abonnement qui s’adapte aux différents profils d’utilisateurs. Une offre gratuite permet d’abord de découvrir l’interface et de tester les principales fonctionnalités. C’est un bon moyen de se familiariser avec la logique de mise en page. Cela vous donnera aussi le temps d’évaluer la qualité des rendus avant de passer à une formule payante.

Pour les besoins plus réguliers, le premier abonnement est proposé à partir de 8,4 dollars par mois. Il convient parfaitement aux créateurs qui réalisent quelques projets chaque semaine sans avoir besoin d’une importante capacité de calcul. En outre, la formule intermédiaire, affichée à 20,9 dollars mensuels, vise les utilisateurs plus actifs. Elle donne accès à davantage de ressources de génération, réduit les temps d’attente et offre une expérience plus fluide.

Sinon, ceux qui cherchent plus de performances peuvent choisir l’offre Premium de 49,9 dollars par mois. Cette formule met l’accent sur la performance, avec un accès prioritaire aux serveurs. Vous aurez aussi droit à des capacités de génération plus importantes pour répondre à des besoins professionnels.

Au-delà des abonnements classiques, Reve 2.0 propose également une API destinée aux développeurs et aux entreprises. Cette option permet d’intégrer directement le moteur de génération dans leurs propres applications. Il est alors possible d’automatiser certains processus de création et profiter des avantages du Large Layout Model.

Le coût de cette intégration dépend principalement de plusieurs critères, notamment la résolution choisie. Il faudrait aussi prendre en compte le nombre de générations effectuées ou les fonctionnalités avancées utilisées. Cette tarification à l’usage offre davantage de flexibilité aux entreprises qui souhaitent adapter leurs dépenses à leur activité réelle.

Cet article REVE 2.0 : l’outil IA qui va bousculer la création d’image a été publié sur LEBIGDATA.FR.

  • ✇LEBIGDATA.FR
  • L’architecture Subquadratic SubQ est-elle le chaînon manquant de l’ère post-Transformer ?
    L’informatique traverse une crise de croissance majeure face à l’explosion des volumes de données. Les infrastructures matérielles peinent désormais à suivre ce rythme soutenu de progression. L’approche Subquadratic SubQ émerge pour répondre à cette saturation technique. Elle redéfinit efficacement la gestion de la mémoire et des calculs massifs. Les géants du secteur cherchent aujourd’hui à dépasser les limites physiques des processeurs. Leurs architectures classiques butent inévitablement s

L’architecture Subquadratic SubQ est-elle le chaînon manquant de l’ère post-Transformer ?

Par : Roberto R.
18 juin 2026 à 20:16

L’informatique traverse une crise de croissance majeure face à l’explosion des volumes de données. Les infrastructures matérielles peinent désormais à suivre ce rythme soutenu de progression. L’approche Subquadratic SubQ émerge pour répondre à cette saturation technique. Elle redéfinit efficacement la gestion de la mémoire et des calculs massifs.

Les géants du secteur cherchent aujourd’hui à dépasser les limites physiques des processeurs. Leurs architectures classiques butent inévitablement sur un plafond de performance structurel. Une refonte mathématique devient indispensable pour garantir la progression du domaine. Les récentes publications scientifiques confirment l’urgence de cette transformation architecturale.

L’impasse algorithmique du coût quadratique dans la tech

La prolifération des données bouscule les infrastructures logicielles actuelles. Chaque jour, les entreprises traitent des milliards de lignes de code et de transactions. Les méthodes traditionnelles se heurtent désormais à un mur physique infranchissable. Ce blocage provient de la complexité quadratique O(n2), où le calcul croît au carré des données.

À l’échelle industrielle, l’impact de cette équation devient immédiat. Si le volume de données double, le temps de traitement quadruple. Une opération simple peut ainsi paralyser un serveur pendant plusieurs jours. Cette logique crée une dépendance intenable envers la puissance matérielle brute.

Face aux coûts énergétiques, attendre la nouvelle génération de puces ne suffit plus. Les centres de données saturent et les budgets cloud explosent rapidement. Les limites de la loi de Moore forcent à repenser l’optimisation. Une rupture purement algorithmique devient désormais la priorité absolue.

Qu’est-ce que l’approche Subquadratic SubQ en informatique générale ?

L’informatique privilégie des structures sobres pour sortir de l’impasse des calculs au carré. L‘approche Subquadratic SubQ désigne les algorithmes dont la complexité croît moins vite que O(n2). Les chercheurs s’appuient sur des notations rigoureuses comme O(n log ⁡n) ou O(n1.5). Ces modèles garantissent une croissance prévisible lors du traitement de volumes massifs.

Les ingénieurs déploient des stratégies spécifiques pour briser ce plafond technique. La méthode « Diviser pour régner » fragmente un problème complexe en plusieurs sous-unités indépendantes. En parallèle, l’usage de tables de hachage évite de parcourir l’intégralité du système. L’algorithme cible directement l’adresse mémoire nécessaire pour optimiser les calculs.

Un exemple classique illustre la supériorité de cette approche en production. Le tri à bulles traditionnel s’effondre rapidement face aux volumes massifs de données. À l’inverse, le tri fusion adopte une logique subquadratique pour réorganiser les éléments. Ce simple basculement réduit des traitements de plusieurs heures à quelques secondes.

une personne travaillant sur Hugging Face (basé sure l'architecture Transformer)

Le problème de l’attention dans les architectures Transformers

En 2017, l’article « Attention Is All You Need » a révolutionné l’IA avec l’architecture Transformer. Ce modèle alimente désormais la majorité des systèmes de langage modernes. Malgré son succès, il cache une faiblesse mathématique structurelle. Son mécanisme de Self-Attention évalue chaque mot par rapport à tous les autres.

Cette opération génère une matrice dense dont la taille équivaut au carré du nombre de mots (n×n). L’analyse des dépendances devient alors nativement quadratique. Cette exigence sature rapidement la mémoire vive (VRAM) dès que la séquence s’allonge. Les fenêtres de contexte des premières IA restaient donc sévèrement limitées par cette barrière physique.

Pour pallier ce défaut, les chercheurs ont longtemps testé des solutions peu efficaces. Le fenêtrage glissant forçait le modèle à oublier les données anciennes pour économiser des ressources. Parallèlement, les coûts d’inférence élevés ont freiné l’adoption généralisée de ces outils. Le développement d’une alternative économique est devenu un impératif pour l’avenir de cette technologie.

Le fonctionnement technique de l’innovation Subquadratic SubQ

L’architecture Subquadratic SubQ élimine la complexité quadratique de la matrice d’attention classique (n×n). Elle remplace le calcul exhaustif des scores par un mécanisme d’attention sous-quadratique linéaire. Un algorithme de filtrage dynamique sélectionne en amont les relations lexicales pertinentes. Ce système intelligent réduit drastiquement le volume de connexions à analyser.

Les ingénieurs appliquent cette méthode chirurgicale sur des modèles open-source existants. Ils substituent la couche d’attention dense d’origine par ce module sous-quadratique linéaire. Cette approche hybride préserve l’intelligence cognitive initiale tout en allégeant la structure. Les besoins en calcul chutent grâce à une réduction massive des opérations requises.

L’efficacité globale de ce système augmente avec la longueur des documents. Sur des volumes massifs, la vitesse d’exécution dépasse la référence FlashAttention-2. Cette optimisation transforme la contrainte de traitement en une courbe quasi linéaire. L’infrastructure matérielle gère ainsi des flux continus sans saturer la VRAM.

La genèse du projet commercial et la levée de fonds

L’origine de Subquadratic repose sur l’alliance de l’entrepreneur Justin Dangel, qui assure la direction générale, et d’Alexander Whedon, expert en systèmes. Désireux de transformer une intuition académique en un produit industriel rentable, ils ont structuré leur start-up autour d’une équipe de pointe. 

Pour cela, ils ont recruté des ingénieurs et chercheurs issus de prestigieux laboratoires comme Meta FAIR et Google Research. Partageant une frustration commune face au conservatisme des architectures actuelles, ce collectif s’est réuni pour innover et briser le monopole financier des fournisseurs d’IA traditionnels.

Établie au sein de l’écosystème dynamique de Miami, la start-up est officiellement sortie de l’ombre en mai 2026, après plusieurs mois de développement discret. L’entreprise a immédiatement captivé le secteur de la tech lors de sa révélation publique en sécurisant 29 millions de dollars lors d’une levée de fonds.

image illustrant un développeur en train de coder avec une IA

L’impact de la technologie Subquadratic SubQ sur les fenêtres de contexte

La technologie Subquadratic SubQ révolutionne les limites du traitement textuel. Elle propose une fenêtre de contexte native atteignant 12 millions de tokens. Cette extension spectaculaire de la mémoire s’accompagne d’un effondrement des coûts d’exploitation. Selon le benchmark RULER, un traitement massif coûte seulement huit dollars contre des milliers auparavant.

Ce bond en avant remet en question la pertinence de la recherche documentaire externe. Les entreprises utilisaient jusqu’ici la méthode du RAG pour compenser le manque de mémoire. Ce système découpait l’information en fragments sélectionnés au lieu de tout lire. Désormais, le besoin de segmenter s’efface au profit d’une analyse native et intégrale.

Cette capacité préserve la vision panoramique indispensable aux analyses complexes. Un cabinet juridique peut ainsi soumettre l’intégralité des archives d’un procès. De son côté, un ingénieur logiciel peut charger tout un répertoire de code source. Cette approche unifiée élimine les hallucinations fréquentes liées au manque de contexte.

Analyse critique des résultats du rapport technique de juin 2026

L’entreprise Subquadratic a publié les détails techniques de son modèle SubQ 1.1 Small les 16 et 17 juin 2026. Cette démarche assure la transparence nécessaire face aux spéculations de la communauté. L’organisme indépendant Appen a supervisé et validé l’ensemble des protocoles. Les résultats confirment un taux de récupération de 98% sur 12 millions de jetons.

Les chercheurs ont intégré leur formule d’attention à un modèle performant existant. Cette phase de post-entraînement a nécessité mille milliards de jetons de haute qualité. Le système exige désormais 64,5 fois moins de calculs pour une séquence d’un million de jetons. La vitesse brute est multipliée par 56 par rapport à la référence FlashAttention-2.

Cette optimisation de la mémoire préserve l’intelligence globale du modèle. Sur le benchmark AutomationBench Finance, la structure démontre des capacités d’analyse de haut niveau. Elle corrèle des rapports divergents tout en maintenant une logique interne rigoureuse. Ces métriques prouvent la viabilité économique du projet face aux architectures denses classiques.

Les limites opérationnelles actuelles du modèle Subquadratic SubQ

Malgré des chiffres flatteurs, le modèle Subquadratic SubQ fait face à d’importantes réserves techniques. L’infrastructure de la start-up demeure un écosystème entièrement fermé. Les poids numériques ne sont pas disponibles en téléchargement libre. Les développeurs extérieurs doivent s’inscrire sur une liste d’attente restrictive.

Cette absence d’ouverture empêche tout audit indépendant par des chercheurs tiers. De nombreux ingénieurs expriment leur scepticisme face à des résultats impossibles à répliquer. Par ailleurs, le mécanisme de routage dynamique introduit une complexité inédite. Un afflux massif d’utilisateurs pourrait créer des goulots d’étranglement imprévus.

Les capacités du modèle en logique pure et en abstraction restent à démontrer. Les architectures éparses sous-performent souvent les modèles denses sur des énoncés courts. La gestion de la concurrence multi-utilisateur sera le véritable test pour cette technologie. Tant que l’API ne sera pas ouverte, le projet restera une promesse théorique.

La confrontation technique entre modèles linéaires et architectures hybrides

Le marché des architectures alternatives aux Transformers classiques est en pleine effervescence. La solution Subquadratic fait face à la concurrence directe des modèles d’espace d’état, comme Mamba. Cette architecture rivale a prouvé son efficacité avec une complexité linéaire O(n). Je suis convaincu que cette rivalité intense va accélérer le rythme des découvertes scientifiques.

Les ingénieurs comparent minutieusement ces deux approches. Les modèles linéaires excellent dans le traitement séquentiel mais peuvent omettre des détails lointains. Les structures subquadratiques hybrides maintiennent, elles, un ciblage précis grâce à leur sélection dynamique. Le choix technique dépendra donc surtout de la nature des applications visées.

L’intégration aux standards industriels, comme Hugging Face ou vLLM, est un enjeu commercial crucial. Les nouvelles architectures doivent s’adapter à ces frameworks sans exiger de réécriture complète. L’efficacité énergétique dicte désormais l’agenda de la recherche mondiale. Cette transition vers des structures optimisées est devenue une nécessité pour l’industrie.

Cet article L’architecture Subquadratic SubQ est-elle le chaînon manquant de l’ère post-Transformer ? a été publié sur LEBIGDATA.FR.

❌
❌