❌

Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hierinformatique général
  • ✇LinuxFr.org : les dépêches
  • Migrer de WordPress vers Hugo
    Passer du système de gestion de contenu WordPress au générateur de sites statiques Hugo c’est changer de paradigme, il faut savoir ce que l’on va gagner et ce que l’on va perdre et il faut retrousser ses manches, un jour viendra où cela se fera en un clic, mais ce n’est pas aujourd’hui ! lien nᵒ 1 : l'original (ou le clone ?) de ce billetSommaire Avant même de se poser la question comment, on peut se poser la question : pourquoi ? Mais pourquoi Hugo et pas une autre solution, par exemple Jekyl

Migrer de WordPress vers Hugo

Passer du système de gestion de contenu WordPress au générateur de sites statiques Hugo c’est changer de paradigme, il faut savoir ce que l’on va gagner et ce que l’on va perdre et il faut retrousser ses manches, un jour viendra où cela se fera en un clic, mais ce n’est pas aujourd’hui !

Sommaire

Avant même de se poser la question comment, on peut se poser la question : pourquoi ?

Avec WordPress chaque page repose sur du PHP, un programme est exécuté qui peut faire de nombreuses actions, il y a une base de données. WordPress est un des classiques LAMP (Linux, Apache, MySql, PHP) et consorts, il nécessite l’installation de multiples composants. Quand le contenu à délivrer doit s’adapter au contexte utilisateur et à d’autres facteurs, c’est approprié, pour un site de commerce ça l’est, s’il s’agit d’une vitrine statique, ça ne l’est pas. Entre les deux on trouve le blog, qui peut se balancer d’un côté ou de l’autre si l’on souhaite gérer des accès utilisateurs, suivre les pages ou ajouter des interactions.

Avec Hugo, le site est généré une seule fois puis les pages sont délivrées, à l’ancienne dirait-on. À la grande époque où l’on éditait le HTML à la main et on publiait son site via FTP. Sauf qu’avec Hugo on manipule du Markdown plutôt que du HTML. Le Markdown est pratique, c’est l’héritage pragmatique d’Aaron Schwartz dont on peut encore trouver la trace dans le code PHP de génération. Le Markdown lui-même porte une étincelle de liberté, il est désormais normalisé dans la RFC 7763. Et on utilise le programme Hugo qui est un binaire fourni, ou bien compilé depuis du code Go, pour générer des pages HTML. Le site généré peut être délivré en http par Hugo ou bien par n’importe quel serveur web. Hugo repose aussi sur des en-têtes front-matter dans les fichiers Markdown qui est une extension plus récente.

Sortir de WordPress c’est sortir d’une zone de confort et ce sera nécessairement perdre des fonctionnalités, comme l’édition en ligne directe intégrée par exemple, le suivi de vues et les formulaires.

C’est aussi faire un choix simplificateur, économe et efficace. Beaucoup moins énergivore il est aussi beaucoup plus efficace et rapide. Il est aussi beaucoup plus facile à déployer qu’un WordPress puisqu’en définitive ce n’est qu’un binaire et un thème.
Une autre bonne raison de migrer est la sécurité, comme a pu le faire le projet Xubuntu à la fin de l’année dernière suite à la compromission de leur site de téléchargement sous WordPress

Mais pourquoi Hugo et pas une autre solution, par exemple Jekyll ?

Hugo est la version la plus efficace, écrit en Go et compilé, les performances se rapprochent sans les égaler de celles de Rust ou de C. Et il est maintenu, dispose d’une communauté qui maintient des thèmes permettant de facilement avoir un rendu à la mode. Jekyll est en Ruby qui n’est pas le plus performant des langages mais est très versatile. Jekyll est apparu avant Hugo ce qui explique sa notoriété.

Ces deux logiciels ont popularisé la génération de sites statiques, mais ce ne sont pas les seuls, eleventry par exemple a déjà été couvert par un journal sur LinuxFr.org.

Ma vie, mon œuvre

Dans mon cas je ne me suis pas posé la question puisque je réponds à une demande d’une personne qui a déjà fait son choix, il faut migrer !

Avant de me lancer dans l’aventure j’ai dû me renseigner, parce que j’opère bien un site statique qui me sert de vitrine et celui-ci est en Markdown sous Git, mais tout est fait à la main et je ne connais pas Hugo. Je ne suis pas non plus un grand utilisateur de WordPress, que j’ai toujours trouvé lourd, et d’ailleurs j’ai toujours eu un faible pour les challengers, et je m’étais penché sur Joomla qui a les mêmes défauts. Utiliser ces CMS c’est déjà avoir appris une façon de penser, avec les pages et les posts, cela ne m’a jamais paru intuitif.

Donc j’étais absolument et résolument prêt pour cette migration !

Vous pouvez à ce moment me demander pourquoi donc l’ai-je fait ?

Parce qu’un ami me l’a demandé, parce qu’il rémunère pour cela et parce que je trouve que cela va dans le bon sens. Celui de l’éco-responsabilité, une sobriété qui ne transige pas avec la qualité et un mouvement vers plus d’indépendance.

Donc je me renseigne.

WordPress via le navigateur, Hugo via le terminal

Si vous ne souhaitez pas utiliser de terminal et des scripts shells, alors je serais d’avis de vous déconseiller fortement de vous lancer dans l’aventure Hugo.
Parce qu’Hugo c’est du Web as code, très exactement l’inverse du WYSIWYG le PETALE Pris à l’écrit tel à l’écran. Tout se fait en Markdown dans votre éditeur favori.
Cela s’opère souvent via Git et le fait de pousser le commit git vers le serveur régénère le contenu du site.
S’il est possible de le faire via un VSCodium, je reste sur mon Emacs favori, mais évidemment ceci un choix très personnel.
Un bon éditeur de texte capable de te laisser saisir des codes Markdown est absolument nécessaire, un éditeur de texte dans ce cas ce n’est pas un traitement de texte, Libreoffice par exemple ne m’apparait pas comme l’outil adapté, mais je vous laisse juge.

On installe le plugin, clic ! On importe le résultat et c’est fini !

C’est assez évident en fait il suffit de suivre ce que propose le projet Hugo en matière de migration vers Hugo.

Ça c’est ce que l’on souhaite et j’y ai presque cru.

Il n’y a pas de plugin WordPress officiel pour exporter vers Hugo, mais il y en a pour exporter en Jekyll. Sachant que Hugo sait importer du Jekyll, cela semble évident.

Tout d’abord il faut importer le plugin sous WordPress.
Si cela semble évident quand le plugin est disponible dans le magasin des plugins WordPress, cela ne l’est plus quand il faut l’installer à la main.

Dans mon cas, et peut être dans le vôtre aussi vous n’avez pas installé le WordPress, il vous a été fourni en tant que service hébergé, et c’est pourquoi vous êtes limités aux plugins officiels, quand encore, on vous y autorise.

Donc en suivant le lien de migration depuis WordPress je lis (en anglais, mais je vous offre gratuitement la traduction) :

wordpress-to-hugo-exporter

Un plugin en un clic qui convertit tous les posts, pages, taxonomies, metadata, et settings en Markdown et YAML et déposable dans Hugo. (Note: Si vous avez des difficultés avec ce plugin, vous pouvez exporter le site pour Jekyll et utiliser le convertisseur intégré à Hugo listé ci-dessus)

Oui mais non, je n’ai pas accès au backend.

Et pourquoi ne pas juste installer un plugin officiel comme celui dont wordpress-to-hugo-exporter dérive ? Le jekyll-exporter

Ce n’est pas un échec, mais ça n’a pas marché.

Après l’installation du plugin et l’utilisation de l’export le site me réponds avec aplomb : 500 Internal ERROR.

Plutôt que d’abandonner, je cherche sur le projet source s’il y a un bug en cours et effectivement : Issue #400 sur wordpress-static-site-exporter. Sur ce, je rajoute mes informations sur le bug et j’attends une réponse.

Donc le ça fonctionne en un clic n’aura pas tenu bien longtemps, en attendant un correctif je me penche sur une alternative. Mais ne vous inquiétez pas, nous y reviendrons, si vous avez suivi le lien de l’issue vous le savez déjà !

Exportez votre site WordPress et appliquez un outil magique !

Ce n’est pas bien grave, il y a d’autres outils…

blog2md
Fonctionne sur l’XML exporté depuis le site gratuit votre VOTRE-DOMAIN.wordpress.com. Cela sauve aussi les commentaires approuvés sous forme YOUR-POST-NAME-comments.md à côté des posts.

Ce projet n’a pas évolué depuis quatre ans, je ne vais pas choisir cette option.

wordhugopress
Un petit utilitaire écrit en Java qui exporte le site WordPress depuis la base de donnée et les resources (c’est-à-dire par exemple les images) stockées localement ou à distance. Ainsi la migration depuis des backups est possible. Support de multiples sites vers un seul site Hugo.

Je n’ai pas accès à la base de données où à l’export des backups, je ne vais pas choisir cette option non plus.

wp2hugo

Celui-ci est un très bon candidat, sauf que je vends mon travail et la licence de cet outil est Attribution-NonCommercial-ShareAlike 4.0 International, donc je ne vais pas choisir cette option. Si mon budget avait été très important j’aurais envisagé de contacter l’auteur pour négocier, mais ce n’est pas le cas.

Donc aucun de ces autres outils ne répond à mes besoins.

La vérité est ailleurs ?

Oui, mais il n’y a pas que site Hugo de référence non plus.

Les forums et en particulier https://discourse.gohugo.io/t/wordpress-migration-url-rewriting/3827, mais il a été écrit il y a presque dix ans…
Et dans mes pérégrinations hors des sentiers battus des scripts Python émergent https://www.infinitescript.com/2024/01/migrate-from-wordpress-to-hugo/.
Ce guide aussi m’a inspiré https://fr.benchwiseunderflow.in/blog/guide-complet-migration-wordpress-hugo/ ceci dit fournir les scripts Python dans son blog sans l’indentation, ce n’est pas ce qui se fait de mieux.

Voici la liste des projets que j’ai regardés, je n’en ai testé qu’une sous partie entre ceux utilisant de l’IA ou pour lesquelles mon utilisation ne respecterait pas la licence et celles dont le contenu semble trop vieux…

Site Commentaire langage html -> markdown license testé
https://github.com/benbalter/wordpress-to-jekyll-exporter plugin officiel nécessite une migration supplémentaire jekyll -> hugo php wordpress plugin Markdownify GPL-3.0 ✅
https://github.com/SchumacherFM/wordpress-to-hugo-exporter basée sur une version du projet ci-dessus mais datant de 2014, a dérivé depuis. Ce n’est hélas pas un plugin officiel php wordpress plugin Markdownify GPL-3.0-or-later ✅
https://github.com/lonekorean/wordpress-export-to-markdown travailler sur l’export en XML it won’t migrate GUID correctly nodeJs javascript turndown - ✅
https://github.com/bradfeld/wp-to-hugo plus complet mais : IA generated Claude / typescript via API strip WordPress block comments nodeJs typescript turndown MIT License (& IA ?) Non : IA
https://github.com/ashishb/wp2hugo attachment page post wp_navigation wp comments footnote go [[site_scrapping_vers_Hugo#johanneskaufmann_html_to_markdown]] Attribution-NonCommercial-ShareAlike 4.0 Non, licence non commerciale et c’est un travail commercialisé
https://github.com/helgeklein/WordPress-Hugo-Migration-Scripts-HTML-Markdown/ https://helgeklein.com/blog/scripted-wordpress-html-to-hugo-markdown-migration/ post_type in (“post”, “page”)… donc pas de gestion des blocks python BeautifulSoup MIT
https://github.com/some-programs/exitwp https://web.archive.org/web/20221120194327/https://www.justindunham.net/migrating-from-wordpress-to-hugo/ 2019 ? page et post + item_type_filter python beautifulsoup html2text ~ GNU GPL 3
https://github.com/dreikanter/wp2md issues https://github.com/dreikanter/wp2md/issues python html2text
https://fr.benchwiseunderflow.in/blog/guide-complet-migration-wordpress-hugo/ status “publish” post_type “post”, “page” le code fourni est à copier coller et non fonctionnel python pandoc
https://www.infinitescript.com/2024/01/migrate-from-wordpress-to-hugo/ post de blog contenant le code python utilisé python re (regular expression python)
https://github.com/palaniraja/blog2md Le projet a 4 ans et part de blogger et non de WordPress javascript ? absence de licence non testé

C’est wordpress-export-to-markdown qui a remporté une partie du travail. Cela a nécessité l’installation de node puisque le code est en javascript.

J’exporte donc le site via la fonction standard d’export de site WordPpress qui fourni un fichier XML.

Cet export contient tout sauf les images et les autres ressources, donc il faudra que l’outil puisse les rechercher, et donc que le site WordPress soit toujours activé. Ceci ne peut donc pas se faire sur un site indisponible ou bien même déjà arrêté.

On installe Hugo

Et il faut un serveur, une vraie machine avec une adresse IP publique, un serveur web.
Là où pour du WordPress un hébergeur fournit la solution, en Hugo le plus classique est tout de même de mettre en place son propre serveur. Avec tout ce qui va bien, et le certificat pour HTTPS.

Mais avant de faire le pas, cela s'installe en local sur une machine de développement avec docker, podman, inclus ou bien même directement puisque ce n’est qu’un exécutable.

sur une machine Linux :

sudo apt install hugo

ou

snap install hugo

Il suffit de lancer hugo server dans le répertoire du projet hugo et se connecter sur localhost avec l’URL qui a été fournie dans le terminal.

Dans le cas d’une migration vous aurez forcément à modifier de nombreuses pages de votre site qui comportent des problèmes de code markdown mal converti depuis le HTML.

Et il vous faudra utiliser des scripts, dans votre langage préféré, mais dans tous les cas l’utilisation d’expressions régulières sera nécessaire. C’est-à-dire : il faut connaître un minimum de programmation.

Voici le genre de commande qui recherche tous les fichiers avec l’extension.md et supprime le 'Proudly powered by WordPress' dedans :

text='Proudly powered by <a href="https://wordpress.org" rel="nofollow">WordPress</a>'
find content -name '*.md' -print0 | xargs -0 sed -i 's|'"$text"'||g'

Attention cette commande fonctionne, car le texte $text est compatible avec la syntaxe de commande sed en particulier utiliser un '|' dans la variable text serait problématique.

En suivant la procédure d’installation rapide https://gohugo.io/getting-started/quick-start/ on va créer un dépôt git. Si par la suite on souhaite le répliquer pour le tester ailleurs alors il ne faudra pas oublier les submodules pour le thème, sinon la génération du site rendra un site vide.

git clone user@server:quickstart --recurse-submodules mon_site
cd mon_site
hugo server

On termine avec un firefox http://localhost:1313 par exemple pour voir en local.

on pourra alors éditer le contenu sous content avec notre éditeur préféré et créer un commit git quand nous sommes contents de notre résultat local.

git add content
git commit -m 'édition numero xx du site'
git push

Cela doit pousser sur le git parent le contenu. Si le git parent est attaché à la production alors la production est mise à jour ainsi.

C’est pas beau hein ?

Le contenu généré par l’outil de migration ayant été copié dans le répertoire content du projet Hugo, il suffit de lancer le serveur Hugo pour qu’il soit délivré sur le port indiqué en console. En se connectant avec un navigateur firefox https://localhost:1313, le contenu apparait…

Ah j’oubliais, en Hugo toute la présentation est contrôlée par le thème, ici le thème choisi est ananke, c’est celui proposé dans la documentation de démarrage rapide de Hugo

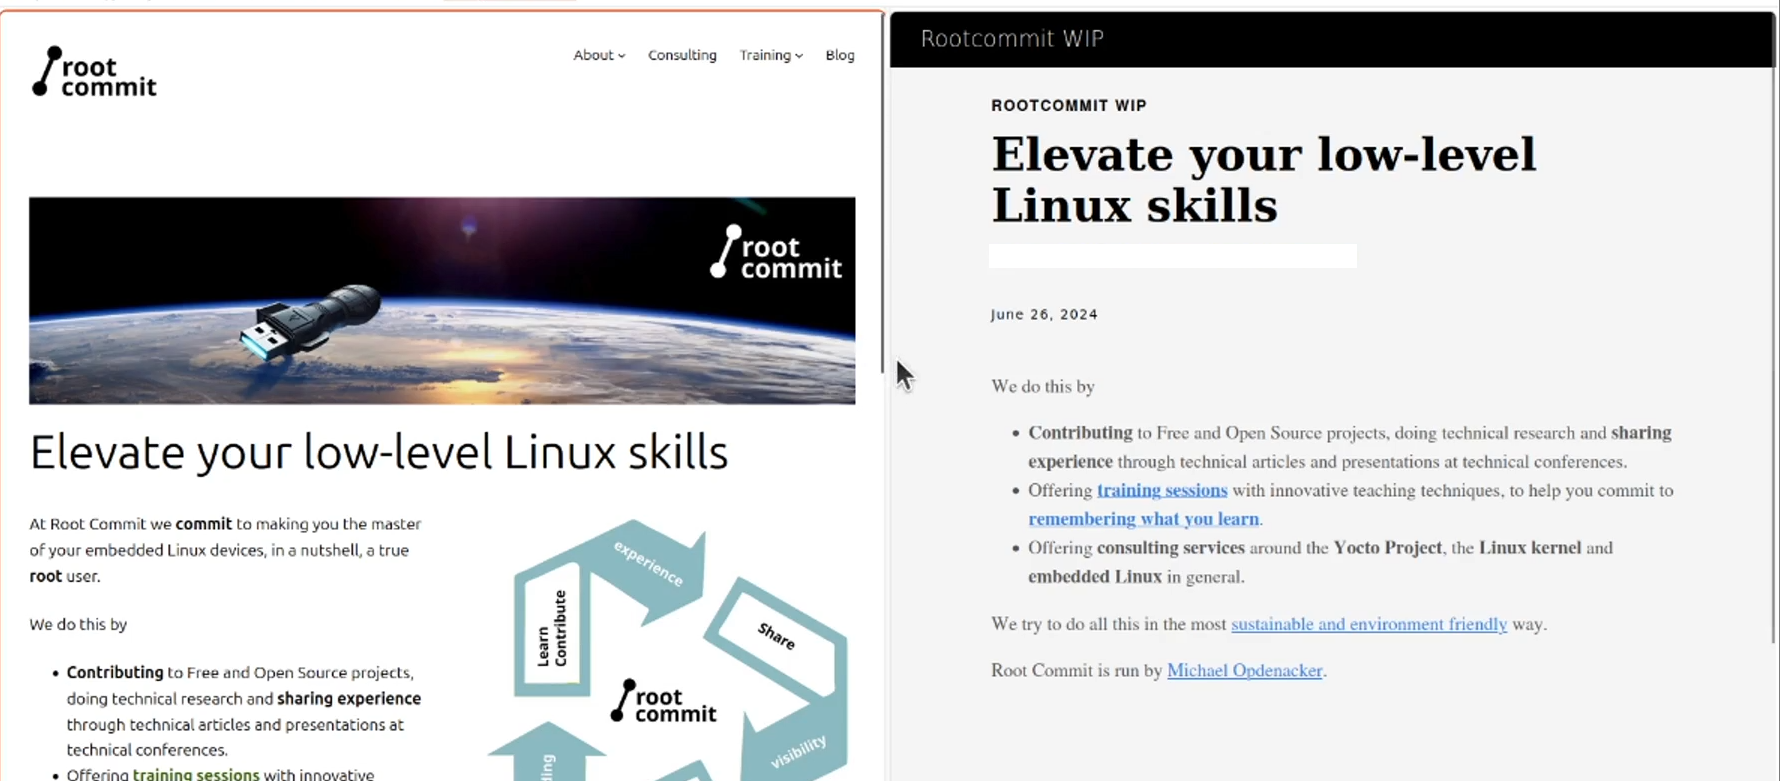
Il y a du contenu, certes mais quand même il y a eu des dégâts collatéraux.

Cliquez sur l’image pour voir la vidéo.

vue comparée du site avant et pendant migration

Les blocs réutilisables de WordPress

Il s’agit d’une fonctionnalité ajoutée dans l’éditeur de WordPress Gutemberg, la possibilité de créer des blocs réutilisables qui seront référencés dans d’autres pages ou bien même dans d’autres blocs

Pratiquement tous les outils d’export ne conservent pas les items qui ne sont ni de type page ni de type post et quand ils conservent les autres type, ils ne gèrent pas les blocs réutilisables.

Dans le fichier d’export.xml de WordPress on les retrouve ainsi :

<item>
…
<wp:post_id>610</wp:post_id>
…
</item>

et sont utilisés par référence :

<!-- wp:block {"ref":610} /-->

Dans mon cas pour l’outil wordpress-export-to-markdown, j’ai créé une demande de fonctionnalité pour le support des blocs réutilisables.

En pratique les outils perdent complètement le contenu de ces blocs.

Une façon de résoudre le problème est d’utiliser la source HTML générée par WordPress directement et de la convertir en Markdown.

Les <figure>

Hugo ne gère pas le tag <figure>, il faut supprimer ces tags, sinon les images qu’ils contiennent n’apparaissent juste pas. Or WordPress génère souvent des blocks HTML avec des tags figure.

Voici un script bash qui supprime le tag figure partout dans tous les fichiers.md de content.

find_files=(find content -name '*.md' -print0)
command2=(xargs -0 sed -i 's|</\?figure[^>]*[>]||g;')
"${find_files[@]}" | "${command2[@]}"

URL permanentes

Il est crucial que les pages migrées se retrouvent au même endroit après migration. C’est crucial car cela fait partie du SEO, votre référencement, si vos pages changent de place, les moteurs de recherche vont vous perdre, tout comme les références depuis tout autre site.

En Hugo c’est le champ urldans l’entête front-matter du fichier markdown qui sert à indiquer où la page destinée à être délivrée.
Cette URL peut être totalement différente du répertoire dans lequel le fichier se trouve, même s’il est conseillé de conserver la mẽme hiérarchie, c’est une solution pratique.

URL relatives

WordPress délivre toutes ses pages avec des URL absolues dans le corps c’est-à-dire avec le nom du site intégré dans l’URL, ceci est un souci quand on souhaite déplacer le site, ou bien avec un site réplica lui aussi accessible en ligne mais sous une autre URL.

Les expressions régulières sont là pour ça, il faut supprimer http://monsite du début des toutes les URL. Pour rappel, à l’intérieur d’une page HTML un lien href='/article/linuxfr.html' est une référence relative dans le site courant, si l’URL du site est https://example.com alors le lien avec l’URL absolue est au lien `href='https://example.com/article/linuxfr.html'.

Si vous ne faites pas vous pourriez avoir la surprise lors de l’arrêt du site WordPress de ne plus avoir les images et autres ressources, car elles étaient sur le site original et non sur le nouveau site migré !

voici un exemple en bash

find_files=(find content -name '*.md' -print0)
command2=(xargs -0 sed -i "s|https://${site_domain}||g")
"${find_files[@]}" | "${command2[@]}"

Le menu

Le menu a été perdu, c’est ballot !
Via l’export Hugo il n’y a pas de menu du tout, il est perdu.
Dans WordPress le menu est supporté par du CSS les classes wp-block-navigation…
En Hugo c’est le thème qui le gère, ici avec ananke il faut rajouter des entrées de menu avec menu.main, dans mon cas j’ai rajouté le menu globalement dans le fichier de configuration Hugo, mais il y a plusieurs façons de définir les menus en Hugo.

Un site WordPress c’est un site web comme un autre

Une autre approche est de considérer qu’un site WordPress c’est un site web comme un autre.
Un navigateur n’a pas de code particulier pour visualiser un site WordPress, donc un site WordPress est juste un site web, certes avec beaucoup de JavaScript et CSS, mais un site web.
Et un site web, ça se siphonne, et c’est facile, il suffit de regarder le projet internet archive, par exemple le site de LinuxFr.org le 2 avril 2018 pour s’en convaincre, il est très facile de récupérer le contenu visible d’un site web, à condition de connaître tous les points d’entrée et en pratique il suffit de partir de la page principale.
Puisque vous migrez un site que vous possédez, il n’y a pas de souci à utiliser un aspirateur de site.

Une fois le site récupéré, il y a des convertisseurs Markdown.

En particulier j’ai employé le convertisseur de HTML vers Markdown de Johannes Kaufmann, qui est aussi une base pour d’autres projets de conversion pour des applications particulières dont WordPress.

Et le tour est joué ! Ou presque…

On repart de zéro et on mélange tout

Si aucune des solutions ne fonctionne, chacune permet de créer une partie du site. En utilisant toutes les générations on peut récupérer les meilleurs pages.

Dans mon cas le plugin officiel de migration de jekyll vers hugo a été corrigé et j’ai donc pu l’utiliser.

En utilisant aussi des parties générées depuis le site statique, j’ai obtenu un résultat acceptable, mais cela ne s’est pas fait sans une série de petits scripts en bash à base de find et de sed et donc d’expression régulières, les fameuses regex.

Variations mais pas sur le même thème

Une fois le contenu cohérent, il est temps de tester d’autres thèmes Hugo pour donner au site une apparence différente.
Ces thèmes aussi peuvent être personnalisés. La notion de thème existe déjà dans WordPress, donc vous ne devez pas être surpris, mais les thèmes de WordPress ne peuvent pas être transposés tels quels dans Hugo, par exemple le thème twentytwo désormais classique ne se résout pas en la copie de son continu sur Hugo.
Mais passer à Hugo c’est aussi l’opportunité de se démarquer.

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇Korben
  • Comment j'ai viré Algolia et recréé le Google de 1998 sur mon site
    Bon, faut qu'on parle un peu du moteur de recherche de mon site. Ceux qui l'ont déjà utilisé savent de quoi je parle : c'était pas terrible. Enfin, « pas terrible » j'suis gentil. C'est un espèce d'overlay avec des résultats certes fiables mais c'était vraiment pas pratique. Et en plus de ça, comme j'ai un site statique généré avec Hugo, je passais par Algolia pour la recherche. Si vous ne connaissez pas, Algolia c'est un service cloud qui indexe votre contenu et vous fournit une API de recherch

Comment j'ai viré Algolia et recréé le Google de 1998 sur mon site

Par : Korben
31 décembre 2025 à 12:00

Bon, faut qu'on parle un peu du moteur de recherche de mon site. Ceux qui l'ont déjà utilisé savent de quoi je parle : c'était pas terrible. Enfin, « pas terrible » j'suis gentil. C'est un espèce d'overlay avec des résultats certes fiables mais c'était vraiment pas pratique.

Et en plus de ça, comme j'ai un site statique généré avec Hugo, je passais par Algolia pour la recherche. Si vous ne connaissez pas, Algolia c'est un service cloud qui indexe votre contenu et vous fournit une API de recherche ultra-rapide. Sur le papier c'est génial et dans la pratique aussi d'ailleurs sauf que voilà, ça coûte des sous. Et mon site rencontre un franc succès ces derniers temps (merci à vous !), donc j'ai de plus en plus de visiteurs, donc de plus en plus de recherches, donc une facture Algolia qui grimpe gentiment chaque mois.

Du coup je me suis dit : « Et si je trouvais une solution de recherche pour sites statiques ? » Parce que oui, ça existe et c'est comme ça que j'ai découvert Pagefind.

Pagefind c'est donc un moteur de recherche statique open source développé par CloudCannon qui fonctionne comme ceci : Au moment du build de votre site, Pagefind parcourt tout votre HTML généré et crée un index de recherche qu'on peut interroger avec un peu de JS. Y'a donc plus d'API, et tout se fait localement sur le navigateur des internautes.

Bref, ça avait l'air très cool alors évidemment, je me suis lancé dans l'aventure et comme j'aime bien me compliquer la vie, j'ai décidé de pas juste intégrer Pagefind tel quel. Non non. J'ai voulu recréer l'interface du Google de 1998 parce que à quoi bon avoir son propre site web si on peut pas s'amuser un peu ^^.

Laissez-moi donc vous raconter cette aventure.

Le problème avec Algolia

Leur service est excellent, je dis pas le contraire, la recherche est rapide, les résultats sont pertinents, l'API est bien foutue mais voilà, y'a le modèle de pricing puisque Algolia facture au nombre de requêtes de recherche.

Plus les gens cherchent sur votre site, plus vous payez et quand vous avez un site qui fait plusieurs millions de pages vues par mois, bah... ça chiffre vite. En gros je dépasse très vite les 10 000 recherches offertes chaque semaine et ensuite ça chiffre. C'est pas la mort, mais c'est un coût récurrent débile pour un truc qui pourrait être gratuit.

En plus de ça, y'a la dépendance à un service externe. Si Algolia tombe, ma recherche tombe. Et si Algolia change ses prix, je vais devoir subir. Même chose si Algolia décide de modifier son API... il faudra que j'adapte mon code. Bref, c'est le cloud dans toute sa splendeur... C'est pratique mais on n'est jamais vraiment chez nous.

Pagefind à la rescousse

Pagefind résout donc tous ces problèmes d'un coup. C'est un outil en ligne de commande qui s'exécute après votre générateur de site statique (Hugo dans mon cas, mais ça marche avec Jekyll, Eleventy, Astro, ou n'importe quoi d'autre).

Concrètement, vous lancez :

npx pagefind --site public

Et Pagefind va :

    1. Scanner tous vos fichiers HTML dans le dossier public/
    1. Extraire le contenu textuel (en ignorant la nav, le footer, les pubs si vous lui dites)
    1. Créer un index de recherche optimisé
    1. Générer des fichiers JavaScript pour interroger cet index côté client

Et le résultat c'est un dossier pagefind/ qui contient tout ce qu'il faut. Ensuite; à vous de servir ces fichiers statiquement avec le reste de votre site, et la magie pourra opérer !

L'index pour mes 18 000 articles fait environ 1,5 Go. Ça peut paraître beaucoup, mais Pagefind est malin car il découpe l'index en fragments et ne charge que ce qui est nécessaire pour la recherche en cours. Du coup en pratique, une recherche typique télécharge quelques centaines de Ko, et pas plus.

L'intégration technique

Pour intégrer Pagefind dans mon workflow Hugo, j'ai donc été cherché le binaire, je l'ai mis sur mon serveur et je l'ai appelé dans un cron comme ça, je rafraichi l'index de recherche 1 fois par jour (et pas à chaque génération du site).

0 4 * * * /home/manu/pagefind/pagefind --site /home/manu/public_html --output-path /home/manu/public_html/pagefind >> /var/log/pagefind.log 2>&1

J'ai aussi créé un fichier de configuration pagefind.yml pour affiner le comportement :

root_selector: "[data-pagefind-body]"
exclude_selectors:
 - "header"
 - ".site-header"
 - "footer"
 - ".sidebar"

L'astuce ici c'est d'indexer uniquement les div ayant la class data-pagefind-body='true' et d'exclure les éléments qui ne font pas partie du contenu éditorial afin de ne pas indexer ce qui se trouve dans le header, les natives, le footer...etc.

Côté JavaScript, Pagefind utilise les imports ES6 dynamiques. Ça veut dire que le moteur de recherche n'est chargé que quand l'utilisateur lance effectivement une recherche :

async function initPagefind() {
pagefind = await import('/pagefind/pagefind.js');
await pagefind.init();
}

Et pour faire une recherche :

const search = await pagefind.search("linux");
// search.results contient les IDs des résultats
// On charge le contenu de chaque résultat à la demande
for (const result of search.results) {
 const data = await result.data();
 console.log(data.url, data.meta.title, data.excerpt);
}

C'est bien fichu parce que search.results retourne immédiatement les références des résultats, mais le contenu réel (titre, extrait, URL) n'est chargé que quand vous appelez result.data(). Du coup vous pouvez implémenter une pagination propre sans télécharger les données de milliers de résultats d'un coup.

Le délire rétro - Recréer Google 1998

Maintenant que j'avais un moteur de recherche fonctionnel, fallait l'habiller. Et c'est là que j'ai eu cette idée un peu débile : Pourquoi pas recréer l'interface du Google de 1998 ?

Pour les plus jeunes qui lisent ça, Google en 1998 c'était une page blanche avec un logo, un champ de recherche, et deux boutons : « Google Search » et « I'm Feeling Lucky« . Pas de suggestions, pas de carrousels, pas de pubs... Juste un champs de recherche. C'était la belle époque !

J'ai donc créé une page de recherche avec deux vues distinctes. La page d'accueil avec le logo centré et le champ de recherche au milieu, exactement comme le Google originel.

Et la page de résultats avec le logo en petit en haut à gauche et les résultats en dessous.

Pour le code CSS, j'ai voulu être fidèle à l'époque. Times New Roman comme police par défaut, les liens en bleu souligné qui deviennent violet une fois visités. Et surtout, les boutons avec l'effet 3D des interfaces Windows 95 :

.search-button:active { border-style: inset; }

Ce border: outset et border-style: inset au clic, c'est exactement ce qui donnait cet effet de bouton en relief qu'on avait partout dans les années 90. Pour moi, ça fait toute la différence pour l'authenticité. Même le logo, je l'ai volontairement « dégradé » pour qu'il soit de la même qualité que le logo Google d'origine.

La pagination « Koooooorben »

Vous vous souvenez de la pagination de Google avec « Goooooogle » en bas de page ? Le nombre de « o » correspondait au nombre de pages de résultats. J'ai fait pareil, mais avec « Koooooorben ».

let logo = 'K'; for (let i = 0; i < oCount; i++)
{
logo += o;
} logo += 'rben'; }

Plus il y a de résultats, plus il y a de « o ». C'est complètement inutile mais ça me fait marrer à chaque fois que je le vois.

Le bouton « J'ai de la chance »

Ah, le fameux « I'm Feeling Lucky » de Google, j'ai voulu l'implémenter comme à l'époque ! Si vous tapez une recherche et cliquez sur « J'ai de la chance », vous êtes envoyé sur le premier résultat. Classique. Mais si vous cliquez sur le bouton avec le champ vide sur la home de la recherche, vous êtes envoyé sur un article aléatoire parmi les +18 000 du site.

Pour ça, j'ai utilisé une astuce : le sitemap. Mon Hugo génère un fichier sitemap.xml qui contient toutes les URLs du site et je peux aller piocher dedans en JS :

const articles = [...xml.querySelectorAll('loc')] .map(loc => loc.textContent) .filter(url => {
// Exclure les pages qui ne sont pas des articles
const path = new URL(url).pathname;
return !path.startsWith('/categories/') && !path.startsWith('/page/') && path !== '/';
});
const randomUrl = articles[Math.floor(Math.random() * articles.length)];
window.location.href = randomUrl;
} }

Un seul fetch, un peu de parsing XML natif, et hop c'est le grand retour de la fonctionnalité « article aléatoire » qui vous manquait, je le sais !

Tri et nombre de résultats

Je vous ai aussi mis une listbox qui vous permet d'afficher 10, 25 ou 50 résultats ainsi qu'un tri par pertinence ou data. Et ça aussi Pagefind sait parfaitement le navigateur.

Mode sombre et accessibilité

Même si l'interface est rétro, j'ai quand même ajouté quelques fonctionnalités modernes. Le mode sombre respecte les préférences système, et j'ai intégré la police OpenDyslexic pour les personnes dyslexiques.

Le truc important c'est de charger ces préférences avant le rendu de la page pour éviter le fameux flash. J'ai donc un petit script qui lit les préférences dans le localStorage et applique les classes CSS immédiatement :

function() {
 if (localStorage.getItem('theme') === 'dark') {
 document.documentElement.classList.add('dark-mode');
 }
 if (localStorage.getItem('dyslexic-font') === 'true') {
 document.documentElement.classList.add('dyslexic-mode');
 }
});

Gestion de l'historique navigateur

Un détail qui peut sembler anodin mais qui est super important pour l'expérience utilisateur c'est la gestion du bouton retour du navigateur.

Quand vous faites une recherche, l'URL change selon votre requête du genre /recherche/?q=linux&p=2. Du coup si vous partagez cette URL à un collègue, la personne arrivera directement sur les résultats de recherche. Et si vous utilisez le bouton retour, vous reviendrez alors à la recherche précédente.

window.addEventListener('popstate', () => {
const query = new URLSearchParams(location.search).get('q');
if (query) doSearch(query);
else showHomePage();
});

Liens vers d'autres moteurs

Et si vous ne trouvez pas votre bonheur dans mes +18 000 articles (ce qui serait quand même étonnant ^^), j'ai ajouté des liens pour relancer la même recherche sur Google, DuckDuckGo, Qwant, Brave et Ecosia. Bref, un petit service bonus pour mes visiteurs, exactement comme le proposait Google à l'époque.

Le bilan - Algolia vs Pagefind

Après 1 semaine d'utilisation, voici donc mon verdict ! Côté portefeuille d'abord, Algolia me coûtait entre 60 et +100 euros par mois et maintenant pour Pagefind, c'est zéro euros ! Et les performances sont également au rendez-vous. Algolia c'était rapide et bien là, ça l'est encore plus. Seul compromis à noter, l'index Algolia se mettait à jour en temps réel, alors que Pagefind nécessite une reconstruction au moment du build.

La conclusion

Voilà, j'ai maintenant une recherche qui marche vraiment bien, qui me coûte 0€ par mois, et qui a un look rétro qui va en surprendre plus d'un...

Alors est-ce que c'était nécessaire de passer autant de temps sur le design rétro ? Hé bien absolument pas. Mais est-ce que ça valait le coup ?

Franchement, oui !! C'est mon site, je fais ce que je veux, et si ça peut faire sourire quelques visiteurs nostalgiques des débuts du web, c'est du bonus. D'ailleurs un grand merci aux Patreons qui me soutiennent car sans eux, je n'aurais pas pu passer mon dimanche là dessus ^^

Et puis surtout, ça m'a permis de découvrir Pagefind qui est vraiment un excellent outil. Donc si vous avez un site statique (ou n'importe quel type de contenu textuel) et que vous cherchez une solution de recherche gratuite et performante, je vous le recommande chaudement. La documentation est claire, l'intégration est simple, et le résultat est top !

Allez, maintenant vous pouvez aller tester la nouvelle recherche sur le site . Et si vous cliquez sur « J'ai de la chance » sans rien taper... bonne découverte !

  • ✇LinuxFr.org : les dépêches
  • Mise à jour de VenC en version 3.2.2
    VenC, un générateur libre (GPLv3) de site statique en python qui avait déjà été présenté dans une dépêche précédente, est de retour en version 3.2.2 avec tout un tas de nouvelles fonctionnalités cool qu’on va voir ici. lien nᵒ 1 : Site de l'auteur lien nᵒ 2 : Site de Jérémy Berrylien nᵒ 3 : Site du projetlien nᵒ 4 : Tipeee lien nᵒ 5 : LiberapaySommaire Auto-rafraîchissement lors de la prévisualisation Assignation d’un thème par défaut Amélioration des fonctionnalités FTP Transfert parallèle

Mise à jour de VenC en version 3.2.2

VenC

VenC, un générateur libre (GPLv3) de site statique en python qui avait déjà été présenté dans une dépêche précédente, est de retour en version 3.2.2 avec tout un tas de nouvelles fonctionnalités cool qu’on va voir ici.

Sommaire

Auto-rafraîchissement lors de la prévisualisation

Quand vous prévisualisez votre site avec venc -s vous n’avez plus besoin de tuer le processus du serveur HTTP local et de régénérer manuellement le site à chaque modification. Le mécanisme est à présent automatique et détecte lui-même un changement pour vous présenter la version à jour de votre contenu ! La cache du navigateur étant parfois capricieux, VenC vous notifie dans la sortie standard de ses actions si jamais vous avez un doute.

Assignation d’un thème par défaut

Si vous utilisez le thème par défaut concrete ou tout autre thème installé en dehors de votre projet il est possible de l’indiquer dans votre fichier de configuration. Ainsi venc -s sait comment régénérer votre site si nécessaire, et vous n’avez plus besoin d’indiquer le nom du thème installé sur votre système lorsque vous utilisez la commande venc -xb ou venc -xftp.

Amélioration des fonctionnalités FTP

Transfert en parallèle

De nombreuses améliorations ont été apportées, en voici quelques-unes !

Transfert parallèle

Vous pouvez maintenant définir un nombre arbitraire de connexions FTP simultanées pour le transfert de votre site en ligne. Pour un petit site, ça ne fait pas de grosse différence, mais quand comme moi votre site comporte plusieurs centaines de pages, ça fait gagner un temps fou !

Verbosité accrue

  • Affichage du prompt FTP
  • Affichage des commandes FTP associées à leur numéro de session

Transfert intelligent

Pour économiser de la bande passante, VenC compare les fichiers locaux avec ceux en ligne. Ce faisant, il ne réalise que les opérations d’I/O strictement nécessaires.

Configuration FTP plus fine

Vous pouvez maintenant paramétrer les options suivantes :

  • ftp_encoding : VenC affichant à présent le prompt FTP du serveur, il est maintenant possible d’avoir des informations sur celui-ci, et notamment l’encodage. Avec l’option ftp_encoding, il est donc possible de configurer l’encodage de la session pour être en phase avec le serveur distant et éviter de mauvaises surprises.
  • ftp_sessions : comme on l’a vu plus haut, c’est le nombre de connexions parallèles possibles.
  • ftp_port : avant, pour une raison obscure et injustifiable par le bon sens, le port de la connexion FTP était codé en dur… Maintenant c’est une valeur par défaut qu’il est possible de redéfinir.

Thème par défaut

Le thème par défaut a été amélioré, notamment au niveau de l’ergonomie et de la qualité visuelle du thème. Ce nouveau thème intègre par ailleurs les nouvelles fonctionnalités de la version 3.2 !

Nouvelles balises VenC

Microcode VenC

Accès amélioré à des métadonnées YAML

Une fonctionnalité ultérieurement manquante et utile dans certains cas d’usage est de pouvoir accéder à des valeurs qui sont imbriquées dans un ou plusieurs dictionnaires YAML dans le fichier de configuration principal ou dans les métadonnées d’une publication.

Pour ce faire, quatre fonctions VenC ont été ajoutés :

Pour les champs non obligatoires ou non prédéfinis par VenC, ça permet donc en conséquence une plus grande liberté dans l’organisation du contenu YAML.

Accéder à la date de la dernière publication

Utile pour la génération de flux Atom ou RSS, récupérer la date de la dernière publication d’un fil de publication permet d’indiquer la vraie date de mise à jour du flux :

GetLastEntryTimestamp

Taxonomie Avancée

Taxonomie Avancée

C’est la grosse fonctionnalité de cette mise à jour !

Avant la version 3.2 vous ne pouviez organiser vos publications “que” par catégories hiérarchisées. C’était déjà pas mal dans la mesure où ça permettait de créer des menus arborescents pour organiser votre contenu, mais parfois ça n’est pas suffisant. Par exemple, tout à fait au hasard, vous êtes un⋅e artiste et vous gérez votre portfolio avec VenC. Vous pourriez alors avoir un menu de la forme suivante pour organiser vos œuvres :

- Peintures
  - Huile
  - Acrylique
  - Aquarelle
- Dessins
  - Encre
  - Crayon
- Mediums Mixtes

Et comme vous êtes un⋅e bon⋅ne p'tit⋅e libriste auto-radicalisé⋅e sur Framasoft et LinuxFr vos œuvres sont en partie sous licence CC-By-SA. En partie seulement car oui, vous faites aussi des fanarts, des travaux dérivés d’œuvres sous licences propriétaires. Vous voulez donc séparer ce qui est véritablement libre de ce qui ne l’est pas. En générant par exemple ce type de menu :

# Mediums

- Peintures
  - Huile
  - Acrylique
  - Aquarelle
- Dessins
  - Encre
  - Crayon
- Mixtes

# Licences

- CC
  - By-NC-ND
  - By-SA
- Copyright
- Licence Art Libre

Ça tombe bien, c’est précisément ce que permet maintenant de faire VenC 3.2.

L’idée est la suivante : puisque l’arbre de toutes les catégories construit à partir de toutes les publications est un arbre hiérarchisé, il suffit de sélectionner une ou plusieurs branches de cet arbre pour créer nos menus et présenter notre contenu de la façon qu’il nous plaira.

Dans notre exemple précédent l’arbre hierarchisé de toutes les catégories aurait donc la forme suivante :

- Mediums:
  - Peintures:
    - Huile
    - Acrylique
    - Aquarelle
  - Dessins:
    - Encre
    - Crayon
  - Mixtes
- Licences:
  - CC:
    - By-NC-ND
    - By-SA
  - Copyright
  - Licence Art Libre

Nous sélectionnons donc les branches Mediums et Licences. Avec les nouvelles fonctions VenC qui vont bien :

Sur le thème par défaut concrete, vous pouvez ainsi avoir un nombre arbitraire de menu de catégories en configurant comme indiqué dans la documentation votre fichier de configuration principal.

À noter que même si ça n’est pas encore idéal, ce système ouvre la voie pour créer des blogs multilingues. Le brainstorming sur le sujet se passe ici. Pour l’heure, il est donc possible de tirer avantage de la taxonomie avancée pour créer des branches pour chaque langue que vous souhaitez utiliser. Avec un peu de JS vous pouvez aller plus loin pour rendre ça plus dynamique à votre convenance.

Le mot de la fin

Voilà pour cette nouvelle version !

La version 3.3 est déjà en cours de développement et vous pouvez suivre l’aventure ici. Un grand merci à Sidoine, Rollniak et Jérémy pour leur aide, leur confiance et leurs feedbacks !

Les sources GIMP des illustrations sont accessibles ici sous licences CC-By-SA

Toutes les contributions sont évidemment les bienvenues :

  • Corriger, relire ou améliorer la documentation.
  • Signaler des bugs ou faire des suggestions.
  • Écrire du code.
  • Me faire aumône pour me payer un p'tit shot de Baileys Irish Cream !

Commentaires : voir le flux Atom ouvrir dans le navigateur

  • ✇LinuxFr.org : les dépêches
  • VenC 3.1.1 | Un nouveau générateur de site statique
    On va présenter ici un nouveau générateur de site statique, écrit en python. Il n’est pas exactement nouveau au sens où nous en sommes à la version 3, mais jusqu’ici le projet est resté relativement confidentiel. Nous parlerons également des perspectives d’évolution de ce projet. lien nᵒ 1 : Site et documentation du projet VenClien nᵒ 2 : Code source de VenC sur Githublien nᵒ 3 : Code source de VenC sur Framagitlien nᵒ 4 : Mistletoelien nᵒ 5 : Docutilslien nᵒ 6 : Latex2MathMLlien nᵒ 7 : Pygmen

VenC 3.1.1 | Un nouveau générateur de site statique

VenC

On va présenter ici un nouveau générateur de site statique, écrit en python. Il n’est pas exactement nouveau au sens où nous en sommes à la version 3, mais jusqu’ici le projet est resté relativement confidentiel. Nous parlerons également des perspectives d’évolution de ce projet.

Sommaire

Introduction et petit historique

Introducing VenC

VenC est un énième générateur de site statique (libre, évidemment !) dont le nom étrange provient d’un rêve dans lequel je naviguais sur un réseau social appelé « V en C ». Ce rêve, ainsi que la forme et le contenu de ce réseau, m’avaient marqué. Rétrospectivement, ça ressemblait un peu aux premières heures glorieuses de Tumblr / Skyblog avec un petit côté web oldschool.

De gros projets historiques sont déjà bien installés dans le game. Par ailleurs, si j’en crois le nombre d’annonces de logiciels de ce type ici, ça ressemble un peu à un running gag d’arriver avec ma proposition !

Je tenais quand même à présenter l’ouvrage, car il s’agit d’un projet qui me tient toujours beaucoup à cœur et avec lequel j’ai notamment appris le langage Python et pour lequel je continue de progresser. Je l’ai commencé au début des années 2010 précisément quand on voyait émerger ce type d’outil, pour une approche plus “lightweight” du web. Ça n’est que récemment que j’ai ambitionné de rendre ce projet public.

La version 2 est la première que j’ai partagée sur mes réseaux sociaux (Diaspora* et Mastodon). C’était un peu la bêta de la version actuelle, où de grandes restructurations de code avaient été réalisées, fort d’une plus grande expérience en Python. Ça ne m’a pas empêché d’introduire de la dette technique corrigée plus tard, et dans sa plus grande partie je l’espère, dans la version actuelle. J’avais également ajouté une fonctionnalité un peu expérimentale, dont on reparlera plus bas.

Globalement la v1 et la v2 sont restées assez confidentielles. Trop de bugs, pas correctement documentées et pas assez adaptées aux multiples et imprévisibles usages que peuvent avoir les utilisateurs finaux. Certaines questions de choix technico-philosophiques restées en suspens sont encore d’actualité et doivent être décidées par ceux qui l’utilisent. En d’autres termes, je souhaite élargir les possibilités qu’offre VenC en l’adaptant aux besoins des autres, et non plus seulement aux miens.

La version 3.1.0 a été mise en ligne le 30 décembre 2023 et j’estime le projet suffisamment mature (en toute modestie) pour être partagé avec vous. Mon idée étant de proposer l’existant, et de réfléchir avec vous avec les perspectives que j’ai en tête ou que vous pourriez vouloir voir implémentées ! C’est également l’occasion pour moi de bénéficier d’un éventuel retour d’expérience, d’une relecture de code ou de la documentation, et améliorer l’existant.

Que permet de faire VenC ?

Create blog in five minutes !

Il s’agit donc d’un générateur de site statique orienté blog proposant les fonctionnalités suivantes :

  • Des balises VenC permettant une mise en page et une intégration de contenus avancés.
  • La possibilité de créer un agencement de publication en nombre arbitraire de colonnes.
  • Un module et une API JavaScript de défilement infini.
  • Les publications peuvent être organisées par catégories, sous-catégories, par période de dates et par chapitres.
  • La possibilité de désactiver des fils de publications spécifiques.
  • La possibilité de configurer des sous-répertoires pour chaque type de publications.
  • La possibilité d’ajouter des métadonnées au blog et aux publications.
  • Les publications sont triées par ordre chronologique par défaut, mais peuvent l’être aussi en fonction de métadonnées. L’ordre peut être ascendant ou descendant.
  • La génération de flux Atom et/ou RSS pour chaque fils de publications.
  • Des permaliens.
  • Un serveur HTTP simple pour effectuer des tests et prévisualiser le site.
  • La gestion et l’édition du blog peuvent être faites entièrement en ligne de commande, dans un environnement non graphique.
  • Le support de Markdown, reStructuredText, AsciiDoc.
  • La mise en ligne du site peut se faire en FTP via VenC.
  • Le support de pygmentize pour la coloration syntaxique.
  • Le support de l’API oEmbed.
  • Le support de l’API Kroki.
  • Le support de contenus audio et vidéo via les balises VenC.
  • Installation facilitée via pip et pipx.

Faster, smaller, stronger

VenC Install Party

À noter qu’ayant à cœur l’optimisation et la performance, l’essentiel du travail réalisé sur cette version 3.1.0 à été l’intégration d’un mode de génération parallèle pour accélérer l’exportation de votre projet. En fait sur ce dernier point, l’ambition est de faire en sorte que VenC puisse passer à l’échelle en tirant parti des threads Python du module multiprocessing de Python. Nous en reparlerons plus bas.

J’ai passé de longues heures à optimiser l’ensemble du code comme je l’avais déjà fait entre la v1 et la v2. Mon propre site contenant énormément de pages, j’ai besoin d’une application rapide et simple pour générer celui-ci. Il y a quelque chose de très satisfaisant à travailler en ce sens. Tout en mesurant les limites de la chose et en découvrant qu’un excès de zèle rend le code incompréhensible bien sûr… Avec cette v3 je pense avoir atteint un équilibre. En termes de rapidité, la force de VenC réside aussi dans le fait qu’il possède sa propre syntaxe de balisage pour la mise en forme (pas de Jinja donc). Le moteur de template étant ici taillé sur mesure et fortement couplé à l’application, ça tourne très très vite ! Voir la documentation de la syntaxe VenC.

Si jamais ça vous intéresse, il est envisageable de découpler cette partie spécifique du code pour être utilisé ailleurs que dans VenC.

Travaux et réflexion en cours, le futur de l’application

Learning VenC

Le moteur de recherche client-side.

Dans la v2 j’avais introduit une fonctionnalité expérimentale permettant de générer des documents JSON-LD au format JSON ou JSONP. Cette fonctionnalité a été retirée depuis, parce que je ne suis plus sûr de la pertinence de cette technique pour le projet initial : celui d’implémenter un moteur de recherche client-side décentralisé. Ce moteur de recherche devait permettre de chercher du contenu sur un site, mais aussi sur celui des amis, pour lesquels les end-points seraient manuellement ajoutés par le propriétaire du site. Ce faisant, cela permettrait de créer un réseau de site qu’il est possible de crawler pour trouver du contenu.

Il se pourrait que JSON-LD ne soit en fait pas le meilleur moyen pour ce genre d’usage. Mais je n’en sais trop rien, qu’en pensez-vous ?

Intégration avec le Fediverse

Un truc que j’ai toujours trouvé chouette avec Tumblr, c’est le fait d’avoir une page hautement personnalisable qui fait néanmoins partie d’un tout qu’il est possible d’explorer avec le moteur de recherche interne du service. En ce sens, cette idée rejoint celle concernant le moteur de recherche client-side décentralisé.

Avec l’émergence de Fediverse, ça serait en fait intéressant de voir comment il est possible d’intégrer VenC à ce type de réseau. Mon idée initiale était de créer une surcouche de VenC, une sorte de serveur, avec un frontend web, gérant plusieurs sites et capable de répondre dynamiquement à des requêtes des APIs du Fediverse. On comprend ici qu’un tel serveur pourrait avoir à gérer des dizaines, voire des centaines de sites, le parallélisme fraîchement implémenté dans la v3 prend tout son sens.

La question de comment explorer du contenu gérer par VenC de façon décentralisé, modulaire, et interopérable étant le grand axe d’évolution de VenC qui me tient à cœur. Je souhaite recréer ce réseau dont j’avais rêvé il y a longtemps.

Sites statiques, deepweb et smolweb

VenC Is Small

Le smolweb, c’est vraiment cool. Par certains aspects il ressemble aussi un peu au deepweb, lui aussi très intéressant pour d’autres raisons. Les propositions de ces réseaux étant toujours plus d’actualités à mesure que les années passent…

De ce que j’ai pu voir du deepweb, beaucoup de sites sont en fait statiques et d’apparence très sobre, ce qui ne manquera pas de faire vibrer la fibre nostalgique de ceux qui ont connu le web des années 1990 et 2000. Quelle époque ! Dans les deux types de réseau on retrouve deux aspects qui me tiennent à cœur, le green IT pour l’un et la vie privée pour l’autre. Des valeurs dans lesquelles je me retrouve évidemment, et pour lesquelles je souhaiterais que VenC apporte sa pierre à l’édifice.

Une des perspectives d’évolution de VenC serait de pouvoir faire en sorte qu’il puisse générer des sites spécifiquement pour les différents types de smolweb : Gopher, Gemini… Mais je ne connais pas bien le fonctionnement de ceux-là, c’est donc encore à l’étude.

Et le format EPUB ?

Puisque VenC gère le chapitrage de son contenu, ça pourrait avoir du sens de pouvoir générer des documents EPUB. Et comme ce format est en fait du contenu HTML embarqué dans un zip… Il n’y a plus qu’à étudier les spécifications du format, et au boulot. Mais peut-être qu’il existe déjà un module ou package Python pour ce genre de chose ? Tout ça est aussi à l’étude.

Internationalisation des articles

Le besoin étant d’avoir plusieurs versions d’un même article dans des langues différentes, il y a plusieurs façons de réaliser ça… Ça n’est donc pas une feature triviale.

Ça pourrait m’aider de me parler un peu de la façon dont vous voyez la chose pour un blog statique.

Fonctionnalités de base manquantes

La plupart des générateurs de sites statiques ont cette fonctionnalité, mais pas VenC. Pas encore en tout cas, mais c’est dans les tuyaux !

Génération incrémentale et mise en cache.

VenC Is Fast

Au lieu de régénérer tout le site à chaque modification, VenC ne devrait modifier que le strict nécessaire. Une mise en cache des pages à certaines étapes de la génération du site pourrait être mise en œuvre pour accélérer le traitement.

Auto-rafraîchissement lors de la prévisualisation

Cette fonctionnalité va de pair avec la précédente, lorsque le site est prévisualisé il devrait s’auto-régénérer quand une modification est faite.

Ajout de modules tiers écrit par les utilisateurs eux-mêmes

VenC Is Written In Python

Pour le moment VenC n’a pas de greffons autres que ceux déjà prévus par l’application, mais les futures versions bénéficieront d’une API permettant d’écrire vos propres fonctionnalités.

Le mot de la fin

J’ai à cœur de rendre ce logiciel accessible dans d’autres langues, pour la traduction de la documentation et du logiciel lui-même, je cherche des personnes pouvant justifier d’une capacité professionnelle de traduction dans une langue ou une ou autre. L’anglais et l’allemand seraient par exemple un bon début. Ce travail serait naturellement rémunéré. N’hésitez pas à me contacter si vous pensez avoir la compétence requise pour que nous en discutions.

Cette v3 a demandé beaucoup d’efforts, j’espère que ce logiciel trouvera ses utilisateurs ! J’en profite pour remercier les contributeurs qui croient en ce projet et notamment Jérémy Berry pour ses conseils et sa précieuse relecture, Sidoine Baratte qui suit le projet depuis le début et avec qui j’ai affronté les bugs ainsi que benben962 pour sa traduction en anglais de l’ancienne documentation !

Ressources du projet

Illustrations

Les sources des illustrations :

Modules optionnels

  • Mistletoe : Pour l’utilisation de la syntaxe Markdown.
  • Docutils : Pour utiliser la syntax reStructuredText.
  • Latex2MathML : Pour convertir du LaTeX en MathML.
  • Pygments : Pour la coloration syntaxique.
  • AsciiDoc3 : Pour utiliser la syntaxe Asciidoc

Commentaires : voir le flux Atom ouvrir dans le navigateur

❌
❌