❌

Vue lecture

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.

Flus sort en 3.0

Flus est une plateforme de veille en ligne conçue pour suivre, lire, organiser et partager vos liens Web de manière simple. Elle s’intègre à votre écosystème d’outils existants pour compléter et éditorialiser votre veille.

Le 12 octobre dernier, j’ai sorti Flus en version 3.0. Cette nouvelle version majeure apporte des fils thématiques (l’équivalent des dossiers ou catégories dans les autres agrégateurs), un moteur de recherche plus puissant, et une nouvelle page pour gérer ses sources de manière avancée.

Logo de Flus

Flus est un logiciel libre sous licence AGPLv3 que je développe depuis 2020. Je le propose en SaaS, à prix libre, pour financer le développement de l’outil.

La dernière dépêche concernant Flus (flusio à l’époque) datant de 2021, je profite de cette sortie pour vous (re)présenter Flus de façon générale et vous détailler la feuille de route 2027.

Sommaire

Flus dans les grandes lignes

Présentation

Flus combine l’agrégation de flux, les listes « à lire plus tard » et le partage de signets pour vous éviter d’avoir à jongler entre trop d’outils. Il permet de :

  • Suivre des sources telles que des blogs, des podcasts ou des chaînes vidéo (flux RSS, Atom et JSON), ainsi que des collections partagées sur Flus.
  • Lire à votre rythme grâce au journal qui vous propose une sélection configurable de liens issus des sources que vous suivez, ainsi qu’aux listes « À lire » et « Liens lus ».
  • Ranger vos liens dans des collections pour les retrouver facilement. Vous pouvez prendre des notes et ajouter des #tags pour mémoriser ce que vous en avez pensé et préparer vos prochaines productions.
  • Partager vos liens, vos collections et vos fils publiquement sur votre profil pour que d’autres personnes puissent vous suivre, ou en privé pour collaborer avec des personnes en particulier.

Bref, si vous utilisez FreshRSS, wallabag et/ou Shaarli : c’est un peu les trois à la fois ! Mais évidemment pas tout à fait : par exemple, Flus ne permet pas (encore) de lire directement les articles dans l’application, il n’archive pas non plus (encore) les articles et il ne permet pas (encore) de prendre des notes en dehors du bloc-notes des liens.

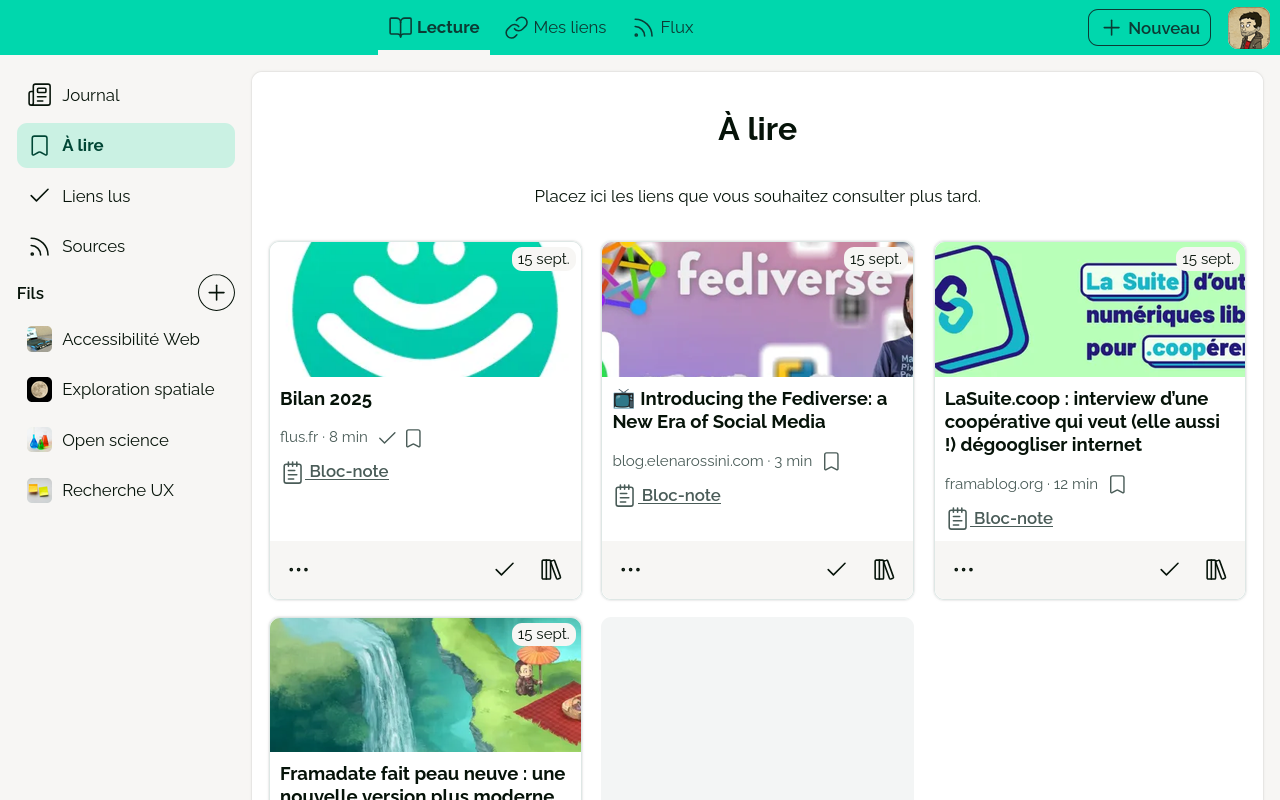
L’écran « À lire » affichant plusieurs liens à lire plus tard.

Stack technique et contributions

Flus est une application Web écrite en PHP, reposant sur Minz, mon framework maison. Côté interface, les templates sont écrits grâce au moteur Twig. Si le JavaScript est requis pour un certain nombre d’actions, on reste sur des technologies assez légères : Turbo et Stimulus. La seule base de données prise en charge est PostgreSQL. Flus a finalement assez peu de dépendances, ce qui me permet de mieux maîtriser la stack technique.

La documentation pour déployer concerne uniquement mon propre environnement de production : Git, Nginx, PHP, PostgreSQL. Je ne fournis pas d’image Docker de production, mais le Dockerfile et le docker-compose.yml de développement peuvent servir de base pour qui serait intéressé·e.

Un fichier détaille comment contribuer, néanmoins je restreins volontairement les possibilités car il m’est compliqué de trouver le temps d’accueillir des contributions en gérant tous les autres aspects (communication, infrastructure, support, etc.).

Du financement de Flus

Je développe Flus à mon compte depuis 2020. L’offre SaaS existe depuis le début : cela m’a permis de payer largement les serveurs ainsi que quelques prestations pour m’aider sur les aspects que je maîtrise moins (ex. le juridique ou les productions visuelles). Je ne me suis en revanche jamais payé un salaire mirobolant ; seulement de quoi mettre un peu de beurre dans les épinards. Désolé de décevoir les personnes qui pensaient que fournir un service en SaaS était un bon plan !

C’est par le biais d’un travail à mi-temps que j’ai trouvé l’équilibre nécessaire pour avancer sur Flus. Je ne consacre ainsi qu’une semaine sur deux au projet, le reste de mon temps étant passé au sein de la SCOP Probesys. Ce n’était absolument pas la solution que j’envisageais initialement, mais ça marche plutôt bien.

Le prix libre que je propose (entre 0 et 120 € par an) est globalement bien compris, notamment parce que je donne quelques seuils :

  • 15 € / an : le tarif solidaire pour celles et ceux qui ne sont pas prêts à dépenser plus, mais qui souhaitent tout de même soutenir le projet.
  • 30 € / an : le tarif équilibre que je juge comme étant le plus juste au regard du service que je propose et de mon objectif financier.
  • et le tarif soutien, qui évolue en fonction de mon objectif financier et du nombre d’abonné·es.

On le verra néanmoins plus loin dans cette dépêche, cela pourrait évoluer en 2027 avec l’arrivée prochaine d’une offre Pro.

Notons que le service va bientôt fêter son septième anniversaire. Ce sera l’occasion de publier un nouveau bilan, à la suite des précédents. Ces bilans abordent plutôt l’aspect « entrepreneurial », mais il me semble que le lectorat de LinuxFr est généralement friand de cela 😉

Les nouveautés de la 3.0

Assez digressé, que renferme donc Flus 3.0 ?

Des fils thématiques

Les fils répondent à deux besoins principaux :

  1. Créer des espaces de veille contextuels permettant de séparer votre veille personnelle de votre veille professionnelle, par exemple.
  2. Gérer les sources les plus prolifiques grâce à un système de filtres avancés pouvant être enregistrés sous forme de vues.

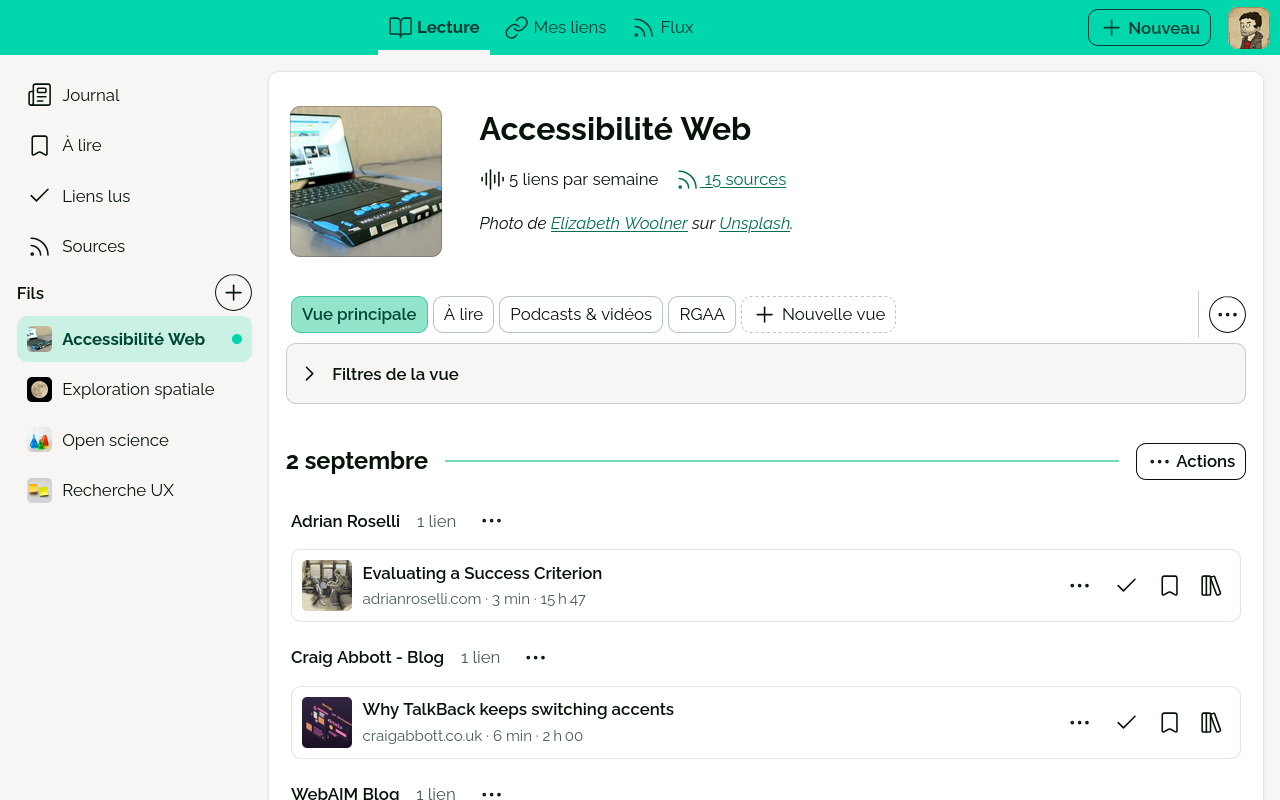
L’écran Lecture de Flus sur ordinateur, avec un fil de veille « Accessibilité Web » et ses liens du jour.

Concrètement, vous pouvez associer vos sources (flux Web et/ou collections Flus) à des fils que vous retrouvez dans le menu de navigation, à gauche de l’écran. Oui, comme les dossiers ou catégories dans les autres agrégateurs de flux. Mais les fils offrent quelques possibilités en plus :

  • ils peuvent être filtrés : par date, mots-clés, statut de lecture ou source ;
  • ces filtres peuvent être enregistrés sous forme de vues accessibles en un clic ;
  • les fils peuvent également être partagés, que ce soit publiquement (voici par exemple mon fil « Planet Flus ») ou avec des personnes spécifiques pour construire une veille commune.

Un moteur de recherche amélioré

Le moteur de recherche a été revu et grandement amélioré. Il est maintenant possible d’exprimer des recherches complexes :

  • la combinaison de mots avec l’opérateur AND (par défaut), l’alternative avec OR, ou encore l’exclusion avec NOT ;
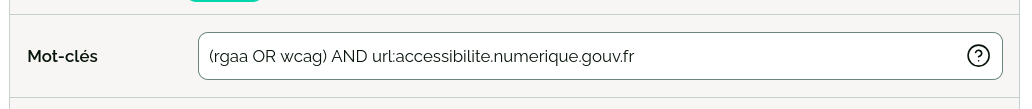
  • le groupement avec les parenthèses, par exemple : (rapport OR étude) NOT #archive ;
  • la recherche par attributs, notamment par date (ex. date: 2026-10), par durée de lecture (duration: >10), ou en recherchant au sein de vos notes (notes: rapport).

Un écran d’aide intégré au champ de recherche permet de connaître les différentes possibilités.

Capture d’écran montrant un champ texte de filtre.

Une nouvelle page pour vos sources

Une nouvelle page, nommée « Sources », permet de lister les flux et les collections Flus que vous suivez. Depuis cette page, il est maintenant possible de :

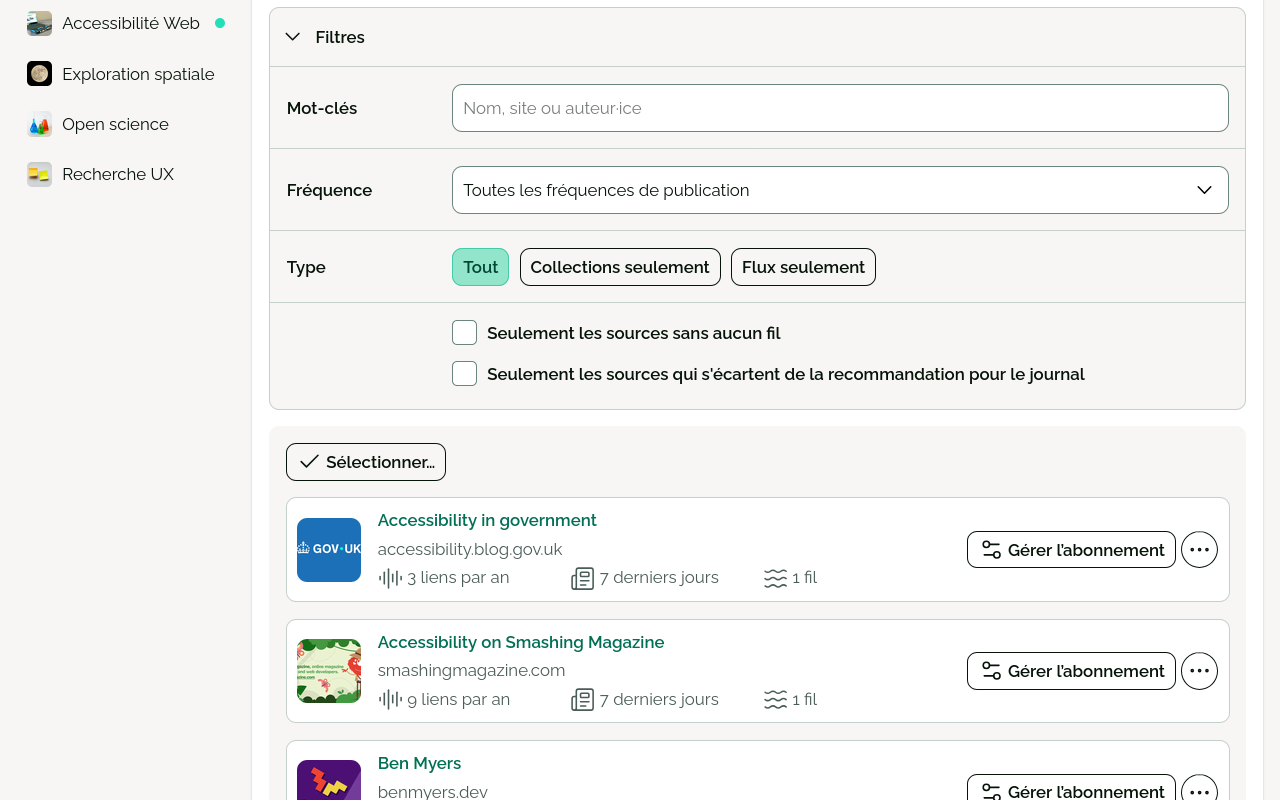
  • Rechercher et filtrer vos sources : pratique pour en retrouver une précisément, ou pour lister toutes les sources désormais inactives, par exemple.
  • Gérer vos abonnements (paramétrage pour le journal, ajout au sein des fils, désabonnement), que ce soit individuellement au niveau de chaque source, ou de manière groupée grâce aux actions de masse.

Capture d’écran montrant un formulaire de filtre et des sources.

Des améliorations diverses

Les trois nouveautés présentées ci-dessus changent fondamentalement la manière d’interagir avec Flus. Mais d’autres évolutions viennent compléter le tableau pour une utilisation plus agréable :

  • La possibilité de renommer une source et d’en changer l’illustration (pratique quand un flux déclare un nom obscur ou beaucoup trop long).
  • Une barre d’édition et des raccourcis pour l’éditeur de texte Markdown : juste de quoi ne pas avoir à tout mémoriser… en attendant des travaux plus conséquents !
  • La prolongation de la durée de session pour ne pas avoir à se reconnecter tous les mois si l’on se connecte régulièrement.

Les plans 2027 : entre travail en équipe et offre Pro

Cette 3.0 constitue déjà une version très complète, mais c’est loin d’être fini ! La feuille de route adoptée pour 2027 est claire (et sans doute ambitieuse) : permettre à des équipes d’organiser leur veille facilement à plusieurs. Voici les fonctionnalités prévues à ce stade :

  • Les organisations disposeront de leurs propres collections et fils, pourront gérer leurs membres et les répartir en équipes.
  • Un mécanisme de feedback léger (émoji + court commentaire) permettra de réagir aux liens et notes des autres membres d’une organisation.
  • Les notes pourront être mises en avant pour aider à contextualiser les liens au sein des collections.
  • Des synthèses pourront être produites pour préparer, par exemple, une newsletter, un article de blog, ou un document PDF à distribuer à ses collègues.
  • Enfin, le mécanisme pour partager les accès aux collections et aux fils sera simplifié (le fonctionnement actuel étant peu intuitif).

Ces éléments constitueront la base d’une offre Pro destinée aux entreprises, associations, universités, etc. Cette offre doit me permettre de dépasser (enfin !) le seuil des 5 000 € de chiffre d’affaires annuel, ce qui ne serait pas du luxe.

Toutes les fonctionnalités développées dans ce cadre seront sous licence libre AGPLv3, mais il n’est pas impossible que certaines soient limitées à l’offre Pro dans la version SaaS (à priori, celles qui impliqueront une utilisation plus intensive des ressources du serveur).

Rendez-vous ici dans un an, lors de la sortie de la 4.0 ? 🙂

Commentaires : voir le flux Atom ouvrir dans le navigateur

SelfRecover — protocole AGPL de récupération de compte sans email

Je suis agriculteur en Creuse et je code sur mon temps libre. J'ai commencé à m'intéresser à la question de la récupération de compte en développant ARC PVE Hub, un site destiné à fédérer une communauté de joueurs. Je n'ai jamais compris pourquoi il fallait transmettre son email pour régénérer un mot de passe — ça déplace la sécurité du compte vers un fournisseur SMTP tiers, qui n'est pas contrôlé par l'utilisateur.

J'ai donc imaginé un protocole de récupération sans email, sans SMS et sans tiers. Le travail s'est étoffé en partenariat avec un assistant IA (Claude), comme outil de réflexion et de mise en forme — j'y reviens en fin de dépêche dans une note de transparence.

L'incident de sécurité ANTS du 15 avril 2026 a publiquement illustré le problème. J'en ai eu connaissance après avoir développé SelfRecover, ce qui m'a confirmé la pertinence d'un protocole sans dépendance à l'email. SelfRecover est publié sous AGPL-3.0-or-later sur GitHub.

Cette dépêche présente le protocole, ses choix de conception, ses limites assumées, et la comparaison avec les approches existantes (Keycloak Recovery Codes en particulier, qui m'a été suggéré en relecture). Audit communautaire bienvenu.

Sommaire

Le contexte

Depuis l'essor du web, la réponse standard à « l'utilisateur a oublié son mot de passe » est « on lui envoie un lien de réinitialisation par email ». C'est devenu si universel qu'on oublie ce que ça implique :

  • La sécurité du compte est déléguée au fournisseur de la boîte mail (Gmail, Outlook, ProtonMail). Si la boîte mail tombe, le compte aussi.
  • Le canal email est régulièrement exploité par phishing : campagnes imitant des mails de réinitialisation légitimes pour capturer les mots de passe.
  • Les bases de données qui stockent les emails des utilisateurs deviennent une cible massive : leur fuite expose à la fois l'identité et les vecteurs de récupération.

L'incident de sécurité ANTS illustre une autre facette du problème de gestion des données d'authentification dans les services en ligne. Détecté le 15 avril 2026 et rendu public le 20 avril, il a touché 11,7 millions de comptes selon les communiqués officiels. La cause technique identifiée est une faille d'énumération de type IDOR (Insecure Direct Object Reference) : il était possible d'accéder aux données d'un autre compte en modifiant un identifiant dans une URL. La fuite ne concerne ni les mots de passe, ni les pièces justificatives, mais les données personnelles associées aux demandes de titres.

Devant ces limites structurelles autour de l'authentification web, SelfRecover propose une inversion : conserver le secret de récupération chez l'utilisateur, et utiliser le navigateur pour faire les calculs cryptographiques nécessaires à la vérification. Le serveur ne détient plus que des dérivés, jamais les secrets bruts.

Le protocole en deux phrases

Côté navigateur, on calcule HMAC-SHA256(secret, domaine) : une fonction cryptographique standard qui combine le secret de l'utilisateur avec le nom de domaine du site, et produit une empreinte impossible à inverser. Côté serveur, on ne stocke que cette empreinte, en plus protégée par un hash adaptatif et memory-hard : Argon2id, qui est le standard moderne recommandé contre les attaques par brute force.

Deux propriétés découlent de cette construction :

  • Le secret brut ne quitte jamais le poste de l'utilisateur.
  • Un secret capturé sur un site A (par exemple via phishing) est mathématiquement inutilisable sur un site B : la dérivation HMAC produit des empreintes différentes pour des domaines différents. C'est de l'anti-phishing par construction, pas par convention.

Note conceptuelle : l'inspiration vient des machines à rotors historiques type Enigma. Le principe partagé est qu'une même configuration secrète, présente des deux côtés (émetteur et récepteur), permet de produire et vérifier un message dérivé. La cryptographie moderne (HMAC-SHA256 ici) repose sur des fondations mathématiques différentes, mais ce principe de dérivation contrôlée par un secret commun est resté.

Deux modes d'adoption

SelfRecover propose deux modes selon le contexte de déploiement.

Mode Full — Sans email

L'application abandonne entièrement le flow de réinitialisation par email. L'utilisateur génère une passphrase diceware à l'inscription (liste EFF de 7 776 mots, 4 à 7 mots par défaut), qu'il mémorise ou stocke dans son gestionnaire de mots de passe. Cette passphrase, combinée au nom de domaine du site via HMAC-SHA256, permet de réinitialiser le mot de passe sans aucune dépendance externe.

Pour qui : nouveaux projets qui veulent s'affranchir de SMTP dès la conception, ou services qui adoptent un modèle de menace post-fuite (l'email n'est plus considéré comme un canal de confiance).

Mode Lite — Avec email + mot mémorisé

L'application conserve le flow de réinitialisation par email habituel, mais y ajoute une étape supplémentaire : l'utilisateur saisit un mot mémorisé (choisi à l'inscription) qui est dérivé HMAC-SHA256 côté navigateur. Le mot brut n'est jamais transmis au serveur. La validation combine donc deux facteurs :

  1. La possession de la boîte mail (lien reset reçu)
  2. La connaissance du mot mémorisé (dérivé HMAC côté client)

Pour qui : applications existantes qui ne peuvent abandonner SMTP du jour au lendemain, mais veulent durcir progressivement leur flow de récupération. Conséquence : un email intercepté seul ne suffit plus à compromettre un compte — il faut aussi connaître le mot mémorisé.

Synthèse

Mode Canal email Crypto utilisateur Cible
Full Aucun Passphrase diceware EFF + HMAC Nouveaux projets
Lite Conservé Mot mémorisé + HMAC Applications existantes

SelfRecover vs Keycloak Recovery Codes

Lors de la relecture de cette dépêche, devnewton a soulevé une question importante : quelle est la différence avec les Recovery Codes de Keycloak ?

Keycloak est l'IAM (Identity and Access Management) open-source de référence, maintenu par Red Hat sous licence Apache 2.0, déployé dans de nombreuses organisations depuis plus d'une décennie. Son mécanisme de Recovery Codes est un fallback d'authentification à deux facteurs : si l'utilisateur perd son téléphone TOTP, il peut saisir un code de secours préalablement généré côté serveur.

Note importante de positionnement : les Recovery Codes Keycloak adressent le cas « j'ai perdu mon 2FA mais je connais toujours mon mot de passe principal ». Le password reset principal de Keycloak utilise, lui, le canal email standard (configuration SMTP dans l'onglet Email de l'admin console).

SelfRecover s'attaque à un cas différent : « j'ai oublié mon mot de passe principal et je ne veux pas dépendre de l'email pour le récupérer ». Concrètement :

Aspect Keycloak Recovery Codes SelfRecover
Cible Fallback 2FA Password recovery sans email
Architecture Serveur IAM standalone (Java + BDD + admin) Bibliothèque à intégrer dans le code de l'application
Source du secret Serveur génère, utilisateur sauvegarde Utilisateur génère/mémorise (diceware ou mot mémorisé)
Stockage utilisateur Codes à sauvegarder physiquement Passphrase mémorisable (mode Full) ou mot mémorisé (mode Lite)
Email reset principal Reste nécessaire (SMTP configuré dans l'admin) Aucun (mode Full) ou en complément (mode Lite)
Anti-phishing crypto Pas spécifique au mécanisme Dérivation HMAC par domaine : un secret capturé sur un site est mathématiquement inutilisable ailleurs
Licence Apache 2.0 AGPL-3.0-or-later
Maturité 10+ ans, audité, déployé largement Récent, audit communautaire bienvenu

Pour la majorité des projets qui acceptent l'email comme canal de récupération, Keycloak (et son écosystème) reste le bon choix. SelfRecover s'adresse aux applications qui veulent réduire ou supprimer leur dépendance à SMTP, et qui n'ont pas besoin de la richesse d'un IAM complet (multi-realm, OIDC/SAML, fédération d'identité, etc.).

Que se passe-t-il si l'utilisateur perd son secret ?

C'est la question critique d'un protocole de récupération. SelfRecover y répond par escalade progressive sur trois niveaux, complétée par un système de litiges et un chat administrateur pour les cas extrêmes.

Niveau 1 — Passphrase oubliée

L'utilisateur saisit son username + sa passphrase diceware (match exact). Sur succès, un nouveau mot de passe est généré et affiché une seule fois. Anti-brute force : 3 tentatives par 15 minutes, 3 blocages successifs → éjection vers L2.

Niveau 2 — Passphrase perdue, mais identifiant + mot de récupération retenus

L'utilisateur saisit son identifiant public (numéro client, identifiant métier — fourni par le site) et son mot de récupération dérivé HMAC-SHA256 côté navigateur. 3 tentatives maximum avec compteur visible. Sur 3 échecs → redirection vers L3. Un litige est automatiquement créé (LIT-XXXX), tracé en base, admin notifié. Les litiges auto-résolus sont purgés après 24 heures.

Niveau 3 — Accès complètement perdu

Entrée par un lien discret « accès perdu » sur la page de connexion. L'utilisateur saisit son identifiant public en premier (anti-timing : délai forcé de 2 à 3 secondes), puis remplit un formulaire de scoring multi-facteur :

Catégorie Champs Points
Identifiant public 4 20
Mot de récupération (dérivé HMAC) 5 25
Username 3 30
Passphrase (fragments) 3 25

Bonus passifs : IP connue (+5), fingerprint connu (+5).

  • Score ≥ 60/100 → compte récupéré, nouveau mot de passe généré
  • Score < 60/100 après 3 tentatives → le compte passe en mode restreint : l'utilisateur n'a plus accès qu'au chat administrateur, le compte n'est ni utilisable ni écrasable tant que l'admin n'a pas validé
  • Cooldown : 1 heure entre tentatives

Chat administrateur humain en mode restreint — état actuel

Dans l'implémentation actuelle (déployée en production sur ARC PVE Hub), le chat L3 est un canal direct entre l'utilisateur en mode restreint et un administrateur humain du site. Pas d'intermédiaire automatisé, pas de bot.

Le canal de chat est bidirectionnel et fonctionne en polling (pas WebSocket temps réel, pour rester simple). L'admin vérifie l'identité par l'échange et décide manuellement :

Accorder la récupération : mot de passe régénéré, compteurs réinitialisés, litige clôturé, mode restreint levé.

Refuser la récupération : ban temporaire de 24 heures, pas de nouveau litige possible pendant cette fenêtre, compteur de refus incrémenté (1/3, 2/3, 3/3). À chaque clic, l'interface admin rappelle explicitement les conséquences via une modale de confirmation (ban 24h aux refus 1 et 2, suppression définitive au 3e refus).

Au 3e refus, le compte est définitivement supprimé : décision exclusivement humaine, prise en pleine connaissance de cause par l'admin via la modale d'avertissement explicite. La suppression libère l'identifiant public pour une nouvelle inscription.

Principe de design MySelf : aucune destruction de données utilisateur n'est déclenchée sans validation humaine consciente. L'interface admin explicite systématiquement les conséquences avant chaque action irréversible. Une IA peut se tromper ou être manipulée ; lui déléguer la décision de supprimer un compte créerait une surface d'attaque.

Ce mécanisme empêche un attaquant de spammer les litiges indéfiniment : chaque refus lui coûte 24 h, et trois échecs effacent toute trace. Un propriétaire légitime bloqué par erreur peut retenter après chaque fenêtre de ban, ou se réinscrire depuis zéro si totalement verrouillé.

Évolution prévue (en réflexion) : pré-traitement optionnel par chatbot LLM local

En complément du chat admin humain (qui resterait toujours disponible), une couche de pré-traitement par un agent conversationnel local (Ollama auto-hébergé) est en cours de design. Le chatbot poserait les questions initiales de vérification d'identité et estimerait si la demande est légitime. Sur estimation positive, le mot de passe serait régénéré directement ; sur doute, l'admin humain reprendrait la main.

Cette option serait configurable par site qui déploie (activable ou non), et le chatbot ne se substituerait jamais à l'admin pour les décisions destructives (suppression de compte) — ces décisions resteraient exclusivement humaines, conformément au principe MySelf énoncé plus haut.

L'enjeu principal en cours de réflexion : calibrer le seuil de confiance du chatbot pour ne pas créer un nouveau vecteur d'attaque par social engineering (un attaquant pourrait essayer de manipuler le LLM par prompts).

Démo standalone vs implémentation de référence

La démo publique (bi-self.my-self.fr/selfrecover/) ne couvre que les niveaux L1 et L2, car L3 nécessite une interface admin, un système de disputes et un dashboard — trop pour une démo à page unique.

L'implémentation de référence en production se trouve sur ARC PVE Hub, un site communautaire de joueurs ARC RAIDERS qui sert de terrain de test à l'écosystème MySelf. L1 + L2 + L3 + mode restreint + chat admin + dispute system y sont fonctionnels.

Pourquoi assumer cette friction

Dans la vie réelle, si l'on perd sa carte bancaire, son code, sa pièce d'identité, son adresse et sa date de naissance, on ne récupère pas son compte bancaire par email. On passe en agence avec preuve d'identité.

SelfRecover applique la même logique en ligne : la sécurité réelle nécessite parfois un passage par l'humain ou un processus d'identification rigoureux. Cette friction est assumée comme un trade-off conscient, pas comme une limitation à compenser.

Pour quel public

Adapté :
- Applications avec un administrateur actif et disponible pour traiter les litiges (forum communautaire, association, e-commerce indépendant, boutique en ligne militante)
- Sites où la sécurité prime sur la fluidité de récupération (services manipulant des données sensibles)
- Communautés à taille humaine (du forum de 50 membres au service de quelques milliers d'utilisateurs)

Non adapté :
- Plateformes à très grande échelle sans admin individuel (réseaux sociaux massifs, services publics avec millions d'utilisateurs) — le volume de litiges dépasse les capacités d'un humain réactif
- Services où une friction de récupération est inacceptable (gaming compétitif, services temps-réel)
- Projets sans maintenance active (l'admin doit pouvoir répondre aux litiges dans des délais raisonnables)

Pour ces cas, un IAM mature comme Keycloak avec ses mécanismes éprouvés reste plus adapté.

Modèle de menace assumé

Pour la transparence, voici les classes d'adversaires explicitement hors périmètre du protocole :

  • Compromission du poste utilisateur (logiciels malveillants, RAT, keyloggers) — un attaquant qui contrôle le poste peut capturer la passphrase à la saisie, indépendamment du protocole.
  • Compromission du navigateur (extensions malveillantes, exploits 0-day) — même cause, même effet : si le moteur JS qui calcule HMAC est compromis, la sortie l'est aussi.
  • Coercition physique — SelfRecover n'offre pas de plausible deniability (pas de second compte caché ou décoy).
  • Cryptanalyse théorique de SHA-256 / HMAC / Argon2id — un cassage mathématique de ces primitives mettrait à mal la quasi-totalité des systèmes cryptographiques modernes, pas seulement SelfRecover.

Ces limitations sont le périmètre normal d'un protocole côté navigateur. Pour les usages à plus haute exigence (cérémonies cryptographiques sensibles, génération initiale de clé maître), MySelf-Live est annoncé dans la roadmap V0.2 : une distribution Linux Live USB minimale, RAM-only, signée GPG, qui isolerait les opérations sensibles du système hôte. Pour les usages courants à fort enjeu, Tails ou Qubes OS offrent déjà ce niveau d'isolation et sont recommandés.

Démos en ligne

Aucune inscription préalable n'est requise. Les données sont éphémères côté serveur.

Code et image Docker

docker run -p 8080:8080 ghcr.io/pierroons/selfrecover:v0.1.1

La démo de référence tourne sur PHP 8.0+ et SQLite (~600 lignes auditables, zéro dépendance externe). Tag GPG-signé v0.1.1, release datée du 5 mai 2026.

Licence et philosophie

AGPL-3.0-or-later. Toute version déployée publiquement doit publier ses modifications sous la même licence. Pas de capture SaaS possible.

SelfRecover est une brique du méta-projet MySelf, un écosystème de modules auto-hébergés qui couvre l'identité, la modération communautaire, le droit, et l'agriculture.

Un module complémentaire répond de manière directe à la problématique illustrée par l'incident ANTS : SelfDataGuard chiffre les données utilisateur côté client de telle sorte qu'une fuite de base de données ne livre que des blobs inexploitables. Le code est public, AGPL, en v0.1.0-beta — une dépêche dédiée pourra suivre quand le module aura plus de maturité (audit communautaire, retours d'intégration).

Note de transparence

Conception en partenariat avec un assistant IA

Ce protocole a été conçu et codé en partenariat avec un assistant IA (Claude), comme outil de réflexion, de revue critique, et d'écriture de code.

Pour être totalement transparent : je ne suis pas développeur de formation. Mon expérience technique vient du dev web amateur (ARC PVE Hub, un site destiné à fédérer une communauté de joueurs ; un outil de gestion de stock pour mon entreprise ; quelques sites perso). Pour SelfRecover, l'écriture des primitives cryptographiques et la mise en œuvre du protocole ont été largement assistées par l'IA, sur la base de mes choix architecturaux et de ma vision.

Ce qui vient de moi (humain) :
- La vision (souveraineté numérique, refus du SMTP comme canal de récupération)
- Les choix philosophiques (AGPL-3.0-or-later, fallback humain assumé, aucune destruction de données sans validation humaine consciente)
- Le contexte initial (besoin né en développant ARC PVE Hub)
- Chaque décision de trade-off d'architecture
- La responsabilité juridique et morale du code publié sous mon nom et signé GPG

Ce qui vient de l'IA :
- L'écriture des primitives cryptographiques (HMAC, dérivations, vérifications)
- L'agencement du code, la structure des fichiers
- La formalisation des paragraphes du whitepaper et de cette dépêche
- La génération de tests unitaires
- La vérification de cohérence interne

Plan d'audit

  • Auto-audit interne : en cours et continu (chaque modification est relue critiquement)
  • Audit communautaire : ouvert dès maintenant, je réponds aux remarques techniques avec sérieux (cette dépêche en est l'illustration directe)
  • Audit tiers certifié : envisagé à moyen terme via un cabinet agréé CESTI ANSSI (Synacktiv, Quarkslab, Wavestone, ou équivalent), sous réserve de financement

Statut du projet

SelfRecover en est à la version 0.1.1, taguée GPG et signée. C'est un état PoC fonctionnel + déployé en production sur un site réel (ARC PVE Hub), mais pas encore mature pour une adoption massive dans des contextes à fort enjeu. La roadmap V0.2 (MySelf-Live, finalisation du chatbot L3, audit tiers) précisera ce périmètre.

Engagement communauté LinuxFr et culture du libre

Mon compte LinuxFr est récent, mais mon ancrage dans la culture du libre ne l'est pas : utilisateur exclusif de distributions Linux depuis quinze ans (principalement Debian), j'ai aidé plusieurs proches à migrer des PC anciens vers Debian pour leur donner une seconde vie au lieu de la déchèterie. J'arrive sur LinuxFr depuis le monde agricole/permaculture et le jeu vidéo (ARC PVE Hub), pas du milieu dev historique.

Je suis salarié couvreur dans une PME et installé en agriculture à temps partiel — mon temps libre pour le développement et la participation communautaire est compté. Je m'engage à répondre aux retours techniques sur cette dépêche et à suivre les disputes sur l'état du projet. Pour le reste (commentaires réguliers, dépêches futures sur d'autres modules MySelf — en particulier SelfDataGuard quand il sera plus mature), ce sera au gré du temps disponible, sans promesse.

Toute critique technique constructive est bienvenue. Pour les critiques sur la légitimité du projet ou la nature humain/IA de la collaboration, j'invite à juger sur les choix concrets, le code public, et la qualité des réponses à vos questions.

Pour aller plus loin

SelfRecover est un module de l'écosystème MySelf, expérimentation citoyenne sur la souveraineté numérique sous licence AGPL-3.0-or-later.

Les retours techniques, audits communautaires, propositions d'intégration et questions de fond sont les bienvenus — en commentaire de cette dépêche ou en issue sur le repo GitHub.

Si une administration ou une organisation souhaite tester le protocole en environnement isolé, l'image Docker et le Dockerfile sont à disposition. Aucune démarche commerciale n'est associée à cette publication.

Merci aux modérateurs et contributeurs de LinuxFr — Pierre Jarillon, devnewton, Florent Zara, bobble bubble — dont les retours pendant la phase de rédaction ont substantiellement amélioré cette dépêche.

Commentaires : voir le flux Atom ouvrir dans le navigateur

9 années de wallabag.it, merci Pocket

wallabag est une application open source (licence MIT) qui sauvegarde des articles et vous permet de les lire plus tard, sur votre smartphone, votre tablette ou votre liseuse.

Un peu plus tard que les années précédentes, je prends le temps de rédiger ce billet. Le début d’année a été (et est encore) chargé, avec notamment les élections municipales, mais ce n’est pas le sujet.

Deuxième année spéciale, avec là encore, la fermeture d’un concurrent. Et non des moindres : l’historique Pocket.

Ça a généré un afflux massif de nouveaux clients, vous le verrez ci-dessous.

On en reparle dans la partie conclusion.

En parallèle de cette activité (en micro-entrepreneur), je suis salarié à 80% en tant que développeur web. Donc wallabag.it n’est pas mon activité principale et je n’y consacre pas énormément de temps. Et je ne fais aucune publicité du service.

C’est uniquement le bouche-à-oreille qui fonctionne.

Pour information, j’ai démarré wallabag.it le 3 décembre 2016.

Dans cette diffusion de données, je ne vais pas forcément chercher à comprendre / étudier telle ou telle donnée, ou alors réfléchir comment améliorer mon chiffre d’affaires. L’idée est d’être transparent avec mes clients et donner des idées à celles et ceux qui souhaiteraient se lancer.

Je ne vais pas non plus refaire l’historique du changement d’offres, ça se trouve dans les billets cités ci-dessous.

Voici les offres disponibles :

  • 3 mois pour 4 €
  • 1 an pour 11 €
  • 1 an pour 30 € (abonnement de soutien)

Nombre de factures

Une facture est un abonnement, peu importe que ça soit pour 3 mois ou 1 an, et peu importe sa valeur.

  • 2016 : 89 (un seul mois d’activité)
  • 2017 : 662 factures
  • 2018 : 787 factures (+18,9%)
  • 2019 : 959 factures (+21,9%)
  • 2020 : 1.266 (+32%)
  • 2021 : 1.526 (+20,5%)
  • 2022 : 1.531 (+0,3%)
  • 2023 : 1.496 (−2,3%)
  • 2024 : 1.656 (+10,7%)
  • 2025 : 3.281 (+98,1%)

Nombre moyen mensuel de factures :

  • 2016 : 89 (un seul mois d’activité)
  • 2017 : 55 factures / mois
  • 2018 : 65 factures / mois
  • 2019 : 79,9 factures / mois
  • 2020 : 105,5 factures / mois
  • 2021 : 127 factures / mois
  • 2022 : 127 factures / mois
  • 2023 : 125 factures / mois
  • 2024 : 138 factures / mois
  • 2025 : 273 factures / mois

Chiffre d’affaires (CA)

  • 2016 : 783 € (un seul mois d’activité)
  • 2017 : 6.093 €
  • 2018 : 7.593 € (+24,6%)
  • 2019 : 9.481 € (+24,9%)
  • 2020 : 12.922 € (+36,3%)
  • 2021 : 15.460 € (+21,5%)
  • 2022 : 15.735 € (+1,8%)
  • 2023 : 16.499 € (+4,9%)
  • 2024 : 19.536 € (+18,4%)
  • 2025 : 38.012 € (+94,6%)

CA mensuel moyen :

  • 2016 : 783 € (un seul mois d’activité)
  • 2017 : 507 €
  • 2018 : 632 €
  • 2019 : 790 €
  • 2020 : 1.076 €
  • 2021 : 1.288 €
  • 2022 : 1.311 €
  • 2023 : 1.375 €
  • 2024 : 1.628 €
  • 2025 : 3.167 €

Abonnement moyen (en moyenne, combien un client paie pour s’abonner) :

  • 2016 : 8,80 €
  • 2017 : 9,19 €
  • 2018 : 9,54 €
  • 2019 : 9,83 €
  • 2020 : 10,20 €
  • 2021 : 10,09 €
  • 2022 : 10,23 €
  • 2023 : 11,21 €
  • 2024 : 11,80 €
  • 2025 : 11,53 €

Type d’abonnements

  • 2017 : 342 abonnements à 9 € (+145 à 12 €, prix au départ de l’abonnement), 32 abonnements à 25 € et 80 abonnements à 3 € .* 2018 : 532 abonnements à 9 €, 93 abonnements à 25 € et 161 abonnements à 3 €
  • 2019 : 668 abonnements à 9 €, 118 abonnements à 25 € et 173 abonnements à 3 €
  • 2020 : 853 abonnements à 9 €, 173 abonnements à 25 € et 240 abonnements à 3 €
  • 2021 : 1084 abonnements à 9 €, 199 abonnements à 25 € et 243 abonnements à 3 €
  • 2022 : 1098 abonnements à 9 €, 207 abonnements à 25 € et 226 abonnements à 3 €
  • 2023 : 668 abonnements à 9 € et 398 abonnements à 11 €, 103 abonnements à 25 € et 91 abonnements à 30 €, 140 abonnements à 3 € et 96 abonnements à 4 €
  • 2024 : 1 202 abonnements à 11€, 173 abonnements à 30€ et 281 abonnements à 4€
  • 2025 : 2 352 abonnements à 11€, 324 abonnements à 30€ et 605 abonnements à 4€

Dépenses

En 2025, j’ai dépensé pour 2 372 € de frais (hébergement, nom de domaine, prestation admin sys, etc.), soit 198€ en moyenne par mois.
J’ai payé 2 207 € de commissions pour PayPal, PayPlug et Stripe, mes prestataires de paiement en ligne.
J’ai également payé environ 8 760 € de cotisations sociales.

Total : 13 340 €

Résultat net

  • 2017 : 3 130 €
  • 2018 : 3 454 €
  • 2019 : 4 823 €
  • 2020 : 6 591 €
  • 2021 : 9 034 €
  • 2022 : 9 401 €
  • 2023 : 9 977 €
  • 2024 : 12 171 €
  • 2025 : 24 672 €

Conclusion

Cette année 2025 a été folle en termes de nombre de nouveaux clients. Tous les chiffres ont explosés.

Et je vais avouer une chose : je suis très partagé sur tout ça.

Courant juin, j’ai eu peur de ne pas être capable d’absorber toute cette nouvelle charge. Ça a tenu (merci Luc pour l’infrastructure).

Mais par contre, je me sens parfois mal à l’aise vis-à-vis du projet opensource, sur lequel j’ai du mal à passer du temps. Et j’ai du mal aussi à suivre le support wallabag.it, avec pas mal de mails en attente à traiter.

Je ne me suis jamais fixé d’objectif d’une année sur l’autre. Mais clairement, 2026 ne fera pas mieux que 2025. Pour rappel, je ne fais aucune publicité pour trouver de nouvelles personnes.

De plus, l’arrivée de l’IA risque de chambouler un peu le secteur. De plus en plus d’applis voient le jour, donc ça risque de disperser les clients.

Autre problématique liée à l’IA : de plus en plus de sites bloquent le fait de « crawler » un site web et donc wallabag (et mon serveur) se voit bloqué à droite à gauche par des sites de contenus.

RDV l’an prochain pour faire le bilan des 10 années d’activité de ma micro-entreprise !

Commentaires : voir le flux Atom ouvrir dans le navigateur

L’année 2025 pour le projet PrestaShop

Les nouvelles les plus récentes sur LinuxFR concernant PrestaShop remontent à bientôt trois ans, une éternité dans le monde de l’édition de solutions web.

Pour rappel, PrestaShop est un système de gestion de contenu (CMS) libre français de commerce en ligne, développé en PHP et placé sous licence OSL v3.

En cette fin d’année 2025, regardons quelles sont les nouveautés des douze mois écoulés.

(Déclaration d’intérêts : je suis salarié PrestaShop SA)

10 juin : sortie de PrestaShop 9

Après plus de deux ans de développement et de collaboration avec la communauté, cette version majeure apporte son lot de nouveautés, principalement sous le capot. Avec, entre autres, le passage à Symfony 6.4 (version LTS), la compatibilité avec PHP 8.4 ou encore une toute nouvelle API d’administration.

La liste complète des nouveautés est disponible dans les notes de publication (en anglais)

Juillet et août : appel aux contributions externes

Le projet PrestaShop, depuis sa genèse, est open source et ouvert à toute forme de contribution : développement, rapport de bugs, traductions, écriture de documentation, etc.

Au quotidien, ce projet est également soutenu par l’entreprise PrestaShop SA.

Durant cette année, cette dernière a souhaité améliorer le suivi des contributions externes. C’est pourquoi il a été décidé de proposer à la communauté deux thématiques ciblées : les hooks (billet en anglais) et l’API Admin (billet en anglais) .

Il y a quelques semaines, un point d’étape concernant les contributions sur l’API Admin a été publié sur le blog du projet (en anglais).

4 septembre : sortie de PrestaShop 8.2.3

Depuis la publication de PrestaShop 9, la branche 8.2 est en support étendu, ce qui veut dire que seuls des correctifs de sécurité sont traités.

C’est pourquoi début septembre, la version 8.2.3 a vu le jour, suite la découverte d’une faille sur la page de réinitialisation du mot de passe.

Le billet de blog est disponible en anglais.

8 décembre : ménage de printemps d’hiver

L’écosystème PrestaShop, ce sont des dizaines de dépôts, des centaines de contributeurices et des milliers de tickets ouverts.

Il a été proposé de revoir la manière dont sont gérés les tickets, afin d’aider la communauté à mieux s’y retrouver.

C’est pourquoi il est maintenant possible d’ouvrir un ticket (pour déclarer un bug ou demander une nouvelle fonctionnalité) sur certains dépôts directement. Auparavant, tout était centralisé sur le projet PrestaShop directement et il était devenu très compliqué, pour les personnes en charge de traiter les plus de 2 300 tickets d’être efficaces.

Toute la nouvelle organisation et les différentes étapes sont disponibles en anglais.

15 décembre : PrestaShop 9.1, levez les stylos !

Et voila, on ne touche plus à cette version, en cours de développement depuis plusieurs mois, et on entre dans une phase de « feature freeze » : plus aucune nouveauté ne sera ajoutée. C’est une période pour tester cette version importante qui apportera notamment un nouveau thème par défaut (Hummingbird), un système de création de promotions revu et amélioré et aussi la possibilité d’assigner plusieurs transporteurs sur une seule commande.

Vous souhaitez tester cette future version et aider la communauté à stabiliser tout cela, n’hésitez pas à lire cette page publiée récemment.

Et en 2026, quel programme ?

La procédure de livraison de PrestaShop 9.1 continuera son cours, avec la sortie de versions Release Candidate et bien sûr, une version finale. Pas de date à donner, c’est toujours plus sage d’être prudent.

Entamé depuis plusieurs années, le chantier de réécriture du backoffice poursuivra son cours, avec la migration vers Symfony.

En tout cas, l’année 2026 sera importante pour le projet et sa communauté, mais nous aurons le temps d’en reparler dans quelques semaines !

Commentaires : voir le flux Atom ouvrir dans le navigateur

Pocket est mort, vive wallabag

Pocket était une application permettant de gérer une liste d'articles lus sur Internet. Elle a été créée en août 2007 par Nathan Weiner, puis est devenue gratuite avec option Premium en 2012. Acquis en 2017 par Mozilla, le service a annoncé le 22 mai 2025 sa fermeture prochaine. (source Wikipedia).

Ainsi, depuis le 8 juillet 2025, il n'est plus possible d'archiver ses contenus via Pocket, seul l'export de ses données est réalisable. Courant octobre, l'export sera également coupé.

Une alternative à Pocket

Depuis maintenant plus de 12 ans, une alternative à ce service privateur existe : il s'agit de wallabag. Nous avons déjà régulièrement parlé de notre projet sur LinuxFR.org.

Suite à l'annonce de la fermeture de Pocket, l'équipe de développement s'est organisée afin de proposer un import possible depuis le CSV fourni.

C'est pourquoi une version 2.6.13 est disponible depuis le 4 juin.

Mettre à jour votre instance

Depuis quelques versions, c’est relativement simple de mettre à jour votre wallabag : vous n’avez qu’à exécuter la commande make update. Si vous le souhaitez, vous trouverez plus d’informations sur le billet de blog du projet.

La suite

Dans quelques semaines, l'équipe aimerait sortir une nouvelle version importante. Outre de nouvelles fonctionnalités (comme par exemple un sélecteur de police de caractères), c'est surtout une montée de version technique nécessaire afin d'assurer la pérennité du projet.

Pour rappel, si vous ne souhaitez pas héberger votre instance de wallabag, il est possible d’utiliser le service en ligne wallabag.it.

Commentaires : voir le flux Atom ouvrir dans le navigateur

Dévoilement de l'édition ConFoo 2025 !

La conférence ConFoo est de retour pour sa 23e édition, du 26 au 28 février 2025 à l’Hôtel Bonaventure de Montréal !

logo confoo.ca

Avec plus de 190 présentations offertes par une centaine d’experts de partout à travers le monde, venez découvrir pourquoi Confoo est devenu l’un des événements phares pour les développeurs en Amérique du Nord et de partout à travers le monde.

Notre programmation officielle est d’ailleurs disponible dès maintenant sur notre site web! Consultez nos toutes nouvelles présentations axées sur le développement FullStack OpenSource, l’intelligence artificielle, le devops et plus encore. Organisé au cœur d’un environnement spécialement conçu pour les développeurs, ConFoo est aussi l’endroit parfait pour rencontrer de potentiels employeurs et réseauter avec les meilleurs de l’industrie.

Réservez vos billets dès maintenant et profitez d’un rabais de 175$ sur votre inscription jusqu’au 13 décembre !

Faites partie de l’aventure et découvrez comment l’intelligence humaine façonne le milieu des hautes technologies!

Commentaires : voir le flux Atom ouvrir dans le navigateur

ConFoo Montreal 2025 : l’appel à conférences est ouvert

La conférence ConFoo est de retour pour sa 23ᵉ édition, du 26 au 28 février 2025 à l’Hôtel Bonaventure de Montréal ! Venez découvrir pourquoi ConFoo est devenu l’un des événements phares pour les développeurs et développeuses en Amérique du Nord et de partout à travers le monde.

Nous sommes présentement à la recherche de conférenciers et de conférencières avides de partager leur expertise et leur savoir dans une multitude de domaines des hautes technologies ; PHP, Ruby, Java, DotNet, JavaScript, Intelligence Artificielle, et plus encore !

Offertes en français ou en anglais, nos présentations sont généralement d’un format de 45 minutes, incluant un 10 minutes de questions des participants. Nos conférenciers et conférencières invitées profitent d’un traitement privilégié ; avec notamment la couverture de leurs frais de déplacement et d’hébergement, en plus de l’accès à l’expérience complète de l’événement (présentations, repas, etc.).

Vous avez jusqu’au 22 septembre prochain pour soumettre votre projet de présentations !

Si vous souhaitez simplement vous inscrire en tant que participant, profitez dès maintenant d’un rabais de 300$ en réservant votre inscription d'ici au 18 octobre !

Faites partie de l’aventure avec nous et découvrez comment l’intelligence humaine façonne le milieu des hautes technologies !

Commentaires : voir le flux Atom ouvrir dans le navigateur

❌