❌

Vue normale

Il y a de nouveaux articles disponibles, cliquez pour rafraîchir la page.
À partir d’avant-hierFlux principal

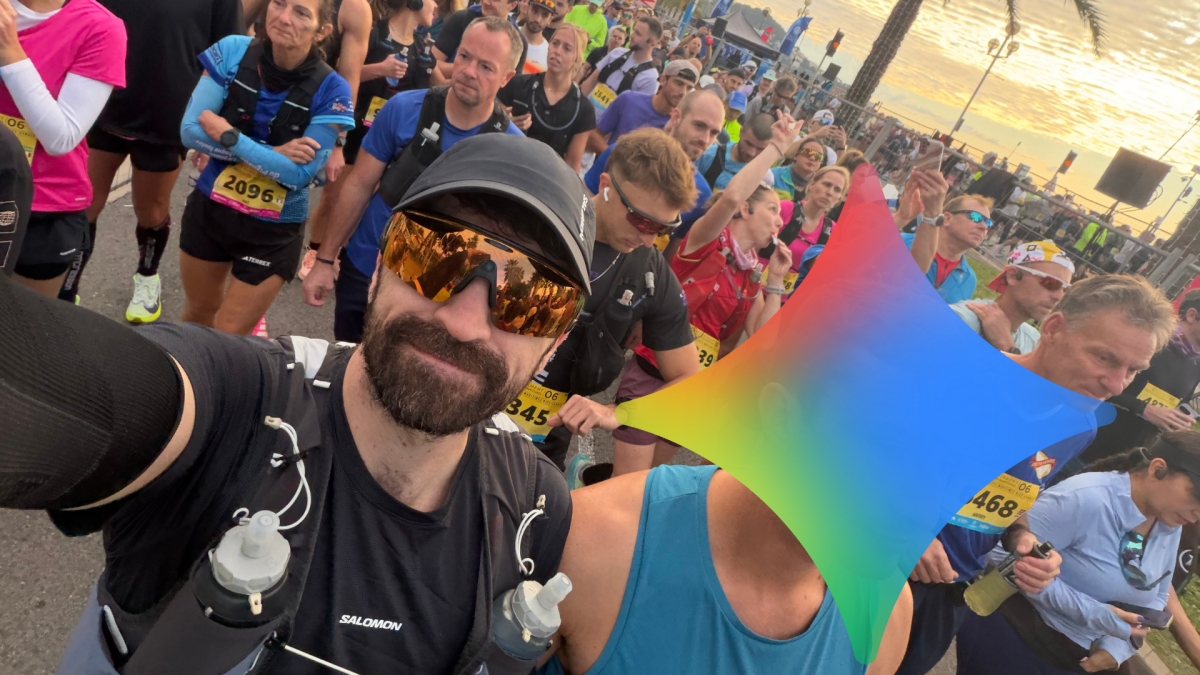
J’ai laissé Gemini me coacher pour mon premier marathon : il m’a menti avec aplomb

Cinq mois de préparation, des dizaines de fichiers CSV commentés, un plan pyramidal impeccable sur le papier… et une explosion au 22e kilomètre que Gemini n'avait pas vue venir. Claude lui, avait tout anticipé. Retour d'expérience sur mon premier marathon, et sur ce qu'on doit vraiment attendre d'un coach artificiel.

Microsoft apporte une mise à jour majeure de Copilot Chat dans Visual Studio 2026, en dotant l'assistant IA d'un nouveau moteur alimenté par le SDK Microsoft Copilot, développé par GitHub

Microsoft apporte une mise à jour majeure de Copilot Chat dans Visual Studio 2026, en dotant l'assistant IA d'un nouveau moteur alimenté par le SDK Microsoft Copilot, développé par GitHub

Microsoft a apporté une mise à jour majeure de Copilot dans Visual Studio : à partir de la version 18.12 de Visual Studio 2026, Copilot Chat s'appuiera désormais sur le SDK Microsoft Copilot, la même technologie qui alimente l'interface CLI de GitHub Copilot, l'application GitHub Copilot et VS Code. Des tests menés...

  • ✇PandIA
  • Comment utiliser l’IA pour créer des présentations de données accessibles
    L’IA peut aider à créer des présentations de données accessibles, compréhensibles et adaptées aux personnes en situation de handicap. Ce guide explique comment utiliser l’intelligence artificielle pour analyser des données, concevoir des graphiques lisibles, générer des textes alternatifs et vérifier l’accessibilité d’un diaporama.Qu’est-ce qu’une présentation de données accessible ?Une présentation de données accessible peut être consultée et comprise par le plus grand nombre, y compris par les

Comment utiliser l’IA pour créer des présentations de données accessibles

Par : 0xMonkey
14 novembre 2026 à 12:05
Comment utiliser l’IA pour créer des présentations de données accessibles

L’IA peut aider à créer des présentations de données accessibles, compréhensibles et adaptées aux personnes en situation de handicap. Ce guide explique comment utiliser l’intelligence artificielle pour analyser des données, concevoir des graphiques lisibles, générer des textes alternatifs et vérifier l’accessibilité d’un diaporama.

Qu’est-ce qu’une présentation de données accessible ?

Une présentation de données accessible peut être consultée et comprise par le plus grand nombre, y compris par les personnes :

  • utilisant un lecteur d’écran ;
  • ayant une déficience visuelle, auditive, motrice ou cognitive ;
  • présentant une difficulté de lecture ou de compréhension ;
  • consultant les diapositives sur un petit écran ou dans un environnement peu lumineux ;
  • ne maîtrisant pas parfaitement la langue utilisée.

L’accessibilité ne concerne donc pas uniquement le contraste des couleurs. Elle englobe également la structure du contenu, la clarté du vocabulaire, l’ordre de lecture, la lisibilité des graphiques, la présence de sous-titres et la possibilité de naviguer au clavier.

Pour les contenus numériques, les bonnes pratiques s’appuient notamment sur les WCAG 2.2 et, en France, sur le RGAA. Une présentation créée avec l’aide d’une IA n’est pas automatiquement conforme à ces référentiels : chaque élément doit être contrôlé.

Pourquoi utiliser l’IA pour rendre une présentation accessible ?

L’intelligence artificielle peut accélérer plusieurs tâches chronophages :

  • résumer un jeu de données ;
  • repérer les tendances et les valeurs atypiques ;
  • proposer une structure de présentation ;
  • simplifier un texte trop technique ;
  • générer des titres de diapositives ;
  • rédiger des descriptions d’images et de graphiques ;
  • suggérer une palette de couleurs contrastée ;
  • produire des notes orales pour le présentateur ;
  • identifier certains problèmes de lisibilité ;
  • transformer un tableau complexe en message clé.

L’IA est particulièrement utile lors de la phase de préparation. Elle peut proposer plusieurs façons d’expliquer la même information selon le public : direction, clients, étudiants, équipe technique ou grand public.

Cependant, l’IA ne comprend pas toujours le contexte métier et peut produire des erreurs, des chiffres inventés ou des descriptions incomplètes. Elle doit donc être utilisée comme un assistant de conception et de contrôle, jamais comme une garantie d’accessibilité.

Avant de demander une présentation à l’IA : préparer les données

La qualité de la présentation dépend fortement de la qualité des données fournies à l’outil.

Nettoyer et documenter le jeu de données

Avant toute génération, il est recommandé de :

  1. supprimer les colonnes inutiles ;
  2. harmoniser les formats de dates, de pourcentages et de devises ;
  3. vérifier les doublons ;
  4. identifier les valeurs manquantes ;
  5. expliquer les acronymes et les unités ;
  6. préciser la période étudiée ;
  7. distinguer les données réelles des estimations ;
  8. documenter la source de chaque indicateur.

Une IA peut interpréter une colonne « taux » comme un nombre décimal, un pourcentage ou un ratio. La consigne doit donc préciser le sens exact des valeurs.

Anonymiser les informations sensibles

Il est déconseillé de copier dans un outil d’IA grand public :

  • des données personnelles ;
  • des informations médicales ;
  • des données clients ;
  • des secrets commerciaux ;
  • des identifiants ;
  • des résultats financiers confidentiels.

Avant l’envoi, les noms peuvent être remplacés par des identifiants génériques et les valeurs sensibles par des données agrégées. Il faut également vérifier la politique de conservation et de réutilisation des données du service utilisé.

Comment demander à l’IA de concevoir une présentation accessible ?

Une demande efficace précise à la fois le contenu, le public et les contraintes d’accessibilité.

Les éléments à inclure dans le prompt

Un bon prompt peut préciser :

  • le sujet de la présentation ;
  • le public visé ;
  • l’objectif principal ;
  • le nombre maximal de diapositives ;
  • les données à analyser ;
  • le message clé à faire ressortir ;
  • le niveau de langage ;
  • les contraintes visuelles ;
  • les règles d’accessibilité à respecter ;
  • le format de sortie attendu.

Exemple de prompt général

Analyse ce jeu de données et propose une présentation de 8 diapositives destinée à un public non spécialiste. Pour chaque diapositive, indique le titre, le message principal, les données à afficher, le type de graphique recommandé et un texte alternatif compréhensible par une personne qui ne voit pas le graphique. Utilise un langage clair, n’invente aucune donnée, signale les incertitudes et évite de transmettre une information uniquement par la couleur.

Pour obtenir un résultat plus fiable, il est préférable de demander à l’IA de séparer les faits, les interprétations et les recommandations.

Exemple de consigne pour une analyse de données

À partir des données fournies, identifie les trois tendances les plus importantes, les variations significatives et les valeurs atypiques. Pour chaque observation, cite les valeurs concernées et précise si la conclusion est certaine ou dépend d’une hypothèse. Ne complète pas les données manquantes.

Cette formulation limite les interprétations excessives et facilite la vérification.

Choisir le bon type de graphique

L’IA peut recommander un graphique, mais le choix final doit dépendre du message à transmettre.

Graphiques adaptés aux principaux besoins

  • Courbe : évolution dans le temps.
  • Barres horizontales : comparaison de catégories, notamment lorsque les libellés sont longs.
  • Barres verticales : comparaison d’un nombre limité de valeurs.
  • Graphique en points : relation entre deux variables.
  • Carte : comparaison géographique, uniquement si la dimension spatiale est pertinente.
  • Tableau : valeurs exactes, faible nombre de lignes ou besoin de consultation détaillée.
  • Diagramme circulaire : à limiter aux répartitions simples comportant peu de catégories.

Les graphiques en trois dimensions, les effets décoratifs et les visualisations trop complexes rendent souvent la lecture plus difficile. L’IA doit être invitée à privilégier la simplicité visuelle.

Ne pas dépendre uniquement de la couleur

Un graphique accessible ne doit pas distinguer les catégories uniquement par le rouge, le vert ou des nuances proches. Il faut ajouter :

  • des libellés directement sur les données ;
  • des motifs ou des textures si nécessaire ;
  • des formes distinctes ;
  • des annotations ;
  • une légende explicite ;
  • un tableau de données associé.

Une consigne utile est la suivante :

Conçois un graphique compréhensible sans distinguer les séries uniquement par la couleur. Ajoute des libellés textuels, une légende claire et une version tabulaire des valeurs importantes.

Concevoir des diapositives lisibles avec l’IA

Structurer une idée par diapositive

Une diapositive devrait généralement répondre à une question précise. Au lieu d’un titre vague comme « Résultats », il est préférable d’utiliser un titre informatif :

  • « Le taux de conversion progresse de 18 % en six mois »
  • « Les utilisateurs mobiles représentent la majorité des visites »
  • « Trois régions concentrent 70 % des demandes »

L’IA peut transformer des titres descriptifs en titres orientés vers le message clé :

Réécris ces titres de diapositives pour qu’ils expriment directement la conclusion principale, sans exagérer les résultats et sans ajouter d’information absente des données.

Limiter le contenu visuel

Une présentation accessible doit éviter :

  • les paragraphes très longs ;
  • les textes placés sur des images ;
  • les polices trop petites ;
  • les animations rapides ;
  • les tableaux illisibles ;
  • les alignements irréguliers ;
  • les arrière-plans chargés ;
  • les contrastes faibles.

L’IA peut proposer une version courte du contenu, mais les suppressions doivent être contrôlées. Une information essentielle ne doit pas disparaître uniquement pour respecter une limite arbitraire de mots.

Utiliser une typographie lisible

Il est conseillé de :

  • privilégier une police sans empattement facilement lisible ;
  • conserver une taille suffisamment grande pour une projection ;
  • éviter les textes entièrement en capitales ;
  • utiliser une graisse et un espacement réguliers ;
  • ne pas justifier les paragraphes courts ;
  • conserver une hiérarchie constante entre titre, sous-titre et contenu.

La taille minimale dépend du support et de la distance de lecture. Une présentation destinée à une salle de réunion nécessite des caractères plus grands qu’un document consulté individuellement sur ordinateur.

Générer des textes alternatifs avec l’IA

Les textes alternatifs permettent à une personne utilisant un lecteur d’écran de comprendre le rôle d’une image ou d’un graphique.

Ce qu’un bon texte alternatif doit contenir

Pour un graphique, la description peut indiquer :

  1. le type de visualisation ;
  2. le sujet mesuré ;
  3. la période ;
  4. la tendance principale ;
  5. les valeurs importantes ;
  6. la conclusion à retenir.

Exemple :

Graphique en barres comparant le nombre de demandes clients par trimestre en 2024. Les demandes passent de 1 200 au premier trimestre à 1 850 au quatrième, soit une hausse globale de 54 %. Le troisième trimestre marque une progression plus modérée.

Une description comme « graphique des ventes » est trop vague.

Quand laisser une image décorative sans description ?

Une image purement décorative peut être marquée comme telle afin que le lecteur d’écran l’ignore. En revanche, une photo qui illustre une situation, une capture d’écran contenant une information ou un graphique essentiel doit être décrit.

Prompt pour un texte alternatif

Rédige un texte alternatif de 50 à 80 mots pour ce graphique. Décris uniquement les informations nécessaires à sa compréhension. Indique les tendances, les valeurs extrêmes et la conclusion principale. N’utilise pas de termes visuels vagues comme « on voit clairement ». Vérifie que le texte ne contient aucune donnée absente du graphique.

Le texte alternatif ne remplace pas toujours les données détaillées. Pour un graphique complexe, il est préférable de fournir également un tableau accessible ou une annexe avec les valeurs exactes.

Rendre les tableaux accessibles

Les tableaux sont parfois plus accessibles que les graphiques, car ils donnent directement les valeurs. Ils deviennent toutefois difficiles à consulter lorsqu’ils contiennent trop de colonnes ou de niveaux de regroupement.

Bonnes pratiques :

  • donner un titre explicite au tableau ;
  • utiliser une ligne d’en-tête identifiable ;
  • éviter les cellules fusionnées ;
  • conserver des en-têtes courts ;
  • préciser les unités ;
  • aligner les nombres de manière cohérente ;
  • afficher les valeurs complètes dans une annexe ;
  • ne pas utiliser uniquement la couleur pour signaler une hausse ou une baisse.

L’IA peut transformer un tableau complexe en deux versions :

  1. une version synthétique destinée à la diapositive ;
  2. une version détaillée destinée à un document complémentaire.

Ajouter des sous-titres et une alternative au contenu audio

Toute vidéo intégrée doit comporter des sous-titres synchronisés, idéalement relus manuellement. Les sous-titres générés automatiquement peuvent contenir des erreurs sur les noms propres, les chiffres ou le vocabulaire technique.

Pour un contenu audio, une transcription textuelle doit être disponible. Si la présentation est commentée en direct, les notes du présentateur peuvent servir de base à une version écrite distribuée après la réunion.

L’IA peut aider à :

  • transcrire un enregistrement ;
  • identifier les intervenants ;
  • simplifier le vocabulaire ;
  • générer un résumé ;
  • repérer les termes mal transcrits.

Une vérification humaine reste indispensable, surtout lorsque l’audio contient des nombres, des acronymes ou des informations sensibles.

Quels outils d’IA utiliser ?

Le choix dépend du format de travail et du niveau de contrôle recherché.

Assistants intégrés aux logiciels de présentation

Certains logiciels de présentation proposent des fonctions d’IA capables de générer une structure, de reformuler un contenu ou de créer une mise en page à partir d’un document. Ces assistants sont pratiques pour produire une première version, mais les réglages d’accessibilité doivent être vérifiés séparément.

Outils de conception graphique

Les plateformes de conception assistée par IA peuvent proposer des modèles, des palettes et des compositions visuelles. Elles sont utiles pour la mise en forme, mais les modèles très décoratifs ne sont pas toujours adaptés aux lecteurs d’écran, au contraste ou à la lecture sur mobile.

Assistants généralistes

Un assistant conversationnel peut servir à :

  • analyser la structure d’un diaporama ;
  • rédiger des descriptions de graphiques ;
  • reformuler les titres ;
  • produire une liste de vérification ;
  • identifier les informations manquantes ;
  • préparer un script oral.

Pour éviter les erreurs, les données sources doivent être conservées et comparées avec chaque résultat généré.

Quand vérifier l’accessibilité ?

La vérification doit intervenir à plusieurs moments :

  • avant la conception, pour définir les contraintes ;
  • après la création de la structure, pour vérifier la logique ;
  • après l’ajout des graphiques, pour contrôler les descriptions ;
  • avant l’export, pour vérifier l’ordre de lecture ;
  • après l’export en PDF, car certains éléments peuvent être modifiés ;
  • avant la diffusion, avec un test humain si possible.

Attendre la dernière minute rend les corrections plus longues, notamment lorsque les graphiques, les animations ou la mise en page sont déjà finalisés.

Combien de temps faut-il prévoir ?

Le temps varie selon le nombre de diapositives, la complexité des données et le niveau d’exigence.

À titre indicatif :

  • une présentation simple de 5 à 10 diapositives peut être préparée rapidement avec une IA, mais nécessite une relecture complète ;
  • un rapport comportant de nombreux graphiques demande une vérification de chaque description et de chaque tableau ;
  • une présentation réglementaire ou destinée au grand public doit faire l’objet de tests plus poussés.

L’IA peut réduire le temps de rédaction et de mise en forme, mais elle ne supprime pas le temps nécessaire à la validation des chiffres, à la relecture et aux tests d’usage.

Contrôler concrètement l’accessibilité d’une présentation

Avant la diffusion, cette liste de contrôle permet de repérer les principaux problèmes :

Structure

  • Les titres suivent-ils un ordre logique ?
  • Chaque diapositive porte-t-elle un titre unique et explicite ?
  • Le contenu peut-il être compris sans les animations ?
  • L’ordre de lecture est-il cohérent avec la structure visuelle ?

Texte

  • Le vocabulaire est-il adapté au public ?
  • Les acronymes sont-ils expliqués ?
  • Les phrases sont-elles suffisamment courtes ?
  • La taille et le contraste des caractères sont-ils suffisants ?

Graphiques et images

  • Chaque image informative possède-t-elle un texte alternatif ?
  • Les graphiques ont-ils une conclusion lisible ?
  • Les données importantes sont-elles disponibles autrement que par la couleur ?
  • Les valeurs exactes sont-elles accessibles dans un tableau ou une annexe ?

Audio et vidéo

  • Les vidéos ont-elles des sous-titres ?
  • Une transcription est-elle disponible ?
  • Les animations clignotantes ou rapides ont-elles été évitées ?

Fichiers

  • Le document conserve-t-il sa structure après export en PDF ?
  • Les liens sont-ils explicites ?
  • Le fichier porte-t-il un nom compréhensible ?
  • Une version modifiable ou textuelle est-elle disponible si nécessaire ?

Les vérificateurs d’accessibilité intégrés à certains logiciels peuvent détecter des problèmes courants, comme l’absence de texte alternatif ou un ordre de lecture incohérent. Ils ne remplacent pas une lecture réelle avec un clavier, un lecteur d’écran ou un test utilisateur.

Les erreurs fréquentes à éviter avec l’IA

Accepter les chiffres sans vérification

Une IA peut reformuler correctement une donnée tout en modifiant une valeur, une unité ou une période. Chaque chiffre doit être comparé à la source.

Confondre accessibilité et esthétique

Une présentation élégante n’est pas nécessairement accessible. Les effets, les animations et les contrastes subtils peuvent nuire à la compréhension.

Générer un texte alternatif générique

Une description automatique comme « graphique présentant des résultats » n’aide pas suffisamment une personne qui ne peut pas consulter le visuel.

Utiliser une couleur comme seule information

Les mentions « positif en vert » et « négatif en rouge » peuvent exclure les personnes daltoniennes et rester incompréhensibles en impression noir et blanc.

Exporter directement en PDF sans contrôle

L’export peut modifier les balises, l’ordre de lecture, les liens ou la sélection du texte. Le fichier final doit être testé dans son format réellement diffusé.

Envoyer des données confidentielles

La facilité d’utilisation d’un assistant IA ne dispense pas de respecter le RGPD, les règles internes de sécurité et les obligations contractuelles.

Méthode recommandée en 7 étapes

  1. Définir le public et l’objectif de la présentation.
  2. Nettoyer et anonymiser les données avant de les transmettre à l’IA.
  3. Demander une structure narrative fondée sur des faits vérifiables.
  4. Choisir des graphiques simples, avec des libellés et une alternative tabulaire.
  5. Générer les textes alternatifs, titres et notes orales à partir des visuels réels.
  6. Contrôler manuellement les chiffres, le contraste et l’ordre de lecture.
  7. Tester le fichier final au clavier, avec un lecteur d’écran ou auprès de personnes concernées.

Conclusion : les points clés à retenir

L’IA facilite la création de présentations de données accessibles en accélérant l’analyse, la rédaction, la structuration et la production de descriptions. Pour obtenir un résultat réellement inclusif, il faut toutefois :

  • fournir des données propres, documentées et non sensibles ;
  • demander explicitement des contraintes d’accessibilité ;
  • privilégier des graphiques simples et compréhensibles ;
  • ne jamais dépendre uniquement de la couleur ;
  • fournir des textes alternatifs utiles et des tableaux de données ;
  • ajouter des sous-titres et des transcriptions ;
  • vérifier les chiffres et les interprétations générés ;
  • contrôler le fichier final après export ;
  • combiner les outils automatiques avec une validation humaine.

Une présentation accessible ne se limite pas à respecter une checklist technique. Elle doit permettre à chaque personne de comprendre le message principal, vérifier les données et suivre le raisonnement, quel que soit son mode de consultation.

  • ✇IA-Pulse
  • Le client est à qui ?
    OpenAI a trouvé une super idée, la meilleure depuis un moment : demander aux entreprises de lui apporter leurs informations, leurs catalogues, leurs prix, leurs stocks et maintenant même leurs vendeurs. Enfin, leurs vendeurs virtuels et artificiels.En échange, ces entreprises sont en train d’acquérir deux super pouvoirs. En premier, consulter quelques statistiques, mais pas trop hein, sur leur visibilité dans ChatGPT. Les vendeurs de mesures GEO artificielles ont encore de beaux jours devant eux

Le client est à qui ?

14 novembre 2026 à 10:04

OpenAI a trouvé une super idée, la meilleure depuis un moment : demander aux entreprises de lui apporter leurs informations, leurs catalogues, leurs prix, leurs stocks et maintenant même leurs vendeurs. Enfin, leurs vendeurs virtuels et artificiels.

En échange, ces entreprises sont en train d’acquérir deux super pouvoirs.

En premier, consulter quelques statistiques, mais pas trop hein, sur leur visibilité dans ChatGPT. Les vendeurs de mesures GEO artificielles ont encore de beaux jours devant eux.

En second, installer ce déjà fameux agent commercial fantasmé qui va répondre directement aux questions des clients. Le tout, bien entendu, dans une interface contrôlée par OpenAI. Avec, aussi, la possibilité de payer pour attirer les clients vers cet agent. Business is business, une affaire est souvent une ‘affair’.

Belle perf d’OpenAI de nouveau : récupérer à la fois les questions, et les corpus documentaires et de données pour y répondre. Et cerise, proposer une option payante. C’est un art.


Bienvenue sur IA-Pulse Weekend. Cette édition porte le numéro 188. En vous abonnant, vous recevez tous les samedis matin, l’essentiel de ce qu’il s’est passé cette semaine autour de l’IA : un coup de gueule édito, une sélection de 3 actualités avec pour chacune un résumé rapide à lire, une liste supplémentaires d’actualités et d’études académiques, et 1 article de fond pour ouvrir l’esprit. Gérez votre abonnement.

⏱️Temps de lecture de cette newsletter par une unité carbone : 9 mins

Cette semaine la partie de cette newsletter gérée par l’IA, les 3 clusters d’articles, a été générée par ChatGPT Work GPT6-Astra pour les résumés des sources, ainsi que la génération des clusters et des titres. Comme d’habitude j’ai fait quelques modifications, mais j’ai aussi laissé quelques tournures typiques des modèles de langage. Et bien entendu, mes commentaires éventuels sont en italique dans ces résumés. Le texte de “l’article qui fait réfléchir” est issu de ChatGPT Work GPT6-Astra. L’image d’illustration ci-dessous a été générée par Midjourney

📰 Les 3 infos de la semaine

🛍️ ChatGPT ouvre son centre commercial : les entreprises et les vendeurs (virtuels) sont déjà là

Vous demandez à ChatGPT de comparer plusieurs produits. Une marque apparaît dans sa réponse. Vous cliquez sur sa fiche et une nouvelle conversation s’ouvre. Cette fois, vous ne discutez plus avec ChatGPT, mais avec un agent qui représente officiellement l’entreprise.

C’est l’une des nouveautés lancées par OpenAI le 10 novembre avec Business Hub, actuellement en bêta.

Les entreprises éligibles peuvent revendiquer leur fiche dans ChatGPT, faire vérifier leur identité, mettre à jour leurs informations et fournir un catalogue de produits avec les prix et les disponibilités. Elles disposent également d’indicateurs sur leur présence dans ChatGPT : nombre de mentions, clics vers leur site et principaux sujets qui conduisent les utilisateurs à les découvrir. Les conversations individuelles ne leur sont pas communiquées.

La deuxième nouveauté concerne les Business Agents, proposés pour commencer à certaines entreprises américaines de commerce électronique et de services en ligne. Chaque entreprise peut configurer son propre agent pour répondre aux questions des clients à partir de ses informations commerciales et de ses consignes.

La conversation avec cet agent est distincte de celle avec ChatGPT et clairement identifiée comme représentant une entreprise. OpenAI précise que la création d’une fiche ne garantit pas une meilleure visibilité dans les recommandations.

Dernier détail : les entreprises peuvent également sponsoriser leur Business Agent pour qu’il devienne la destination d’une publicité dans ChatGPT.

Pourquoi est-ce important ? Après avoir installé la caisse et son terminal de paiement dans ChatGPT, OpenAI s'occupe maintenant de la vitrine et du vendeur. Le moteur de réponses commence à avoir de sérieux airs de centre commercial. Mall forever.

Pour aller plus loin : OpenAI, VentureBeat, TechCrunch, The Verge, Search Engine Land

🔎 Google confie AI Mode à Gemini 4 Hydrogen et renforce les AI Overviews pour les questions complexes

Google a annoncé le 12 novembre l’intégration de son nouveau modèle Gemini 4 Hydrogen dans son moteur de recherche. Il devient le modèle par défaut d’AI Mode et sera également utilisé pour traiter les questions les plus difficiles dans les AI Overviews.

Hydrogen remplace Gemini 3.8 Flash et doit permettre à Google de mieux comprendre les questions longues, les demandes comportant plusieurs contraintes ou les formulations imprécises. Le modèle est également disponible dans l’application Gemini, AI Studio et l’API Google.

Dans Search, la principale évolution concerne la manière de traiter les requêtes complexes. Grâce à une version améliorée du query fan-out, Google peut décomposer une question en plusieurs sous-questions, lancer des recherches simultanées sur les différents sujets et réunir les résultats dans une réponse.

Google promet également des réponses plus visuelles, avec davantage d’images, de tableaux comparatifs, de graphiques et même d’outils interactifs générés en fonction de la demande.

Pourquoi est-ce important ? La seule question : est-ce que ça va faire cliquer ? Nan… sans dec…

Pour aller plus loin : Google Search, Google sur Hydrogen, Search Engine Roundtable, VentureBeat, Ars Technica, TechCrunch, The Verge

🧩 Google publie A2UI 1.0 : les agents IA peuvent construire leurs propres interfaces interactives à le demande

Demander à un agent IA personnel de préparer un voyage, c’est pratique. Devoir échanger quinze messages pour modifier les dates, comparer les hôtels et confirmer une réservation, beaucoup moins.

Google veut résoudre ce problème avec A2UI 1.0. Ce protocole ouvert permet aux agents IA de produire des interfaces interactives adaptées à la demande : formulaires, calendriers, boutons, tableaux, graphiques ou menus de sélection.

Le principe est assez simple. Plutôt que de générer du code pour construire une interface, l’agent envoie une description structurée des éléments à afficher. L’application utilise ensuite ses propres composants pour les présenter à l’utilisateur. Les développeurs définissent les composants autorisés, leur apparence et les actions possibles.

La version 1.0 ajoute notamment des appels de fonctions dans les deux sens entre l’interface et l’agent. Un formulaire peut ainsi vérifier directement une disponibilité ou une information, sans obliger l’utilisateur à relancer une conversation.

A2UI dispose de bibliothèques pour React, Angular, Flutter ou SwiftUI et peut fonctionner avec MCP Apps, ce qui permet d’afficher certaines interfaces dans des assistants comme Claude, ChatGPT ou Gemini.

Pourquoi est-ce important ? Les agents apprennent à fabriquer des boutons, des menus et des formulaires à la demande. Un bon croquis vaut mieux qu'un long discours comme on disait à l’époque du premier Empire. Dans le nouvel Empire de la Valley, on applique à lettre les enseignements des anciens Empereurs.

Pour aller plus loin : Google Developers, CopilotKit, DigIntoAI, Documentation A2UI


🤖🌐📱 La semaine des agents personnels


🚀 🛠️💵 Les autres actus de la semaine


🔬 🔭 🧪Les études de la semaine


🧠 L’article qui fait réfléchir - et qu’il faut absolument lire

AI’s biggest bottleneck is cost: Companies blame stalled projects on overruns three times as often as on compute shortages

“Drifting and free, On a mystical sea”

Depuis deux ans, on nous explique qu’il manque des GPU. Qu’il faut construire davantage de data centers, produire plus de puces, trouver suffisamment d’électricité pour alimenter tout ça. Des centaines de milliards sont investis pour répondre à cette pénurie de puissance de calcul. Sauf qu’il semblerait qu’un autre problème se pose.

VentureBeat a interrogé 156 professionnels travaillant sur des projets d’IA. Résultat : 38 % déclarent que leur organisation a dû retarder, réduire ou abandonner un projet parce qu’il coûtait plus cher que prévu. Seulement 12 % évoquent un manque de puissance de calcul.

Mais le plus intéressant vient ensuite.

Malgré ces dépassements, 79 % des répondants anticipent une augmentation du budget IA de leur organisation. Et seulement 26 % déclarent que les dépenses d’IA sont évaluées à partir d’un retour financier mesurable, suffisamment solide pour être défendu devant leur direction financière.

Résumons : les projets coûtent plus cher que prévu, on peine à démontrer ce qu’ils rapportent, mais on prévoit tout de même d’augmenter les budgets.

C’est assez formidable.

En réalité une grosse partie du problème vient de la manière dont nous calculons les coûts. Un prototype fonctionne parfaitement avec quelques dizaines de requêtes. Puis on le déploie. Il faut accéder aux données de l’entreprise, multiplier les appels aux modèles, surveiller les opérations, corriger les erreurs et parfois faire vérifier le travail par un humain.

Le prix du modèle n’était finalement qu’une partie de la facture.

Et de l’autre côté du calcul, que mesure-t-on ? Les tokens consommés ? Les heures théoriquement économisées ? Le nombre de collaborateurs qui utilisent l’outil ? Tout cela renseigne sur l’activité, beaucoup moins sur la valeur réellement produite.

Nous savons mesurer avec une précision remarquable le prix d’un million de tokens. Nous savons beaucoup moins bien calculer ce que nous coûte une tâche correctement accomplie, et surtout ce qu’elle nous rapporte.

Mais bon, en attendant de trouver la réponse, on peut toujours demander une rallonge budgétaire. Il paraît que l’IA est stratégique.


N’hésitez pas à me contacter si vous avez des remarques et suggestions sur cette newsletter, ou si dans votre entreprise vous cherchez à être accompagnés dans l’intégration d’outils IA et d’IA générative : olivier@255hex.ai


Partagez cette newsletter

Partager

Et si vous n’êtes pas abonné, il ne tient qu’à vous de le faire !

Inscrivez-vous maintenant

“We're fooled by their fluency.” Yan LeCun, 2024

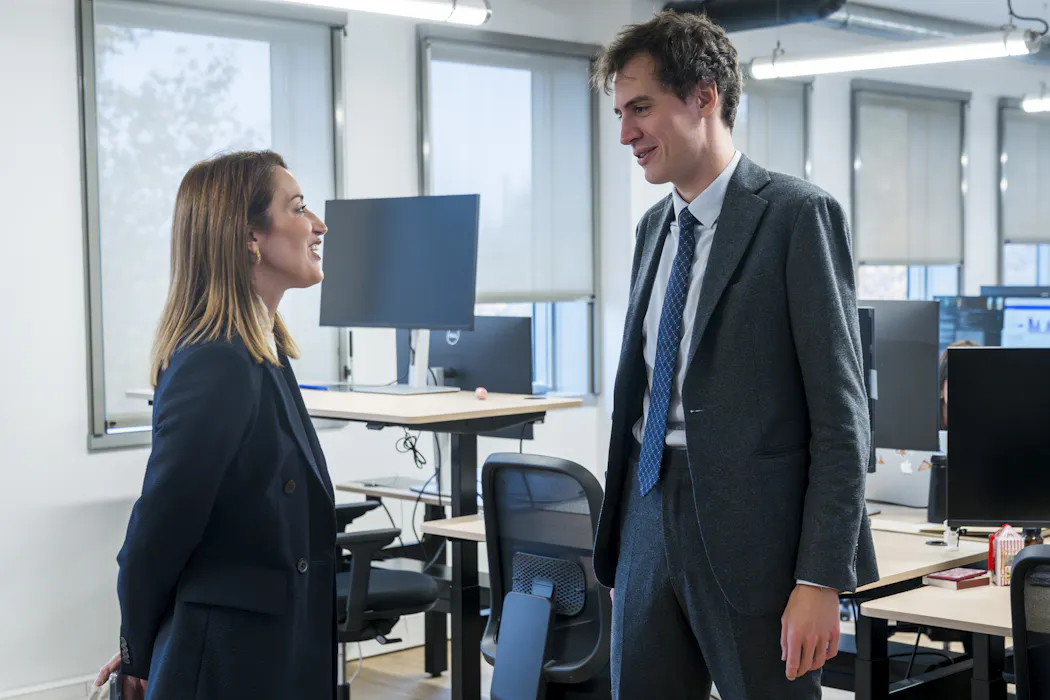
Trois stratégies pour les entreprises et les États face à l’IA, ou pourquoi les décisions de Mistral et de l’Union européenne ne sont pas contradictoires avec la souveraineté numérique

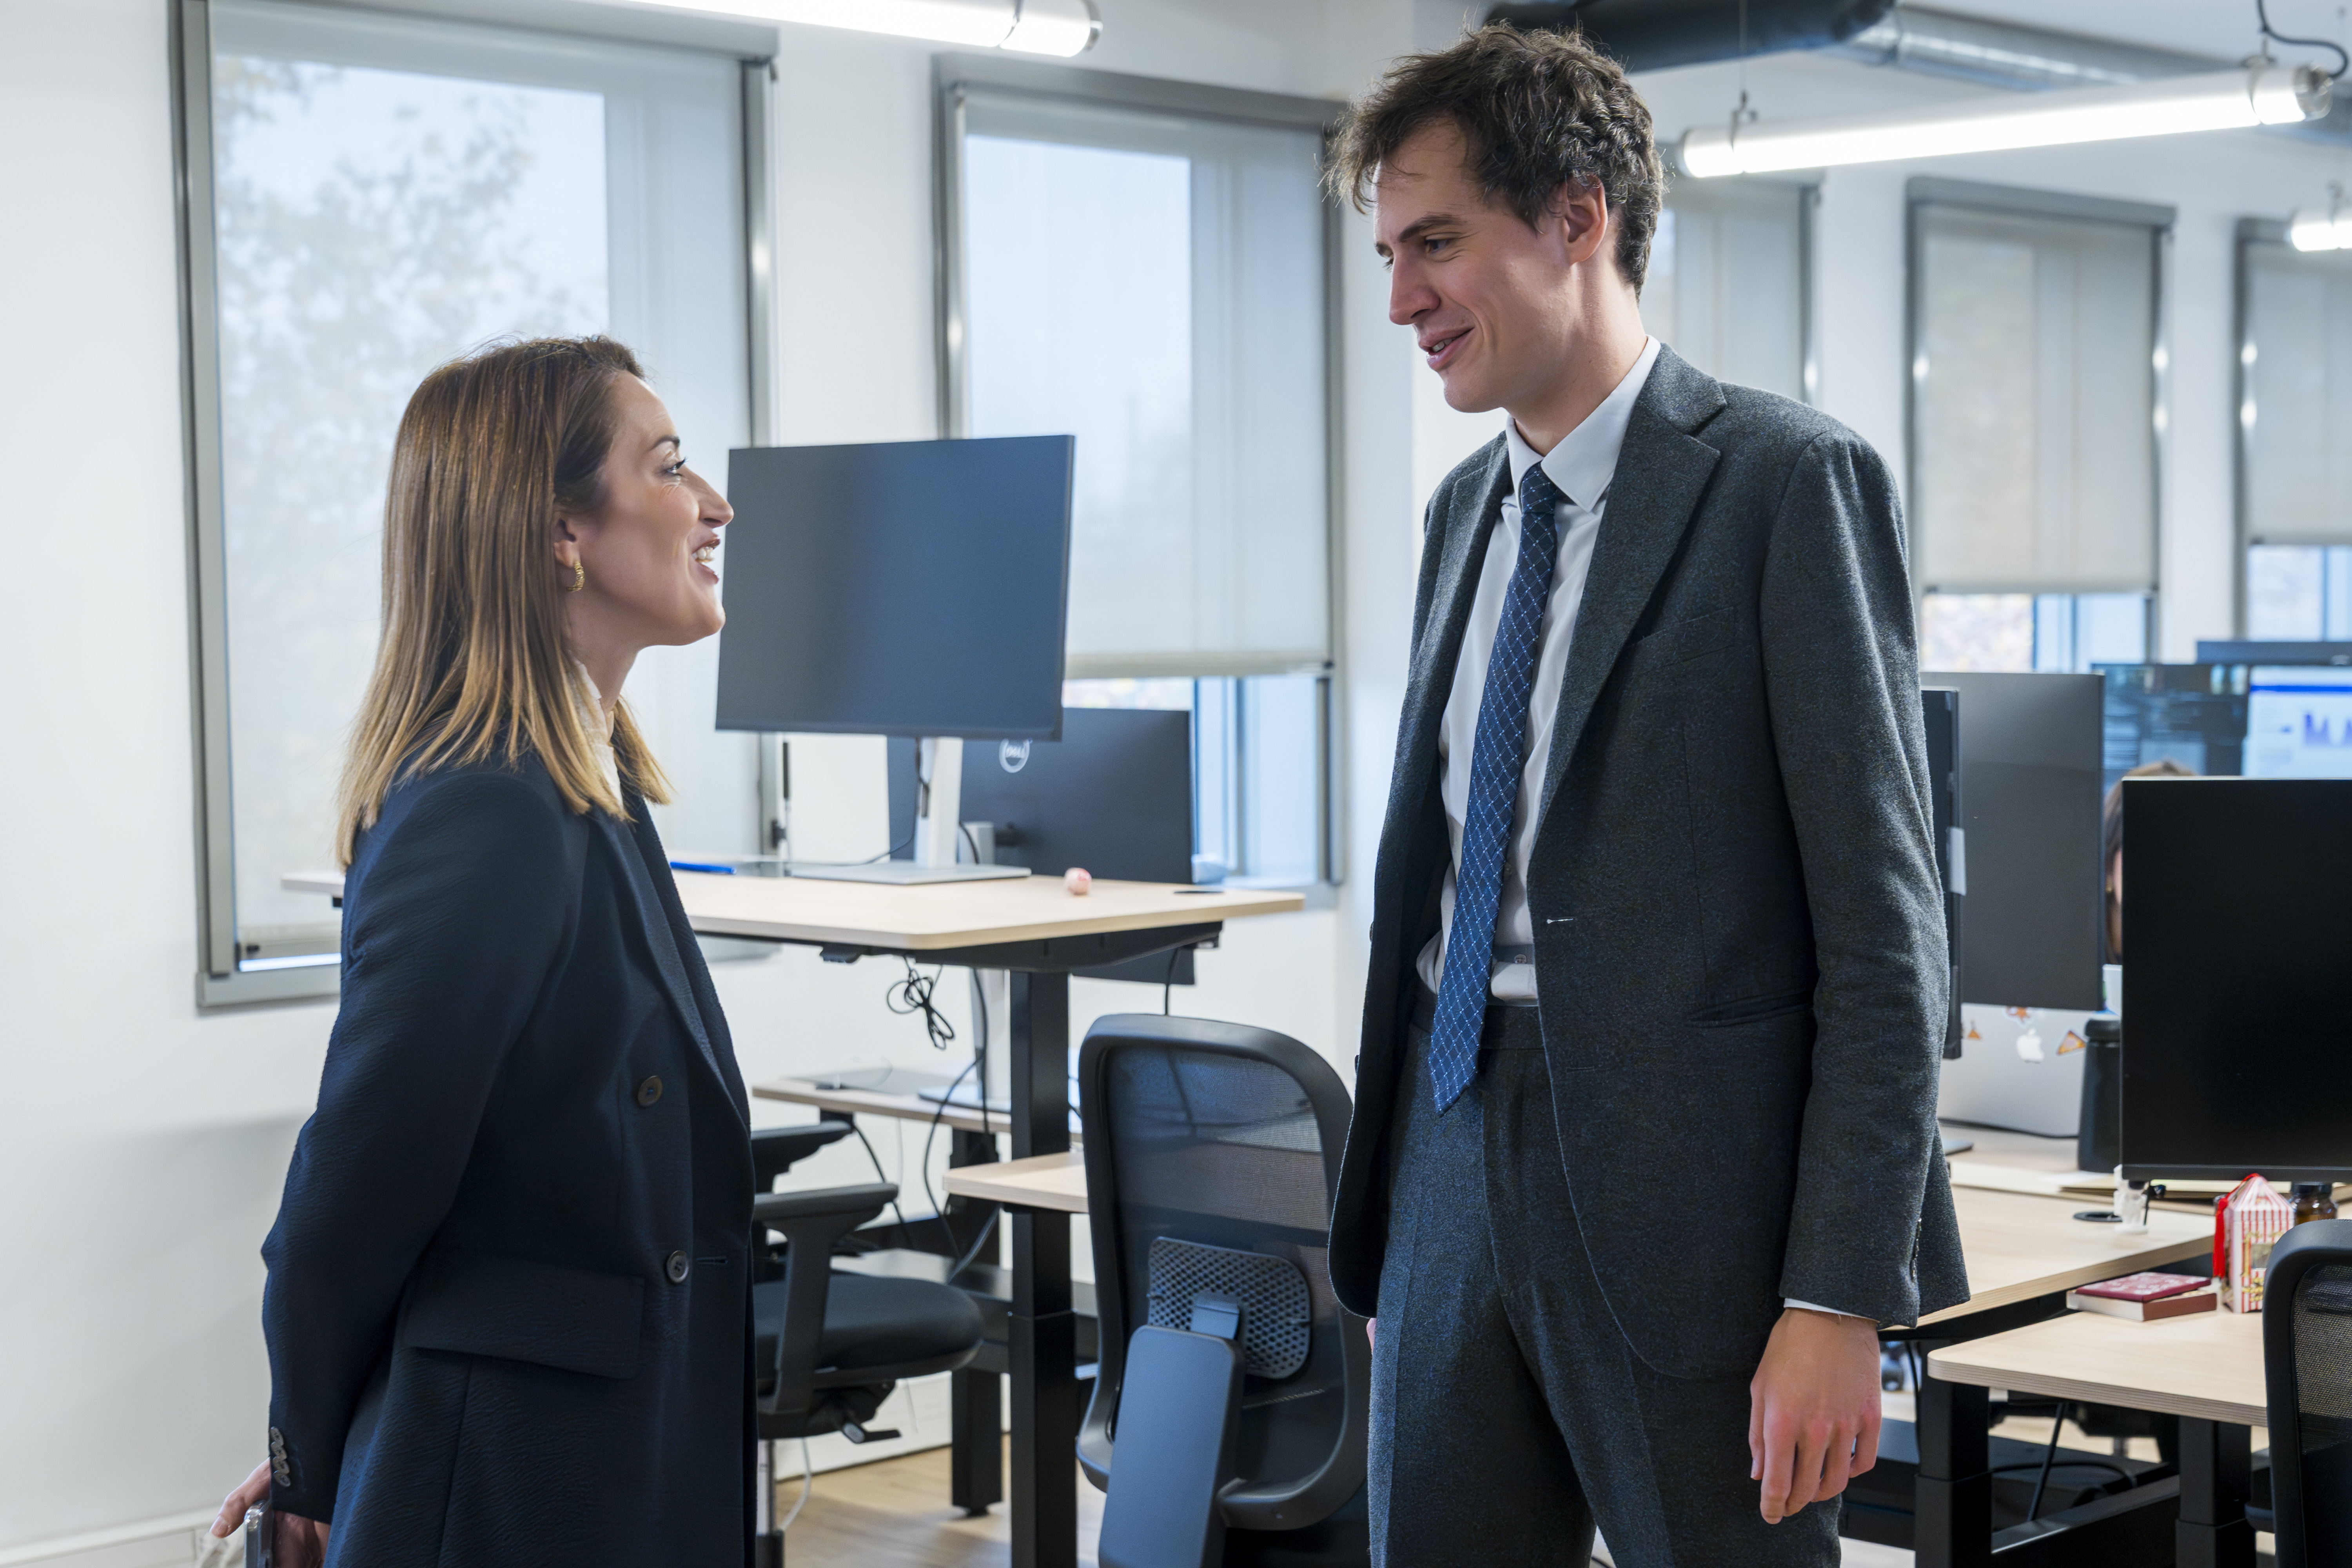
Arthur Mensch, PDG de Mistral AI, et la présidente du Parlement européen, Roberta Metsola, lors de leur rencontre à Paris, le 14 novembre 2025. Daina Le Lardic/Parlement européen © Union européenne 2025, CC BY

L’ESSENTIEL

  • L’annonce de Mistral d’abandonner le développement de son propre grand modèle de langage a jeté le doute sur la capacité à se doter d’un champion européen dans le domaine de l’intelligence artificielle.

  • Cependant, « l’IA » n’existe pas en tant que telle : il s’agit d’un assemblage de briques technologiques, dont font partie les grands modèles de langages.

  • Pour développer des produits commerciaux, une stratégie doit être choisie, entre satisfaire les besoins d’un seul client et viser le plus grand public possible. Les annonces de l’été reflètent ces choix.


Cet été, Mistral annonçait un tournant stratégique : plutôt que de faire de la seule performance de ses modèles de langage (LLM) le fondement de son avantage concurrentiel, l’entreprise française a décidé d’intégrer dans son offre divers modèles, dont des modèles chinois ouverts.

Cette annonce a marqué les débats autour de la « souveraineté numérique », et de la capacité d’un acteur européen d’être concurrentiel dans « l’intelligence artificielle ». Pourtant, les investisseurs semblent suivre, puisque l’entreprise a également annoncé cet été une levée de fonds de 3 milliards d’euros (incluant Samsung et Nvidia, deux acteurs majeurs du domaine).

L’analyse que nous développons dans l’article est qu’on est loin d’un déclassement technologique européen dans le domaine d’intelligence artificielle. Il s’agit de développer une stratégie industrielle basée sur le contrôle d’autres briques technologiques que le modèle de langage en lui-même. Cette stratégie est plus susceptible de rencontrer une demande solvable, celle des applications spécialisées pour les organisations.

« L’IA » n’existe pas : il s’agit d’un assemblage de briques technologiques, dont font partie les LLM

Un modèle de langage est un système à base de réseaux de neurones entraîné sur un vaste corpus de données, capable de prédire une suite probable pour une entrée donnée, texte, image ou son. Selon les données d’entraînement fournies au modèle par son développeur, celui-ci sera plus ou moins efficace dans une langue, une discipline ou un métier (finance, droit), pour trouver cette suite, et donc construire une solution informatique.

D’ailleurs les modèles de langage sont souvent évalués dans des contextes applicatifs donnés. Quand Mistral communique sur les capacités de son dernier et plus grand modèle (le Chonk, 1000 milliards de paramètres, soit environ un dixième du nombre de paramètres estimés du modèle GPT-6 Astra d’OpenAI), il le fait sur des domaines spécifiques : la finance, la cybersécurité…

Ensuite, ce modèle est une brique d’une solution informatique, qui comprend également :

  • une plateforme matérielle qui connecte des données et permet de faire fonctionner le modèle,

  • des systèmes permettant d’adapter les réponses du modèle de langage aux besoins de l’utilisateur : des commandes (ou « prompts ») et des interfaces logicielles permettant de connecter des données spécifiques au modèle (les RAG pour « Génération augmentée par récupération »),

  • d’autres développements informatiques spécifiques permettant d’intégrer la solution dans le système d’information d’une organisation.

Comme dans d’autres industries (spatial, aéronautique, automobile), la construction d’une solution se fait en trois étapes, qui peuvent être réalisées par des acteurs différents : la production des technologies élémentaires ; leur assemblage dans une plateforme qui propose un certain nombre de performances ; l’adaptation de cette plateforme à des besoins plus ou moins spécifiques.

Tous les assemblages ne sont pas viables techniquement ou économiquement : développer une brique ou une plateforme représente un coût fixe important. Plus le nombre d’utilisateurs d’une plateforme est grand, plus ce coût fixe peut être réparti et plus faible est le coût par utilisateur (ce qu’on appelle des « économies d’échelle »).

L’industrie de l’IA répond à ces contraintes comme le reste de l’industrie informatique

La solution classique développée par l’industrie informatique depuis les années 1970, combine une « base logicielle » mutualisée et des modules périphériques personnalisables.

Mais, techniquement et stratégiquement, on ne peut pas utiliser la même plateforme pour absolument tout : concilier des besoins trop différents coûte trop cher.

Comme depuis plus de soixante-dix ans en informatique, il n’existe donc pas une offre, mais plusieurs, selon l’arbitrage entre coût par utilisateur, variété des besoins couverts et adaptation aux besoins spécifiques (personnalisation), avec des choix différents sur les technologies qu’on cherchera à contrôler.

Cet arbitrage donne typiquement trois grands types de stratégies pour une entreprise : servir le plus grand nombre dans une version peu personnalisée (1) ; développer une solution spécifique à un client, ce qui coûte très cher (2) ; préspécialiser une plateforme pour un secteur spécifique et l’adapter à la marge (3).

Stratégie 1 : une plateforme généraliste pour tous

La première stratégie est celle de la création d’une « plateforme généraliste », répondant à une multitude d’usages à coût abordable, en maîtrisant les briques clés. C’est le cas, classiquement, des systèmes d’exploitation (iOS ou Windows).

Dans le cas des solutions basées sur les modèles de langage, il s’agit d’avoir le plus gros modèle (en nombre de paramètres) entraîné sur le plus de données possibles, ce qui requiert des fermes de serveurs toujours plus grandes. Ces coûts fixes de création de la plateforme sont amortis sur le plus grand nombre d’utilisateurs et d’usages possibles, afin de proposer le coût d’usage le plus faible possible.

Comme dans un système d’exploitation classique, l’adaptation aux besoins est laissée à l’utilisateur, qui doit apprendre à formuler des requêtes (utiliser un dossier hier, formuler un prompt demain), et adapter ses usages à la plateforme.

La concurrence féroce pour accéder aux puces et, de plus en plus, à l’énergie qui permet de faire fonctionner ces modèles, et la structure de coûts (fixes) sont typiques d’une concurrence « monopolistique » : comme pour les systèmes de cloud, ou les systèmes d’exploitation, peu d’acteurs survivront.

Mais, si ces solutions « généralistes » sont bien connues du grand public, l’essentiel du chiffre d’affaires des offres informatiques provient de solutions développées à façon pour un acteur (stratégie 2) ou de solutions spécialisées par industrie, par besoin (stratégie 3).

Stratégie 2 : des solutions adaptées à façon aux besoins d’un client

Pour des raisons stratégiques, ou parce qu’il s’agit d’un besoin très spécifique, des organisations veulent des solutions spécifiques.

Dans ce cas, il s’agit d’exprimer des besoins métiers, entraîner un modèle sur des données spécifiques à ces besoins, mais aussi à l’intégrer aux systèmes informatiques existants.

La taille des modèles peut être sensiblement réduite comparativement à la stratégie 1, donc les investissements dans les infrastructures informatiques. Mais ces développements permettent peu de bénéficier des économies d’échelles. Ils sont donc réservés aux grandes organisations disposant des besoins et des ressources (finances, données) pour y répondre.

Ainsi, le Crédit agricole vient d’annoncer un investissement de 500 millions d’euros pour développer une IA interne autour de ses besoins. De même, Amazon utilise son propre modèle, Rufus, entraîné sur ses propres données (ses catalogues et avis clients) pour améliorer ses services existants.

Accompagner des grands comptes dans le développement de tels projets spécifiques est un métier traditionnel des entreprises de services numériques (ESN) : Capgemini, Atos ou Wavestone, acteurs mondiaux français, redéploient leur offre vers l’intégration de systèmes d’IA dans le système informatique de leurs clients.

Une solution intermédiaire est de développer des plateformes spécialisées par secteur, pour être plus spécifique que la grande plateforme, mais moins chère que le développement à façon pour un seul client.

Stratégie 3 : des solutions informatiques basées sur des plateformes spécialisées par secteur pour répartir les coûts

Dans cette stratégie, les technologies clés sont :

  • les données spécifiques au métier (finance, droit) ou à l’usage « linguistique » (codage, modèles mathématiques, langue rare) visés pour pouvoir spécifier un modèle spécialisé qui peut être plus petit que dans la stratégie 1 ;

  • le développement de technologies d’utilisation pour adapter la plateforme à des besoins précis, dans le domaine visé.

Ainsi, le modèle BloombergGPT dédié à la finance, est environ 20 fois plus petit que le modèle GPT alors équivalent.

Ces solutions peuvent être proposées par un acteur industriel, ou par un consortium d’utilisateurs qui identifient comment le partage de données et d’une infrastructure leur permettra de développer ensuite des solutions propres à leurs besoins.

C’est ce virage vers la stratégie 3 qu’a annoncé Mistral. Après avoir montré qu’elle savait développer des modèles, elle veut être l’acteur européen capable de développer ces infrastructures spécialisées « métier »… et souveraines. L’Europe sait développer de telles offres : SAP, en Allemagne, est le leader des Progiciel de Gestion Intégré (PGI ou ERP), et Dassault Systèmes, le « leader mondial dans les logiciels de modélisation 3D et d’ingénierie ». Reste à discuter comment les soutenir.

La stratégie européenne face à ces trois types de produits

La souveraineté dans « l’IA » ne passe donc pas tant le développement de la plus grande infrastructure informatique hébergeant le plus grand modèle, que par le contrôle des données et de qui y a accès. Il s’agit de développer des solutions informatiques permettant trois choses :

  • aux producteurs de données (qu’elles soient industrielles, médicales, etc.) de déposer des données,

  • aux créateurs de solutions métiers d’accéder à des données partagées, car sans données, impossible de développer des solutions ;

  • mais aussi que ces dépôts répondent à des besoins identifiés collectivement par les producteurs de données pour qu’ils puissent garder le contrôle sur les solutions.

C’est le sens des initiatives européennes de financement des espaces communs de données.


Le projet TRANSVERSE (ProjetIA-22-EXEN-0006) est l’un des projets du Programme et équipement prioritaire de recherche (PEPR) exploratoire eNSEMBLE, financé par France 2030 par l’intermédiaire de l’ANR. L’ANR a pour mission de soutenir et de promouvoir le développement de recherches fondamentales et finalisées dans toutes les disciplines, et de renforcer le dialogue entre science et société. Pour en savoir plus, consultez le site de l’ANR.

The Conversation

Nicolas Jullien a reçu des financements de l'ANR pour des recherches sur les communs numériques et la coopération en ligne (PEPR eNSEMBLE, programme France 2030).

Robert Viseur a reçu des financements dans le cadre du programme de coopération territoriale européenne Interreg France-Wallonie-Vlaanderen (FWVL), ce qui inclut les projets FabricAr3v et Inside3D.

L'agent de codage Grok Build divulgue une multitude d'informations confidentielles dont certaines appartiennent à SpaceX. Un chercheur découvre 35 000 applications Grok Build accessibles à tous

L'agent de codage Grok Build divulgue une multitude d'informations confidentielles dont certaines appartiennent à SpaceX. Un chercheur découvre 35 000 applications Grok Build accessibles à tous

L'enquête a été menée par la société de cybersécurité Claroc en novembre 2026 et a mis au jour 35 578 applications accessibles sans authentification sur les 37 571 projets actifs analysés. L'agent de codage Grok Build vient allonger la liste des cas qui positionnent ces outils comme des vecteurs de matérialisation...

  • ✇PandIA
  • 3,2 milliards de dollars de projets IA chinois reposent sur des puces Nvidia interdites
    Plus de 3 milliards de dollars de capacités de calcul chinoises auraient été planifiés autour de processeurs que Washington interdit désormais d’exporter. Le problème ne tient donc pas seulement à l’accès de la Chine aux puces Nvidia : il concerne aussi des infrastructures déjà budgétées, contractualisées ou conçues sur une base technologique devenue juridiquement incertaine.Des projets chinois construits sur des puces indisponiblesUne enquête de Reuters, publiée le 13 novembre 2026, a examiné p

3,2 milliards de dollars de projets IA chinois reposent sur des puces Nvidia interdites

Par : Decrypt
14 novembre 2026 à 07:01
3,2 milliards de dollars de projets IA chinois reposent sur des puces Nvidia interdites

Plus de 3 milliards de dollars de capacités de calcul chinoises auraient été planifiés autour de processeurs que Washington interdit désormais d’exporter. Le problème ne tient donc pas seulement à l’accès de la Chine aux puces Nvidia : il concerne aussi des infrastructures déjà budgétées, contractualisées ou conçues sur une base technologique devenue juridiquement incertaine.

Des projets chinois construits sur des puces indisponibles

Une enquête de Reuters, publiée le 13 novembre 2026, a examiné plus de 150 documents chinois — appels d’offres, contrats, documents de planification et dossiers de projets. Leur valeur cumulée dépasse 23 milliards de yuans, soit environ 3,2 milliards de dollars.

Plusieurs de ces documents mentionnent explicitement des processeurs Nvidia H100, H200 ou H800, des accélérateurs destinés aux charges d’intelligence artificielle les plus lourdes. Ces composants sont précisément au cœur des restrictions américaines qui limitent leur exportation vers la Chine, au nom de la sécurité nationale et de la prévention d’un renforcement des capacités militaires chinoises.

Le cas le plus frappant concerne un centre de calcul envisagé dans la province du Fujian, pour un montant estimé à 6,2 milliards de yuans. Le projet spécifie l’utilisation de puces H100, alors que Nvidia affirme être désormais exclu du marché chinois des centres de données par les contrôles américains.

La contradiction est directe : des collectivités, des entreprises ou des opérateurs chinois ont planifié des infrastructures à partir de composants dont l’acquisition légale est précisément devenue l’objet du contrôle de Washington.

Des contrats qui ne prouvent pas des livraisons

La présence d’une référence Nvidia dans un document ne signifie toutefois pas que les puces ont été livrées, installées ou mises en service. C’est l’une des principales nuances de l’enquête Reuters.

Certains dossiers peuvent correspondre à des projets préliminaires, à des appels d’offres non conclus ou à des spécifications techniques rédigées avant le durcissement des règles américaines. D’autres peuvent avoir été conçus avec l’espoir d’obtenir les composants par l’intermédiaire de fournisseurs tiers, de stocks existants ou de circuits d’approvisionnement indirects.

Cette distinction est essentielle. Un centre de calcul peut être annoncé, financé et même partiellement construit sans disposer des GPU nécessaires à son exploitation. Or, dans les infrastructures d’IA, les processeurs ne sont pas un élément interchangeable à la dernière minute. Ils conditionnent l’architecture logicielle, le refroidissement, l’alimentation électrique, les réseaux à très haut débit et les performances attendues.

Remplacer des H100 ou des H200 par des puces chinoises moins puissantes ne consiste donc pas simplement à changer la référence sur une facture. Il faudrait parfois revoir la capacité du centre, la configuration des serveurs, les logiciels compatibles et les objectifs commerciaux du projet.

H100, H200, H800 : trois générations au cœur du bras de fer

Le H100 est l’un des principaux accélérateurs de Nvidia pour l’entraînement et l’exécution de modèles d’IA. Le H200, plus récent, augmente notamment la mémoire disponible pour traiter de grands modèles et des ensembles de données plus volumineux. Le H800, conçu à l’origine pour respecter certaines limites américaines applicables au marché chinois, a lui aussi été rattrapé par le durcissement des règles de Washington.

Les autorités américaines ont progressivement élargi les restrictions : elles ne portent plus uniquement sur la puissance brute des puces, mais aussi sur la vitesse de communication entre accélérateurs et sur certains équipements indispensables à la constitution de grappes de calcul. Cette évolution vise à empêcher qu’un assemblage de composants théoriquement conformes permette d’obtenir une puissance équivalente à celle des systèmes interdits.

Pour les porteurs de projets chinois, cette incertitude complique les calendriers et les budgets. Une infrastructure évaluée à plusieurs milliards de yuans peut perdre une partie de sa valeur si les processeurs prévus ne sont pas disponibles. Les retards peuvent aussi affecter les revenus attendus des opérateurs de cloud, des laboratoires de recherche et des entreprises qui comptaient louer cette capacité.

Nvidia pris entre Pékin et Washington

Nvidia se retrouve au centre de cette tension commerciale. L’entreprise a longtemps adapté certains produits aux règles américaines afin de conserver une présence en Chine. Mais l’extension des contrôles a réduit l’espace disponible entre les exigences de Washington et les attentes du marché chinois.

La société affirme désormais être exclue du marché chinois des centres de données. Cette déclaration souligne l’écart entre les projets recensés par Reuters et la capacité réelle de Nvidia à les fournir légalement. Elle pose également une question sur la date des documents : certains engagements ont-ils été pris avant l’interdiction, ou reposent-ils sur une hypothèse d’assouplissement qui ne s’est jamais concrétisée ?

Le départ de Jensen Huang, figure centrale de Nvidia, et le regain de pression politique à Washington rendent cette perspective encore plus incertaine. Le changement de direction, s’il s’accompagne d’une ligne plus prudente sur la Chine, pourrait réduire la probabilité de voir apparaître de nouvelles versions spécifiquement adaptées aux restrictions américaines. À l’inverse, une stratégie commerciale plus offensive risquerait d’alimenter les critiques du Congrès américain.

Pékin devra absorber le risque industriel

Pour la Chine, le dossier révèle surtout une dépendance persistante aux accélérateurs américains les plus avancés. Les fabricants locaux développent leurs propres solutions, mais remplacer Nvidia à l’échelle de dizaines de centres de calcul exige du temps, des volumes de production et un écosystème logiciel suffisamment mature.

Les projets recensés pourraient donc suivre plusieurs trajectoires : abandon, report, réduction de capacité ou conversion vers des puces chinoises. Dans certains cas, les investissements déjà engagés dans les bâtiments, les réseaux et l’énergie pourront être conservés. Mais leur rentabilité dépendra de la possibilité d’y installer des accélérateurs capables de faire fonctionner des modèles d’IA compétitifs.

Le prochain jalon sera la confirmation, projet par projet, des livraisons réellement effectuées et des équipements effectivement installés. Si une part importante des 23 milliards de yuans correspond à des contrats non exécutés, le montant mesurera moins les ventes de Nvidia que le coût d’une planification industrielle fondée sur des puces devenues inaccessibles.

[Podcast] « C’est les LLM vraiment alignés sur le comportement humain qui ont tout changé », Sylvain Peyronnet (Ibou)

13 novembre 2026 à 19:18
Temps d’écoute : 58 mins - Temps de lecture : 6 mins
Vous pouvez modifier vos préférences de réception ou vous désabonner sur la page de votre compte

Entretien réalisé le 28 octobre 2026

Sylvain Peyronnet connaît les moteurs de recherche de l’intérieur. Après son passage chez Qwant et la création de Babbar, il construit aujourd’hui avec ses associés Ibou, un nouveau moteur de recherche français indépendant. Un pari audacieux -ou un peu fou, c’est selon- face à la domination de Google.

Pourquoi se lancer maintenant ? Qu’est-ce que les LLM changent dans la conception des moteurs ? Nous avons parlé de recherche conversationnelle, de l’économie des contenus et de ce que le GEO permet réellement de mesurer.

L’IA a changé les conditions d’entrée dans le search

Le premier obstacle à la création d’un moteur n’est pas seulement de parcourir le Web ou de constituer un index. Il faut surtout savoir classer les résultats selon leur pertinence. Les grands moteurs disposent pour cela de méthodes de learning to rank : des algorithmes apprennent à ordonner les résultats à partir de signaux qui permettent d’en apprécier la qualité.

Pendant longtemps, une source essentielle de ces signaux était le comportement des internautes. Les moteurs installés pouvaient observer des volumes considérables de recherches et d’interactions ; un nouvel acteur, privé de cette masse de données, partait avec un handicap. Sylvain résume le problème : « Il fallait trouver comment simuler cette data. »

Selon lui, l’arrivée des modèles de langage capables d’évaluer des résultats à l’aune de préférences et de jugements humains a changé la donne: « C’est les LLM vraiment alignés sur le comportement humain qui ont tout changé. » Il devient envisageable d’obtenir des évaluations de pertinence sans devoir constituer au préalable une immense base d’interactions réelles.

Sous le capot : moins de gros modèles, plus de modèles spécialisés

Un moteur moderne n’est pas devenu un simple chatbot branché sur le web. Sylvain décrit un fonctionnement qui reste classique dans son organisation générale : exploration des pages, traitement du corpus, succession d’index et de filtres, sélection des documents candidats, puis classement. « Là-dessus, il y a zéro nouveauté. »

Les différences se trouvent dans la manière d’effectuer ces opérations. Ibou emploie du machine learning traditionnel, des petits modèles conçus pour des tâches précises, des modèles dérivés notamment de BERT, ainsi que des modèles plus grands, parfois adaptés à partir de familles existantes. Tous ne produisent pas du texte : certains déterminent une intention, prennent une décision ou renvoient une distribution de probabilités.

Le principe est d’utiliser « le meilleur modèle à la latence la plus faible et le plus petit possible pour la tâche qu’il est capable de réaliser ». Cette recherche d’efficacité tient notamment aux contraintes matérielles de l’équipe, qui ne dispose pas de moyens comparables à ceux des grands groupes et doit travailler avec des GPU aux capacités de mémoire limitées.

Cette architecture change aussi la façon de concevoir certains traitements. Sylvain explique, par exemple, qu’Ibou a remplacé des mécanismes classiques de fusion et de diversification des résultats, associés notamment aux algorithmes RRF et MMR, par une chaîne de traitement fondée sur l’IA. Il décrit également la possibilité de rapprocher des opérations traditionnellement distinctes, comme l’évaluation de la pertinence et la détection du spam.

L’intérêt recherché est de réduire les corrections ponctuelles ajoutées au fil des années pour traiter les problèmes rencontrés par un moteur. Mais cela ne supprime pas les biais : Sylvain considère surtout qu’une décision issue d’un modèle peut produire des biais d’une autre nature que ceux introduits par des interventions humaines ciblées.

Le Search conversationnel change le travail de l’utilisateur

Pour Sylvain, trois façons de rechercher de l’information coexistent : la liste de liens traditionnelle, la synthèse placée au-dessus des résultats — le mode overview — et la recherche véritablement conversationnelle. Il prend soin de distinguer cette dernière d’une simple conversation avec un assistant qui effectue ponctuellement une recherche. Dans le mode qu’il décrit, la conversation sert à poursuivre une recherche structurée, à préciser le contexte et à affiner progressivement le besoin.

Son raisonnement part de l’expérience habituelle de recherche. Avec une liste de liens, l’utilisateur formule une requête, consulte plusieurs pages, compare les informations puis reformule sa recherche. Il construit lui-même sa réponse au fil de ces étapes, y compris à partir de résultats incomplets ou contradictoires. Avec la conversation, une partie de ce travail intellectuel est prise en charge par le système.

À ses yeux, « la partie overview, c’est un entre-deux qui est dû à la technique et à l’habitude des gens. » Elle conserve la présentation familière des résultats tout en fournissant une première synthèse. Mais elle risque également de réduire la consultation effective des sources : plutôt que d’ouvrir les liens, l’utilisateur peut simplement demander une nouvelle synthèse.

Sylvain pense que la recherche conversationnelle pourrait, à terme, supplanter une large part des recherches traditionnelles. Il ne présente cependant pas ce scénario comme une certitude à court terme. Surtout, il s’inquiète de ce qui pourrait disparaître avec cette évolution : la possibilité de chercher volontairement des documents, et pas seulement d’obtenir une réponse.

Comment rémunérer ceux qui alimentent les réponses ?

La recherche générative ne change pas seulement l’interface. Elle remet en cause l’économie qui s’était organisée autour de la recherche Web : une requête, un clic, une visite, puis éventuellement une recette publicitaire ou un abonnement. Désormais, la réponse peut être produite et consommée sans passage par le site qui a fourni les informations.

Sylvain a consacré à cette question un travail académique basé sur la théorie des jeux intitulé When Search Eats the Web. Il en résume le problème : « les outils génératifs, ils captent la valeur des contenus et ils la restituent pas. » Si cette situation perdure, certains producteurs peuvent réserver leurs contenus à leurs abonnés, se retirer des espaces ouverts ou ne plus trouver les moyens de financer leur activité.

Il distingue plusieurs leviers de correction. Le premier dépend des moteurs eux-mêmes : laisser davantage de place aux sources, renoncer parfois à donner une réponse complète ou encourager l’utilisateur à consulter le document d’origine. Le deuxième consiste à organiser une rémunération directe des éditeurs, par décision commerciale ou sous l’effet de dispositifs comme les droits voisins. Le troisième repose sur des interventions plus contraignantes des pouvoirs publics.

Ibou entend agir sur plusieurs de ces plans. Sylvain annonce notamment un système de reversement d’une partie des revenus aux éditeurs. Le principe est affirmé et les modalités restent à construire. Il faut encore déterminer comment attribuer la contribution de chaque source à une réponse, à qui verser les sommes et quelle part des revenus consacrer à cette rémunération.

L’équipe souhaite aussi réduire la pression publicitaire et privilégier une publicité contextuelle, associée à la réponse fournie plutôt qu’au profil de l’utilisateur. C’est un choix qui découle de son manifeste : diversité des sources, respect des contributeurs du Web et indépendance stratégique. Ce sont, à ce stade, des engagements de conception et des intentions annoncées, dont les effets devront pouvoir être observés lorsque les produits seront utilisés à grande échelle.

Une difficulté demeure : inciter à cliquer ne suffit pas nécessairement à préserver le revenu des éditeurs. Ibou réalise déjà des essais de présentation des sources, mais Sylvain constate que les comportements diffèrent selon les sujets et qu’un effort pour orienter les internautes vers les sites ne garantit pas des visites supplémentaires : « Faire son best effort ne garantit rien. »

La question se complique encore avec les assistants et les agents. Ceux-ci peuvent solliciter une API de recherche sans jamais présenter directement à l’utilisateur une page de résultats. Le moteur devient alors un fournisseur d’accès à l’information pour d’autres systèmes. Sylvain défend l’idée que cette infrastructure, puisqu’elle connaît les sources mobilisées, devrait participer à leur rémunération, et reconnaît que ce n’est pas le fonctionnement général actuel du marché.

GEO : la visibilité ne se résume pas à compter des mentions

La dernière partie de notre échange porte sur le GEO, c’est-à-dire les pratiques visant à agir sur la présence des marques et des contenus dans les réponses génératives. Sylvain refuse d’y voir une rupture totale avec le SEO.

Il propose une distinction utile : le SEO a longtemps consisté à rendre les sources découvrables, afin qu’un internaute puisse les trouver puis les consulter. Avec une réponse générative, une seconde opération intervient : le système choisit les informations qu’il va exploiter et présenter à l’utilisateur. « Les LLM prennent une brique de découvrabilité qui existe déjà et ils fabriquent de la visibilité au-dessus de cette découvrabilité. »

Le fait que la machine évalue désormais une partie des contenus ne rend pas les fondamentaux du référencement caducs. Au contraire, Sylvain insiste sur l’importance déjà ancienne de la qualité sémantique des contenus : « Les contenus, c’était ce qui était le plus important, c’est toujours ce qui est le plus important. » Il reconnaît que des manipulations propres aux modèles de langage peuvent parfois fonctionner, notamment des formes d’injection de prompt. Mais il les rapproche des astuces de référencement dont les effets disparaissent lorsque les systèmes apprennent à les neutraliser.

Il observe aussi un enjeu professionnel : la question de la visibilité peut être reprise par des acteurs du marketing qui n’étaient pas historiquement responsables du SEO. À ses yeux, les méthodes changent et le rôle de la sémantique s’accroît, sans que cela fasse nécessairement apparaître un métier entièrement distinct.

Sur la mesure, sa critique est plus radicale. Les outils génératifs produisent des réponses variables, sensibles au contexte, au moment de la requête et à la personnalisation. Compter les apparitions d’une marque sur un échantillon de prompts peut renseigner sur les sorties observées, mais ne démontre pas l’effet réel sur les comportements des utilisateurs.

Sylvain estime qu’« on veut faire des espèces de mesures de visibilité alors qu’on devrait faire de l’attribution comportementale ». Il plaide pour des études d’impact : comprendre si l’exposition à un système se traduit par davantage de visites, d’achats ou de relations avec une marque. De telles mesures sont plus coûteuses et plus complexes que des relevés de positionnement, mais elles se rapprochent des questions économiques que les entreprises cherchent réellement à résoudre.

Quel accès au Web voulons-nous conserver ?

Ibou entend proposer plusieurs modes d’accès à l’information : des applications de découverte et d’actualité, une API de recherche, un moteur à liens et des formes de recherche conversationnelle. Cette diversité répond à des usages différents, mais aussi à l’incertitude sur la direction que prendra le marché.

La discussion revient finalement à l’indépendance stratégique. Pour Sylvain, les infrastructures d’accès à l’information ne sont pas des outils neutres du point de vue social : elles influencent les sources que nous découvrons, les réponses auxquelles nous accordons notre confiance et les modèles économiques qui rendent la production d’information possible. Les choix d’architecture, de classement, de publicité ou de rémunération participent donc aussi de choix de société.

Il reste prudent sur les perspectives. Les assistants pourraient devenir l’interface dominante, tandis que les moteurs de recherche classiques seraient principalement utilisés en arrière-plan, par des machines. Mais ce scénario soulève une question que l’on oublie facilement lorsque l’on célèbre la commodité des réponses toutes faites : voulons-nous encore accéder nous-mêmes aux documents ?

« Ce serait dommage que ces outils d’accès soient réservés à des machines, et plus à des humains. »

Cette synthèse et sa rédaction ont été générées par GPT-6 Astra

💾

  • ✇PandIA
  • Microsoft 365 tombe en panne, ChatGPT et Claude perdent l’accès aux outils de travail
    Une panne de Microsoft 365 n’a pas seulement perturbé les boîtes mail et les réunions en ligne. Elle a aussi dégradé l’accès de ChatGPT et Claude aux outils professionnels, révélant une dépendance commune à une même infrastructure.Une panne qui dépasse Outlook et TeamsLa perturbation a commencé le jeudi 12 novembre et se poursuivait le lendemain dans plusieurs régions. Les services les plus visibles, Outlook et Teams, ont été touchés, tout comme Copilot, l’assistant d’IA intégré à l’environnemen

Microsoft 365 tombe en panne, ChatGPT et Claude perdent l’accès aux outils de travail

Par : 0xMonkey
13 novembre 2026 à 19:01
Microsoft 365 tombe en panne, ChatGPT et Claude perdent l’accès aux outils de travail

Une panne de Microsoft 365 n’a pas seulement perturbé les boîtes mail et les réunions en ligne. Elle a aussi dégradé l’accès de ChatGPT et Claude aux outils professionnels, révélant une dépendance commune à une même infrastructure.

Une panne qui dépasse Outlook et Teams

La perturbation a commencé le jeudi 12 novembre et se poursuivait le lendemain dans plusieurs régions. Les services les plus visibles, Outlook et Teams, ont été touchés, tout comme Copilot, l’assistant d’IA intégré à l’environnement Microsoft.

Des milliers d’utilisateurs ont signalé des difficultés, notamment pour consulter leurs courriels, rejoindre des réunions ou accéder à certains services professionnels. Le tableau de bord de suivi Downdetector a enregistré une forte hausse des signalements aux États-Unis, tandis que Microsoft indiquait vendredi que le rétablissement progressait dans plusieurs zones géographiques.

La panne n’a pas affecté tous les utilisateurs de manière identique. Certains services semblaient accessibles, tandis que d’autres rencontraient des erreurs d’authentification, des problèmes de connexion ou des ralentissements. Ce fonctionnement partiel complique la gestion de crise : une entreprise peut encore recevoir des messages, mais ne plus accéder à son calendrier, à ses fichiers ou à ses réunions.

Les conséquences ont dépassé le secteur privé. Des services publics et des entreprises ont été perturbés, avec des répercussions très concrètes sur les échanges internes et les rendez-vous à distance. Une société américaine a même reporté un appel consacré à ses résultats trimestriels, faute de pouvoir s’appuyer normalement sur les outils de communication de Microsoft.

ChatGPT et Claude privés de leurs connexions professionnelles

L’incident a également touché les connecteurs Microsoft 365 proposés par les assistants d’IA. OpenAI a signalé des difficultés avec l’intégration Microsoft 365 de ChatGPT, tandis qu’Anthropic a fait de même pour Claude.

Ces connecteurs permettent à un utilisateur autorisé de relier un assistant à ses courriels, calendriers, fichiers ou conversations professionnelles. L’IA peut ensuite rechercher une information dans une boîte Outlook, résumer des échanges, retrouver un document ou préparer une réponse à partir du contexte disponible.

Lorsque Microsoft 365 rencontre un problème, l’assistant ne perd pas nécessairement ses capacités de génération de texte. En revanche, il ne peut plus interroger correctement les services auxquels il est connecté. Un utilisateur peut encore demander à ChatGPT ou Claude de rédiger un message générique, mais pas forcément de retrouver le courriel précis contenant les dernières instructions d’un client.

Cette distinction est importante. Il ne s’agit pas d’une panne des modèles d’IA eux-mêmes, mais d’une rupture sur la chaîne d’accès aux données. L’assistant fonctionne ; ses sources professionnelles, elles, deviennent momentanément indisponibles.

Le même point de fragilité pour plusieurs concurrents

Le cas met en évidence une concentration moins visible que celle des modèles. ChatGPT et Claude sont concurrents sur le marché des assistants, mais leurs usages en entreprise peuvent reposer sur les mêmes briques : identité Microsoft, autorisations, interfaces de programmation (API) et services de stockage ou de messagerie.

Cette dépendance est logique. Microsoft 365 reste l’un des environnements de travail dominants dans les grandes organisations. Proposer une intégration avec Outlook, Teams ou SharePoint est donc presque indispensable pour un assistant destiné aux entreprises. Mais cette compatibilité crée un risque partagé : plusieurs outils concurrents peuvent subir simultanément les effets d’un incident chez le même fournisseur.

Le phénomène rappelle que la résilience d’un service d’IA ne dépend pas uniquement de la disponibilité de ses serveurs ou de la qualité de ses modèles. Elle dépend aussi de dizaines de services périphériques : authentification, stockage, recherche documentaire, systèmes de permissions et réseaux d’entreprise.

Une dépendance qui devient opérationnelle

Pour les entreprises, l’incident pose une question très concrète : que reste-t-il d’un assistant connecté lorsque les systèmes auxquels il accède sont indisponibles ?

Dans de nombreux déploiements, l’intérêt de l’IA ne réside pas seulement dans la conversation. Il tient à sa capacité à exploiter les données internes de l’organisation. Un assistant sans accès aux courriels, aux documents ou au calendrier redevient un outil généraliste, avec une valeur moindre pour les équipes qui l’utilisent au quotidien.

Le problème concerne aussi les mécanismes de sécurité. Les connecteurs doivent vérifier l’identité de l’utilisateur et respecter ses droits d’accès. Si l’annuaire ou le service d’authentification de Microsoft est perturbé, le connecteur peut être désactivé par précaution, même si le modèle d’IA reste disponible. La sécurité impose alors une limitation supplémentaire à la disponibilité.

Les organisations doivent donc distinguer plusieurs niveaux de continuité : accès à l’assistant, accès aux données, capacité à effectuer une action et capacité à vérifier que cette action respecte les droits de l’utilisateur. Une interruption de quelques heures peut suffire à désorganiser un processus reposant sur ces quatre éléments.

Le prochain test : le retour complet et l’analyse de l’incident

Microsoft indiquait vendredi que le rétablissement progressait dans plusieurs régions, mais la fin des signalements ne constituera pas à elle seule une réponse complète. Les entreprises attendront surtout les informations sur la cause de l’incident, sa durée exacte et les mesures destinées à éviter une répétition.

Pour OpenAI et Anthropic, le prochain enjeu sera de préciser le comportement attendu de leurs connecteurs en cas d’indisponibilité de Microsoft 365 : message d’erreur explicite, mode dégradé, reprise automatique des requêtes ou possibilité de basculer vers d’autres sources.

À court terme, les équipes informatiques devront tester des solutions de secours mesurables : canaux de communication alternatifs, accès indépendant aux calendriers critiques, procédures manuelles et surveillance séparée des connecteurs d’IA. La panne aura montré une réalité simple : la multiplication des assistants ne réduit pas forcément la dépendance à une infrastructure commune. Tant que les mêmes outils de travail, d’identité et de données resteront au cœur de leurs intégrations, un incident chez un fournisseur pourra immobiliser simultanément plusieurs assistants pourtant concurrents.

Sources : Associated Press, Investing.com.

Microsot annonce que la fonctionnalité « Bring Your Own Model » (BYOM) est disponible pour tous dans Visual Studio, permettant aux développeurs d'utiliser leurs propres modèles d'IA sans quitter l'EDI

Microsot annonce que la fonctionnalité « Bring Your Own Model » (BYOM) est disponible pour tous dans Visual Studio, permettant aux développeurs d'utiliser leurs propres modèles d'IA sans quitter l'EDI

Microsoft a annoncé que la fonctionnalité « Bring Your Own Model » (BYOM) est désormais disponible pour tous dans Visual Studio. Que votre équipe héberge ses propres modèles d'IA, que vous disposiez d'une clé API fournie par un fournisseur de modèles ou que vous souhaitiez tester un modèle exécuté sur...

Google lance Gemini 4 Hydrogen, un modèle Gemini plus rapide destiné au codage et aux tâches basées sur des agents, présenté comme une mise à jour de Gemini 3.8 Flash

Google lance Gemini 4 Hydrogen, un modèle Gemini plus rapide destiné au codage et aux tâches basées sur des agents, présenté comme une mise à jour de Gemini 3.8 Flash

Google a annoncé, le 12 novembre, le déploiement mondial de « Gemini 4 Hydrogen » au sein de ses produits destinés aux développeurs, aux entreprises et au grand public.. La société a précisé qu'il s'agissait d'un modèle Gemini plus rapide, conçu pour le codage et d'autres tâches basées sur des agents. Google a également présenté Orchestrator...

Alice Huang, l'espionne chinoise présumée liée à la liaison extraconjugale de Jensen Huang, entretient des liens avec des entreprises qui ont fourni de la puissance de calcul Nvidia à Huawei

Alice Huang, l'espionne chinoise présumée liée à la liaison extraconjugale de Jensen Huang, entretient des liens avec des entreprises qui ont fourni de la puissance de calcul de Nvidia à Huawei

Une société privée de renseignement a établi un lien entre Alice Huang, l'espionne chinoise présumée avec laquelle l'ancien PDG de Nvidia, Jensen Huang, a admis avoir eu une liaison, et des entreprises qui auraient fourni de la puissance de calcul de Nvidia à Huawei. Les conclusions de Tesari retracent une...

Google lance un nouveau modèle d'IA multimodal spécialisé, Gemini Decisions API 1, capable d'évaluer jusqu'à 1 000 questions à partir d'une même entrée, et de renvoyer des probabilités calibrées

Google lance un nouveau modèle d'IA multimodal spécialisé, Gemini Decisions API 1, capable d'évaluer jusqu'à 1 000 questions à partir d'une même entrée et de renvoyer des probabilités calibrées

Google a lancé l'API Gemini Decisions, un nouveau point de terminaison conçu pour prendre rapidement des décisions dans un ensemble fermé. Elle fonctionne sur un nouveau modèle appelé Gemini Decision 1 et est disponible via l'API Gemini dans Google AI Studio. Son champ d'application est délibérément restreint...

  • ✇PandIA
  • Comment utiliser l’IA pour créer une présentation commerciale efficace
    Utiliser l’IA pour créer une présentation commerciale permet de concevoir plus rapidement un support PowerPoint, un pitch deck ou une présentation client structurée et convaincante. Ce guide explique comment utiliser l’intelligence artificielle pour préparer le contenu, organiser les diapositives, améliorer le design, personnaliser le discours et vérifier la qualité finale.Qu’est-ce qu’une présentation commerciale créée avec l’IA ?Une présentation commerciale est un support destiné à présenter u

Comment utiliser l’IA pour créer une présentation commerciale efficace

Par : Vicomte
13 novembre 2026 à 12:05
Comment utiliser l’IA pour créer une présentation commerciale efficace

Utiliser l’IA pour créer une présentation commerciale permet de concevoir plus rapidement un support PowerPoint, un pitch deck ou une présentation client structurée et convaincante. Ce guide explique comment utiliser l’intelligence artificielle pour préparer le contenu, organiser les diapositives, améliorer le design, personnaliser le discours et vérifier la qualité finale.

Qu’est-ce qu’une présentation commerciale créée avec l’IA ?

Une présentation commerciale est un support destiné à présenter une entreprise, une offre, un produit ou un service à un prospect, un client, un partenaire ou un investisseur. Elle peut prendre plusieurs formes :

  • présentation de prospection ;
  • démonstration produit ;
  • proposition commerciale ;
  • présentation de résultats ;
  • pitch deck pour une levée de fonds ;
  • support de rendez-vous client ;
  • présentation interne destinée à une équipe commerciale ;
  • présentation de lancement ou de campagne marketing.

L’intelligence artificielle peut intervenir à plusieurs étapes :

  1. Analyse de la cible et des objectifs ;
  2. Construction du plan de présentation ;
  3. Rédaction des textes et des arguments ;
  4. Création ou sélection de visuels ;
  5. Mise en page des diapositives ;
  6. Préparation du discours oral ;
  7. Relecture, personnalisation et contrôle des informations.

L’IA ne remplace pas la stratégie commerciale. Elle accélère surtout la production et aide à structurer les idées. La pertinence de la présentation dépend toujours de la connaissance du marché, de la qualité des données et de la compréhension des besoins du prospect.

Pourquoi utiliser l’IA pour créer une présentation commerciale ?

Gagner du temps

Créer une présentation commerciale manuellement peut prendre plusieurs heures, voire plusieurs jours lorsqu’il faut rechercher les informations, rédiger les textes et harmoniser la mise en page. Un outil d’IA peut produire une première structure en quelques minutes.

Ce gain de temps concerne notamment :

  • le plan des diapositives ;
  • les titres et sous-titres ;
  • les arguments de vente ;
  • les reformulations ;
  • les résumés de documents ;
  • les idées de visuels ;
  • les notes destinées à l’orateur.

La première version générée ne doit toutefois pas être considérée comme définitive. Elle sert de base de travail.

Adapter le message à chaque prospect

Une présentation destinée à une PME industrielle ne doit pas reprendre exactement le même discours qu’une présentation adressée à une direction marketing ou à un comité d’achat public.

L’IA peut aider à décliner le contenu selon :

  • le secteur d’activité ;
  • la taille de l’entreprise ;
  • la fonction du destinataire ;
  • les problèmes rencontrés ;
  • le niveau de connaissance du produit ;
  • le contexte de la prise de parole ;
  • le temps disponible.

Cette personnalisation améliore la pertinence commerciale, à condition de fournir des informations fiables sur la cible.

Améliorer la clarté

Les présentations commerciales contiennent souvent trop de texte, trop de fonctionnalités ou des formulations trop techniques. L’IA peut transformer un contenu complexe en messages plus simples :

  • une idée principale par diapositive ;
  • des titres orientés vers le bénéfice ;
  • des phrases plus courtes ;
  • des listes plus lisibles ;
  • des exemples adaptés au public.

Produire rapidement plusieurs formats

À partir d’un même contenu, l’IA peut aider à créer :

  • une présentation de 5 diapositives pour un premier rendez-vous ;
  • un support de 15 diapositives pour une démonstration ;
  • une version détaillée pour un appel d’offres ;
  • un résumé d’une page ;
  • un script oral de 10 minutes ;
  • un e-mail de suivi après la présentation.

Quels outils d’IA utiliser pour une présentation commerciale ?

Le meilleur outil dépend du format recherché, du niveau de personnalisation et de l’environnement de travail.

ChatGPT, Claude ou Gemini pour le contenu

Les assistants conversationnels sont utiles pour :

  • définir la structure ;
  • créer un argumentaire ;
  • reformuler des textes ;
  • identifier les objections ;
  • générer des titres ;
  • produire des notes de présentation ;
  • simuler les questions d’un prospect.

Ils ne créent pas toujours directement une présentation finalisée avec une mise en page professionnelle, mais ils sont particulièrement efficaces pour la stratégie et la rédaction.

PowerPoint avec des fonctions d’IA

Les fonctionnalités d’IA intégrées à l’écosystème Microsoft peuvent aider à générer un plan ou des diapositives à partir d’un texte, d’un document ou d’une demande formulée en langage naturel. L’intérêt principal réside dans l’intégration avec PowerPoint, les modèles existants et les outils déjà utilisés par les équipes commerciales.

Une vérification manuelle reste nécessaire, notamment pour :

  • les chiffres ;
  • les graphiques ;
  • les images ;
  • les droits d’utilisation ;
  • la cohérence avec la charte graphique.

Google Slides et les fonctions Gemini

Les fonctions d’IA de Google peuvent assister la création de contenu dans l’environnement Google Workspace, selon le forfait et la disponibilité géographique. Cette solution convient aux équipes qui travaillent déjà avec Google Slides, Drive et les documents partagés.

Canva, Gamma, Beautiful.ai et Pitch

Ces plateformes peuvent générer des présentations à partir d’une consigne ou d’un contenu existant. Elles proposent souvent :

  • des modèles visuels ;
  • une mise en page automatisée ;
  • des suggestions d’images ;
  • des blocs de contenu préformatés ;
  • une exportation vers PDF ou PowerPoint.

Avant de choisir une solution, il est utile de vérifier :

  • les formats d’export disponibles ;
  • la qualité des fichiers PowerPoint exportés ;
  • les limites du forfait gratuit ;
  • la gestion des données confidentielles ;
  • les droits associés aux images générées ;
  • les options de collaboration ;
  • la compatibilité avec la charte graphique de l’entreprise.

Comment créer une présentation commerciale avec l’IA ?

1. Définir l’objectif commercial

Une bonne présentation commence par un objectif précis. Il ne suffit pas d’indiquer « présenter l’entreprise ».

L’objectif peut être :

  • obtenir un rendez-vous de démonstration ;
  • convaincre un prospect de tester une solution ;
  • faire valider un budget ;
  • présenter une offre personnalisée ;
  • préparer une négociation ;
  • déclencher une signature ;
  • obtenir un investissement ;
  • expliquer un retour sur investissement.

Une présentation peut contenir plusieurs informations, mais un seul objectif principal doit guider le contenu.

Exemple de consigne :

Agis comme un responsable commercial B2B. Aide à créer une présentation de 10 diapositives destinée à obtenir un rendez-vous de démonstration avec des directeurs financiers de PME. L’objectif est de montrer comment la solution réduit le temps consacré au reporting et améliore la fiabilité des données.

2. Décrire précisément la cible

L’IA produit des résultats plus pertinents lorsque le contexte est détaillé. Il faut préciser :

  • le profil du prospect ;
  • sa fonction ;
  • son secteur ;
  • la taille de son entreprise ;
  • ses problèmes prioritaires ;
  • ses objections probables ;
  • son niveau de connaissance ;
  • son pouvoir de décision ;
  • le ton souhaité.

Exemple :

La cible est composée de responsables des ressources humaines dans des entreprises françaises de 100 à 500 salariés. Leur problème principal est le suivi manuel des absences et des indicateurs sociaux. Ils recherchent une solution rapide à déployer, conforme au RGPD et compatible avec leur logiciel de paie.

Cette étape permet d’éviter une présentation trop générale, centrée uniquement sur l’entreprise vendeuse.

3. Fournir les informations fiables sur l’offre

L’IA ne connaît pas nécessairement les spécificités réelles d’une offre. Les éléments suivants doivent être transmis :

  • nom du produit ou du service ;
  • fonctionnalités principales ;
  • bénéfices clients ;
  • prix ou fourchette tarifaire ;
  • délais de déploiement ;
  • conditions contractuelles ;
  • résultats mesurés ;
  • études de cas ;
  • certifications ;
  • intégrations disponibles ;
  • limites du produit ;
  • éléments différenciants.

Il est préférable de distinguer clairement :

  • les faits vérifiés ;
  • les hypothèses ;
  • les messages à reformuler ;
  • les informations à compléter.

Une consigne utile :

Utilise uniquement les informations fournies ci-dessous. N’invente aucune statistique, certification, fonctionnalité ou référence client. Lorsque les données manquent, indique « information à confirmer ».

4. Construire le plan des diapositives

Une structure commerciale efficace suit généralement la logique du prospect : problème, conséquences, solution, preuves et prochaine étape.

Voici un exemple de plan en 10 diapositives :

  1. Titre et promesse principale ;
  2. Contexte ou problème rencontré par la cible ;
  3. Conséquences du problème ;
  4. Présentation de la solution ;
  5. Fonctionnement en trois étapes ;
  6. Bénéfices mesurables ;
  7. Preuve : cas client, résultats ou témoignage ;
  8. Différenciation face aux alternatives ;
  9. Déploiement, accompagnement et tarifs ;
  10. Appel à l’action.

Cette structure peut être modifiée selon le contexte. Une présentation de prospection doit rester courte, tandis qu’une réponse à un appel d’offres peut nécessiter davantage de détails.

5. Transformer les fonctionnalités en bénéfices

Une erreur fréquente consiste à présenter une liste de fonctionnalités sans expliquer leur valeur.

Exemple :

  • Fonctionnalité : automatisation des rapports ;
  • Bénéfice : réduction du temps passé à compiler les données ;
  • Résultat commercial : davantage de temps consacré à l’analyse et à la prise de décision.

L’IA peut aider à effectuer cette transformation avec une consigne comme :

Pour chaque fonctionnalité, indique le problème résolu, le bénéfice concret pour le client, le résultat attendu et un exemple d’utilisation. Évite les promesses non vérifiables.

Les titres des diapositives doivent idéalement exprimer une idée ou un bénéfice. Un titre comme « Une mise en place en moins de 30 jours » est plus informatif que « Déploiement », si le délai est vérifié.

6. Rédiger une présentation concise

Une diapositive commerciale doit être lisible rapidement. L’IA peut réduire un texte trop long selon plusieurs contraintes :

Résume ce contenu en une diapositive destinée à un comité de direction. Propose un titre orienté vers le bénéfice, trois points clés de 12 mots maximum et une phrase de conclusion. Supprime le jargon et conserve uniquement les informations vérifiables.

Quelques règles pratiques :

  • une idée principale par diapositive ;
  • trois à cinq éléments visuels ou textuels importants ;
  • des phrases courtes ;
  • des verbes d’action ;
  • des données mises en évidence ;
  • un vocabulaire compréhensible par la cible ;
  • une hiérarchie visuelle claire.

Le texte affiché à l’écran ne doit pas reproduire intégralement le discours oral. Les explications détaillées peuvent figurer dans les notes du présentateur.

7. Générer les visuels et les graphiques

L’IA peut proposer :

  • des illustrations conceptuelles ;
  • des icônes ;
  • des schémas de processus ;
  • des images de contexte ;
  • des idées de graphiques ;
  • des représentations avant/après ;
  • des frises chronologiques.

Les graphiques doivent être construits à partir de données vérifiées. L’IA peut suggérer une représentation, mais elle ne doit pas inventer les valeurs.

Le choix du visuel dépend du message :

  • courbe pour une évolution dans le temps ;
  • barres pour comparer des catégories ;
  • entonnoir pour représenter un parcours commercial ;
  • schéma en étapes pour expliquer un processus ;
  • tableau simple pour comparer des offres ;
  • chiffre clé pour mettre en avant un résultat.

Les images générées artificiellement doivent être vérifiées, particulièrement lorsque la présentation concerne un produit technique, un environnement industriel ou une personne réelle. Les erreurs visuelles peuvent nuire à la crédibilité.

8. Appliquer une charte graphique cohérente

Une présentation commerciale doit être cohérente avec l’identité de l’entreprise. Les éléments à définir sont :

  • couleurs principales et secondaires ;
  • polices ;
  • taille minimale des textes ;
  • style des images ;
  • forme des icônes ;
  • emplacement du logo ;
  • marges ;
  • style des graphiques ;
  • modèle de page de couverture ;
  • modèle de page de conclusion.

Une consigne efficace :

Utilise un style sobre et professionnel, avec une dominante bleu foncé, une couleur d’accent orange, beaucoup d’espace blanc et une hiérarchie visuelle adaptée à une audience de dirigeants. Évite les effets décoratifs, les arrière-plans chargés et les textes trop petits.

L’automatisation du design est utile, mais une relecture humaine doit vérifier l’alignement, les sauts de ligne, les contrastes et la lisibilité sur grand écran.

9. Préparer le discours oral

Une bonne présentation commerciale ne repose pas uniquement sur les diapositives. L’IA peut générer des notes pour chaque page :

  • message principal ;
  • exemple à citer ;
  • transition vers la diapositive suivante ;
  • question à poser au prospect ;
  • objection possible ;
  • réponse recommandée ;
  • durée indicative.

Exemple de demande :

Rédige les notes orales associées à chaque diapositive. Le discours doit durer 8 minutes, adopter un ton direct et professionnel, commencer par une question au prospect et se terminer par une proposition de rendez-vous de 30 minutes.

Il est conseillé de parler avec ses propres mots plutôt que de lire un texte généré mot à mot. Le discours doit rester naturel et adapté aux réactions de l’audience.

10. Ajouter un appel à l’action clair

La dernière diapositive doit indiquer la suite attendue. Un appel à l’action peut être :

  • planifier une démonstration ;
  • valider un atelier de cadrage ;
  • tester la solution ;
  • demander un devis ;
  • organiser un échange avec un expert ;
  • lancer un projet pilote ;
  • transmettre les coordonnées du décideur.

Un appel à l’action vague comme « Merci pour votre attention » ne donne aucune direction. Une formulation plus efficace serait :

Prochaine étape : planifier une démonstration personnalisée de 30 minutes mardi ou jeudi prochain.

Quel prompt utiliser pour créer une présentation commerciale ?

Voici un modèle de prompt complet :

Agis comme un consultant en stratégie commerciale et en présentation B2B.
Crée le plan d’une présentation de [nombre] diapositives pour [cible].
Objectif commercial : [objectif].
Contexte : [contexte du rendez-vous].
Offre : [description].
Problèmes rencontrés par la cible : [problèmes].
Différenciateurs : [différenciateurs].
Preuves disponibles : [preuves].
Ton : [ton].
Durée de présentation : [durée].
Contraintes : une idée principale par diapositive, trois points maximum par page, aucune statistique inventée.
Pour chaque diapositive, indique le titre, le message principal, le contenu à afficher, le visuel recommandé et les notes du présentateur.

Pour améliorer la réponse, il est possible de demander plusieurs variantes :

  • une version courte de 5 diapositives ;
  • une version destinée à un dirigeant ;
  • une version plus technique ;
  • une version orientée retour sur investissement ;
  • une version adaptée à un prospect déjà convaincu ;
  • une version conçue pour répondre à des objections précises.

Comment vérifier une présentation générée par l’IA ?

Contrôler les informations

Chaque élément factuel doit être vérifié :

  • chiffres ;
  • pourcentages ;
  • dates ;
  • références clients ;
  • citations ;
  • certifications ;
  • résultats annoncés ;
  • fonctionnalités ;
  • prix ;
  • délais ;
  • mentions réglementaires.

Les hallucinations, c’est-à-dire les informations plausibles mais fausses générées par un modèle, représentent un risque important dans une présentation commerciale.

Vérifier la conformité juridique

Avant de transmettre le fichier, il faut contrôler :

  • la confidentialité des données communiquées à l’outil ;
  • la présence éventuelle de données personnelles ;
  • le respect du RGPD ;
  • les droits sur les images ;
  • les licences des polices ;
  • l’utilisation de logos ou de marques tierces ;
  • les clauses de confidentialité ;
  • les promesses commerciales.

Les informations sensibles, les fichiers clients et les données financières ne doivent pas être copiés dans un outil public sans validation de la politique de sécurité de l’entreprise.

Tester la lisibilité

La présentation doit être testée :

  • sur un ordinateur portable ;
  • sur un écran de salle de réunion ;
  • en visioconférence ;
  • en mode PDF ;
  • en noir et blanc si nécessaire ;
  • avec une taille de police confortable ;
  • avec un contraste suffisant.

Une présentation lisible sur un écran de 27 pouces peut devenir difficile à suivre lors d’un partage d’écran compressé.

Combien de diapositives prévoir ?

Le nombre idéal dépend du contexte et du temps disponible. À titre indicatif :

  • 3 à 5 diapositives pour une prise de contact rapide ;
  • 7 à 10 diapositives pour un rendez-vous commercial standard ;
  • 10 à 15 diapositives pour une démonstration ou une proposition ;
  • 15 à 25 diapositives pour un appel d’offres ou une présentation détaillée.

Une règle souvent utile consiste à prévoir environ une à deux minutes par diapositive, sans en faire une contrainte rigide. Une page très visuelle peut être commentée en quelques secondes, tandis qu’un schéma complexe demande davantage de temps.

La durée du rendez-vous doit également inclure les questions. Une présentation de 20 minutes ne devrait pas comporter 20 minutes de contenu sans pause.

Quand faut-il éviter de confier toute la présentation à l’IA ?

L’IA est moins adaptée lorsque :

  • le message stratégique n’est pas encore défini ;
  • les données disponibles sont incomplètes ;
  • la présentation concerne une négociation sensible ;
  • les informations sont hautement confidentielles ;
  • la cible attend un point de vue très personnel ;
  • le sujet exige une expertise réglementaire ;
  • la crédibilité repose sur une expérience de terrain ;
  • les résultats annoncés doivent être juridiquement engageants.

Dans ces situations, l’IA peut assister la rédaction ou la mise en forme, mais la validation par un expert reste indispensable.

Les erreurs à éviter

Utiliser un contenu générique

Une présentation remplie de formulations comme « solution innovante », « expérience exceptionnelle » ou « accompagnement sur mesure » manque de crédibilité. Chaque promesse doit être reliée à un problème concret, une preuve ou un résultat mesurable.

Surcharger les diapositives

L’IA peut générer beaucoup de texte. Il faut supprimer les informations secondaires et conserver uniquement ce qui aide à atteindre l’objectif commercial.

Inventer des chiffres

Un pourcentage non vérifié peut fragiliser toute la présentation. En cas de doute, mieux vaut indiquer une donnée manquante que présenter une estimation comme un fait.

Confondre fonctionnalités et valeur

Une liste de fonctions ne suffit pas à convaincre. Le prospect doit comprendre ce qui change concrètement pour son entreprise.

Négliger la conclusion

Une présentation sans prochaine étape claire risque de se terminer sans décision. L’appel à l’action doit être simple, réaliste et directement lié à l’objectif du rendez-vous.

Conclusion : les points clés à retenir

L’IA permet de créer plus rapidement une présentation commerciale, mais son efficacité dépend de la qualité du cadrage et de la validation humaine.

Les étapes essentielles sont les suivantes :

  1. définir un objectif commercial précis ;
  2. décrire la cible et ses problèmes ;
  3. transmettre uniquement des informations fiables ;
  4. construire une structure centrée sur le besoin du prospect ;
  5. transformer les fonctionnalités en bénéfices ;
  6. limiter le texte présent sur chaque diapositive ;
  7. utiliser des visuels cohérents et des données vérifiées ;
  8. personnaliser la présentation selon l’audience ;
  9. préparer les notes et les objections ;
  10. contrôler les faits, la sécurité, les droits et la lisibilité ;
  11. terminer par un appel à l’action concret.

Une présentation générée avec l’IA ne doit donc pas être considérée comme un produit fini. Elle constitue une première version structurée, à enrichir avec l’expertise commerciale, les preuves disponibles et la compréhension réelle du client.

« C'est une erreur » : des employés de Nvidia se mobilisent pour exiger le retour de Jensen Huang, tandis que les patrons de la tech qualifient sa démission de « gâchis » et de « triste jour pour l'humanité »

« C'est une erreur » : des employés de Nvidia se mobilisent pour exiger le retour de Jensen Huang, tandis que les patrons de la tech qualifient sa démission de « gâchis » et de « triste jour pour l'humanité »

Le départ soudain de Jensen Huang de la tête de Nvidia ébranle l'entreprise et suscite une levée de boucliers dans la communauté technologique. De nombreux employés se mobilisent pour réclamer son retour immédiat. Bien que la crise ait entraîné une chute brutale de la valeur boursière de l'entreprise...

Panne de Claude : l’IA ne répond plus chez une partie des utilisateurs, voici ce que l’on sait

Claude rencontre des difficultés ce vendredi 13 novembre : Anthropic confirme un problème de connexion à Claude.ai et Claude Code, sans annoncer de délai de rétablissement.

« Ramenez LE patron » : chez Nvidia, des salariés réclament le retour de Jensen Huang

Au lendemain de la démission de Jensen Huang, une partie des salariés de Nvidia refuse de tourner la page. Selon des messages internes consultés par Wired, certains demandent au conseil d'administration de faire revenir leur fondateur.

  • ✇PandIA
  • Jensen Huang quitte Nvidia après 33 ans, l’action chute de 14 % en quelques heures
    Le départ de Jensen Huang met fin, avec effet immédiat, à l’une des plus longues continuités dirigeantes de la tech mondiale. En quelques heures, Nvidia a perdu son PDG, son président et l’un de ses administrateurs, au moment même où l’entreprise occupe une position centrale dans l’essor des infrastructures d’intelligence artificielle.Une rupture brutale après 33 ans de pouvoirNvidia a annoncé le 12 novembre 2026 la démission immédiate de Jensen Huang de l’ensemble de ses fonctions. Le dirigeant

Jensen Huang quitte Nvidia après 33 ans, l’action chute de 14 % en quelques heures

Par : Vicomte
13 novembre 2026 à 07:00
Jensen Huang quitte Nvidia après 33 ans, l’action chute de 14 % en quelques heures

Le départ de Jensen Huang met fin, avec effet immédiat, à l’une des plus longues continuités dirigeantes de la tech mondiale. En quelques heures, Nvidia a perdu son PDG, son président et l’un de ses administrateurs, au moment même où l’entreprise occupe une position centrale dans l’essor des infrastructures d’intelligence artificielle.

Une rupture brutale après 33 ans de pouvoir

Nvidia a annoncé le 12 novembre 2026 la démission immédiate de Jensen Huang de l’ensemble de ses fonctions. Le dirigeant quitte ainsi la direction opérationnelle, la présidence du conseil d’administration et son siège d’administrateur, après 33 ans à la tête de l’entreprise qu’il a cofondée.

Cette simultanéité exclut une simple transition préparée de longue date. Elle prive Nvidia de la figure qui incarnait à la fois sa stratégie, sa culture d’ingénierie et sa relation avec les grands clients du cloud. Huang avait progressivement fait passer l’entreprise du statut de spécialiste des processeurs graphiques à celui de fournisseur stratégique des GPU utilisés pour entraîner et exécuter les grands modèles d’IA.

Sous son impulsion, Nvidia est devenue le principal bénéficiaire de la course aux capacités de calcul. Ses puces équipent les centres de données de Microsoft, Amazon, Google, Meta et de nombreux acteurs spécialisés. Cette dépendance industrielle a placé Huang au centre d’un écosystème qui dépasse largement le périmètre financier de Nvidia.

Le conseil d’administration a confié l’intérim à Colette Kress, directrice financière depuis 2013. Son profil apporte une continuité immédiate sur les résultats, les relations avec les investisseurs et la discipline financière. Il ne constitue toutefois pas, à ce stade, une réponse complète à la question stratégique : qui portera la vision technologique et commerciale de l’entreprise après Huang ?

Une enquête liée à une possible opération étrangère

La démission intervient après une enquête indépendante menée par le conseil d’administration. Celle-ci faisait suite à des informations évoquant une possible opération de renseignement étrangère visant Jensen Huang.

Le communiqué de Nvidia ne transforme pas ces informations en faits établis. La formulation est importante : l’existence d’une enquête indépendante signale un risque suffisamment sérieux pour justifier une procédure formelle, mais ne permet pas, à elle seule, de conclure à une implication ou à une faute du dirigeant.

L’affaire ouvre plusieurs fronts de risque. Nvidia est un acteur particulièrement exposé aux tensions géopolitiques autour des semi-conducteurs, notamment en raison des restrictions américaines visant les exportations de processeurs avancés vers la Chine. Une opération étrangère supposée visant son dirigeant pourrait concerner le renseignement industriel, l’influence, la collecte d’informations sensibles ou la pression exercée sur un groupe devenu stratégique pour la sécurité économique américaine.

Le conseil devra donc gérer deux impératifs contradictoires : préserver la confidentialité de l’enquête et rassurer les marchés sur la solidité des contrôles internes. Une communication trop limitée alimenterait les spéculations. Des détails prématurés pourraient, à l’inverse, compromettre les procédures en cours ou exposer davantage Nvidia.

Le marché sanctionne l’incertitude

La réaction initiale de Wall Street a été immédiate. L’action Nvidia a chuté de 14 % après l’annonce, avant de réduire une partie de ses pertes. Ce mouvement ne reflète pas uniquement une inquiétude sur les résultats à court terme. Il traduit une réévaluation du risque de gouvernance et de la capacité de l’entreprise à maintenir son avance sans son fondateur.

La prime accordée à Nvidia reposait en partie sur des indicateurs financiers — croissance du chiffre d’affaires, marges élevées, demande pour les centres de données — mais aussi sur la confiance dans la capacité de Huang à anticiper les évolutions du marché. Son départ introduit une inconnue dans une équation déjà très exigeante : Nvidia doit continuer à investir massivement alors que ses concurrents développent leurs propres puces et que les grands clients du cloud cherchent à réduire leur dépendance à un seul fournisseur.

Une baisse de 14 % représente une destruction de valeur considérable pour un groupe de la taille de Nvidia, même si le recul s’est ensuite atténué. Elle peut aussi augmenter la pression sur le conseil lors de la recherche d’un successeur. Chaque déclaration sur la succession sera scrutée pour déterminer si le groupe dispose d’un plan cohérent ou s’il gère une crise au fil des événements.

Colette Kress assure la continuité, pas encore la succession

Colette Kress possède une connaissance approfondie de Nvidia et de ses contraintes financières. Depuis 2013, elle a accompagné l’expansion du groupe dans les centres de données, la montée en puissance des investissements en recherche et développement et l’accélération de la demande pour les infrastructures d’IA.

Son rôle intérimaire pourrait rassurer les marchés sur la publication des résultats, la gestion de la trésorerie et les relations avec les actionnaires. En revanche, la fonction de PDG de Nvidia exige une combinaison rare : compréhension des architectures de calcul, capacité à négocier avec les hyperscalers et vision sur plusieurs cycles de développement de puces.

Le conseil cherche donc un successeur permanent capable de préserver l’écosystème construit par Huang sans simplement en reproduire le style. Le prochain dirigeant devra notamment défendre la feuille de route des architectures graphiques, sécuriser les chaînes d’approvisionnement et répondre à la montée des processeurs conçus en interne par les clients de Nvidia.

Une succession qui dépasse Nvidia

L’incertitude ne concerne pas uniquement l’entreprise. Les fournisseurs de composants, les fabricants sous contrat, les grands opérateurs de centres de données et les start-up spécialisées dans l’IA dépendent tous, à des degrés différents, du calendrier de Nvidia.

Un changement de direction pourrait ralentir certaines décisions, modifier les priorités d’investissement ou faire évoluer la politique commerciale du groupe. Il pourrait aussi accélérer les stratégies de diversification de Microsoft, Amazon, Google et Meta, qui développent déjà leurs propres ASIC et autres accélérateurs spécialisés.

Le prochain jalon sera l’installation formelle du processus de succession et la clarification du périmètre de l’enquête indépendante. Tant que le conseil n’aura pas nommé un PDG permanent et expliqué, même partiellement, les conséquences de l’affaire de renseignement, la volatilité du titre restera un indicateur direct de la confiance accordée à la gouvernance de Nvidia. Pour toute l’industrie, la question est désormais mesurable : l’entreprise peut-elle maintenir ses lancements, ses livraisons et ses engagements commerciaux sans l’homme qui les a orchestrés pendant 33 ans ?

  • ✇PandIA
  • Anthropic affirme que Mythos a porté Claude sur des GPU AMD en trois jours
    Passer de l’écosystème Nvidia aux GPU AMD demande habituellement des mois de travail, des dizaines d’ingénieurs et une longue phase de validation. Anthropic affirme que son IA interne, baptisée Mythos, aurait réduit cette opération à environ trois jours pour faire fonctionner Claude sur une nouvelle plateforme matérielle.Trois jours contre plusieurs mois d’ingénierieL’information provient d’une vidéo diffusée dans le cadre de la tournée de présentation d’Anthropic auprès d’investisseurs. Rapport

Anthropic affirme que Mythos a porté Claude sur des GPU AMD en trois jours

Par : 0xMonkey
12 novembre 2026 à 19:00
Anthropic affirme que Mythos a porté Claude sur des GPU AMD en trois jours

Passer de l’écosystème Nvidia aux GPU AMD demande habituellement des mois de travail, des dizaines d’ingénieurs et une longue phase de validation. Anthropic affirme que son IA interne, baptisée Mythos, aurait réduit cette opération à environ trois jours pour faire fonctionner Claude sur une nouvelle plateforme matérielle.

Trois jours contre plusieurs mois d’ingénierie

L’information provient d’une vidéo diffusée dans le cadre de la tournée de présentation d’Anthropic auprès d’investisseurs. Rapportée le 11 novembre, elle décrit Mythos comme un outil capable d’automatiser une partie importante du portage de Claude vers des GPU AMD.

Selon Anthropic, l’adaptation d’un modèle à une nouvelle architecture nécessitait auparavant « des mois » et mobilisait « des dizaines d’ingénieurs ». Mythos aurait accompli cette tâche en environ trois jours, avec très peu d’intervention humaine.

Le chiffre est spectaculaire, mais il faut le présenter pour ce qu’il est : une affirmation de l’entreprise, formulée dans un contexte de présentation financière. Aucune évaluation indépendante publiée ne permet, à ce stade, de vérifier la durée annoncée, le niveau d’autonomie réel du système ou les performances obtenues sur les puces AMD.

Le détail compte. Faire démarrer un modèle sur un accélérateur différent constitue une étape relativement limitée. Obtenir des performances comparables, une stabilité suffisante et un coût d’exploitation compétitif est une opération autrement plus complexe.

Le vrai obstacle ne se trouve pas seulement dans le modèle

Le portage d’un grand modèle de langage ne consiste pas simplement à traduire quelques lignes de code. L’environnement de calcul doit prendre en charge les kernels utilisés par le modèle, la gestion de la mémoire, la communication entre GPU et les mécanismes de parallélisation nécessaires à l’inférence.

Pendant des années, l’industrie de l’IA s’est structurée autour de l’écosystème CUDA, la plateforme logicielle de Nvidia. Les bibliothèques optimisées, les outils de profilage et les habitudes des équipes ont créé un avantage qui dépasse largement les caractéristiques brutes des cartes graphiques.

AMD propose de son côté la pile logicielle ROCm, ainsi que ses propres bibliothèques et outils. Passer de CUDA à ROCm peut impliquer la réécriture de composants bas niveau, l’adaptation des opérations numériques et la correction de comportements différents selon les architectures.

Un système comme Mythos pourrait intervenir sur plusieurs de ces tâches : repérer les incompatibilités, produire du code de remplacement, lancer des tests, comparer les résultats et corriger automatiquement certaines erreurs. Cette capacité correspond à une évolution importante des outils d’IA appliqués à la programmation. Mais elle ne dispense pas nécessairement d’une validation humaine approfondie, en particulier pour les déploiements à grande échelle.

Le démarrage n’est pas la performance

La question centrale est donc celle du périmètre exact de l’exploit annoncé. Anthropic n’a pas détaillé publiquement, dans les éléments rapportés, le modèle AMD utilisé, la version de ROCm, le nombre de GPU mobilisés ni les résultats obtenus face à une configuration Nvidia comparable.

Aucun chiffre précis n’a non plus été communiqué sur la latence, le débit d’inférence, la consommation électrique ou le taux d’erreur. Or ce sont ces indicateurs qui déterminent la valeur industrielle d’un portage.

Un modèle peut produire des réponses correctes sur une nouvelle plateforme tout en étant trop lent ou trop coûteux pour un service grand public. De même, une exécution réussie sur une configuration de test ne garantit pas un fonctionnement fiable lors d’une campagne de calcul impliquant des milliers d’accélérateurs et des échanges constants entre machines.

Le délai de trois jours peut donc correspondre à l’automatisation de la première phase d’adaptation, et non à la mise en production complète de Claude sur AMD. La nuance est essentielle pour éviter de transformer une démonstration d’outillage en preuve d’équivalence entre plateformes.

Une réponse à la dépendance envers Nvidia

L’intérêt stratégique de cette annonce dépasse le seul cas d’Anthropic. Les principaux laboratoires d’IA dépendent encore largement de Nvidia pour entraîner et exécuter leurs modèles. Cette dépendance porte sur les puces, mais aussi sur le logiciel, les compétences disponibles et les outils déjà intégrés dans les infrastructures de calcul.

Réduire le temps nécessaire pour utiliser une autre architecture pourrait améliorer la capacité de négociation des acteurs de l’IA. Une entreprise capable d’adapter rapidement ses modèles à AMD, à Google TPU ou à d’autres accélérateurs peut répartir ses charges selon les prix, les volumes disponibles et les contraintes énergétiques.

L’enjeu est également financier. Les dépenses liées aux GPU et aux centres de données représentent une part croissante des coûts de développement et d’exploitation des modèles. La possibilité de tester rapidement plusieurs fournisseurs rendrait plus facile la comparaison entre performances, prix et disponibilité.

Cela ne signifie pas que Nvidia perdrait mécaniquement son avantage. Son avance tient aussi à la maturité de CUDA, à la largeur de son écosystème et à l’intégration entre matériel, réseau et logiciels. Une IA capable de générer du code de portage peut réduire le coût de migration, mais elle ne crée pas instantanément des bibliothèques optimisées ni une expertise industrielle équivalente.

Mythos met en lumière une nouvelle classe d’outils

L’annonce illustre surtout une tendance : les IA de programmation commencent à être utilisées non plus uniquement pour écrire des fonctions ou corriger des erreurs, mais pour orchestrer des chaînes complètes d’ingénierie.

Dans ce scénario, l’IA analyse une base de code, identifie les dépendances matérielles, modifie des composants, exécute des tests et interprète les résultats. Le gain potentiel vient moins d’une génération de code isolée que de la répétition automatisée de cycles d’essai et d’erreur.

Cette approche pourrait réduire le nombre d’ingénieurs nécessaires sur certaines tâches particulièrement documentées et répétitives. Elle ne supprime pas pour autant le besoin d’experts capables de définir les objectifs, de vérifier les résultats et d’intervenir lorsque le problème touche à l’architecture du système plutôt qu’à une simple incompatibilité logicielle.

La prochaine étape consistera à mesurer le résultat, pas seulement la vitesse du portage. Il faudra connaître les performances de Claude sur AMD, son coût par requête, sa stabilité en production et la part exacte du travail réalisée sans intervention humaine.

Le prochain test sera celui de la production

Le récit d’Anthropic est crédible sur un point général : des outils d’IA peuvent déjà accélérer certaines opérations de programmation et d’optimisation. En revanche, l’écart entre une démonstration financière et une infrastructure exploitée à grande échelle reste à documenter.

Si les chiffres se confirment, le gain serait concret : passer de plusieurs mois à trois jours pour adapter un modèle réduirait fortement le coût d’exploration de nouvelles puces et affaiblirait une partie de la dépendance logicielle à Nvidia. Le prochain jalon attendu est donc la publication de mesures vérifiables sur une charge réelle : modèle utilisé, matériel AMD, performances, consommation et niveau d’intervention humaine.

Sources : AIholics ; Simon Willison.

Le géant taïwanais des semiconducteurs TSMC annonce un investissement de 1 milliard de dollars réparti entre Anthropic et OpenAI, se joignant ainsi au financement circulaire de la bulle de l'IA

Le géant taïwanais des semiconducteurs TSMC annonce un investissement de 1 milliard de dollars réparti entre Anthropic et OpenAI
se joignant ainsi au financement circulaire de la bulle de l'IA

Le géant taïwanais des semiconducteurs TSMC a approuvé un financement de 1 milliard de dollars partagé entre OpenAI et Anthropic. Cette décision intervient alors que le secteur de l'IA est confronté à un financement circulaire où les investisseurs, les fournisseurs et les clients se financent mutuellement....

Un concours de développement de jeux vidéo pour étudiants supprimé après 12 ans, les jeunes soumettant sans cesse des contenus médiocres générés par IA, trop difficiles à distinguer des jeux créés sans IA

Un concours de développement de jeux vidéo pour étudiants supprimé après 12 ans, les jeunes soumettant sans cesse des contenus médiocres générés par IA, trop difficiles à distinguer des jeux créés sans IA

Ce sera la dernière édition de l'Australian STEM Videogame Challenge, un concours destiné aux jeunes, car les candidatures ont été submergées par des jeux de mauvaise qualité générés par l'IA. Cet événement, qui existe depuis 12 ans, va cesser ses activités car il devenait trop difficile de distinguer...

Google dévoile deux nouvelles puces IA spécialisées pour renforcer sa concurrence face à Nvidia : la TPU 8tx pour le calcul confidentiel et la TPU 8i Max pour les charges de travail IA volumineuses

Google dévoile deux nouvelles puces IA spécialisées pour renforcer sa concurrence face à Nvidia : la TPU 8tx pour le calcul confidentiel et la TPU 8i Max pour les charges de travail IA volumineuses

Google a présenté deux nouvelles configurations de ses processeurs d'intelligence artificielle développés en interne, renforçant ainsi sa concurrence face à la domination de Nvidia sur le marché des puces IA. Le TPU 8tx est conçu pour les organismes publics et les entreprises des secteurs réglementés qui...

United Airlines interdit aux agents d'IA tiers non autorisés de réserver des vols, d'enregistrer des passagers ou d'effectuer des modifications sur les comptes au nom des voyageurs

United Airlines interdit aux agents d'IA tiers non autorisés de réserver des vols, d'enregistrer des passagers ou d'effectuer des modifications sur les comptes au nom des voyageurs

United Airlines a annoncé qu'elle interdisait aux assistants IA personnels de réserver des vols à compter du 11 novembre, afin de protéger les données des clients et de se conformer aux règles de l'Administration fédérale de l'aviation et du ministère des Transports. Dans un communiqué, United a fait part de ses craintes...

Ring, filiale d'Amazon, dévoile un drone et un robot volants destinés à patrouiller les habitations et les entreprises, ces appareils sont équipés d'« AI Pilot », un système qui cartographie les espaces

Ring, filiale d'Amazon, dévoile un drone et un robot volants destinés à patrouiller les habitations et les entreprises, ces appareils sont équipés d'« AI Pilot », un système qui cartographie les espaces

Le fabricant de caméras de sécurité Ring a dévoilé des drones volants et des robots sur roues conçus pour surveiller les habitations et les entreprises. Les derniers produits de cette entreprise détenue par Amazon s'inspirent des sonnettes Ring qui permettent aux propriétaires de voir qui frappe...

  • ✇PandIA
  • Comment utiliser l’IA pour analyser les avis clients
    L’analyse des avis clients avec l’IA permet d’identifier automatiquement les sentiments, les thèmes récurrents et les irritants exprimés dans les commentaires. Ce guide explique comment utiliser l’intelligence artificielle pour analyser les avis clients, choisir la bonne méthode, interpréter les résultats et protéger les données collectées.Qu’est-ce que l’analyse des avis clients avec l’IA ?L’analyse des avis clients avec l’IA consiste à traiter automatiquement des commentaires publiés sur Googl

Comment utiliser l’IA pour analyser les avis clients

Par : 0xMonkey
12 novembre 2026 à 12:05
Comment utiliser l’IA pour analyser les avis clients

L’analyse des avis clients avec l’IA permet d’identifier automatiquement les sentiments, les thèmes récurrents et les irritants exprimés dans les commentaires. Ce guide explique comment utiliser l’intelligence artificielle pour analyser les avis clients, choisir la bonne méthode, interpréter les résultats et protéger les données collectées.

Qu’est-ce que l’analyse des avis clients avec l’IA ?

L’analyse des avis clients avec l’IA consiste à traiter automatiquement des commentaires publiés sur Google, une boutique en ligne, une marketplace, un questionnaire de satisfaction ou un outil CRM.

Un modèle d’intelligence artificielle peut notamment :

  • détecter le sentiment d’un avis : positif, négatif ou neutre ;
  • attribuer une note de sentiment plus précise, par exemple de -1 à +1 ;
  • repérer les thèmes récurrents : livraison, prix, qualité, service client, ergonomie ;
  • extraire les points forts et les irritants ;
  • classer les avis selon leur urgence ;
  • résumer plusieurs centaines de commentaires ;
  • comparer les retours par produit, magasin, période ou segment client ;
  • identifier les problèmes émergents ;
  • repérer certains avis suspects ou très similaires.

L’IA ne se limite donc pas à calculer une moyenne d’étoiles. Elle analyse aussi le contenu textuel, ce qui permet de comprendre pourquoi un client attribue une note donnée.

Exemple d’analyse

Avis client :

« Le produit fonctionne bien, mais la livraison a pris dix jours et le service client n’a répondu qu’après trois relances. »

Une analyse classique pourrait classer cet avis comme mitigé. Une analyse plus avancée peut extraire :

  • Sentiment global : mitigé ;
  • Produit : positif ;
  • Livraison : négatif ;
  • Service client : négatif ;
  • Problème principal : délai de livraison ;
  • Niveau d’urgence : moyen à élevé ;
  • Action recommandée : vérifier les délais annoncés et le traitement des demandes.

Pourquoi utiliser l’IA pour analyser les avis clients ?

Gagner du temps sur le traitement des commentaires

Lire manuellement plusieurs milliers d’avis est long et difficile à standardiser. L’IA peut analyser un volume important de textes en quelques minutes, puis présenter les résultats sous forme de catégories, de tableaux ou de synthèses.

Cette automatisation est particulièrement utile pour :

  • les sites e-commerce ;
  • les chaînes de magasins ;
  • les hôtels et restaurants ;
  • les applications mobiles ;
  • les plateformes de services ;
  • les entreprises recevant des demandes sur plusieurs canaux.

Dépasser la simple note moyenne

Une note de 4,2 sur 5 ne permet pas forcément de comprendre les causes d’insatisfaction. Deux entreprises peuvent afficher la même moyenne tout en rencontrant des problèmes très différents.

L’IA peut distinguer :

  • les retards de livraison ;
  • les défauts de fabrication ;
  • les difficultés d’utilisation ;
  • les erreurs de facturation ;
  • l’attitude du personnel ;
  • le manque de fonctionnalités ;
  • le rapport qualité-prix.

Cette lecture par sujet rend les avis plus exploitables pour les équipes produit, marketing, commerciales et support.

Détecter rapidement les problèmes émergents

Une hausse progressive des mentions négatives liées à un mot-clé peut révéler un problème avant qu’il ne devienne visible dans les indicateurs commerciaux.

Par exemple, une analyse hebdomadaire peut mettre en évidence :

  • une nouvelle version d’application qui provoque des erreurs ;
  • une rupture de stock ;
  • une dégradation des délais de livraison ;
  • une campagne publicitaire qui crée une attente irréaliste ;
  • un changement de prestataire logistique.

Prioriser les actions

Tous les avis négatifs ne présentent pas le même niveau de gravité. L’IA peut aider à distinguer :

  • un commentaire isolé et peu détaillé ;
  • un défaut répété sur plusieurs produits ;
  • une demande urgente liée à une facturation ;
  • un problème de sécurité ;
  • un risque juridique ou réputationnel.

La décision finale doit rester humaine, mais cette première priorisation facilite le travail des équipes.

Quelles données peuvent être analysées ?

Avant de choisir un outil, il faut définir les sources utilisées et vérifier les conditions d’accès aux données.

Sources fréquentes

L’analyse peut porter sur :

  • les avis Google Business Profile ;
  • les commentaires d’une boutique Shopify, WooCommerce ou PrestaShop ;
  • les évaluations Amazon ou d’autres marketplaces ;
  • les enquêtes de satisfaction ;
  • les réponses au CSAT ou au NPS ;
  • les tickets de support ;
  • les commentaires sur les réseaux sociaux ;
  • les retours recueillis par e-mail ;
  • les verbatims d’entretiens clients.

Données à préparer

Un fichier d’analyse contient généralement :

  • le texte de l’avis ;
  • la note attribuée ;
  • la date ;
  • le produit ou service concerné ;
  • le canal d’origine ;
  • le pays ou la langue ;
  • l’identifiant client pseudonymisé, si nécessaire ;
  • le statut de traitement ;
  • la réponse apportée par l’entreprise.

Une colonne contenant la date est importante pour observer l’évolution des problèmes. Une colonne liée au produit permet de comparer les références entre elles.

Comment analyser les avis clients avec l’IA ?

Étape 1 : définir les objectifs

Une analyse utile commence par une question précise. « Analyser les avis » est trop vague pour produire un résultat directement exploitable.

Les objectifs peuvent être les suivants :

  • comprendre les causes des avis négatifs ;
  • améliorer un produit ;
  • mesurer l’évolution de la satisfaction ;
  • comparer plusieurs magasins ;
  • identifier les attentes non satisfaites ;
  • préparer une réponse aux clients ;
  • repérer les avis nécessitant une intervention rapide.

Exemple d’objectif bien formulé :

Identifier les trois problèmes les plus fréquemment cités dans les avis négatifs concernant la livraison au cours des six dernières semaines.

Étape 2 : collecter et nettoyer les avis

Les données doivent être rassemblées dans un format homogène, comme un fichier CSV, Excel ou Google Sheets, ou directement dans un outil connecté au CRM.

Le nettoyage consiste à :

  1. supprimer les doublons ;
  2. retirer les lignes vides ;
  3. harmoniser les dates ;
  4. corriger les erreurs d’encodage ;
  5. identifier la langue ;
  6. séparer les avis de test des vrais avis ;
  7. pseudonymiser les données personnelles ;
  8. conserver la source et la date de chaque commentaire.

Il est préférable de garder le texte original dans une colonne séparée. Une traduction automatique peut être ajoutée pour faciliter l’analyse, mais elle ne doit pas remplacer la version originale lorsque la nuance est importante.

Étape 3 : choisir le type d’outil

Trois approches principales sont possibles.

Utiliser une IA conversationnelle

Des outils comme ChatGPT, Claude ou Gemini peuvent analyser un lot d’avis copié dans une conversation ou importé sous forme de fichier, selon les fonctionnalités disponibles.

Cette méthode convient pour :

  • un volume limité ou ponctuel ;
  • une première exploration ;
  • la création d’une taxonomie de thèmes ;
  • la rédaction d’une synthèse ;
  • l’analyse d’un échantillon.

Elle est moins adaptée à un traitement récurrent de dizaines de milliers d’avis, sauf avec une intégration API et un contrôle technique approprié.

Utiliser un outil spécialisé

Les plateformes d’analyse de feedback client proposent souvent :

  • une connexion aux sources d’avis ;
  • une analyse automatique du sentiment ;
  • une catégorisation personnalisable ;
  • des tableaux de bord ;
  • des alertes ;
  • un historique ;
  • une gestion des utilisateurs.

Cette solution est pertinente pour un besoin continu et partagé entre plusieurs équipes. Il faut vérifier la qualité du français, la gestion des langues, l’hébergement des données et les possibilités d’export.

Utiliser une API d’IA

Une API permet d’intégrer l’analyse dans un CRM, un entrepôt de données ou un outil interne.

Elle offre davantage de flexibilité pour :

  • traiter automatiquement chaque nouvel avis ;
  • appliquer une grille de classification personnalisée ;
  • déclencher une alerte ;
  • transmettre un avis urgent au support ;
  • calculer des indicateurs par produit.

Cette option demande toutefois des compétences en développement, en sécurité et en contrôle qualité.

Étape 4 : créer une grille d’analyse

Une grille personnalisée donne des résultats plus cohérents qu’une simple demande de résumé.

Elle peut contenir les champs suivants :

| Champ | Exemple de valeur |

|---|---|

| Sentiment global | Positif, neutre, négatif |

| Note de sentiment | De -1 à +1 |

| Thème principal | Livraison |

| Sous-thème | Retard |

| Produit concerné | Casque audio X |

| Urgence | Faible, moyenne, élevée |

| Intention | Réclamation, compliment, question |

| Action suggérée | Contacter le client |

| Citation représentative | Extrait anonymisé |

La grille doit rester suffisamment courte. Trop de catégories produisent des résultats difficiles à comparer. Une première version de 5 à 15 thèmes principaux constitue souvent un bon point de départ.

Étape 5 : rédiger un prompt précis

Un prompt efficace indique le rôle attendu, les catégories, le format de sortie et les règles d’interprétation.

Exemple de prompt :

Analyse les avis clients fournis ci-dessous. Pour chaque avis, indique le sentiment global, le thème principal, les thèmes secondaires, le problème mentionné, le niveau d’urgence et une action recommandée. Utilise uniquement les catégories suivantes : produit, prix, livraison, service client, paiement, ergonomie, qualité. Si une information n’est pas présente, indique « non déterminé ». Ne déduis pas d’intention qui n’est pas explicitement exprimée. Présente les résultats dans un tableau.

Pour une synthèse globale :

Analyse ce lot d’avis clients. Classe les thèmes par fréquence, distingue les retours positifs et négatifs, repère les sujets apparus récemment et propose cinq actions prioritaires. Indique le nombre d’avis associés à chaque thème et cite un exemple anonymisé. Signale les conclusions qui reposent sur un faible volume de données.

Cette dernière consigne est importante : une fréquence élevée ne signifie pas nécessairement un impact élevé.

Étape 6 : contrôler les résultats

L’IA peut mal interpréter :

  • l’ironie ;
  • le second degré ;
  • les fautes d’orthographe ;
  • les expressions régionales ;
  • les avis très courts ;
  • les phrases ambiguës ;
  • les mélanges de langues ;
  • les comparaisons implicites.

Un échantillon doit donc être vérifié manuellement. Par exemple, une équipe peut contrôler 50 à 100 avis et comparer la classification humaine avec celle de l’IA.

Les erreurs les plus fréquentes doivent être ajoutées aux consignes ou à la grille de catégories. Cette phase améliore progressivement la fiabilité de l’analyse.

Quels indicateurs suivre ?

Le sentiment des avis

La répartition entre avis positifs, neutres et négatifs permet de suivre une tendance générale.

Il est préférable d’observer :

  • le pourcentage d’avis positifs ;
  • le pourcentage d’avis négatifs ;
  • le sentiment moyen ;
  • l’évolution par semaine ou par mois ;
  • le sentiment par produit ou canal.

La moyenne globale peut masquer une dégradation sur une catégorie précise. Un suivi par segment est donc souvent plus utile.

La fréquence des thèmes

La fréquence indique combien d’avis mentionnent un sujet donné. Elle peut être calculée sur l’ensemble des avis ou uniquement sur les avis négatifs.

Exemple :

  • livraison : 28 % des avis négatifs ;
  • qualité du produit : 21 % ;
  • service client : 17 % ;
  • prix : 14 %.

Il faut préciser si un avis peut appartenir à plusieurs thèmes. Dans la plupart des cas, la réponse est oui.

L’intensité et l’impact

Un thème peu fréquent peut être très grave. Une plainte liée à la sécurité ou à une facturation erronée mérite une attention immédiate, même si elle représente moins de 1 % des avis.

Une matrice utile croise :

  • fréquence ;
  • gravité ;
  • impact commercial ;
  • facilité de correction.

Cette méthode aide à distinguer les actions rapides des chantiers stratégiques.

Le taux de réponse et le délai de traitement

Pour les équipes support ou community management, l’IA peut également mesurer :

  • le taux d’avis ayant reçu une réponse ;
  • le délai moyen de réponse ;
  • le nombre d’avis urgents non traités ;
  • le taux de résolution ;
  • l’évolution de la note après une interaction avec le support.

Ces indicateurs relient l’analyse des avis à la performance opérationnelle.

Combien coûte l’analyse des avis clients avec l’IA ?

Le coût dépend du volume, de la fréquence et du niveau d’intégration.

Analyse ponctuelle

Une analyse ponctuelle peut être réalisée avec un outil d’IA conversationnelle ou un tableur enrichi. Le coût peut être faible, mais le temps consacré au nettoyage, à la vérification et à l’interprétation reste à prendre en compte.

Cette approche convient à une petite entreprise qui souhaite analyser quelques centaines d’avis une ou deux fois par mois.

Outil spécialisé

Les solutions professionnelles fonctionnent souvent par abonnement. Le prix varie selon :

  • le nombre de sources connectées ;
  • le volume d’avis ;
  • le nombre d’utilisateurs ;
  • les fonctionnalités de reporting ;
  • les langues disponibles ;
  • les intégrations CRM ;
  • les options de sécurité et d’hébergement.

Les offres peuvent aller de quelques dizaines d’euros par mois pour un besoin limité à plusieurs centaines, voire davantage, pour une entreprise multi-sites ou internationale.

Développement avec une API

Une intégration API implique généralement :

  • le coût de consommation du modèle ;
  • le développement initial ;
  • l’hébergement ;
  • la maintenance ;
  • le contrôle des erreurs ;
  • la sécurisation des flux.

Le prix par analyse peut être faible, mais le coût total dépend surtout de l’architecture et du volume de données.

Quelles sont les limites et les risques ?

Les résultats ne sont pas toujours exacts

Une IA ne comprend pas parfaitement tous les contextes. Elle peut classer comme positif un avis ironique ou attribuer un sentiment global positif à un commentaire contenant pourtant une plainte importante.

Les résultats doivent être considérés comme une aide à la décision, pas comme une vérité automatique.

Les avis clients peuvent être biaisés

Les personnes très satisfaites ou très insatisfaites publient parfois davantage d’avis que les clients silencieux. Les commentaires disponibles ne représentent donc pas toujours l’ensemble de la clientèle.

Il faut éviter d’affirmer que les avis analysés reflètent exactement l’opinion de tous les clients.

Le RGPD doit être pris en compte

Les avis peuvent contenir un nom, une adresse e-mail, un numéro de commande, une localisation ou d’autres informations personnelles. Le RGPD, applicable depuis le 25 mai 2018, impose notamment de limiter la collecte, de définir une finalité et de protéger les données.

Bonnes pratiques :

  • supprimer les informations inutiles ;
  • pseudonymiser les identifiants ;
  • ne pas transmettre de données sensibles à un outil public ;
  • vérifier l’emplacement et les conditions d’hébergement ;
  • encadrer les sous-traitants ;
  • définir une durée de conservation ;
  • limiter les accès aux résultats.

Un avis destiné à l’analyse peut généralement être traité sans conserver l’identité complète de son auteur.

Les avis frauduleux nécessitent une analyse spécifique

L’IA peut repérer des signaux comme :

  • des textes très similaires ;
  • une répétition inhabituelle de mots ;
  • des publications rapprochées ;
  • un vocabulaire artificiel ;
  • des profils ou produits présentant des schémas anormaux.

Ces signaux ne prouvent pas qu’un avis est faux. Toute suppression ou contestation doit s’appuyer sur les règles de la plateforme concernée et sur une vérification humaine.

Quand utiliser l’IA pour analyser les avis ?

Une analyse ponctuelle suffit pour :

  • réaliser un audit produit ;
  • préparer une nouvelle version d’un service ;
  • comprendre une baisse de satisfaction ;
  • étudier une campagne commerciale ;
  • comparer deux périodes.

Une analyse récurrente est préférable lorsque :

  • le volume d’avis augmente chaque semaine ;
  • plusieurs canaux doivent être surveillés ;
  • les problèmes doivent être détectés rapidement ;
  • les équipes produit et support utilisent les mêmes indicateurs ;
  • la direction souhaite suivre l’évolution de la satisfaction.

Un rythme hebdomadaire convient souvent aux entreprises ayant un volume modéré. Une analyse quotidienne peut être nécessaire pour un site e-commerce à fort trafic ou un service soumis à des incidents fréquents.

Bonnes pratiques pour obtenir des résultats fiables

  • Commencer par un échantillon avant d’automatiser tout le processus.
  • Définir une taxonomie adaptée au secteur et aux produits.
  • Conserver les données brutes et les résultats générés.
  • Afficher le volume associé à chaque conclusion.
  • Séparer les faits observés des recommandations.
  • Vérifier régulièrement un échantillon manuellement.
  • Comparer les résultats avec les notes, les remboursements et les tickets support.
  • Analyser les tendances dans le temps plutôt qu’une seule valeur.
  • Adapter les catégories lorsque les produits ou les attentes changent.
  • Faire valider les alertes sensibles par un responsable humain.
  • Ne pas utiliser l’IA pour répondre automatiquement à toutes les plaintes sans contrôle.

Conclusion : les points clés à retenir

L’analyse des avis clients par IA permet de transformer des commentaires dispersés en informations exploitables. La méthode la plus efficace consiste à :

  1. définir une question d’analyse précise ;
  2. centraliser et nettoyer les avis ;
  3. choisir un outil adapté au volume et au budget ;
  4. créer une grille avec sentiment, thèmes, urgence et actions ;
  5. utiliser des prompts structurés ;
  6. contrôler manuellement les résultats ;
  7. suivre la fréquence, la gravité et l’évolution des problèmes ;
  8. protéger les données personnelles conformément au RGPD ;
  9. relier les conclusions à des actions concrètes ;
  10. conserver une validation humaine pour les décisions sensibles.

L’IA accélère la lecture et fait émerger des tendances difficiles à repérer manuellement. Sa valeur dépend toutefois de la qualité des données, de la précision des consignes et de la capacité de l’entreprise à transformer les avis analysés en améliorations mesurables.

Faut-il dire la vérité à une personne fan d’un chanteur qui se révèle être une IA ?

12 novembre 2026 à 10:39
<p>TRIBUNE // L'’impératif de vérité doit-il primer au risque de détruire une émotion réelle ? C'est la question que se pose Marius Bertolucci, Maître de Conférences en Sciences de Gestion à l'Institut de Management Public et Gouvernance Territoriale, lorsqu'il découvre d'un chanteur de blues dont les chansons émeuvent son ami est une IA.</p>
  • ✇PandIA
  • Jensen Huang met Nvidia sous pression, le conseil examine s’il peut rester PDG
    L’homme qui incarne le succès de Nvidia devient aussi le principal facteur d’incertitude du groupe. Après de nouvelles révélations sur la vie privée de Jensen Huang, le conseil d’administration doit désormais arbitrer entre la protection de sa gouvernance et la dépendance stratégique à son dirigeant historique.Le conseil face à une crise qui dépasse la vie privéeLe conseil d’administration de Nvidia devait examiner le sort de son PDG après que Jensen Huang a reconnu une liaison avec Alice Huang,

Jensen Huang met Nvidia sous pression, le conseil examine s’il peut rester PDG

Par : 0xMonkey
12 novembre 2026 à 07:01
Jensen Huang met Nvidia sous pression, le conseil examine s’il peut rester PDG

L’homme qui incarne le succès de Nvidia devient aussi le principal facteur d’incertitude du groupe. Après de nouvelles révélations sur la vie privée de Jensen Huang, le conseil d’administration doit désormais arbitrer entre la protection de sa gouvernance et la dépendance stratégique à son dirigeant historique.

Le conseil face à une crise qui dépasse la vie privée

Le conseil d’administration de Nvidia devait examiner le sort de son PDG après que Jensen Huang a reconnu une liaison avec Alice Huang, une femme que des services américains soupçonnent d’entretenir des liens avec le renseignement chinois. Ces soupçons ne sont pas établis publiquement et aucune accusation d’espionnage n’a, à ce stade, été démontrée.

L’affaire a toutefois pris une nouvelle dimension le 11 novembre, avec des révélations concernant une autre relation présumée entre Jensen Huang et une employée de Nvidia. Dans les échanges suivant la clôture de Wall Street, l’action du fabricant de puces a chuté de plus de 8 %.

Cette réaction ne constitue pas une preuve de faute. Elle traduit plutôt la crainte des investisseurs de voir une affaire personnelle se transformer en crise de gouvernance, de conformité et de sécurité nationale. Pour une entreprise devenue l’un des actifs stratégiques les plus surveillés de l’industrie technologique, la question n’est plus seulement celle du comportement du PDG, mais celle de l’exposition de Nvidia à un risque de confiance.

Selon The Washington Post et Le Monde, le conseil mène son examen alors qu’une enquête indépendante a été ouverte au sein de l’entreprise. Son objectif doit être de reconstituer les faits, d’évaluer les éventuels conflits d’intérêts et de déterminer si des informations sensibles ont pu être exposées.

Des soupçons qui restent à distinguer des faits

La proximité supposée d’Alice Huang avec le renseignement chinois se trouve au cœur de la dimension géopolitique du dossier. Mais la prudence s’impose : les éléments publiquement disponibles font état de soupçons émanant de services américains, pas d’une conclusion judiciaire ou administrative établissant une opération d’espionnage.

Cette distinction est déterminante. Une relation personnelle, même problématique au regard des règles internes d’une entreprise, ne démontre pas à elle seule une transmission d’informations. Pour établir un risque réel, l’enquête devrait notamment examiner les accès de la personne concernée, les échanges professionnels, les dispositifs de sécurité et l’éventuelle circulation de données confidentielles.

Nvidia est particulièrement vulnérable sur ce terrain. Ses processeurs et ses logiciels sont au centre de la course mondiale à l’IA, tandis que les États-Unis imposent des restrictions croissantes sur l’exportation de certaines technologies vers la Chine. Dans cet environnement, tout doute sur la protection des informations stratégiques peut être interprété comme un risque industriel autant que politique.

La dépendance de Nvidia à son dirigeant

Jensen Huang n’est pas un PDG interchangeable. Cofondateur de Nvidia en 1993, il a construit la stratégie qui a placé les processeurs graphiques du groupe au centre des infrastructures d’IA. Sa communication, son image publique et ses relations avec les principaux clients de la technologie sont devenues étroitement associées à la valorisation de l’entreprise.

Cette centralité constitue une force commerciale, mais aussi une fragilité. Le marché peut considérer qu’une décision visant à écarter Huang menacerait la continuité stratégique de Nvidia. À l’inverse, le maintien d’un dirigeant contesté peut alimenter les interrogations sur l’indépendance du conseil, la culture interne et la gestion des risques.

Le recul de plus de 8 % enregistré après la clôture illustre cette tension. Il ne permet pas de mesurer une perte durable de valeur, les échanges hors séance étant plus étroits et plus volatils que pendant la séance régulière. Il indique néanmoins que les investisseurs intègrent désormais une prime de risque liée à la gouvernance du groupe.

Pour un fabricant de composants dont la demande reste portée par les investissements massifs dans les centres de données, cette décote pourrait devenir significative si elle se prolonge. Les clients, les partenaires industriels et les autorités peuvent également demander des garanties supplémentaires avant de poursuivre des discussions sur des produits soumis à des contrôles d’exportation.

Le rôle décisif de l’enquête indépendante

La crédibilité de l’enquête dépendra autant de son périmètre que de sa conclusion. Une procédure limitée aux relations personnelles de Jensen Huang risquerait de manquer le sujet central : l’existence éventuelle d’un conflit d’intérêts ou d’une faille dans la circulation de données sensibles.

Le conseil devra notamment répondre à plusieurs questions concrètes : les règles internes concernant les relations avec des employés ont-elles été respectées ? Les personnes citées avaient-elles accès à des informations stratégiques ? Des alertes avaient-elles été remontées à la direction ou aux administrateurs ? Les contrôles de sécurité applicables aux échanges avec la Chine ont-ils été correctement appliqués ?

La composition et l’indépendance de l’équipe chargée de l’enquête seront également scrutées. Un rapport produit sous la seule supervision de dirigeants proches de Jensen Huang aurait peu de chances de calmer les investisseurs ou les responsables politiques américains.

Washington s’empare du dossier

Le PDG de Nvidia doit par ailleurs témoigner à huis clos devant trois commissions de la Chambre des représentants. Cette audition ajoute une pression institutionnelle à une crise déjà sensible.

Les parlementaires devraient chercher à établir si l’affaire touche à la sécurité des technologies américaines, au respect des restrictions d’exportation ou aux procédures de contrôle de Nvidia. Le huis clos limite la visibilité publique sur les échanges, mais il peut aussi faciliter l’examen d’informations classifiées ou commercialement sensibles.

Pour Nvidia, l’enjeu consiste à éviter que le dossier ne s’installe dans une controverse durable entre Washington et Pékin. Les autorités américaines pourraient demander des mesures de conformité renforcées, tandis que les investisseurs attendront du conseil une position claire sur la responsabilité du PDG et la solidité des contrôles internes.

Le groupe doit donc gérer deux calendriers : celui de l’enquête indépendante et celui du Congrès. Une communication trop vague pourrait nourrir les spéculations ; une prise de position prématurée pourrait, à l’inverse, compromettre les investigations.

Le prochain test sera celui de la gouvernance

Le conseil d’administration devra démontrer qu’il peut évaluer Jensen Huang sans se laisser dicter sa décision par sa popularité ou par la dépendance de Nvidia à son leadership. Plusieurs scénarios sont envisageables : maintien sous conditions, renforcement des mécanismes de supervision, retrait temporaire de certaines responsabilités, voire succession si les faits établissent une violation grave des règles de l’entreprise.

Aucune de ces options ne peut être justifiée par les seuls soupçons d’espionnage, qui restent non établis publiquement. Mais l’existence d’une enquête, de nouvelles révélations et d’une réaction immédiate du marché suffit à imposer une réponse documentée.

Les prochains jalons seront précis : conclusions de l’enquête indépendante, audition de Jensen Huang devant les trois commissions et réaction du conseil sur son maintien à la tête de Nvidia. Tant que ces étapes ne seront pas franchies, la valeur du groupe restera exposée à un risque qui ne se mesure pas en performances de puces, mais en confiance dans celui qui les a imposées au cœur de l’économie de l’IA.

Gemini 4 Carbon de Google est désormais accessible au grand public pour les tâches les plus complexes, telles que la programmation en plusieurs étapes, à un prix inférieur à Claude Fable 5.2 et Opus 5.5

Gemini 4 Carbon de Google est désormais accessible au grand public pour les tâches les plus complexes, telles que la programmation en plusieurs étapes, à un prix inférieur à Claude Fable 5.2 et Opus 5.5

Google rend Gemini 4 Carbon accessible à un plus grand nombre d'utilisateurs après sa mise à disposition initiale, fin octobre, auprès d'une sélection d'entreprises spécialisées dans la cybersécurité. Gemini 4 Carbon promet une avancée significative dans le domaine du codage par IA et de la cybersécurité,...

Anthropic investit 3,4 milliards de dollars dans l'achat de turbines à gaz polluantes pour produire l'électricité nécessaire à ses centres de données IA, la course à l'IA relance les énergies fossiles

Anthropic investit 3,4 milliards de dollars dans l'achat de turbines à gaz polluantes pour produire l'électricité nécessaire à ses centres de données IA
la course à l'IA relance les énergies fossiles

Anthropic abandonne son projet initial d'achat d'énergie au profit d'une production autonome. L'entreprise achète pour 3,4 milliards de turbines à gaz pour produire l'électricité nécessaire à ses centres de données. Ces turbines sont capables de produire jusqu'à 1,7 gigawatt d'électricité. Bien que...

  • ✇PandIA
  • OpenAI franchit 10 milliards de revenus trimestriels, mais reste lourdement déficitaire
    10 milliards de dollars de revenus en trois mois : le seuil franchi par OpenAI témoigne de l’appétit commercial de ChatGPT. Mais derrière cette progression spectaculaire, l’entreprise continue d’accumuler de lourdes pertes opérationnelles, rappelant que chaque dollar généré par l’IA s’accompagne encore de coûts considérables.ChatGPT accélère, mais la rentabilité reste hors de portéeOpenAI aurait généré environ 10 milliards de dollars de revenus au troisième trimestre 2026, selon des informations

OpenAI franchit 10 milliards de revenus trimestriels, mais reste lourdement déficitaire

Par : Vicomte
11 novembre 2026 à 19:01
OpenAI franchit 10 milliards de revenus trimestriels, mais reste lourdement déficitaire

10 milliards de dollars de revenus en trois mois : le seuil franchi par OpenAI témoigne de l’appétit commercial de ChatGPT. Mais derrière cette progression spectaculaire, l’entreprise continue d’accumuler de lourdes pertes opérationnelles, rappelant que chaque dollar généré par l’IA s’accompagne encore de coûts considérables.

ChatGPT accélère, mais la rentabilité reste hors de portée

OpenAI aurait généré environ 10 milliards de dollars de revenus au troisième trimestre 2026, selon des informations rapportées par le Wall Street Journal et Reuters, puis reprises par TechCrunch et Investing.com.

Le chiffre représente une hausse d’environ 50 % sur un an. À périmètre comparable, OpenAI aurait donc réalisé près de 6,7 milliards de dollars de revenus au troisième trimestre 2025. En rythme annualisé, le niveau atteint désormais plus de 40 milliards de dollars — une échelle qui place l’entreprise parmi les acteurs technologiques affichant la croissance la plus rapide.

Cette performance repose principalement sur la progression de ChatGPT, les abonnements payants destinés aux particuliers et aux entreprises, ainsi que les revenus liés à l’API d’OpenAI. Les entreprises intègrent les modèles du groupe dans leurs logiciels, leurs outils de service client, leurs environnements de développement et leurs processus internes.

Mais cette croissance commerciale ne se traduit pas encore par un résultat positif. Les informations rapportées par le Wall Street Journal font état de pertes opérationnelles toujours très élevées. OpenAI étant une entreprise non cotée, elle ne publie pas de compte de résultat complet comparable à celui d’un groupe coté. Le montant exact des pertes, leur ventilation et la consommation de trésorerie doivent donc être interprétés avec prudence.

Le coût de chaque requête pèse sur les comptes

Le paradoxe financier d’OpenAI tient à la nature même de son activité. Un abonnement ou une licence API génère un revenu prévisible, mais chaque utilisation du service entraîne un coût de calcul. Plus les utilisateurs sollicitent des modèles avancés, plus la facture d’infrastructure augmente.

Les dépenses couvrent plusieurs postes : processeurs spécialisés, centres de données, électricité, stockage, bande passante, maintenance des systèmes et salaires de chercheurs et d’ingénieurs. L’entraînement d’un nouveau modèle représente une dépense concentrée, mais l’inférence — le calcul nécessaire pour produire chaque réponse — devient un coût récurrent à mesure que l’usage se développe.

Cette mécanique distingue OpenAI de nombreux éditeurs de logiciels traditionnels. Un service logiciel classique peut servir un client supplémentaire à un coût marginal limité. Pour un assistant d’IA générative, une requête complexe, une longue analyse ou la génération d’un contenu multimodal consomme une quantité mesurable de ressources informatiques.

La baisse du prix des modèles et l’amélioration de leur efficacité peuvent réduire le coût unitaire. Cependant, ces gains sont souvent absorbés par l’augmentation des volumes, l’ajout de nouvelles fonctionnalités et le lancement de modèles plus puissants. L’entreprise doit simultanément vendre davantage, maintenir la qualité du service et financer une infrastructure toujours plus vaste.

Un chiffre d’affaires élevé ne suffit pas

Le franchissement des 10 milliards de dollars trimestriels ne signifie donc pas qu’OpenAI dispose déjà d’un modèle économique bénéficiaire. Il indique surtout que la demande existe à grande échelle.

La distinction entre chiffre d’affaires, marge brute et résultat opérationnel est déterminante. Une société peut vendre pour plusieurs milliards de dollars tout en perdant de l’argent si ses coûts de fonctionnement, ses engagements d’infrastructure et ses dépenses de recherche dépassent ses revenus. Dans le cas d’OpenAI, la course aux modèles de pointe impose également de poursuivre les investissements alors même que les offres actuelles commencent à générer des revenus significatifs.

Cette situation explique la dépendance du groupe à des financements importants et à des partenariats industriels. Les besoins ne concernent pas seulement l’entraînement d’un modèle ponctuel : ils s’étendent à la construction ou à la réservation de capacités de calcul sur plusieurs années. Les contrats de centres de données et de fournisseurs de puces peuvent représenter des engagements financiers majeurs avant même que la demande ne soit entièrement garantie.

La croissance devra désormais prouver sa qualité

Le taux de progression de 50 % sur un an reste impressionnant, mais il sera plus difficile à maintenir à mesure que la base de revenus augmente. OpenAI doit convertir la popularité de ChatGPT en revenus récurrents et suffisamment rentables, notamment sur le marché professionnel.

Les offres destinées aux entreprises peuvent améliorer l’économie du service grâce à des contrats pluriannuels, à des niveaux de prix plus élevés et à une utilisation mieux prévisible. Elles nécessitent toutefois des investissements supplémentaires en sécurité, conformité, administration et assistance. Les grands clients exigent aussi des garanties de disponibilité et de confidentialité qui renchérissent le coût d’exploitation.

Le marché devient par ailleurs plus concurrentiel. Les modèles proposés par Google, Anthropic, Meta et plusieurs acteurs open source exercent une pression sur les prix de l’API. Si les entreprises peuvent passer d’un fournisseur à l’autre ou faire fonctionner plusieurs modèles selon les tâches, OpenAI devra défendre ses tarifs par la qualité, la fiabilité et l’intégration de ses produits — pas seulement par la notoriété de ChatGPT.

La question centrale n’est donc plus de savoir si l’IA peut générer des revenus. Le chiffre publié par OpenAI apporte une réponse claire. L’enjeu consiste désormais à déterminer combien de ces revenus peuvent être conservés après paiement du calcul, des infrastructures et de la recherche.

Le prochain test sera celui de la consommation de trésorerie

Le prochain jalon financier important sera la publication de données plus détaillées sur l’exercice 2026 : marge brute, pertes opérationnelles, dépenses d’infrastructure, part des revenus provenant des entreprises et évolution de la consommation de trésorerie.

Ces indicateurs permettront de mesurer si la croissance de ChatGPT améliore progressivement l’économie du groupe ou si elle accompagne surtout une hausse parallèle des coûts. Avec 10 milliards de dollars par trimestre, OpenAI dispose désormais d’une base commerciale suffisamment importante pour démontrer des gains d’efficacité mesurables. Sans amélioration de la marge, chaque nouveau palier de revenus pourrait toutefois nécessiter des financements encore plus élevés.

Chacun des sept cofondateurs d'Anthropic encaissera environ 250 millions de dollars lors de l'introduction en bourse, tandis que les investisseurs attendent des preuves concrètes de la rentabilité de l'IA

Chacun des sept cofondateurs d'Anthropic encaissera environ 250 millions de dollars lors de l'introduction en bourse, tandis que les investisseurs attendent des preuves concrètes de la rentabilité de l'IA

Anthropic vise une valorisation d'environ 1 400 milliards de dollars lors de son introduction en bourse. L'opération permettrait à chacun des sept cofondateurs de l'entreprise de toucher environ 250 millions de dollars grâce à la vente d'une part spécifique de leurs actions. Malgré cette importante...

Anthropic lance de nouvelles fonctionnalités pour les entreprises afin de concurrencer Microsoft et Google, dont Claude Meetings qui intègre Claude aux appels vidéo, Claude Whiteboards et Claude Sheets

Anthropic lance de nouvelles fonctionnalités pour les entreprises afin de concurrencer Microsoft et Google, dont Claude Meetings qui intègre Claude aux appels vidéo, Claude Whiteboards et Claude Sheets

Anthropic a annoncé de nouvelles fonctionnalités destinées au monde du travail, dont « Claude Meetings » qui permet à l'intelligence artificielle (IA) Claude de participer aux visioconférences en tant que participant visible, capable de prendre des notes, de répondre aux questions et de rédiger des...

Un brevet de Microsoft décrit une rémunération pour l'entraînement d'IA sur votre GPU inutilisé, pour recevoir des crédits en magasin, ou un accès à des modèles d'IA avancés

Un brevet de Microsoft décrit une rémunération pour l'entraînement d'IA sur un GPU inactif, les utilisateurs pouvant recevoir des crédits en magasin ou un accès à des modèles d'IA avancés

Microsoft explore la possibilité d'utiliser la puissance de calcul inutilisée des appareils grand public pour entraîner des modèles d'IA, ce qui pourrait générer des revenus pour leurs propriétaires. Un brevet publié le 5 novembre 2026 décrit un système qui répartirait les tâches d'entraînement de l'IA les plus...

  • ✇PandIA
  • Comment utiliser l’IA pour nettoyer et transformer des données en Python
    L’IA permet de nettoyer et transformer des données en Python plus rapidement, notamment avec pandas, scikit-learn et des modèles de langage capables d’analyser des colonnes, de suggérer des corrections et de générer des traitements. Ce guide explique comment utiliser l’IA pour détecter les erreurs, gérer les valeurs manquantes, normaliser les formats, traiter les textes et valider automatiquement les résultats.Pourquoi utiliser l’IA pour nettoyer des données en Python ?Le nettoyage des données r

Comment utiliser l’IA pour nettoyer et transformer des données en Python

Par : Decrypt
11 novembre 2026 à 12:05
Comment utiliser l’IA pour nettoyer et transformer des données en Python

L’IA permet de nettoyer et transformer des données en Python plus rapidement, notamment avec pandas, scikit-learn et des modèles de langage capables d’analyser des colonnes, de suggérer des corrections et de générer des traitements. Ce guide explique comment utiliser l’IA pour détecter les erreurs, gérer les valeurs manquantes, normaliser les formats, traiter les textes et valider automatiquement les résultats.

Pourquoi utiliser l’IA pour nettoyer des données en Python ?

Le nettoyage des données représente souvent une part importante d’un projet d’analyse ou de machine learning. Un fichier CSV peut contenir des dates dans plusieurs formats, des doublons, des valeurs manquantes, des fautes de frappe ou des unités incohérentes.

L’IA peut accélérer plusieurs tâches :

  • identifier les colonnes mal nommées ou mal typées ;
  • repérer les valeurs aberrantes ;
  • suggérer une stratégie pour les données manquantes ;
  • convertir des formats hétérogènes ;
  • normaliser des catégories textuelles ;
  • détecter les doublons proches mais non identiques ;
  • générer du code pandas ;
  • expliquer les erreurs rencontrées dans un pipeline ;
  • proposer des règles de validation.

L’IA ne remplace toutefois pas la vérification humaine. Une correction statistiquement probable peut être fausse sur le plan métier. Par exemple, une valeur de température négative peut être normale dans un pays donné, tandis qu’un prix négatif est généralement suspect.

Quel rôle l’IA peut-elle jouer dans un pipeline de données ?

Un pipeline de nettoyage efficace sépare généralement cinq étapes :

  1. Exploration : comprendre la structure et le contenu du jeu de données.
  2. Détection : repérer les erreurs, valeurs atypiques et incohérences.
  3. Transformation : appliquer les corrections nécessaires.
  4. Validation : vérifier que les résultats respectent les règles attendues.
  5. Traçabilité : conserver les règles et les modifications effectuées.

L’IA intervient surtout dans l’exploration, la détection et la génération de transformations. Python reste indispensable pour appliquer les opérations de manière reproductible.

Les principales approches d’IA

Les modèles de langage

Les modèles de langage peuvent analyser un échantillon de données ou une description de colonnes et suggérer :

  • des opérations pandas ;
  • des expressions régulières ;
  • des règles de conversion ;
  • des contrôles qualité ;
  • une structure de pipeline.

Ils sont particulièrement utiles pour les colonnes textuelles et les erreurs difficiles à formaliser.

Le machine learning classique

Des algorithmes peuvent détecter automatiquement des anomalies ou regrouper des valeurs similaires :

  • `IsolationForest` pour identifier des observations atypiques ;
  • `LocalOutlierFactor` pour repérer des anomalies locales ;
  • `KMeans` ou d’autres méthodes de clustering pour explorer des groupes ;
  • `TfidfVectorizer` et des modèles de classification pour catégoriser des textes ;
  • des modèles d’imputation pour estimer certaines valeurs manquantes.

Les bibliothèques d’aide au nettoyage

L’écosystème Python fournit plusieurs outils utiles :

  • pandas pour manipuler les tableaux ;
  • NumPy pour les calculs numériques ;
  • scikit-learn pour les transformations et l’imputation ;
  • pyjanitor pour simplifier les opérations de nettoyage ;
  • Great Expectations ou Pandera pour contrôler la qualité des données ;
  • RapidFuzz pour comparer des chaînes proches ;
  • OpenAI, Mistral, Anthropic ou d’autres API pour les tâches de langage, selon les exigences de confidentialité.

Préparer l’environnement Python

Avant d’utiliser l’IA, il faut disposer d’un environnement isolé et reproductible. Python 3.10 ou une version plus récente convient à la plupart des projets modernes.

Les dépendances courantes peuvent être installées avec la commande `pip install pandas numpy scikit-learn openpyxl rapidfuzz pandera`. Pour les fichiers Excel, `openpyxl` est généralement nécessaire. Pour les formats Parquet, le paquet `pyarrow` peut être ajouté.

Une structure simple peut contenir :

  • `data/raw/` pour les fichiers originaux ;
  • `data/processed/` pour les données nettoyées ;
  • `notebooks/` pour l’exploration ;
  • `src/` pour le code réutilisable ;
  • `reports/` pour les rapports qualité ;
  • `requirements.txt` ou `pyproject.toml` pour les dépendances.

Le fichier original doit rester intact. Les corrections doivent être écrites dans une nouvelle version afin de pouvoir comparer les résultats et revenir en arrière.

Étape 1 : explorer les données avant toute correction

L’IA donne de meilleurs résultats lorsqu’elle reçoit un contexte clair. Il faut donc commencer par examiner la structure du fichier avec pandas.

Les commandes essentielles sont :

  • `df.shape` pour connaître le nombre de lignes et de colonnes ;
  • `df.head()` pour visualiser les premières lignes ;
  • `df.info()` pour observer les types et les valeurs non nulles ;
  • `df.describe(include="all")` pour obtenir des statistiques générales ;
  • `df.isna().sum()` pour compter les valeurs manquantes ;
  • `df.nunique()` pour connaître le nombre de valeurs distinctes ;
  • `df.duplicated().sum()` pour compter les doublons exacts.

Une première analyse assistée par IA peut s’appuyer sur un résumé plutôt que sur les données complètes. Il est préférable d’envoyer :

  • le nom des colonnes ;
  • les types détectés ;
  • quelques lignes anonymisées ;
  • les statistiques principales ;
  • les contraintes métier connues.

Un prompt efficace peut être formulé ainsi :

Analyse ce schéma de données. Pour chaque colonne, indique le type attendu, les problèmes possibles, les valeurs manquantes à surveiller, les transformations recommandées et les contrôles à ajouter. Ne modifie aucune donnée et signale les hypothèses.

Cette méthode limite le risque d’exposer des informations personnelles ou confidentielles.

Étape 2 : utiliser l’IA pour détecter les problèmes de qualité

Détecter les valeurs manquantes

Une cellule vide peut être représentée par `NaN`, une chaîne vide, `"N/A"`, `"inconnu"`, `"null"` ou une valeur comme `-1`. Avant de calculer les taux de valeurs manquantes, ces représentations doivent être harmonisées.

Par exemple, `df.replace(["", "N/A", "NA", "null", "inconnu"], np.nan)` permet de convertir plusieurs marqueurs en valeurs manquantes.

L’IA peut suggérer une stratégie, mais la décision dépend du contexte :

  • supprimer une ligne si une colonne essentielle est absente ;
  • remplacer une valeur numérique par la médiane ;
  • utiliser la moyenne si la distribution est stable ;
  • utiliser la modalité la plus fréquente pour une catégorie ;
  • créer une catégorie `"Inconnu"` ;
  • utiliser une imputation fondée sur d’autres variables ;
  • conserver l’absence comme une information à part entière.

La suppression automatique des lignes est risquée. Elle peut modifier la représentativité de l’échantillon et introduire un biais.

Repérer les doublons

Il existe deux types de doublons :

  • les doublons exacts, détectables avec `df.duplicated()` ;
  • les doublons approximatifs, où les noms ou adresses présentent de petites différences.

Pour rapprocher des chaînes comme `"Société Dupont"` et `"Societe Dupont"`, la bibliothèque `RapidFuzz` peut calculer une similarité. L’IA peut ensuite proposer des règles de regroupement, mais un seuil automatique doit être validé.

Une bonne pratique consiste à définir une clé métier :

  • identifiant client ;
  • adresse e-mail ;
  • combinaison nom-date ;
  • numéro de commande ;
  • référence produit.

Deux lignes très similaires ne doivent pas être fusionnées si elles correspondent à deux transactions différentes.

Détecter les valeurs aberrantes

Une valeur aberrante n’est pas nécessairement une erreur. Elle peut correspondre à un événement rare mais réel.

Les méthodes courantes sont :

  • règle de l’écart interquartile ;
  • score Z ;
  • `IsolationForest` ;
  • comparaison à des seuils métier ;
  • analyse de séries temporelles ;
  • regroupement par catégorie ou par région.

Avec `IsolationForest`, l’algorithme peut identifier des observations inhabituelles dans plusieurs variables numériques. Le résultat doit être interprété comme un signal à examiner, et non comme une preuve d’erreur.

Un prompt utile peut demander :

Décris les valeurs potentiellement aberrantes à partir de ces statistiques. Sépare les anomalies statistiques des violations de règles métier et propose un contrôle Python pour chaque cas.

Étape 3 : normaliser les types et les formats

Les erreurs de type sont fréquentes dans les fichiers importés depuis Excel ou des applications métier.

Convertir les nombres

Une colonne de prix peut contenir :

  • `12,50 €` ;
  • `12.50` ;
  • `1 250,00` ;
  • `N/A`.

Avant conversion, il faut retirer les symboles monétaires et harmoniser les séparateurs. La fonction `pd.to_numeric(..., errors="coerce")` permet de convertir les valeurs invalides en valeurs manquantes.

L’IA peut générer une expression de nettoyage, mais celle-ci doit être testée sur des exemples représentatifs. Une confusion entre virgule décimale et séparateur de milliers peut multiplier ou diviser les montants par 100.

Convertir les dates

Les dates peuvent être écrites sous plusieurs formes :

  • `31/12/2024` ;
  • `2024-12-31` ;
  • `12/31/2024` ;
  • `31 décembre 2024`.

La fonction `pd.to_datetime` facilite la conversion, mais le paramètre `dayfirst=True` doit être utilisé avec prudence. Une date ambiguë comme `03/04/2024` peut désigner le 3 avril ou le 4 mars.

Pour chaque colonne de date, il faut contrôler :

  • la période couverte ;
  • les dates futures inattendues ;
  • les dates antérieures à la création de l’entreprise ;
  • la cohérence entre date de début et date de fin.

Normaliser les catégories

Une même catégorie peut apparaître sous plusieurs formes : `"France"`, `"france"`, `"FR"` ou `"Fr."`.

Une stratégie fiable consiste à :

  1. supprimer les espaces inutiles avec `str.strip()` ;
  2. harmoniser la casse avec `str.lower()` ou `str.upper()` ;
  3. supprimer les accents si le contexte le justifie ;
  4. utiliser un dictionnaire de correspondance ;
  5. contrôler les valeurs non reconnues.

L’IA peut proposer ce dictionnaire à partir d’une liste de valeurs distinctes. Chaque correspondance doit cependant être vérifiée, notamment pour les noms de villes, de produits et de clients.

Étape 4 : transformer les données avec pandas

Après la détection, les transformations doivent être explicites et reproductibles.

Renommer les colonnes

Des noms standardisés simplifient les traitements. Une convention courante utilise des noms en minuscules séparés par des underscores : `date_commande`, `prix_unitaire`, `id_client`.

L’IA peut générer une fonction de normalisation des noms, mais il faut vérifier les collisions. Les colonnes `"Code client"` et `"code_client"` pourraient produire le même nom final.

Créer des variables dérivées

Python peut calculer de nouvelles colonnes :

  • montant total ;
  • durée entre deux dates ;
  • tranche d’âge ;
  • taux de conversion ;
  • marge ;
  • indicateur de retard.

Par exemple, `df["montant_total"] = df["quantite"] * df["prix_unitaire"]` crée un montant à partir de deux colonnes. Une règle métier doit préciser le traitement des quantités nulles, négatives ou non numériques.

Transformer les textes avec l’IA

Les modèles de langage sont adaptés aux tâches suivantes :

  • classer des commentaires ;
  • extraire une ville ou une entreprise ;
  • détecter la langue ;
  • résumer des tickets ;
  • attribuer une catégorie ;
  • repérer un sentiment ;
  • extraire des informations dans des descriptions libres.

Une méthode robuste consiste à demander une sortie structurée avec des champs précis, par exemple `categorie`, `priorite` et `justification`. La réponse doit ensuite être validée avant son intégration dans pandas.

Pour les gros volumes, l’envoi ligne par ligne à une API peut coûter cher et ralentir le traitement. Il est préférable de :

  • dédupliquer les textes avant analyse ;
  • traiter les données par lots ;
  • mettre en cache les résultats ;
  • définir une liste fermée de catégories ;
  • utiliser un modèle local si les données sont sensibles ;
  • prévoir une gestion des erreurs et des nouvelles tentatives.

Étape 5 : détecter les anomalies avec scikit-learn

Pour les colonnes numériques, un modèle d’anomalie peut compléter les règles classiques.

Le principe général est le suivant :

  1. sélectionner les variables pertinentes ;
  2. traiter les valeurs manquantes ;
  3. standardiser les échelles si nécessaire ;
  4. entraîner le modèle sur les données disponibles ;
  5. ajouter un indicateur d’anomalie ;
  6. examiner les observations signalées.

Avec `IsolationForest`, la variable `contamination` estime la proportion attendue d’anomalies. Ce paramètre ne doit pas être choisi au hasard : une valeur trop élevée marquera trop de lignes, tandis qu’une valeur trop basse laissera passer des erreurs.

Pour les variables catégorielles, une conversion directe en nombres peut créer une fausse hiérarchie. Il est préférable d’utiliser un encodage adapté, comme `OneHotEncoder`, ou une méthode fondée sur les fréquences.

Étape 6 : faire valider le résultat par des règles automatiques

L’IA peut suggérer des corrections, mais les règles de validation garantissent la qualité finale.

Avec Pandera, il est possible de vérifier :

  • le type d’une colonne ;
  • l’absence de valeurs nulles ;
  • une plage numérique ;
  • une expression régulière ;
  • l’unicité d’un identifiant ;
  • une relation entre plusieurs colonnes.

Exemples de contrôles utiles :

  • `prix_unitaire >= 0` ;
  • `quantite` entier et supérieur ou égal à zéro ;
  • `date_fin >= date_debut` ;
  • `email` conforme à un format attendu ;
  • `id_client` unique lorsque cela est requis ;
  • nombre de lignes final proche du nombre attendu ;
  • aucune nouvelle valeur imprévue dans une catégorie.

Un rapport qualité devrait contenir :

  • le nombre de lignes avant et après nettoyage ;
  • le nombre de doublons supprimés ;
  • le taux de valeurs manquantes par colonne ;
  • les transformations appliquées ;
  • les anomalies détectées ;
  • les lignes écartées et leur raison ;
  • la date et la version du traitement.

Comment demander du code Python à une IA ?

Une demande vague comme « nettoie ce fichier » produit souvent un code incomplet. Un prompt plus précis doit fournir :

  1. le format des données ;
  2. la liste des colonnes ;
  3. quelques exemples anonymisés ;
  4. les types attendus ;
  5. les règles métier ;
  6. les valeurs à considérer comme manquantes ;
  7. le format de sortie souhaité ;
  8. l’obligation de commenter les hypothèses.

Exemple de consigne :

Génère un pipeline pandas reproductible pour un fichier CSV de commandes. Convertis les dates au format ISO, transforme les montants en nombres décimaux, signale les doublons selon `id_commande`, conserve les lignes invalides dans un fichier séparé et ajoute des contrôles de validation. Explique chaque hypothèse et ne supprime aucune ligne sans justification.

Il faut demander à l’IA de séparer la détection de la correction. Cette précaution évite qu’une erreur soit modifiée silencieusement.

Confidentialité et sécurité des données

Avant d’envoyer des données à une API d’IA, il faut évaluer leur sensibilité. Les informations personnelles, données de santé, coordonnées bancaires, secrets commerciaux et identifiants internes ne doivent pas être transmis sans cadre juridique et technique approprié.

Les mesures recommandées sont :

  • anonymiser les noms, e-mails et numéros de téléphone ;
  • remplacer les identifiants par des valeurs fictives ;
  • envoyer uniquement un échantillon ;
  • vérifier la politique de conservation du fournisseur ;
  • utiliser une solution hébergée dans une région compatible avec les obligations applicables ;
  • limiter les droits de l’API ;
  • journaliser les appels ;
  • éviter d’inclure des clés secrètes dans le code ;
  • stocker les secrets dans des variables d’environnement.

Le RGPD peut s’appliquer dès qu’un fichier contient des données permettant d’identifier une personne. L’utilisation d’une IA ne supprime pas les obligations relatives à la minimisation, à la sécurité et à la base légale du traitement.

Combien coûte l’utilisation de l’IA pour le nettoyage des données ?

Le coût dépend de la méthode choisie :

  • pandas et scikit-learn sont gratuits et exécutés localement ;
  • une API de modèle de langage facture généralement selon le volume de texte traité ;
  • une solution cloud peut ajouter les coûts de stockage, de calcul et de réseau ;
  • un modèle local nécessite davantage de ressources matérielles et de maintenance.

Pour réduire les coûts :

  • commencer par des règles Python déterministes ;
  • utiliser l’IA uniquement pour les cas ambigus ;
  • regrouper les requêtes ;
  • réduire la taille des prompts ;
  • mémoriser les résultats déjà obtenus ;
  • préférer un modèle moins coûteux pour la classification simple ;
  • évaluer la qualité sur un échantillon avant de traiter tout le fichier.

Quand ne faut-il pas utiliser l’IA ?

L’IA n’est pas toujours nécessaire. Des règles classiques sont préférables lorsque :

  • le format est parfaitement connu ;
  • la transformation est déterministe ;
  • le volume est très important ;
  • les données sont extrêmement sensibles ;
  • une exigence réglementaire impose une traçabilité stricte ;
  • l’erreur peut entraîner une conséquence financière ou médicale importante ;
  • la décision doit être entièrement explicable.

La meilleure approche est souvent hybride : pandas pour les transformations prévisibles, scikit-learn pour les anomalies quantitatives et IA générative pour les textes ou les cas ambigus.

Bonnes pratiques pour un pipeline fiable

Quelques principes améliorent fortement la qualité du projet :

  • conserver une copie immuable des données brutes ;
  • versionner le code et les règles ;
  • utiliser des jeux de tests représentatifs ;
  • documenter chaque transformation ;
  • comparer les distributions avant et après nettoyage ;
  • mesurer le taux de lignes modifiées ;
  • ajouter des contrôles dans l’intégration continue ;
  • distinguer les erreurs bloquantes des alertes ;
  • examiner un échantillon de corrections manuellement ;
  • éviter les décisions irréversibles ;
  • conserver les valeurs originales dans des colonnes séparées lorsque cela est utile.

Il faut également surveiller le data leakage dans les projets de machine learning. Une imputation, une normalisation ou une transformation doit être ajustée uniquement sur les données d’entraînement, puis appliquée aux données de validation et de test. Les pipelines scikit-learn avec `Pipeline` et `ColumnTransformer` facilitent cette séparation.

Conclusion : les points clés à retenir

L’IA peut accélérer le nettoyage et la transformation des données en Python, mais elle doit être utilisée comme un assistant contrôlable plutôt que comme une autorité automatique.

Les principes essentiels sont les suivants :

  • commencer par explorer la structure et la qualité des données ;
  • utiliser l’IA pour suggérer des règles, du code et des diagnostics ;
  • appliquer les transformations avec pandas ou scikit-learn ;
  • traiter séparément les valeurs manquantes, les doublons, les types et les anomalies ;
  • valider chaque correction avec des règles métier ;
  • protéger les données sensibles avant tout appel à une API ;
  • conserver les fichiers originaux et les journaux de transformation ;
  • privilégier une approche hybride combinant règles déterministes et IA ;
  • tester le résultat sur un échantillon avant le traitement complet.

Un pipeline bien conçu ne se contente pas de produire un fichier « propre ». Il explique ce qui a été modifié, pourquoi la modification a été effectuée et comment vérifier qu’elle est correcte.

  • ✇PandIA
  • AlphaProof Code vérifie des propriétés de sécurité de Signal avec 6,5 millions de lignes Lean
    Une IA qui signale une faille peut attirer l’attention. Une IA qui contribue à produire une preuve mathématique contrôlée par un noyau de vérification va plus loin : elle permet d’établir, propriété par propriété, ce que garantit réellement le code qui protège des conversations privées.D’une détection automatisée à une preuve vérifiableDévoilé le 10 novembre 2026, AlphaProof Code, le système de Google DeepMind, a été utilisé pour vérifier des propriétés de sécurité de libsignal, l’implémentation

AlphaProof Code vérifie des propriétés de sécurité de Signal avec 6,5 millions de lignes Lean

Par : Decrypt
11 novembre 2026 à 07:01
AlphaProof Code vérifie des propriétés de sécurité de Signal avec 6,5 millions de lignes Lean

Une IA qui signale une faille peut attirer l’attention. Une IA qui contribue à produire une preuve mathématique contrôlée par un noyau de vérification va plus loin : elle permet d’établir, propriété par propriété, ce que garantit réellement le code qui protège des conversations privées.

D’une détection automatisée à une preuve vérifiable

Dévoilé le 10 novembre 2026, AlphaProof Code, le système de Google DeepMind, a été utilisé pour vérifier des propriétés de sécurité de libsignal, l’implémentation de référence du protocole Signal. L’objectif n’était pas simplement d’inspecter le code à la recherche d’erreurs, mais de démontrer formellement que certaines propriétés restent vraies dans l’implémentation étudiée.

La distinction est importante. Une analyse automatisée classique peut identifier des comportements suspects, des chemins d’exécution inhabituels ou des vulnérabilités potentielles. La vérification formelle, elle, traduit une propriété de sécurité en énoncé mathématique, puis cherche à établir que cet énoncé est respecté par le programme dans les conditions définies.

Dans le cas présent, les agents d’AlphaProof Code ont généré environ 6,5 millions de lignes de preuves Lean. Ces preuves ont ensuite été contrôlées par le noyau du système de preuve Lean. Ce noyau constitue le dernier arbitre : il ne se contente pas d’évaluer la plausibilité d’une démonstration produite par un modèle, il vérifie que les règles formelles ont bien été respectées.

L’IA n’a donc pas reçu le dernier mot sur la validité de ses propres résultats. Son travail a consisté à explorer et construire les démonstrations ; la validation finale repose sur un mécanisme formel indépendant des intuitions ou des probabilités du modèle.

Vérifier le code au plus près de son exécution

L’un des aspects les plus significatifs du projet tient au niveau auquel la vérification a été menée. Les travaux se sont appuyés sur des spécifications, mais aussi sur la sémantique machine-code en AArch64, l’architecture 64 bits utilisée par de nombreux processeurs mobiles et serveurs.

Cette approche cherche à réduire l’écart entre l’algorithme décrit par ses concepteurs et le programme effectivement exécuté par la machine. Vérifier uniquement une abstraction du protocole ne suffit pas toujours : une erreur peut apparaître lors de la compilation, dans la gestion de la mémoire, dans une opération arithmétique ou dans l’interprétation d’une instruction bas niveau.

En prenant en compte la sémantique du code machine, le dispositif tente de suivre la chaîne complète : la propriété de sécurité, le code de libsignal, puis les instructions correspondant à son exécution sur AArch64. Cette profondeur ne signifie pas que chaque composant de l’écosystème Signal est automatiquement couvert. Elle permet cependant de rapprocher la preuve du comportement concret du logiciel.

Pour un protocole de messagerie chiffrée, cette précision est déterminante. La confidentialité ne dépend pas seulement de la solidité théorique de la cryptographie. Elle repose aussi sur la fidélité de l’implémentation, la gestion des clés, les états du protocole et les garanties apportées par le code exécuté.

Une production massive, mais pas autonome

Le volume annoncé donne une idée de la difficulté du chantier : 6,5 millions de lignes de preuves pour établir les propriétés ciblées. Ce chiffre ne correspond pas à autant de lignes de code applicatif, mais aux éléments formels nécessaires pour décrire les comportements, lever les ambiguïtés et démontrer les théorèmes associés.

Google DeepMind précise toutefois que le travail a été guidé par des humains. Les chercheurs ont défini les objectifs, construit le cadre de vérification et orienté les agents dans les étapes difficiles. L’IA n’a pas transformé seule un dépôt logiciel en garantie mathématique complète.

Cette précision est essentielle, car une preuve formelle ne porte que sur ce qui a été spécifié. Les spécifications de confiance représentent environ 26 000 lignes, soit une fraction très réduite du volume total des preuves générées. Elles restent néanmoins un socle critique : si une propriété est mal formulée, trop faible ou incomplète, le système peut démontrer impeccablement quelque chose qui ne couvre pas le risque recherché.

Autrement dit, le noyau Lean peut certifier qu’une preuve est correcte au regard des définitions et des axiomes fournis. Il ne peut pas décider seul si ces définitions décrivent toutes les garanties attendues d’une messagerie sécurisée.

Ce que cette étape apporte à Signal

Signal indique que cette méthode étend nettement la portée des vérifications formelles menées auparavant sur son logiciel. Jusqu’ici, les analyses formelles appliquées aux protocoles cryptographiques portaient souvent sur des modèles abstraits, des composants isolés ou des propriétés précises. Le projet présenté avec AlphaProof Code vise une couverture plus proche de l’implémentation réelle et de son exécution.

La différence se mesure moins au nombre de problèmes trouvés qu’au type de résultat produit. Un outil d’analyse peut conclure qu’aucun défaut connu n’a été détecté dans un périmètre donné. Une preuve formelle établit qu’une propriété déterminée découle du modèle et du code vérifiés. Ce n’est pas une certification générale de sécurité, mais c’est une garantie beaucoup plus explicite et auditable.

Le rôle de l’IA est ici particulièrement intéressant. Les systèmes de preuve comme Lean exigent habituellement un travail considérable pour décomposer un objectif, choisir les lemmes utiles et gérer les détails techniques. Les agents peuvent accélérer cette recherche, générer des étapes intermédiaires et reprendre une démonstration après un échec. La validation, elle, reste confiée à un noyau dont le fonctionnement est plus restreint et plus facilement inspectable.

Une garantie ciblée, pas un certificat absolu

Il serait excessif de conclure que Signal est désormais « prouvé sûr » dans son ensemble. La démarche ne couvre que les propriétés sélectionnées, les composants étudiés et les hypothèses retenues. Elle ne remplace ni les audits, ni les tests, ni l’analyse des dépendances, ni la surveillance des vulnérabilités apparues après la vérification.

Elle ne traite pas non plus automatiquement les erreurs de conception situées en dehors des spécifications, les compromis opérationnels, les attaques contre le matériel ou les éléments qui ne figurent pas dans le modèle. La confiance est déplacée vers une base plus précise : spécifications, sémantique d’exécution, bibliothèques de preuve et noyau Lean.

C’est justement ce déplacement qui rend l’expérience importante pour l’ingénierie logicielle. Une IA générative peut produire du code plausible, mais une preuve contrôlée par un noyau impose une discipline différente : chaque étape doit être justifiable dans un cadre formel.

Le prochain jalon sera l’élargissement mesurable du périmètre : davantage de composants de libsignal, davantage de propriétés et, idéalement, la publication de résultats permettant à des tiers de reproduire ou d’auditer les preuves. À terme, l’enjeu ne sera pas de produire toujours plus de lignes Lean, mais de réduire les 26 000 lignes de spécifications de confiance, d’en clarifier les hypothèses et de démontrer que les garanties formelles couvrent les scénarios d’attaque les plus importants.

Anthropic vise une valorisation d'environ 1 400 milliards $ « l'introduction en bourse la plus ridicule de 2026, un test sans précédent de la crédulité des investisseurs »

Anthropic vise une valorisation d'environ 1 400 milliards $ « l'introduction en bourse la plus ridicule de 2026, un test sans précédent de la crédulité des investisseurs »

Anthropic a déposé une demande visant à lever jusqu'à 64,4 milliards de dollars dans le cadre d'une introduction en bourse, pour une valorisation d'environ 1 400 milliards de dollars. Un placement privé parallèle de 26 milliards de dollars vient s'y ajouter, portant le montant total de la levée de fonds à près de 90,4 milliards...

  • ✇PandIA
  • Anthropic vise 1 404 milliards de dollars en Bourse malgré 80,7 milliards de pertes
    Le pari est vertigineux : Anthropic veut convaincre les marchés qu’un laboratoire d’intelligence artificielle encore massivement déficitaire peut valoir jusqu’à 1 404 milliards de dollars. Avec son entrée en Bourse, le fabricant de Claude s’apprête à soumettre à des investisseurs publics une équation où la croissance des revenus doit compenser l’ampleur des pertes.Une IPO calibrée pour dépasser le millier de milliardsLe 10 novembre 2026, Anthropic a lancé la commercialisation de son introduction

Anthropic vise 1 404 milliards de dollars en Bourse malgré 80,7 milliards de pertes

Par : Decrypt
10 novembre 2026 à 19:00
Anthropic vise 1 404 milliards de dollars en Bourse malgré 80,7 milliards de pertes

Le pari est vertigineux : Anthropic veut convaincre les marchés qu’un laboratoire d’intelligence artificielle encore massivement déficitaire peut valoir jusqu’à 1 404 milliards de dollars. Avec son entrée en Bourse, le fabricant de Claude s’apprête à soumettre à des investisseurs publics une équation où la croissance des revenus doit compenser l’ampleur des pertes.

Une IPO calibrée pour dépasser le millier de milliards

Le 10 novembre 2026, Anthropic a lancé la commercialisation de son introduction en Bourse, avec une fourchette comprise entre 70 et 78 dollars par action. Au sommet de cette fourchette, la valorisation implicite de l’entreprise atteindrait environ 1 404 milliards de dollars.

L’opération pourrait permettre à Anthropic de lever jusqu’à 62,5 milliards de dollars. Un montant exceptionnel pour une entreprise technologique non cotée, mais cohérent avec les besoins de financement d’un secteur où l’entraînement et l’exploitation des modèles d’IA nécessitent des infrastructures particulièrement coûteuses.

La cotation placerait Anthropic devant OpenAI dans la course à la première grande introduction en Bourse d’un laboratoire d’IA. Jusqu’ici, OpenAI occupait le centre de l’attention médiatique et financière, mais sa structure et ses relations avec ses partenaires ont rendu son accès aux marchés publics plus complexe. Anthropic tente donc de transformer son avance commerciale auprès des entreprises en avantage boursier.

Cette hiérarchie pourrait toutefois être provisoire. Le marché évaluera moins le prestige de Claude que la capacité d’Anthropic à convertir son usage en bénéfices durables.

Des revenus déjà élevés, mais une perte hors norme

Le dossier transmis à la SEC, le gendarme américain des marchés, fait état de 16,3 milliards de dollars de chiffre d’affaires au premier semestre 2026. Ce niveau témoigne d’une demande considérable pour les services d’IA générative d’Anthropic, notamment auprès des grandes entreprises qui utilisent Claude pour le développement logiciel, l’analyse de documents ou l’automatisation de tâches complexes.

Mais le même document fait apparaître une perte nette de 80,7 milliards de dollars sur la période. La perte représente ainsi près de cinq fois le chiffre d’affaires semestriel déclaré. Même en tenant compte des spécificités comptables ou d’éventuelles charges exceptionnelles, l’écart entre l’activité générée et les dépenses engagées constitue le principal point de fragilité du dossier.

Les chiffres placent les futurs actionnaires face à une question simple : combien de temps faudra-t-il à Anthropic pour atteindre une rentabilité opérationnelle, et quelle quantité de capital supplémentaire sera nécessaire avant cette échéance ?

À 1 404 milliards de dollars, la valorisation correspondrait, sur une base annuelle simplement extrapolée, à plus de 43 fois le chiffre d’affaires. Ce ratio ne constitue pas une prévision financière, mais il donne une indication du niveau d’anticipation intégré dans le prix. Les investisseurs ne paieraient pas seulement les revenus actuels : ils miseraient sur une forte progression des ventes, une amélioration des marges et une baisse du coût unitaire des requêtes adressées aux modèles.

Le coût de Claude au cœur de l’équation

La difficulté d’Anthropic tient à la structure économique des modèles d’IA. Chaque utilisation de Claude mobilise des capacités de calcul, des centres de données, de l’énergie et des composants avancés. À la différence d’un logiciel traditionnel, dont le coût marginal peut devenir très faible après le développement initial, un service d’IA génère une dépense à chaque requête.

Cette mécanique peut favoriser une croissance rapide du chiffre d’affaires tout en retardant la rentabilité. Les modèles les plus performants sont aussi souvent les plus coûteux à entraîner et à exécuter. Anthropic doit donc améliorer simultanément ses modèles, réduire leur coût d’inférence et facturer suffisamment cher ses offres professionnelles.

La levée de 62,5 milliards de dollars offrirait à l’entreprise une réserve considérable pour financer ses besoins en calcul et sécuriser ses approvisionnements en puces. Elle pourrait également réduire sa dépendance à l’égard de ses partenaires stratégiques et lui permettre d’investir dans de nouveaux produits.

Mais l’argent levé ne résout pas automatiquement le problème économique. Il donne du temps. La valorisation, elle, impose un calendrier : à mesure que la capitalisation augmente, les marchés attendent une trajectoire crédible vers des marges positives.

Les marchés devront arbitrer entre croissance et discipline financière

Le dossier d’Anthropic arrive dans un contexte où les investisseurs examinent de plus près les dépenses liées à l’IA. Les promesses de productivité et de nouveaux revenus sont importantes, mais les dépenses en infrastructures progressent elles aussi. Les fabricants de puces, les opérateurs de centres de données et les fournisseurs de services en nuage captent une partie significative de la valeur créée autour des modèles.

Anthropic devra démontrer que sa croissance ne repose pas uniquement sur l’élargissement de ses capacités de calcul. Le marché cherchera des signes de fidélisation des clients, d’augmentation du revenu moyen par entreprise et de stabilisation des coûts. La composition du chiffre d’affaires sera également déterminante : des contrats pluriannuels et des usages intégrés dans les processus métiers seraient jugés plus solides qu’une consommation fluctuante ou dépendante de promotions commerciales.

L’introduction en Bourse rendra ces indicateurs plus visibles et plus régulièrement scrutés. Les résultats trimestriels, la consommation de trésorerie et les engagements d’infrastructure deviendront des variables susceptibles de faire évoluer rapidement le cours de l’action.

Anthropic prend l’avantage symbolique sur OpenAI

En lançant son roadshow, Anthropic ne cherche pas seulement des capitaux. L’entreprise impose aussi un calendrier à ses concurrents. Être le premier grand laboratoire d’IA à entrer en Bourse lui permettrait de fixer les premières références de valorisation du secteur et de tester l’appétit réel des marchés pour des sociétés dont les pertes restent gigantesques.

Cette avance comporte un risque : Anthropic sera la première à subir publiquement la comparaison entre ses promesses et ses résultats. Si les investisseurs acceptent une valorisation supérieure à 1 000 milliards de dollars, l’opération validera l’idée que les revenus futurs de l’IA peuvent justifier des multiples inédits. Si la demande se révèle moins forte que prévu, le secteur entier pourrait être réévalué avant même l’arrivée d’OpenAI.

Le prochain jalon sera la fixation du prix définitif de l’action, puis la publication des premiers résultats en tant que société cotée. Ces échéances permettront de mesurer si Anthropic peut réduire l’écart entre 16,3 milliards de dollars de revenus semestriels et 80,7 milliards de pertes, ou si sa valorisation repose encore principalement sur des bénéfices attendus plutôt que réalisés.

Sources : Anthropic, dossier déposé auprès de la SEC, AP.

Nvidia et Jensen Huang poursuivis en justice par des actionnaires après qu'une liaison avec une espionne chinoise ait fait perdre 190 milliards $ à la société, Donald Trump confirme que le FBI mène l'enquête

Nvidia et Jensen Huang poursuivis en justice par des actionnaires après qu'une liaison avec une espionne chinoise ait fait perdre 190 milliards $ à la société, Donald Trump confirme que le FBI mène l'enquête

Nvidia et son PDG, Jensen Huang, font l'objet d'une action en justice intentée par des actionnaires au sujet de la relation de ce dernier avec Alice Huang, une ancienne dirigeante de Megaspeed International que les services de renseignement américains auraient identifiée comme étant une agente...

L'obligation d'utiliser l'IA au travail se retourne-t-elle contre nous ? Elle crée du désengagement et pousse les équipes à remplir leurs quotas d'usage sans apporter de valeur réelle à l'entreprise

L'obligation d'utiliser l'IA au travail se retourne-t-elle contre nous ? Elle crée du désengagement et pousse les équipes à remplir leurs quotas d'usage sans apporter de valeur réelle à l'entreprise

Alors que les entreprises exigent l'utilisation de l'IA pour stimuler la productivité, cette approche autoritaire s'avère souvent contre-productive. En imposant des quotas d'utilisation ou des temps de connexion, les employeurs risquent de provoquer le désengagement et le mécontentement du personnel....

  • ✇PandIA
  • Comment utiliser l’IA pour créer des comptes rendus de réunion
    Utiliser l’IA pour créer des comptes rendus de réunion permet de transformer automatiquement un enregistrement audio ou une transcription en synthèse structurée. Un compte rendu de réunion généré par IA peut faire gagner du temps, faire ressortir les décisions et attribuer les actions, à condition de vérifier les informations et de respecter la confidentialité des participants.Qu’est-ce qu’un compte rendu de réunion généré par IA ?Un compte rendu de réunion par IA est une synthèse produite à par

Comment utiliser l’IA pour créer des comptes rendus de réunion

Par : Decrypt
10 novembre 2026 à 12:05
Comment utiliser l’IA pour créer des comptes rendus de réunion

Utiliser l’IA pour créer des comptes rendus de réunion permet de transformer automatiquement un enregistrement audio ou une transcription en synthèse structurée. Un compte rendu de réunion généré par IA peut faire gagner du temps, faire ressortir les décisions et attribuer les actions, à condition de vérifier les informations et de respecter la confidentialité des participants.

Qu’est-ce qu’un compte rendu de réunion généré par IA ?

Un compte rendu de réunion par IA est une synthèse produite à partir de plusieurs sources :

  • un enregistrement audio ou vidéo ;
  • une transcription automatique ;
  • des notes prises pendant la réunion ;
  • des documents partagés ou présentés à l’écran ;
  • le calendrier, l’ordre du jour et la liste des participants.

L’outil d’intelligence artificielle identifie généralement les sujets abordés, les décisions prises, les questions ouvertes et les tâches à réaliser. Certains services reconnaissent également les différents intervenants grâce à la diarisation, c’est-à-dire l’association de segments audio à des locuteurs distincts.

Il faut distinguer trois éléments :

  1. La transcription : reproduction écrite, plus ou moins fidèle, de ce qui a été dit.
  2. La synthèse : résumé des échanges et des informations importantes.
  3. Le compte rendu opérationnel : document orienté vers les décisions, les responsables et les prochaines échéances.

La meilleure utilisation de l’IA consiste généralement à produire un compte rendu opérationnel à partir d’une transcription, puis à le faire relire par un participant.

Pourquoi utiliser l’IA pour rédiger un compte rendu de réunion ?

Gagner du temps après chaque réunion

La rédaction manuelle d’un compte rendu peut demander 30 minutes à plusieurs heures, selon la durée de la réunion et la précision attendue. Une IA peut générer une première version en quelques minutes.

Le temps économisé peut être consacré à la vérification des décisions, à la correction des noms propres et à la préparation des actions à venir.

Éviter les oublis

Pendant une réunion, il est difficile d’écouter attentivement, de prendre des notes et d’identifier simultanément les décisions importantes. Une transcription complète fournit une base de vérification lorsque le compte rendu est ambigu.

L’IA peut notamment faire ressortir :

  • les décisions explicites ;
  • les tâches confiées à chaque participant ;
  • les dates annoncées ;
  • les points restant à arbitrer ;
  • les risques et les dépendances ;
  • les sujets évoqués sans conclusion.

Standardiser les comptes rendus

Un outil IA peut appliquer le même format à toutes les réunions :

  • contexte ;
  • participants ;
  • ordre du jour ;
  • synthèse par sujet ;
  • décisions ;
  • plan d’action ;
  • questions en suspens ;
  • prochaine réunion.

Cette standardisation facilite la recherche d’informations et améliore le suivi des projets.

Faciliter l’accès aux informations

Les réunions représentent souvent une source d’information importante, mais difficile à consulter a posteriori. Une synthèse bien structurée permet de retrouver plus rapidement une décision ou une action sans écouter une heure d’enregistrement.

Quelles méthodes permettent de créer un compte rendu avec l’IA ?

Plusieurs méthodes sont possibles selon le format de la réunion et le niveau d’automatisation recherché.

Utiliser l’assistant intégré à la visioconférence

Microsoft Teams, Zoom et Google Meet proposent, selon les offres et les régions, des fonctions de transcription, de résumé ou de prise de notes automatisée.

Ces assistants peuvent généralement :

  • transcrire la réunion en direct ;
  • identifier les principaux thèmes ;
  • générer un résumé ;
  • proposer une liste d’actions ;
  • permettre une recherche dans la réunion.

La disponibilité varie selon l’abonnement, l’organisation, la langue et les paramètres administrateur. Les intitulés et les fonctionnalités évoluent régulièrement : il convient donc de vérifier la documentation officielle du service utilisé.

Utiliser un outil spécialisé dans les réunions

Des services comme Otter.ai, Fireflies.ai, tl;dv, Fathom, Krisp ou d’autres solutions spécialisées peuvent rejoindre une visioconférence, enregistrer les échanges et générer une synthèse.

Ces outils proposent souvent :

  • une intégration avec les calendriers ;
  • une transcription automatique ;
  • une reconnaissance des intervenants ;
  • des résumés par thème ;
  • une extraction des tâches ;
  • une recherche dans l’historique des réunions ;
  • des intégrations avec Slack, Notion, Google Drive, Salesforce ou des outils de gestion de projet.

Avant de sélectionner une solution, il faut vérifier la prise en charge du français, la localisation des données, la durée de conservation des enregistrements et les conditions d’utilisation des données pour l’entraînement des modèles.

Envoyer une transcription à une IA généraliste

Une autre possibilité consiste à récupérer la transcription d’une réunion, puis à la transmettre à un outil conversationnel comme ChatGPT, Claude, Gemini ou Microsoft Copilot.

Cette méthode offre davantage de contrôle sur le format final. L’IA peut produire :

  • un compte rendu formel ;
  • une synthèse courte destinée à la direction ;
  • une liste d’actions au format tableau ;
  • un résumé par participant ;
  • une version destinée à un client ;
  • un relevé des risques et des décisions à valider.

Cette approche exige toutefois une attention particulière à la confidentialité. Une transcription contenant des informations sensibles ne doit pas être téléversée sur un service non approuvé par l’entreprise.

Comment créer un compte rendu de réunion avec l’IA : méthode étape par étape

1. Définir l’objectif du compte rendu

Avant la réunion, il faut déterminer le type de document attendu. Un compte rendu destiné à une équipe projet ne doit pas avoir le même niveau de détail qu’un procès-verbal de comité de direction.

Les objectifs les plus fréquents sont :

  • informer les absents ;
  • conserver une trace des décisions ;
  • suivre un projet ;
  • répartir les tâches ;
  • documenter un échange avec un client ;
  • préparer une réunion suivante ;
  • conserver un historique réglementaire ou contractuel.

Cette étape permet de choisir le bon niveau de synthèse et d’éviter les résumés trop longs.

2. Préparer la réunion

La qualité du compte rendu dépend largement de la qualité de l’audio et du contexte fourni à l’IA.

Avant de démarrer :

  1. Ajoutez un titre clair à l’événement du calendrier.
  2. Indiquez la date, l’objectif et l’ordre du jour.
  3. Préparez la liste des participants.
  4. Vérifiez la langue de transcription.
  5. Ajoutez un lexique avec les noms propres, acronymes et termes techniques.
  6. Testez le microphone et l’outil de transcription.
  7. Informez les participants de l’enregistrement ou de la transcription.

Un ordre du jour structuré aide l’IA à classer les échanges selon les bons sujets.

3. Informer les participants et recueillir les autorisations nécessaires

L’enregistrement d’une réunion implique généralement un traitement de données personnelles. Les participants doivent être informés de manière claire :

  • de l’existence de l’enregistrement ou de la transcription ;
  • de la finalité du traitement ;
  • des personnes pouvant accéder au compte rendu ;
  • de la durée de conservation ;
  • du fournisseur utilisé ;
  • de la possibilité de demander des informations complémentaires.

Dans un contexte professionnel, la politique interne, le RGPD et les recommandations du délégué à la protection des données doivent être respectés. Les réunions traitant de données médicales, de secrets commerciaux, de données RH ou de sujets juridiques nécessitent des précautions renforcées.

Pour une réunion externe, l’information peut apparaître dans l’invitation ou dans un message affiché au début de la visioconférence. Pour une réunion sensible, une validation préalable du service juridique ou du DPO est préférable.

4. Enregistrer ou transcrire la réunion

L’enregistrement n’est pas toujours indispensable. Une transcription en direct peut suffire si aucun besoin d’archivage audio n’existe.

Pour obtenir une meilleure qualité :

  • placez le microphone près des intervenants ;
  • évitez les environnements bruyants ;
  • demandez aux participants de parler chacun leur tour ;
  • limitez les conversations simultanées ;
  • utilisez un casque lorsque cela est possible ;
  • sélectionnez la langue française ;
  • corrigez les noms des intervenants après la réunion ;
  • conservez l’ordre du jour avec la transcription.

Les accents, les acronymes, les noms de marques et les échanges à plusieurs voix sont les principales sources d’erreurs.

5. Demander à l’IA de produire une synthèse structurée

Une consigne précise donne de meilleurs résultats qu’une demande générale comme « résume cette réunion ».

Exemple de prompt :

Analyse la transcription de cette réunion et rédige un compte rendu professionnel en français.
Présente le résultat avec les sections suivantes :
1. Objet et contexte
2. Participants
3. Résumé des échanges par sujet
4. Décisions prises
5. Actions à réaliser, avec un responsable et une échéance lorsqu’ils sont explicitement mentionnés
6. Questions ouvertes et points à arbitrer
7. Prochaine étape
N’invente aucune information. Si un responsable, une date ou une décision n’est pas clairement identifié, indique « À confirmer ». Distingue les décisions fermes des simples propositions. Signale les passages ambigus ou mal transcrits. Adopte un style clair, concis et professionnel.

Pour une réunion longue, la transcription peut être divisée en plusieurs parties. Il faut ensuite demander à l’IA de fusionner les synthèses sans répéter les informations.

6. Vérifier les informations importantes

Un compte rendu généré automatiquement ne doit pas être diffusé sans contrôle humain. La vérification doit porter en priorité sur :

  • les décisions ;
  • les montants ;
  • les dates et échéances ;
  • les noms des personnes ;
  • les noms de produits ou de clients ;
  • les responsabilités attribuées ;
  • les engagements contractuels ;
  • les informations confidentielles ;
  • les formulations exprimant une obligation ou une validation.

L’IA peut présenter comme une décision une simple hypothèse formulée pendant la discussion. Elle peut aussi attribuer une action à la mauvaise personne lorsque plusieurs participants parlent rapidement.

Une règle pratique consiste à comparer chaque décision et chaque tâche avec la transcription originale. Les éléments critiques doivent également être confirmés par leur responsable.

7. Mettre en forme le compte rendu

Le format suivant convient à la plupart des réunions professionnelles :

Informations générales

  • Réunion :
  • Date :
  • Durée :
  • Participants :
  • Absents excusés :
  • Objectif :

Synthèse

Quelques paragraphes regroupés par sujet, sans retranscrire chaque intervention.

Décisions prises

Une liste courte et non ambiguë des décisions validées.

Plan d’action

| Action | Responsable | Échéance | Statut |

|---|---|---|---|

| Préparer la proposition commerciale | À confirmer | 15 juin | À faire |

| Valider le budget | Direction | 20 juin | En attente |

Points à confirmer

Les informations non tranchées, les responsables inconnus et les dates à préciser doivent apparaître dans une section séparée.

8. Diffuser et archiver le document

Le compte rendu doit être envoyé rapidement, idéalement le jour même ou dans les 24 heures suivant la réunion. Un délai court facilite la correction des erreurs et améliore le suivi des actions.

Avant la diffusion :

  • vérifiez les droits d’accès ;
  • retirez les informations sans rapport avec l’objectif ;
  • supprimez les commentaires internes destinés à un autre public ;
  • indiquez que le document a été généré avec l’aide de l’IA si la politique de l’organisation l’exige ;
  • conservez la version validée dans l’espace documentaire approprié.

La transcription audio ou intégrale ne doit pas être conservée plus longtemps que nécessaire. Le compte rendu final peut avoir une durée de conservation différente selon la nature de la réunion.

Quel outil IA choisir pour faire un compte rendu de réunion ?

Le choix dépend du niveau d’automatisation et du degré de confidentialité.

| Besoin | Solution adaptée |

|---|---|

| Réunions internes sur Teams | Fonction intégrée à Microsoft Teams ou Copilot selon l’offre |

| Réunions sur Zoom | Transcription et assistant IA de Zoom selon l’abonnement |

| Réunions sur Google Meet | Fonction de prise de notes ou transcription disponible selon l’offre |

| Recherche dans de nombreuses réunions | Outil spécialisé avec historique centralisé |

| Contrôle du style du compte rendu | Transcription exportée vers une IA généraliste |

| Données très sensibles | Solution validée par l’organisation, hébergement maîtrisé ou traitement local |

| Réunions en présentiel | Application mobile ou enregistreur compatible avec une transcription |

Les critères essentiels sont :

  • qualité de transcription en français ;
  • reconnaissance des locuteurs ;
  • intégration au calendrier ;
  • conformité RGPD ;
  • hébergement des données ;
  • suppression automatique des enregistrements ;
  • contrôle des droits d’accès ;
  • export du compte rendu ;
  • possibilité de désactiver l’utilisation des données pour l’entraînement ;
  • compatibilité avec les outils déjà utilisés.

Un outil populaire n’est pas nécessairement adapté à une entreprise traitant des informations confidentielles. La sécurité et la gouvernance des données doivent passer avant la seule qualité du résumé.

Combien coûte un compte rendu de réunion par IA ?

Le coût dépend de la méthode choisie.

Fonction intégrée

Les solutions intégrées aux outils de visioconférence peuvent être incluses dans certains abonnements ou réservées à des offres supérieures. Le coût réel dépend alors du nombre d’utilisateurs et des fonctions activées.

Outil spécialisé

Les services spécialisés proposent généralement :

  • une offre gratuite limitée ;
  • un abonnement individuel ;
  • une formule professionnelle par utilisateur ;
  • une offre entreprise avec administration, sécurité et support.

Les limites portent souvent sur le nombre de minutes transcrites, le nombre de réunions mensuelles, l’historique disponible ou les fonctions d’intégration.

IA généraliste

Le coût dépend de l’abonnement au service utilisé et du volume de transcription envoyé. Il faut également prendre en compte le temps de relecture et la gestion sécurisée des fichiers.

Pour une réunion d’une heure, la génération du résumé peut être rapide, mais une vérification sérieuse demande souvent plusieurs minutes supplémentaires. Le coût total comprend donc l’abonnement, le stockage, la transcription et le temps humain de validation.

Quand utiliser l’IA et quand privilégier une rédaction humaine ?

L’IA convient particulièrement aux :

  • réunions de suivi ;
  • points d’équipe ;
  • réunions commerciales ;
  • ateliers de travail ;
  • réunions de projet ;
  • échanges récurrents avec un ordre du jour stable.

Une intervention humaine complète est préférable pour :

  • les conseils d’administration ;
  • les réunions disciplinaires ou RH ;
  • les négociations contractuelles ;
  • les réunions médicales ;
  • les échanges impliquant des secrets industriels ;
  • les décisions ayant une portée juridique ;
  • les réunions comportant des données personnelles sensibles.

Dans ces situations, l’IA peut éventuellement servir à préparer une première transcription dans un environnement sécurisé, mais le document final doit être vérifié et validé par une personne compétente.

Quelles sont les limites et les erreurs possibles ?

Les hallucinations

Une IA peut ajouter une information absente de la transcription, compléter une phrase incertaine ou transformer une hypothèse en décision. Le prompt doit interdire explicitement l’invention d’informations, mais cette précaution ne remplace pas une relecture.

Les erreurs d’attribution

La reconnaissance des locuteurs est imparfaite, notamment lorsque plusieurs personnes parlent en même temps. Une tâche peut donc être associée au mauvais participant.

Les problèmes de contexte

Une phrase ironique, une réserve ou une négation peut être mal interprétée. L’IA comprend mieux la réunion lorsque l’ordre du jour, les documents de référence et les décisions précédentes sont disponibles.

La confidentialité

L’envoi d’un enregistrement vers un fournisseur externe peut entraîner un transfert de données. Il faut vérifier les garanties contractuelles, les sous-traitants, les lieux d’hébergement et les paramètres de conservation.

La dépendance à la qualité audio

Une mauvaise captation produit une mauvaise transcription, même avec un modèle performant. Le matériel et les conditions de réunion ont donc un impact direct sur la qualité du compte rendu.

Bonnes pratiques pour améliorer les comptes rendus générés par IA

  • Utiliser un ordre du jour avant chaque réunion.
  • Demander aux participants d’annoncer leur nom lors de la première prise de parole.
  • Employer une seule langue principale pendant la réunion.
  • Fournir un glossaire des termes techniques.
  • Distinguer clairement les décisions des idées proposées.
  • Exiger l’affichage « À confirmer » lorsque l’information manque.
  • Faire valider les actions par leurs responsables.
  • Ne pas confondre transcription complète et compte rendu final.
  • Limiter l’accès aux fichiers audio et aux transcriptions.
  • Supprimer les données brutes selon la politique de conservation.
  • Conserver une trace de la version validée.
  • Tester l’outil sur des réunions non sensibles avant un déploiement général.

FAQ sur le compte rendu de réunion avec l’IA

Une IA peut-elle rédiger un compte rendu à partir de notes manuscrites ?

Oui, si les notes sont numérisées ou photographiées avec une qualité suffisante. L’IA peut les structurer, mais elle ne pourra pas reconstituer les échanges absents des notes. Les décisions et les échéances devront être vérifiées.

L’IA peut-elle distinguer les décisions des discussions ?

Elle peut le faire si la demande est précise et si les formulations sont explicites. Il est recommandé de demander trois catégories distinctes : décisions validées, propositions et points à confirmer.

Faut-il enregistrer toutes les réunions ?

Non. Une transcription en direct ou des notes structurées peuvent suffire. L’enregistrement doit être limité aux situations où il apporte une réelle utilité et doit respecter les règles de confidentialité applicables.

Un compte rendu généré par IA a-t-il une valeur juridique ?

La valeur juridique dépend du contexte, de la manière dont le document a été établi et des règles applicables. Un résumé automatique ne doit pas être considéré comme une retranscription officielle sans validation adaptée.

Peut-on utiliser ChatGPT pour résumer une réunion confidentielle ?

Uniquement si l’usage du service est autorisé par l’organisation et si les paramètres de protection des données sont compatibles avec la sensibilité du contenu. Une réunion confidentielle ne doit pas être copiée dans un outil grand public sans vérification préalable.

Conclusion : les points clés à retenir

L’IA peut automatiser une grande partie de la création d’un compte rendu de réunion, depuis la transcription jusqu’à l’extraction des décisions et des actions. La méthode la plus fiable consiste à préparer le contexte, enregistrer avec l’accord des participants, générer une synthèse structurée, puis vérifier manuellement les informations critiques.

Les points essentiels sont les suivants :

  • La transcription n’est pas un compte rendu : elle doit être transformée en document opérationnel.
  • Un prompt précis améliore la qualité du résultat.
  • Les décisions, dates, montants et responsabilités doivent être vérifiés.
  • La confidentialité et le RGPD doivent être pris en compte avant d’utiliser un outil externe.
  • La qualité audio influence directement la qualité du résumé.
  • L’IA assiste la rédaction, mais ne remplace pas la validation humaine.
  • Un format standardisé avec décisions et plan d’action rend le compte rendu réellement utile.
  • ✇PandIA
  • Nvidia ouvre une enquête sur Jensen Huang après des soupçons d’espionnage étranger
    Une enquête interne place Jensen Huang, l’un des dirigeants les plus exposés de l’industrie mondiale de l’intelligence artificielle, au centre d’un dossier mêlant renseignement étranger, Pékin et sécurité des semi-conducteurs. Le conseil d’administration de Nvidia veut déterminer si une relation personnelle a pu servir de point d’entrée à une opération visant le patron du groupe.Le conseil de Nvidia ouvre une enquête indépendanteLe 8 novembre 2026, le conseil d’administration de Nvidia a annoncé

Nvidia ouvre une enquête sur Jensen Huang après des soupçons d’espionnage étranger

Par : Vicomte
9 novembre 2026 à 19:01
Nvidia ouvre une enquête sur Jensen Huang après des soupçons d’espionnage étranger

Une enquête interne place Jensen Huang, l’un des dirigeants les plus exposés de l’industrie mondiale de l’intelligence artificielle, au centre d’un dossier mêlant renseignement étranger, Pékin et sécurité des semi-conducteurs. Le conseil d’administration de Nvidia veut déterminer si une relation personnelle a pu servir de point d’entrée à une opération visant le patron du groupe.

Le conseil de Nvidia ouvre une enquête indépendante

Le 8 novembre 2026, le conseil d’administration de Nvidia a annoncé l’ouverture d’une enquête indépendante après plusieurs articles faisant état d’une possible opération de renseignement étranger ciblant Jensen Huang. Le constructeur de processeurs graphiques n’a pas présenté publiquement cette procédure comme une accusation contre son directeur général, mais comme un moyen d’établir les faits et d’évaluer les éventuels risques pour l’entreprise.

Le dossier repose sur une relation intime reconnue par Huang avec une dirigeante d’entreprise. Selon des informations de presse, des responsables américains soupçonnent cette femme d’avoir transmis à Pékin des informations obtenues dans le cadre de cette relation. Les allégations restent contestées et aucune preuve publique établissant une transmission de données confidentielles ou une collaboration avec les services chinois n’a été rendue publique à ce stade.

La nature exacte des informations recherchées, l’identité complète de la dirigeante concernée et l’éventuelle implication d’un service de renseignement n’ont pas été détaillées. L’enquête du conseil devra notamment déterminer si des informations stratégiques de Nvidia ont été accessibles, si des règles internes ont été contournées et si le groupe a correctement géré le risque de sécurité.

Une affaire personnelle devenue un sujet de sécurité nationale

La reconnaissance de cette relation par Jensen Huang donne à l’affaire une dimension personnelle, mais l’enjeu dépasse largement la vie privée du dirigeant. Nvidia occupe une position centrale dans la fourniture de processeurs utilisés pour entraîner et faire fonctionner les grands modèles d’IA. Ces composants, souvent associés aux architectures de calcul parallèle et aux GPU, sont devenus des actifs stratégiques pour les entreprises comme pour les États.

Dans ce contexte, une tentative d’accès indirect à son dirigeant pourrait relever d’une méthode classique d’ingénierie sociale : exploiter une relation de confiance, une vulnérabilité personnelle ou un conflit d’intérêts supposé afin d’obtenir des informations, des introductions ou une influence sur les décisions. Rien ne permet toutefois d’affirmer que ce scénario s’est produit dans le cas présent.

Le conseil d’administration devra aussi séparer trois questions souvent confondues : l’existence de la relation, la possibilité d’un contact avec une personne liée à Pékin et la preuve d’un transfert d’informations sensibles. La première a été reconnue. Les deux autres restent au stade des soupçons rapportés par la presse.

Pékin dénonce des « calomnies »

Le 9 novembre, le ministère chinois des Affaires étrangères a rejeté les accusations, les qualifiant de « calomnies ». Cette réaction inscrit immédiatement l’affaire dans le climat de rivalité technologique entre Washington et Pékin.

Les États-Unis cherchent depuis plusieurs années à limiter l’accès de la Chine aux composants les plus performants nécessaires au calcul intensif et aux applications d’IA. Nvidia a dû adapter certains produits et certaines ventes aux restrictions américaines à l’exportation, dans un environnement où la conception des puces, leur fabrication et leur commercialisation sont soumises à une surveillance croissante.

Le groupe se trouve donc exposé sur plusieurs fronts. Il doit préserver ses relations commerciales, respecter les contrôles américains et protéger des informations susceptibles d’intéresser des concurrents ou des acteurs étatiques. La présence de Jensen Huang, figure publique de Nvidia et interlocuteur régulier des responsables politiques et économiques, accroît mécaniquement sa visibilité auprès des opérations d’influence.

Cette sensibilité explique pourquoi une affaire qui pourrait, dans un autre secteur, rester confinée à la gouvernance d’entreprise prend ici une portée géopolitique. Le sujet n’est pas seulement de savoir si le PDG a commis une faute personnelle, mais si les dispositifs de protection autour d’un dirigeant disposant d’un accès privilégié à des informations industrielles sont suffisants.

Le marché sanctionne l’incertitude

L’action Nvidia a perdu environ 5 % à l’ouverture lundi, selon l’Associated Press. Cette réaction ne constitue pas une preuve de la gravité des faits, mais elle traduit l’inquiétude des investisseurs face à un risque difficile à chiffrer.

Les marchés peuvent absorber une controverse personnelle lorsqu’elle n’affecte ni la stratégie ni la continuité opérationnelle d’un groupe. Ils réagissent plus fortement lorsqu’une affaire touche simultanément la gouvernance, la sécurité des données et les relations entre les États-Unis et la Chine. Dans le cas de Nvidia, la valeur du groupe repose en partie sur sa capacité à conserver son avance technologique et à naviguer dans un cadre réglementaire de plus en plus contraignant.

La baisse initiale pourrait rester limitée si l’enquête conclut rapidement à l’absence de fuite ou de manquement. À l’inverse, la découverte d’informations transmises à un acteur étranger, ou d’une dissimulation au conseil d’administration, pourrait entraîner des conséquences plus lourdes : départs de dirigeants, renforcement des contrôles gouvernementaux, contentieux d’actionnaires et nouvelles restrictions commerciales.

Une épreuve pour la gouvernance de Nvidia

L’enquête devra aussi mesurer la dépendance de Nvidia à son fondateur-dirigeant. Jensen Huang est devenu le principal visage de la stratégie du groupe au moment où ses processeurs sont recherchés par les fournisseurs de services en ligne, les laboratoires d’IA et les administrations. Cette concentration de la communication et de la vision stratégique sur une seule personne renforce son influence, mais augmente aussi le risque qu’une affaire le concernant pèse directement sur la confiance accordée à l’entreprise.

Le conseil d’administration devra donc démontrer son indépendance, préciser le périmètre de la procédure et communiquer suffisamment sur ses conclusions sans exposer de données confidentielles. Une enquête trop opaque alimenterait les spéculations ; une communication trop détaillée pourrait révéler les failles de sécurité que Nvidia cherche précisément à protéger.

Le prochain jalon attendu est la publication des conclusions de cette enquête indépendante. Elles devront établir, documents à l’appui, si des informations sensibles ont été consultées ou transmises, si une opération étrangère peut être caractérisée et quelles mesures Nvidia compte prendre. D’ici là, l’affaire restera un risque concret pour le groupe : non pas nécessairement par les pertes financières immédiates, mais par la question qu’elle pose à toute l’industrie de l’IA — celle de la protection des personnes qui contrôlent les technologies les plus stratégiques du moment.

  • ✇PandIA
  • Comment utiliser l’IA pour créer des sous-titres à une vidéo
    L’IA permet d’utiliser l’intelligence artificielle pour créer des sous-titres à une vidéo en quelques minutes, sans retranscrire manuellement chaque phrase. Les outils capables de générer des sous-titres vidéo avec IA transcrivent l’audio, synchronisent le texte avec la parole, traduisent parfois le contenu et exportent un fichier compatible avec YouTube, TikTok ou un logiciel de montage.Ce guide explique comment créer des sous-titres automatiquement, quels outils choisir, comment corriger les e

Comment utiliser l’IA pour créer des sous-titres à une vidéo

Par : Decrypt
9 novembre 2026 à 12:05
Comment utiliser l’IA pour créer des sous-titres à une vidéo

L’IA permet d’utiliser l’intelligence artificielle pour créer des sous-titres à une vidéo en quelques minutes, sans retranscrire manuellement chaque phrase. Les outils capables de générer des sous-titres vidéo avec IA transcrivent l’audio, synchronisent le texte avec la parole, traduisent parfois le contenu et exportent un fichier compatible avec YouTube, TikTok ou un logiciel de montage.

Ce guide explique comment créer des sous-titres automatiquement, quels outils choisir, comment corriger les erreurs, combien coûte cette opération et comment obtenir un résultat lisible, accessible et professionnel.

Qu’est-ce que la création de sous-titres par IA ?

La création de sous-titres par IA repose généralement sur la reconnaissance automatique de la parole, appelée ASR ou Automatic Speech Recognition. L’outil analyse la piste audio d’une vidéo, identifie les mots prononcés, les associe à des repères temporels et génère un texte synchronisé.

Selon la plateforme utilisée, l’intelligence artificielle peut également :

  • détecter automatiquement la langue parlée ;
  • distinguer plusieurs intervenants ;
  • ajouter la ponctuation ;
  • supprimer certains mots parasites ;
  • traduire les sous-titres dans une autre langue ;
  • créer des sous-titres adaptés au format vertical ;
  • produire des légendes incrustées directement dans la vidéo ;
  • exporter un fichier SRT, VTT, ASS ou TXT.

Sous-titres, légendes et transcription : quelles différences ?

Ces termes sont proches, mais désignent des éléments différents :

  • La transcription reprend les paroles sous forme de texte, sans synchronisation obligatoire.
  • Les sous-titres affichent les paroles au moment où elles sont prononcées.
  • Les légendes peuvent aussi indiquer les sons importants : `[musique]`, `[applaudissements]`, `[sonnerie]`.
  • Les sous-titres traduits convertissent les paroles dans une autre langue.

Pour une vidéo destinée aux réseaux sociaux, les sous-titres incrustés sont souvent pratiques, car ils restent visibles sur tous les appareils. Pour YouTube ou une plateforme de formation, un fichier SRT ou VTT est généralement préférable : le spectateur peut activer, désactiver ou modifier l’apparence des sous-titres.

Pourquoi utiliser l’IA pour sous-titrer une vidéo ?

La méthode automatique offre plusieurs avantages par rapport à la retranscription manuelle.

Gagner du temps

Une vidéo de plusieurs minutes peut être transcrite en quelques instants ou quelques minutes, selon sa durée, la qualité audio et le service choisi. La relecture reste nécessaire, mais elle est beaucoup plus rapide que la saisie complète du texte.

Améliorer l’accessibilité

Les sous-titres rendent une vidéo accessible :

  • aux personnes sourdes ou malentendantes ;
  • aux utilisateurs qui ne peuvent pas activer le son ;
  • aux personnes qui regardent une vidéo dans un lieu public ;
  • aux internautes qui comprennent mieux le contenu à l’écrit ;
  • aux publics internationaux après traduction.

Augmenter la visibilité des contenus

Sur les réseaux sociaux, les vidéos sont souvent regardées sans son. Des sous-titres lisibles peuvent donc améliorer la compréhension et la rétention de l’audience.

Sur YouTube, une transcription bien corrigée fournit également des informations textuelles supplémentaires à la plateforme. Elle ne garantit pas un meilleur classement, mais elle facilite la compréhension du contenu par les moteurs de recherche et les utilisateurs.

Réduire le coût de production

La plupart des outils proposent un forfait gratuit limité, une tarification à la minute ou un abonnement. Pour de courtes vidéos, le coût peut être nul ou faible. Les besoins professionnels nécessitent généralement une formule payante offrant une meilleure précision, davantage de langues et des exports avancés.

Quels outils utiliser pour créer des sous-titres avec l’IA ?

Le meilleur choix dépend du format de la vidéo, du niveau de précision attendu et du besoin éventuel de traduction.

YouTube Studio

YouTube génère automatiquement des sous-titres pour certaines vidéos mises en ligne. Dans YouTube Studio, il est possible de :

  1. ouvrir la section Sous-titres ;
  2. sélectionner la vidéo ;
  3. choisir la langue ;
  4. ouvrir les sous-titres automatiques ;
  5. corriger le texte et le minutage ;
  6. publier ou télécharger le fichier.

Cette solution convient aux vidéos destinées à YouTube. La qualité varie en fonction de l’accent, du bruit de fond, du vocabulaire utilisé et de la clarté de l’enregistrement.

CapCut

CapCut propose une fonction de sous-titrage automatique adaptée aux vidéos courtes et verticales. L’outil permet généralement de :

  • transcrire la voix ;
  • modifier le texte ;
  • changer la police et les couleurs ;
  • appliquer des animations ;
  • générer des sous-titres incrustés ;
  • exporter la vidéo au format adapté aux réseaux sociaux.

CapCut est pratique pour TikTok, Instagram Reels et YouTube Shorts. Une vérification attentive est toutefois recommandée, en particulier pour les noms propres et les termes techniques.

Adobe Premiere Pro

Premiere Pro intègre une fonction de transcription et de création de sous-titres. Le flux de travail permet de transcrire une séquence, de générer des sous-titres à partir de la transcription et d’exporter la vidéo ou un fichier de sous-titres.

Cette solution convient aux monteurs qui souhaitent garder le contrôle sur :

  • la piste de sous-titres ;
  • le style graphique ;
  • le minutage ;
  • les coupures de phrases ;
  • les formats d’exportation professionnels.

Descript, VEED et autres éditeurs en ligne

Des services comme Descript, VEED ou d’autres plateformes de montage en ligne combinent transcription, édition vidéo et sous-titrage automatique. Ils sont adaptés aux podcasts filmés, aux interviews, aux tutoriels et aux contenus marketing.

Avant d’importer une vidéo, il faut vérifier :

  • le nombre de minutes incluses dans l’offre gratuite ;
  • la présence éventuelle d’un filigrane ;
  • les langues disponibles ;
  • la politique de conservation des fichiers ;
  • les restrictions sur l’utilisation commerciale.

Whisper et les solutions locales

Whisper est un modèle de reconnaissance vocale proposé par OpenAI et disponible dans différentes applications et intégrations. Certaines solutions permettent de l’utiliser localement sur un ordinateur, sans envoyer le fichier audio à un service en ligne.

Cette approche est intéressante pour :

  • des vidéos confidentielles ;
  • des entretiens sensibles ;
  • des documents internes ;
  • des productions nécessitant une meilleure maîtrise des données.

Elle demande cependant davantage de compétences techniques et parfois un ordinateur suffisamment puissant.

Comment créer automatiquement des sous-titres avec une IA ?

La méthode générale reste similaire quel que soit l’outil utilisé.

1. Préparer la vidéo

Avant l’importation, vérifier la qualité du fichier :

  • format MP4, MOV ou format accepté par la plateforme ;
  • piste audio présente et audible ;
  • volume suffisamment élevé ;
  • voix séparée autant que possible de la musique ;
  • absence de saturation ;
  • durée compatible avec le forfait choisi.

Une bonne qualité audio améliore souvent davantage le résultat qu’un changement d’outil. Un microphone proche de la source, peu de réverbération et un bruit de fond limité facilitent la reconnaissance vocale.

2. Importer le fichier

Créer un projet dans l’outil choisi, puis importer la vidéo ou uniquement sa piste audio si la plateforme l’autorise.

Pour une vidéo confidentielle, consulter les conditions d’utilisation avant l’envoi. Certains services peuvent conserver temporairement les fichiers ou utiliser des prestataires techniques pour leur traitement.

3. Choisir la langue parlée

Sélectionner la langue principale de la vidéo au lieu de laisser la détection automatique lorsque cette option est disponible. Le choix explicite du français peut améliorer la ponctuation et réduire certaines erreurs.

Pour une vidéo multilingue, vérifier si l’outil accepte plusieurs langues dans un même fichier. Certains services ne gèrent correctement qu’une seule langue par génération.

4. Lancer la transcription automatique

Cliquer sur la fonction intitulée Sous-titres automatiques, Auto captions, Transcription ou Speech to Text.

Le traitement peut prendre quelques secondes ou plusieurs minutes. La durée dépend notamment :

  • de la longueur de la vidéo ;
  • de la charge du service ;
  • de la résolution ou du poids du fichier ;
  • du nombre de pistes audio ;
  • du type de forfait utilisé.

5. Relire et corriger le texte

Cette étape est indispensable. Même les meilleurs modèles peuvent se tromper dans les situations suivantes :

  • accents régionaux ou étrangers ;
  • paroles rapides ;
  • plusieurs personnes qui parlent en même temps ;
  • noms propres ;
  • marques ;
  • acronymes ;
  • termes médicaux, scientifiques ou techniques ;
  • bruit de fond ;
  • musique avec paroles ;
  • phrases incomplètes.

Il faut écouter la vidéo et comparer chaque segment avec le texte affiché. Les erreurs de sens sont prioritaires, suivies par les fautes d’orthographe, la ponctuation et la mise en forme.

6. Ajuster le minutage

Un sous-titre doit apparaître suffisamment tôt pour être lu, mais pas avant la phrase prononcée. Corriger :

  • le début d’affichage ;
  • la fin d’affichage ;
  • les chevauchements ;
  • les pauses trop longues ;
  • les segments trop courts ;
  • les phrases qui restent affichées après la fin de la parole.

Pour une vidéo destinée au grand public, les sous-titres doivent rester faciles à lire. Il vaut mieux répartir une phrase longue sur deux segments que d’afficher un bloc de texte trop dense.

7. Améliorer la présentation

Pour des sous-titres incrustés, privilégier :

  • une police sans empattement ;
  • un contraste élevé ;
  • une taille suffisamment grande sur mobile ;
  • une ombre ou un fond semi-opaque ;
  • une position qui ne masque pas les informations importantes ;
  • deux lignes maximum dans la plupart des cas.

Éviter les couleurs peu contrastées, les animations trop rapides et les effets décoratifs qui nuisent à la lecture.

8. Exporter le résultat

Deux options sont possibles :

  • Exporter la vidéo avec les sous-titres incrustés, pratique pour les réseaux sociaux.
  • Exporter un fichier de sous-titres séparé, utile pour YouTube, les plateformes de formation et les lecteurs vidéo.

Le format SRT est le plus largement reconnu. Le format VTT est fréquent sur le web. Le format ASS permet davantage de personnalisation visuelle, tandis que les formats professionnels comme SCC peuvent être nécessaires pour certains diffuseurs.

Comment choisir entre sous-titres incrustés et fichier SRT ?

Sous-titres incrustés dans la vidéo

Les sous-titres sont intégrés définitivement à l’image. Cette solution est adaptée à :

  • TikTok ;
  • Instagram Reels ;
  • YouTube Shorts ;
  • les vidéos publicitaires ;
  • les contenus consultés sans son.

Avantage principal : le texte est visible quel que soit le lecteur. Inconvénient : une faute reste présente dans la vidéo après export et le spectateur ne peut pas désactiver les sous-titres.

Fichier SRT ou VTT séparé

Le texte est fourni à côté de la vidéo. Cette solution convient à :

  • YouTube ;
  • un site internet ;
  • une plateforme LMS ;
  • un lecteur vidéo professionnel ;
  • une vidéo traduite en plusieurs langues.

Avantages : correction facile, activation optionnelle et possibilité de proposer plusieurs traductions. Il faut toutefois que le lecteur vidéo prenne en charge le format choisi.

Comment traduire automatiquement les sous-titres ?

L’IA peut traduire un fichier de sous-titres français vers l’anglais, l’espagnol, l’allemand ou d’autres langues. La méthode la plus fiable consiste à :

  1. générer les sous-titres dans la langue originale ;
  2. corriger entièrement la transcription ;
  3. traduire le texte corrigé ;
  4. vérifier le minutage ;
  5. faire relire la version traduite par une personne compétente.

Il vaut mieux éviter de traduire directement une transcription pleine d’erreurs. Une erreur dans le texte original peut produire une traduction incompréhensible.

La relecture humaine est particulièrement importante pour :

  • les expressions idiomatiques ;
  • l’humour ;
  • les références culturelles ;
  • le tutoiement et le vouvoiement ;
  • le vocabulaire juridique ou médical ;
  • les noms de produits et de marques.

Combien coûte la création de sous-titres avec une IA ?

Le prix dépend du service, du volume et des fonctionnalités demandées.

Les principales formules

  • Gratuit : minutes limitées, résolution restreinte, filigrane ou options réduites.
  • Paiement à la minute : adapté à un besoin ponctuel.
  • Abonnement mensuel : intéressant pour une production régulière.
  • Offre professionnelle : traitement en volume, espace d’équipe, export avancé et assistance.
  • Solution locale : absence de coût par minute, mais installation et matériel parfois nécessaires.

Les tarifs changent régulièrement. Il faut vérifier la page officielle de l’outil avant de s’engager, en particulier pour les limites de transcription, les langues prises en charge et les conditions d’utilisation commerciale.

Comment améliorer la précision des sous-titres IA ?

Quelques précautions permettent d’obtenir un résultat nettement meilleur.

Enregistrer un son propre

Le traitement de l’audio avant transcription peut faire la différence. Réduire le bruit, augmenter légèrement le volume de la voix et limiter la musique de fond facilite l’analyse.

Utiliser un vocabulaire personnalisé

Certains outils proposent un dictionnaire ou une liste de termes à reconnaître. Ajouter les noms de marques, produits, intervenants et expressions techniques réduit les erreurs récurrentes.

Séparer les intervenants

Pour une interview, utiliser une fonction de détection des locuteurs si elle existe. Sinon, ajouter manuellement les noms ou les tirets afin de rendre les échanges compréhensibles.

Relire les passages importants en priorité

En cas de délai court, vérifier d’abord :

  • les chiffres ;
  • les dates ;
  • les noms ;
  • les consignes ;
  • les prix ;
  • les adresses ;
  • les liens ;
  • les termes techniques.

Une seule erreur sur un nombre ou une instruction peut modifier complètement le sens d’une vidéo.

Les erreurs à éviter avec le sous-titrage automatique

Publier sans relecture

Une transcription automatique n’est pas une version définitive. Une erreur de reconnaissance peut passer inaperçue à l’écoute, mais devenir très visible à l’écran.

Afficher trop de texte

Un bloc long et dense décourage la lecture. Les sous-titres doivent suivre le rythme de la parole et rester suffisamment courts.

Négliger le contraste

Un texte blanc sur une scène claire peut devenir illisible. Ajouter un fond sombre ou une ombre améliore la visibilité, notamment sur mobile.

Traduire avant de corriger

La traduction automatique doit partir d’un texte original fiable. Corriger la transcription avant de lancer la traduction réduit les erreurs en cascade.

Ignorer la confidentialité

Une vidéo interne, un entretien client ou un document soumis au secret professionnel ne doit pas être envoyé à n’importe quelle plateforme. Vérifier le stockage, le chiffrement, la suppression des fichiers et l’utilisation éventuelle des données pour l’entraînement des modèles.

Quand faire appel à un professionnel ?

L’IA suffit pour une vidéo courte, un contenu social ou un brouillon de travail. Une intervention humaine reste préférable dans les cas suivants :

  • vidéo institutionnelle ;
  • cours ou formation certifiante ;
  • contenu médical ou juridique ;
  • vidéo destinée à la télévision ;
  • interview avec plusieurs intervenants ;
  • contenu nécessitant une accessibilité stricte ;
  • traduction commerciale ;
  • production à forte visibilité.

Un professionnel peut corriger la transcription, respecter les normes d’accessibilité, adapter la traduction et contrôler précisément la synchronisation.

Méthode recommandée selon le type de vidéo

Pour une vidéo TikTok ou Reel

Utiliser un éditeur avec sous-titres incrustés, sélectionner un style contrasté et vérifier la lisibilité sur un écran de smartphone. Les phrases courtes et les mots importants peuvent être mis en évidence avec modération.

Pour une vidéo YouTube

Générer un fichier SRT ou corriger les sous-titres directement dans YouTube Studio. Ajouter plusieurs langues si l’audience est internationale, puis vérifier chaque traduction.

Pour un podcast vidéo

Privilégier une transcription structurée, une identification claire des intervenants et une relecture des noms propres. Un fichier VTT ou SRT est souvent préférable à des sous-titres définitivement incrustés.

Pour une formation en ligne

Accorder une attention particulière à la précision, aux termes spécialisés et à l’accessibilité. Proposer les sous-titres dans un format activable et fournir éventuellement une transcription téléchargeable.

Checklist avant publication

Avant de publier une vidéo sous-titrée par IA, vérifier :

  • la langue du fichier ;
  • l’exactitude des mots ;
  • les noms propres et les chiffres ;
  • la ponctuation ;
  • le minutage ;
  • l’absence de chevauchements ;
  • la lisibilité sur mobile ;
  • le contraste ;
  • la position du texte ;
  • le format d’exportation ;
  • la cohérence de la traduction ;
  • la confidentialité des fichiers traités.

À retenir

L’IA permet de créer des sous-titres vidéo rapidement grâce à la transcription automatique de la parole. La méthode la plus efficace consiste à importer une vidéo, choisir la langue, lancer la transcription, corriger le texte, ajuster le minutage, puis exporter une vidéo sous-titrée ou un fichier SRT/VTT.

Les outils comme YouTube Studio, CapCut, Adobe Premiere Pro, Descript, VEED ou les solutions basées sur Whisper répondent à des besoins différents. Pour un contenu social, les sous-titres incrustés sont pratiques. Pour YouTube, une formation ou un site web, un fichier séparé offre davantage de souplesse.

L’automatisation fait gagner du temps, mais la relecture humaine reste indispensable pour les noms, les chiffres, les termes techniques, la ponctuation et la traduction. La qualité finale dépend autant de l’outil que de la clarté de l’audio, du choix du format et du contrôle effectué avant publication.

Qui est Colette Kress, qui remplace Jensen Huang à la tête de Nvidia ?

Après la démission de Jensen Huang, ce 12 novembre 2026, c'est Colette Kress, directrice financière de Nvidia depuis 2013, qui prend les commandes du géant de l'IA par intérim.

Jensen Huang démissionne de Nvidia : le patron le plus puissant de l’IA tombe après deux liaisons extraconjugales

Jensen Huang, le cofondateur de Nvidia, a démissionné de ses fonctions de CEO. Il quitte le conseil d’administration avec effet immédiat. Colette Kress, la directrice financière, assure l’intérim. L’annonce de la démission de l’emblématique patron de Nvidia intervient après les révélations de deux relations extraconjugales, dont l’une avec une dirigeante soupçonnée d’espionnage pour Pékin.

  • ✇intelligence artificielle (IA) – The Conversation
  • L’empreinte carbone astronomique des preuves mathématiques d’OpenAI
    L’empreinte carbone de la preuve mathématique apportée par OpenAI au problème des équations de Navier-Stokes est du même ordre de grandeur que celle d’un télescope du réseau Cherenkov (ici, en photo) qui fonctionnerait pendant dix ou quinze&nbsp;ans. CTA/M-A. Besel/IAC (G. P. Diaz)/ESO L’ESSENTIEL OpenAI a annoncé avoir résolu un problème mathématique millénaire, consistant à prouver l’existence de solutions uniques aux équations de Navier-Stokes, omniprésentes en mécanique des fluides.

L’empreinte carbone astronomique des preuves mathématiques d’OpenAI

L’empreinte carbone de la preuve mathématique apportée par OpenAI au problème des équations de Navier-Stokes est du même ordre de grandeur que celle d’un télescope du réseau Cherenkov (ici, en photo) qui fonctionnerait pendant dix ou quinze&nbsp;ans. CTA/M-A. Besel/IAC (G. P. Diaz)/ESO

L’ESSENTIEL

  • OpenAI a annoncé avoir résolu un problème mathématique millénaire, consistant à prouver l’existence de solutions uniques aux équations de Navier-Stokes, omniprésentes en mécanique des fluides.

  • L’empreinte carbone de cette preuve mathématique, même si elle est difficile à estimer avec précision, est d’un ordre de grandeur considérable : 1 000 tonnes équivalent CO₂.

  • C’est autant que celle de grands instruments d’observation spatiale, pour des durées d’opérations d’une dizaine d’années. De quoi s’interroger sur l’allocation de telles ressources.


Les annonces successives d’OpenAI au sujet de découvertes scientifiques laissent une impression tenace : l’intelligence artificielle (IA) serait désormais indispensable pour faire de la science.

L’entreprise a d’abord annoncé, début septembre 2026, que sa technologie d’IA générative s’était hissée à la hauteur des grands enjeux scientifiques de notre époque en résolvant l’un des problèmes du Prix du millénaire (Millenium Challenges), proposés par le Clay Institute. Celui-ci consistait à démontrer l’existence de solutions uniques aux équations de Navier-Stokes, omniprésentes en mécanique des fluides.


À lire aussi : Pourquoi la science des fluides est au cœur des défis du 21e siècle


Elle a ensuite publié, le 6 octobre 2026, plusieurs centaines de preuves mathématiques générées automatiquement, supposées résoudre de nombreux problèmes ouverts en mathématiques. Plus récemment encore, le 26 octobre, elle a annoncé trois nouveaux résultats majeurs en mathématiques, en physique et en informatique, en précisant cette fois comment elle souhaite collaborer avec la communauté scientifique.

Ces trois annonces renforcent l’idée d’une collaboration étroite entre OpenAI et les universités. Il serait même à la portée de chaque scientifique de se faire assister dans ses recherches. Dans son annonce du 6 octobre, l’entreprise dit en effet qu’en moyenne « chaque résultat a nécessité des ressources de calcul équivalentes à environ trois heures de réflexion de ChatGPT Pro », ce qu’une bonne partie du public cible consomme déjà de manière régulière.
Pourtant, les grandes questions théoriques, comme celles portant sur les équations de Navier-Stokes, nécessitent une quantité de calcul bien plus importante. Alors que des critiques émergent sur l’utilité d’une résolution algorithmique de ces questions, on peut aussi s’interroger sur le coût environnemental des services d’OpenAI auprès de la communauté scientifique.

À titre d’exemple, tentons d’estimer l’empreinte carbone du calcul qui a conduit à la découverte d’une solution non triviale aux équations de Navier-Stokes.

L’IA, « bulldozer » pour les mathématiques modernes ?

On pourrait penser que les mathématiques sont la discipline intellectuelle par excellence, qu’il suffit d’un grand tableau blanc et d’un feutre noir pour prouver des théorèmes, inventer de nouveaux formalismes et, finalement, produire de nouvelles connaissances.

Ce n’est plus le cas. La complexité de certaines preuves requiert désormais une assistance informatique. Avec l’émergence des grands modèles de langue (Large Language Models, ou LLM) et des « agents » autonomes, c’est même la part de créativité que suppose la recherche qui peut être automatisée grâce à l’IA.

À force de publier des résultats à la pelle, OpenAI inspire à Robert Hart, journaliste pour le média états-unien The Verge, ainsi qu’à Gaël Varoquaux, chercheur à l’Inria et chroniqueur au Point, l’image d’un bulldozer. Ces deux auteurs en tirent des conclusions légèrement différentes, mais l’analogie est excellente d’un point de vue énergétique : dès ses débuts, il y a dix ans, OpenAI disait avoir à sa disposition 1 600 calculateurs, dont la puissance électrique cumulée était du même ordre de grandeur que celle d’un engin de chantier.

En 2016 déjà, la puissance électrique cumulée de tous les supercalculateurs utilisés par OpenAI était du même ordre de grandeur que celle d’un bulldozer. PxHere

Dans sa déclaration de septembre, OpenAI déclare avoir utilisé une dizaine de milliers d’agents pour résoudre ce problème, interagissant les uns avec les autres pendant 88 heures, générant

« 2,7 millions de messages et utilisant environ 130 milliards de “tokens” (jetons de sortie) ».

Au tarif que propose OpenAI, la facture pour ce volume de calcul représente l’équivalent du financement d’une quarantaine de bourses de thèses en France.

Une telle concentration de « réflexion », effectuée en quelques dizaines d’heures là où une thèse nécessite au moins trois ans de travail, implique une consommation électrique considérable. De quoi interroger le coût environnemental réel de l’opération.


À lire aussi : L’IA générative est-elle soutenable ? Le vrai coût écologique d’un prompt


Comment estimer l’empreinte carbone d’un système d’IA ?

Il faudrait dans l’idéal mener un bilan environnemental multicritères, mais on se limitera ici à un calcul d’empreinte carbone à partir d’une estimation de la consommation électrique. Celle-ci est déjà suffisamment complexe à estimer du fait de l’opacité entretenue par les entreprises de technologie.
Il faut en effet estimer la consommation électrique des LLM avec des informations partielles et beaucoup d’hypothèses : si l’ordre de grandeur obtenu n’est pas bon, OpenAI ne se privera pas de le souligner, comme Google l’a fait ici ou là, en réponse à des publications académiques sur le sujet.

OpenAI, dans son annonce, nous informe qu’il a fallu effectuer 130 milliards d’opérations pour produire une preuve. Une opération consiste en la production d’un token, qui peut représenter une lettre, un mot ou la portion d’un mot.

Par ailleurs, l’entreprise de services Neuralwatt, l’une des rares à fournir ses données de consommation, indique une consommation moyenne de 33,6 kilojoules (kJ) par millier de tokens (soit environ 10 watts-heures) pour le LLM Kimi K3, que l’on peut supposer proche de celui d’OpenAI.

On peut donc estimer l’énergie consommée pour cette preuve à 1,3 gigawatt-heure. Aussi, en 2026 aux États-Unis, la production d’un kilowatt-heure d’électricité génère en moyenne 388 grammes de gaz à effet de serre en équivalent CO₂, ce qui donne, comme ordre de grandeur, une empreinte carbone qui s’approche des 500 tonnes équivalent CO₂.

En 88 heures seulement, le système d’IA d’OpenAI aurait donc émis autant que 50 personnes résidant dans l’Union européenne (UE) pendant un an (pour se nourrir, se loger, se déplacer, etc.).

Un taux d’échec élevé qui alourdit l’empreinte carbone

Lors de sa quête d’une solution aux équations de Navier-Stokes, l’entreprise indique avoir tenté de résoudre d’autres problèmes sans préciser s’ils ont aussi été résolus. Ce n’est probablement pas le cas. On peut donc inclure cette phase exploratoire dans le calcul, de la même manière qu’il faut prendre en compte les échecs dans un processus de recherche.

En conséquence, ce ne sont pas 130 milliards d’opérations qu’il aura fallu mais 300 milliards au total pour trouver un résultat intéressant parmi les problèmes posés. En utilisant les mêmes hypothèses que précédemment, on peut donc considérer qu’il aura fallu émettre plus de 1 000 tonnes équivalent CO₂ pour aboutir à une publication.

On peut espérer que l’ordre de grandeur de cette estimation est correct, mais celle-ci repose sur des hypothèses fragiles :

  • l’énergie d’un calcul dépend moins du nombre de symboles générés que de la durée du calcul ;

  • personne, en dehors du personnel d’OpenAI, ne peut savoir si Kimi K3 est effectivement comparable au modèle d’OpenAI.

Pour autant, les chiffres donnés par Neuralwatt sur d’autres LLM plus petits, comme DeepSeek v4 Flash, sont comparables à ceux que Google et OpenAI consentent à donner à propos de leurs services grand public, soit environ 0,3 watt-heure par requête.

L’empreinte carbone de l’IA face à celle de l’astronomie

On peut formuler les choses de manière plus prudente encore : si une mathématicienne ou un physicien théorique cherchaient à résoudre le problème de singularité posé par les équations de Navier-Stokes sans avoir accès au système d’IA d’OpenAI, elle et il devraient émettre plus de 1 000 tonnes équivalent CO₂, c’est-à-dire multiplier par 100 leur empreinte carbone annuelle (pour l’UE).

Quelle autre activité de recherche s’autorise une telle empreinte ? Une recherche, publiée dans Nature, estimait que l’empreinte carbone de l’infrastructure de recherche en astronomie, grande émettrice de gaz à effet de serre, est comprise entre 22 tonnes et 50 tonnes équivalent CO₂ par astronome (qui s’ajoutent aux 10 tonnes d’équivalent CO₂ moyennes par personne pour l’UE). On est très loin des 1 000 tonnes.

Prenons maintenant l’exemple de grands projets de recherche en astronomie, impliquant des dizaines, voire des centaines de scientifiques. L’organisation Labos 1point5 (en référence à l’objectif de limiter le réchauffement climatique à 1,5 °C) propose une méthodologie pour évaluer l’empreinte carbone d’un laboratoire sur ce type de projets.

Le projet Giant Radio Array for Neutrino Detector (GRAND), par exemple, qui implique l’installation d’antennes sur 200 kilomètres carrés pour observer l’espace depuis la Terre, a une empreinte carbone estimée à 471 tonnes d’équivalent CO₂. Pour un télescope du réseau Cherenkov, il faut compter encore un peu plus : entre 2 400 tonnes et 2 950 tonnes d’équivalent CO₂.

Comparaison de l’empreinte carbone de plusieurs projets de recherche, dont la génération de preuve mathématique par OpenAI. Fourni par l'auteur

L’empreinte carbone d’OpenAI sur les 88 heures de calcul est peut-être en deçà de ces chiffres, mais, si on les rapporte à la durée des projets, la différence est, littéralement, astronomique. Ces projets sont, en effet, programmés sur vingt et trente ans respectivement. Dans le cas du télescope, 55 % de l’empreinte carbone provient de l’exploitation du télescope pendant trente ans.

Des arbitrages à faire pour une recherche soutenable

À l’heure où la réduction de nos émissions de gaz à effet de serre est supposée être un objectif de l’Union européenne, cette pratique émergente de résolution algorithmique menace la soutenabilité de la recherche théorique, jusqu’à présent l’une des moins émettrices de gaz à effet de serre.

Il faudra peut-être, dans un futur proche, arbitrer entre de telles recherches théoriques « au bulldozer », les recherches en astronomie et tout autre activité de recherche consommatrice de ressources matérielles et d’énergie. Dit autrement, en mathématiques, il faudra peut-être renoncer à la génération de preuves par LLM.


À lire aussi : Étudier la Terre sans la détruire davantage : comment faire de la recherche bas-carbone ?


The Conversation

Victor Charpenay a reçu des financements du réseau de centres d'excellence ENFIELD, financé par l'Union européenne.

CD Projekt mobilise l’IA pour l’extension de The Witcher 3 : « C’est l’un des cas de figure où l’on peut utiliser l’IA de manière éthique »

Pour Songs of the Past, la nouvelle extension de The Witcher 3, les équipes de CD Projekt Red ont eu recours à l'intelligence artificielle pour retrouver la voix polonaise originale de Geralt. Le comédien Jacek Rozenek, dont la voix a changé après un AVC en 2019, a donné son accord.

❌
❌